
この記事の内容
AliExpressスクレイパーは、商品情報を分析しやすい構造化データとして収集するツールです。以下のPythonの例では、検索ページの商品名、価格、通貨、評価、販売数をCSVに出力します。バリエーションやレビューの詳細については、別途ブラウザを使ったワークフローが必要です。
2026年10月16日に行った簡易テストでは、2ページ分の検索結果から117件の商品が取得できました。これは小規模なスナップショットであり、ベンチマークではありません。検索ページからの抽出は機能しましたが、商品ページのレンダリングは安定しませんでした。まずは確認できる項目から始め、必要な場合にのみ詳細情報の収集を追加してください。
主なポイント
- 簡易テストでは、2ページの検索結果から117件の商品を取得しました。
- 取得した117件すべてに表示価格がありました。
- 星評価がなかった商品は16件でした。
- 販売数がなかった商品は6件でした。
- 商品ページがレンダリングできたのは、ブラウザでの3回の試行のうち1回でした。
- 検索ページのHTMLは1ページあたり約0.83〜0.96 MBでした。
- 検索ページのHTML約15 MBは、1 GBあたり$1の場合、$0.015の費用になります。
AliExpressスクレイパーで取得できるデータは?
今回の検索ページ用スクレイパーでは、商品ID、商品名、表示価格、通貨、割引、評価、表示されている販売数を取得できました。バリエーションや個別のレビューは出力していません。
| 取得元 | 確認できた項目 | 確認できた場所 | 制限事項 |
|---|---|---|---|
| 検索ページ | ID、商品名、販売価格、元の価格、通貨、割引、評価、販売数 | HTMLのスクリプト内に埋め込まれたJSON | 評価や販売数がない商品もありました |
| 商品ページ | 商品名、価格、評価、レビュー件数、販売数、バリエーション | レンダリングされたブラウザページ | ブラウザでの3回の試行のうち1回のみレンダリングされました |
| 個別レビュー | 検証済みの抽出方法なし | 読み込まれたレビュー画面の確認が必要です | テスト済みのレビュー用エンドポイントやページ送り処理はありません |
検索結果のペイロードでは itemList.content が使われていました。役立つパスとして、title.displayTitle、prices.salePrice.minPrice、prices.salePrice.currencyCode、trade.tradeDesc、evaluation.starRating などがありました。また、60件の商品URLを含むschema.orgのItemListも確認できました。
2K+ sold のような値はテキストのまま保持してください。これらは表示用のラベルであり、正確な注文総数ではありません。同様に、評価がない場合は0ではなく不明を意味します。
計測元:aliexpress_scraper.py の実行結果と、出力された aliexpress_products.csv です。環境はLinux、Python 3.12、requests、ログインなしの公開ページ、4〜8秒の待機時間でした。2ページ分の収集結果は60件と57件でした。このほか、5つの出口コンテキストの比較と、商品ページでの3回のブラウザ試行を別途確認しました。
PythonでAliExpressスクレイパーを作るには?
検索ページを取得し、埋め込まれたJSONを見つけてデコードし、選んだ項目をCSVに書き出します。以下が、今回の簡易テストで使用したコードです。
python3 -m pip install requests でrequestsをインストールし、次のコードを aliexpress_scraper.py として保存してください。直接リクエストする場合は PROXY_URL を未設定のままにし、プロキシを使う場合は自分のプロキシURLを非公開の状態で設定します。例に含まれる認証情報の値はプレースホルダーです。
import csv, json, os, random, time
import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
}


def fetch(url, retries=3):
    for attempt in range(1, retries + 1):
        try:
            r = requests.get(url, headers=HEADERS, proxies=PROXIES, timeout=40)
        except requests.RequestException as exc:  # timeouts, dropped connections
            print(f"{url} -> {type(exc).__name__}, retry {attempt}")
            time.sleep(5 * attempt)
            continue
        # A slider CAPTCHA page has no product data in it
        if r.status_code == 200 and '"itemList":{"content":[' in r.text:
            return r.text
        print(f"{url} -> {r.status_code}, no product data, retry {attempt}")
        time.sleep(5 * attempt)
    return None


def parse_search(html):
    """Search results are embedded as JSON in the page: "itemList":{"content":[...]}."""
    start = html.find('"itemList":{"content":[') + len('"itemList":')
    item_list, _ = json.JSONDecoder().raw_decode(html, start)
    for item in item_list["content"]:
        if "productId" not in item:
            continue
        sale = item.get("prices", {}).get("salePrice", {})
        original = item.get("prices", {}).get("originalPrice", {})
        yield {
            "product_id": item["productId"],
            "title": item.get("title", {}).get("displayTitle"),
            "price": sale.get("minPrice"),
            "currency": sale.get("currencyCode"),
            "original_price": original.get("minPrice"),
            "discount_pct": sale.get("discount"),
            "sold": item.get("trade", {}).get("tradeDesc"),
            "rating": item.get("evaluation", {}).get("starRating"),
            "url": f"https://www.aliexpress.com/item/{item['productId']}.html",
        }


def scrape_search(query, max_pages=2):
    seen, rows = set(), []
    slug = query.strip().replace(" ", "-")
    for page in range(1, max_pages + 1):
        html = fetch(f"https://www.aliexpress.com/w/wholesale-{slug}.html?page={page}")
        if not html:
            break
        new = [r for r in parse_search(html) if r["product_id"] not in seen]
        if not new:
            break
        seen.update(r["product_id"] for r in new)
        rows.extend(new)
        print(f"page {page}: {len(new)} products")
        time.sleep(random.uniform(4, 8))
    return rows


if __name__ == "__main__":
    rows = scrape_search("phone case", max_pages=2)
    if not rows:
        raise SystemExit("No products collected; check fetch() output first.")
    with open("aliexpress_products.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=rows[0].keys())
        w.writeheader()
        w.writerows(rows)
    print(f"saved {len(rows)} products")
python3 aliexpress_scraper.py を実行してください。プレースホルダーの __cr.us というサフィックスは、出口の国として米国を指定するものです。実際の認証情報は、ソース管理や共有ログに含めないでください。
デコーダーは開始位置から1つのJSONオブジェクトを読み取るため、入れ子の配列に対して正規表現を使う必要がありません。ヘッダーは今回のリクエスト設定を再現したものであり、アクセスや英語での出力を保証するものではありません。
運用上の制限が1つあります。マーカーは完全一致のテキストを必要とするため、ページ構造が変わると抽出できなくなる可能性があります。このスクリプトは、商品が1件も取得できなかった場合、空のリストで失敗するのではなく、わかりやすいメッセージを出して停止します。
商品詳細については、通常のrequestsでは window._d_c_.isCSR = true を含む77 KBの空のシェルが返され、米国からのトラフィックはaliexpress.usにリダイレクトされました。プロキシ経由のヘッドレスChromiumでは、3回の試行のうち1回だけ詳細がレンダリングされ、$1.09、評価5.0、レビュー2件、500+ sold、バリエーションを取得できました。残りの試行では空のままでした。
商品ページ用のコードは、今回のテストでは安定しなかったため公開していません。ブラウザで実装する場合は、公式のPlaywright Pythonのセットアップと、Playwrightスクレイピングガイドから始めてください。セレクターを決める前に、読み込みに成功したページを確認し、動的ページのスクレイピングの手順に従ってください。
AliExpressの検索結果をスクレイピングするには?
キーワード検索のURLを使い、ページのパラメーターを進めながら、商品IDで重複を除外します。この例では、https://www.aliexpress.com/w/wholesale-phone-case.html?page=1 を取得し、続けて2ページ目を取得します。
スクリプトはスペースをハイフンに置き換えます。これはテストした検索語には有効です。すべての記号や言語に対応できるとは考えないでください。入力リストを増やす前に、実際の検索URLを確認してください。
seen セットは、前のページですでに取得したIDを除外します。ページ送りは、取得に失敗した場合、またはページに新しいIDがない場合に停止します。一致するすべての商品を収集できたことを保証するものではなく、1回のレスポンス内の重複には追加のチェックが必要です。
定期的にエクスポートする場合は、各バッチに検索語、ページ番号、出口の国、収集時刻を併せて記録してください。CSVを開くときは、商品IDをテキストとして保持してください。別のマーケットプレイスのワークフローとして、PythonによるeBayのチュートリアルも比較の参考になります。
Googleスプレッドシートを使う場合は、ドキュメント化されたファイルのインポート手順で、CSVを新しいシートに取り込みます。数式を使う前に、識別子の書式と小数の解釈を確認し、通貨は別の列に分けて保持してください。
AliExpressのレビューをスクレイピングするには?
レビューの抽出には、正常に読み込まれた商品ページを対象にした別個の検証が必要です。今回のスナップショットで確認できたのは表示されているレビュー件数であり、動作するレビュースクレイパーではありません。
許可された範囲のブラウザセッションでレビュー画面を開き、実際に送信されるリクエストを確認してください。レスポンスにレビューのレコードが含まれているか、次のページをどのようにリクエストするか、どの項目が含まれているかを把握します。古いチュートリアルからコピーしたエンドポイントが今も使えると思い込まないでください。
最小限のレビューデータセットには、商品ID、評価、日付、関連する個人情報を含まない内容を含めます。投稿者名、プロフィールへのリンク、アバター、識別子は除外してください。レビュー本文にも、個人情報が含まれていないかの確認が必要です。ページ送りは、空のレスポンス、重複したレコード、アクセスチャレンジのいずれかが出た時点で停止します。
レビューは、商品IDで紐づけた別のテーブルに保存してください。商品の総合評価は個別のレビューの代わりにはなりません。また、今回の検索用CSVには、レビュー本文も、検証済みのレビューのページ送り処理も含まれていません。
なぜ価格が表示と異なるのですか?
国別のチェックでは、通貨も商品セットも異なる結果が返されました。このことは収集時のコンテキストが重要である理由を示していますが、同じ商品における地域ごとの価格差を証明するものではありません。
| 出口の国 | 1ページ目の表示価格の中央値 |
|---|---|
| US | 1.09 USD |
| ドイツ | 3.19 EUR |
| 英国 | 1.00 GBP |
| ブラジル | 12.56 BRL |
各ページには60件の商品が含まれていました。USのページには、他のコンテキストと共通する商品がありませんでした。ドイツ、英国、ブラジル、およびEUからの直接接続では、13〜25件の商品が重複していました。直接リクエストでは、英語のlanguageヘッダーを指定したにもかかわらず、EURとフランス語の商品名が返されました。
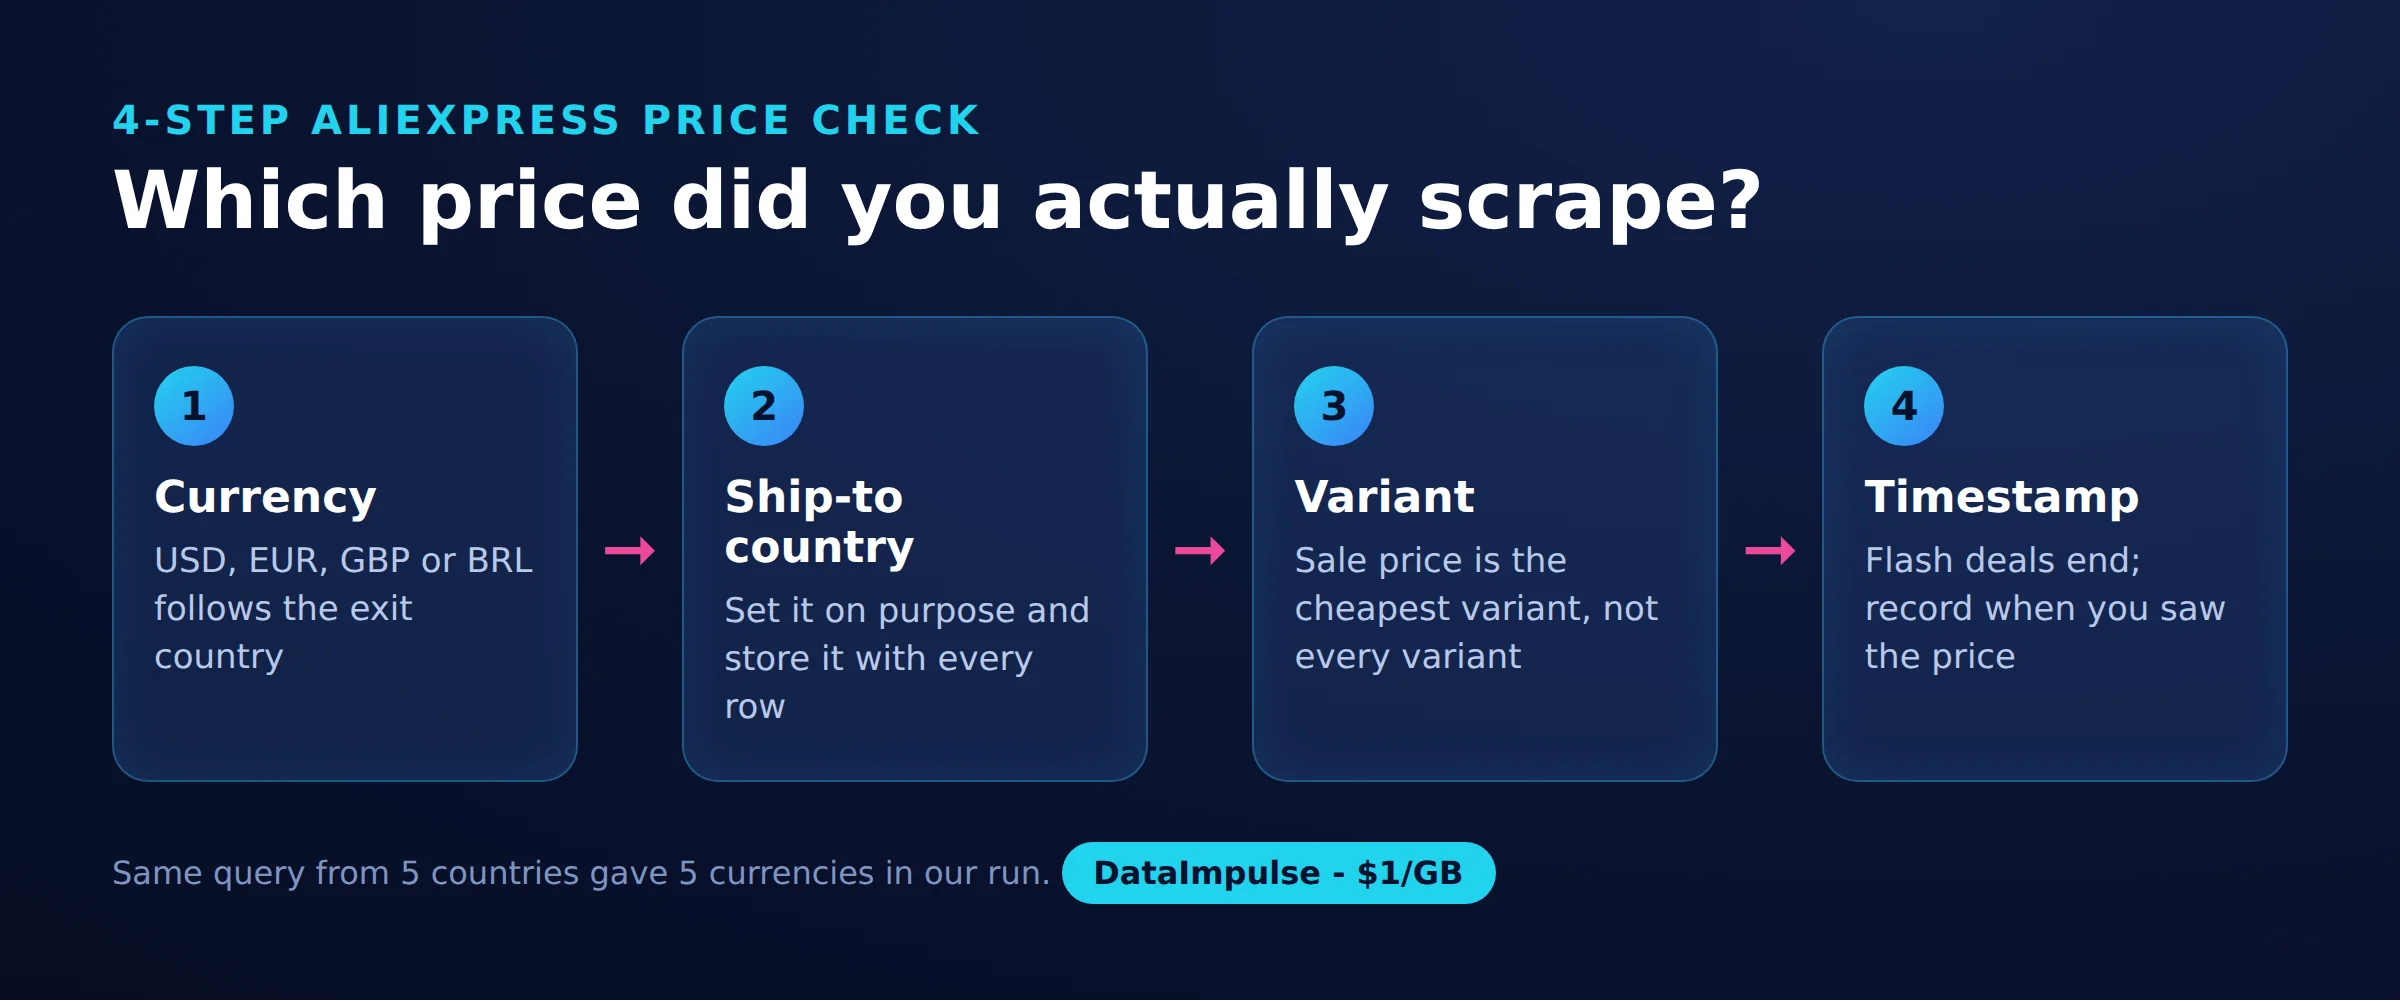
観測結果を比較する前に、AliExpress価格チェックの4ステップを実施してください。
ステップ1:通貨。表示したい通貨を設定し、実際に返された通貨を記録します。
ステップ2:配送先の国。配送先を明示的に設定し、プロキシの出口の国とは別に記録します。ロケールとCookieの状態は一貫させてください。今回のスナップショットでは、これらの影響を切り分けていません。
ステップ3:バリエーション。商品IDと選択したオプションを一致させます。検索ペイロードの minPrice は、リスト上での観測値として扱い、すべてのバリエーションの検証済み価格とは見なさないでください。
ステップ4:タイムスタンプ。観測ごとに収集時刻を保存します。変化を解釈する前に、同等の商品と設定を比較してください。
国を指定したレジデンシャルプロキシは、出口の場所を制御するのに役立ちます。ただし、ストアフロントのあらゆる設定まで決められるわけではありません。再現性のある比較の設計については、価格比較のワークフローをご覧ください。
ブロックされないようにするには?
ゆっくりとした上限のある収集を行い、明確なアクセスチャレンジが出たら停止します。HTTPステータスが成功を示していても、それだけで商品データが届いたことにはなりません。
今回の検索URLは、直接アクセスでもレジデンシャルプロキシ経由でも、HTTP 200を返しました。スクリプトはさらにJSONマーカーの存在を条件とし、再試行は最大3回までで、失敗後は5秒、10秒、15秒待機します。成功したページの間には、4〜8秒のランダムな待機を挟みます。
これは上限付きの線形バックオフであり、完全なブロック検出機能ではありません。JSONが見つからない場合は、レイアウトの変更、空のシェル、チャレンジのいずれかが考えられます。レスポンスと最終的なURLを確認し、スライダー式のCAPTCHAやpunishページが出ていないか調べてください。確認できた場合は、再試行を繰り返さずに実行を中止します。今回のスナップショットでは、CAPTCHAの発生頻度は確認していません。
ブラウザの一連の操作でCookieや場所を一貫させたい場合は、スティッキーセッションが適しています。独立したジョブの間では、対象の国を固定したままローテーションを使います。どちらの方法でもアクセスは保証されません。DataImpulseが提供するのはプロキシによる通信であり、スクレイピングAPI、マネージド型のアンブロッカー、VPNではありません。HTTPエラーが出た場合は、403エラーのトラブルシューティングガイドをご利用ください。
AliExpressの商品1,000件をスクレイピングする費用は?
1 GBあたり$1の場合、検索ページのHTML約15 MBの費用は$0.015です。これは一覧の行を取得するための推定トラフィック費用であり、完全にレンダリングした商品ページ1,000件の見積もりではありません。
約60件の商品を含む検索ページ1ページあたり、HTMLは約0.83〜0.96 MBでした。同様のページ17ページ分では、再試行などのオーバーヘッドを除いて、約14〜16 MBが転送されることになります。この見積もりは10進法のギガバイトを使用し、ページ内の商品密度が同程度であることを前提としています。
重複や欠損項目があると、利用可能な1行あたりの費用が増える場合があります。また、実際に課金されるトラフィックは、スクリプトで計測したHTMLサイズと異なる場合があるため、規模を拡大する前に使用状況の記録を確認してください。
ブラウザでの収集では、追加のスクリプトやその他のアセットもダウンロードされます。商品詳細にはかなり多くのトラフィックを見込んでください。今回のテストでは、正確な倍率を示すことはできません。エンジニアリングの工数、ホスティング、読み込みの失敗、レビューのページ送りは、$0.015の見積もりには含まれていません。
公式APIや既製のスクレイパーを使うべきですか?
必要な項目、保守にかけられる余力、許容できる有効な1行あたりの費用で選んでください。リクエスト単価が安くても、必要なバリエーションや市場の情報が結果に含まれていなければ、あまり役に立ちません。
Open Platformのキーを取得するには、開発者アカウントを作成し、アプリケーションを登録します。アクセスに頼る前に、該当する承認とAPI権限の手続きを完了してください(2026年10月時点)。手順は公式のオンボーディング手順に従います。アプリケーションコンソールからアプリキーとシークレットを取得し、シークレットは非公開に保ってください。アフィリエイト商品クエリの仕様と、認可されたレスポンスを確認して、アプリケーションで使える商品と価格の項目を把握してください。
以下の比較は、各プラットフォームの機能を説明したものであり、AliExpressでの実測性能ではありません。ここでの「記載なし」は、引用元の情報からその比較項目の値が確認できないことを意味します。
| ツール | 料金の単位 | JavaScript | プロキシローテーションは含まれるか | ワークフロー | エクスポート |
|---|---|---|---|---|---|
| Apify | Starter:月額$19と従量課金(2026年10月時点)、1,000件あたりの共通価格:記載なし | ブラウザActorに対応 | 利用可能。含まれるかどうかはActorと課金方式によります | Actorの設定またはカスタムコード | JSON、CSV。Sheetsへのネイティブなエクスポート:ここでは記載なし |
| Octoparse | Standardは年払いで月額$69から(2026年10月時点)、1,000件あたりの共通価格:記載なし | 動的ページに対応 | Standardに含まれる | ビジュアル操作、ノーコード | JSON、CSV、Googleスプレッドシート。プランごとの条件あり |
| ScrapingBee | 通常リクエスト1,000件:JSなしで1,000クレジット、JSありで5,000クレジット(2026年10月時点) | 対応 | マネージド型のローテーション | API/コード | 構造化されたJSON。CSVとSheetsへのネイティブなエクスポート:ここでは記載なし |
| Oxylabs | /Scrapeは、掲載されている対象で1,000件あたり$0.50から、その他の対象では1,000件あたり$1.00から(2026年10月時点)。レンダリングによって費用が変わります | 対応 | マネージド型のローテーション | API/コード | 構造化されたJSON。CSVとSheetsへのネイティブなエクスポート:ここでは記載なし |
利用率を測定せずに、サブスクリプション料金を1件あたりの価格に換算しないでください。マネージドサービスを選ぶ前に、必要な項目を含むサンプルを依頼してください。
- PythonとプロキシによるDIYが向いているのは、検索結果の項目で要件を満たせて、パース処理を保守できる場合です。PythonとプロキシによるDIYが向いていないのは、保守の手間をかけずに、ブラウザで取得する詳細情報を安定して得たい場合です。
- 既製のスクレイパーAPIが向いているのは、サンプルで必要なカバー範囲が確認できた場合です。既製のスクレイパーAPIが向いていないのは、課金単位や欠損項目のせいで費用が読めなくなる場合です。
- 公式のアフィリエイトAPIが向いているのは、承認されたアクセスとそのレスポンススキーマが用途に合う場合です。公式のアフィリエイトAPIが向いていないのは、それらの権限や項目が合わない場合です。
- Chrome拡張機能が向いているのは、監督のもとで小規模なエクスポートを試す場合です。Chrome拡張機能が向いていないのは、無人で繰り返し収集したり、詳細な監査記録が必要だったりする場合です。
AliExpressのスクレイピングは合法ですか?
公開されているからといって、スクレイピングやコンテンツの再利用が許可されているとは限りません。答えは、利用規約、法域、収集方法、利用目的によって異なります。
AliExpressの利用規約は、書面による許可なく、コレクションやデータベースを構築するために体系的にデータを取得することを禁じています。収集する前に、適用される規約を確認してください。
対象ホストのrobots.txtを確認してください。ただし、それをライセンスと見なしてはいけません。RFC 9309は、robotsのルールとアクセス許可を明確に区別しています。
2022年のhiQ対LinkedInの判決は、予備的差止命令の段階で、米国のCFAAのもとでの公開ページへのアクセスを扱いました。契約、著作権、あらゆるスクレイピング行為を対象とした包括的な許可ではありませんでした。
EUデータベース指令は、要件を満たすデータベースを、相当な部分の抽出や再利用から保護しています。CNILのガイダンスも、公開ウェブサイトから収集した個人データに対する保護措置を重視しており、レビュー投稿者の情報には別の義務が生じる場合があります。
進めるかどうかは、現地の法律と関連する許可を確認したうえで、ご自身で判断してください。商用での収集については、必要に応じて専門家の助言を受けてください。より広い論点については、Webスクレイピングの合法性に関するガイドで解説しています。
よくある質問
AliExpressスクレイパーとは何ですか?
マーケットプレイスのコンテンツを構造化されたレコードに変換するプログラムです。実装を選ぶ前に、必要なのが検索結果の一覧なのか、選択したバリエーションなのか、個別のレビューなのかを明確にしてください。
PythonのrequestsでAliExpressをスクレイピングできますか?
requestsによる検索結果の収集では、2ページで117件の商品が取得できました。商品詳細へのリクエストでは空のアプリケーションシェルが返されたため、この結果をすべてのページ種別に一般化すべきではありません。
このコードでバリエーションやレビューを出力できますか?
いいえ。出力できるのは、スクリプトに示した検索結果の項目です。ブラウザによる詳細情報の収集には、別途実装と検証が必要です。
CSVの価格がブラウザで見た価格と違うのはなぜですか?
まず、レコードが同じ商品と同じバリエーションを指しているかを確認してください。そのうえで、通貨、配送先、出口の国、タイムスタンプ、ブラウザの状態を比較してから、違いを解釈してください。
出力に行がない場合はどうすればよいですか?
再実行する前に、レスポンスを確認してください。商品が見つからなかった場合、スクリプトはメッセージを出して停止します。よくある原因は、ページ構造の変更、空のシェル、チャレンジページです。
ローテーション式のプロキシなら、収集の成功は保証されますか?
いいえ。出口のアドレスを変えても、変更されたJSON構造を修復したり、ブラウザでのレンダリングを保証したりすることはできません。明確なアクセスチャレンジが出たら停止し、失敗の原因を調べてください。
AliExpressスクレイパーAPIはどのように評価すればよいですか?
代表的な少量のリストを渡し、実際の出力を確認してください。宣伝されているリクエスト数だけでなく、利用可能なレコード、地域のコンテキスト、欠損項目、総請求額を比較してください。
収集する国を一貫させましょう
自作のスクレイパーで出口の場所を制御したい場合は、国の指定を含めて1 GBあたり$1から利用できるDataImpulseのレジデンシャルプロキシをご利用ください。まずは少量のサンプルから始め、返された通貨と商品を確認し、規模を拡大する前に実際のトラフィックを計測してください。
最終更新日:2026年10月16日。