
In this Article
Według Business of Apps. Google Search obsługuje ponad 10 miliardów wyszukiwań dziennie. Każdy z nas codziennie wysyła dziesiątki konkretnych zapytań. Sam Google przekształcił się w złożony system aplikacji i usług, które pomagają użytkownikom rozwiązywać różne problemy. Jedną z nich jest Google Maps, uznawane za jedną z głównych platform wybieranych do nawigacji i podróży.
Na naszym blogu opisaliśmy już web scraping danych o produktach z Amazon oraz zbieranie popularnych repozytoriów z GitHub. W tym poradniku wyjaśniamy krok po kroku, jak wykonać web scraping Google Search i Maps. Skorzystamy przy tym z proxy. dataimpulse.com oferuje ponad 90 milionów pozyskiwanych etycznie residential proxy oraz sieć 20 milionów datacenter i 16 milionów mobile proxy.
Najważniejsze informacje
- Usługi Google są powszechnie używane na całym świecie, dlatego umiejętność wykonywania web scrapingu danych zależnych od lokalizacji jest niezbędna dla każdego programisty.
- Aby rozpocząć web scraping, należy zainstalować Python z Playwright oraz zapisać dane uwierzytelniające proxy do dalszej konfiguracji.
- Proxy od DataImpulse zapewniają stabilne połączenia i niewidoczność podczas sesji, co jest niezbędne do bezpiecznego web scrapingu.
- Zawsze sprawdzaj i przestrzegaj warunków korzystania z docelowych witryn. Nie wykorzystuj web scrapingu do działań niezgodnych z prawem.
Wymagania wstępne
Jeśli zamierzasz wykonywać web scraping danych Google SERP, z pewnością potrzebujesz określonego zestawu narzędzi. Oto kilka z nich:
- Python, w najnowszej wersji. W tym poradniku używamy macOS. Pobierz go tutaj, zainstaluj rozszerzenie Python w VS Code. Otwórz terminal i sprawdź, czy jest zainstalowany, za pomocą:
python3 --version
- Visual Studio Code (lub inny edytor kodu). Pobierz go tutaj, zainstaluj i otwórz folder projektu.
- Playwright do automatyzacji przeglądarki. Zainstaluj Playwright, uruchamiając w terminalu:
pip3 install playwright
- Dane uwierzytelniające proxy z dashboardu DataImpulse. Zaloguj się do DataImpulse i skopiuj dane proxy, takie jak host, port, login i hasło.
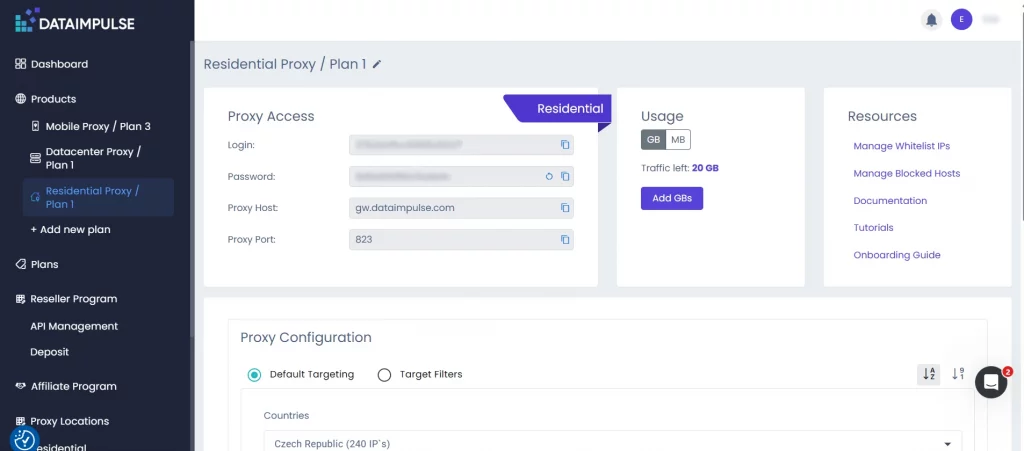
- Wbudowane biblioteki Python. Będziemy potrzebować asyncio oraz random, które są już zainstalowane.
- Mechanizm wykrywania blokad i ponawiania prób. Scraper wykrywa blokady przez mechanizmy antybotowe Google, śledząc URL pod kątem sygnałów takich jak przekierowania /sorry/ przekierowania i skanuje treść strony pod kątem komunikatów “unusual traffic”. Jeśli blokada zadziałała lub strona zwróciła pusty wynik, system nie zatrzymuje się. Odczekuje losową przerwę, rozpoczyna nową sesję przeglądarki i kieruje kolejne żądanie przez świeży serwer proxy. Pętla jest powtarzana kilka razy. To wystarcza, by przejść dalej bez dwukrotnego uruchamiania tych samych mechanizmów wykrywania.
Mechanizm ponawiania prób wygląda tak:
for attempt in range(1, MAX_ATTEMPTS + 1):
wait_time = RETRY_DELAY_SECONDS + random.randint(1, 7)
await asyncio.sleep(wait_time)
- Logika ekstrakcji DOM. Analizuje i wyodrębnia wyniki organiczne z Document Object Model Google, wskazując kontenery wyników, analizując tytuł lub URL oraz odfiltrowując reklamy i duplikaty.
Web scraping wyników wyszukiwania Google
Oto główne powody, dla których możesz potrzebować wykonać web scraping danych wyszukiwania Google:
- Monitorowanie SEO pozycji witryny i analiza wyników konkurencji w czasie rzeczywistym.
- Analiza konkurencji, aby dowiedzieć się, kto dominuje w niszy i jakich strategii reklamowych używają konkurenci.
- Badanie rynku pod kątem trendów, popularnych zapytań i zmian popytu konsumenckiego.
- Pozyskiwanie leadów za pomocą katalogów firm i lokalnej dystrybucji.
- Ochrona marki i monitorowanie tego, co Google wyświetla dla zapytań o markę i wzmianek o firmie.
Przygotowany przez nas kod automatyzuje wyszukiwania Google za pomocą przeglądarki Playwright i proxy DataImpulse. Skrypt otwiera Google, wpisuje podane zapytanie, naśladuje zachowanie zwykłego użytkownika, sprawdza, czy pojawiła się CAPTCHA lub blokada, a następnie zbiera organiczne wyniki wyszukiwania.
Dla każdego wyniku skrypt wyodrębnia link do witryny, tytuł i krótki opis. Aby działać szybciej, kod blokuje ładowanie obrazów i multimediów. Jeśli Google zablokuje żądanie lub nie znajdzie wyników, skrypt ponawia próbę kilka razy z przerwami. Jest to tak zwana rotacja proxy.
W efekcie program wyświetla bezpośrednio w konsoli pierwsze 10 wyników organicznych dla danego słowa kluczowego. Krótko mówiąc, są trzy główne kroki.
Krok 1. Zbuduj kontrolowane środowisko przeglądania.
Najpierw musimy zainicjować i skonfigurować sesję przeglądarki. Uruchom instancję Chromium sterowaną przez Playwright, rozpocznij kierowanie ruchu przez proxy oraz zastosuj ustawienia geolokalizacji i fingerprintingu.
Krok 2. Naśladuj zachowanie użytkownika i obsługuj blokady.
Aby symulować rzeczywistą interakcję użytkownika, uwzględnij ruch myszy i obsługę plików cookie. Wygląda to tak:
await page.goto(google_home_url, wait_until="domcontentloaded", timeout=60000)
await page.wait_for_timeout(random.randint(1200, 2500))
await accept_google_cookies(page)
await check_google_block(page)
search_box = page.locator('textarea[name="q"], input[name="q"]').first
await search_box.click()
await page.mouse.move(
random.randint(250, 900),
random.randint(180, 650),
steps=8
)
for char in keyword:
await search_box.type(char, delay=random.randint(35, 110))
await search_box.press("Enter")
Sprawdź CAPTCHA lub blokady i zastosuj logikę ponawiania prób ze świeżymi sesjami.
Krok 3. Wyodrębnij i zweryfikuj końcowe wyniki.
W tym kroku analizujemy DOM i wyodrębniamy ustrukturyzowane dane SERP. W tym poradniku użyliśmy jako słowa kluczowego ‘lokalizacje na Ukrainie’.
Oto końcowy fragment kodu:
*Nie zapomnij zastąpić konfiguracji proxy własnymi danymi uwierzytelniającymi proxy.
#!/usr/bin/env python3
import asyncio
import random
from playwright.async_api import async_playwright
# ====== EDIT THESE VALUES ======
PROXY_HOSTNAME = "gw.dataimpulse.com"
PROXY_PORT = "823"
PROXY_LOGIN = "LOGIN"
PROXY_PASSWORD = "PASS"
keyword = "Ukraine locations"
# ===============================
RESULTS_LIMIT = 10
GOOGLE_COUNTRY = "US"
GOOGLE_LANGUAGE = "en"
BLOCK_RESOURCE_TYPES = {"image", "media"}
MAX_ATTEMPTS = 5
RETRY_DELAY_SECONDS = 8
HEADLESS = True
async def block_slow_resources(route):
if route.request.resource_type in BLOCK_RESOURCE_TYPES:
await route.abort()
else:
await route.continue_()
async def accept_google_cookies(page):
buttons = [
'button:has-text("Accept all")',
'button:has-text("I agree")',
'button:has-text("Accept")',
'button:has-text("Reject all")',
"#L2AGLb",
]
for selector in buttons:
try:
button = page.locator(selector).first
if await button.is_visible(timeout=1500):
await button.click()
await page.wait_for_timeout(700)
return
except Exception:
pass
async def check_google_block(page):
current_url = page.url.lower()
if "/sorry/" in current_url or "captcha" in current_url:
raise RuntimeError("Google returned CAPTCHA / unusual traffic page.")
body_text = (await page.locator("body").inner_text(timeout=5000)).lower()
block_texts = [
"our systems have detected unusual traffic",
"unusual traffic from your computer network",
"detected suspicious traffic",
"captcha",
]
if any(text in body_text for text in block_texts):
raise RuntimeError("Google returned CAPTCHA / unusual traffic page.")
async def human_like_google_search(page):
google_home_url = (
"https://www.google.com/"
f"?hl={GOOGLE_LANGUAGE}"
f"&gl={GOOGLE_COUNTRY}"
"&pws=0"
)
await page.goto(google_home_url, wait_until="domcontentloaded", timeout=60000)
await page.wait_for_timeout(random.randint(1200, 2500))
await accept_google_cookies(page)
await check_google_block(page)
search_box = page.locator('textarea[name="q"], input[name="q"]').first
await search_box.wait_for(state="visible", timeout=30000)
await search_box.click()
await page.mouse.move(random.randint(250, 900), random.randint(180, 650), steps=8)
await page.wait_for_timeout(random.randint(400, 900))
for char in keyword:
await search_box.type(char, delay=random.randint(35, 110))
await page.wait_for_timeout(random.randint(500, 1100))
await search_box.press("Enter")
await page.wait_for_load_state("domcontentloaded", timeout=60000)
async def extract_results(page):
return await page.evaluate(
"""
() => {
const cleanText = (value) => (value || '').replace(/\\s+/g, ' ').trim();
const cleanUrl = (href) => {
if (!href) return '';
try {
const parsed = new URL(href, window.location.href);
if (parsed.hostname.includes('google.') && parsed.pathname === '/url') {
return parsed.searchParams.get('q') || parsed.searchParams.get('url') || '';
}
return parsed.href;
} catch {
return href;
}
};
const isNormalWebsite = (href) => {
if (!href || !/^https?:\\/\\//i.test(href)) return false;
try {
const host = new URL(href).hostname.replace(/^www\\./, '');
return !host.startsWith('google.') &&
!host.endsWith('.google.com') &&
host !== 'webcache.googleusercontent.com';
} catch {
return false;
}
};
const root = document.querySelector('#rso') || document.querySelector('#search') || document.body;
const blocks = [...root.querySelectorAll('div.tF2Cxc, div.MjjYud, div.g')];
const results = [];
const seenUrls = new Set();
for (const block of blocks) {
const titleElement = block.querySelector('h3');
if (!titleElement) continue;
const linkElement = titleElement.closest('a') || block.querySelector('a[href]');
const websiteUrl = cleanUrl(linkElement && linkElement.href);
if (!isNormalWebsite(websiteUrl) || seenUrls.has(websiteUrl)) continue;
const blockText = cleanText(block.innerText).toLowerCase();
if (blockText.startsWith('sponsored') || blockText.startsWith('ad ')) continue;
const descriptionElement =
block.querySelector('.VwiC3b, .IsZvec, .GI74Re, [data-sncf], .kb0PBd') ||
[...block.querySelectorAll('span, div')]
.find((node) => cleanText(node.innerText).length > 80);
results.push({
website_url: websiteUrl,
title: cleanText(titleElement.innerText),
description: cleanText(descriptionElement && descriptionElement.innerText),
});
seenUrls.add(websiteUrl);
}
return results;
}
"""
)
async def scrape_google_serp():
proxy_server = f"http://{PROXY_HOSTNAME}:{PROXY_PORT}"
async with async_playwright() as playwright:
browser = await playwright.chromium.launch(
headless=HEADLESS,
proxy={
"server": proxy_server,
"username": PROXY_LOGIN,
"password": PROXY_PASSWORD,
},
args=[
"--disable-blink-features=AutomationControlled",
"--disable-dev-shm-usage",
"--no-first-run",
],
)
context = await browser.new_context(
viewport={
"width": random.choice([1280, 1366, 1440]),
"height": random.choice([720, 768, 900]),
},
locale=f"{GOOGLE_LANGUAGE}-{GOOGLE_COUNTRY}",
timezone_id="America/New_York",
color_scheme="light",
user_agent=(
"Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
"AppleWebKit/537.36 (KHTML, like Gecko) "
"Chrome/126.0.0.0 Safari/537.36"
),
)
await context.add_init_script(
"""
Object.defineProperty(navigator, 'webdriver', { get: () => undefined });
Object.defineProperty(navigator, 'languages', { get: () => ['en-US', 'en'] });
"""
)
await context.route("**/*", block_slow_resources)
page = await context.new_page()
try:
await human_like_google_search(page)
await check_google_block(page)
await page.wait_for_selector("#search, #rso", timeout=30000)
results = await extract_results(page)
return results[:RESULTS_LIMIT]
finally:
await browser.close()
async def main():
print(f"Query: {keyword}")
print("Searching Google through DataImpulse proxy...\n")
results = []
for attempt in range(1, MAX_ATTEMPTS + 1):
print(f"Attempt {attempt}/{MAX_ATTEMPTS}")
try:
results = await scrape_google_serp()
except Exception as error:
print(f"Attempt failed: {error}")
if attempt < MAX_ATTEMPTS:
wait_time = RETRY_DELAY_SECONDS + random.randint(1, 7)
print(f"Retrying with a fresh browser context in {wait_time}s...\n")
await asyncio.sleep(wait_time)
continue
print("\nFinished without crashing, but Google still returned a block page.")
print("Try again later, lower request volume, or use DataImpulse country targeting like login__cr.us.")
return
if results:
break
if attempt < MAX_ATTEMPTS:
wait_time = RETRY_DELAY_SECONDS + random.randint(1, 7)
print(f"No results found. Retrying in {wait_time}s...\n")
await asyncio.sleep(wait_time)
else:
print("No results found after all attempts.")
if not results:
print("Finished successfully, but no organic results were found.")
return
print("Success. Organic results extracted.\n")
for index, result in enumerate(results, start=1):
print(f"#{index}")
print(f"Query: {keyword}")
print(f"Website URL: {result['website_url']}")
print(f"Title: {result['title']}")
print(f"Description: {result['description']}")
print("-" * 80)
if __name__ == "__main__":
asyncio.run(main())
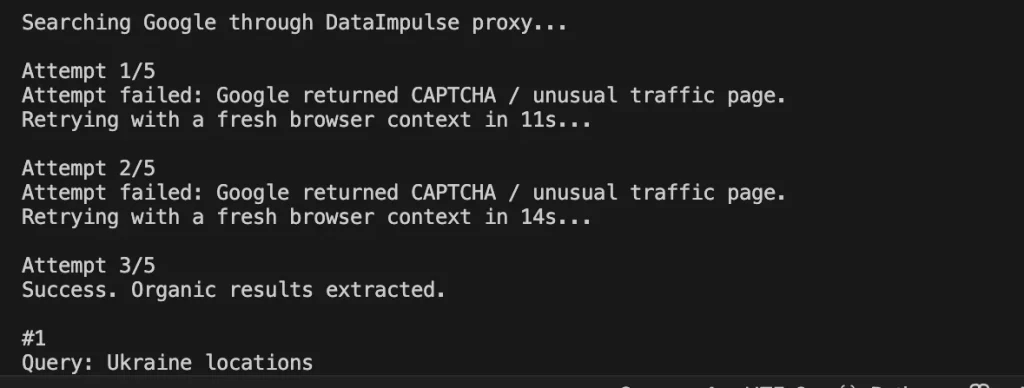
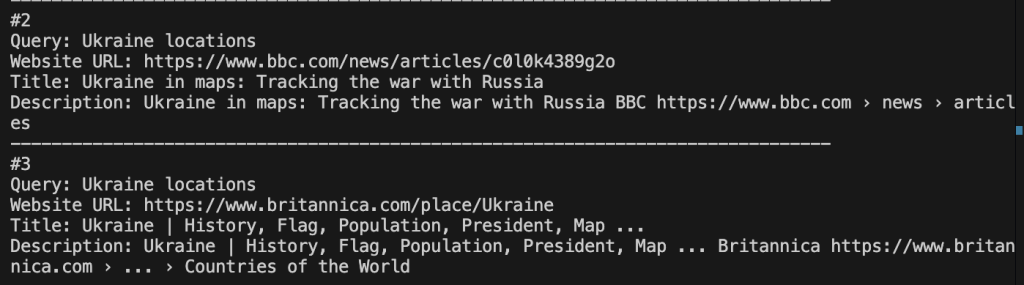
W naszym przypadku pierwsze dwie próby się nie powiodły, ale trzecia w końcu zadziałała:
Web scraping Google Maps w Python
Dane zależne od lokalizacji od zawsze stanowią cenny zasób dla wielu projektów biznesowych, w tym analiz i monitorowania. Poniższy kod automatyzuje zbieranie danych z Google Maps przez Playwright i proxy DataImpulse. Otwiera Google Maps z podanym zapytaniem, takim jak “dentysta w Niewym Jorku”, symuluje zwykłą przeglądarkę, akceptuje pliki cookie, sprawdza, czy Google nie wyświetlił CAPTCHA, a następnie przewija listę wyników.
Następnie skrypt zbiera linki do znalezionych lokalizacji, otwiera kolejno każdy profil firmy i wyodrębnia najważniejsze informacje, takie jak nazwa, adres, numer telefonu, witryna, ocena oraz URL Google Maps.
Skrypt blokuje też ładowanie obrazów i plików multimedialnych. Korzysta również z ustawień stealth, user-agent, losowego rozmiaru ekranu i naturalnych opóźnień, aby przeglądarka wyglądała na mniej zautomatyzowaną.
Jeśli Google Maps zablokuje żądanie lub nie znajdzie danych, skrypt ponawia próbę kilka razy w nowym kontekście przeglądarki. W efekcie wyświetla w konsoli do 10 pasujących lokalizacji dla podanego słowa kluczowego.
Proces web scrapingu wygląda tak:
- 1. Zainicjuj i skonfiguruj sesję przeglądarki.
- 2. Otwórz Google Maps i załaduj wyniki wyszukiwania.
- 3. Wyodrębnij i zweryfikuj dane firmy.
- 4. Wykryj blokady i przywróć działanie.
Oto końcowy fragment kodu:
*Nie zapomnij zastąpić konfiguracji proxy własnymi danymi uwierzytelniającymi proxy.
#!/usr/bin/env python3
"""
Simple Google Maps address scraper through a DataImpulse proxy.
Before first run:
python3 -m pip install playwright playwright-stealth
python3 -m playwright install chromium
Then edit the values below and run:
python3 google_maps_address_scraper.py
"""
import asyncio
import random
from urllib.parse import quote_plus
from playwright.async_api import TimeoutError as PlaywrightTimeoutError
from playwright.async_api import async_playwright
# ====== EDIT THESE VALUES ======
PROXY_HOSTNAME = "gw.dataimpulse.com"
PROXY_PORT = "823"
PROXY_LOGIN = "LOGIN"
PROXY_PASSWORD = "PASS"
keyword = "dentist in New York"
# ===============================
RESULTS_LIMIT = 10
GOOGLE_COUNTRY = "US"
GOOGLE_LANGUAGE = "en"
HEADLESS = True
MAX_ATTEMPTS = 3
RETRY_DELAY_SECONDS = 8
BLOCK_RESOURCE_TYPES = {"image", "media"}
async def block_slow_resources(route):
if route.request.resource_type in BLOCK_RESOURCE_TYPES:
await route.abort()
else:
await route.continue_()
async def apply_stealth_if_available(page):
try:
from playwright_stealth import Stealth
except ImportError:
try:
from playwright_stealth import stealth_async
except ImportError:
print("playwright-stealth is not installed for this Python.")
print("Optional install: python3 -m pip install playwright-stealth\n")
return
await stealth_async(page)
print("playwright-stealth applied.\n")
return
await Stealth().apply_stealth_async(page)
print("playwright-stealth applied.\n")
async def accept_google_cookies(page):
buttons = [
'button:has-text("Accept all")',
'button:has-text("I agree")',
'button:has-text("Accept")',
'button:has-text("Reject all")',
"#L2AGLb",
]
for selector in buttons:
try:
button = page.locator(selector).first
if await button.is_visible(timeout=1500):
await button.click()
await page.wait_for_timeout(700)
return
except Exception:
pass
async def check_google_block(page):
current_url = page.url.lower()
if "/sorry/" in current_url or "captcha" in current_url:
raise RuntimeError("Google returned CAPTCHA / unusual traffic page.")
body_text = (await page.locator("body").inner_text(timeout=5000)).lower()
block_texts = [
"our systems have detected unusual traffic",
"unusual traffic from your computer network",
"detected suspicious traffic",
"captcha",
]
if any(text in body_text for text in block_texts):
raise RuntimeError("Google returned CAPTCHA / unusual traffic page.")
async def open_google_maps(page):
maps_url = (
"https://www.google.com/maps/search/"
f"{quote_plus(keyword)}"
f"?hl={GOOGLE_LANGUAGE}"
f"&gl={GOOGLE_COUNTRY}"
)
await page.goto(maps_url, wait_until="domcontentloaded", timeout=60000)
await page.wait_for_timeout(random.randint(2500, 4500))
await accept_google_cookies(page)
await check_google_block(page)
async def scroll_results_list(page):
feed = page.locator('[role="feed"]').first
try:
await feed.wait_for(state="visible", timeout=15000)
except PlaywrightTimeoutError:
return
previous_count = 0
stable_rounds = 0
for _ in range(12):
cards = page.locator('a[href*="/maps/place/"]')
current_count = await cards.count()
if current_count >= RESULTS_LIMIT:
return
if current_count == previous_count:
stable_rounds += 1
else:
stable_rounds = 0
if stable_rounds >= 3:
return
previous_count = current_count
await feed.evaluate("(element) => element.scrollBy(0, element.scrollHeight)")
await page.wait_for_timeout(random.randint(1200, 2200))
async def get_place_links(page):
return await page.evaluate(
"""
() => {
const links = [...document.querySelectorAll('a[href*="/maps/place/"]')]
.map((link) => link.href)
.filter(Boolean);
return [...new Set(links)];
}
"""
)
async def get_text(page, selector, timeout=2500):
try:
element = page.locator(selector).first
if await element.is_visible(timeout=timeout):
return " ".join((await element.inner_text()).split())
except Exception:
return ""
return ""
async def extract_place_data(page):
name = await get_text(page, "h1.DUwDvf, h1")
address = await get_text(page, '[data-item-id="address"]')
website = ""
phone = ""
if not address:
address = await page.evaluate(
"""
() => {
const item = document.querySelector('[aria-label^="Address:"]');
return item ? item.getAttribute('aria-label').replace(/^Address:\\s*/i, '').trim() : '';
}
"""
)
website = await page.evaluate(
"""
() => {
const selectors = [
'a[data-item-id="authority"]',
'a[aria-label^="Website:"]',
'a[href^="http"]:not([href*="google."])'
];
for (const selector of selectors) {
const element = document.querySelector(selector);
if (!element) continue;
const href = element.href || '';
if (href && !href.includes('/maps/')) return href;
}
return '';
}
"""
)
phone = await page.evaluate(
"""
() => {
const byItemId = document.querySelector('[data-item-id^="phone:"]');
if (byItemId) return (byItemId.innerText || '').replace(/\\s+/g, ' ').trim();
const byAria = document.querySelector('[aria-label^="Phone:"]');
if (byAria) {
return byAria.getAttribute('aria-label').replace(/^Phone:\\s*/i, '').trim();
}
return '';
}
"""
)
rating = await page.evaluate(
"""
() => {
const rating = document.querySelector('[role="img"][aria-label*="stars"]');
return rating ? rating.getAttribute('aria-label') : '';
}
"""
)
return {
"query": keyword,
"name": name,
"address": address,
"phone": phone,
"website": website,
"rating": rating,
"google_maps_url": page.url,
}
async def scrape_google_maps_once():
proxy_server = f"http://{PROXY_HOSTNAME}:{PROXY_PORT}"
async with async_playwright() as playwright:
browser = await playwright.chromium.launch(
headless=HEADLESS,
proxy={
"server": proxy_server,
"username": PROXY_LOGIN,
"password": PROXY_PASSWORD,
},
args=[
"--disable-blink-features=AutomationControlled",
"--disable-dev-shm-usage",
"--no-first-run",
],
)
context = await browser.new_context(
viewport={
"width": random.choice([1280, 1366, 1440]),
"height": random.choice([720, 768, 900]),
},
locale=f"{GOOGLE_LANGUAGE}-{GOOGLE_COUNTRY}",
timezone_id="America/New_York",
color_scheme="light",
user_agent=(
"Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
"AppleWebKit/537.36 (KHTML, like Gecko) "
"Chrome/126.0.0.0 Safari/537.36"
),
)
await context.add_init_script(
"""
Object.defineProperty(navigator, 'webdriver', { get: () => undefined });
Object.defineProperty(navigator, 'languages', { get: () => ['en-US', 'en'] });
"""
)
await context.route("**/*", block_slow_resources)
page = await context.new_page()
try:
await apply_stealth_if_available(page)
await open_google_maps(page)
await scroll_results_list(page)
place_links = await get_place_links(page)
place_links = place_links[:RESULTS_LIMIT]
results = []
seen = set()
if not place_links:
print("No result list detected. Trying to extract the currently opened place.")
data = await extract_place_data(page)
if data["name"] or data["address"]:
return [data]
for index, place_url in enumerate(place_links, start=1):
print(f"Opening place {index}/{len(place_links)}")
await page.goto(place_url, wait_until="domcontentloaded", timeout=60000)
await page.wait_for_timeout(random.randint(2500, 4500))
await check_google_block(page)
data = await extract_place_data(page)
unique_key = data["name"] or data["google_maps_url"]
if unique_key in seen:
continue
if data["name"] or data["address"]:
results.append(data)
seen.add(unique_key)
return results
finally:
await browser.close()
async def main():
print(f"Google Maps query: {keyword}")
print("Searching Google Maps through DataImpulse proxy...\n")
results = []
for attempt in range(1, MAX_ATTEMPTS + 1):
print(f"Attempt {attempt}/{MAX_ATTEMPTS}")
try:
results = await scrape_google_maps_once()
except Exception as error:
print(f"Attempt failed: {error}")
if attempt < MAX_ATTEMPTS:
wait_time = RETRY_DELAY_SECONDS + random.randint(1, 7)
print(f"Retrying with a fresh browser context in {wait_time}s...\n")
await asyncio.sleep(wait_time)
continue
print("\nFinished without crashing, but Google Maps did not return usable data.")
print("Try DataImpulse country targeting like login__cr.us, lower volume, or run again later.")
return
if results:
break
if attempt < MAX_ATTEMPTS:
wait_time = RETRY_DELAY_SECONDS + random.randint(1, 7)
print(f"No places found. Retrying in {wait_time}s...\n")
await asyncio.sleep(wait_time)
else:
print("No places found after all attempts.")
if not results:
print("Finished successfully, but no Google Maps places were found.")
return
print(f"Success. Extracted {len(results)} Google Maps places.\n")
for index, item in enumerate(results, start=1):
print(f"#{index}")
print(f"Query: {item['query']}")
print(f"Name: {item['name']}")
print(f"Address: {item['address']}")
print(f"Phone: {item['phone']}")
print(f"Website: {item['website']}")
print(f"Rating: {item['rating']}")
print(f"Google Maps URL: {item['google_maps_url']}")
print("-" * 80)
if __name__ == "__main__":
asyncio.run(main())
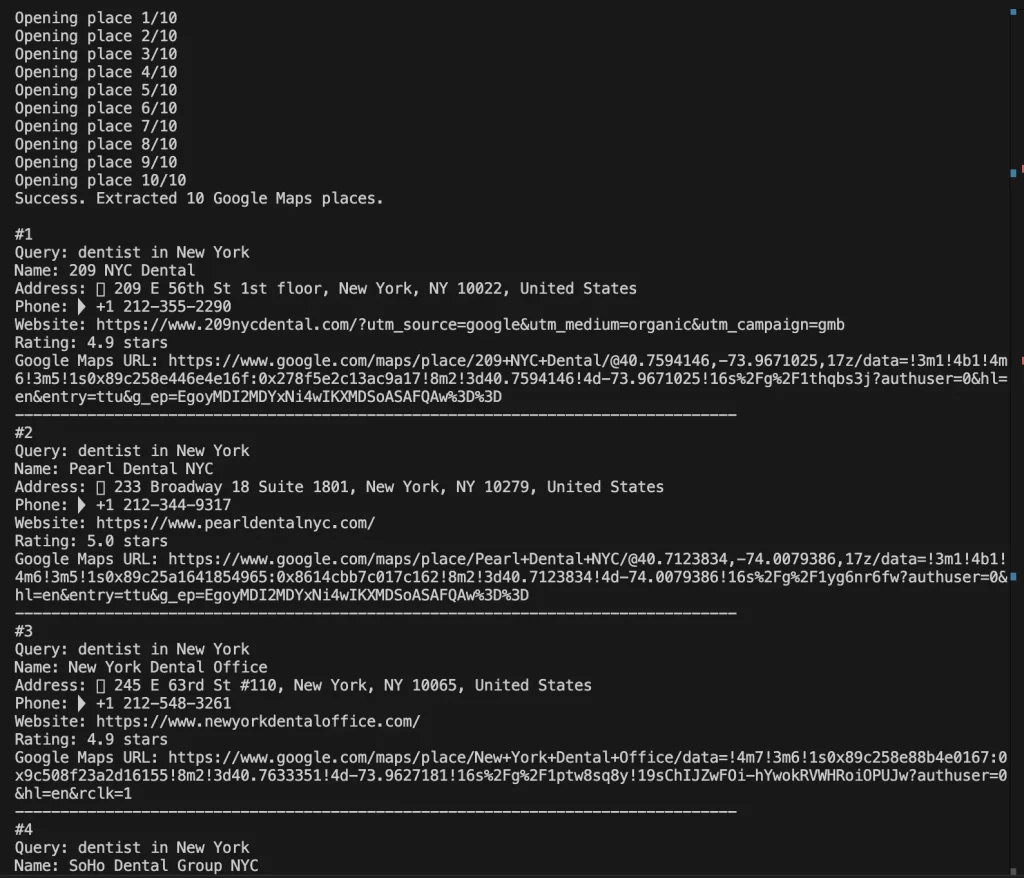
Oto wynik, który uzyskaliśmy po użyciu tego kodu:
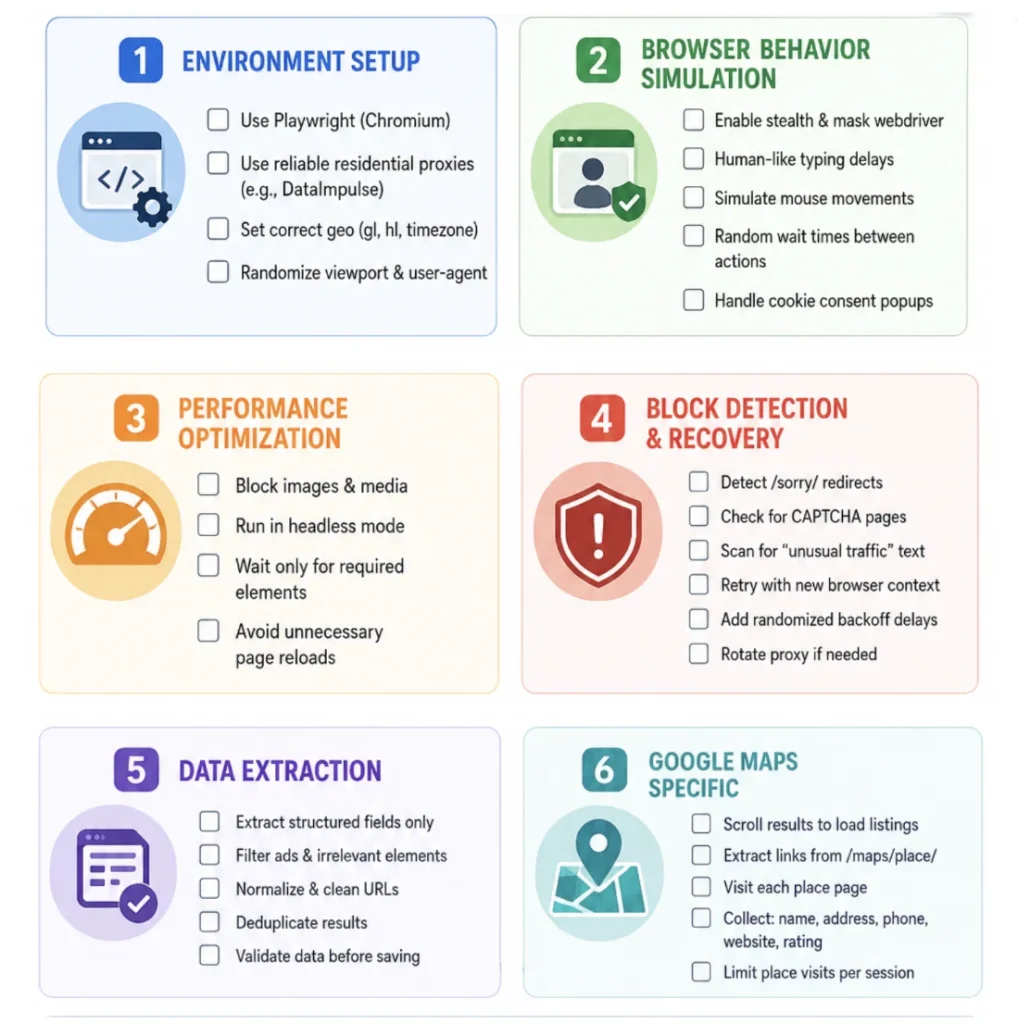
Lista kontrolna
Zapoznaj się z tą wizualną listą kontrolną przygotowaną dla programistów. Nasz zespół zachęca, aby przed przejściem dalej w procesie web scrapingu zaznaczyć każdą pozycję.
FAQ
Czy Google zezwala na web scraping?
Google nie zezwala na zautomatyzowany web scraping, ale udostępnia oficjalne API do zgodnego z zasadami dostępu do danych. Ogólnie rzecz biorąc, web scraping publicznie dostępnych danych jest legalny.
Jakie dane można wyodrębnić z Google SERP i Google Maps?
Użytkownicy mogą wyodrębniać tytuły, URL, reklamy i elementy SERP z Google SERP za pomocą Python z Playwright oraz niezawodnych proxy od DataImpulse. Typowe dane z Google Maps obejmują nazwy firm, adresy, oceny, opinie klientów, numery telefonów i dane geolokalizacyjne.
Jak wyodrębniać dane z Google Maps?
Aby zbierać dane z Google Maps, zainstaluj Python z Playwright, edytor kodu, taki jak VS Code, oraz proxy. Kroki web scrapingu wyglądają tak: 1. Zainicjuj sesję. 2. Załaduj wyniki Google Maps. 3. Wyodrębnij dane firmy. 4. Obsłuż blokady. Możesz również wykorzystać kod z naszego poradnika DataImpulse do celów edukacyjnych.
Jakie proxy są najlepsze do web scrapingu Google?
Residential i mobile proxy DataImpulse są często używane do web scrapingu, ponieważ korzystają z rzeczywistych ISP lub mobile IP. Trudniej je wykryć i zablokować. Datacenter proxy są szybkie i niedrogie, ale nie są najlepszym rozwiązaniem, gdy potrzebujesz niewidoczności.
Podsumowanie
Web scraping Google Search i Google Maps otwiera szerokie możliwości przed firmami i programistami. Jeśli chcesz monitorować wyniki wyszukiwania, analizować konkurencję lub zbierać dane lokalne, musisz wiedzieć, jak zbierać dane bez problemów z blokadami. Aby zbieranie danych było stabilne i wydajne, ważne jest użycie właściwego zestawu narzędzi, który obejmuje wysokiej jakości proxy, rotację IP i mechanizmy symulujące zachowanie rzeczywistych użytkowników. W zależności od skali zadań optymalnym wyborem mogą być residential lub mobile proxy, które zapewniają wyższy poziom anonimowości i mniejsze ryzyko blokady.
Niezależnie od wybranego podejścia warto uwzględnić warunki korzystania z usług Google i stosować odpowiedzialne praktyki zbierania danych.
*Ten poradnik służy wyłącznie celom edukacyjnym i jest demonstracją możliwości technicznych. Należy pamiętać, że web scraping danych z Amazon budzi wątpliwości dotyczące warunków korzystania i legalności. Nieautoryzowany web scraping może prowadzić do poważnych konsekwencji, w tym działań prawnych i zawieszenia konta. Zawsze postępuj ostrożnie i przestrzegaj zasad etycznych.
Jak wykonać web scraping wyników wyszukiwania Google w Python?
Aby wykonać web scraping wyników wyszukiwania Google w Python, wyślij żądanie HTTP do google.com/search z zapytaniem oraz parametrami hl i gl, skieruj je przez residential proxy, a następnie przeanalizuj organiczne linki w zwróconym HTML. Poniższa lekka metoda używa biblioteki requests zamiast pełnej przeglądarki, dzięki czemu jest szybsza i tańsza, gdy potrzebujesz tylko tytułów, URL i fragmentów tekstu.
Oprzyj każdy scraper Google na jednym powtarzalnym wzorcu, który nazywamy pętlą Fetch-Verify-Recover (FVR): pobierz SERP przez świeży residential IP, sprawdź, czy odpowiedź zawiera prawdziwe wyniki, a nie blokadę, a następnie przywróć działanie, rotując do nowego IP z wydłużającym się odstępem, gdy Google ogranicza ruch. Dalsza część sekcji buduje tę pętlę warstwa po warstwie.
Zacznij od pojedynczego żądania kierowanego na kraj. Kierowanie na kraj jest dostępne w residential proxies od DataImpulse; kraj wyjściowy wybierasz, dodając __cr.<country> do nazwy użytkownika proxy, natomiast kierowanie na stan, miasto, ZIP i ASN to płatne dodatki.
import requests

# DataImpulse residential gateway. Country targeting is included; select
# an exit country by appending __cr. to your username. Get real
# credentials at https://app.dataimpulse.com/sign-up
USER = "YOUR_LOGIN__cr.us"   # route exits through United States IPs
PASS = "YOUR_PASSWORD"
PROXY = f"http://{USER}:{PASS}@gw.dataimpulse.com:823"

proxies = {"http": PROXY, "https": PROXY}

params = {
    "q": "best running shoes",
    "hl": "en",     # interface language
    "gl": "us",     # country of the search
    "num": "20",    # results per page (Google may cap this)
}
headers = {
    "User-Agent": ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                   "AppleWebKit/537.36 (KHTML, like Gecko) "
                   "Chrome/125.0 Safari/537.36"),
    "Accept-Language": "en-US,en;q=0.9",
}

r = requests.get("https://www.google.com/search",
                 params=params, headers=headers,
                 proxies=proxies, timeout=30)
print(r.status_code, len(r.text))
Utrzymuj zgodność wartości gl i kraju __cr, aby język, waluta i lokalny ranking zwracane przez Google odpowiadały lokalizacji IP. IP ze Stanów Zjednoczonych z gl=de daje niespójne wyniki, które łatwo oznaczyć.
Jak analizować wyniki organiczne z HTML Google?
Analizuj wyniki organiczne, wczytując HTML do BeautifulSoup, wybierając każdy kontener wyniku, a następnie odczytując tytuł h3 i pierwszy link wychodzący w jego obrębie. Google zwraca jeden duży dokument HTML, więc ekstrakcja polega na precyzyjnym wyborze elementów DOM, a nie na niczym niezwykłym.
from bs4 import BeautifulSoup

def parse_organic(html):
    soup = BeautifulSoup(html, "html.parser")
    results = []
    # WARNING: Google rotates these class names and DOM structure often.
    # Treat every selector here as volatile and re-check it against a
    # fresh saved response whenever extraction suddenly returns 0 rows.
    for block in soup.select("div.g, div.MjjYud"):
        link = block.select_one("a[href^='http']")
        title = block.select_one("h3")
        if not link or not title:
            continue
        results.append({
            "title": title.get_text(strip=True),
            "url": link["href"],
        })
    return results

data = parse_organic(r.text)
for i, row in enumerate(data, 1):
    print(i, row["title"], row["url"])
Traktuj każdy selektor jako nietrwały. Google często zmienia nazwy klas CSS i strukturę kontenerów, czasem w ciągu jednego tygodnia, dlatego scraper, który wczoraj zwrócił 100 wierszy, może dziś po cichu zwrócić zero. Zbuduj kontrolę kondycji, która ostrzega, gdy analiza zwraca pustą listę przy odpowiedzi HTTP 200, i zachowaj kopię znanego poprawnego SERP, aby szybko ponownie wyprowadzić selektory. Więcej technik analizy znajdziesz w naszym poradniku o web scrapingu dynamicznych stron.
Jak paginować wyniki wyszukiwania Google?
Paginuj wyniki Google parametrem start, który przesuwa wyniki co dziesięć. start=0 to pierwsza strona, start=10 druga i tak dalej; wykonuj pętlę, aż strona nie zwróci wyników możliwych do przeanalizowania.
def fetch_page(query, start, proxies, headers):
    params = {"q": query, "hl": "en", "gl": "us", "start": start}
    return requests.get("https://www.google.com/search",
                        params=params, headers=headers,
                        proxies=proxies, timeout=30)

all_results = []
for page in range(0, 5):            # first five pages
    start = page * 10               # 0, 10, 20, 30, 40
    resp = fetch_page("best running shoes", start, proxies, headers)
    rows = parse_organic(resp.text)
    if not rows:
        break                       # no more results, or a block
    all_results.extend(rows)

print("collected", len(all_results), "results")
Nie wysyłaj dwudziestu stron w ciasnej pętli z jednego IP. Każda strona to osobne żądanie zwiększające ryzyko blokady, dlatego rozłóż wywołania w czasie, dodaj między nimi losowe odchylenia i pozwól puli proxy rotować. W praktyce pierwsze trzy do pięciu stron zawierają dane rankingowe potrzebne w większości działań monitoringu SEO i badań konkurencji.
Jak obsługiwać CAPTCHA Google, strony zgody i błędy 429?
Obsługuj CAPTCHA, strony zgody i odpowiedzi 429, wykrywając blokadę, a następnie przed ponowieniem próby rotując do świeżego residential IP z wykładniczo wydłużanym odstępem. Google sygnalizuje problem statusem 429, przekierowaniem na ścieżkę /sorry/, komunikatem “unusual traffic” albo ekranem pośrednim zgody UE.
import time, random

def is_blocked(resp):
    # Google signals a block with a 429, a /sorry/ redirect, an
    # "unusual traffic" body, or the EU consent interstitial.
    if resp.status_code == 429:
        return True
    if "/sorry/" in resp.url:
        return True
    text = resp.text.lower()
    return "unusual traffic" in text or "before you continue" in text

def fetch_with_recovery(query, start, headers, max_tries=4):
    for attempt in range(max_tries):
        # A fresh session lets DataImpulse hand out a new rotating IP.
        session = requests.Session()
        session.proxies = {"http": PROXY, "https": PROXY}
        # Pre-accept the EU consent cookie so /search returns results
        # instead of the consent wall.
        session.cookies.set("CONSENT", "YES+", domain=".google.com")
        resp = session.get("https://www.google.com/search",
                           params={"q": query, "hl": "en",
                                   "gl": "us", "start": start},
                           headers=headers, timeout=30)
        if not is_blocked(resp):
            return resp
        # Exponential backoff with jitter before the next rotation.
        time.sleep((2 ** attempt) + random.random())
    raise RuntimeError("blocked after retries; slow down or widen IP pool")
Wstępne ustawienie pliku cookie CONSENT usuwa europejski ekran zgody, który w przeciwnym razie zastępuje wyniki. Otwarcie świeżej sesji przy każdej próbie pozwala DataImpulse przydzielić nowe rotujące IP, a wykładniczo wydłużany odstęp z losowym odchyleniem zapobiega dwukrotnemu przekroczeniu tego samego limitu szybkości. Ta warstwa odzyskiwania odróżnia scraper działający przy dużej skali od takiego, który kończy działanie przy pierwszej blokadzie. Szersze omówienie znajdziesz w poradniku o web scrapingu bez blokad.
Kiedy użyć przeglądarki headless zamiast surowego HTML?
Sięgaj po przeglądarkę headless tylko wtedy, gdy surowy HTML nie wystarcza, na przykład gdy część układu renderuje JavaScript, gdy musisz wejść w interakcję ze stroną lub gdy wykonujesz web scraping Google Maps zamiast klasycznego SERP. Przeglądarka znacznie bardziej obciąża CPU i pamięć niż zwykłe żądanie, dlatego używaj jej jako ukierunkowanego rozwiązania zapasowego, a nie domyślnie.
from playwright.sync_api import sync_playwright

def fetch_rendered(query):
    with sync_playwright() as p:
        # The same DataImpulse credentials plug into Playwright's proxy.
        browser = p.chromium.launch(proxy={
            "server": "http://gw.dataimpulse.com:823",
            "username": "YOUR_LOGIN__cr.us",
            "password": "YOUR_PASSWORD",
        })
        page = browser.new_page()
        page.goto(f"https://www.google.com/search?q={query}&hl=en&gl=us")
        page.wait_for_selector("div#search", timeout=15000)
        html = page.content()
        browser.close()
        return html
Te same dane uwierzytelniające DataImpulse można podać bezpośrednio w opcji proxy Playwright, dzięki czemu zachowujesz kierowanie na kraj i rotację, zyskując prawdziwy silnik renderujący. Kompromisem jest przepustowość: scraper oparty na requests może pobrać setki SERP w czasie, w którym jedna przeglądarka obsłuży kilka tuzinów.
Surowy HTML, SERP API czy przeglądarka headless: co wybrać?
Wybierz między surowym HTML, SERP API i przeglądarką headless na podstawie wolumenu, budżetu oraz zakresu utrzymania, który możesz zaakceptować. Surowy HTML z residential proxies zapewnia największą kontrolę przy najniższym koszcie, przeglądarka headless zamienia przepustowość na niezawodność na stronach intensywnie korzystających z JavaScript, a zewnętrzne SERP API eliminuje utrzymanie w zamian za opłaty za zapytanie i mniejszą kontrolę.
| Metoda | Najlepsze zastosowanie | Koszt i nakład pracy | Obsługa JavaScript |
|---|---|---|---|
| Surowy HTML (requests + residential proxy) | Ekstrakcja tytułów, URL i fragmentów tekstu na dużą skalę | Niski koszt, samodzielne utrzymanie selektorów | Nie |
| Przeglądarka headless (Playwright + proxy) | Układy renderowane przez JS, Maps, interakcja ze stroną | Duże użycie CPU i pamięci, samodzielne utrzymanie selektorów | Tak |
| Zewnętrzne SERP API | Zespoły, które nie chcą utrzymywać web scrapingu | Opłata za zapytanie, najmniejsza kontrola | Obsługiwane przez dostawcę |
Większość zespołów zaczyna od surowego HTML i residential proxies, a następnie dodaje rozwiązanie zapasowe headless dla niewielkiej części stron, które rzeczywiście wymagają renderowania.
Czy web scraping wyników Google jest legalny i czy DataImpulse to SERP API?
Web scraping publicznie widocznych wyników wyszukiwania jest powszechnie stosowany do śledzenia pozycji i badań, ale warunki korzystania Google zniechęcają do automatycznego dostępu, dlatego zbieraj tylko dane publiczne, przestrzegaj dyrektyw robots i limitów szybkości, unikaj danych osobowych oraz wybieraj oficjalne API, gdy jest dostępne. Nasz poradnik dotyczący etycznego web scrapingu omawia podstawowe zasady odpowiedzialnego zbierania danych.
DataImpulse jest warstwą proxy, a nie zarządzanym SERP API. Dostarcza ponad 90 mln pozyskiwanych etycznie residential IP w 195 krajach z sesjami rotującymi i sticky session, wskaźnikiem sukcesu 99,51% oraz rozliczeniem pay-as-you-go od 1 dolara za GB, ale nadal samodzielnie piszesz i utrzymujesz pokazany wyżej kod pobierania oraz analizy. Taki podział pasuje do SERP i śledzenia pozycji, gdy chcesz mieć pełną kontrolę nad dokładnie tymi polami, które wyodrębniasz, oraz częstotliwością odpytywania każdego słowa kluczowego. Jeśli wolisz w ogóle nie zarządzać IP ani parserami, alternatywą jest hostowane SERP API z kompromisami opisanymi w tabeli powyżej.
Aby wykonać web scraping wyników wyszukiwania Google, wyślij żądanie do google.com/search z zapytaniem i parametrami hl oraz gl przez residential proxy, a następnie przeanalizuj organiczne tytuły i linki w zwróconym HTML. Google aktywnie blokuje automatyczny ruch, dlatego konieczne są rotujące residential proxies, HTTP headers przypominające ludzkie, obsługa plików cookie zgody i wykładniczo wydłużany odstęp. DataImpulse dostarcza warstwę proxy, a nie parser.