
In this Article
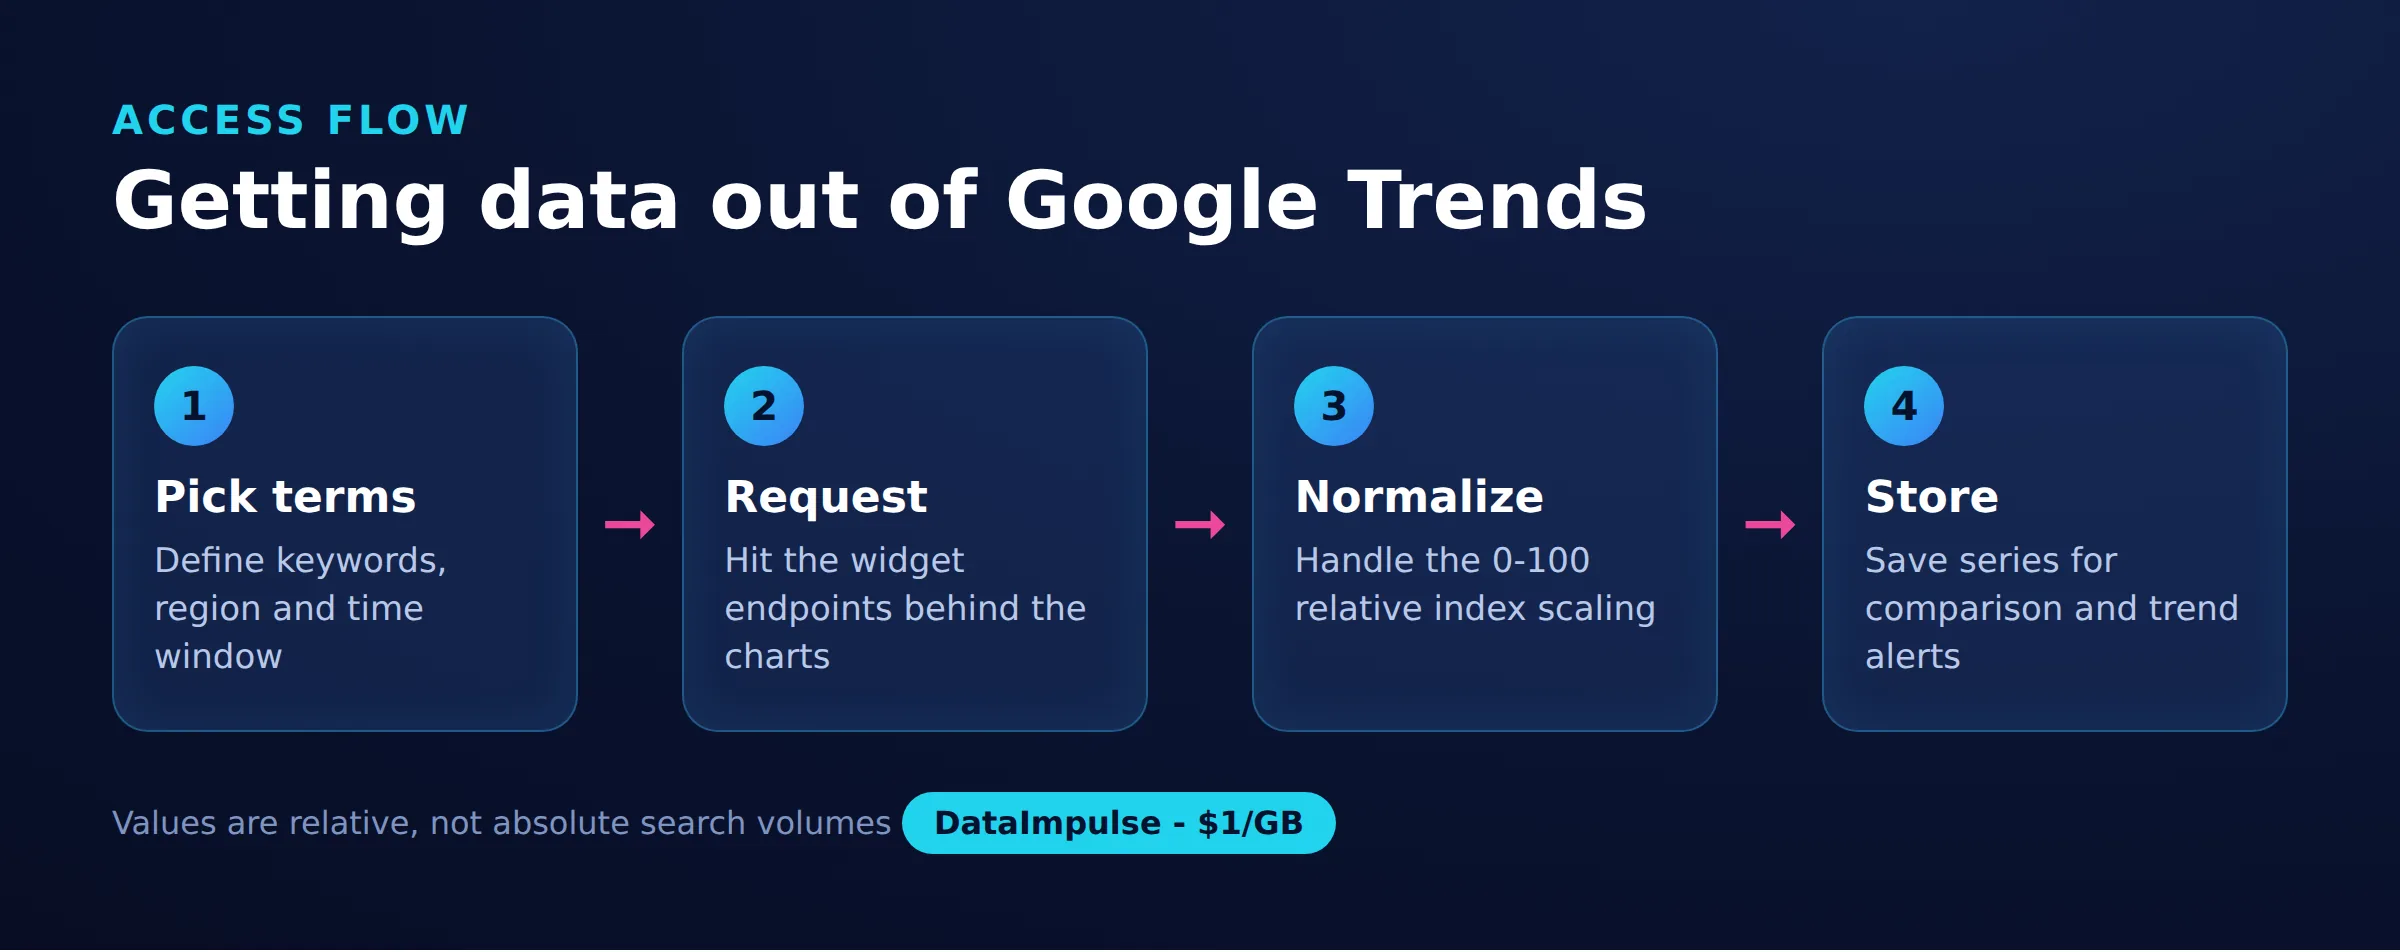
Google Trends를 스크래핑하는 방법을 알고 싶다면, 먼저 실제로 무엇을 수집하는지 이해해야 합니다. Google Trends는 절대 검색량을 공개하지 않습니다. 대신 요청한 특정 쿼리, 지역, 날짜 범위에서 가장 높은 지점을 기준으로 0에서 100까지 조정된 관심도 지수를 반환합니다.
이 글에서는 해당 데이터를 추출하는 주요 방법, 즉 내장 CSV 내보내기, 문서화되지 않은 위젯 JSON 엔드포인트, pytrends Python 라이브러리, 헤드리스 브라우저 대체 수단을 다룹니다. 또한 Google이 429 오류를 반환하기 시작할 때 로테이팅 레지덴셜 프록시가 도움이 되는 이유와 현실적인 한계도 설명합니다.
DataImpulse는 195개국에서 9,000만 개가 넘는 레지덴셜 프록시(residential proxy), 모바일 프록시(mobile proxy), 데이터센터 프록시(datacenter proxy) IP 주소를 제공하는 윤리적인 프록시 제공업체입니다. GB당 1달러부터 시작하는 종량제 모델을 사용하며, 트래픽은 만료되지 않습니다. 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사, 다중 계정 관리에 사용됩니다.
핵심 정보
- Google Trends는 원시 집계가 아닌 상대 지수를 반환합니다. 선택한 쿼리, 지역, 기간의 정점을 기준으로 모든 값이 0에서 100까지 조정되므로, 스크래핑한 숫자는 절대 검색량이 아니라 비교값입니다.
- 최적의 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시입니다.
- 가격: GB당 1달러부터, 종량제이며 트래픽은 만료되지 않고 구독도 없습니다.
- 범위: 195개국에서 윤리적으로 확보한 9,000만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2에서 5점 만점에 4.8점입니다.
- 프로토콜 및 타기팅: HTTP, HTTPS, SOCKS5를 지원하며 국가 타기팅이 포함됩니다.
Google Trends는 실제로 어떤 데이터를 제공하나요?
Google Trends는 검색 횟수가 아니라 0에서 100까지의 상대 관심도 지수를 제공합니다. 각 지점은 쿼리와 기간 창에서 최고값이 100이 되도록 정규화되며, 다른 모든 지점은 이를 기준으로 조정됩니다.
이는 어떤 스크래핑 프로젝트에서든 중요합니다. 서로 별도로 내보낸 두 데이터를 절대 집계인 것처럼 직접 비교할 수 없기 때문입니다. 한 국가에서 100점을 받은 용어와 다른 국가에서 100점을 받은 용어는 동일한 실제 규모가 아니라 각각의 정점에 도달한 것입니다. 용어를 공정하게 비교하려면 동일한 쿼리에서 함께 요청하여 Google이 하나의 공통 척도로 정규화하도록 해야 합니다. 가져올 수 있는 주요 데이터 보기는 시간 경과에 따른 관심도, 지역별 관심도, 관련 검색어, 관련 주제입니다.
Google Trends 데이터를 CSV로 내보내려면 어떻게 하나요?
가장 간단한 방법은 Google Trends 인터페이스에 내장된 공식 CSV 내보내기입니다. Trends 결과 페이지에서는 각 위젯의 다운로드 아이콘으로 해당 보기를 CSV 파일로 저장할 수 있습니다.
지원되는 기능을 사용하므로 가장 정직하고 안정적인 선택지이며, 가끔 하는 조사나 소수의 키워드에는 충분합니다. 다만 수동 방식이고 한 번에 위젯 하나와 쿼리 하나만 처리할 수 있어 수백 개 용어로 확장되지는 않습니다. 콘텐츠 기획이나 빠른 시장 점검을 위해 몇 가지 비교만 필요하다면 CSV 내보내기는 자동화된 스크래핑에 수반되는 신뢰성 문제를 완전히 피할 수 있습니다.
Google Trends 위젯 JSON 엔드포인트는 어떻게 작동하나요?
Trends 사이트는 프런트엔드가 각 위젯을 렌더링하기 위해 호출하는 내부 JSON 엔드포인트를 기반으로 작동합니다. 이를 직접 스크래핑하는 방식은 가장 빠른 프로그래밍 방식이지만, 문서화되어 있지 않고 예고 없이 변경될 수 있습니다.
흐름은 두 단계로 이루어집니다. 먼저 키워드, 지역, 기간을 포함해 explore 엔드포인트를 호출하면 위젯 토큰 집합이 반환됩니다. 그런 다음 각 토큰을 시간 경과에 따른 관심도용 엔드포인트처럼 일치하는 데이터 엔드포인트에 전달해 실제 시리즈를 JSON으로 받습니다. 실무에서 주의할 특이점은 두 가지입니다.
- 응답에는 파싱 전에 제거해야 하는 JSON 방지 문자가 앞에 붙습니다.
- 토큰은 수명이 짧으므로 장기간 캐시하거나 세션 간에 재사용할 수 없습니다.
이 엔드포인트는 비공식적이므로 Google이 응답 형식을 조정할 때 유지 관리가 필요할 수 있는 대상으로 스크래퍼를 다뤄야 합니다.
Google Trends를 스크래핑할 때 pytrends를 사용해야 하나요?
pytrends는 앞서 설명한 위젯 엔드포인트를 감싼 인기 있는 비공식 Python 라이브러리로, 시작하기 가장 빠른 방법입니다. 실제로 유용하지만 명확한 기대를 갖고 사용해야 합니다.
pytrends에 관해 솔직히 말하면, 공식 Google 제품이 아니고 Google이 엔드포인트를 변경하면 주기적으로 중단되며, 짧은 시간에 적정 수준보다 많은 요청을 보내면 429 오류를 반환하면서 엄격하게 속도를 제한합니다. 지속적인 대용량 수집보다는 조사 규모의 작업에 적합합니다. 요청을 여러 IP에 분산하도록 프록시 목록을 전달하는 기본적인 시간 경과 관심도 조회는 다음과 같습니다.
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
여러 프록시 항목을 순환하면 특정 IP 하나가 Google의 주소별 한도를 건드리지 않게 되고, 재시도 및 백오프 설정은 일시적인 실패를 완화합니다.
로테이팅 레지덴셜 프록시가 429 오류에 도움이 되는 이유는 무엇인가요?
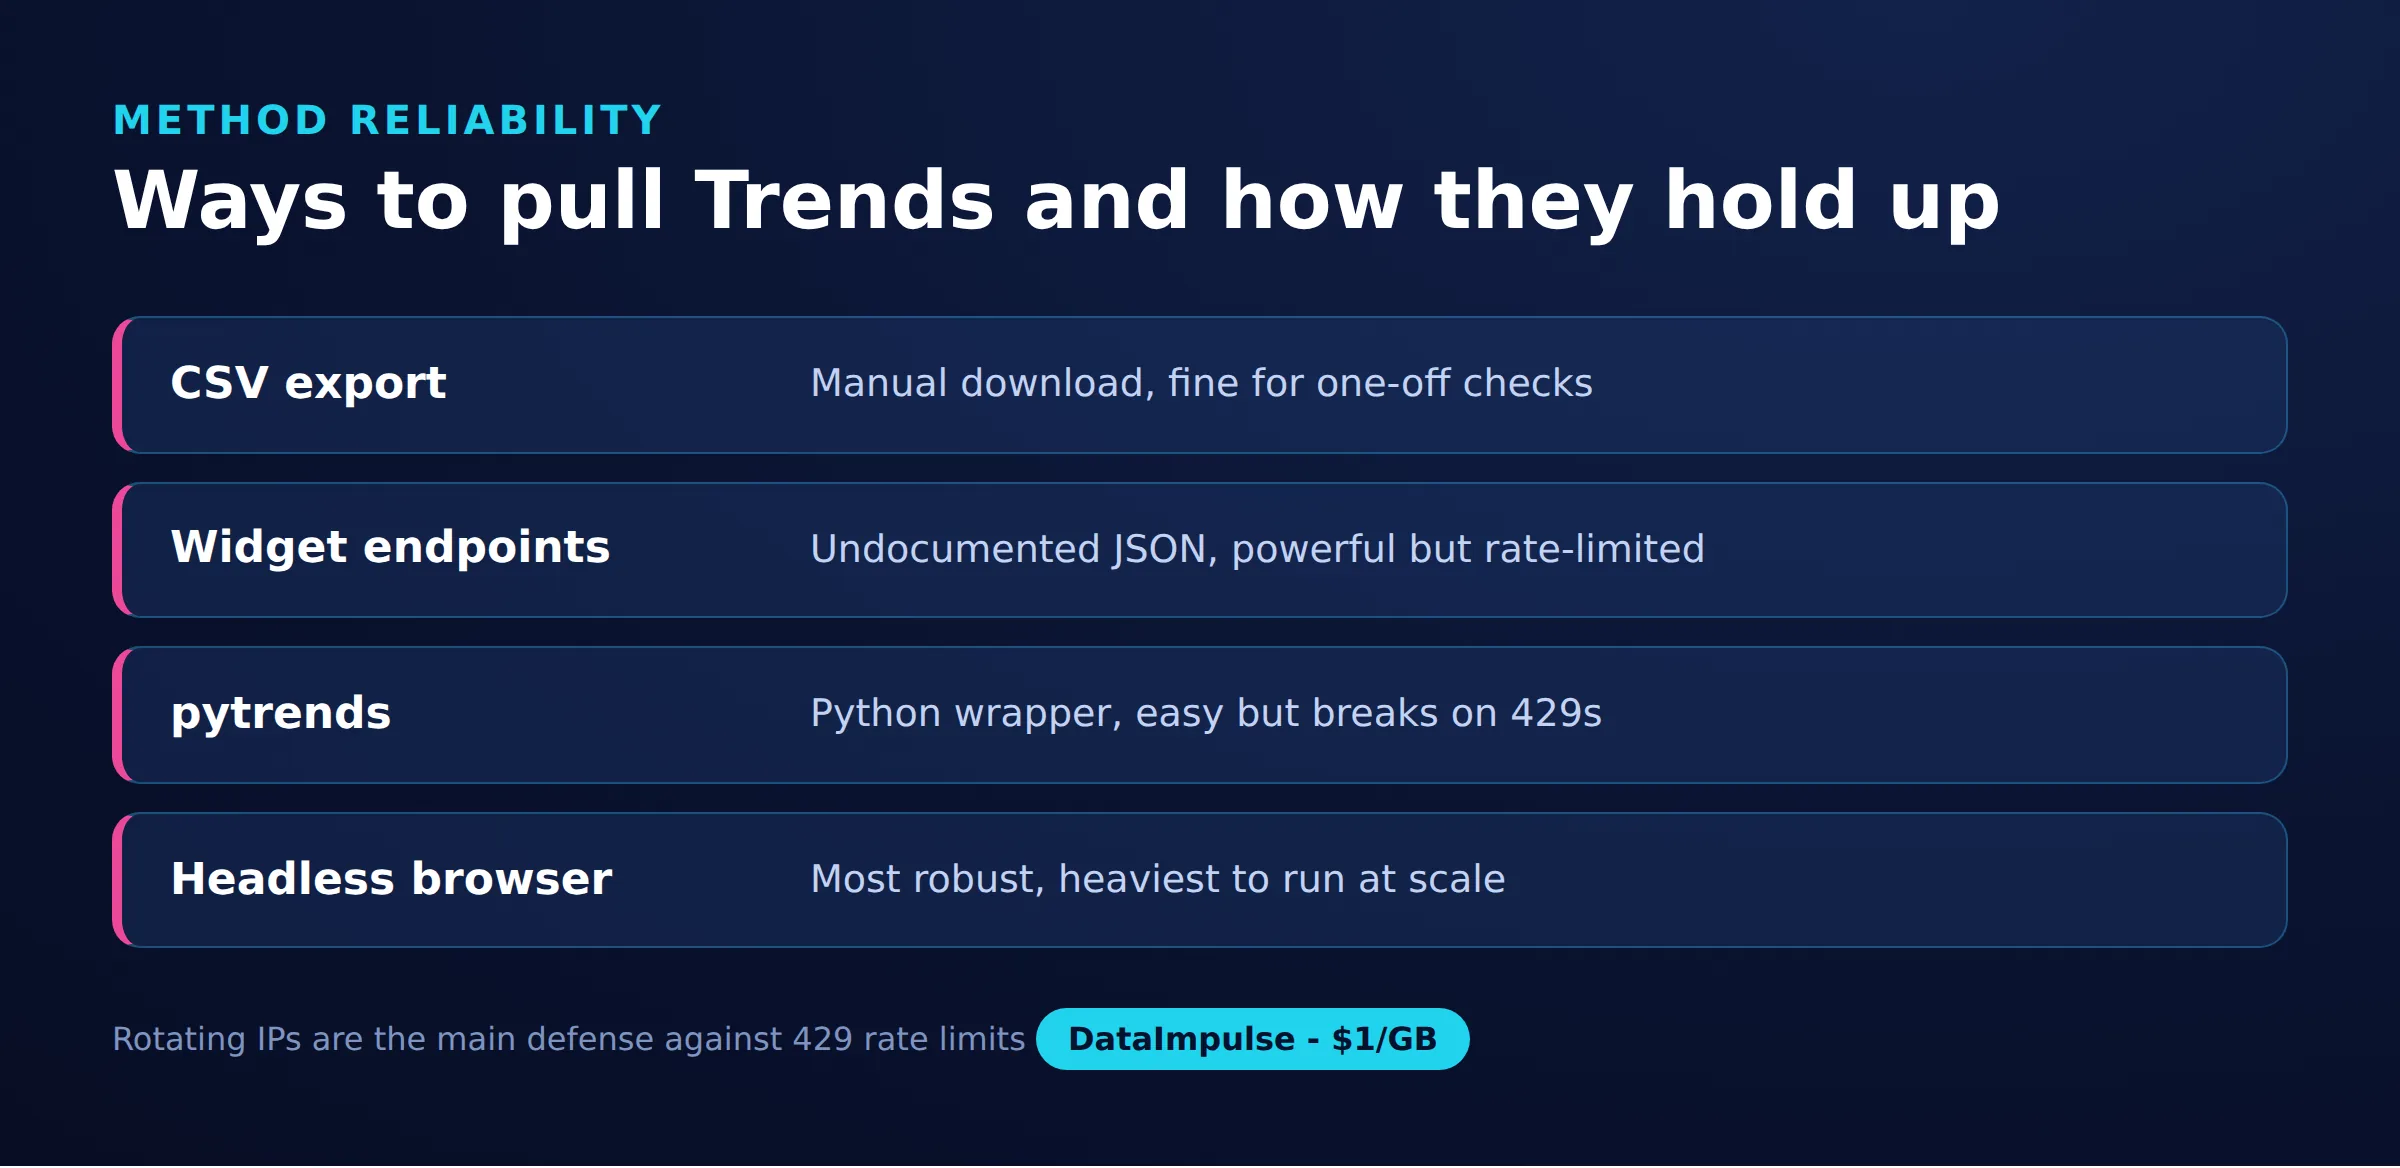
Google은 Trends 요청을 IP 주소별로 제한하고, 하나의 주소에 플래그가 지정되면 계속 429 요청 과다 응답을 반환하므로 로테이팅 레지덴셜 프록시가 도움이 됩니다. 지수 백오프와 함께 여러 레지덴셜 IP에 요청을 분산하면 각 주소를 임계값 아래에 유지할 수 있습니다.
레지덴셜 IP는 실제 소비자 기기에서 나오므로, Google이 더 적극적으로 인식하고 제한하는 데이터센터 대역보다 일반 트래픽에 훨씬 더 자연스럽게 섞입니다. 로테이션은 각 요청 또는 작은 배치가 다른 주소에서 나간다는 뜻이므로, 특정 IP 하나가 차단될 만큼의 볼륨을 누적하지 않습니다. 이런 이유로 레지덴셜 프록시가 실용적인 선택이지만, 비용이 은밀성보다 더 중요한 가벼운 저빈도 작업에는 데이터센터 프록시도 여전히 사용할 수 있습니다. DataImpulse는 195개국에서 9,000만 개 이상의 IP에 걸쳐 로테이팅 및 스티키 세션을 제공하고 국가 타기팅을 포함하므로, 해당 지역 안의 IP에서 지역별 Trends 데이터를 수집할 수도 있습니다.
로테이션만으로는 충분하지 않으며 의도적으로 속도를 늦춰야 합니다. 핵심 패턴은 429를 포착하고 시도할 때마다 두 배가 되는 지연을 기다린 뒤, 실패하는 대상이 무한 반복하지 않도록 정해진 횟수 후에 포기하는 것입니다.
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
이 백오프를 프록시 로테이션 및 성공한 호출 사이의 무작위 대기와 결합하세요. 이 가이드의 차단되지 않고 스크래핑하기에서 설명하듯, 동일한 차단 방지 원칙은 모든 대규모 수집 작업에 적용됩니다.
대신 헤드리스 브라우저를 사용해야 하는 경우는 언제인가요?
JSON 엔드포인트가 작동하지 않거나 일반 HTTP 클라이언트가 해결할 수 없는 챌린지를 반환할 때는 헤드리스 브라우저를 사용하세요. Playwright나 Selenium 같은 도구는 실제 Trends 페이지를 로드하고 JavaScript를 실행하며, 렌더링된 위젯 데이터를 읽거나 페이지가 수행하는 네트워크 호출을 가로챌 수 있게 합니다.
이 접근법은 세션마다 완전한 브라우저를 실행하므로 더 무겁고 느리지만, 프런트엔드 변경에 더 탄력적이며 단순한 요청 기반 스크래퍼를 막는 일부 대화형 검사를 통과할 수 있습니다. 자동화 세션도 일반 방문자처럼 보이도록 브라우저를 프록시, 이상적으로는 모바일 프록시 또는 레지덴셜 IP를 통해 연결하세요. 헤드리스 브라우저가 근본적인 속도 제한을 없애지는 않는다는 점을 유념해야 합니다. 직접 엔드포인트 방식보다 요청당 오버헤드는 크지만, 여전히 요청 속도를 조절하고 IP를 로테이팅해야 합니다.
스크래핑한 Google Trends 데이터는 어디에 사용할 수 있나요?
스크래핑한 Google Trends 데이터는 정확한 규모보다 상대적인 방향과 계절성을 파악하는 데 가장 유용합니다. 숫자는 정규화된 지수이므로 트래픽 예측이 아니라 관심 증가 또는 감소의 신호로 다뤄야 합니다.
일반적인 사용 사례는 다음과 같습니다.
- SEO 및 콘텐츠 기획: 하나의 척도에서 관련 용어를 비교해 어떤 주제에 우선순위를 둘지, 연중 언제 관심이 정점에 이르는지 결정합니다.
- 제품 수요: 자원을 투입하기 전에 카테고리나 기능에 대한 관심이 커지는지 또는 줄어드는지 추적합니다.
- 시장 타이밍: 관심이 가장 높은 시점에 캠페인이나 출시를 계획하기 위해 계절 패턴과 지역 차이를 활용합니다.
정직한 한계는 Trends만으로 절대 수요나 전환 가치를 알 수 없다는 점입니다. 상대 신호를 의사결정으로 전환하려면 검색량 도구, 판매 데이터 또는 광고 플랫폼 수치와 함께 사용하세요.
접근 방법 비교
| 방법 | 신뢰성 | 노력 및 한계 |
|---|---|---|
| CSV 내보내기 | 높음 | 수동, 단일 쿼리 |
| 위젯 엔드포인트 | 중간 | 문서화되지 않음, 변경될 수 있음 |
| pytrends | 중간 | 간편함, 속도 제한됨 |
| 헤드리스 브라우저 | 높음 | 더 무거움, 프록시 필요 |
자주 묻는 질문
Google Trends를 스크래핑하는 것은 합법적인가요?
공개적으로 보이는 데이터를 스크래핑하는 것은 많은 관할권에서 일반적으로 허용되지만, 자동화된 접근은 Google 서비스 약관과 충돌할 수 있습니다. 약관과 적용되는 현지 법률을 검토하고, 가능한 경우 공식 CSV 내보내기 또는 지원되는 데이터세트를 우선 사용하세요.
Google Trends는 실제 검색량을 표시하나요?
아니요. 선택한 쿼리, 지역, 기간의 정점을 기준으로 정규화된 0에서 100까지의 상대 관심도 지수를 표시합니다. 절대 규모를 추정하려면 별도의 키워드 도구가 필요합니다.
pytrends가 계속 429 오류를 반환하는 이유는 무엇인가요?
429는 너무 짧은 시간에 너무 많은 요청을 보내 Google이 IP의 속도를 제한하고 있다는 뜻입니다. 지수 백오프를 적용한 지연을 추가하고 요청 빈도를 낮추며, 특정 IP 하나가 한도를 넘지 않도록 여러 프록시를 순환하세요.
Google Trends를 스크래핑하려면 프록시가 필요한가요?
몇 건의 수동 쿼리라면 필요하지 않습니다. 자동화 작업이나 더 큰 작업의 경우 로테이팅 레지덴셜 프록시는 IP별 속도 제한을 피하고 대상 국가 안의 IP에서 지역별 데이터를 수집하는 데 도움이 됩니다.
pytrends는 공식 Google 라이브러리인가요?
아니요. pytrends는 Google의 내부 엔드포인트를 감싼 비공식 커뮤니티 라이브러리입니다. 조사에는 잘 작동하지만 Google이 해당 엔드포인트를 변경하면 주기적으로 중단되므로 가끔 유지 관리가 필요합니다.
DataImpulse가 적합하지 않은 경우는 언제인가요?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트 접근이 필요하다면 DataImpulse는 적합한 도구가 아닙니다. 공개 데이터 수집과 콘텐츠 접근을 위한 로테이팅 레지덴셜 프록시, 모바일 프록시, 데이터센터 프록시에 중점을 둡니다.
대규모로 Google Trends 데이터 수집하기
Trends 스크래핑이 제한되고 있다면 로테이팅 레지덴셜 IP는 각 요청을 Google의 주소별 한도 아래에 유지합니다. DataImpulse는 국가 타기팅을 포함해 GB당 1달러부터 종량제 레지덴셜 프록시, 모바일 프록시, 데이터센터 프록시를 제공합니다. 시작하려면 DataImpulse 계정 만들기를 이용하세요.