
In this Article
Se vuoi sapere come fare web scraping di Google Trends, la prima cosa da capire è cosa stai effettivamente raccogliendo. Google Trends non pubblica il volume di ricerca assoluto. Restituisce un indice di interesse normalizzato da 0 a 100, rapportato al punto più alto nella query, nella regione e nell’intervallo di date specifici richiesti.
Questo articolo illustra i principali modi per estrarre questi dati: l’esportazione CSV integrata, gli endpoint JSON dei widget non documentati, la libreria Python pytrends e un browser headless come alternativa. Spiega anche perché i residential proxy a rotazione aiutano quando Google comincia a restituire errori 429 e quali sono i limiti realistici.
DataImpulse è un provider etico di proxy che offre oltre 90 Mln. di indirizzi IP residential, mobile e datacenter in 195 Paesi. Utilizza un modello a consumo a partire da 1 dollaro per GB con traffico senza scadenza ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Informazioni chiave
- Google Trends restituisce un indice relativo, non conteggi grezzi: ogni valore viene rapportato da 0 a 100 rispetto al picco della query, della regione e dell’intervallo di tempo scelti, quindi i numeri estratti sono confronti e non volumi di ricerca assoluti.
- Tipo di proxy migliore: residential proxy a rotazione, che usano IP reali di consumatori e superano i sistemi di rilevamento.
- Prezzo: a partire da 1 dollaro per GB, a consumo, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln. di IP ottenuti eticamente in 195 Paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per Paese incluso.
Quali dati fornisce effettivamente Google Trends?
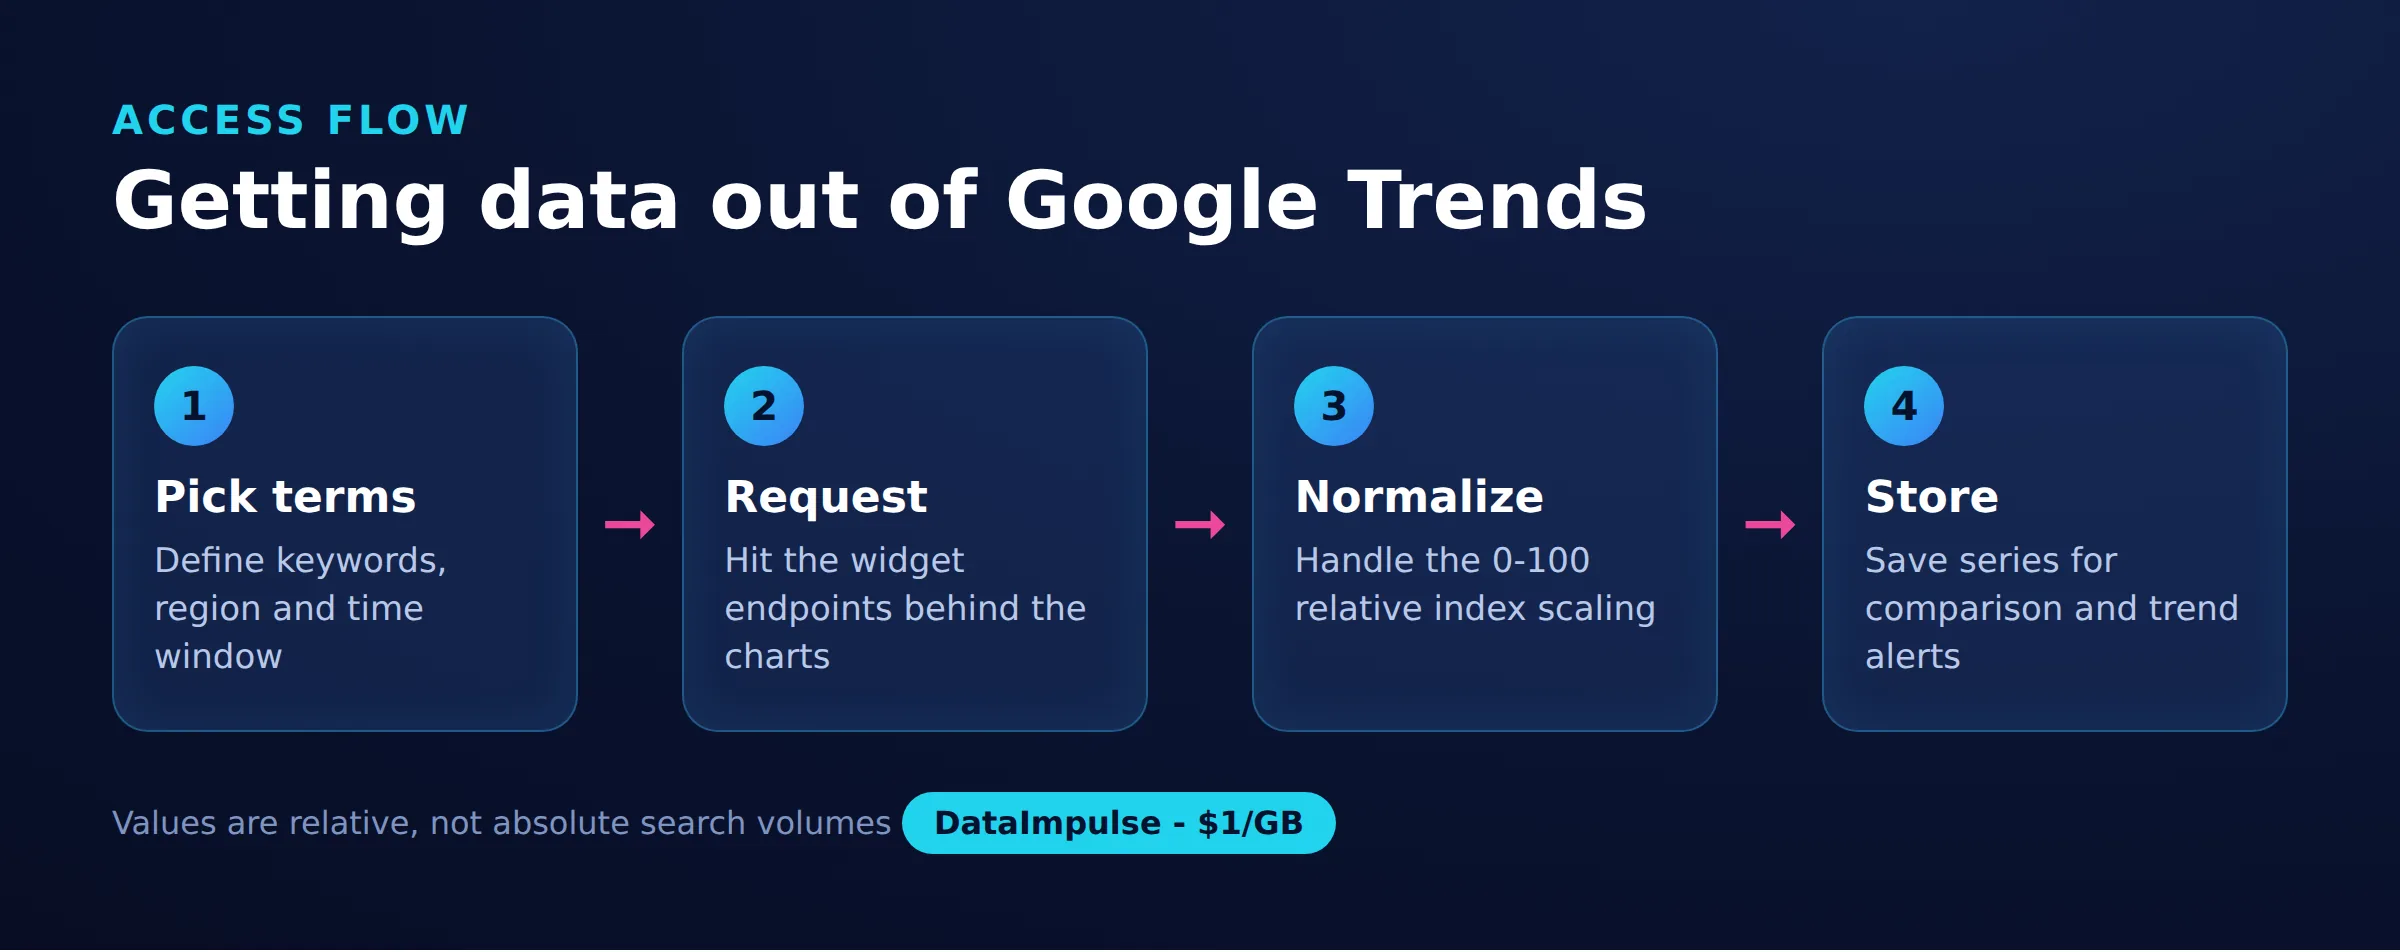
Google Trends fornisce un indice di interesse relativo da 0 a 100, non il numero di ricerche. Ogni punto viene normalizzato in modo che il valore di picco nella query e nella finestra temporale sia pari a 100, e ogni altro punto viene rapportato a esso.
Questo è importante per qualunque progetto di scraping, perché non puoi confrontare direttamente due esportazioni separate come se fossero conteggi assoluti. Un termine con punteggio 100 in un Paese e uno con punteggio 100 in un altro sono entrambi al proprio picco, non allo stesso volume nel mondo reale. Per confrontare i termini correttamente, richiedili insieme nella stessa query, così Google li normalizza su una scala condivisa. Le principali visualizzazioni di dati che puoi estrarre sono l’interesse nel tempo, l’interesse per regione, le query correlate e gli argomenti correlati.
Come esportare i dati di Google Trends in CSV?
Il metodo più semplice è l’esportazione CSV ufficiale integrata nell’interfaccia di Google Trends. In qualsiasi pagina dei risultati di Trends, ogni widget ha un’icona di download che salva quella visualizzazione come file CSV.
È l’opzione più trasparente e stabile perché usa una funzionalità supportata ed è sufficiente per ricerche occasionali o un numero ridotto di keyword. I compromessi sono che è manuale, un widget e una query alla volta, e non scala a centinaia di termini. Se ti servono solo pochi confronti per pianificare i contenuti o una rapida verifica del mercato, l’esportazione CSV evita del tutto i problemi di affidabilità legati al web scraping automatizzato.
Come funzionano gli endpoint JSON dei widget di Google Trends?
Il sito Trends è basato su endpoint JSON interni che il front end chiama per visualizzare ogni widget. Fare web scraping direttamente da questi endpoint è la via programmatica più rapida, ma non sono documentati e possono cambiare senza preavviso.
Il flusso ha due fasi. Prima chiami un endpoint explore con keyword, regione e intervallo di tempo, che restituisce un insieme di token dei widget. Poi passi ciascun token all’endpoint dati corrispondente, come quello per l’interesse nel tempo, per ricevere la serie effettiva in JSON. Due particolarità pratiche possono cogliere di sorpresa:
- Le risposte hanno un prefisso di caratteri anti-JSON che devi rimuovere prima del parsing.
- I token hanno vita breve, quindi non puoi memorizzarli nella cache a lungo né riutilizzarli tra sessioni.
Poiché questi endpoint non sono ufficiali, considera qualunque scraper basato su di essi come qualcosa che richiederà manutenzione quando Google modifica il formato della risposta.
Dovresti usare pytrends per fare web scraping di Google Trends?
pytrends è una popolare libreria Python non ufficiale che racchiude gli endpoint dei widget descritti sopra ed è il modo più rapido per iniziare. È davvero utile, ma dovresti usarla con aspettative chiare.
Parlando con franchezza di pytrends: non è un prodotto Google ufficiale, si interrompe periodicamente quando Google modifica gli endpoint e applica limiti di frequenza severi, restituendo errori 429 quando invii più di un modesto numero di richieste in un breve intervallo. È più adatta a lavori su scala di ricerca che a una raccolta continua ad alto volume. Un’estrazione di base dell’interesse nel tempo, con un elenco di proxy passato per distribuire le richieste tra gli IP, è simile a questa:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Alternare più voci proxy evita che un singolo IP superi i limiti di Google per indirizzo, mentre le impostazioni di retry e backoff attenuano gli errori transitori.
Perché i residential proxy a rotazione aiutano con gli errori 429?
I residential proxy a rotazione aiutano perché Google limita le richieste Trends per indirizzo IP e, una volta che un indirizzo viene segnalato, continui a ricevere risposte 429 Too Many Requests. Distribuire le richieste tra molti IP residential, insieme al backoff esponenziale, mantiene ogni indirizzo sotto la soglia.
Gli IP residential provengono da dispositivi reali di consumatori, quindi si integrano con il traffico normale molto meglio degli intervalli datacenter, che Google riconosce e limita più aggressivamente. La rotazione significa che ogni richiesta o piccolo gruppo parte da un indirizzo diverso, così nessun singolo IP accumula abbastanza volume da essere bloccato. Residential proxy sono qui la scelta pratica per questo motivo, anche se i proxy datacenter possono comunque funzionare per lavori leggeri e a bassa frequenza, in cui il costo conta più della discrezione. DataImpulse fornisce sessioni a rotazione e sticky session in 90 Mln.+ IP in 195 Paesi, con targeting per Paese incluso, permettendoti anche di raccogliere dati Trends specifici per regione da un IP all’interno di quella regione.
La rotazione da sola non basta: devi anche rallentare deliberatamente. Lo schema fondamentale consiste nell’intercettare un 429, attendere un ritardo che raddoppia a ogni tentativo e rinunciare dopo un numero fisso di tentativi, così una destinazione in errore non continua in un ciclo infinito:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Combina questo backoff con la rotazione dei proxy e una pausa casuale tra chiamate riuscite. Gli stessi principi anti-blocco si applicano a qualsiasi grande lavoro di raccolta, come illustrato in questa guida sullo scraping senza essere bloccati.
Quando dovresti usare invece un browser headless?
Usa un browser headless quando gli endpoint JSON smettono di funzionare o restituiscono verifiche che un semplice client HTTP non riesce a risolvere. Strumenti come Playwright o Selenium caricano la vera pagina Trends, eseguono il suo JavaScript e ti consentono di leggere i dati del widget renderizzato o intercettare le chiamate di rete effettuate dalla pagina.
Questo approccio è più pesante e lento perché esegue un browser completo per sessione, ma è più resistente alle modifiche del front end e può superare alcune verifiche interattive che bloccano i semplici scraper basati su richieste. Instrada il browser attraverso un proxy, idealmente proxy mobile o IP residential, così la sessione automatizzata sembra comunque quella di un visitatore normale. Tieni presente che un browser headless non elimina i limiti di frequenza sottostanti: devi comunque dosare le richieste e ruotare gli IP, solo con più overhead per richiesta rispetto al metodo dell’endpoint diretto.
Per cosa puoi usare i dati estratti da Google Trends?
I dati estratti da Google Trends sono più utili per individuare direzione relativa e stagionalità che volumi esatti. Poiché i numeri sono un indice normalizzato, considerali segnali di interesse in crescita o in calo, non previsioni di traffico.
I casi d’uso comuni includono:
- SEO e pianificazione dei contenuti: confronta termini correlati su un’unica scala per decidere quale argomento prioritizzare e quando l’interesse raggiunge il picco durante l’anno.
- Domanda di prodotto: monitora se l’interesse per una categoria o una funzionalità sta crescendo o diminuendo prima di impegnare risorse.
- Tempistica di mercato: usa i modelli stagionali e le differenze regionali per programmare campagne o lanci quando l’attenzione è massima.
Il limite reale è che Trends da solo non può dirti la domanda assoluta o il valore di conversione; abbinalo a strumenti per il volume di ricerca, dati sulle vendite o numeri delle piattaforme pubblicitarie per trasformare il segnale relativo in una decisione.
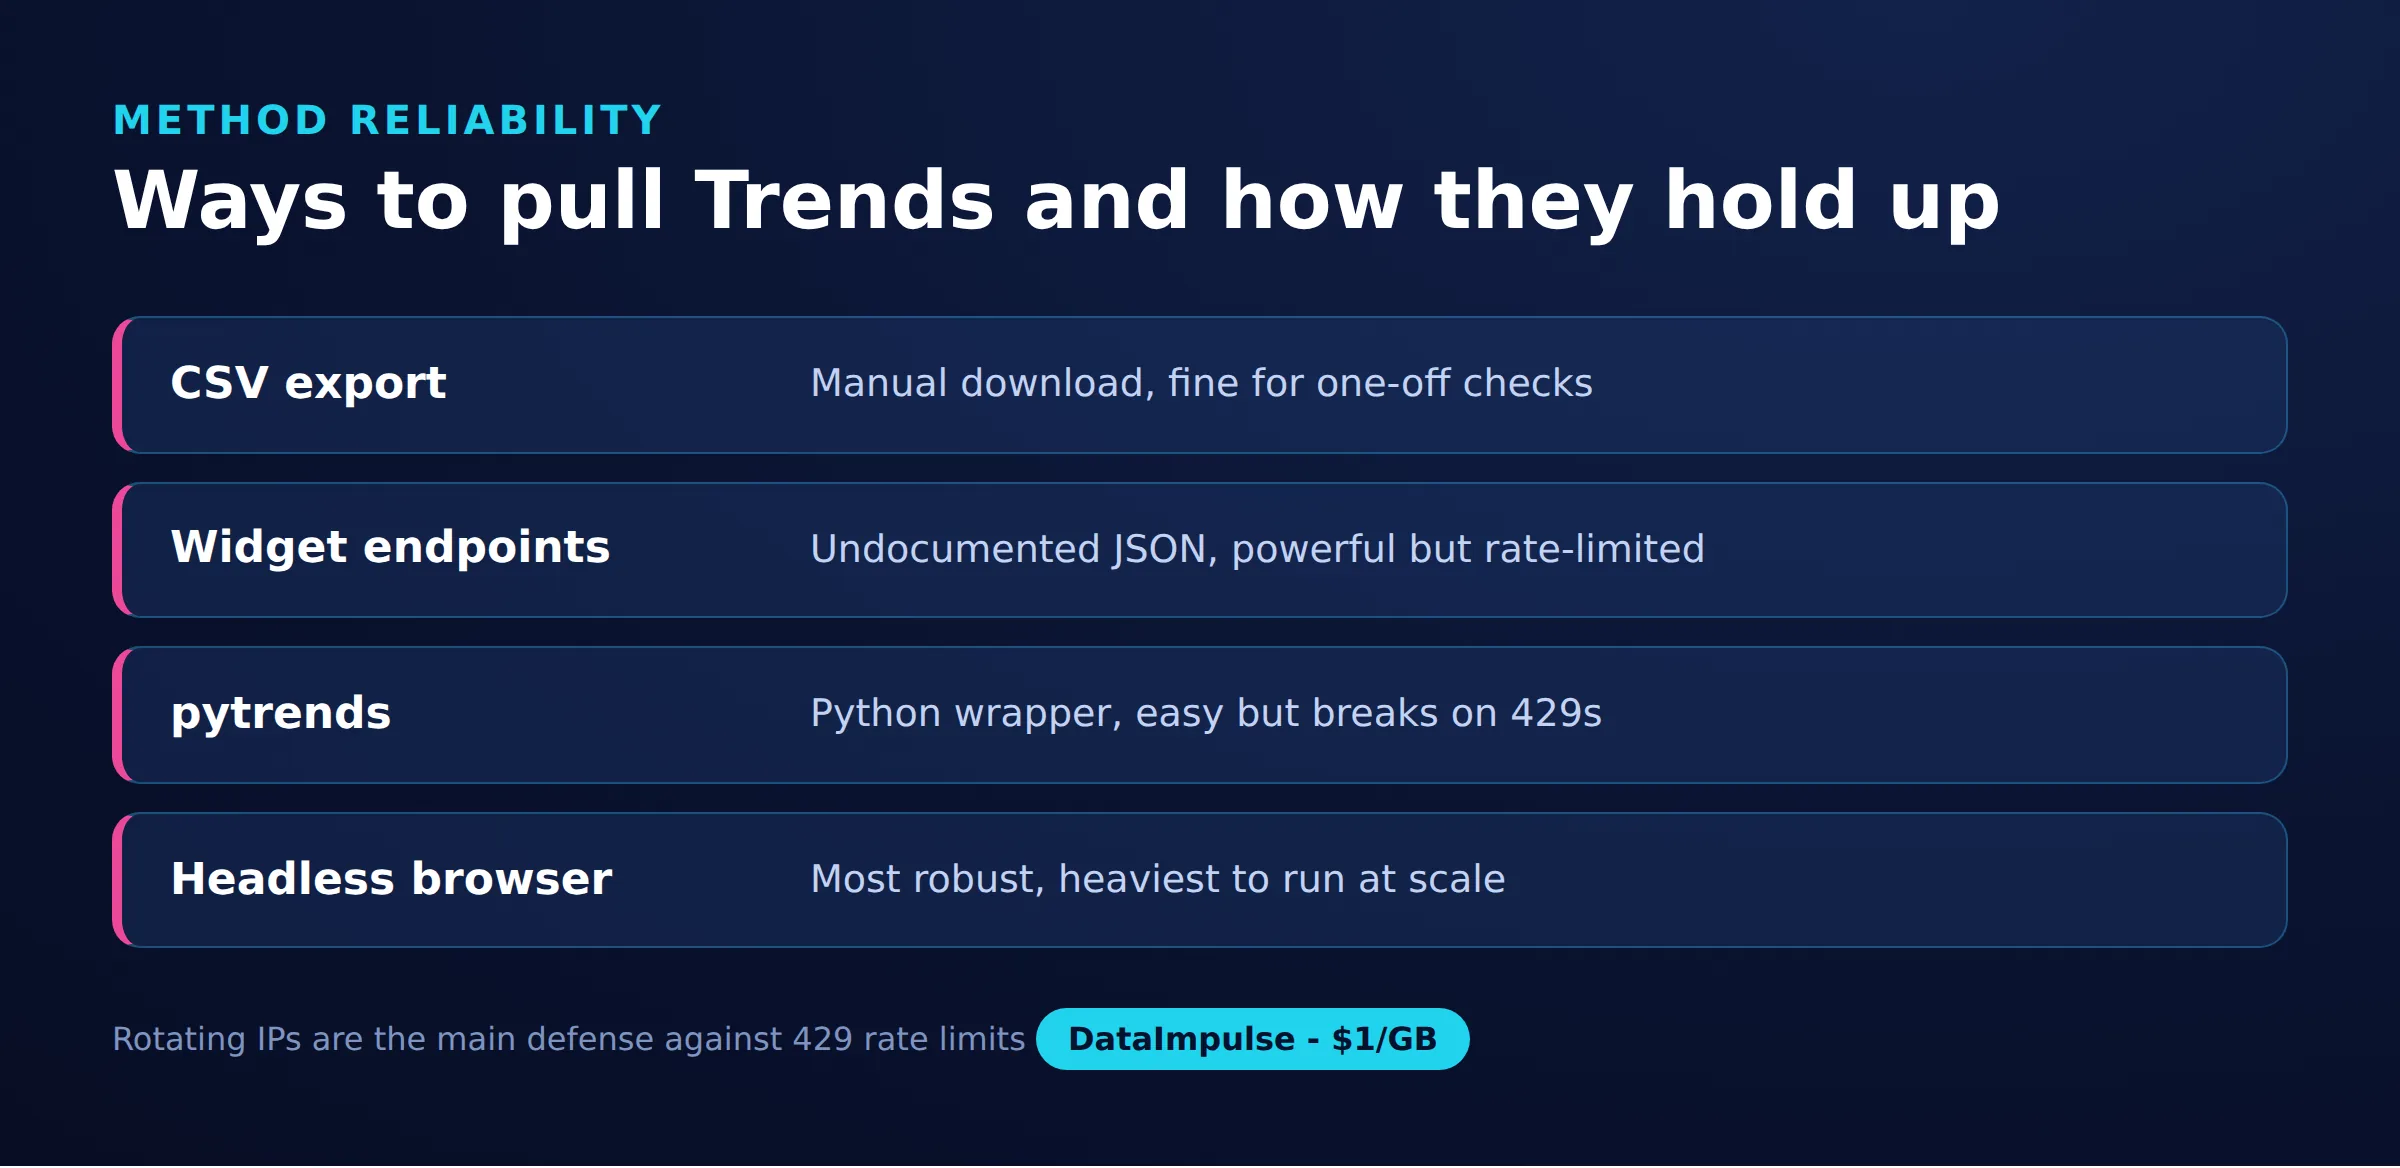
Metodi di accesso a confronto
| Metodo | Affidabilità | Impegno e limiti |
|---|---|---|
| Esportazione CSV | Alta | Manuale, query singola |
| Endpoint dei widget | Media | Non documentati, possono cambiare |
| pytrends | Media | Semplice, con limiti di frequenza |
| Browser headless | Alta | Più pesante, richiede proxy |
Domande frequenti
Fare web scraping di Google Trends è legittimo?
Il web scraping di dati visibili pubblicamente è generalmente consentito in molte giurisdizioni, ma l’accesso automatizzato può entrare in conflitto con i termini di servizio di Google. Esamina i termini e la normativa locale applicabile e, ove possibile, preferisci l’esportazione CSV ufficiale o un set di dati supportato.
Google Trends mostra il volume di ricerca effettivo?
No. Mostra un indice di interesse relativo da 0 a 100, normalizzato rispetto al picco nella query, nella regione e nell’intervallo di tempo scelti. Per stimare il volume assoluto ti serve uno strumento separato per le keyword.
Perché pytrends continua a restituire errori 429?
429 significa che Google sta limitando la frequenza del tuo IP perché ci sono troppe richieste in troppo poco tempo. Aggiungi ritardi con backoff esponenziale, riduci la frequenza delle richieste e alterna più proxy, così nessun singolo IP supera il limite.
Mi servono proxy per fare web scraping di Google Trends?
Per poche query manuali, no. Per lavori automatizzati o più grandi, i residential proxy a rotazione ti aiutano a evitare i limiti di frequenza per IP e a raccogliere dati specifici per regione da un IP nel Paese di destinazione.
pytrends è una libreria Google ufficiale?
No. pytrends è una libreria della community non ufficiale che racchiude gli endpoint interni di Google. Funziona bene per la ricerca, ma si interrompe periodicamente quando Google modifica tali endpoint, quindi richiede manutenzione occasionale.
Quando DataImpulse non è la soluzione giusta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Raccogli dati Google Trends su larga scala
Se il tuo scraping di Trends subisce limitazioni, gli IP residential a rotazione mantengono ogni richiesta sotto i limiti di Google per indirizzo. DataImpulse offre proxy residential, mobile e datacenter a consumo a partire da 1 dollaro per GB con targeting per Paese incluso. Crea un account DataImpulse per iniziare.