
In this Article
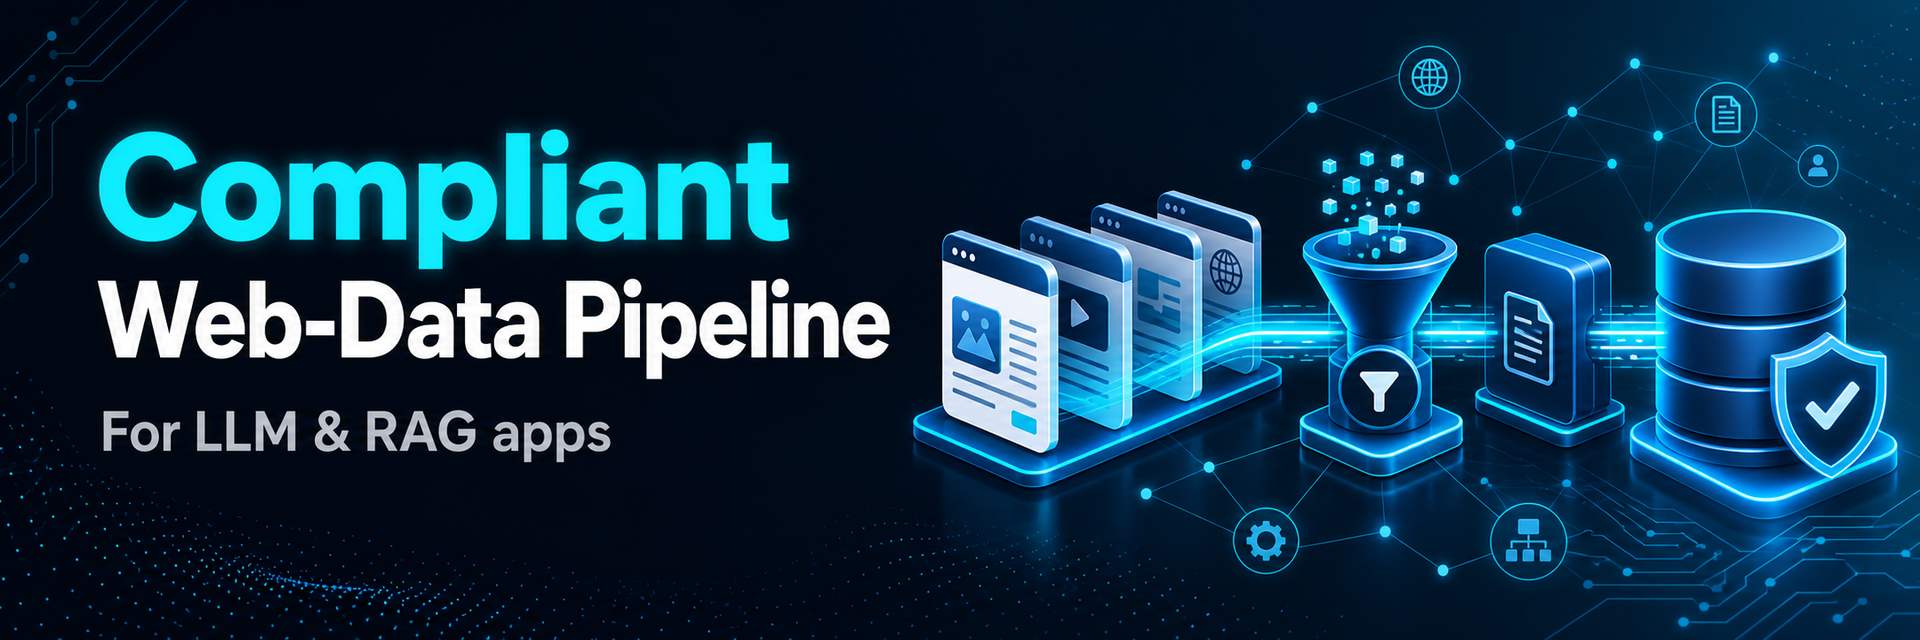
Tworzenie aplikacji LLM lub RAG na podstawie publicznych danych z internetu oznacza prowadzenie procesu pozyskiwania danych, a w 2026 roku proces ten musi być zgodny z wymogami, nie tylko funkcjonalny. Między zasadami EU AI Act dotyczącymi danych treningowych i praw autorskich, możliwymi do odczytu maszynowego rezygnacjami oraz RODO era podejścia “po prostu zbieraj dane przez web scraping” skończyła się dla każdego, kto traktuje sprawę poważnie. Ten przewodnik przedstawia praktyczną architekturę zgodnego z wymogami procesu pozyskiwania publicznych danych z internetu dla aplikacji LLM/RAG: co zbierać, jak respektować rezygnacje, jak zachowywać informacje o pochodzeniu danych i gdzie pasuje czysta infrastruktura proxy.
Nazywam się Andrii Byzov, jestem dyrektorem marketingu na część etatu specjalizującym się w AI i pracuję z procesami danych AI. To praktyczny przegląd architektury, a nie porada prawna. Zobacz też: EU AI Act i dane z internetu, robots.txt i crawlery AI oraz proxy do obciążeń AI.
Najważniejsze fakty
- Zgodność z wymogami jest teraz częścią procesu – EU AI Act (podsumowanie danych treningowych + rezygnacja z praw autorskich/TDM), możliwe do odczytu maszynowego rezygnacje i RODO mają zastosowanie do sposobu pozyskiwania danych.
- Zbieraj publiczne dane tylko do odczytu – nie omijaj logowania ani kontroli dostępu, sprawdzaj dane osobowe.
- Respektuj możliwe do odczytu maszynowego rezygnacje – robots.txt, ai.txt i zastrzeżenia TDM mają obecnie znaczenie w zakresie praw autorskich dla modeli na rynku UE.
- Zachowuj informacje o pochodzeniu danych – zapisuj źródło, znacznik czasu i metodę dla każdego zbioru danych, aby móc przygotować podsumowanie danych treningowych i odpowiadać na audyty.
- Korzystaj z proxy pozyskanych w sposób etyczny – czyste residential IP uzyskane za zgodą są warstwą pozyskiwania danych w procesie, którego można bronić.
Dlaczego podejście “po prostu zbieraj dane przez web scraping” już nie działa
Publiczne dane z internetu nadal zasilają większość systemów LLM i RAG, ale zasady ich pozyskiwania stały się surowsze. EU AI Act wymaga od dostawców modeli ogólnego przeznaczenia publikowania podsumowania danych treningowych i respektowania rezygnacji z eksploracji tekstu i danych; sygnały możliwe do odczytu maszynowego, takie jak robots.txt, mają obecnie znaczenie w zakresie praw autorskich, a RODO reguluje wszelkie dane osobowe trafiające do Twojego korpusu. Proces, który to ignoruje, nie jest tylko ryzykowny – może zaszkodzić zgodności z wymogami po stronie klienta korzystającego z danych w dalszym etapie. Dobra wiadomość: zgodność z wymogami i jakość idą w tym samym kierunku. Udokumentowane, respektujące rezygnacje i pozbawione duplikatów dane są również lepszymi danymi.
Proces zgodny z wymogami, etap po etapie
- 1. Wybór źródeł. Kieruj się na strony publiczne, dostępne tylko do odczytu. Wyklucz wszystko, co znajduje się za logowaniem lub kontrolą dostępu, której nie kontrolujesz. Od pierwszego dnia prowadź rejestr źródeł.
- 2. Sprawdzenie rezygnacji i praw. Przed crawlowaniem źródła przeczytaj jego robots.txt oraz wszelkie zastrzeżenia TDM/ai.txt i ich przestrzegaj. Traktuj je jako zasady warunkujące dostęp, a nie sugestie – dla modeli na rynku UE są częścią zgodności z prawami autorskimi.
- 3. Pozyskiwanie danych. Pobieraj dane przez rotujące, pozyskane w sposób etyczny residential proxy z rozsądną częstotliwością, aby nie pogarszać działania serwisów docelowych ani nie zostać zablokowanym. Stosuj targetowanie geograficzne tam, gdzie treść jest regionalna. To warstwa, którą zapewniają proxy do web scraping.
- 4. Sprawdzanie PII. Wykrywaj i minimalizuj dane osobowe na wczesnym etapie – filtruj je lub redaguj, aby ograniczać narażenie związane z RODO/CCPA, zanim trafią do magazynu.
- 5. Pochodzenie danych i przechowywanie. Przechowuj każdy rekord wraz z URL źródła, znacznikiem czasu pobrania i metodą pozyskania. Te metadane umożliwiają przygotowanie podsumowania danych treningowych EU AI Act i odpowiedzi na pytania zadawane w dalszych etapach.
- 6. Usuwanie duplikatów i jakość. Usuń duplikaty i treści niskiej jakości; wersjonuj swoje zbiory danych, aby móc prześledzić, co trenowało lub ugruntowało konkretną wersję modelu.
Gdzie pasują proxy, a gdzie nie
Proxy są warstwą pozyskiwania danych: pozwalają niezawodnie pobierać publiczne strony na dużą skalę, z właściwych lokalizacji geograficznych, bez nadmiernego obciążania pojedynczego IP. Nie sprawiają jednak, że pozyskiwanie danych niezgodne z wymogami staje się zgodne – praca prawna dotyczy tego, co zbierasz, oraz tego, czy respektujesz rezygnacje i zasady dotyczące danych osobowych. Dlatego sposób pozyskania ma znaczenie: pozyskana etycznie, oparta na zgodzie sieć residential jest elementem procesu, którego można bronić, podczas gdy nieuczciwa sieć podważa całą argumentację dotyczącą zgodności z wymogami. Proxy DataImpulse są pozyskiwane etycznie i rozliczane za użycie, z rotacją i targetowaniem krajów – to czysta infrastruktura stanowiąca podstawę odpowiedzialnego procesu.
Szybka lista kontrolna przed startem
- Źródła są publiczne i dostępne tylko do odczytu; bez omijania logowania.
- Rezygnacje w robots.txt i TDM/ai.txt zostały odczytane i są respektowane dla każdego źródła.
- Częstotliwość żądań jest rozsądna; IP rotują; pozyskiwanie danych jest poprawne geograficznie.
- Dane osobowe są sprawdzane i minimalizowane.
- Przy każdym rekordzie zapisano źródło, znacznik czasu i metodę.
- Zbiory danych są pozbawione duplikatów, sprawdzone pod względem jakości i wersjonowane.
- Infrastruktura proxy jest pozyskiwana w sposób etyczny.
FAQ
Co sprawia, że proces pozyskiwania danych z internetu jest “zgodny z wymogami” w 2026 roku?
Pozyskiwanie publicznych danych tylko do odczytu; respektowanie możliwych do odczytu maszynowego rezygnacji (robots.txt, TDM/ai.txt); sprawdzanie danych osobowych pod kątem RODO oraz zachowywanie informacji o pochodzeniu danych, aby móc przygotować podsumowanie danych treningowych EU AI Act. Chodzi o to, co zbierasz i jak to dokumentujesz, a nie tylko o narzędzia.
Czy muszę respektować robots.txt w przypadku danych treningowych AI?
W praktyce tak w przypadku modeli ogólnego przeznaczenia wprowadzanych na rynek UE – zasady EU AI Act dotyczące praw autorskich wymagają respektowania rezygnacji z eksploracji tekstu i danych, wyrażanych za pomocą możliwych do odczytu maszynowego sygnałów, takich jak robots.txt i ai.txt.
Jak proxy pomagają w procesie zgodnym z wymogami?
Proxy są warstwą pozyskiwania danych – niezawodnie pobierają publiczne strony na dużą skalę, z właściwych lokalizacji geograficznych, bez przeciążania jednego IP. Residential proxy pozyskane etycznie są częścią procesu, którego można bronić; nie zastępują pracy prawnej polegającej na respektowaniu rezygnacji i zasad dotyczących danych osobowych.
Czym jest pochodzenie danych i dlaczego ma znaczenie?
Pochodzenie danych to zapis, skąd pochodzi każdy zbiór danych, kiedy i jak został zebrany. Dzięki niemu możesz przygotować podsumowanie danych treningowych EU AI Act i odpowiadać na audyty lub procedury należytej staranności klientów.
Czy web scraping publicznych danych dla RAG jest dozwolony?
Pozyskiwanie publicznych danych tylko do odczytu jest ogólnie możliwe do uzasadnienia, a korzystanie z proxy jest legalne – ale respektuj rezygnacje, zwracaj uwagę na dane osobowe i zachowuj informacje o pochodzeniu danych. To informacje ogólne, nie porada prawna; skonsultuj się z prawnikiem w sprawie swojego przypadku użycia.
Buduj proces danych AI na czystej infrastrukturze
Proces zgodny z wymogami zaczyna się od publicznych źródeł, respektowanych rezygnacji i IP pozyskanych w sposób etyczny. Kup residential proxy pozyskane etycznie od $1/GB – rozliczane za użycie, rotujące, globalne – jako warstwę pozyskiwania danych stanowiącą podstawę odpowiedzialnego procesu danych LLM/RAG.
Ten artykuł zawiera informacje ogólne, a nie poradę prawną. Skonsultuj się z wykwalifikowanym prawnikiem w sprawie obowiązków wynikających z EU AI Act, dyrektywy DSM i RODO.