
In this Article
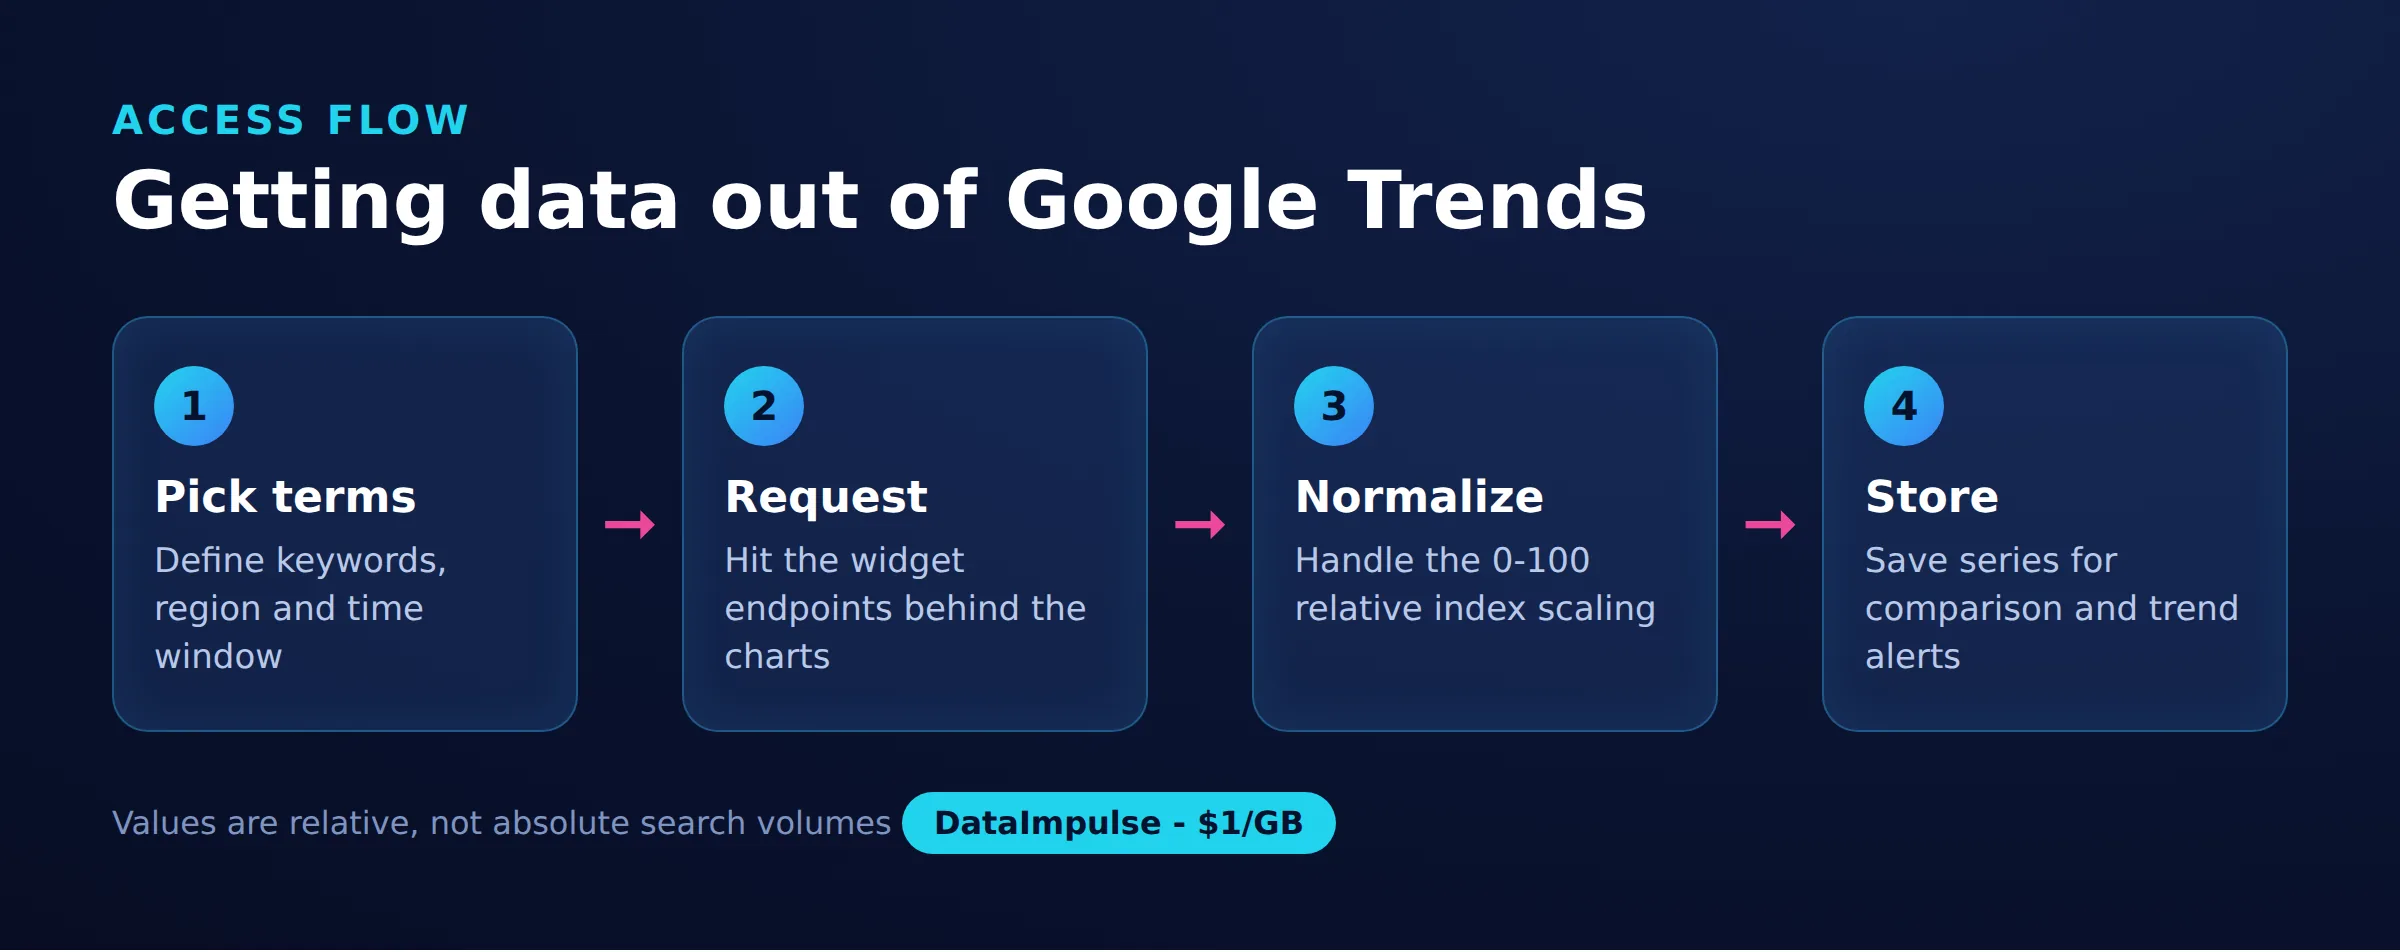
หากต้องการทราบวิธี scrape Google Trends สิ่งแรกที่ควรเข้าใจคือคุณกำลังเก็บข้อมูลอะไรอยู่จริงๆ Google Trends ไม่ได้เผยแพร่ปริมาณการค้นหาแบบสัมบูรณ์ แต่จะแสดงดัชนีความสนใจที่ปรับมาตรฐานแล้วตั้งแต่ 0 ถึง 100 โดยเทียบกับจุดสูงสุดของคำค้นหา ภูมิภาค และช่วงวันที่ที่คุณระบุ
บทความนี้ครอบคลุมวิธีหลักในการดึงข้อมูลดังกล่าว ได้แก่ การส่งออก CSV ที่มีในระบบ endpoint JSON ของวิดเจ็ตที่ไม่มีเอกสารอธิบาย ไลบรารี Python อย่าง pytrends และทางเลือกด้วยเบราว์เซอร์แบบ headless นอกจากนี้ยังอธิบายว่า residential proxy แบบหมุนเวียนช่วยได้อย่างไรเมื่อ Google เริ่มส่งข้อผิดพลาด 429 และข้อจำกัดที่เป็นจริงอยู่ตรงไหน
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมี IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการครอบคลุม 195 ประเทศ ใช้โมเดลจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- Google Trends แสดงดัชนีสัมพัทธ์ ไม่ใช่จำนวนดิบ: ทุกค่าถูกปรับสเกลจาก 0 ถึง 100 เทียบกับจุดสูงสุดในคำค้นหา ภูมิภาค และช่วงเวลาที่เลือก ดังนั้นตัวเลขที่ scrape มาใช้เปรียบเทียบกัน ไม่ใช่ปริมาณการค้นหาแบบสัมบูรณ์
- ประเภท proxy ที่เหมาะที่สุด: residential proxy แบบหมุนเวียน ซึ่งใช้ IP ของผู้ใช้งานจริงและผ่านการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุ และไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่จัดหาอย่างมีจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
Google Trends ให้ข้อมูลอะไรจริงๆ?
Google Trends ให้ดัชนีความสนใจสัมพัทธ์ตั้งแต่ 0 ถึง 100 ไม่ใช่จำนวนการค้นหา แต่ละจุดถูกปรับมาตรฐานเพื่อให้ค่าสูงสุดในคำค้นหาและช่วงเวลาของคุณเท่ากับ 100 แล้วจุดอื่นทั้งหมดจะถูกปรับสเกลโดยเทียบกับค่านั้น
เรื่องนี้สำคัญกับทุกโปรเจกต์ scraping เพราะคุณไม่สามารถเปรียบเทียบการส่งออก 2 ชุดที่แยกกันราวกับเป็นจำนวนสัมบูรณ์ได้ คำที่ได้ 100 ในประเทศหนึ่งและคำที่ได้ 100 ในอีกประเทศหนึ่ง ต่างก็อยู่ที่จุดสูงสุดของตัวเอง ไม่ได้มีปริมาณจริงเท่ากัน หากต้องการเปรียบเทียบคำอย่างเป็นธรรม ให้ขอคำเหล่านั้นรวมกันในคำขอเดียว เพื่อให้ Google ปรับมาตรฐานบนสเกลร่วมเดียวกัน มุมมองข้อมูลหลักที่ดึงได้คือความสนใจตามเวลา ความสนใจตามภูมิภาค คำค้นหาที่เกี่ยวข้อง และหัวข้อที่เกี่ยวข้อง
จะส่งออกข้อมูล Google Trends เป็น CSV ได้อย่างไร?
วิธีที่ง่ายที่สุดคือการส่งออก CSV อย่างเป็นทางการที่มีอยู่ในอินเทอร์เฟซ Google Trends ในหน้าผลลัพธ์ Trends ทุกหน้า แต่ละวิดเจ็ตมีไอคอนดาวน์โหลดสำหรับบันทึกมุมมองนั้นเป็นไฟล์ CSV
นี่เป็นตัวเลือกที่ตรงไปตรงมาและเสถียรที่สุด เพราะใช้ฟีเจอร์ที่รองรับ และเพียงพอสำหรับงานวิจัยเป็นครั้งคราวหรือคำหลักชุดเล็ก ข้อแลกเปลี่ยนคือทำด้วยตนเอง ครั้งละ 1 วิดเจ็ตและ 1 คำค้นหา และไม่ขยายไปสู่คำหลายร้อยคำได้ หากต้องการเปรียบเทียบเพียงไม่กี่รายการสำหรับการวางแผนเนื้อหาหรือตรวจตลาดอย่างรวดเร็ว การส่งออก CSV จะหลีกเลี่ยงปัญหาความน่าเชื่อถือที่มาพร้อมการ scraping อัตโนมัติได้ทั้งหมด
endpoint JSON ของวิดเจ็ต Google Trends ทำงานอย่างไร?
เว็บไซต์ Trends ทำงานด้วย endpoint JSON ภายในที่ส่วนหน้าบ้านเรียกใช้เพื่อแสดงผลแต่ละวิดเจ็ต การ scrape โดยตรงผ่าน endpoint เหล่านี้เป็นเส้นทางแบบโปรแกรมที่เร็วที่สุด แต่ไม่มีเอกสารอธิบายและอาจเปลี่ยนแปลงได้โดยไม่แจ้งล่วงหน้า
กระบวนการมี 2 ขั้นตอน ขั้นแรก เรียก endpoint explore พร้อมคำหลัก ภูมิภาค และช่วงเวลา ซึ่งจะส่งชุด token ของวิดเจ็ตกลับมา จากนั้นส่ง token แต่ละรายการไปยัง endpoint ข้อมูลที่ตรงกัน เช่น endpoint สำหรับความสนใจตามเวลา เพื่อรับชุดข้อมูลจริงในรูป JSON มีข้อควรระวังเชิงปฏิบัติ 2 ข้อที่มักทำให้สับสน:
- การตอบกลับมีอักขระป้องกัน JSON นำหน้า ซึ่งต้องตัดออกก่อนแยกวิเคราะห์
- token มีอายุสั้น จึงไม่สามารถแคชไว้นานหรือใช้ซ้ำข้ามเซสชันได้
เนื่องจาก endpoint เหล่านี้ไม่เป็นทางการ ควรมอง scraper ที่สร้างบน endpoint เหล่านี้ว่าเป็นสิ่งที่จะต้องบำรุงรักษาเมื่อ Google ปรับรูปแบบการตอบกลับ
ควรใช้ pytrends เพื่อ scrape Google Trends หรือไม่?
pytrends เป็นไลบรารี Python นอกทางการที่ได้รับความนิยม ซึ่งห่อหุ้ม endpoint ของวิดเจ็ตที่กล่าวถึงข้างต้น และเป็นวิธีที่เริ่มต้นได้เร็วที่สุด มันมีประโยชน์จริง แต่ควรใช้โดยมีความคาดหวังที่ชัดเจน
พูดถึง pytrends ตามตรง: มันไม่ใช่ผลิตภัณฑ์ Google อย่างเป็นทางการ ใช้งานไม่ได้เป็นระยะเมื่อ Google เปลี่ยน endpoint และจำกัดอัตราอย่างเข้มงวด โดยส่งข้อผิดพลาด 429 เมื่อคุณส่งคำขอเกินจำนวนพอประมาณในช่วงเวลาสั้นๆ จึงเหมาะที่สุดสำหรับงานระดับวิจัยมากกว่าการเก็บข้อมูลปริมาณมากอย่างต่อเนื่อง ตัวอย่างการดึงความสนใจตามเวลาเบื้องต้น โดยส่งรายการ proxy เข้าไปเพื่อกระจายคำขอไปยัง IP หลายรายการ มีลักษณะดังนี้:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
การหมุนเวียนผ่านรายการ proxy หลายรายการช่วยไม่ให้ที่อยู่ใดที่อยู่หนึ่งไปกระทบขีดจำกัดต่อที่อยู่ของ Google และการตั้งค่า retry กับ backoff ช่วยลดผลกระทบจากความล้มเหลวชั่วคราว
เหตุใด residential proxy แบบหมุนเวียนจึงช่วยเรื่องข้อผิดพลาด 429?
residential proxy แบบหมุนเวียนช่วยได้เพราะ Google จำกัดคำขอ Trends ต่อ IP และเมื่อที่อยู่หนึ่งถูกทำเครื่องหมาย คุณจะยังคงได้รับการตอบกลับ 429 Too Many Requests การกระจายคำขอผ่าน residential IP จำนวนมากร่วมกับ exponential backoff ทำให้แต่ละที่อยู่ไม่เกินเกณฑ์
residential IP มาจากอุปกรณ์ผู้บริโภคจริง จึงกลมกลืนกับทราฟฟิกปกติได้ดีกว่าช่วง IP ของ datacenter ซึ่ง Google ตรวจพบและจำกัดอย่างเข้มงวดกว่า การหมุนเวียนหมายความว่าแต่ละคำขอหรือชุดเล็กๆ จะออกจากที่อยู่ที่ต่างกัน จึงไม่มี IP เดียวสะสมปริมาณมากพอที่จะถูกบล็อก residential proxy เป็นตัวเลือกที่ใช้ได้จริงในกรณีนี้ด้วยเหตุผลดังกล่าว แม้ว่า datacenter proxy ยังใช้ได้กับงานเบาๆ ที่ทำไม่บ่อย ซึ่งต้นทุนสำคัญกว่าการหลบการตรวจจับ DataImpulse มีเซสชันแบบหมุนเวียนและ sticky session ครอบคลุม 90M+ IP ใน 195 ประเทศ พร้อมการกำหนดเป้าหมายตามประเทศ ซึ่งยังช่วยให้เก็บข้อมูล Trends เฉพาะภูมิภาคจาก IP ภายในภูมิภาคนั้นได้
การหมุนเวียนอย่างเดียวไม่พอ คุณต้องชะลอความเร็วอย่างตั้งใจด้วย รูปแบบหลักคือดักจับ 429 รอเป็นระยะเวลาที่เพิ่มเป็น 2 เท่าในแต่ละครั้ง แล้วหยุดหลังจากลองครบจำนวนที่กำหนด เพื่อไม่ให้เป้าหมายที่ล้มเหลววนซ้ำไม่สิ้นสุด:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
ใช้ backoff นี้ร่วมกับการหมุนเวียน proxy และการพักแบบสุ่มระหว่างคำขอที่สำเร็จ หลักการป้องกันการบล็อกแบบเดียวกันใช้ได้กับงานเก็บข้อมูลขนาดใหญ่ทุกประเภท ดังที่อธิบายไว้ในคู่มือ scraping โดยไม่ถูกบล็อก
ควรใช้เบราว์เซอร์แบบ headless แทนเมื่อใด?
ใช้เบราว์เซอร์แบบ headless เมื่อ endpoint JSON ใช้ไม่ได้หรือส่งการตรวจสอบกลับมาซึ่งไคลเอนต์ HTTP ธรรมดาแก้ไม่ได้ เครื่องมืออย่าง Playwright หรือ Selenium จะโหลดหน้า Trends จริง รัน JavaScript และให้คุณอ่านข้อมูลวิดเจ็ตที่แสดงผลแล้ว หรือดักจับการเรียกเครือข่ายที่หน้าเว็บส่งออกไป
แนวทางนี้หนักและช้ากว่าเพราะรันเบราว์เซอร์เต็มรูปแบบต่อเซสชัน แต่ทนต่อการเปลี่ยนแปลงส่วนหน้าบ้านมากกว่า และอาจผ่านการตรวจสอบเชิงโต้ตอบบางอย่างที่ทำให้ scraper แบบใช้คำของ่ายๆ ใช้ไม่ได้ กำหนดเส้นทางเบราว์เซอร์ผ่าน proxy โดยควรเป็น mobile proxy หรือ residential IP เพื่อให้เซสชันอัตโนมัติยังดูเหมือนผู้เข้าชมปกติ โปรดทราบว่าเบราว์เซอร์แบบ headless ไม่ได้ยกเลิกขีดจำกัดอัตราพื้นฐาน คุณยังต้องกำหนดจังหวะคำขอและหมุนเวียน IP เพียงแต่มีภาระต่อคำขอมากกว่าวิธี endpoint โดยตรง
จะนำข้อมูล Google Trends ที่ scrape มาไปใช้อะไรได้บ้าง?
ข้อมูล Google Trends ที่ scrape มาเหมาะที่สุดสำหรับสังเกตทิศทางสัมพัทธ์และฤดูกาล มากกว่าปริมาณที่แน่นอน เนื่องจากตัวเลขเป็นดัชนีที่ปรับมาตรฐานแล้ว จึงควรมองเป็นสัญญาณของความสนใจที่เพิ่มขึ้นหรือลดลง ไม่ใช่การคาดการณ์ทราฟฟิก
กรณีการใช้งานทั่วไป ได้แก่:
- SEO และการวางแผนเนื้อหา: เปรียบเทียบคำที่เกี่ยวข้องบนสเกลเดียวเพื่อเลือกหัวข้อที่ควรให้ความสำคัญ และดูว่าความสนใจสูงสุดเมื่อใดในระหว่างปี
- อุปสงค์ของผลิตภัณฑ์: ติดตามว่าความสนใจในหมวดหมู่หรือฟีเจอร์กำลังเติบโตหรือลดลงก่อนทุ่มทรัพยากร
- จังหวะตลาด: ใช้รูปแบบตามฤดูกาลและความแตกต่างตามภูมิภาคเพื่อกำหนดเวลาของแคมเปญหรือการเปิดตัว เมื่อความสนใจสูงที่สุด
ข้อจำกัดตามจริงคือ Trends เพียงอย่างเดียวไม่สามารถบอกอุปสงค์สัมบูรณ์หรือมูลค่าการเปลี่ยนเป็นลูกค้าได้ ควรใช้คู่กับเครื่องมือปริมาณการค้นหา ข้อมูลยอดขาย หรือตัวเลขจากแพลตฟอร์มโฆษณา เพื่อเปลี่ยนสัญญาณสัมพัทธ์เป็นการตัดสินใจ
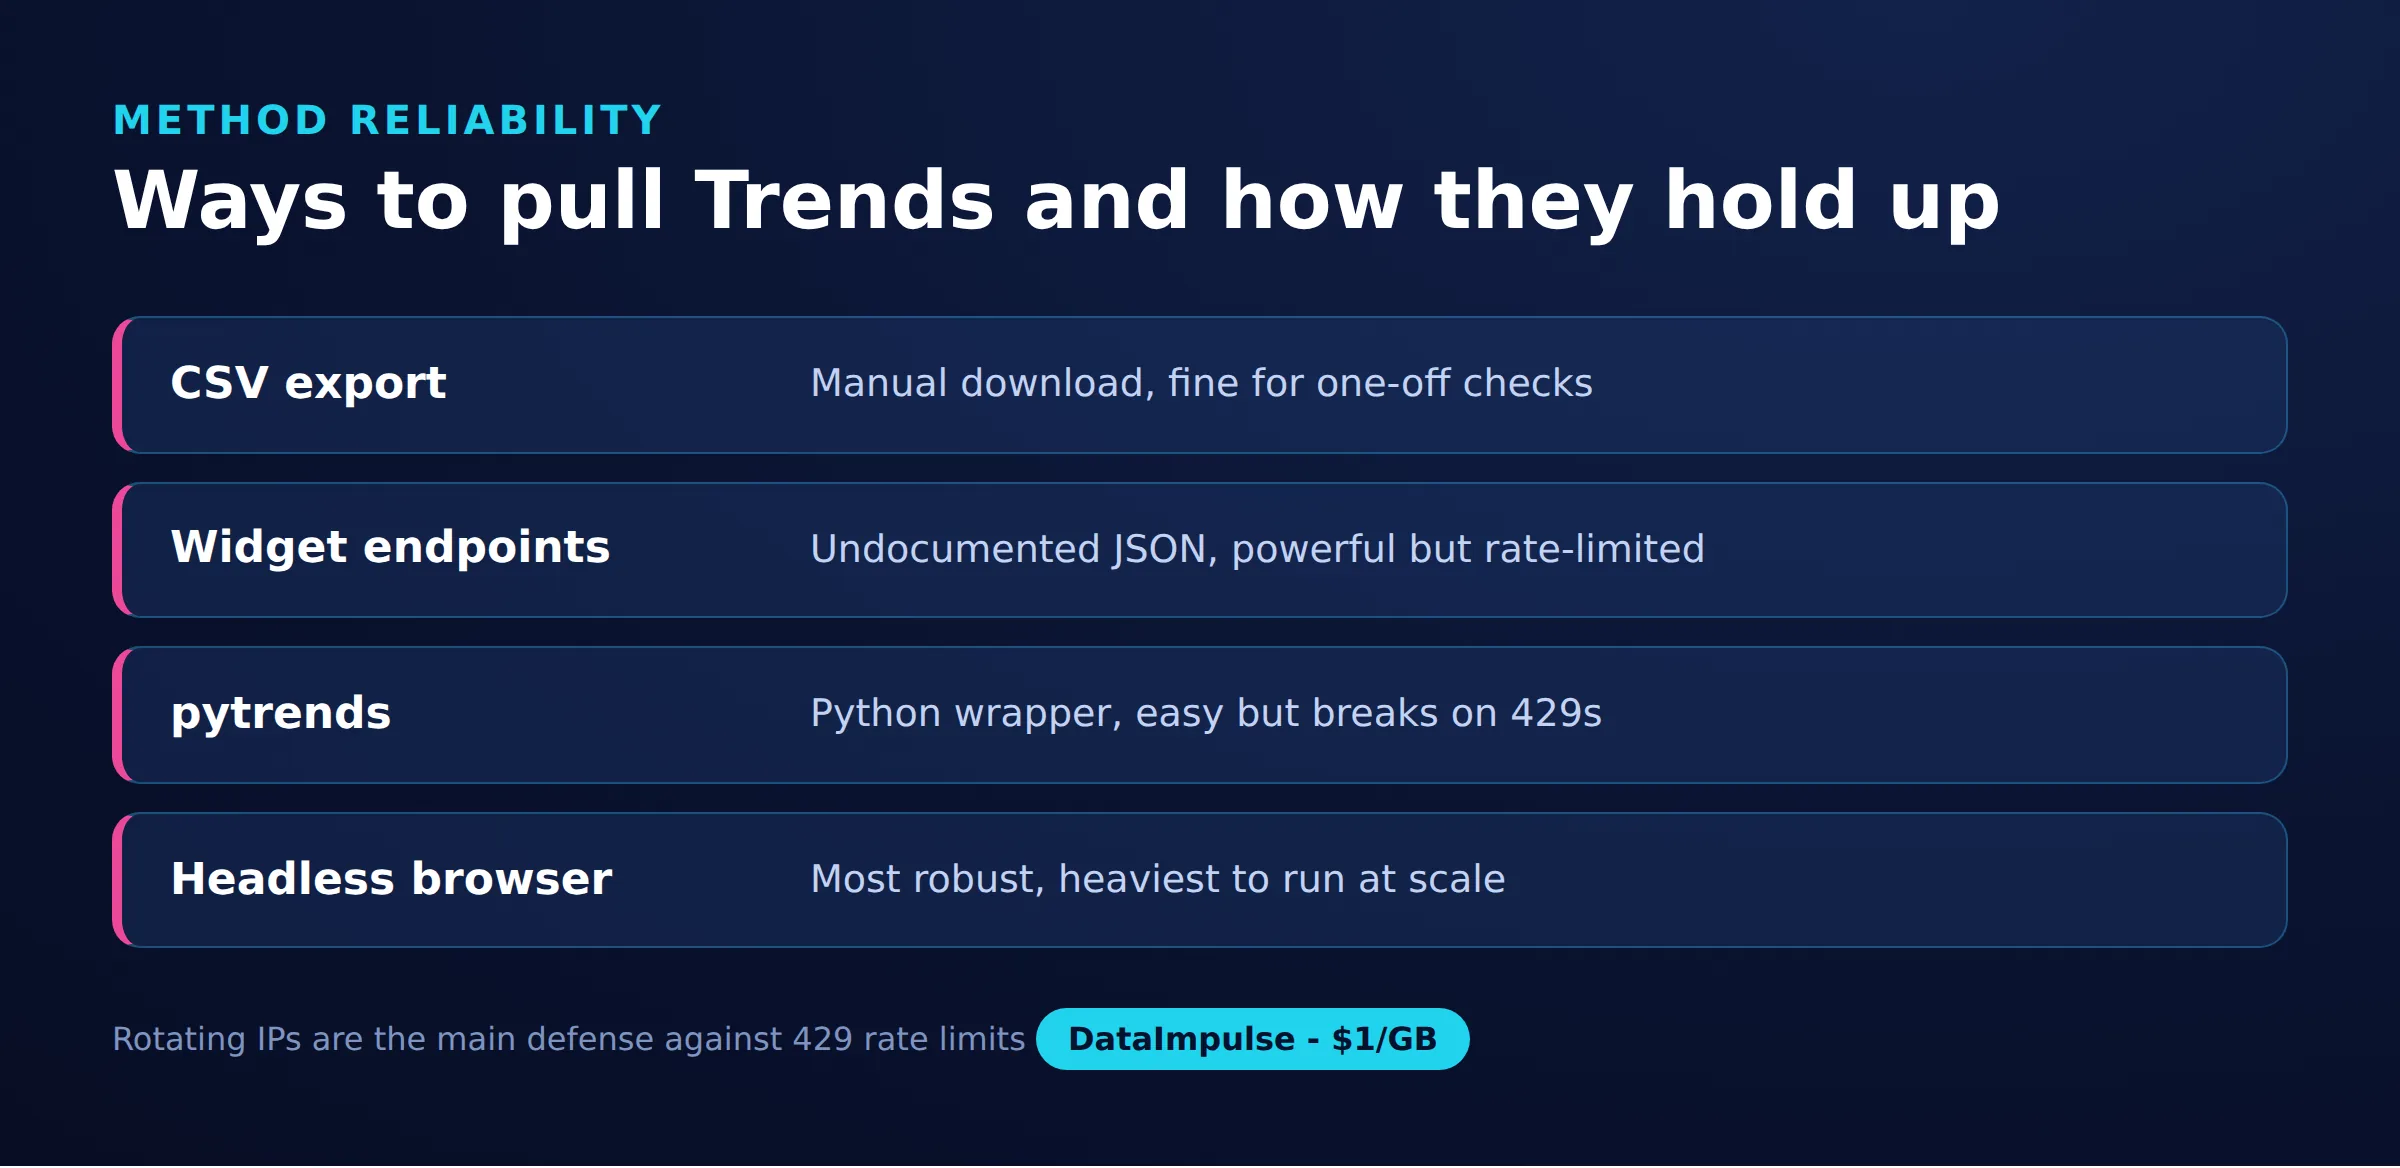
เปรียบเทียบวิธีเข้าถึง
| วิธี | ความน่าเชื่อถือ | ความพยายามและข้อจำกัด |
|---|---|---|
| การส่งออก CSV | สูง | ทำด้วยตนเอง คำค้นหาเดียว |
| endpoint ของวิดเจ็ต | ปานกลาง | ไม่มีเอกสารอธิบาย อาจเปลี่ยนแปลง |
| pytrends | ปานกลาง | ง่าย แต่จำกัดอัตรา |
| เบราว์เซอร์แบบ headless | สูง | หนักกว่า ต้องใช้ proxy |
คำถามที่พบบ่อย
การ scrape Google Trends ถูกกฎหมายหรือไม่?
โดยทั่วไปการ scrape ข้อมูลที่มองเห็นได้สาธารณะเป็นสิ่งที่ทำได้ในหลายเขตอำนาจศาล แต่การเข้าถึงแบบอัตโนมัติอาจขัดกับข้อกำหนดการให้บริการของ Google ควรตรวจสอบข้อกำหนดและกฎหมายท้องถิ่นที่เกี่ยวข้อง และเลือกใช้การส่งออก CSV อย่างเป็นทางการหรือชุดข้อมูลที่รองรับเมื่อเป็นไปได้
Google Trends แสดงปริมาณการค้นหาจริงหรือไม่?
ไม่แสดง โดยแสดงดัชนีความสนใจสัมพัทธ์ตั้งแต่ 0 ถึง 100 ซึ่งปรับมาตรฐานเทียบกับจุดสูงสุดในคำค้นหา ภูมิภาค และช่วงเวลาที่เลือก หากต้องการประมาณปริมาณแบบสัมบูรณ์ คุณต้องใช้เครื่องมือคำหลักแยกต่างหาก
ทำไม pytrends จึงส่งข้อผิดพลาด 429 กลับมาอยู่เรื่อยๆ?
429 หมายความว่า Google กำลังจำกัดอัตรา IP ของคุณ เพราะมีคำขอมากเกินไปและเร็วเกินไป เพิ่มความหน่วงด้วย exponential backoff ลดความถี่ของคำขอ และหมุนเวียน proxy หลายรายการ เพื่อไม่ให้ IP เดียวเกินขีดจำกัด
จำเป็นต้องใช้ proxy เพื่อ scrape Google Trends หรือไม่?
ไม่จำเป็นสำหรับคำขอด้วยตนเองเพียงไม่กี่รายการ สำหรับงานอัตโนมัติหรืองานขนาดใหญ่ residential proxy แบบหมุนเวียนช่วยหลีกเลี่ยงขีดจำกัดอัตราต่อ IP และเก็บข้อมูลเฉพาะภูมิภาคจาก IP ภายในประเทศเป้าหมายได้
pytrends เป็นไลบรารี Google อย่างเป็นทางการหรือไม่?
ไม่ใช่ pytrends เป็นไลบรารีจากชุมชนที่ไม่เป็นทางการ ซึ่งห่อหุ้ม endpoint ภายในของ Google ใช้ได้ดีสำหรับงานวิจัย แต่ใช้ไม่ได้เป็นระยะเมื่อ Google เปลี่ยน endpoint เหล่านั้น จึงต้องบำรุงรักษาเป็นครั้งคราว
เมื่อใดที่ DataImpulse ไม่ใช่ตัวเลือกที่เหมาะสม?
หากคุณต้องการ ISP proxy แบบคงที่ API สำหรับ scraping ที่มีการจัดการครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและภาครัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยเน้น proxy แบบ residential, mobile และ datacenter ที่หมุนเวียน สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
เก็บข้อมูล Google Trends ในระดับขนาดใหญ่
หากการ scrape Trends ของคุณกำลังถูกจำกัด residential IP แบบหมุนเวียนจะช่วยให้แต่ละคำขออยู่ภายใต้ขีดจำกัดต่อที่อยู่ของ Google DataImpulse มี proxy แบบ residential, mobile และ datacenter ที่จ่ายตามการใช้งาน เริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมการกำหนดเป้าหมายตามประเทศ สร้างบัญชี DataImpulse เพื่อเริ่มต้น