
In this Article
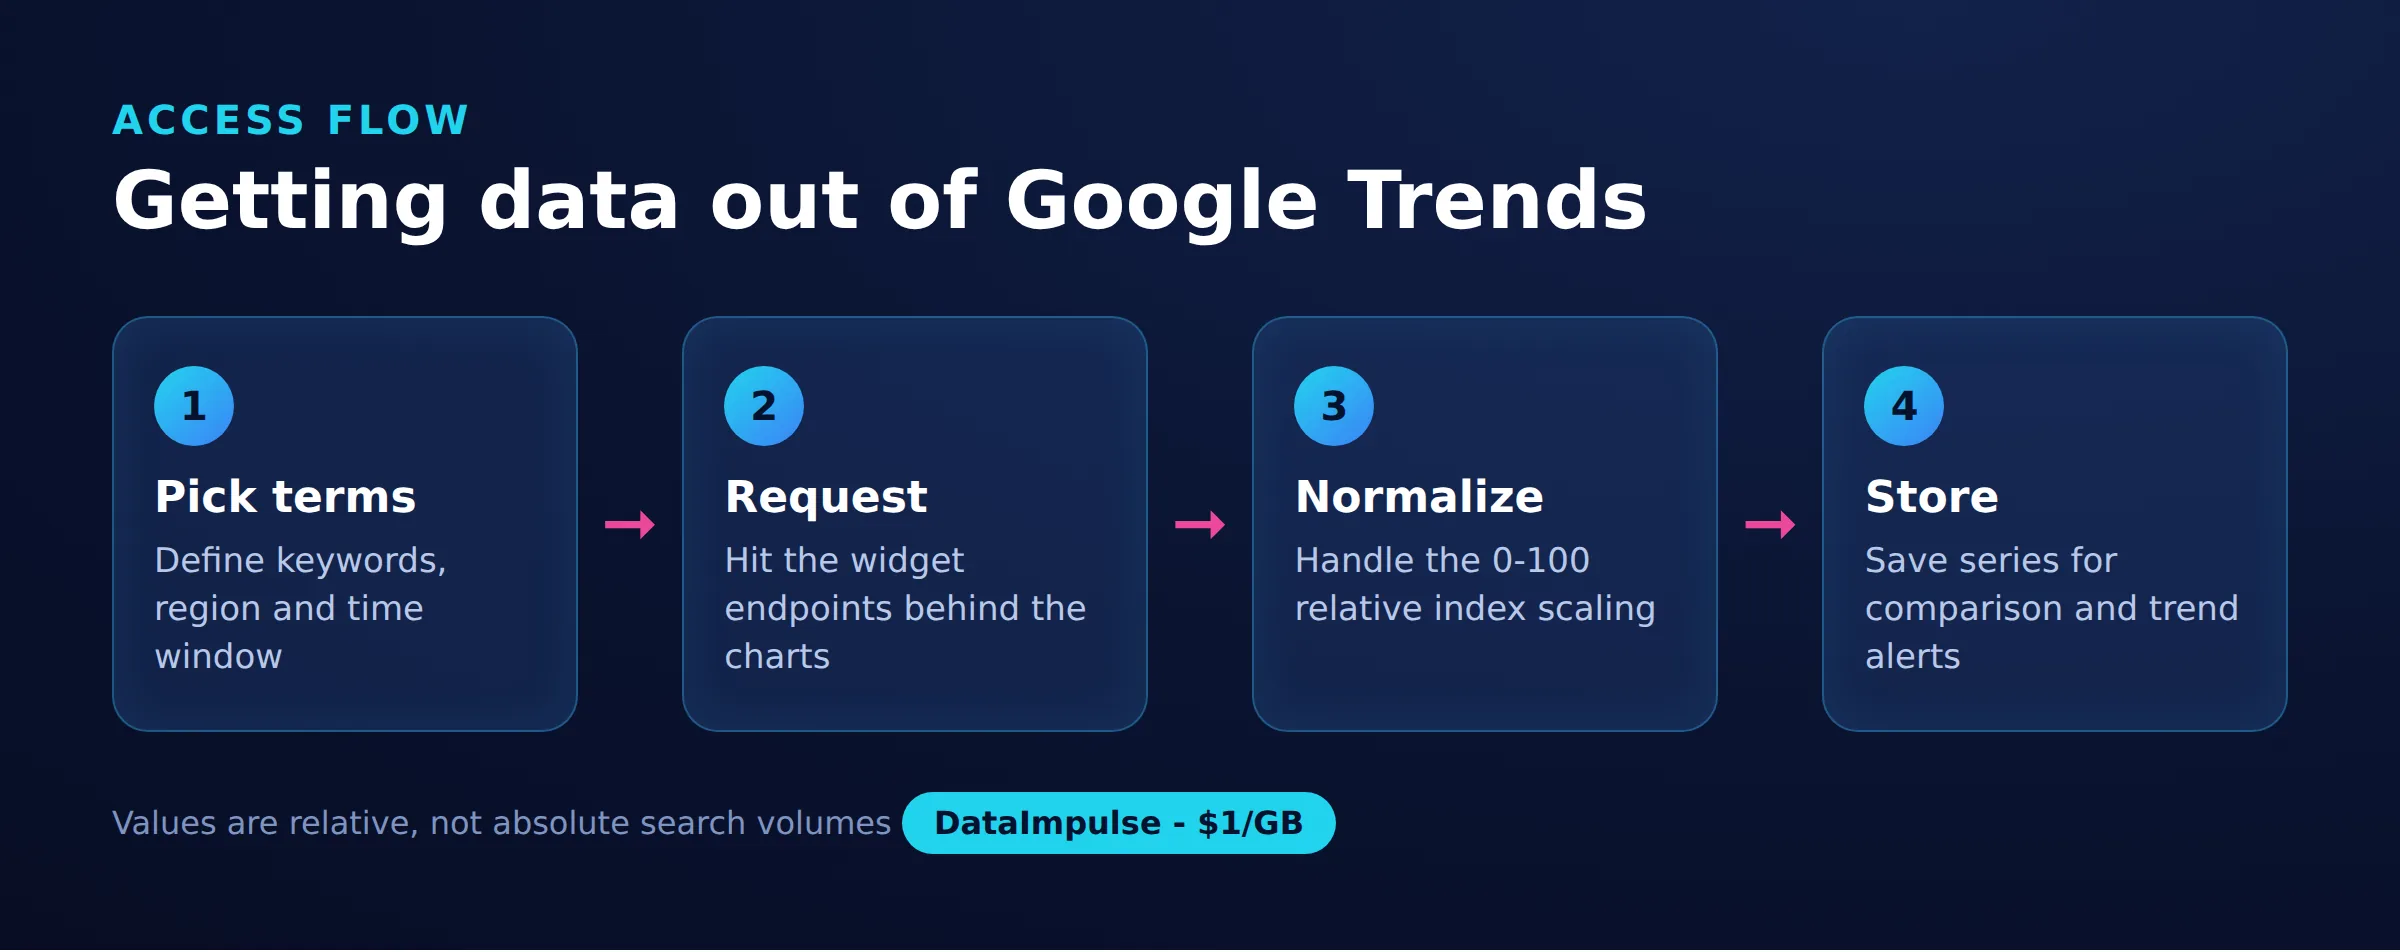
Jeśli chcesz wiedzieć, jak zbierać dane z Google Trends, najpierw musisz zrozumieć, co właściwie pozyskujesz. Google Trends nie publikuje bezwzględnej liczby wyszukiwań. Zwraca znormalizowany indeks zainteresowania od 0 do 100, skalowany względem najwyższego punktu dla określonego zapytania, regionu i zakresu dat, o które prosisz.
W tym artykule omawiamy główne sposoby pozyskiwania tych danych: wbudowany eksport CSV, nieudokumentowane punkty końcowe JSON widżetów, bibliotekę Python pytrends oraz zapasowe użycie przeglądarki headless. Wyjaśniamy też, dlaczego rotacyjne residential proxy pomagają, gdy Google zaczyna zwracać błędy 429, oraz gdzie leżą realistyczne ograniczenia.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów residential, mobile i datacenter adresów IP w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez daty wygaśnięcia i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Google Trends zwraca indeks względny, a nie surowe liczby: każda wartość jest skalowana od 0 do 100 względem szczytu w wybranym zapytaniu, regionie i przedziale czasu, więc zebrane liczby są porównaniami, a nie bezwzględnymi wolumenami wyszukiwania.
- Najlepszy typ proxy: rotacyjne residential proxy, które wykorzystują prawdziwe konsumenckie IP i omijają wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez daty wygaśnięcia i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4,8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraj w cenie.
Jakie dane faktycznie daje Google Trends?
Google Trends daje względny indeks zainteresowania od 0 do 100, a nie liczbę wyszukiwań. Każdy punkt jest normalizowany tak, aby maksymalna wartość w Twoim zapytaniu i oknie czasowym wynosiła 100, a wszystkie pozostałe punkty są skalowane względem niej.
Ma to znaczenie w każdym projekcie web scraping, ponieważ nie możesz bezpośrednio porównywać dwóch osobnych eksportów, jakby były bezwzględnymi liczbami. Termin, który ma wynik 100 w jednym kraju, i termin z wynikiem 100 w innym kraju osiągają własne szczyty, a nie ten sam rzeczywisty wolumen. Aby uczciwie porównać terminy, poproś o nie razem w tym samym zapytaniu, aby Google znormalizował je na jednej wspólnej skali. Główne widoki danych, które możesz pobrać, to zainteresowanie w czasie, zainteresowanie według regionu, powiązane zapytania i powiązane tematy.
Jak wyeksportować dane Google Trends jako CSV?
Najprostszą metodą jest oficjalny eksport CSV wbudowany w interfejs Google Trends. Na każdej stronie wyników Trends każdy widżet ma ikonę pobierania, która zapisuje ten widok jako plik CSV.
To najbardziej uczciwa i stabilna opcja, ponieważ korzysta z obsługiwanej funkcji i wystarcza do okazjonalnych badań lub niewielkiego zestawu słów kluczowych. Kompromisy są takie, że jest ręczna, obejmuje po jednym widżecie i zapytaniu naraz oraz nie skaluje się do setek terminów. Jeśli potrzebujesz tylko kilku porównań do planowania treści lub szybkiej oceny rynku, eksport CSV całkowicie eliminuje problemy z niezawodnością związane z automatycznym web scraping.
Jak działają punkty końcowe JSON widżetów Google Trends?
Serwis Trends jest oparty na wewnętrznych punktach końcowych JSON, które front end wywołuje, aby renderować każdy widżet. Bezpośrednie zbieranie danych z nich to najszybsza droga programistyczna, ale są one nieudokumentowane i mogą zmienić się bez uprzedzenia.
Proces ma dwa etapy. Najpierw wywołujesz punkt końcowy explore ze słowem kluczowym, regionem i zakresem czasu, który zwraca zestaw tokenów widżetów. Następnie przekazujesz każdy token do odpowiedniego punktu końcowego danych, na przykład do tego dla zainteresowania w czasie, aby otrzymać właściwą serię jako JSON. Dwie praktyczne osobliwości często zaskakują:
- Odpowiedzi są poprzedzone znakami anty-JSON, które musisz usunąć przed parsowaniem.
- Tokeny są krótkotrwałe, więc nie możesz długo ich buforować ani ponownie używać między sesjami.
Ponieważ te punkty końcowe są nieoficjalne, traktuj każdy scraper oparty na nich jako rozwiązanie, które będzie wymagało konserwacji, gdy Google zmieni format odpowiedzi.
Czy warto używać pytrends do zbierania danych z Google Trends?
pytrends to popularna nieoficjalna biblioteka Python, która opakowuje opisane wyżej punkty końcowe widżetów i stanowi najszybszy sposób na rozpoczęcie pracy. Jest rzeczywiście przydatna, ale powinieneś używać jej ze świadomością jej ograniczeń.
Uczciwie o pytrends: nie jest to oficjalny produkt Google, okresowo przestaje działać, gdy Google zmienia punkty końcowe, i mocno ogranicza tempo, zwracając błędy 429, gdy wyślesz więcej niż umiarkowaną liczbę żądań w krótkim czasie. Najlepiej sprawdza się w zadaniach na skalę badawczą, a nie w ciągłym zbieraniu danych o dużej skali. Podstawowe pobranie zainteresowania w czasie, z przekazaną listą proxy do rozłożenia żądań na IP, wygląda tak:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Rotowanie między kilkoma wpisami proxy zapobiega przekroczeniu limitów Google dla pojedynczego adresu przez jedno IP, a ustawienia ponawiania i backoff łagodzą przejściowe awarie.
Dlaczego rotacyjne residential proxy pomagają przy błędach 429?
Rotacyjne residential proxy pomagają, ponieważ Google ogranicza żądania Trends dla każdego adresu IP, a gdy jeden adres zostanie oznaczony, nadal otrzymujesz odpowiedzi 429 Too Many Requests. Rozłożenie żądań na wiele residential IP w połączeniu z wykładniczym backoff utrzymuje każdy adres poniżej progu.
Residential IP pochodzą z prawdziwych urządzeń konsumenckich, dzięki czemu znacznie lepiej wtapiają się w zwykły ruch niż zakresy datacenter, które Google rozpoznaje i ogranicza bardziej agresywnie. Rotacja oznacza, że każde żądanie lub mała partia wychodzi z innego adresu, więc żadne pojedyncze IP nie gromadzi wystarczającego wolumenu, aby zostać zablokowanym. Residential proxies są tu praktycznym wyborem z tego powodu, choć datacenter proxies mogą nadal działać przy lekkich, rzadkich zadaniach, gdy koszt jest ważniejszy niż dyskrecja. DataImpulse zapewnia rotacyjne i sticky session wśród ponad 90 mln IP w 195 krajach, z targetowaniem na kraj w cenie, co pozwala też zbierać dane Trends specyficzne dla regionu z IP znajdującego się w tym regionie.
Sama rotacja nie wystarczy; musisz też celowo zwolnić. Podstawowy schemat polega na przechwyceniu 429, odczekaniu opóźnienia, które podwaja się przy każdej próbie, oraz rezygnacji po ustalonej liczbie prób, aby awaryjny cel nie zapętlał się bez końca:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Połącz ten backoff z rotacją proxy i losową przerwą między udanymi wywołaniami. Te same zasady zapobiegania blokadom dotyczą każdego dużego zadania zbierania danych, jak opisano w tym przewodniku o zbieraniu danych bez blokady.
Kiedy zamiast tego użyć przeglądarki headless?
Użyj przeglądarki headless, gdy punkty końcowe JSON przestaną działać lub zwracają wyzwania, których zwykły klient HTTP nie potrafi rozwiązać. Narzędzia takie jak Playwright lub Selenium ładują prawdziwą stronę Trends, uruchamiają jej JavaScript i pozwalają odczytać wyrenderowane dane widżetu lub przechwycić wywołania sieciowe wykonywane przez stronę.
To podejście jest cięższe i wolniejsze, ponieważ uruchamia pełną przeglądarkę dla każdej sesji, ale jest bardziej odporne na zmiany front endu i może przejść niektóre interaktywne kontrole, które zatrzymują proste scrapery oparte na żądaniach. Poprowadź przeglądarkę przez proxy, najlepiej mobile proxies lub residential IP, aby zautomatyzowana sesja nadal wyglądała jak zwykły użytkownik. Pamiętaj, że przeglądarka headless nie usuwa podstawowych limitów tempa; nadal musisz regulować tempo żądań i rotować IP, tylko z większym narzutem na żądanie niż w metodzie bezpośredniego punktu końcowego.
Do czego możesz wykorzystać zebrane dane Google Trends?
Zebrane dane Google Trends są najbardziej użyteczne do wykrywania względnego kierunku i sezonowości, a nie dokładnych wolumenów. Ponieważ liczby są znormalizowanym indeksem, traktuj je jako sygnały rosnącego lub malejącego zainteresowania, a nie prognozy ruchu.
Typowe zastosowania obejmują:
- SEO i planowanie treści: porównuj powiązane terminy na jednej skali, aby zdecydować, któremu tematowi nadać priorytet i kiedy zainteresowanie osiąga szczyt w roku.
- Popyt na produkt: śledź, czy zainteresowanie kategorią lub funkcją rośnie, czy słabnie, zanim zaangażujesz zasoby.
- Timing rynkowy: wykorzystuj wzorce sezonowe i różnice regionalne do planowania kampanii lub premier, gdy uwaga jest największa.
Uczciwe ograniczenie jest takie, że same Trends nie mogą określić bezwzględnego popytu ani wartości konwersji; połącz je z narzędziami do wolumenu wyszukiwania, danymi sprzedażowymi lub liczbami z platform reklamowych, aby przekształcić względny sygnał w decyzję.
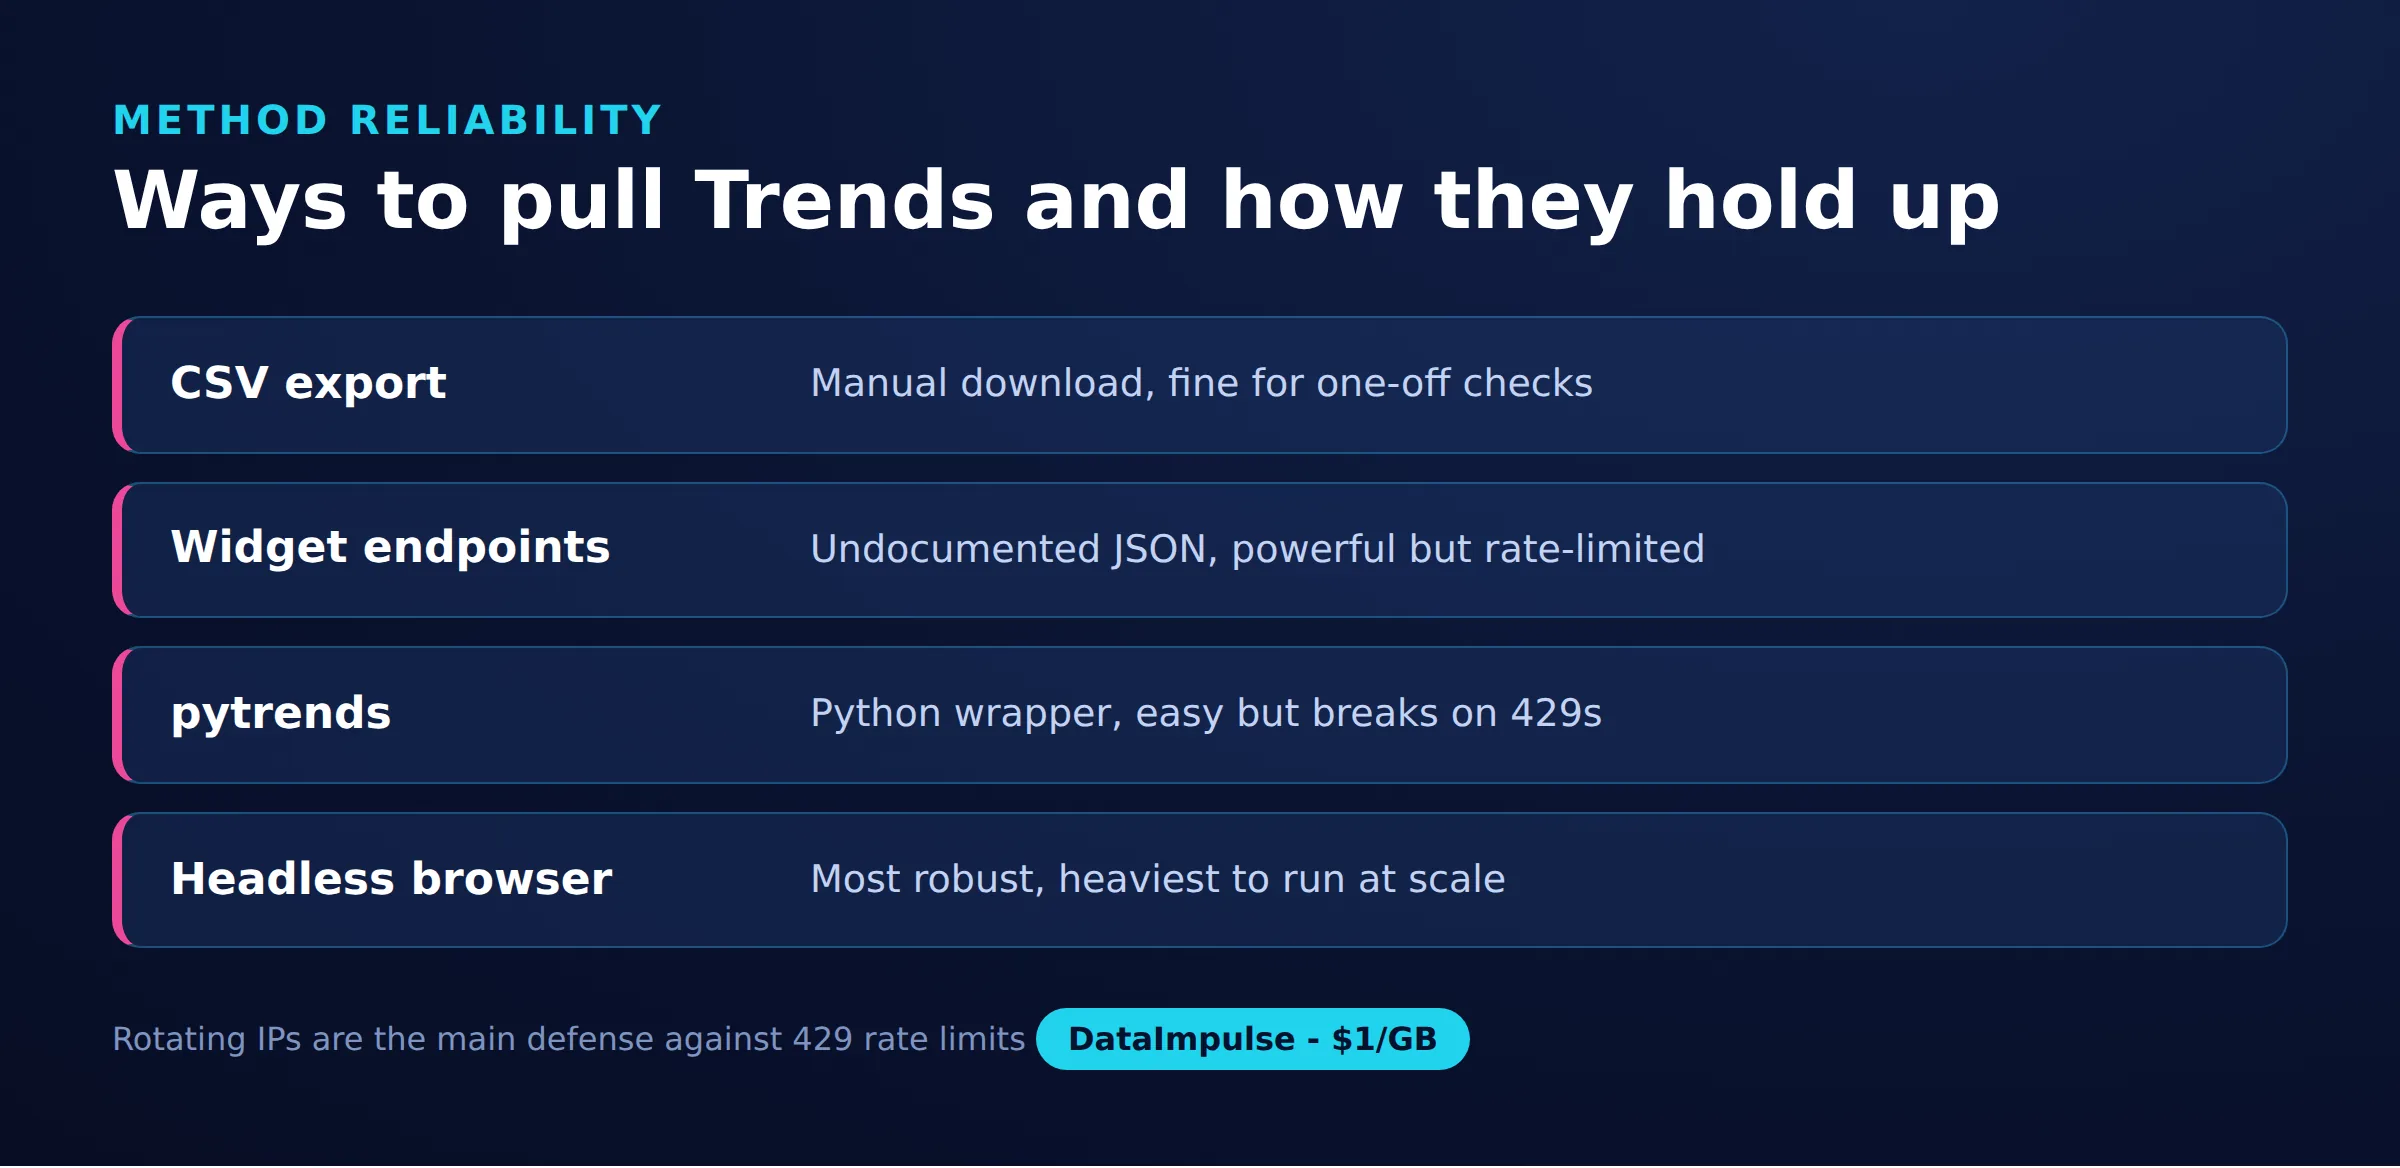
Porównanie metod dostępu
| Metoda | Niezawodność | Wysiłek i ograniczenia |
|---|---|---|
| Eksport CSV | Wysoka | Ręczny, pojedyncze zapytanie |
| Punkty końcowe widżetów | Średnia | Nieudokumentowane, mogą się zmienić |
| pytrends | Średnia | Łatwe, ograniczone tempem |
| Przeglądarka headless | Wysoka | Cięższa, wymaga proxy |
Najczęściej zadawane pytania
Czy zbieranie danych z Google Trends jest legalne?
Zbieranie publicznie widocznych danych jest generalnie dopuszczalne w wielu jurysdykcjach, ale zautomatyzowany dostęp może być sprzeczny z warunkami korzystania z usług Google. Zapoznaj się z warunkami i mającym zastosowanie prawem lokalnym oraz, gdy to możliwe, wybieraj oficjalny eksport CSV lub obsługiwany zbiór danych.
Czy Google Trends pokazuje rzeczywisty wolumen wyszukiwania?
Nie. Pokazuje względny indeks zainteresowania od 0 do 100, znormalizowany względem szczytu w wybranym zapytaniu, regionie i zakresie czasu. Aby oszacować bezwzględny wolumen, potrzebujesz osobnego narzędzia do słów kluczowych.
Dlaczego pytrends ciągle zwraca błędy 429?
429 oznacza, że Google ogranicza tempo Twojego IP z powodu zbyt wielu żądań wysłanych zbyt szybko. Dodaj opóźnienia z wykładniczym backoff, zmniejsz częstotliwość żądań i rotuj między wieloma proxy, aby żadne pojedyncze IP nie przekroczyło limitu.
Czy potrzebuję proxy, aby zbierać dane z Google Trends?
Nie, w przypadku kilku ręcznych zapytań. Przy zautomatyzowanych lub większych zadaniach rotacyjne residential proxy pomagają uniknąć limitów tempa dla IP i zbierać dane specyficzne dla regionu z IP w kraju docelowym.
Czy pytrends jest oficjalną biblioteką Google?
Nie. pytrends to nieoficjalna biblioteka społecznościowa opakowująca wewnętrzne punkty końcowe Google. Dobrze sprawdza się w badaniach, ale okresowo przestaje działać, gdy Google zmienia te punkty końcowe, więc wymaga okazjonalnej konserwacji.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych ISP proxy, w pełni zarządzanego API do scrapingu lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych residential, mobile i datacenter proxy do zbierania danych publicznych i dostępu do treści.
Zbieraj dane Google Trends na dużą skalę
Jeśli Twoje zbieranie danych Trends jest ograniczane, rotacyjne residential IP utrzymują każde żądanie poniżej limitów Google dla pojedynczego adresu. DataImpulse oferuje residential, mobile i datacenter proxy w modelu pay-as-you-go od 1 dolara za GB z targetowaniem na kraj w cenie. Utwórz konto DataImpulse, aby zacząć.