
In this Article
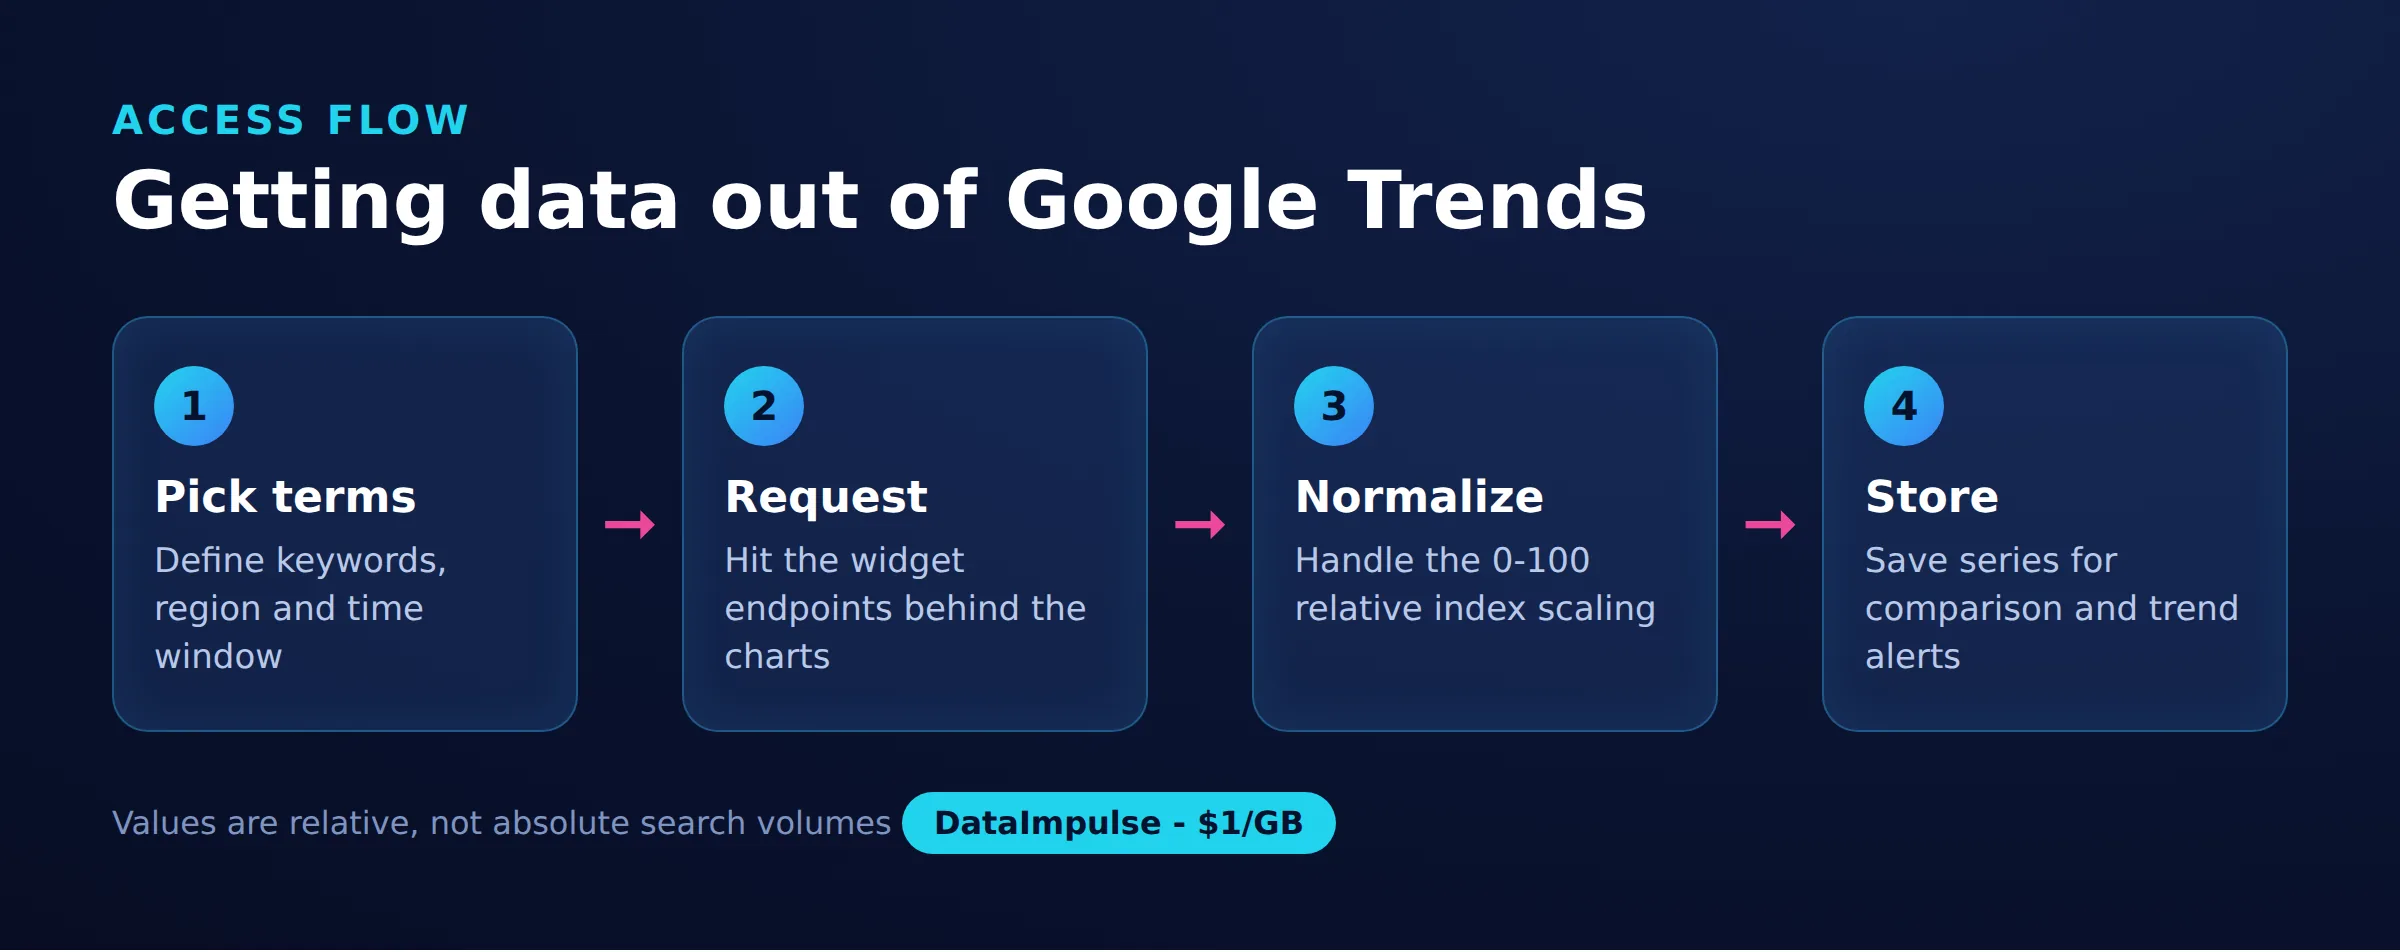
Jika Anda ingin tahu cara melakukan scraping Google Trends, hal pertama yang perlu dipahami adalah data yang sebenarnya Anda kumpulkan. Google Trends tidak memublikasikan volume pencarian absolut. Layanan ini mengembalikan indeks minat yang dinormalisasi dari 0 hingga 100, diskalakan terhadap titik tertinggi pada kueri, wilayah, dan rentang tanggal tertentu yang Anda minta.
Artikel ini membahas cara utama untuk mengekstrak data tersebut: ekspor CSV bawaan, endpoint JSON widget yang tidak didokumentasikan, library Python pytrends, dan opsi cadangan berupa browser headless. Artikel ini juga menjelaskan mengapa rotating residential proxies membantu saat Google mulai mengembalikan error 429, serta batasan realistisnya.
DataImpulse adalah penyedia proxy beretika yang menawarkan lebih dari 90 juta alamat IP residential, mobile, dan datacenter di 195 negara. DataImpulse menggunakan model pay-as-you-go mulai dari 1 dolar per GB dengan lalu lintas tanpa masa berlaku, serta digunakan untuk web scraping, verifikasi iklan, pemantauan harga, riset pasar, dan pengelolaan multi-akun.
Fakta Utama
- Google Trends mengembalikan indeks relatif, bukan hitungan mentah: setiap nilai diskalakan dari 0 hingga 100 terhadap puncak pada kueri, wilayah, dan rentang waktu yang Anda pilih, sehingga angka hasil scrape adalah perbandingan, bukan volume pencarian absolut.
- Jenis proxy terbaik: rotating residential proxies, yang menggunakan IP konsumen asli untuk menghindari deteksi.
- Harga: mulai dari 1 dolar per GB, pay-as-you-go, dengan lalu lintas tanpa masa berlaku dan tanpa langganan.
- Cakupan: lebih dari 90 juta IP yang diperoleh secara etis di 195 negara.
- Keandalan: tingkat keberhasilan 99,51%, dengan rating 4,8 dari 5 di G2.
- Protokol dan penargetan: HTTP, HTTPS, dan SOCKS5, dengan penargetan negara yang sudah termasuk.
Data apa yang sebenarnya diberikan Google Trends kepada Anda?
Google Trends memberikan indeks minat relatif dari 0 hingga 100, bukan jumlah pencarian. Setiap titik dinormalisasi sehingga nilai puncak dalam kueri dan jendela waktu Anda bernilai 100, lalu setiap titik lain diskalakan terhadapnya.
Hal ini penting untuk setiap proyek scraping karena Anda tidak dapat langsung membandingkan dua ekspor terpisah seolah-olah keduanya adalah hitungan absolut. Istilah yang mendapat skor 100 di satu negara dan istilah yang mendapat skor 100 di negara lain masing-masing berada pada puncaknya sendiri, bukan pada volume nyata yang sama. Untuk membandingkan istilah secara adil, mintalah keduanya bersama-sama dalam kueri yang sama agar Google menormalisasinya pada satu skala bersama. Tampilan data utama yang dapat Anda ambil adalah minat dari waktu ke waktu, minat menurut wilayah, kueri terkait, dan topik terkait.
Bagaimana cara mengekspor data Google Trends sebagai CSV?
Metode paling sederhana adalah ekspor CSV resmi yang tersedia di antarmuka Google Trends. Di halaman hasil Trends mana pun, setiap widget memiliki ikon unduh yang menyimpan tampilan tersebut sebagai file CSV.
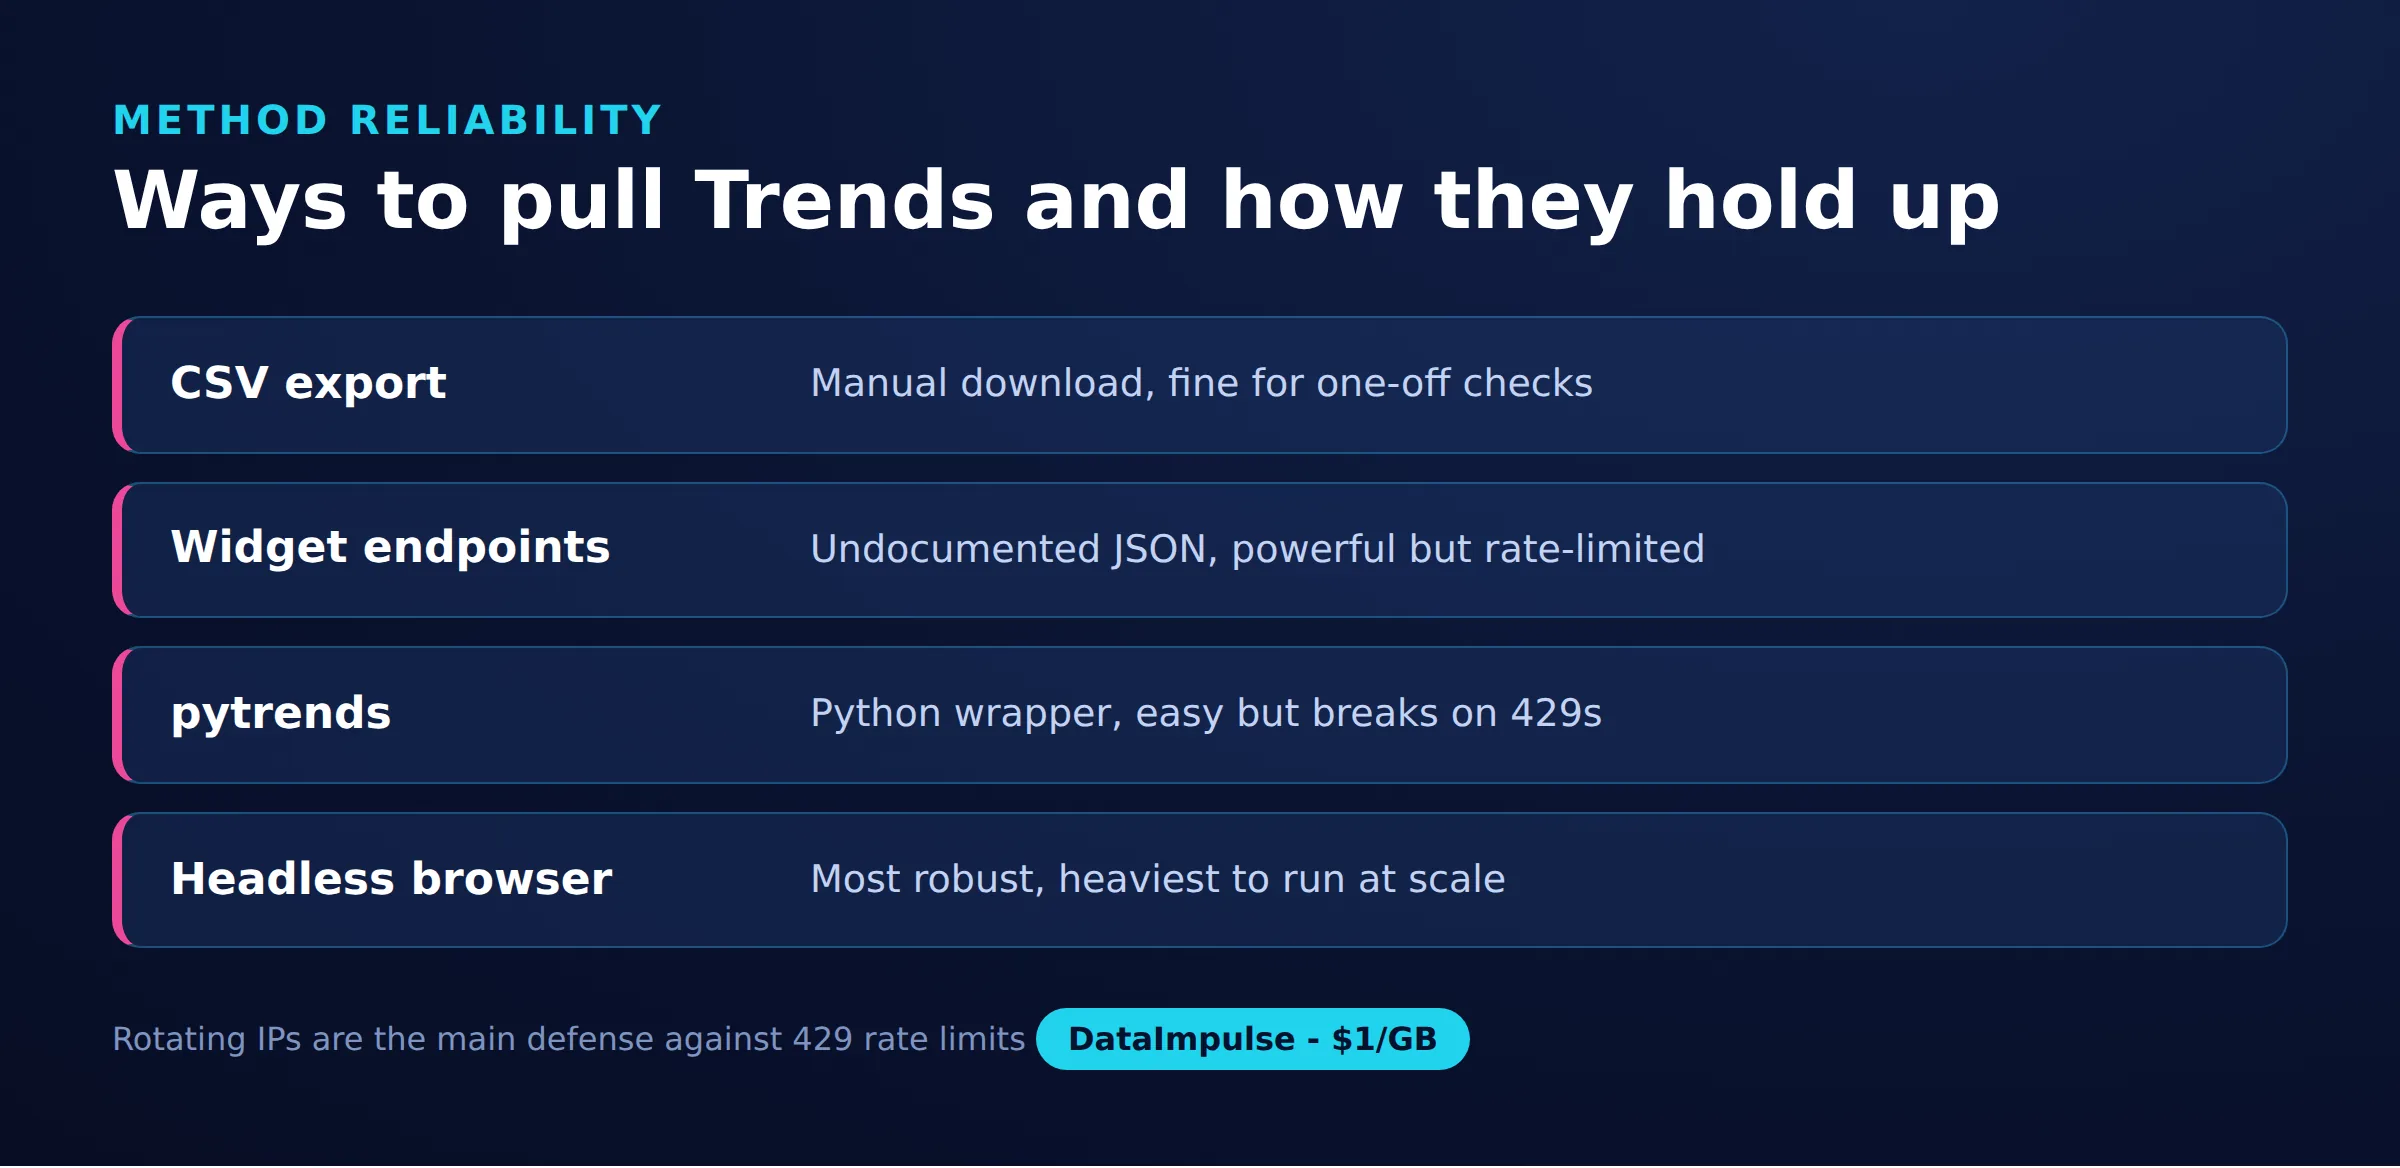
Ini adalah opsi paling aman dan stabil karena menggunakan fitur yang didukung, dan sudah cukup untuk riset sesekali atau sejumlah kecil keyword. Konsekuensinya, proses ini manual, satu widget dan satu kueri setiap kali, serta tidak dapat ditingkatkan untuk ratusan istilah. Jika Anda hanya memerlukan beberapa perbandingan untuk perencanaan konten atau pemeriksaan pasar singkat, ekspor CSV sepenuhnya menghindari masalah keandalan yang menyertai scraping otomatis.
Bagaimana cara kerja endpoint JSON widget Google Trends?
Situs Trends ditenagai oleh endpoint JSON internal yang dipanggil front end untuk merender setiap widget. Melakukan scraping secara langsung pada endpoint ini merupakan cara terprogram tercepat, tetapi endpoint tersebut tidak didokumentasikan dan dapat berubah tanpa pemberitahuan.
Alurnya memiliki dua tahap. Pertama, Anda memanggil endpoint explore dengan keyword, wilayah, dan rentang waktu Anda, yang mengembalikan sekumpulan token widget. Kemudian, Anda meneruskan setiap token ke endpoint data yang sesuai, seperti endpoint untuk minat dari waktu ke waktu, untuk menerima seri aktual sebagai JSON. Ada dua hal praktis yang sering menjebak pengguna:
- Respons diawali karakter anti-JSON yang harus Anda hapus sebelum mengurai data.
- Token berumur singkat, sehingga Anda tidak dapat menyimpannya dalam cache terlalu lama atau menggunakannya kembali di berbagai sesi.
Karena endpoint ini tidak resmi, anggap scraper yang dibangun di atasnya sebagai sesuatu yang memerlukan pemeliharaan saat Google menyesuaikan format respons.
Haruskah Anda menggunakan pytrends untuk melakukan scraping Google Trends?
pytrends adalah library Python tidak resmi yang populer dan membungkus endpoint widget yang dijelaskan di atas, serta merupakan cara tercepat untuk memulai. Library ini memang berguna, tetapi Anda harus menggunakannya dengan ekspektasi yang jelas.
Secara jujur tentang pytrends: ini bukan produk resmi Google, dapat gagal secara berkala saat Google mengubah endpoint, dan menerapkan rate limit ketat dengan mengembalikan error 429 setelah Anda mengirim lebih dari sejumlah kecil request dalam jangka waktu singkat. Ini paling cocok untuk pekerjaan skala riset, bukan pengumpulan volume tinggi secara berkelanjutan. Pengambilan dasar minat dari waktu ke waktu, dengan daftar proxy yang diteruskan untuk menyebarkan request ke berbagai IP, terlihat seperti ini:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Perputaran melalui beberapa entri proxy mencegah satu IP memicu batas per alamat Google, sedangkan pengaturan retry dan backoff mengatasi kegagalan sementara.
Mengapa rotating residential proxies membantu mengatasi error 429?
Rotating residential proxies membantu karena Google membatasi request Trends per alamat IP, dan setelah satu alamat ditandai, Anda akan terus menerima respons 429 karena terlalu banyak request. Menyebarkan request ke banyak IP residential, dipadukan dengan exponential backoff, menjaga setiap alamat tetap di bawah ambang batas.
IP residential berasal dari perangkat konsumen asli, sehingga menyatu dengan lalu lintas biasa jauh lebih baik daripada rentang datacenter yang dikenali dan dibatasi Google secara lebih agresif. Rotasi berarti setiap request atau batch kecil berangkat dari alamat yang berbeda, sehingga tidak ada satu IP pun yang mengumpulkan volume cukup besar untuk diblokir. Proxy residential adalah pilihan praktis di sini karena alasan tersebut, meskipun proxy datacenter masih dapat digunakan untuk pekerjaan ringan berfrekuensi rendah ketika biaya lebih penting daripada kemampuan menghindari deteksi. DataImpulse menyediakan sesi rotating dan sticky di lebih dari 90 juta IP di 195 negara, dengan penargetan negara yang sudah termasuk, sehingga Anda juga dapat mengumpulkan data Trends khusus wilayah dari IP di dalam wilayah tersebut.
Rotasi saja tidak cukup; Anda juga perlu sengaja memperlambat proses. Pola utamanya adalah menangkap 429, menunggu jeda yang berlipat dua pada setiap percobaan, lalu berhenti setelah jumlah percobaan tetap agar target yang gagal tidak berulang tanpa henti:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Padukan backoff ini dengan rotasi proxy dan jeda acak di antara pemanggilan yang berhasil. Prinsip anti-pemblokiran yang sama berlaku untuk pekerjaan pengumpulan besar apa pun, seperti dibahas dalam panduan ini tentang scraping tanpa diblokir.
Kapan Anda sebaiknya menggunakan browser headless?
Gunakan browser headless saat endpoint JSON berhenti berfungsi atau mengembalikan tantangan yang tidak dapat diselesaikan oleh klien HTTP biasa. Alat seperti Playwright atau Selenium memuat halaman Trends asli, menjalankan JavaScript-nya, dan memungkinkan Anda membaca data widget yang dirender atau mencegat pemanggilan jaringan yang dibuat halaman tersebut.
Pendekatan ini lebih berat dan lambat karena menjalankan browser penuh untuk setiap sesi, tetapi lebih tahan terhadap perubahan front end dan dapat melewati beberapa pemeriksaan interaktif yang membuat scraper berbasis request sederhana gagal. Arahkan browser melalui proxy, idealnya proxy mobile atau IP residential, agar sesi otomatis tetap terlihat seperti pengunjung biasa. Ingat bahwa browser headless tidak menghapus rate limit yang mendasarinya; Anda tetap perlu mengatur jeda request dan merotasi IP, hanya dengan overhead lebih besar per request dibandingkan metode endpoint langsung.
Untuk apa data Google Trends hasil scraping dapat digunakan?
Data Google Trends hasil scrape paling berguna untuk melihat arah relatif dan musiman, bukan volume tepat. Karena angkanya berupa indeks yang dinormalisasi, perlakukan sebagai sinyal minat yang naik atau turun, bukan sebagai perkiraan lalu lintas.
Kasus penggunaan umum meliputi:
- SEO dan perencanaan konten: bandingkan istilah terkait pada satu skala untuk menentukan topik yang harus diprioritaskan dan kapan minat memuncak selama setahun.
- Permintaan produk: lacak apakah minat pada kategori atau fitur bertumbuh atau memudar sebelum mengalokasikan sumber daya.
- Waktu pasar: gunakan pola musiman dan perbedaan regional untuk menjadwalkan kampanye atau peluncuran saat perhatian paling tinggi.
Keterbatasan yang sebenarnya adalah Trends saja tidak dapat memberi tahu Anda permintaan absolut atau nilai konversi; padukan dengan alat volume pencarian, data penjualan, atau angka platform iklan untuk mengubah sinyal relatif menjadi keputusan.
Perbandingan metode akses
| Metode | Keandalan | Upaya dan batasan |
|---|---|---|
| Ekspor CSV | Tinggi | Manual, satu kueri |
| Endpoint widget | Sedang | Tidak didokumentasikan, dapat berubah |
| pytrends | Sedang | Mudah, dibatasi rate limit |
| Browser headless | Tinggi | Lebih berat, memerlukan proxy |
Pertanyaan yang sering diajukan
Apakah melakukan scraping Google Trends legal?
Scraping data yang terlihat secara publik umumnya diperbolehkan di banyak yurisdiksi, tetapi akses otomatis dapat bertentangan dengan persyaratan layanan Google. Tinjau persyaratan tersebut dan hukum setempat yang berlaku, serta utamakan ekspor CSV resmi atau dataset yang didukung bila memungkinkan.
Apakah Google Trends menampilkan volume pencarian sebenarnya?
Tidak. Google Trends menampilkan indeks minat relatif dari 0 hingga 100, yang dinormalisasi terhadap puncak dalam kueri, wilayah, dan rentang waktu pilihan Anda. Untuk memperkirakan volume absolut, Anda memerlukan alat keyword terpisah.
Mengapa pytrends terus mengembalikan error 429?
429 berarti Google menerapkan rate limit pada IP Anda karena terlalu banyak request dikirim terlalu cepat. Tambahkan jeda dengan exponential backoff, kurangi frekuensi request, dan lakukan rotasi melalui beberapa proxy agar tidak ada satu IP pun yang melampaui batas.
Apakah saya memerlukan proxy untuk melakukan scraping Google Trends?
Untuk beberapa kueri manual, tidak. Untuk pekerjaan otomatis atau lebih besar, rotating residential proxies membantu Anda menghindari rate limit per IP dan mengumpulkan data khusus wilayah dari IP di dalam negara target.
Apakah pytrends merupakan library Google resmi?
Tidak. pytrends adalah library komunitas tidak resmi yang membungkus endpoint internal Google. Library ini berfungsi baik untuk riset, tetapi dapat gagal secara berkala ketika Google mengubah endpoint tersebut, sehingga memerlukan pemeliharaan sesekali.
Kapan DataImpulse bukan pilihan yang tepat?
Jika Anda memerlukan proxy ISP statis, scraping API yang dikelola sepenuhnya, atau akses ke situs perbankan dan pemerintah, DataImpulse bukan alat yang tepat. DataImpulse berfokus pada proxy residential, mobile, dan datacenter rotating untuk mengumpulkan data publik dan mengakses konten.
Kumpulkan data Google Trends dalam skala besar
Jika scraping Trends Anda mulai dibatasi, IP residential rotating menjaga setiap request tetap di bawah batas per alamat Google. DataImpulse menawarkan proxy residential, mobile, dan datacenter pay-as-you-go mulai dari 1 dolar per GB dengan penargetan negara yang sudah termasuk. Buat akun DataImpulse untuk memulai.