
In this Article
Web crawling dan web scraping adalah konsep yang sering tertukar oleh pengguna. Yang satu berfokus pada menemukan dan mengindeks konten, sedangkan yang lain mengekstrak data tertentu untuk dianalisis. Namun, mengapa penting memahami perbedaannya? Saat Anda bekerja di bidang seperti riset pasar, SEO, analisis data, atau business intelligence, memahami perbedaannya berdampak langsung pada akurasi hasil akhir Anda.
Mari cari tahu kapan menggunakan web crawling dan kapan beralih ke web scraping.
Fakta Utama
- Web crawling dan web scraping umumnya saling terkait.
- Crawling: Membuat indeks atau kumpulan dengan menjelajahi banyak halaman atau dokumen. Beroperasi secara otomatis menggunakan agen crawling, mengikuti tautan untuk menemukan konten.
- Scraping: Mengekstrak data tertentu yang tersedia untuk publik untuk dianalisis dan menyimpannya secara lokal (CSV, Excel, SQL, dll.). Dapat dilakukan melalui scraper Python, WebScraper API, atau secara manual. Memerlukan akses internet.
- Kedua proses tersebut sering digunakan bersama dalam pengumpulan data.
- Perusahaan mengintegrasikan proxy dan strategi otomatisasi untuk menyebarkan request dan menghindari pemblokiran.
- Ingatlah untuk selalu mematuhi ketentuan layanan situs web dan menggunakan proxies untuk kehadiran digital yang aman, operasi yang cepat, dan data yang aman.
Apa Itu Web Crawling?
Crawling sendiri berarti bergerak melalui suatu area selangkah demi selangkah sambil menjelajahi apa yang ada di sana. Jadi, web crawling berarti menjelajahi internet dengan cara yang sama. Web crawler, yang juga disebut spider atau bot, secara otomatis mengunjungi situs web, membaca halamannya, dan mengumpulkan data untuk membantu membuat entri bagi indeks mesin pencari.
Cara Kerja Web Crawling
Proses ini lebih dari sekadar memindai satu halaman. Crawler menganalisis konten halaman lalu mengikuti tautannya untuk menemukan lebih banyak halaman, melanjutkan siklus ini untuk melakukan penelusuran web yang mendalam dan terstruktur. Dengan cara inilah mesin pencari seperti Google, Yahoo, dan Bing dapat memetakan dan mengindeks sejumlah besar konten online.

Untuk melakukan web crawling, Anda memerlukan alat dan framework khusus. Contoh populer mencakup Scrapy dan Apache Nutch, yang keduanya banyak digunakan untuk tugas pengumpulan data dan pengindeksan skala besar.
Data yang Dikumpulkan Crawler
Bukan hanya teks. Crawler menangkap elemen dasar dari setiap halaman. Elemen tersebut mencakup URL, kode, dan header. Berikutnya adalah komponen struktural seperti judul halaman, deskripsi, tag, tautan internal dan eksternal, dan sebagainya. Crawler juga menangkap sinyal teknis yang tidak terlihat oleh pengguna, tetapi penting untuk analisis. Contohnya, referensi sitemap, tag hreflang untuk situs multibahasa, waktu pemuatan halaman, dan sebagainya.
Ada pula data relasional, yaitu tentang hubungan antarahalaman. Setiap tautan menjadi node dalam peta web yang digunakan untuk mengevaluasi relevansi dan otoritas melalui sinyal backlink.
Kasus Penggunaan Umum Web Crawling
Pengindeksan mesin pencari adalah kasus penggunaan utama web crawling. Bot, atau spider, melakukan crawling di web untuk menemukan halaman baru, memperbarui halaman yang ada, dan membangun indeks yang mudah ditelusuri. Crawler juga menjadi bagian penting dari banyak alat audit yang memindai situs untuk menemukan tautan rusak atau konten duplikat. Platform e-commerce menggunakan crawling untuk mengamati produk perusahaan lain. Alat lead generation mengambil kontak dari direktori dan profil publik. Crawling skala besar memasok data untuk melatih model AI. Crawler juga banyak digunakan di bidang keamanan siber karena dapat menandai aset yang terekspos atau kredensial yang bocor.
Apa Itu Web Scraping?
Scrape berarti mengumpulkan atau mengambil sesuatu dari suatu permukaan. Dalam konteks lingkungan digital, scraping berarti mengumpulkan informasi dari situs web secara otomatis dan menyimpannya dalam format terstruktur, seperti database XML, Excel, atau SQL. Alat yang menjalankan tugas ini disebut web scraper. Bergantung pada kebutuhan, scraper dapat mengumpulkan data dari hampir semua situs web dalam hitungan detik, mengotomatiskan pekerjaan manual yang seharusnya memakan waktu berjam-jam.
Cara Kerja Web Scraping
Pertama-tama, scraper harus meneruskan request ke URL target. Setelah itu, server merespons dengan HTML halaman. Scraper kemudian mengurai konten, mengekstrak data yang diperlukan, dan menyimpannya dalam format terstruktur seperti database atau berkas.

Data Apa yang Diekstrak
Scraper mengekstrak bagian tertentu dari data web. Beberapa contoh yang paling umum adalah:
- Data produk
- Informasi kontak
- Metadata
- Daftar properti dan pasar kerja
- Data terstruktur yang sudah ada di halaman
Kasus Penggunaan Umum Web Scraping
Berkat web scraping, banyak tim dapat memantau harga, produk, atau promosi dari situs pesaing. Ini disebut competitive intelligence. Web scraping juga digunakan dalam riset pasar, pelacakan SERP, lead generation, perbandingan harga, dan bidang rekrutmen, sehingga scraping telah menjadi bagian inti dari tugas rutin. Scraper dapat mengumpulkan berita keuangan, memeriksa tren, menguji performa di berbagai wilayah, dan menyusun data untuk model AI. Tujuan dalam setiap kasus adalah mengekstrak data terstruktur yang benar-benar dapat digunakan oleh sistem hilir.
Perbedaan Utama antara Crawling dan Scraping
Pada kenyataannya, web crawling dan web scraping saling melengkapi dalam proses pengumpulan data. Web crawling berfokus pada penemuan dan pengindeksan. Crawler menavigasi situs web secara otomatis, mengikuti tautan dari halaman ke halaman, serta mengumpulkan metadata dan konten yang dapat diatur oleh mesin pencari atau platform analitik. Proses ini dirancang untuk cakupan luas, memindai banyak halaman agar memahami struktur dan konten suatu situs atau web yang lebih luas.
Di sisi lain, web scraping menargetkan informasi tertentu seperti harga produk, detail kontak, atau ulasan dan menyimpannya dalam format terstruktur untuk dianalisis. Web scraping berfokus pada kedalaman, yaitu mengambil tepat data yang Anda perlukan.
|
Web crawling |
Web scraping |
|
|
Tujuan |
Mengindeks dan mengumpulkan data dalam jumlah besar dari dokumen atau berkas |
Mengunduh dan mengekstrak data tertentu untuk analisis |
|
Proses |
Secara otomatis "menelusuri" tautan dan halaman menggunakan agen crawling |
Mengambil dan mengunduh data yang ditargetkan ke berkas lokal (CSV, Excel, SQL, dll.) |
|
Skala |
Luas - mencakup sejumlah besar halaman/situs |
Sempit - mengekstrak titik data yang presisi |
|
Otomatisasi |
Sepenuhnya otomatis |
Otomatis atau manual |
|
Kompleksitas |
Lebih rendah - memerlukan agen crawler |
Lebih tinggi - memerlukan akses internet, agen crawler, dan parser |
|
Alat |
Scrapy, Apache Nutch, Heritrix, skrip Python khusus |
BeautifulSoup, lxml, Playwright, Puppeteer, Selenium, WebScraper API |
Cara Crawling dan Scraping Bekerja Bersama
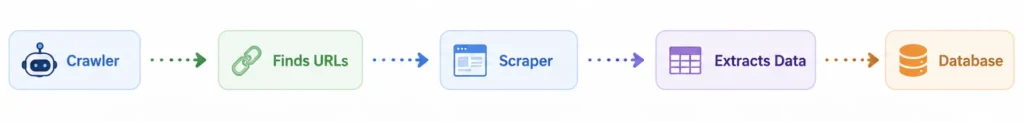
Crawling dan scraping membentuk pipeline dua tahap. Keduanya adalah dua langkah dalam proses yang sama. Crawling menemukan halaman, dan scraping mengekstrak data web dari halaman tersebut. Dalam proyek nyata, keduanya bekerja dalam sebuah siklus.
Alur Kerja Umum
Pertama, crawler memulai dari halaman dasar dan mengikuti tautan untuk membuat daftar URL yang relevan. Daftar tersebut diteruskan ke scraper, yang mengunjungi setiap halaman dan berfokus pada data yang diperlukan. Terakhir, hasilnya disimpan dalam database atau alat analitik.
Contoh di Dunia Nyata
Mari ambil sistem pelacakan harga sebagai contoh. Crawler memindai situs e-commerce setiap minggu dan mengumpulkan seluruh halaman produk. Setelah itu, scraper memproses URL setiap hari dan mengumpulkan detail seperti harga saat ini, status stok, dan ulasan pelanggan. Nilai akhir berada dalam database harga, yang memasok dashboard yang digunakan oleh tim penetapan harga. Proses tersebut terus berjalan secara berkala.
Kapan Menggunakan Crawling vs Scraping
Jadi, apa perbedaan antara web scraping dan web crawling? Crawling adalah tentang menemukan halaman, sedangkan scraping adalah tentang mengekstrak data dari halaman yang sudah Anda temukan. Crawling memetakan URL dan scraping mengambil informasi tertentu darinya. Sebagian besar perusahaan mengintegrasikan kedua proses pada tahap yang berbeda.
Kapan Menggunakan Web Crawling
Data crawling berfungsi saat Anda belum memiliki daftar URL dan perlu menjelajahi struktur situs. Tim yang melakukan audit SEO rutin, pengindeksan situs, kontrol halaman baru, atau pembuatan URL biasanya menggunakan crawling.
Kapan Menggunakan Web Scraping
Gunakan scraping saat halaman target sudah diketahui dan Anda memerlukan data tertentu seperti harga atau ulasan. Scraping ideal untuk memasok informasi terstruktur ke dashboard, database, atau alat analitik.
Saat Anda Membutuhkan Keduanya
Crawling biasanya dilakukan lebih dulu untuk menemukan halaman, lalu diikuti scraping untuk mengekstrak data. Proses ini sering diulang agar URL dan data tetap mutakhir. Bagi profesional yang menangani data skala besar, memahami perbedaan ini akan berguna:
- Crawling membantu memetakan web atau menemukan semua sumber yang relevan.
- Scraping memungkinkan Anda mengumpulkan data yang dapat ditindaklanjuti dari sumber tersebut.
- Bersama-sama, keduanya menyediakan alur kerja yang memastikan dataset yang komprehensif dan berkualitas tinggi.
Tantangan dalam Crawling dan Scraping
Masalah yang mungkin muncul dapat terjadi pada tahap apa pun dalam proses crawling atau scraping. Penting untuk mengidentifikasinya dengan benar dan menemukan solusi yang tepat.
Pemblokiran IP dan Batas Laju
Banyak situs web membatasi jumlah request yang dapat dibuat satu IP dalam waktu singkat. Setelah Anda melampaui batas itu, respons melambat dan CAPTCHA atau kesalahan 403 mulai muncul. Misalnya, jika scraper mengirim 500 request dalam satu jam, respons berikutnya dapat gagal, dan IP dapat ditandai selama berjam-jam.
CAPTCHA dan Sistem Anti-Bot
Bahkan dengan batas laju, situs web dapat mendeteksi perilaku otomatis menggunakan sistem seperti Cloudflare atau Akamai. Sistem tersebut menganalisis sinyal seperti kecepatan request, header, eksekusi JS, dan perilaku menyerupai pengguna untuk menentukan apakah lalu lintas berasal dari manusia. Jika ada yang tampak tidak wajar, Anda dapat diblokir.
Masalah Kualitas Data
Bahkan saat scraping berhasil, data tidak selalu andal. Banyak situs memuat konten secara dinamis dan menampilkan versi yang berbeda. Itulah sebabnya pengguna yang berbeda dapat melihat hasil yang berbeda. Sebagian bahkan menyajikan halaman yang ‘diblokir secara lunak’ dan tampak baik, tetapi mungkin berisi data yang salah.
Mengapa Proxy Penting untuk Crawling dan Scraping
Intinya adalah membuat request Anda tidak dapat dibedakan dari request pengunjung sungguhan. Artinya, header, waktu, dan IP itu sendiri harus tampak alami.
Alurnya seperti ini:
request → proxy → target website → response
Scraper mengirim request ke proxy, yang meneruskannya ke situs web target menggunakan alamat IP-nya sendiri lalu mengembalikan respons kepada pengguna. Dengan cara ini, target melihat proxy, bukan koneksi asli. Proxy penting karena menyembunyikan IP dan aktivitas scraping Anda.
Cara Proxy Membantu
Mengintegrasikan proxy ke alur kerja Anda adalah investasi yang wajib dimiliki. Manfaat utama proxy mencakup akses yang andal, perlindungan dari pembatasan IP, dan operasi yang dapat diskalakan. Dalam proyek data yang serius, proxy untuk web scraping tidak tergantikan. Dengan proxy, pekerjaan tetap berjalan bahkan ketika target semakin agresif memblokir lalu lintas otomatis. Geo-targeting membantu mengumpulkan harga regional atau daftar dari berbagai negara. Keuntungan lain adalah kemampuan proxy menjaga pola lalu lintas tetap bersih dan mengurangi risiko memicu pertahanan anti-bot.
Jenis Proxy Terbaik untuk Setiap Tugas
Pilihan proxy yang tepat bergantung pada kebutuhan dan kasus penggunaan Anda. Berikut tiga jenis proxy utama:
- Proxy residential menggunakan IP asli yang ditetapkan oleh Penyedia Layanan Internet. Bagi situs target, proxy ini identik dengan pengunjung biasa yang menjelajah dari ruang tamunya. Proxy ini memiliki salah satu skor kepercayaan tertinggi dan lebih jarang diblokir daripada jenis lain. Gunakan proxy residential untuk scraping situs dengan sistem perlindungan ketat dan untuk data tertentu dari wilayah lain. Proxy residential DataImpulse mulai dari $1 per GB.
- Proxy datacenter adalah IP yang di-hosting di pusat data. Proxy ini cepat dan murah, harga proxy datacenter DataImpulse adalah $0.50 per GB. Namun, karena alamat IP ini berasal dari rentang pusat data, beberapa situs web target dapat mendeteksi dan memblokirnya. Gunakan proxy datacenter ketika kecepatan menjadi prioritas utama, untuk scraping API terbuka atau dataset publik.
- Proxy mobile merutekan lalu lintas melalui perangkat seluler asli di jaringan 3G-5G dan LTE. Proxy ini menawarkan tingkat anonimitas tertinggi, dan situs web tidak menandainya. Gunakan proxy ini ketika situs web memiliki sistem pertahanan anti-bot yang serius atau jika Anda mengelola akun yang perlu tetap aktif dalam jangka panjang.
Crawling vs Scraping dalam SEO
Proses crawling merujuk pada analisis URL, sitemap, teks, dan kode untuk mengidentifikasi konten serta menentukan halaman mana yang harus dikunjungi berikutnya. Dalam SEO, mesin pencari menerapkan crawling untuk menemukan data yang relevan di internet. Misalnya, Googlebot mengikuti tautan dari halaman ke halaman, mencari halaman baru atau yang baru saja diubah. Ketika crawler menemukan halaman web, sistem pencarian merender konten, mencari kata kunci, dan menyimpannya dalam indeks pencarian. Berikut tiga langkah utama yang menunjukkan cara kerja mesin pencari:
- Crawling untuk menemukan halaman.
- Mengindeks halaman dan menyimpannya dalam database.
- Memberi peringkat halaman dan menjawab kueri pencarian.
Crawler memindai konteks, seperti teks, visual, HTML, CSS, berkas JavaScript, sehingga SEO halaman harus tertata dengan baik. Crawling adalah bagian yang sangat penting dari optimasi. Tanpa crawling, tidak ada pengindeksan dan tidak ada peringkat.
Di sisi lain, ada scraping. Ini adalah proses yang sepenuhnya berbeda dalam hal mendapatkan lalu lintas dari hasil pencarian organik. Tujuan scraping adalah mengekstrak informasi tertentu dari halaman web untuk digunakan kemudian dalam spreadsheet atau dashboard. Biasanya, ini tidak ada kaitannya dengan pengindeksan SEO. Mereka yang melacak harga, menghasilkan lead, menganalisis pesaing, atau melakukan riset biasanya menggunakan scraping, tetapi scraping tidak membantu situs Anda memperoleh peringkat atau diindeks.
Crawling dan scraping sama-sama mengunjungi URL dan membaca HTML, tetapi perbedaannya terletak pada tujuan. Crawling digunakan untuk memetakan web bagi mesin pencari, sedangkan scraping digunakan untuk mengambil data untuk penggunaan eksternal.
FAQ
Apa itu web crawling?
Web crawling adalah proses menemukan dan mengindeks halaman web dengan mengikuti tautan. Web crawler secara otomatis mengunjungi situs web, membaca halamannya, dan mengumpulkan data untuk membantu membuat entri bagi indeks mesin pencari.
Apa itu web scraping?
Web scraping adalah proses mengekstrak data tertentu dari halaman web dan menyimpannya dalam format terstruktur seperti database XML, Excel, atau SQL. Web scraper mengunjungi halaman produk dan mengambil nama, harga, gambar, serta rating produk.
Apa perbedaan di antara keduanya?
Data crawling adalah tentang mengikuti tautan dan memetakan URL di seluruh situs, dengan fokus pada hubungan antarhalaman. Sementara itu, scraping adalah tentang ekstraksi titik data tertentu yang mengubah HTML tidak terstruktur menjadi data terstruktur.
Dapatkah keduanya digunakan bersama?
Ya. Crawler terlebih dahulu menemukan semua URL yang relevan pada situs web, lalu scraper mengekstrak data dari masing-masing URL. Metode ini bekerja dengan baik untuk pelacakan harga atau analitik pasar kerja.
Apakah web scraping legal?
Ya. Scraping data yang tersedia untuk publik adalah legal. Anda merutekan lalu lintas melalui alamat IP yang sah. DataImpulse memblokir akses ke sumber daya perbankan dan pemerintah di pihak kami, khususnya untuk menjaga penggunaan tetap dalam batas yang sah. Jika kasus penggunaan Anda melibatkan industri yang diatur atau data pribadi, harap periksa terlebih dahulu undang-undang perlindungan data setempat sebelum memulai.
Apakah Anda memerlukan proxy untuk scraping?
Ya. Di DataImpulse, kami merekomendasikan proxy residential untuk web scraping. IP residential dapat melewati situs yang memblokir lalu lintas datacenter. Jika kecepatan dan latensi rendah adalah prioritas Anda, proxy datacenter adalah pilihan yang tepat. Periksa ToS situs sebelum Anda memulai.
Kesimpulan
Crawling dan scraping membentuk sistem yang saling terhubung. Crawling memberikan struktur dengan menemukan dan mengatur halaman di seluruh situs web, dan scraping mengubahnya menjadi data yang dapat digunakan. Dengan keduanya, pengumpulan data skala besar menjadi lebih praktis. Penting untuk mengetahui kapan setiap langkah terjadi dan mengapa langkah itu penting. Crawling dan scraping bukan alat yang bersaing, melainkan saling melengkapi dalam proses yang sama.