
In this Article
Un IP blocker è un controllo di sicurezza che decide se consentire una richiesta in base alla sua provenienza ed è presente dietro la maggior parte dei siti web moderni. Questo articolo spiega cos’è un IP blocker, perché i siti ne adottano uno e quali sono gli esatti meccanismi che usano per identificare il traffico da bloccare.
Esamina anche l’altro lato del problema: perché i team che raccolgono dati pubblici in modo legittimo talvolta incontrano questi blocchi e come operare nel rispetto delle regole, anziché aggirarle.
DataImpulse è un provider etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione multi-account.
Dati principali
- Definizione: un IP blocker è qualsiasi controllo, come una regola firewall, una policy WAF o un limitatore di frequenza, che nega il traffico in base a un indirizzo IP di origine, alla sua gamma di rete o alla sua reputazione.
- Tipo di proxy migliore: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Cos’è un IP blocker?
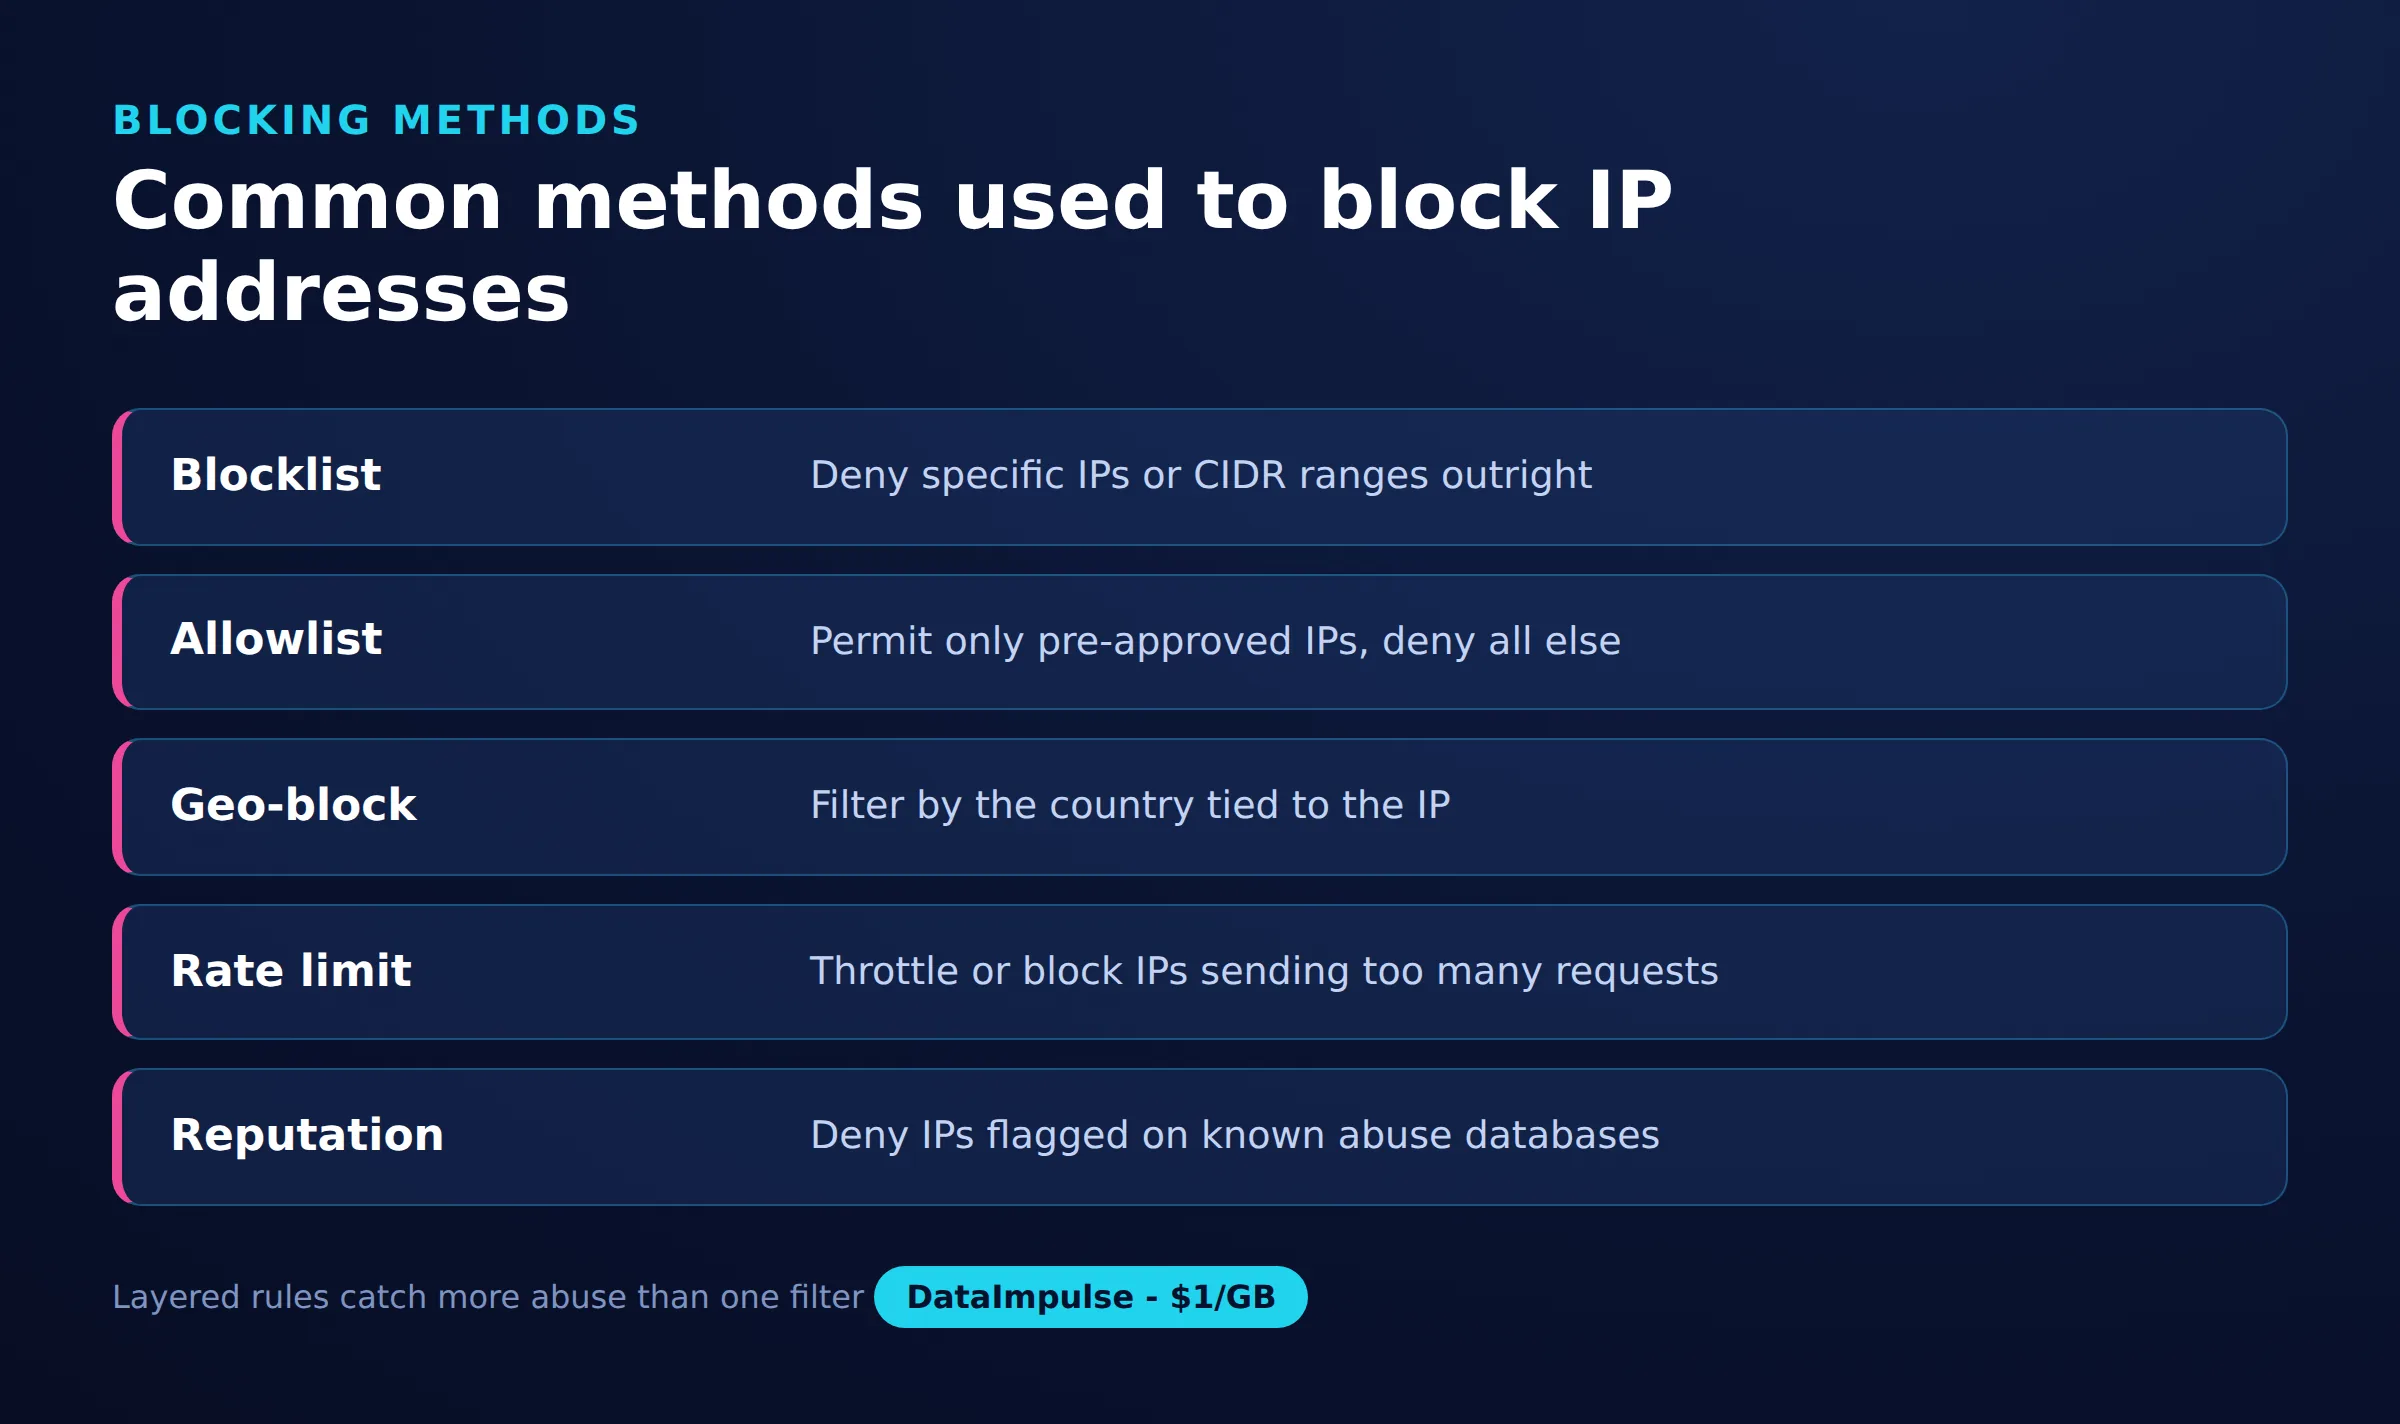
Un IP blocker è qualsiasi controllo che consente o nega il traffico di rete in base all’indirizzo IP di origine di una richiesta. Più che un singolo prodotto, è una categoria di difese sovrapposte che il gestore di un sito combina tra loro.
I componenti più comuni includono:
- Firewall: regole a livello di rete, per esempio iptables o nftables, che scartano i pacchetti provenienti da indirizzi o gamme specifiche prima ancora che un’applicazione li veda.
- Web application firewall (WAF): filtri a livello applicativo, come quelli di una CDN, che ispezionano le richieste HTTP e bloccano per IP, header o pattern.
- fail2ban e strumenti simili: monitor dei log che aggiungono un IP a un elenco temporaneo di divieti dopo ripetuti accessi non riusciti o richieste sospette.
- Limitatori di frequenza: contatori che rifiutano un indirizzo quando supera una soglia di richieste in una finestra temporale.
- Blocchi geografici: regole che consentono o negano interi paesi, spesso per ragioni di licenza o conformità.
- Blacklist e feed di reputazione: elenchi di terze parti di indirizzi noti per abusi o ad alto rischio, a cui un sito si abbona.
Perché i siti web usano gli IP blocker?
I siti web usano gli IP blocker per ridurre gli abusi, proteggere l’infrastruttura e rispettare obblighi legali o contrattuali. La motivazione è quasi sempre difensiva, non arbitraria.
Le ragioni tipiche includono:
- Abusi e attacchi: fermare credential stuffing, spam e traffico di denial-of-service che altrimenti peggiorerebbe il servizio per gli utenti reali.
- Gestione dei bot: filtrare il traffico automatizzato che effettua web scraping aggressivo, accumula inventario o altera le analisi.
- Licenze e geografia: limitare i contenuti alle regioni in cui il gestore ha i diritti per offrirli.
- Conformità: bloccare regioni sottoposte a sanzioni o rispettare requisiti di trattamento dei dati.
Di conseguenza, un singolo indirizzo problematico, o un’intera gamma associata ad abusi, viene negato affinché il resto del pubblico non ne risenta.
Come decide un IP blocker cosa bloccare?
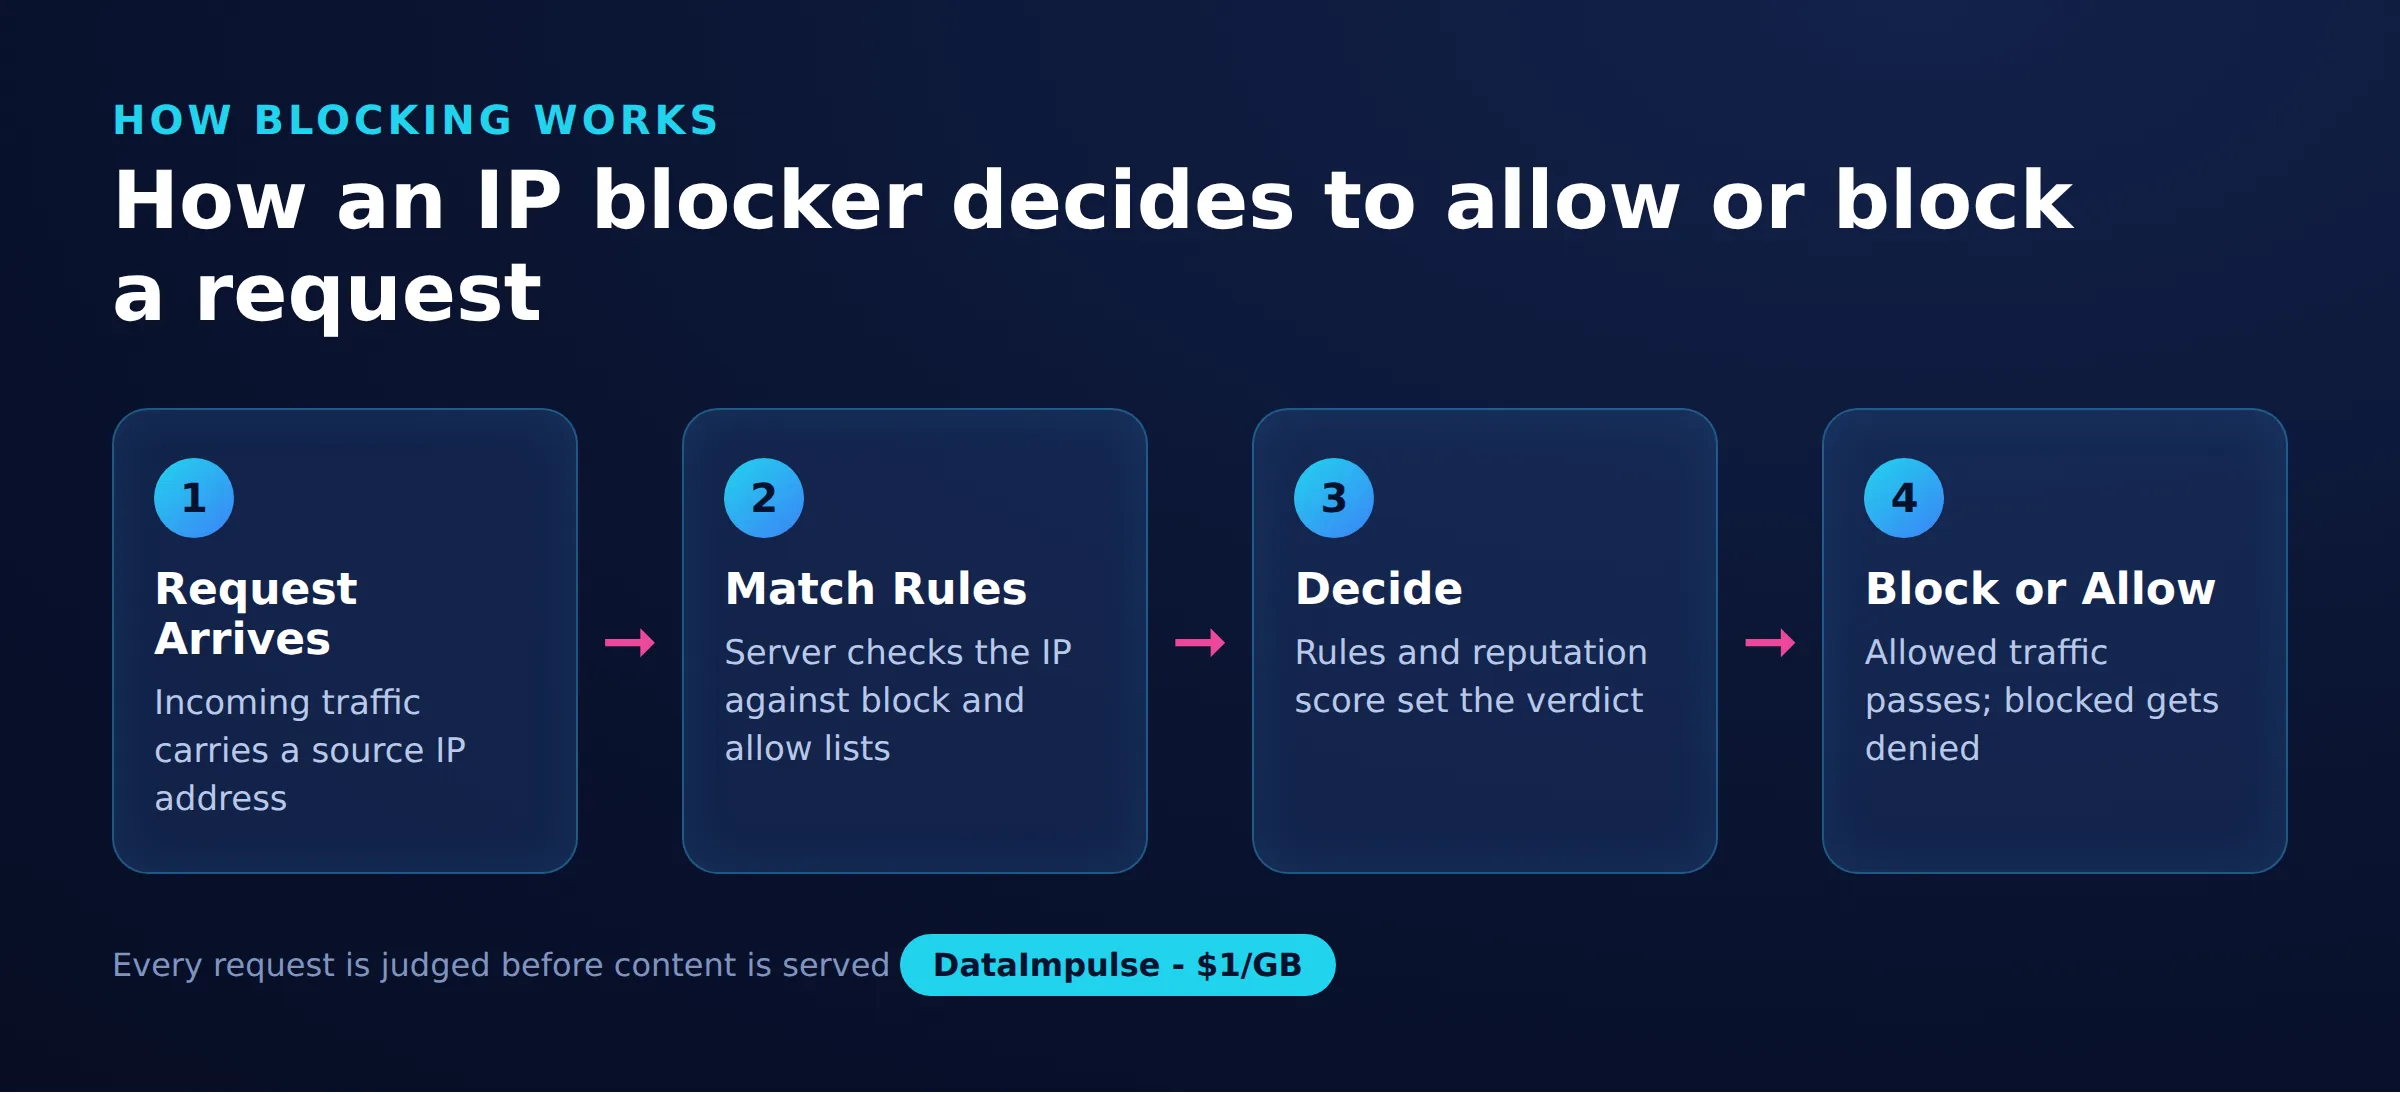
Un IP blocker confronta una richiesta in arrivo con una o più regole e la nega se una di esse scatta. La granularità di queste regole va da un singolo indirizzo a reti intere.
I metodi di corrispondenza comuni sono:
- IP esatto: viene negato un indirizzo specifico, utile per un soggetto noto per comportamenti dannosi.
- Gamma CIDR: un blocco di indirizzi, per esempio 203.0.113.0/24, viene negato in una volta sola, soluzione efficiente per infrastrutture raggruppate.
- A livello ASN: tutti gli indirizzi appartenenti a un sistema autonomo, come la rete di un provider di hosting, vengono trattati allo stesso modo. Ecco perché il traffico datacenter viene spesso filtrato indiscriminatamente.
- Basato sulla reputazione: un punteggio ricavato da feed di minacce e comportamenti passati determina il risultato, quindi un indirizzo eredita il rischio dai suoi vicini.
- Comportamentale: il blocco scatta in base al comportamento del client, come frequenza delle richieste, coerenza degli header o pattern di navigazione, anziché al solo indirizzo.
Al livello più semplice, un blocco è una riga che indica a un firewall di scartare il traffico da un indirizzo, come mostrano questi esempi di iptables e fail2ban:
#deny a single address with iptables
iptables -A INPUT -s 203.0.113.45 -j DROP

#deny a whole /24 range
iptables -A INPUT -s 203.0.113.0/24 -j DROP

#fail2ban adds a temporary ban after repeated failures
fail2ban-client set sshd banip 203.0.113.45
In produzione questi elementi di base sono racchiusi in dashboard WAF e configurazioni di limitazione della frequenza, ma la logica è la stessa: confronta l’origine, poi consenti o nega.
Perché gli scraper legittimi incontrano blocchi IP?
La raccolta legittima di dati spesso attiva blocchi IP non perché sia dannosa, ma perché assomiglia ai pattern di traffico che questi blocchi sono tarati per fermare. Due fattori predominano.
Il primo sono le gamme di rete condivise. Il traffico proveniente da proxy datacenter economici e provider cloud passa attraverso un numero ristretto di ASN condivisi da molti soggetti, quindi le regole di reputazione e a livello ASN negano l’intera gamma indipendentemente dall’intento. Il secondo è una frequenza aggressiva: inviare molte richieste al secondo dallo stesso indirizzo è l’esatto segnale che un limitatore di frequenza è progettato per rilevare. Un raccoglitore che si comporta correttamente e rispetta entrambi i fattori ha molte meno probabilità di essere bloccato fin dall’inizio.
Come aiutano i proxy residential a rotazione con i dati pubblici?
I proxy residential a rotazione distribuiscono le richieste tra molti indirizzi reali assegnati dagli ISP, così nessun singolo indirizzo accumula il volume di richieste che attiva un blocco basato sulla frequenza. Questo consente a un progetto legittimo sui dati pubblici di restare entro le soglie per indirizzo applicate dai siti.
Poiché gli indirizzi appartengono a connessioni residential autentiche anziché a una gamma datacenter segnalata, hanno una reputazione normale e non vengono negati dalle regole a livello ASN rivolte al traffico cloud. DataImpulse fornisce proxy residential insieme a proxy mobile, ottenuti da utenti che aderiscono e ricevono un compenso, motivo per cui sono descritti come proxy etici. Gli indirizzi sono lo strumento; l’accettabilità del loro uso dipende interamente da cosa viene raccolto e come, come affronta la sezione successiva.
Come dovresti raccogliere dati pubblici in modo responsabile?
Raccogliere in modo responsabile significa trattare un sito di destinazione come una risorsa condivisa: preleva solo dati pubblici, procedi lentamente e riduci l’attività quando il server segnala affaticamento. Distribuire le richieste non sostituisce le buone pratiche.
Le abitudini pratiche includono:
- Limitazione della frequenza: limita le richieste simultanee e aggiungi ritardi, affinché il tuo traffico resti entro ciò che genererebbe un utente normale.
- Exponential backoff: quando ricevi un 429 o 503, attendi progressivamente più a lungo prima di riprovare invece di sovraccaricare l’endpoint.
- Rispetta i segnali: leggi le direttive robots e rispetta le preferenze dichiarate dal sito.
- Cache e deduplica: evita di richiedere di nuovo pagine che hai già.
La nostra guida sullo scraping senza essere bloccati approfondisce queste pratiche.
Dov’è il confine tra uso legittimo ed elusione?
Il confine è definito da ciò che si trova dietro al blocco, non dalla capacità tecnica di aggirarlo. Distribuire richieste per raccogliere rispettosamente informazioni pubbliche è una pratica di gestione del carico; usare gli stessi strumenti per eludere un login, un divieto o un controllo antifrode è elusione.
Limiti chiari da rispettare:
- Non aggirare l’autenticazione: non usare mai proxy per raggiungere servizi protetti da login o paywall ai quali non sei autorizzato ad accedere.
- Non eludere i divieti della piattaforma: ruotare gli indirizzi per aggirare una sospensione o un divieto dell’account viola i termini della piattaforma.
- Non agevolare frodi: i proxy non sono uno strumento per creare account falsi, commettere frodi pubblicitarie o ingannare un servizio.
I servizi di proxy etici sono pensati per attività sui dati pubblici conformi alla legge, non per sconfiggere controlli di sicurezza o di licenza.
Come funziona il blocco IP
| Metodo | Come funziona | Attivatore tipico |
|---|---|---|
| IP esatto | Blocca un singolo indirizzo | Soggetto noto per comportamenti dannosi |
| Gamma CIDR | Blocca un blocco di subnet | Abusi da una rete |
| ASN | Blocca un intero provider | Traffico datacenter o di hosting |
| Feed di reputazione | Blocca gli indirizzi presenti nell’elenco | Punteggio di reputazione basso |
| Comportamentale o frequenza | Blocca in base ai pattern delle richieste | Troppe richieste rapide |
Domande frequenti
Qual è la differenza tra un IP blocker e un firewall?
Un firewall è un modo comune per implementare il blocco IP a livello di rete, ma un IP blocker è un concetto più ampio. Include anche regole WAF, limitatori di frequenza, fail2ban, blocchi geografici e feed di reputazione che negano il traffico per indirizzo.
Perché i proxy datacenter vengono bloccati più spesso di quelli residential?
I proxy datacenter condividono un insieme limitato di ASN di hosting usati da molti soggetti, quindi i siti spesso negano quelle gamme indiscriminatamente. Gli indirizzi residential appartengono a connessioni ISP reali e hanno una reputazione normale, quindi è meno probabile che siano intercettati dalle regole a livello ASN.
I proxy a rotazione possono aggirare qualsiasi blocco IP?
No. I proxy a rotazione aiutano a distribuire le richieste affinché un progetto resti sotto i limiti di frequenza per indirizzo, ma non possono e non dovrebbero sconfiggere autenticazione, divieti dell’account o controlli antifrode. Sono limiti da rispettare, non ostacoli da aggirare.
DataImpulse aiuta a eludere i divieti sulle piattaforme?
No. DataImpulse è un provider etico di proxy per la raccolta di dati pubblici conforme alla legge. Usare proxy per eludere un divieto della piattaforma, aggirare un login o commettere frodi viola i suoi termini e non è un caso d’uso supportato.
Come posso evitare che il mio scraper venga bloccato fin dall’inizio?
Raccogli solo dati pubblici, mantieni basse le frequenze di richiesta, usa exponential backoff sulle risposte 429 e 503 e rispetta le preferenze dichiarate dal sito. Distribuire le richieste tra indirizzi residential integra queste abitudini, ma non le sostituisce.
Quando DataImpulse non è la scelta giusta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Raccogli dati pubblici in modo responsabile
Se il tuo lavoro comporta la raccolta di dati pubblici su larga scala senza sovraccaricare un singolo indirizzo, DataImpulse offre proxy residential, mobile e datacenter a rotazione ottenuti eticamente, con traffico pay-as-you-go. Crea un account per iniziare.