
In this Article
IP blocker คือกลไกควบคุมความปลอดภัยที่ตัดสินใจว่าจะอนุญาตคำขอหรือไม่ตามแหล่งที่มา และอยู่เบื้องหลังเว็บไซต์สมัยใหม่ส่วนใหญ่ บทความนี้อธิบายว่า IP blocker คืออะไร เหตุใดเว็บไซต์จึงนำไปใช้ และกลไกที่ใช้ระบุ traffic ที่ต้องบล็อกอย่างละเอียด
นอกจากนี้ยังกล่าวถึงอีกด้านของปัญหา คือเหตุใดทีมงานที่เก็บรวบรวมข้อมูลสาธารณะอย่างถูกต้องจึงอาจพบการบล็อกเหล่านี้ และควรทำงานภายใต้กฎแทนที่จะหาทางเลี่ยงกฎอย่างไร
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมี IP addresses แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อม traffic ที่ไม่มีวันหมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- คำจำกัดความ: IP blocker คือกลไกใดก็ตาม เช่นกฎ firewall, นโยบาย WAF หรือ rate limiter ที่ปฏิเสธ traffic โดยอิงจาก source IP address ช่วงเครือข่าย หรือ reputation ของ IP นั้น
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxies ซึ่งใช้ IP ของผู้ใช้จริงและหลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน พร้อม traffic ที่ไม่มีวันหมดอายุและไม่มีค่าสมัครสมาชิก
- ความครอบคลุม: IP ที่จัดหาอย่างมีจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
IP blocker คืออะไร
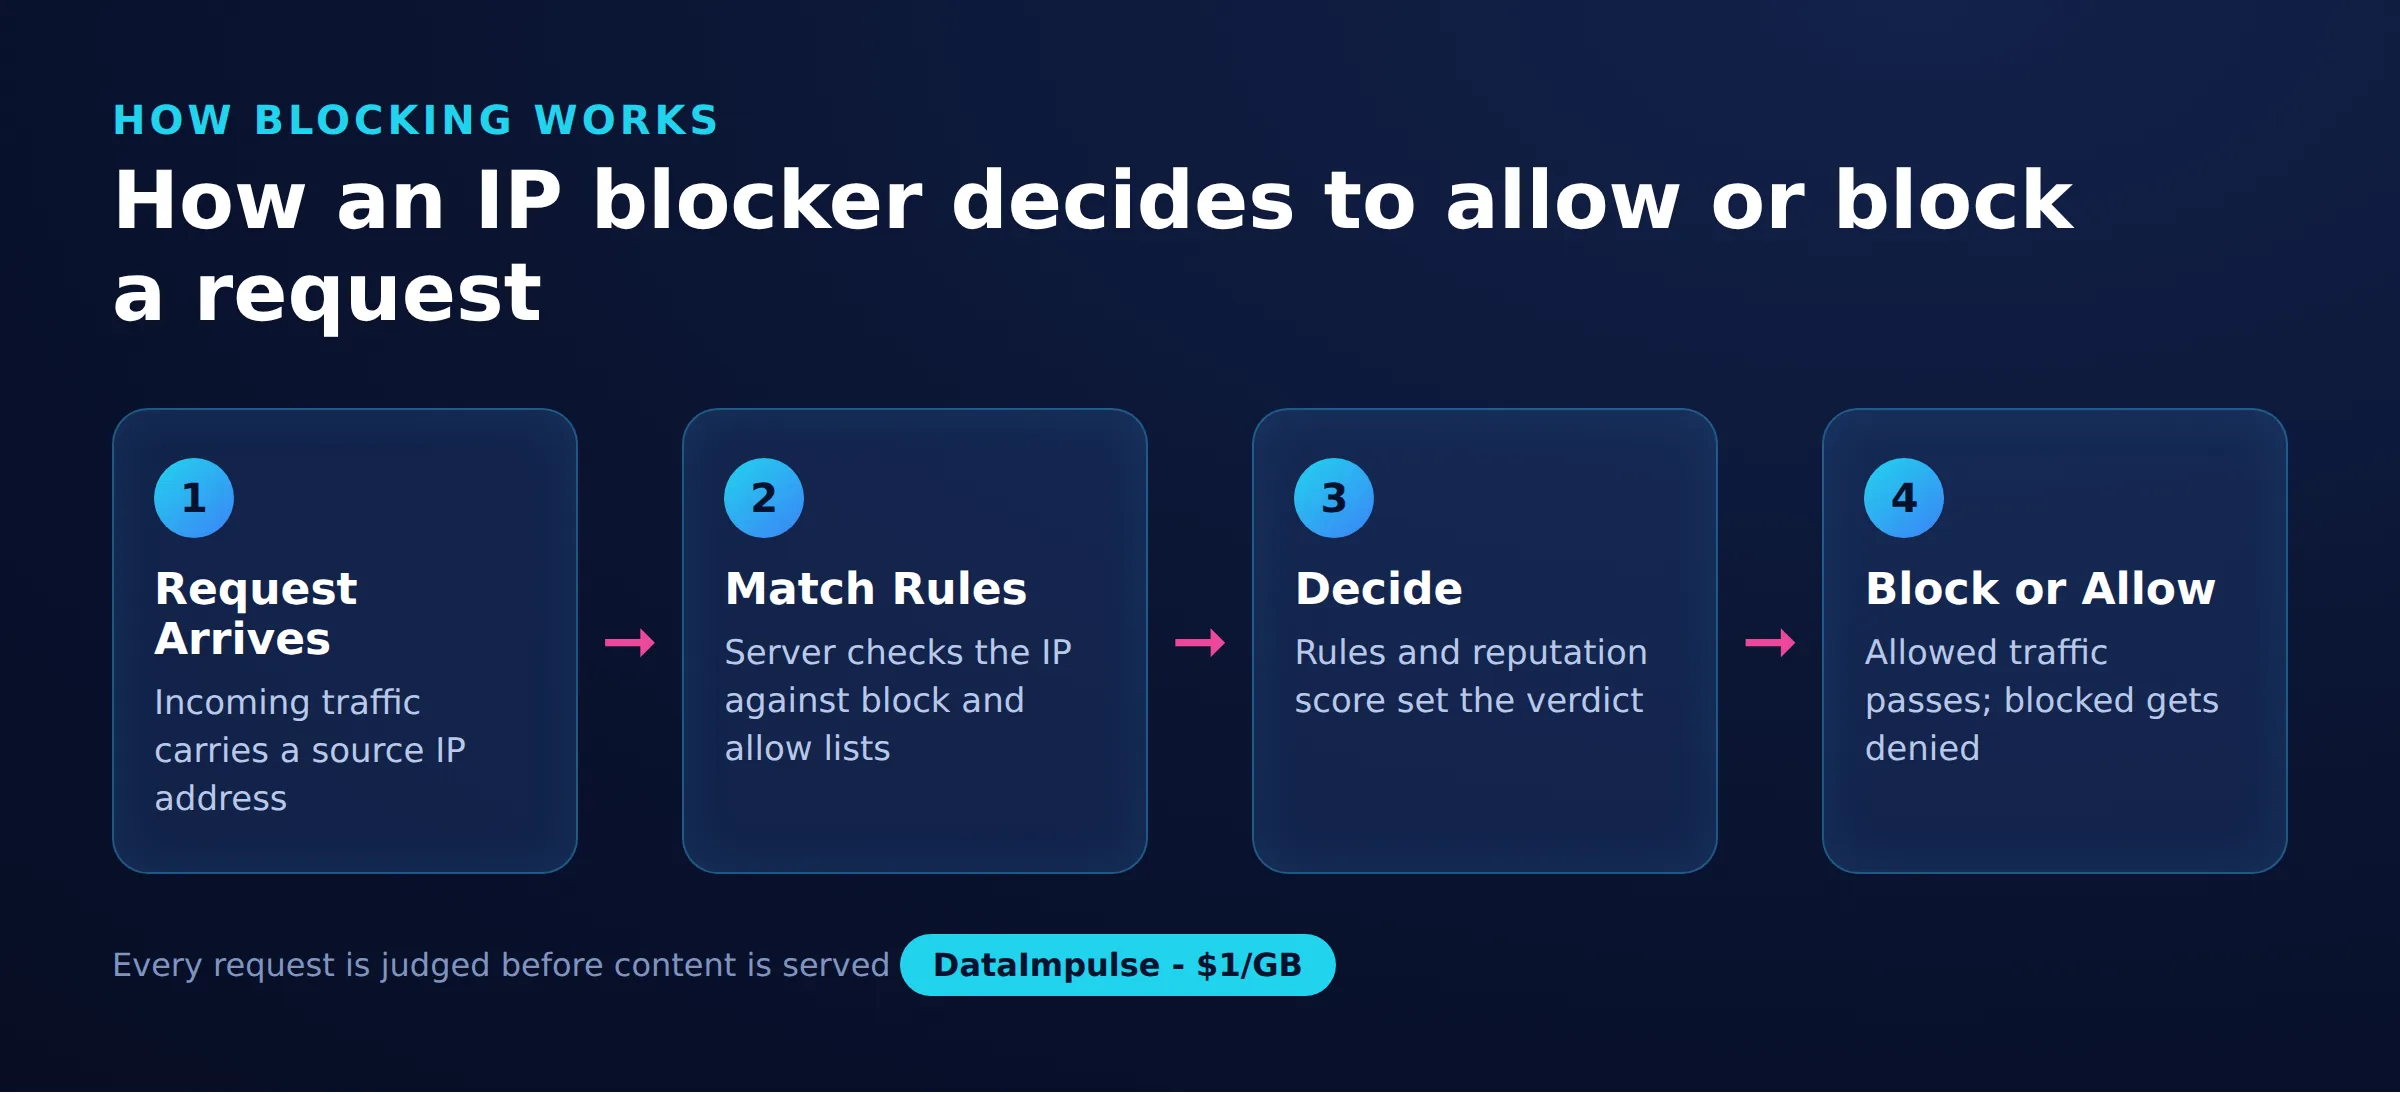
IP blocker คือกลไกใดก็ตามที่อนุญาตหรือปฏิเสธ network traffic โดยอิงจาก source IP address ของคำขอ มันไม่ใช่ผลิตภัณฑ์ชิ้นเดียว แต่เป็นหมวดหมู่ของการป้องกันที่ทับซ้อนกันซึ่งผู้ดูแลเว็บไซต์นำมาซ้อนใช้ร่วมกัน
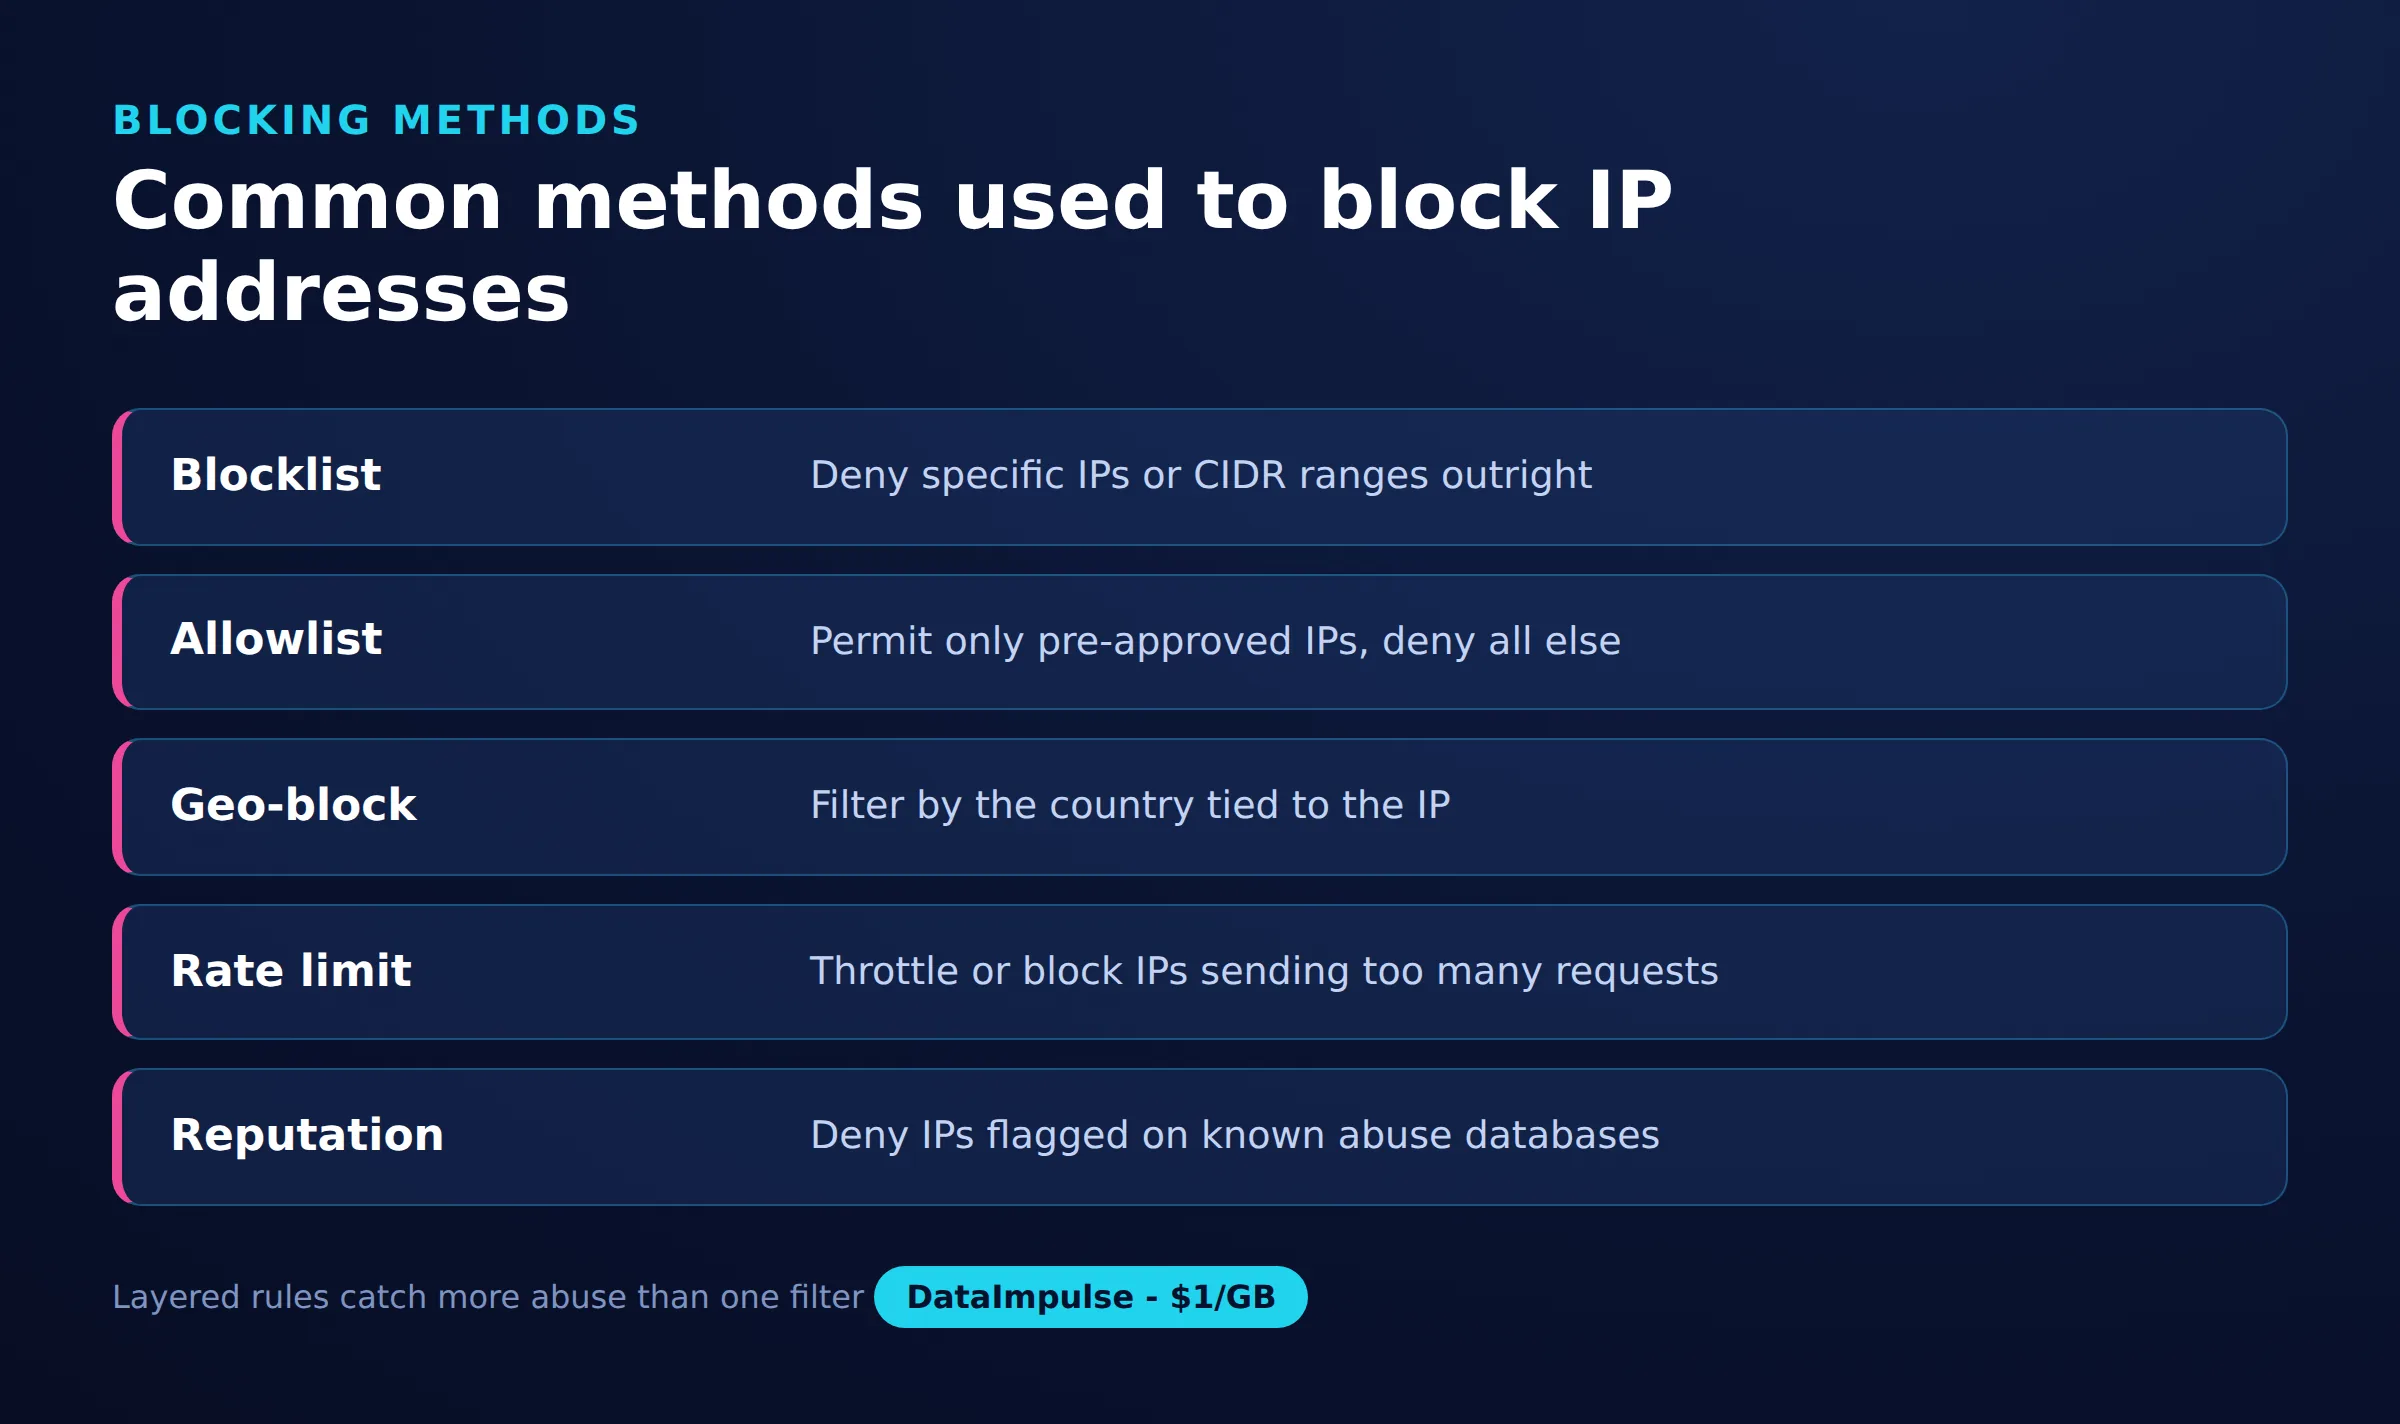
องค์ประกอบที่พบบ่อย ได้แก่:
- Firewalls: กฎในระดับเครือข่าย เช่น iptables หรือ nftables ที่ทิ้ง packets จาก address หรือช่วงที่ระบุก่อนที่แอปพลิเคชันจะเห็น packets เหล่านั้น
- Web application firewalls (WAF): ตัวกรองระดับแอปพลิเคชัน เช่นใน CDN ที่ตรวจสอบ HTTP requests และบล็อกตาม IP, header หรือรูปแบบ
- fail2ban และเครื่องมือที่คล้ายกัน: ตัวติดตาม log ที่เพิ่ม IP ลงในรายการแบนชั่วคราวหลังการ login ล้มเหลวซ้ำหลายครั้งหรือมี hits ที่น่าสงสัย
- Rate limiters: ตัวนับที่ปฏิเสธ address เมื่อเกิน request threshold ภายในช่วงเวลาที่กำหนด
- Geo-blocks: กฎที่อนุญาตหรือปฏิเสธทั้งประเทศ มักใช้ด้วยเหตุผลด้าน licensing หรือ compliance
- Blacklist และ reputation feeds: รายการจาก third-party ของ address ที่ทราบว่ามีพฤติกรรมไม่เหมาะสมหรือมีความเสี่ยงสูง ซึ่งเว็บไซต์สมัครใช้
เหตุใดเว็บไซต์จึงใช้ IP blockers
เว็บไซต์ใช้ IP blockers เพื่อลดการใช้งานในทางที่ผิด ปกป้องโครงสร้างพื้นฐาน และปฏิบัติตามภาระผูกพันทางกฎหมายหรือสัญญา แรงจูงใจแทบทั้งหมดเป็นการป้องกัน ไม่ใช่การทำโดยไร้เหตุผล
เหตุผลทั่วไป ได้แก่:
- การใช้งานในทางที่ผิดและการโจมตี: หยุด credential stuffing, spam และ denial-of-service traffic ที่มิฉะนั้นจะทำให้บริการสำหรับผู้ใช้จริงแย่ลง
- การจัดการ bot: กรอง automated traffic ที่ทำ web scraping อย่างหนัก กักตุนสินค้า หรือทำให้ analytics บิดเบือน
- Licensing และภูมิศาสตร์: จำกัดเนื้อหาไว้ในภูมิภาคที่ผู้ดำเนินการมีสิทธิ์ให้บริการ
- Compliance: บล็อกภูมิภาคที่ถูกคว่ำบาตรหรือปฏิบัติตามข้อกำหนดการจัดการข้อมูล
ผลคือ address ที่มีพฤติกรรมไม่เหมาะสมเพียงรายการเดียว หรือทั้งช่วงที่เชื่อมโยงกับการใช้งานในทางที่ผิด จะถูกปฏิเสธเพื่อให้ผู้ใช้อื่น ๆ ไม่ได้รับผลกระทบ
IP blocker ตัดสินใจว่าจะบล็อกอะไรอย่างไร
IP blocker จับคู่คำขอขาเข้ากับกฎหนึ่งข้อหรือมากกว่า และปฏิเสธหากมีกฎข้อใดทำงาน ระดับความละเอียดของกฎเหล่านี้มีตั้งแต่ address เดียวไปจนถึงทั้งเครือข่าย
วิธีการจับคู่ที่พบบ่อย ได้แก่:
- IP แบบระบุเจาะจง: ปฏิเสธ address ที่เฉพาะเจาะจง เหมาะสำหรับผู้กระทำที่เป็นอันตรายซึ่งทราบตัว
- ช่วง CIDR: ปฏิเสธ address ทั้งบล็อก เช่น 203.0.113.0/24 พร้อมกัน ซึ่งมีประสิทธิภาพสำหรับโครงสร้างพื้นฐานที่จัดเป็นกลุ่ม
- ระดับ ASN: address ทั้งหมดที่อยู่ใน autonomous system เช่น network ของ hosting provider จะได้รับการปฏิบัติแบบเดียวกัน นี่คือเหตุผลที่ traffic จาก datacenter มักถูกกรองทั้งชุด
- อิง reputation: คะแนนที่ได้จาก threat feeds และพฤติกรรมในอดีตเป็นตัวตัดสินผลลัพธ์ ดังนั้น address จึงรับความเสี่ยงจาก address ใกล้เคียง
- เชิงพฤติกรรม: การบล็อกเกิดจากพฤติกรรมของ client เช่น request rate, ความสอดคล้องของ header หรือรูปแบบการนำทาง แทนที่จะดู address เพียงอย่างเดียว
ในระดับพื้นฐานที่สุด การบล็อกคือบรรทัดเดียวที่สั่ง firewall ให้ทิ้ง traffic จาก address ดังตัวอย่าง iptables และ fail2ban ต่อไปนี้:
#deny a single address with iptables
iptables -A INPUT -s 203.0.113.45 -j DROP

#deny a whole /24 range
iptables -A INPUT -s 203.0.113.0/24 -j DROP

#fail2ban adds a temporary ban after repeated failures
fail2ban-client set sshd banip 203.0.113.45
ในการใช้งานจริง กลไกพื้นฐานเหล่านี้ถูกห่อไว้ใน dashboard ของ WAF และ config ของ rate-limit แต่ตรรกะยังคงเหมือนเดิม คือจับคู่แหล่งที่มา แล้วจึงอนุญาตหรือปฏิเสธ
เหตุใดผู้ทำ web scraping ที่ถูกต้องจึงพบ IP blocks
การเก็บรวบรวมข้อมูลที่เหมาะสมมักกระตุ้น IP blocks ไม่ใช่เพราะมีเจตนาร้าย แต่เพราะมีลักษณะคล้ายรูปแบบ traffic ที่การบล็อกเหล่านั้นตั้งค่าไว้เพื่อหยุด มีปัจจัยหลักสองประการ
ประการแรกคือ ช่วงเครือข่ายที่ใช้ร่วมกัน traffic จาก datacenter proxies ราคาถูกและ cloud providers เดินทางผ่าน ASN จำนวนไม่มากที่ผู้ใช้งานจำนวนมากใช้ร่วมกัน ดังนั้นกฎ reputation และระดับ ASN จึงปฏิเสธทั้งช่วงโดยไม่คำนึงถึงเจตนา ประการที่สองคือ อัตราที่สูงเกินไป: การส่ง requests จำนวนมากต่อวินาทีจาก address เดียวคือสัญญาณตรงตามที่ rate limiter ถูกสร้างมาเพื่อตรวจจับ ผู้เก็บข้อมูลที่ทำงานอย่างเหมาะสมและคำนึงถึงทั้งสองปัจจัย มีโอกาสถูกบล็อกตั้งแต่แรกน้อยกว่ามาก
rotating residential proxies ช่วยเรื่องข้อมูลสาธารณะอย่างไร
Rotating residential proxies กระจาย requests ไปยัง address จริงจำนวนมากที่ ISP จัดสรร จึงไม่มี address ใด address หนึ่งสะสมปริมาณ requests จนกระตุ้นการบล็อกตามอัตรา วิธีนี้ช่วยให้โครงการข้อมูลสาธารณะที่เหมาะสมอยู่ภายใน threshold ต่อ address ที่เว็บไซต์บังคับใช้
เนื่องจาก address เหล่านี้มาจากการเชื่อมต่อ residential จริง แทนที่จะเป็นช่วง datacenter ที่ถูกทำเครื่องหมายไว้ จึงมี reputation ปกติและไม่ถูกปฏิเสธด้วยกฎระดับ ASN ที่มุ่งเป้าไปที่ cloud traffic DataImpulse มี residential proxies ควบคู่กับ mobile proxies ซึ่งจัดหาจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน จึงอธิบายว่าเป็น ethical proxies address เป็นเพียงเครื่องมือ ส่วนการใช้งานจะยอมรับได้หรือไม่นั้นขึ้นอยู่ทั้งหมดกับข้อมูลที่เก็บและวิธีเก็บ ซึ่งหัวข้อถัดไปจะกล่าวถึง
ควรเก็บรวบรวมข้อมูลสาธารณะอย่างรับผิดชอบอย่างไร
การเก็บรวบรวมอย่างรับผิดชอบหมายถึงการปฏิบัติต่อเว็บไซต์เป้าหมายเป็นทรัพยากรที่ใช้ร่วมกัน เก็บเฉพาะข้อมูลสาธารณะ ดำเนินการอย่างช้า ๆ และลดการทำงานเมื่อ server ส่งสัญญาณว่ารับภาระหนัก การกระจาย requests ไม่อาจทดแทนมารยาทที่ดีได้
แนวปฏิบัติที่เป็นประโยชน์ ได้แก่:
- Rate limiting: จำกัด requests ที่ทำพร้อมกันและเพิ่มช่วงหน่วง เพื่อให้ traffic อยู่ในระดับที่ผู้ใช้ทั่วไปจะสร้าง
- Exponential backoff: เมื่อได้รับ 429 หรือ 503 ให้รอนานขึ้นเป็นลำดับก่อน retry แทนที่จะส่ง requests ซ้ำไปยัง endpoint อย่างหนัก
- เคารพสัญญาณ: อ่าน robots directives และปฏิบัติตามข้อกำหนดที่เว็บไซต์ระบุ
- Cache และ dedupe: หลีกเลี่ยงการ request หน้าเดิมซ้ำเมื่อมีอยู่แล้ว
คู่มือของเราเกี่ยวกับ การทำ web scraping โดยไม่ถูกบล็อก อธิบายแนวปฏิบัติเหล่านี้อย่างละเอียดมากขึ้น
เส้นแบ่งระหว่างการใช้งานที่เหมาะสมกับการหลบเลี่ยงอยู่ที่ใด
เส้นแบ่งนิยามจากสิ่งที่อยู่เบื้องหลังการบล็อก ไม่ใช่จากความสามารถทางเทคนิคในการหาเส้นทางเลี่ยง การกระจาย requests เพื่อเก็บข้อมูลสาธารณะอย่างเคารพเป็นแนวปฏิบัติในการจัดการภาระงาน ส่วนการใช้เครื่องมือเดียวกันเพื่อเอาชนะ login, การแบน หรือการควบคุมป้องกัน fraud คือการหลบเลี่ยง
ขอบเขตที่ชัดเจนที่ควรยึดถือ:
- อย่าข้ามการยืนยันตัวตน: ห้ามใช้ proxies เพื่อเข้าถึงบริการที่ต้อง login หรือ paywall หากไม่ได้รับอนุญาตให้เข้าถึง
- อย่าหลบเลี่ยงการแบนของ platform: การหมุนเวียน address เพื่อหลีกเลี่ยงการระงับหรือแบนบัญชีเป็นการขัดต่อเงื่อนไขของ platform
- อย่าสนับสนุน fraud: proxies ไม่ใช่เครื่องมือสำหรับสร้างบัญชีปลอม, ad fraud หรือการหลอกลวงบริการใด ๆ
บริการ proxy ที่มีจริยธรรมมีไว้สำหรับงานข้อมูลสาธารณะที่ชอบด้วยกฎหมาย ไม่ใช่เพื่อเอาชนะการควบคุมด้านความปลอดภัยหรือ licensing
การบล็อก IP ทำงานอย่างไร
| วิธีการ | วิธีทำงาน | สิ่งที่มักกระตุ้น |
|---|---|---|
| IP แบบระบุเจาะจง | บล็อก address เดียว | ผู้กระทำที่เป็นอันตรายซึ่งทราบตัว |
| ช่วง CIDR | บล็อก subnet หนึ่งบล็อก | การใช้งานในทางที่ผิดจากเครือข่ายเดียว |
| ASN | บล็อก provider ทั้งราย | traffic จาก Datacenter หรือ hosting |
| Reputation feed | บล็อก address ในรายการ | คะแนน reputation ต่ำ |
| เชิงพฤติกรรมหรือตามอัตรา | บล็อกตามรูปแบบ request | requests เร็วเกินไปจำนวนมาก |
คำถามที่พบบ่อย
IP blocker กับ firewall ต่างกันอย่างไร
firewall เป็นวิธีหนึ่งที่ใช้ดำเนินการ IP blocking ในระดับเครือข่าย แต่ IP blocker เป็นแนวคิดที่กว้างกว่า ยังรวมถึงกฎ WAF, rate limiters, fail2ban, geo-blocks และ reputation feeds ที่ปฏิเสธ traffic ตาม address ด้วย
เหตุใด datacenter proxies จึงถูกบล็อกบ่อยกว่า residential proxies
Datacenter proxies ใช้ชุด ASN ของ hosting ที่มีจำนวนจำกัดร่วมกัน ซึ่งผู้ใช้งานจำนวนมากใช้ด้วย เว็บไซต์จึงมักปฏิเสธช่วงเหล่านั้นทั้งชุด ส่วน residential addresses เป็นของการเชื่อมต่อ ISP จริงและมี reputation ปกติ จึงมีโอกาสน้อยกว่าที่จะติดกฎระดับ ASN
rotating proxies สามารถข้าม IP block ได้ทุกแบบหรือไม่
ไม่ได้ Rotating proxies ช่วยกระจาย requests เพื่อให้โครงการอยู่ต่ำกว่า rate limits ต่อ address แต่ไม่ได้และไม่ควรเอาชนะการยืนยันตัวตน การแบนบัญชี หรือการควบคุมป้องกัน fraud สิ่งเหล่านี้เป็นขอบเขตที่ควรเคารพ ไม่ใช่อุปสรรคที่ควรหาเส้นทางเลี่ยง
DataImpulse ช่วยหลบเลี่ยงการแบนบน platforms หรือไม่
ไม่ DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรมสำหรับการเก็บรวบรวมข้อมูลสาธารณะที่ชอบด้วยกฎหมาย การใช้ proxies เพื่อหลบเลี่ยงการแบนของ platform ข้าม login หรือกระทำ fraud เป็นการขัดต่อเงื่อนไข และไม่ใช่กรณีการใช้งานที่รองรับ
จะหลีกเลี่ยงไม่ให้ web scraper ถูกบล็อกตั้งแต่แรกได้อย่างไร
เก็บเฉพาะข้อมูลสาธารณะ รักษา request rates ให้ต่ำ ใช้ exponential backoff กับ responses 429 และ 503 และปฏิบัติตามข้อกำหนดที่เว็บไซต์ระบุ การกระจาย requests ข้าม residential addresses ช่วยเสริมแนวปฏิบัติเหล่านี้ แต่ไม่อาจทดแทนได้
เมื่อใดที่ DataImpulse ไม่ใช่ตัวเลือกที่เหมาะสม
หากต้องการ static ISP proxies, scraping API ที่มีการจัดการครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและภาครัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น rotating residential, mobile และ datacenter proxies สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
เก็บข้อมูลสาธารณะอย่างรับผิดชอบ
หากงานของคุณเกี่ยวข้องกับการรวบรวมข้อมูลสาธารณะในปริมาณมากโดยไม่ทำให้ address ใด address หนึ่งรับภาระเกินไป DataImpulse มี rotating residential, mobile และ datacenter proxies ที่จัดหาอย่างมีจริยธรรมในรูปแบบ traffic จ่ายตามการใช้งาน สร้างบัญชี เพื่อเริ่มต้น