
In this Article
Le best practice del web scraping fanno la differenza tra uno scraper che funziona senza problemi per mesi e uno che si interrompe, viene bloccato o restituisce silenziosamente dati inutilizzabili. Questa guida si concentra sull’aspetto ingegneristico: come creare scraper affidabili, rispettosi dei siti che consultano ed economici da gestire su larga scala.
La maggior parte degli scraper fallisce in modi prevedibili: sovraccaricano i server, sembrano bot oppure dipendono da una struttura di pagina che cambia. Considerare lo scraping come una pipeline di dati anziché come uno script isolato è il cambiamento di mentalità fondamentale; le tecniche seguenti comprendono la limitazione della frequenza, rotazione di IP e headers, scelta della fonte di dati corretta, parsing robusto, retry, caching e controllo della qualità. Si applicano sia alla raccolta di alcune migliaia di pagine al giorno sia a quella di diversi milioni.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello a consumo a partire da 1 dollaro per GB con traffico senza scadenza ed è impiegato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Informazioni chiave
- Prima l’affidabilità: le best practice del web scraping più importanti sono rispettare i limiti di frequenza, ruotare gli IP con headers realistici, riprovare con backoff e convalidare ogni batch prima di considerarlo affidabile.
- Il miglior tipo di proxy: residential proxy rotating, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, a consumo, con traffico senza scadenza e nessun abbonamento.
- Copertura: oltre 90M di IP ottenuti in modo etico in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Come rispettare i limiti di frequenza e applicare il backoff?
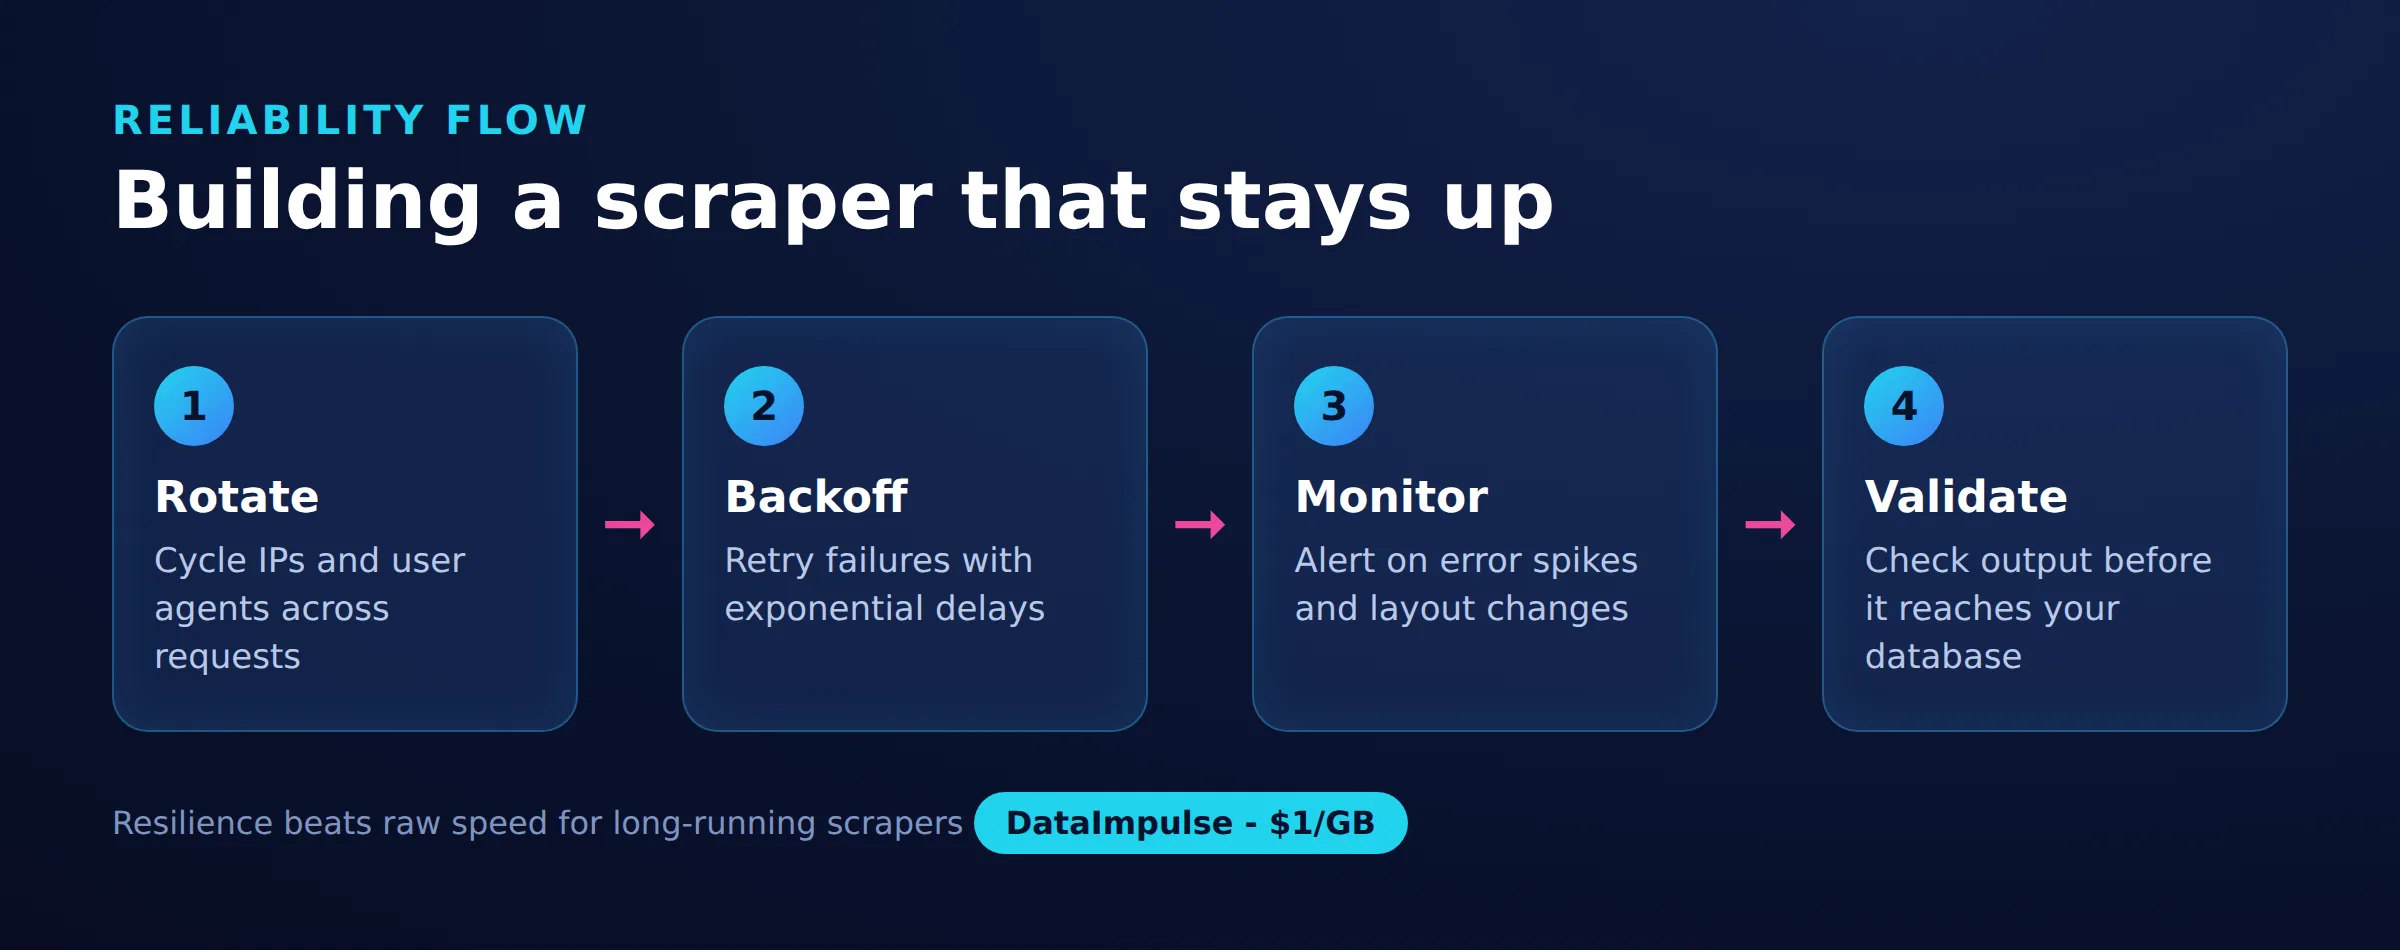
Invia richieste a un ritmo che il target può gestire e rallenta automaticamente quando segnala difficoltà. Il backoff adattivo è sia rispettoso sia protettivo, perché il traffico aggressivo è il modo più rapido per essere bloccati.
Inizia con un livello di concorrenza prudente e un breve ritardo tra le richieste, quindi aumentalo solo se il sito resta sano. Monitora le risposte HTTP 429 (Troppe richieste) e 503 e rispetta qualsiasi header Retry-After restituito dal server. Quando incontri errori, aumenta esponenzialmente l’attesa con una piccola variazione casuale, così i worker paralleli non riprovano tutti nello stesso momento.
- Concorrenza: limita le connessioni simultanee per host, non solo a livello globale.
- Ritardo di base: aggiungi una breve pausa tra le richieste allo stesso dominio.
- Backoff esponenziale: raddoppia l’attesa dopo ogni errore, fino a un limite massimo.
- Variazione casuale: rendi casuali i ritardi per distribuire i retry nel tempo.
Come ruotare IP e headers per evitare i blocchi?
Distribuisci le richieste tra molti indirizzi IP e invia headers di richiesta realistici e coerenti, in modo che ogni sessione sembri un normale browser. La rotazione distribuisce il carico e impedisce che un singolo indirizzo superi le soglie di frequenza.
Gli IP residential e mobile assomigliano a quelli di utenti reali e sono più difficili da segnalare rispetto ai range datacenter non elaborati, anche se i proxy datacenter restano adatti a target permissivi e a un throughput elevato. DataImpulse offre residential proxy, mobile proxy e proxy datacenter con sessioni rotating e sticky session, così puoi abbinare il tipo di IP alla difficoltà del sito. Abbina la rotazione a headers coerenti: un User-Agent, Accept-Language e Accept-Encoding che corrispondano a un browser reale plausibile, mantenuti stabili nella sessione anziché resi casuali a ogni richiesta. Per una checklist più approfondita, consulta la nostra guida sullo scraping senza essere bloccati.
Scegli la modalità di sessione adatta al tuo workflow. Le sessioni rotating assegnano spesso un IP nuovo, distribuendo il carico e risultando adatte al crawling parallelo di pagine non correlate; le sticky session mantengono un IP per una durata prestabilita, il che è importante per flussi in più passaggi come l’accesso, l’aggiunta al carrello o lo scorrimento di risultati legati a un cookie di sessione. DataImpulse supporta entrambe le modalità nei suoi pool. Mantieni coerenti tra loro IP, cookie e headers di una sessione, perché un IP stabile abbinato a fingerprint che cambiano è di per sé un segnale da evitare.
import requests

HEADERS_POOL = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/124.0 Safari/537.36",
        "Accept-Language": "en-US,en;q=0.9",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                      "Version/17.4 Safari/605.1.15",
        "Accept-Language": "en-GB,en;q=0.8",
    },
]

def build_session(headers, proxy_url):
    s = requests.Session()
    s.headers.update(headers)
    s.proxies.update({"http": proxy_url, "https": proxy_url})
    return s
Quando usare una API nascosta invece di analizzare HTML?
Quando esiste, preferisci la API JSON sottostante di un sito allo scraping di HTML renderizzato. Le API restituiscono dati puliti e strutturati, cambiano meno spesso del markup delle pagine e richiedono molto meno da elaborare.
Apri gli strumenti per sviluppatori del browser, osserva la scheda Network e filtra le richieste XHR o Fetch durante il caricamento della pagina. Molti siti popolano i contenuti da endpoint JSON che puoi chiamare direttamente, talvolta con semplici parametri di query per paginazione o filtri. Così eviti il sovraccarico di un browser headless, aggiri la maggior parte delle modifiche di layout e ottieni campi tipizzati anziché una fragile estrazione di testo. Controlla sempre i termini del sito e richiedi solo dati a cui sei autorizzato ad accedere; mantieni inoltre un volume di richieste ragionevole anche quando un endpoint è veloce.
Come scrivere selettori che resistono alle modifiche del sito?
Scrivi selettori che puntino ad attributi stabili e significativi e aggiungi un monitoraggio, così saprai delle interruzioni prima dei tuoi utenti. I selettori fragili sono la causa più comune di perdite silenziose di dati.
Fai leva su agganci semantici come ID degli elementi, attributi data o ruoli ARIA, anziché su catene profonde di nomi di classi generati automaticamente e modificati a ogni nuovo deploy. Mantieni la logica di parsing in un unico punto, così una modifica del layout richiede di modificare un solo modulo, non di cercare nell’intera codebase. Poi tratta il parser come codice di produzione:
- Asserzioni: conferma che ogni campo previsto sia presente e non vuoto per record.
- Canary: esegui lo scraping di alcuni URL noti a intervalli programmati e invia un avviso se la struttura cambia.
- Conteggio delle righe: confronta il volume di oggi con quello di ieri e segnala cali rilevanti.
- Istantanee: conserva un campione di HTML non elaborato per poter eseguire il debug degli errori in seguito.
In che modo retry e caching mantengono economico lo scraping?
Rendi le richieste idempotenti e riprova solo quelle che non sono riuscite, quindi usa il caching in modo estensivo per non scaricare mai di nuovo pagine che non sono cambiate. Entrambe le pratiche riducono i costi e il carico sul target.
Progetta ogni unità di lavoro attorno a una chiave stabile, come un URL o un ID record, così rieseguire un job è sicuro e non crea mai duplicati. In caso di errori transitori (timeout, 5xx, reset della connessione), riprova con backoff; in caso di errori permanenti (404, 410), registra l’esito e prosegui. Per il caching, rispetta i validatori HTTP come ETag e Last-Modified e invia richieste condizionali, affinché le pagine invariate restituiscano un piccolo 304 anziché un corpo completo. Lo scraping incrementale, che recupera solo elementi nuovi o aggiornati tramite timestamp, sitemap o feed, è la leva principale per la larghezza di banda. Poiché il traffico proxy viene fatturato per GB, saltare le pagine invariate riduce direttamente la spesa.
import time
import random
import requests
from requests.exceptions import RequestException

def fetch(session, url, retries=4):
    for attempt in range(retries):
        try:
            r = session.get(url, timeout=20)
            if r.status_code in (429, 503):
                wait = int(r.headers.get("Retry-After", 2 ** attempt))
                time.sleep(wait + random.random())
                continue
            r.raise_for_status()
            return r
        except RequestException:
            if attempt == retries - 1:
                raise
            time.sleep((2 ** attempt) + random.random())
    return None
Come convalidare i dati estratti e osservare la pipeline?
Convalida ogni batch rispetto a uno schema esplicito e registra abbastanza dettagli da diagnosticare i problemi senza rieseguire l’intero job. I dati di cui non puoi fidarti sono peggio dell’assenza di dati.
Definisci tipo, intervallo e campi obbligatori previsti per ogni colonna, quindi rifiuta o metti in quarantena i record che non li soddisfano invece di scriverli nel tuo archivio principale. Verifica le modalità di errore silenzioso: stringhe vuote dove dovrebbero esserci prezzi, date molto lontane nel futuro, improvvisi picchi nei tassi di valori nulli o chiavi duplicate. Sul fronte dell’osservabilità, registra il codice di stato, la latenza, il proxy usato e i byte trasferiti per ogni richiesta; monitora inoltre tasso di successo e costo nel tempo, così un degrado lento è visibile su un dashboard. Log strutturati e pochi avvisi trasformano uno scraper fragile in un sistema che puoi gestire con fiducia.
Quali sono le tutele legali ed etiche per lo scraping?
Estrai solo dati che sei autorizzato a raccogliere, rispetta i termini di servizio e le direttive robots ed evita dati personali per i quali non hai una base giuridica per il trattamento. Affidabilità e responsabilità vanno di pari passo.
Le regole variano in base alla giurisdizione e al tipo di dati, quindi considera la legittimità un requisito reale anziché un aspetto secondario; la nostra panoramica su se il web scraping è legittimo illustra le principali considerazioni e la guida sullo scraping senza essere bloccati tratta le tecniche rispettose. Anche la provenienza conta: DataImpulse opera come fornitore etico di proxy i cui IP provengono da utenti che aderiscono volontariamente e ricevono un compenso, mantenendo la tua raccolta dati in linea con le aspettative del GDPR.
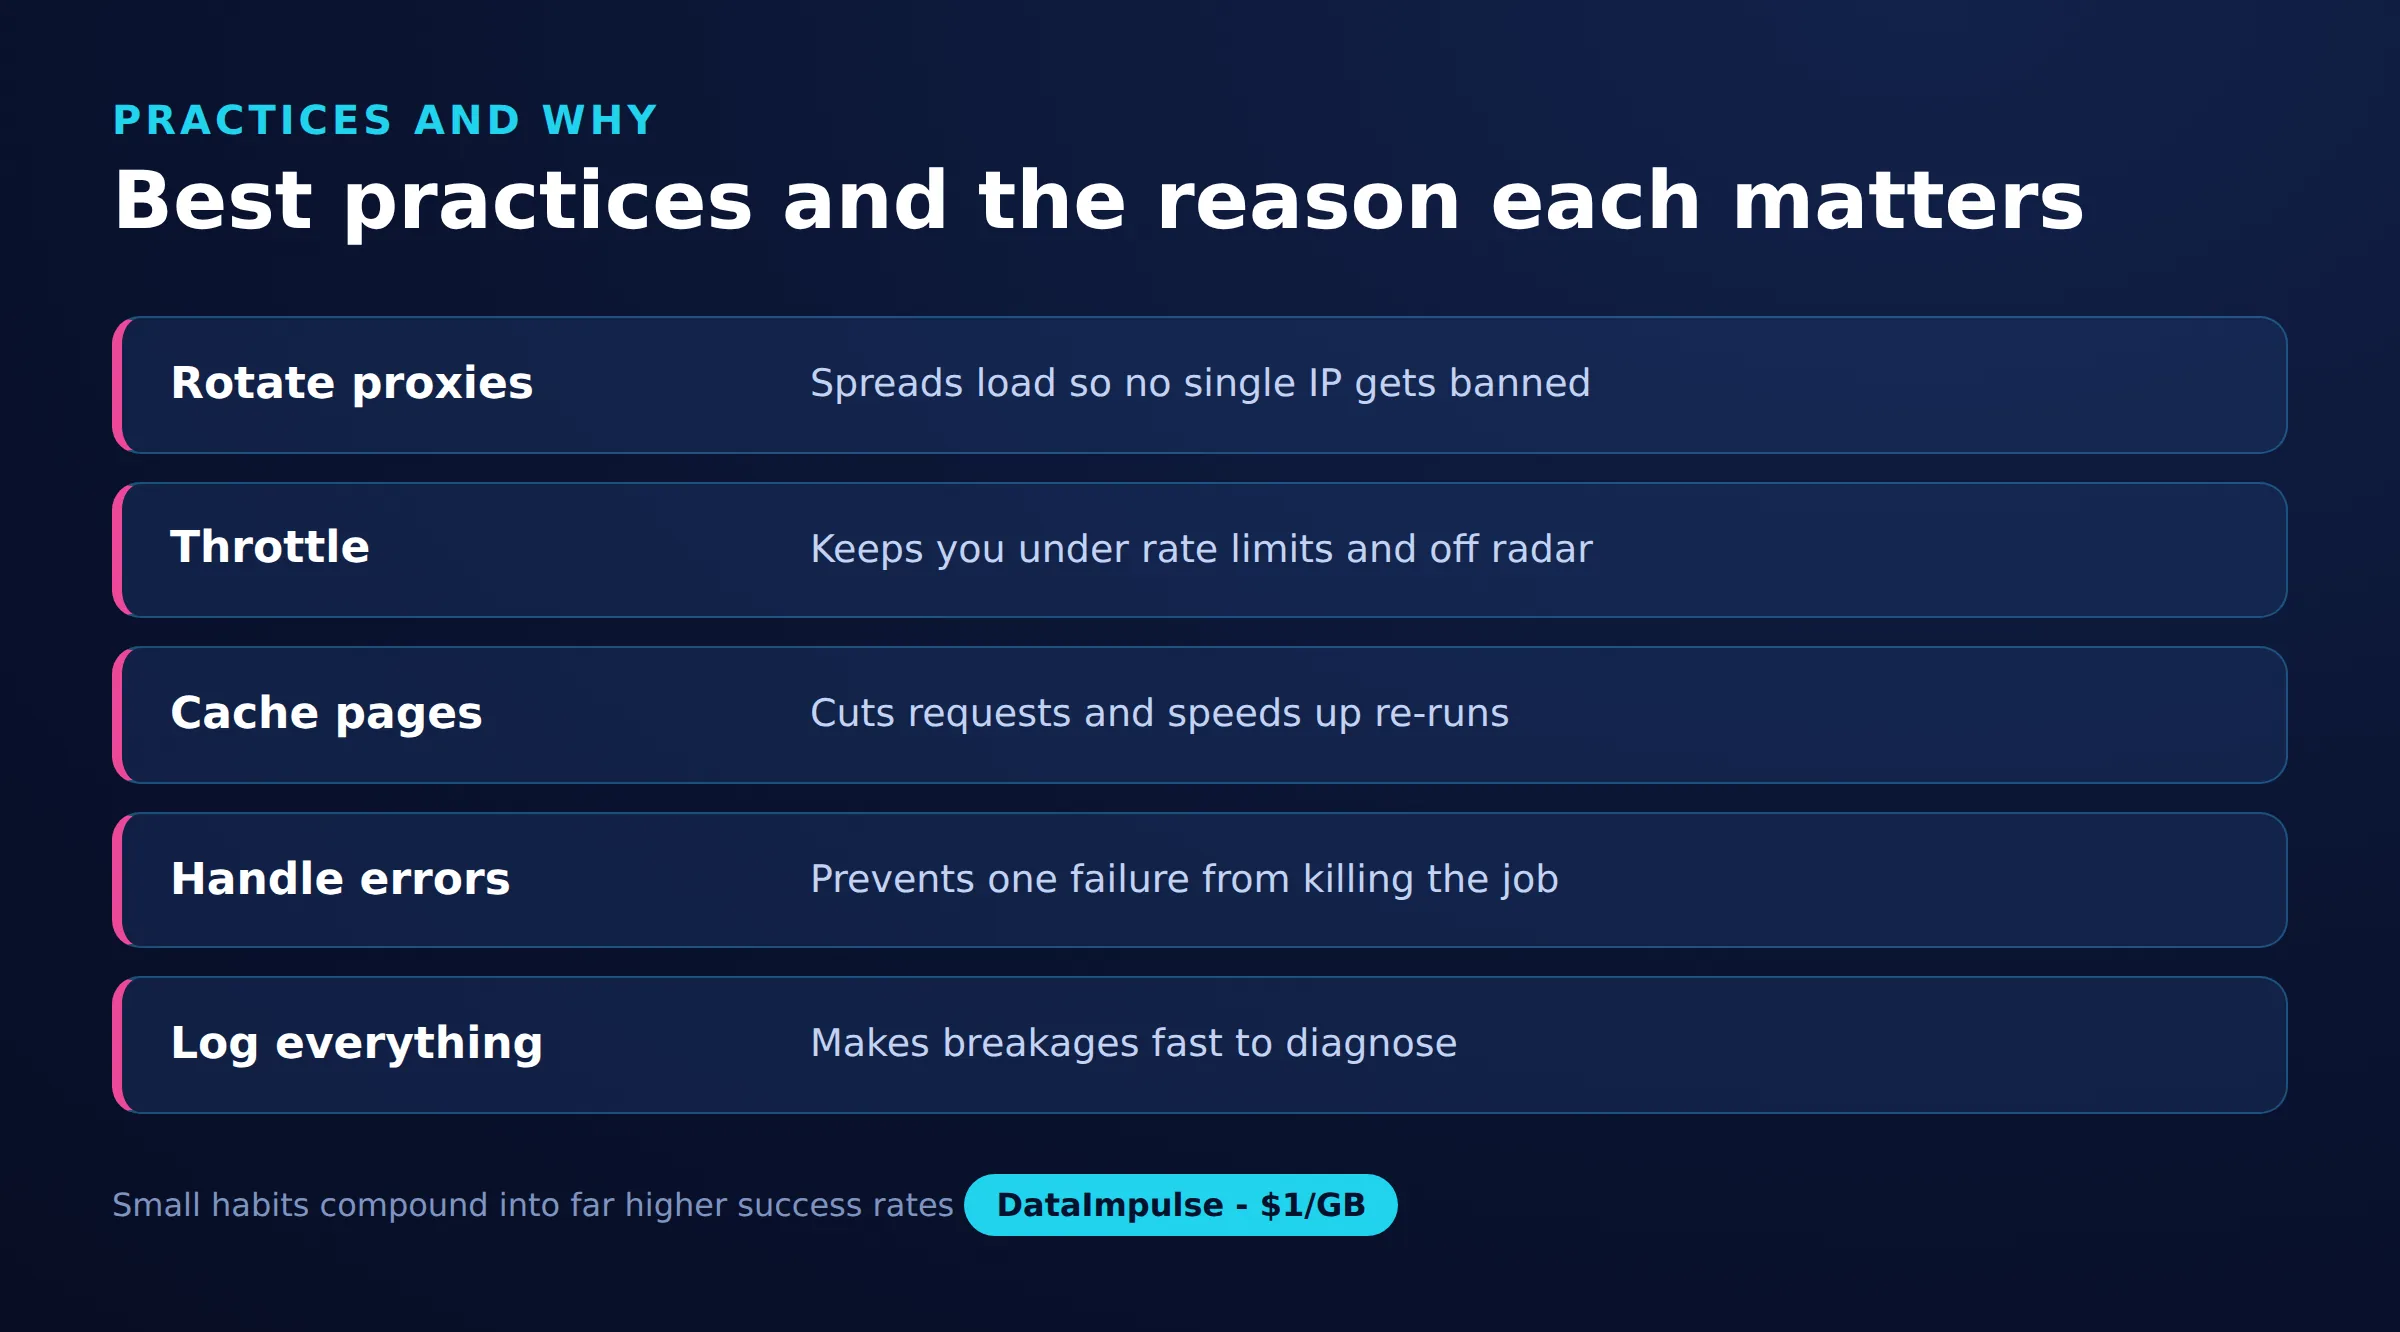
Best practice in sintesi
| Pratica | Perché | Strumenti |
|---|---|---|
| Backoff e retry | Evita di sovraccaricare i server | Librerie di retry |
| Rotazione IP | Previene i blocchi | Proxy rotating |
| Usare API nascoste | Dati più puliti e rapidi | Ispettore Network |
| Monitoraggio | Individua presto le interruzioni | Avvisi e log |
| Caching | Riduce le richieste duplicate | Archivio cache locale |
| Convalida | Garantisce la qualità dei dati | Controlli dello schema |
Domande frequenti
Qual è la best practice più importante per il web scraping?
Rispettare i limiti di frequenza con backoff adattivo. Inviare richieste a un ritmo che il target può gestire previene la maggior parte dei blocchi e mantiene stabile il tuo scraper, un aspetto più importante di qualsiasi singolo trucco anti-rilevamento.
Ho bisogno di residential proxy per il web scraping?
Non sempre. I proxy datacenter funzionano bene per siti permissivi e throughput elevato, mentre gli IP residential o mobile sono più adatti ai target con sistemi anti-bot rigidi. Abbina il tipo di IP alla difficoltà del sito.
In che modo il caching riduce i costi del web scraping?
Il caching e lo scraping incrementale ti permettono di saltare le pagine che non sono cambiate tramite richieste condizionali e timestamp. Poiché il traffico proxy viene fatturato per GB, non scaricare di nuovo contenuti invariati riduce direttamente la spesa per la larghezza di banda.
Come impedire che il mio scraper si interrompa quando un sito cambia?
Usa come target attributi stabili quali ID e attributi data anziché nomi di classi generati automaticamente, mantieni il parsing in un solo modulo ed esegui controlli canary programmati che ti avvisino quando la struttura della pagina cambia.
Dovrei usare sessioni rotating o sticky session?
Usa le sessioni rotating per grandi batch di richieste indipendenti e le sticky session quando un workflow richiede lo stesso IP in più passaggi, come l’accesso o lo scorrimento di risultati legati alla sessione.
Quando DataImpulse non è la scelta giusta?
Se hai bisogno di proxy ISP statici, di una API di scraping completamente gestita o dell’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter rotating per raccogliere dati pubblici e accedere ai contenuti.
Crea scraper affidabili su proxy etici
Solide pratiche ingegneristiche funzionano al meglio su una rete affidabile. DataImpulse offre proxy etici rotating e sticky session in 195 paesi, con traffico a consumo senza scadenza a partire da 1 dollaro per GB, così puoi iniziare in piccolo e scalare man mano che la tua pipeline cresce. Crea un account per mettere in produzione queste best practice.