
In this Article
แนวทางปฏิบัติที่ดีที่สุดสำหรับ web scraping คือสิ่งที่แยกระหว่างตัวเก็บข้อมูลที่ทำงานเงียบ ๆ ได้นานหลายเดือน กับตัวที่พัง ถูกบล็อก หรือส่งคืนข้อมูลไร้ประโยชน์โดยไม่มีสัญญาณ คู่มือนี้เน้นด้านวิศวกรรม: วิธีสร้าง scraper ที่เชื่อถือได้ สุภาพต่อเว็บไซต์ที่อ่าน และมีต้นทุนต่ำเมื่อใช้งานในระดับใหญ่
scraper ส่วนใหญ่มักล้มเหลวด้วยรูปแบบที่คาดเดาได้: ส่งคำขอถี่เกินไป ดูเหมือนบอต หรือพึ่งพาโครงสร้างหน้าที่เปลี่ยนแปลง การมอง scraping เป็น data pipeline แทนที่จะเป็นสคริปต์ใช้ครั้งเดียวคือการปรับกรอบความคิดหลัก และเทคนิคด้านล่างครอบคลุมการจำกัดอัตรา การสลับ IP และ headers การเลือกแหล่งข้อมูลที่เหมาะสม การแยกวิเคราะห์ที่ทนทาน การลองใหม่ การแคช และการประกันคุณภาพ เทคนิคเหล่านี้ใช้ได้ไม่ว่าจะเก็บเพียงไม่กี่พันหน้าต่อวันหรือหลายล้านหน้า
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมีที่อยู่ IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการใน 195 ประเทศ ใช้โมเดลจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- ให้ความสำคัญกับความน่าเชื่อถือ: แนวทางปฏิบัติสำหรับ web scraping ที่สำคัญที่สุดคือเคารพขีดจำกัดอัตรา สลับ IP พร้อม headers ที่สมจริง ลองใหม่พร้อม backoff และตรวจสอบทุกชุดข้อมูลก่อนเชื่อถือ
- ชนิด proxy ที่เหมาะที่สุด: rotating residential proxy ซึ่งใช้ IP ของผู้ใช้จริงที่ผ่านการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุและไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่จัดหามาอย่างมีจริยธรรมมากกว่า 90M+ ใน 195 ประเทศ
- ความน่าเชื่อถือ: อัตราสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
ควรเคารพขีดจำกัดอัตราและชะลอการส่งคำขออย่างไร?
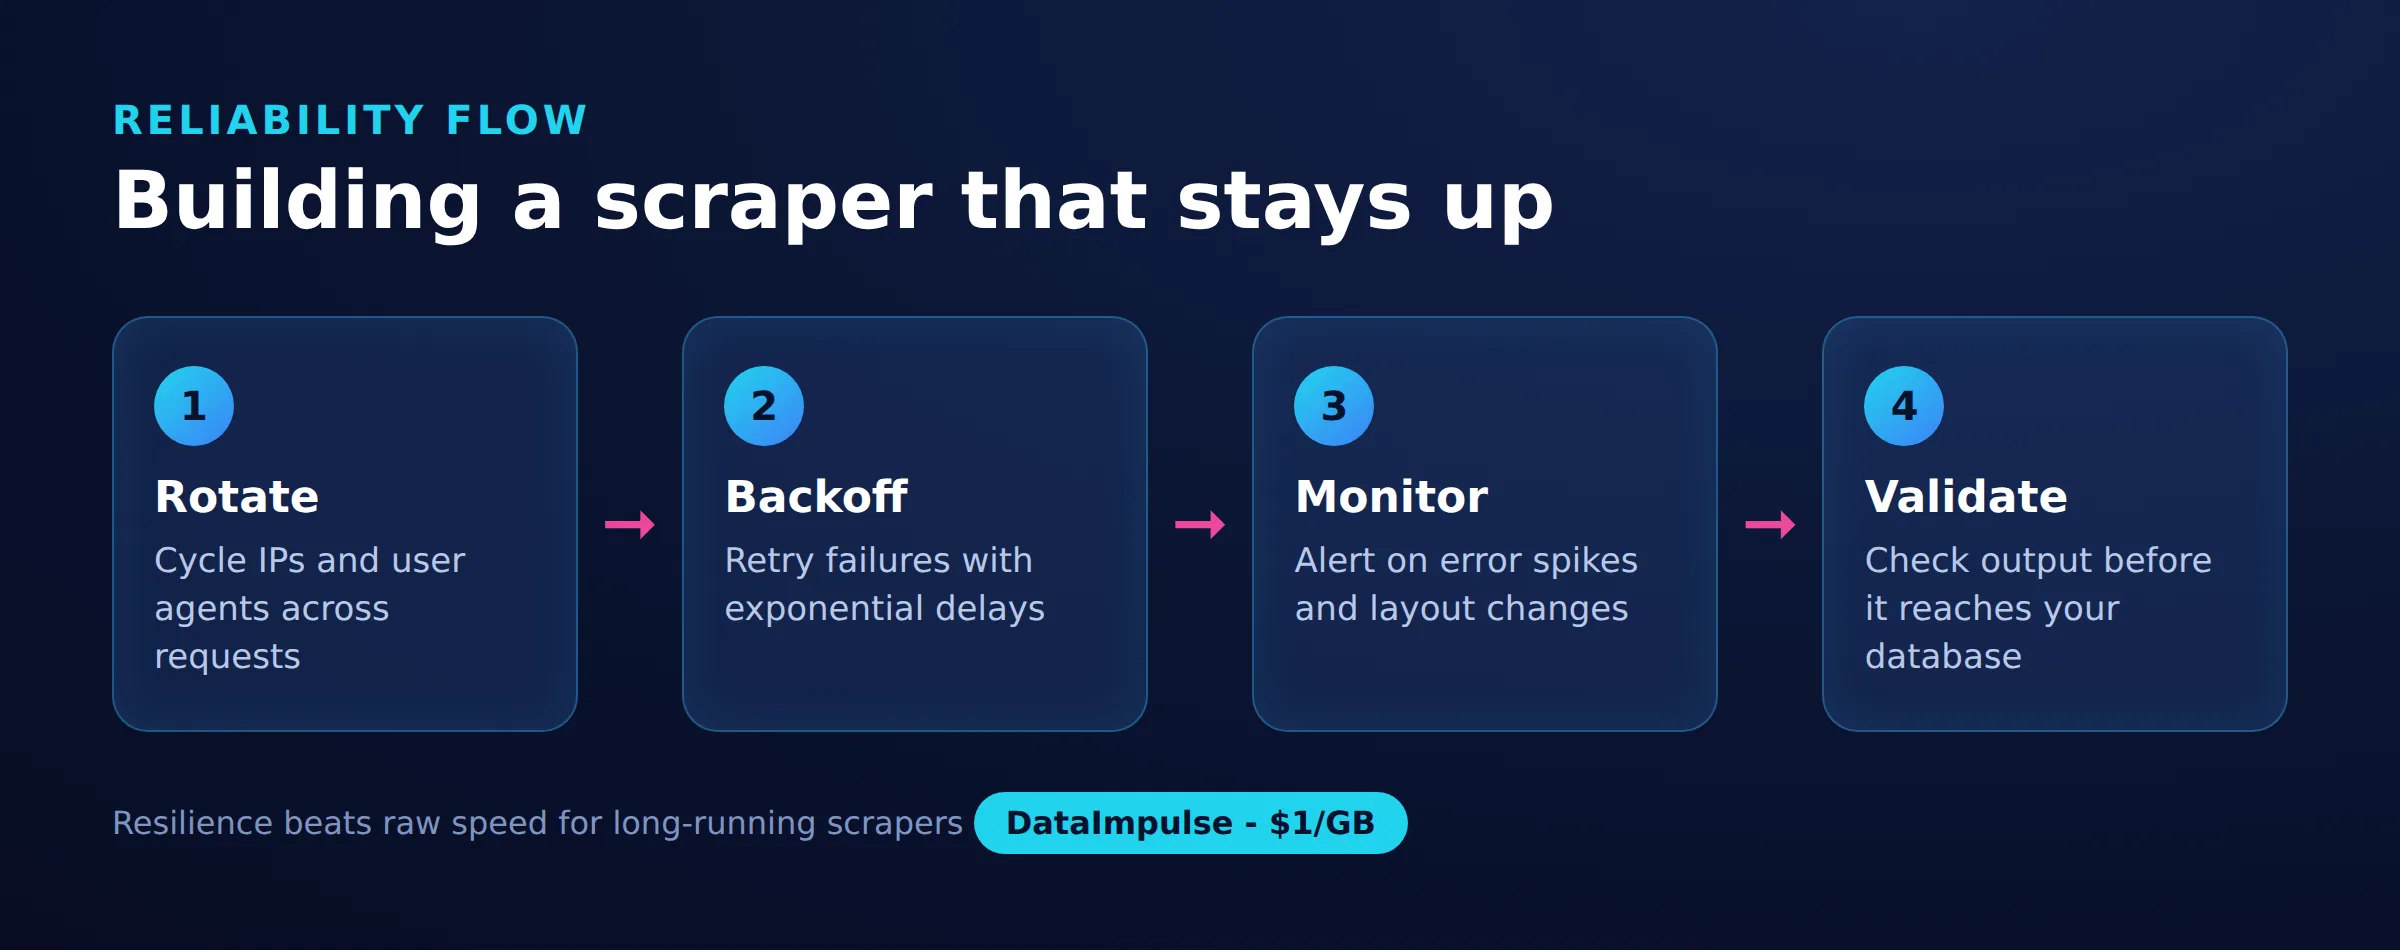
ส่งคำขอในอัตราที่เป้าหมายรองรับได้ และชะลอลงอัตโนมัติเมื่อเป้าหมายส่งสัญญาณว่ามีภาระสูง adaptive backoff ทั้งสุภาพและช่วยป้องกันตัว เพราะทราฟฟิกเชิงรุกเป็นทางที่เร็วที่สุดในการถูกบล็อก
เริ่มด้วยระดับ concurrency แบบระมัดระวังและมีช่วงหน่วงเล็กน้อยระหว่างคำขอ จากนั้นจึงปรับเพิ่มเมื่อเว็บไซต์ยังทำงานปกติเท่านั้น เฝ้าดูการตอบกลับ HTTP 429 (คำขอมากเกินไป) และ 503 และปฏิบัติตาม header Retry-After ที่เซิร์ฟเวอร์ส่งกลับ เมื่อพบข้อผิดพลาด ให้เพิ่มเวลารอแบบทวีคูณพร้อม random jitter เล็กน้อย เพื่อไม่ให้ worker ที่ทำงานขนานกันลองใหม่พร้อมกันเป็นจังหวะเดียว
- Concurrency: จำกัดการเชื่อมต่อพร้อมกันต่อโฮสต์ ไม่ใช่เพียงโดยรวม
- ช่วงหน่วงพื้นฐาน: เพิ่มการหยุดสั้น ๆ ระหว่างคำขอไปยังโดเมนเดียวกัน
- Exponential backoff: เพิ่มเวลารอเป็นสองเท่าหลังล้มเหลวแต่ละครั้งจนถึงเพดานที่กำหนด
- Jitter: สุ่มช่วงหน่วงเพื่อให้การลองใหม่กระจายออกตามเวลา
จะสลับ IP และ headers อย่างไรเพื่อหลีกเลี่ยงการบล็อก?
กระจายคำขอไปยังที่อยู่ IP หลายรายการและส่ง request headers ที่สมจริงและสอดคล้องกัน เพื่อให้แต่ละ session ดูเหมือนเบราว์เซอร์ปกติ การสลับช่วยกระจายภาระและป้องกันไม่ให้ที่อยู่เดียวแตะเกณฑ์อัตรา
IP แบบ residential และ mobile มีลักษณะคล้ายผู้ใช้จริงและถูกระบุได้ยากกว่าช่วง datacenter แบบดิบ แม้ datacenter proxy ยังคงเหมาะกับเป้าหมายที่อนุญาตได้ง่ายและงานปริมาณสูง DataImpulse มี residential proxy, mobile proxy และ datacenter proxy พร้อม rotating และ sticky session จึงเลือกชนิด IP ให้ตรงกับความยากของเว็บไซต์ได้ จับคู่การสลับกับ headers ที่สอดคล้องกัน: User-Agent, Accept-Language และ Accept-Encoding ที่ตรงกับเบราว์เซอร์จริงที่สมเหตุสมผล โดยคงให้เสถียรภายใน session แทนที่จะสุ่มใหม่ทุกคำขอ หากต้องการรายการตรวจสอบเชิงลึก โปรดดูคู่มือ การ scraping โดยไม่ถูกบล็อก
เลือกโหมด session ให้ตรงกับเวิร์กโฟลว์ rotating session กำหนด IP ใหม่เป็นประจำ ช่วยกระจายภาระและเหมาะกับการ crawl หน้าที่ไม่เกี่ยวข้องกันแบบขนาน ส่วน sticky session จะใช้ IP เดียวตามระยะเวลาที่กำหนด ซึ่งสำคัญสำหรับกระบวนการหลายขั้นตอน เช่น การเข้าสู่ระบบ การเพิ่มสินค้าลงตะกร้า หรือการเลื่อนดูผลลัพธ์ที่ผูกกับ session cookie DataImpulse รองรับทั้งสองโหมดใน pool ของตน รักษา IP, cookies และ headers ของ session ให้สอดคล้องกัน เพราะ IP ที่เสถียรแต่จับคู่กับ fingerprint ที่เปลี่ยนไปมาก็เป็นสัญญาณที่ควรหลีกเลี่ยง
import requests

HEADERS_POOL = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/124.0 Safari/537.36",
        "Accept-Language": "en-US,en;q=0.9",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                      "Version/17.4 Safari/605.1.15",
        "Accept-Language": "en-GB,en;q=0.8",
    },
]

def build_session(headers, proxy_url):
    s = requests.Session()
    s.headers.update(headers)
    s.proxies.update({"http": proxy_url, "https": proxy_url})
    return s
เมื่อใดควรใช้ API ที่ซ่อนอยู่แทนการแยกวิเคราะห์ HTML?
หากมี API JSON พื้นฐานของเว็บไซต์ ให้เลือกใช้แทนการ scraping HTML ที่เรนเดอร์แล้ว APIs ส่งคืนข้อมูลที่สะอาดและมีโครงสร้าง เปลี่ยนแปลงน้อยกว่า markup ของหน้า และใช้ต้นทุนประมวลผลน้อยกว่ามาก
เปิดเครื่องมือสำหรับนักพัฒนาในเบราว์เซอร์ ดูแท็บ Network และกรองคำขอ XHR หรือ Fetch ขณะหน้าโหลด เว็บไซต์จำนวนมากเติมเนื้อหาจาก JSON endpoint ที่เรียกใช้โดยตรงได้ บางครั้งมี query parameters อย่างง่ายสำหรับการแบ่งหน้าหรือการกรอง วิธีนี้หลีกเลี่ยงภาระของเบราว์เซอร์แบบ headless ลดผลกระทบจากการเปลี่ยนเลย์เอาต์ส่วนใหญ่ และให้ฟิลด์แบบระบุชนิดแทนการดึงข้อความที่เปราะบาง ควรตรวจสอบเงื่อนไขของเว็บไซต์เสมอและขอเฉพาะข้อมูลที่ได้รับอนุญาตให้เข้าถึง รวมทั้งรักษาปริมาณคำขอให้เหมาะสมแม้ endpoint จะรวดเร็ว
จะเขียน selector ให้ทนต่อการเปลี่ยนแปลงของเว็บไซต์ได้อย่างไร?
เขียน selector ที่กำหนดเป้าหมายแอตทริบิวต์ที่เสถียรและมีความหมาย พร้อมเพิ่มการติดตามเพื่อให้ทราบการขัดข้องก่อนผู้ใช้ selector ที่เปราะบางเป็นสาเหตุที่พบบ่อยที่สุดของการสูญหายของข้อมูลโดยไม่มีสัญญาณ
ยึด semantic hook เช่น ID ขององค์ประกอบ, data attribute หรือ ARIA role แทนสาย class name ที่สร้างอัตโนมัติซึ่งลึกและเปลี่ยนทุกครั้งที่ปรับใช้ใหม่ รวมตรรกะการแยกวิเคราะห์ไว้ที่เดียว เพื่อให้การเปลี่ยนเลย์เอาต์หมายถึงการแก้เพียงโมดูลเดียว ไม่ใช่ค้นหาทั่ว codebase จากนั้นปฏิบัติต่อ parser เสมือนเป็นโค้ดสำหรับใช้งานจริง:
- Assertions: ยืนยันว่าทุกฟิลด์ที่คาดหวังมีอยู่และไม่ว่างในแต่ละระเบียน
- Canaries: scraping URL ที่ทราบแน่ชัดบางรายการตามกำหนดเวลาและแจ้งเตือนหากรูปแบบเปลี่ยน
- จำนวนแถว: เปรียบเทียบปริมาณวันนี้กับเมื่อวานและระบุการลดลงมากผิดปกติ
- Snapshots: เก็บตัวอย่าง HTML ดิบไว้เพื่อแก้จุดบกพร่องของความล้มเหลวภายหลัง
การลองใหม่และการแคชช่วยให้ scraping มีต้นทุนต่ำได้อย่างไร?
ทำให้คำขอมีคุณสมบัติ idempotent และลองใหม่เฉพาะสิ่งที่ล้มเหลว จากนั้นแคชอย่างจริงจังเพื่อไม่ต้องดาวน์โหลดหน้าที่ยังไม่เปลี่ยนอีก ทั้งสองแนวทางช่วยลดต้นทุนและภาระบนเป้าหมาย
ออกแบบหน่วยงานแต่ละส่วนโดยใช้คีย์ที่เสถียร เช่น URL หรือ ID ระเบียน เพื่อให้การรันงานซ้ำปลอดภัยและไม่สร้างข้อมูลซ้ำ เมื่อเกิดข้อผิดพลาดชั่วคราว (หมดเวลา, 5xx, การเชื่อมต่อถูกรีเซ็ต) ให้ลองใหม่ด้วย backoff ส่วนข้อผิดพลาดถาวร (404, 410) ให้บันทึกผลแล้วทำต่อไป สำหรับการแคช ให้ปฏิบัติตาม HTTP validator เช่น ETag และ Last-Modified และส่งคำขอแบบมีเงื่อนไข เพื่อให้หน้าที่ยังไม่เปลี่ยนส่งกลับ 304 ขนาดเล็กแทนเนื้อหาฉบับเต็ม การ scraping แบบเพิ่มเฉพาะส่วน (ดึงเฉพาะรายการใหม่หรือที่อัปเดตโดยใช้ timestamps, sitemap หรือ feed) เป็นปัจจัยที่ทรงพลังที่สุดในการลดการใช้แบนด์วิดท์ เนื่องจากคิดค่าทราฟฟิก proxy ต่อ GB การข้ามหน้าที่ยังไม่เปลี่ยนจึงลดค่าใช้จ่ายโดยตรง
import time
import random
import requests
from requests.exceptions import RequestException

def fetch(session, url, retries=4):
    for attempt in range(retries):
        try:
            r = session.get(url, timeout=20)
            if r.status_code in (429, 503):
                wait = int(r.headers.get("Retry-After", 2 ** attempt))
                time.sleep(wait + random.random())
                continue
            r.raise_for_status()
            return r
        except RequestException:
            if attempt == retries - 1:
                raise
            time.sleep((2 ** attempt) + random.random())
    return None
จะตรวจสอบข้อมูลที่ scraping และติดตาม pipeline ได้อย่างไร?
ตรวจสอบทุกชุดข้อมูลกับ schema ที่ชัดเจน และบันทึกรายละเอียดเพียงพอสำหรับวินิจฉัยปัญหาโดยไม่ต้องรันงานทั้งหมดซ้ำ ข้อมูลที่เชื่อถือไม่ได้แย่กว่าการไม่มีข้อมูล
กำหนดชนิด ช่วง และฟิลด์ที่จำเป็นที่คาดหวังสำหรับแต่ละคอลัมน์ แล้วปฏิเสธหรือกักกันระเบียนที่ไม่ผ่าน แทนการเขียนไปยังที่เก็บหลัก ตรวจสอบรูปแบบความล้มเหลวที่เกิดอย่างเงียบ ๆ: สตริงว่างในตำแหน่งที่ควรเป็นราคา วันที่ไกลเกินไปในอนาคต อัตราค่าว่างที่เพิ่มขึ้นฉับพลัน หรือคีย์ซ้ำ ในด้าน observability ให้บันทึกรหัสสถานะ เวลาแฝง proxy ที่ใช้ และจำนวนไบต์ที่ถ่ายโอนของทุกคำขอ แล้วติดตามอัตราสำเร็จและต้นทุนตามเวลาเพื่อให้เห็นการเสื่อมลงอย่างช้า ๆ บน dashboard structured logs พร้อมการแจ้งเตือนเพียงไม่กี่รายการจะเปลี่ยน scraper ที่เปราะบางให้เป็นระบบที่ดำเนินงานได้อย่างมั่นใจ
แนวปฏิบัติด้านกฎหมายและจริยธรรมสำหรับ scraping มีอะไรบ้าง?
scraping เฉพาะข้อมูลที่ได้รับอนุญาตให้เก็บ เคารพเงื่อนไขการให้บริการและคำสั่ง robots และหลีกเลี่ยงข้อมูลส่วนบุคคลที่ไม่มีฐานทางกฎหมายในการประมวลผล ความน่าเชื่อถือและความรับผิดชอบต้องไปด้วยกัน
กฎแตกต่างกันตามเขตอำนาจศาลและชนิดข้อมูล ดังนั้นควรมองความชอบด้วยกฎหมายเป็นข้อกำหนดจริง ไม่ใช่สิ่งที่นึกถึงภายหลัง ภาพรวมของเราว่า web scraping ชอบด้วยกฎหมายหรือไม่ อธิบายประเด็นสำคัญ และคู่มือ การ scraping โดยไม่ถูกบล็อก ครอบคลุมเทคนิคที่สุภาพ แหล่งที่มาสำคัญเช่นกัน: DataImpulse ดำเนินงานเป็นผู้ให้บริการ proxy ที่มีจริยธรรม ซึ่ง IP มาจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน ช่วยให้การรวบรวมข้อมูลสอดคล้องกับความคาดหวังของ GDPR
แนวทางปฏิบัติแบบสรุป
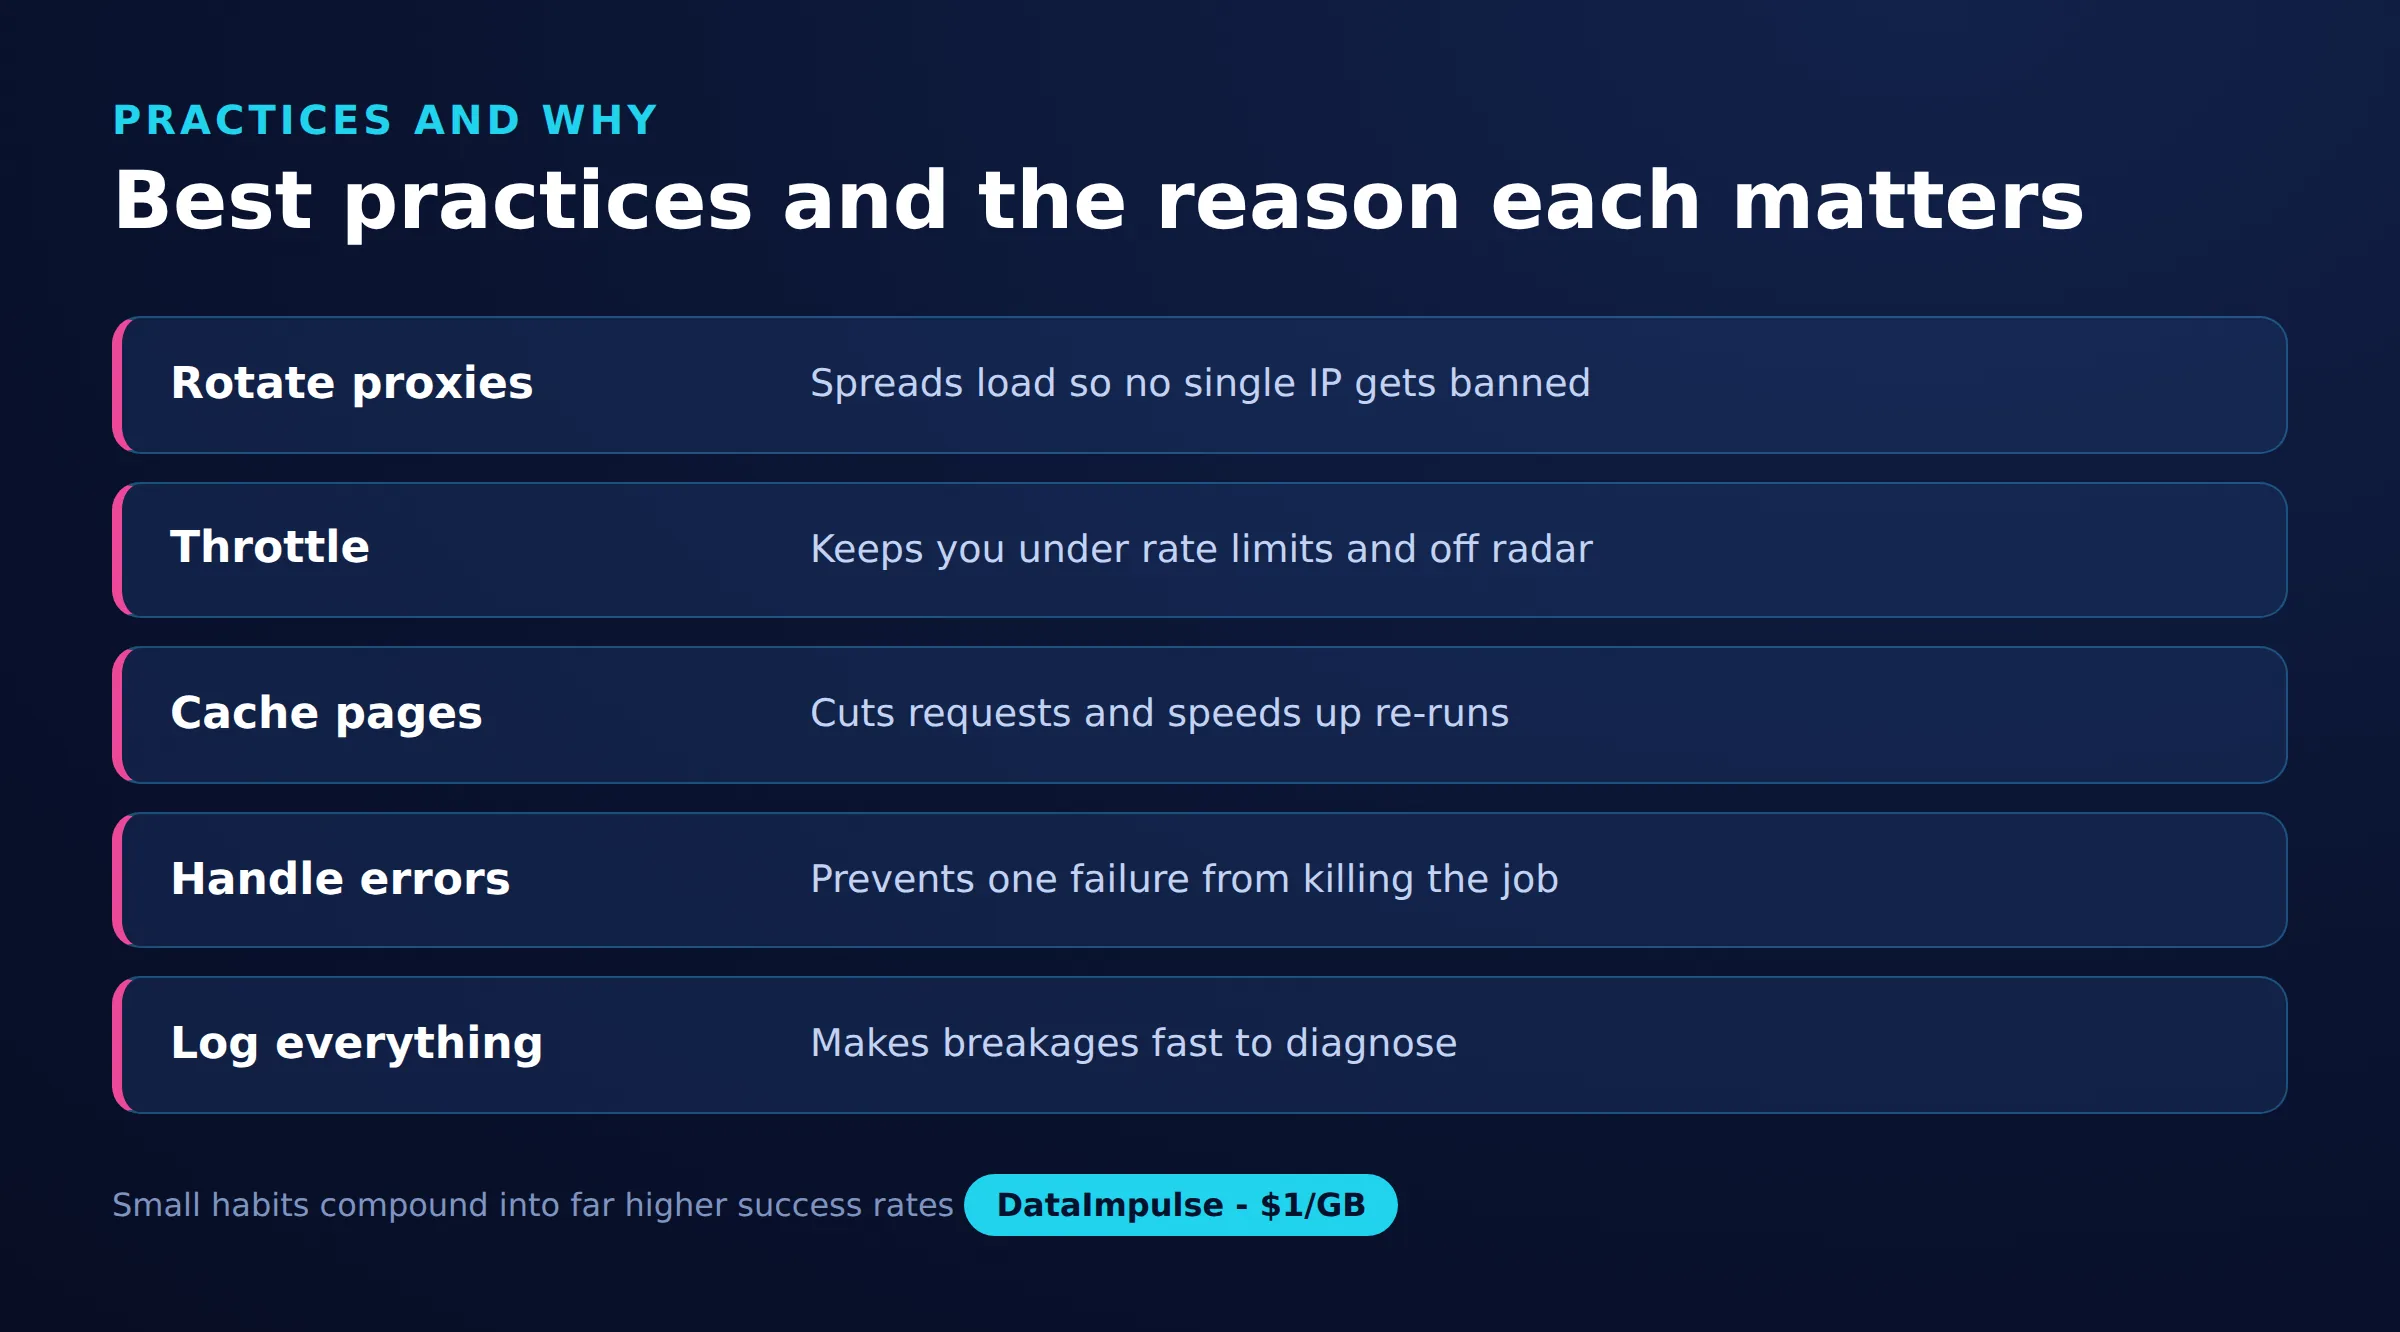
| แนวปฏิบัติ | เหตุผล | เครื่องมือ |
|---|---|---|
| Backoff และการลองใหม่ | หลีกเลี่ยงการทำให้เซิร์ฟเวอร์ทำงานหนักเกินไป | ไลบรารีสำหรับลองใหม่ |
| การสลับ IP | ป้องกันการบล็อก | rotating proxy |
| ใช้ API ที่ซ่อนอยู่ | ข้อมูลสะอาดและรวดเร็วกว่า | ตัวตรวจสอบ Network |
| การติดตาม | พบการขัดข้องได้เร็ว | การแจ้งเตือนและ logs |
| การแคช | ลดคำขอซ้ำ | ที่เก็บแคชในเครื่อง |
| การตรวจสอบความถูกต้อง | รับประกันคุณภาพข้อมูล | การตรวจ schema |
คำถามที่พบบ่อย
แนวทางปฏิบัติที่สำคัญที่สุดสำหรับ web scraping คืออะไร?
การเคารพขีดจำกัดอัตราด้วย adaptive backoff การส่งคำขอในอัตราที่เป้าหมายรองรับได้ช่วยป้องกันการบล็อกส่วนใหญ่และทำให้ตัวเก็บข้อมูลทำงานเสถียร ซึ่งสำคัญกว่ากลวิธีหลบเลี่ยงการตรวจจับเพียงวิธีใดวิธีหนึ่ง
จำเป็นต้องใช้ residential proxy สำหรับ web scraping หรือไม่?
ไม่เสมอไป datacenter proxy ใช้ได้ดีกับเว็บไซต์ที่อนุญาตได้ง่ายและงานปริมาณสูง ขณะที่ IP แบบ residential หรือ mobile เหมาะกับเป้าหมายที่มีระบบป้องกันบอตเข้มงวดกว่า ควรเลือกชนิด IP ให้เหมาะกับระดับความยากของเว็บไซต์
การแคชช่วยลดต้นทุน web scraping ได้อย่างไร?
การแคชและการ scraping แบบเพิ่มเฉพาะส่วนช่วยให้ข้ามหน้าที่ยังไม่เปลี่ยนได้ โดยใช้คำขอแบบมีเงื่อนไขและ timestamps เนื่องจากคิดค่าทราฟฟิก proxy ต่อ GB การไม่ดาวน์โหลดเนื้อหาที่ไม่เปลี่ยนซ้ำจึงช่วยลดค่าแบนด์วิดท์โดยตรง
จะป้องกันไม่ให้ scraper เสียเมื่อเว็บไซต์เปลี่ยนได้อย่างไร?
เลือกแอตทริบิวต์ที่เสถียร เช่น ID และ data attribute แทนชื่อ class ที่สร้างอัตโนมัติ รวมการแยกวิเคราะห์ไว้ในโมดูลเดียว และตั้งการตรวจ canary ตามกำหนดเวลาเพื่อแจ้งเตือนเมื่อโครงสร้างหน้าเปลี่ยน
ควรใช้ rotating หรือ sticky session?
ใช้ rotating session สำหรับคำขออิสระจำนวนมาก และใช้ sticky session เมื่องานต้องใช้ IP เดิมตลอดหลายขั้นตอน เช่น การเข้าสู่ระบบหรือการเลื่อนดูผลลัพธ์ที่ผูกกับ session
เมื่อใดที่ DataImpulse ไม่ใช่ตัวเลือกที่เหมาะสม?
หากต้องการ ISP proxy แบบคงที่ API สำหรับการ scraping ที่จัดการให้ทั้งหมด หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยเน้น rotating proxy แบบ residential, mobile และ datacenter สำหรับรวบรวมข้อมูลสาธารณะและเข้าถึงเนื้อหา
สร้าง scraper ที่เชื่อถือได้บน proxy ที่มีจริยธรรม
แนวปฏิบัติทางวิศวกรรมที่ดีทำงานได้ดีที่สุดบนเครือข่ายที่เชื่อถือได้ DataImpulse มี rotating และ sticky proxy ที่มีจริยธรรม ใน 195 ประเทศ พร้อมการจ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุเริ่มต้นที่ 1 ดอลลาร์ต่อ GB จึงเริ่มต้นขนาดเล็กและขยายตามการเติบโตของ pipeline ได้ สร้างบัญชี เพื่อนำแนวทางปฏิบัติเหล่านี้ไปใช้จริง