
In this Article
web scraping ถูกกฎหมายหรือไม่? ความชอบด้วยกฎหมายของ web scraping ขึ้นอยู่กับ 4 เรื่อง: คุณ scrape อะไร (ราคาสินค้าสาธารณะเทียบกับโปรไฟล์ส่วนบุคคล), scrape อย่างไร (หน้าสาธารณะเทียบกับหลังการล็อกอิน), ดำเนินการ ที่ใด (แนวคิด CFAA ของสหรัฐฯ เทียบกับ GDPR ของยุโรป) และ ทำอะไร กับข้อมูล (การติดตามราคาเทียบกับการฝึก AI) ดังนั้นเมื่อมีคนถามว่า “การ scrape ข้อมูลจากเว็บไซต์ถูกกฎหมายหรือไม่” คำตอบตรงไปตรงมาคือ การ scrape ข้อมูลที่เปิดเผยต่อสาธารณะและไม่ใช่ข้อมูลส่วนบุคคลนั้นโดยทั่วไปชอบด้วยกฎหมายในหลายเขตอำนาจศาล แต่แต่ละปัจจัยเหล่านี้อาจทำให้คุณอยู่ระหว่างแนวปฏิบัติทางธุรกิจที่พอปกป้องได้กับการถูกหน่วยงานกำกับดูแลดำเนินการ คู่มือนี้ครอบคลุมคดีสำคัญ คดีความยุค AI ปี 2025–2026 จุดยืนของหน่วยงานกำกับดูแลหลักทุกแห่ง และกรอบการปฏิบัติตามข้อกำหนดที่ใช้งานได้จริง
ขอเน้นตั้งแต่ต้น: นี่คือข้อมูลทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย ก่อนขยายระบบ scraping เชิงพาณิชย์ ควรขอคำแนะนำทางกฎหมายในเขตอำนาจศาลของคุณและของเป้าหมายคุณ
ข้อเท็จจริงสำคัญ
- การ scrape ข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลโดยทั่วไปชอบด้วยกฎหมาย ; รายละเอียด (อะไร อย่างไร ที่ไหน เพราะอะไร) เป็นตัวตัดสินทุกอย่าง
- “สาธารณะ” ไม่ได้หมายความว่า “หยิบไปได้ฟรี” สำหรับข้อมูลส่วนบุคคล ; หน่วยงานกำกับดูแลใน EU ปรับกรณีนี้ (Clearview: €30.5M เนเธอร์แลนด์, €20M อิตาลี, £7.5M สหราชอาณาจักร)
- การออกจากระบบเทียบกับการล็อกอินคือเส้นแบ่งที่ยังคงชนะคดี ; การ scrape แบบออกจากระบบจากหน้าสาธารณะพอปกป้องได้ (hiQ, Meta v. Bright Data); แต่การทำหลังล็อกอินโดยขัดกับเงื่อนไขที่ยอมรับแล้วไม่ใช่
- ยุค AI เพิ่มข้อเรียกร้องด้านสัญญา ใบอนุญาต และลิขสิทธิ์ ; ความชอบด้วยกฎหมายของ การเก็บรวบรวม และ การฝึก เป็นคำถามแยกกันแล้ว
- proxy เองนั้นถูกกฎหมาย ; กิจกรรม ไม่ใช่เครื่องมือ เป็นตัวกำหนดความชอบด้วยกฎหมาย
คำตอบสั้นตามคำถาม
| คำถาม | คำตอบสั้น |
|---|---|
| การ scrape ข้อมูลสินค้า/ราคาสาธารณะถูกกฎหมายหรือไม่? | โดยทั่วไปใช่ ; เป็นหมวดหมู่ที่พอปกป้องได้มากที่สุดในทุกที่ |
| การ scrape ข้อมูลส่วนบุคคล (ชื่อ โปรไฟล์ รายชื่อติดต่อ) ถูกกฎหมายหรือไม่? | ความเสี่ยงสูง ; หน่วยงานกำกับดูแล GDPR ปรับแม้ข้อมูลจะเป็นสาธารณะ |
| การ scrape หลังล็อกอินถูกกฎหมายหรือไม่? | มีความเสี่ยง ; คุณยอมรับเงื่อนไขแล้ว ข้อเรียกร้องตามสัญญายังคงอยู่แม้ CFAA ใช้ไม่ได้ |
| การฝ่าฝืน robots.txt ผิดกฎหมายหรือไม่? | ไม่ใช่กฎหมายในตัวเอง แต่ศาลและหน่วยงานกำกับดูแลถือเป็นหลักฐานของการไม่สุจริต |
| การใช้ proxy ถูกกฎหมายหรือไม่? | ใช่ ; กิจกรรม ไม่ใช่เครื่องมือ เป็นตัวกำหนดความชอบด้วยกฎหมาย |
| การ scrape เพื่อฝึก AI ถูกกฎหมายหรือไม่? | ยังไม่แน่ชัด ; fair use ชนะสำหรับข้อมูลที่ได้มาโดยชอบ แต่คดีเรื่องสัญญา/ใบอนุญาตกำลังเพิ่มขึ้น |
ความเชื่อผิด ๆ ที่พบบ่อยเกี่ยวกับความชอบด้วยกฎหมายของ web scraping
ความสับสนส่วนใหญ่เกี่ยวกับความชอบด้วยกฎหมายของ web scraping เกิดจากการปะปนระหว่างความสามารถทางเทคนิคกับสิทธิอนุญาตทางกฎหมาย มี 3 ความเชื่อที่ควรทำความเข้าใจก่อนลงรายละเอียด
ความเชื่อที่ 1: Web Scraping คือการแฮ็ก
การ scrape หน้าสาธารณะไม่ใช่การเข้าถึงโดยไม่ได้รับอนุญาต ; bot ขอหน้าต่างเดียวกับที่เบราว์เซอร์ทั่วไปขอ คดี hiQ v. LinkedIn (2022) ของศาลอุทธรณ์สหรัฐฯ เขต 9 วินิจฉัยว่าการ scrape หน้าสาธารณะไม่น่าฝ่าฝืน CFAA หากไม่ได้ข้ามด่านการยืนยันตัวตน ผู้คนยังถามว่า “screen scraping ถูกกฎหมายหรือไม่” ; คำตอบเดียวกัน: การอ่านหน้าสาธารณะเหมือนที่เบราว์เซอร์ทำไม่ใช่ “การแฮ็ก”
ความเชื่อที่ 2: “ข้อมูลสาธารณะ” หมายถึงหยิบไปได้ฟรี
สาธารณะไม่ได้หมายถึงไม่มีข้อจำกัด ข้อมูลส่วนบุคคลยังได้รับการคุ้มครองแม้จะแสดงให้เห็นอย่างเปิดเผย ; หน่วยงานกำกับดูแลยุโรปปรับกรณี scrape ข้อมูลส่วนบุคคลสาธารณะ ลิขสิทธิ์ยังคุ้มครองบทความและภาพสาธารณะ และเงื่อนไขการให้บริการอาจผูกพันคุณได้แม้ไม่ล็อกอิน ดังนั้นคำถามที่แท้จริง ; การ scrape ข้อมูลถูกกฎหมายหรือไม่? ; ขึ้นอยู่มากกับว่าข้อมูลนั้นคืออะไร
ความเชื่อที่ 3: การฝ่าฝืน ToS คืออาชญากรรม
การผิดเงื่อนไขการให้บริการเป็นเรื่องทางแพ่ง ไม่ใช่ทางอาญา การฝ่าฝืน ToS ไม่ได้ผิดกฎหมายโดยอัตโนมัติ ; แต่อาจเป็นเหตุให้ถูกบล็อก เป็นฐานสำหรับคดีแพ่ง และเป็นหลักฐานของการไม่สุจริตในศาล อ่านเพิ่มเติมเกี่ยวกับเงื่อนไขการให้บริการของ web scraping ด้านล่าง
สหรัฐอเมริกา: CFAA, hiQ และชั้นของสัญญา
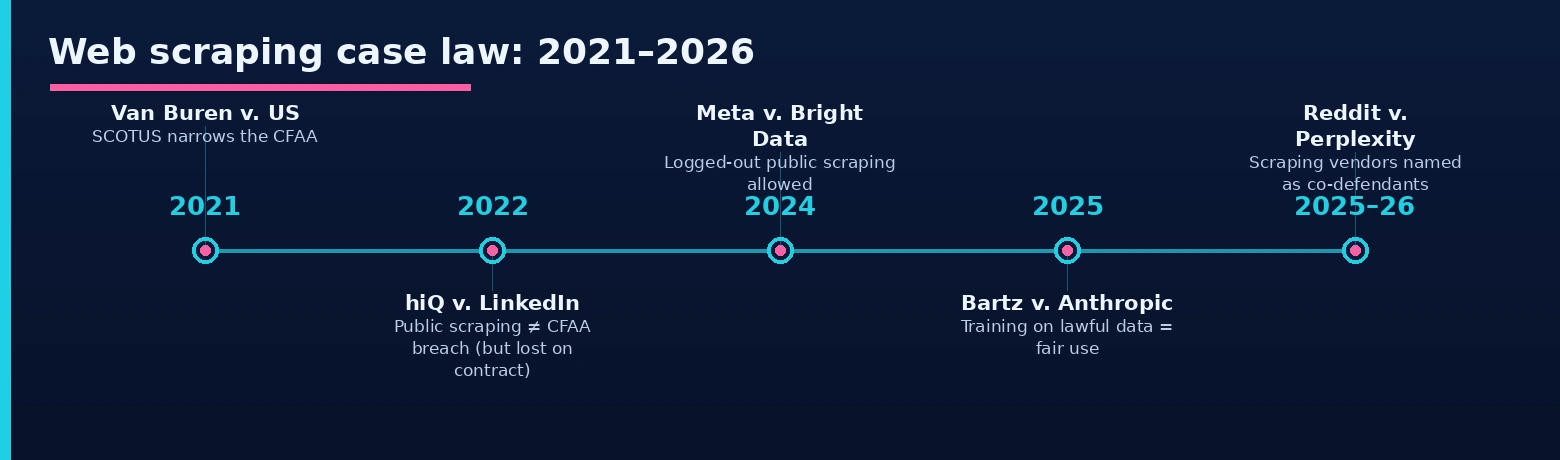
คำถามพื้นฐาน ; การ scrape เว็บไซต์ในสหรัฐฯ ถูกกฎหมายหรือไม่? ; ขึ้นอยู่กับว่าการ scrape หน้าสาธารณะเป็น “การเข้าถึงโดยไม่ได้รับอนุญาต” ภายใต้ Computer Fraud and Abuse Act ซึ่งเป็นกฎหมายต่อต้านการแฮ็กหรือไม่ ศาลอุทธรณ์เขต 9 ตอบในคดี hiQ Labs v. LinkedIn (2022 โดยใช้แนวคิด Van Buren ของศาลสูงสุด): ไม่ใช่ เมื่อหน้าหนึ่งเปิดให้ทุกคนเข้าถึงโดยไม่ต้องใช้ข้อมูลรับรอง ก็ไม่มีด่านอนุญาตให้ละเมิด ดังนั้นการ scrape ข้อมูลสาธารณะจึงไม่ใช่การฝ่าฝืน CFAA
แต่เรื่องราวทั้งหมดของ hiQ คือบทเรียนจริง หลังชนะประเด็น CFAA hiQ แพ้สงคราม: ในเดือนพฤศจิกายน 2022 ศาลพบว่าบริษัท ละเมิด User Agreement ของ LinkedIn (ที่ยอมรับไว้ด้วยการสร้างบัญชี) และคดีจบด้วยคำพิพากษาโดยความยินยอม CFAA คุ้มครองคุณจากข้ออ้างเรื่องแฮ็กในหน้าสาธารณะ แต่ไม่ได้คุ้มครองคุณจาก สัญญาที่คุณตกลง
Meta v. Bright Data (มกราคม 2024) ทำให้เส้นแบ่งชัดขึ้น: ศาลไม่พบว่า Bright Data ผิดสัญญาจากการ scrape หน้า Facebook และ Instagram สาธารณะขณะออกจากระบบ เนื่องจากเงื่อนไขของแพลตฟอร์มใช้กับเจ้าของบัญชี ไม่ใช่ผู้เข้าชมที่ออกจากระบบ กฎที่เกิดขึ้นคือ ; การ scrape หน้าสาธารณะขณะออกจากระบบพอปกป้องได้ การ scrape ขณะล็อกอินโดยขัดกับเงื่อนไขที่ยอมรับแล้วไม่ใช่ คดีละเมิดทรัพย์สินสังหาริมทรัพย์เก่าแก่ (eBay v. Bidder’s Edge, 2000) ยังใช้ได้กับปริมาณสุดโต่ง และกฎหมายความเป็นส่วนตัวของรัฐ (CCPA/CPRA ของแคลิฟอร์เนีย, VCDPA ของเวอร์จิเนีย) เพิ่มภาระข้อมูลส่วนบุคคลเข้าไปอีก
เงื่อนไขการให้บริการ: Browsewrap, Clickwrap และเมื่อกฎกลายเป็นความเสี่ยงทางกฎหมาย
เงื่อนไขการให้บริการไม่ใช่กฎหมาย แต่ศาลให้น้ำหนักอย่างมาก และคำถามหลักคือผู้ใช้ยอมรับเงื่อนไขนั้นจริงหรือไม่
Browsewrap เทียบกับ Clickwrap: ToS แบบใดผูกพันคุณจริง
ข้อตกลง browsewrap เป็นเพียงลิงก์ที่อยู่บางแห่งบนหน้าโดยไม่มีการยอมรับเชิงรุก ; ศาลมักไม่บังคับใช้กับคนที่ไม่เคยคลิก ข้อตกลง clickwrap ต้องมีการกระทำอย่างชัดแจ้ง ; ช่องทำเครื่องหมายหรือปุ่ม “I agree” ; และศาลบังคับใช้เกือบทุกครั้ง เส้นแบ่งในทางปฏิบัติคือ เงื่อนไขที่คุณยอมรับเชิงรุก (โดยปกติเมื่อสร้างบัญชี) ผูกพันคุณ ส่วนเงื่อนไขที่คุณเพียงอาจเห็นมักไม่ผูกพัน
เมื่อการฝ่าฝืน ToS กลายเป็นพยานหลักฐานทางกฎหมาย
การฝ่าฝืนเงื่อนไขการให้บริการของ web scraping ไม่ใช่ความผิดอาญา แต่มีผลในทางปฏิบัติ 3 ประการ: แพลตฟอร์มบล็อกคุณได้ทันที เป็นฐานของคดีแพ่งเรื่องผิดสัญญา (ข้อเรียกร้องที่ทำให้ hiQ แพ้ในท้ายที่สุด) และดูเป็นการไม่สุจริตหากข้อเรียกร้อง CFAA หรือข้อเรียกร้องที่เกี่ยวข้องไปถึงศาล
ยุค AI: คดีปี 2025-2026 ที่เปลี่ยนแผนที่
การฝึก AI สร้างคลื่นที่สองของคดี web scraping ; สนใจน้อยลงว่า “การเข้าถึงได้รับอนุญาตหรือไม่” และสนใจมากขึ้นเรื่อง สัญญา ใบอนุญาต และลิขสิทธิ์ (คำถามเดียวกับที่กำหนด proxy สำหรับการเก็บข้อมูลฝึก AI):
- Bartz v. Anthropic (มิถุนายน 2025, ผู้พิพากษา Alsup): การฝึก LLM ด้วยหนังสือที่ได้มาโดยชอบเป็น fair use ที่ “เปลี่ยนแปลงอย่างยิ่ง” แต่คำวินิจฉัยยกเว้นสำเนาต้นทางที่ละเมิดลิขสิทธิ์ไว้อย่างชัดเจน วิธีที่คุณ ได้มา ซึ่งข้อมูลสำคัญพอ ๆ กับสิ่งที่คุณทำกับมัน
- Kadrey v. Meta (มิถุนายน 2025, ผู้พิพากษา Chhabria): โจทก์แพ้ตามหลักฐานที่นำมา แต่ความเห็นเตือนว่านี่ไม่ใช่การอนุญาตกว้าง ๆ สำหรับการฝึก AI ; เป็นชัยชนะที่แคบ ไม่ใช่หลักเกณฑ์
- Reddit v. Anthropic (ยื่นฟ้องมิถุนายน 2025): Reddit ฟ้องตามทฤษฎี เงื่อนไขการให้บริการและการได้ประโยชน์โดยไม่เป็นธรรม ไม่ใช่ลิขสิทธิ์ ปลายเดือนมีนาคม 2026 ผู้พิพากษาศาลรัฐบาลกลาง ส่งคดีกลับไปยังศาลรัฐแคลิฟอร์เนีย โดยเห็นว่าข้อเรียกร้องไม่ถูกกฎหมายลิขสิทธิ์กันไว้ ยืนยันว่าข้อเรียกร้อง web scraping ที่อิงสัญญามีฐานะอิสระ
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (ต.ค. 2025, S.D.N.Y.): คดีแรกที่ระบุ ผู้ให้บริการโครงสร้างพื้นฐาน scraping เป็นจำเลยร่วมกับบริษัท AI สำหรับผู้ซื้อ proxy ข้อสรุปคือเรื่องห่วงโซ่อุปทาน: ใครเก็บข้อมูลของคุณและเก็บอย่างไร เป็นส่วนหนึ่งของความเสี่ยงทางกฎหมายของคุณแล้ว
- NYT v. OpenAI (รวมคดี, S.D.N.Y.): เดือนมกราคม 2026 ศาลสั่งให้ OpenAI ส่งตัวอย่างบันทึกการสนทนา 20-million รายการในการค้นหาพยานหลักฐาน คดีนี้ทดสอบว่าการ “สำรอก” ของโมเดลทำลาย fair use หรือไม่
- เศรษฐกิจใบอนุญาตคืออีกด้านหนึ่ง: Reddit ให้ใบอนุญาตข้อมูลแก่ Google (~$60M/yr) และ OpenAI; Cloudflare และ Stack Overflow เปิดตัวระบบจ่ายต่อการ crawl “scrape ได้ฟรี” และ “มีใบอนุญาตให้ฝึก” กำลังกลายเป็นเส้นทางที่แยกจากกัน
ยุโรป: GDPR และหน่วยงานกำกับดูแลที่เข้มงวดที่สุด
ใน EU (และสหราชอาณาจักร) คำถามมักไม่ใช่ “การเข้าถึงได้รับอนุญาตหรือไม่” ; แต่เป็น “คุณประมวลผลข้อมูลส่วนบุคคลโดยไม่มีฐานทางกฎหมายหรือไม่?” ภายใต้ GDPR การ scrape ข้อมูลใด ๆ ที่ระบุตัวบุคคลได้ (ชื่อ ภาพถ่าย โปรไฟล์ รายละเอียดการติดต่อ) คือ “การประมวลผล” และ “มันเป็นข้อมูลสาธารณะ” ไม่ใช่ฐานทางกฎหมายด้วยตัวเอง ประวัติการบังคับใช้นั้นชัดเจน:
- เนเธอร์แลนด์ (AP) ; แนวทางที่เข้มที่สุดในยุโรป แนวทางเดือนพฤษภาคม 2024 ระบุว่าการ scrape ข้อมูลส่วนบุคคล “เกือบทุกครั้งเป็นการละเมิด GDPR” และปรับ Clearview AI €30.5 million โดยเตือนกรรมการถึงความรับผิดส่วนบุคคล
- อิตาลี (Garante) ; ปรับ Clearview €20 million; หลักการที่ประกาศคือ “หากเป็นสาธารณะ ฉันก็เอาได้” เป็น เท็จ
- ฝรั่งเศส (CNIL) ; ปรับนายหน้าข้อมูลการติดต่อ KASPR €240,000 (ธ.ค. 2024) แนวทางเดือนมิถุนายน 2025 อนุญาตการ scrape ข้อมูลส่วนบุคคลสาธารณะตาม ผลประโยชน์โดยชอบ ; แต่ต้องมีมาตรการคุ้มครองเท่านั้น (รายการยกเว้น การลดข้อมูลให้น้อยที่สุด ความโปร่งใส)
- สหราชอาณาจักร (ICO) ; ปรับ Clearview £7.5 million; UK GDPR ร่วมกับ Data (Use and Access) Act 2025 ทำให้กรอบการกำกับสอดคล้องกับ EU
- ทั่ว EU: Database Directive เพิ่มสิทธิ sui generis แยกต่างหากต่อการดึงส่วนสำคัญของฐานข้อมูลที่ได้รับความคุ้มครอง ; เป็นข้อเรียกร้องที่มีในยุโรปแต่ไม่มีในสหรัฐฯ
ข้อแตกต่างสำคัญคือ: ทั้งหมดนี้ไม่ได้มุ่งเป้าข้อมูลที่ไม่ใช่ข้อมูลส่วนบุคคล ราคา รายการสินค้า ความพร้อมจำหน่าย และอันดับ อยู่นอกขอบเขต GDPR ; ระบบข้อมูลราคาและ SEO ของยุโรปดำเนินงานอย่างถูกกฎหมายทุกวัน แผนที่ความเสี่ยงด้านล่างแสดงว่าความเสี่ยงจากการ scrape ข้อมูลส่วนบุคคลแตกต่างกันตามเขตอำนาจศาลอย่างไร
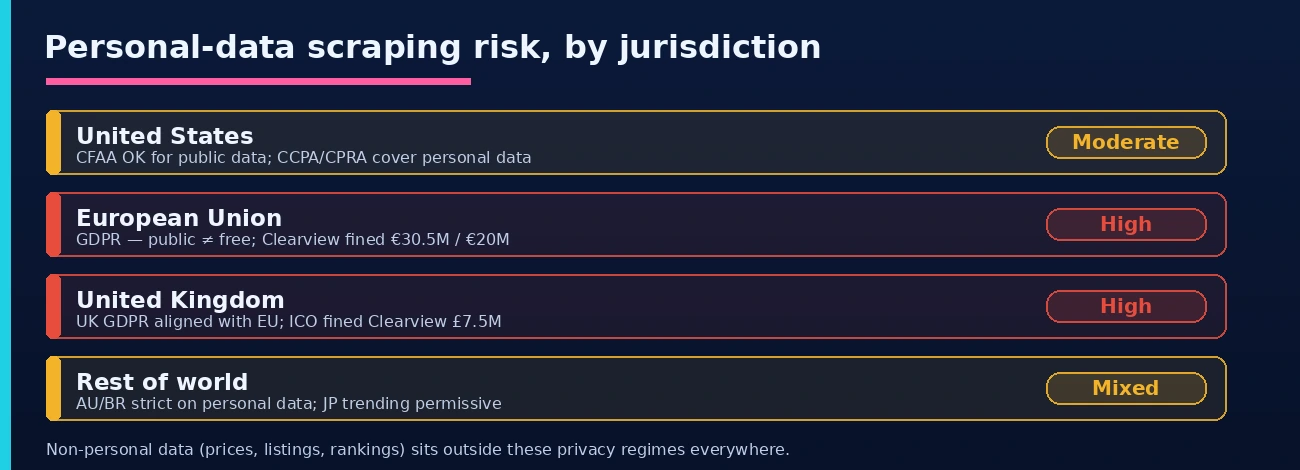
นอกเหนือจากยุโรปและสหรัฐฯ ภาพของการ scrape ข้อมูลส่วนบุคคลมีตั้งแต่เข้มงวดไปจนถึงผ่อนคลายมากขึ้น:
| เขตอำนาจศาล | กรอบ | จุดยืนต่อการ scrape |
|---|---|---|
| ออสเตรเลีย | Privacy Act 1988 + การปฏิรูป 2024 | ข้อมูลสินค้าสาธารณะพอปกป้องได้ แต่ข้อมูลส่วนบุคคลไม่ใช่ |
| ญี่ปุ่น | APPI | แนวโน้มเอื้ออำนวย ; การแก้ไขปี 2026 จะผ่อนคลายการใช้ข้อมูลสาธารณะสำหรับ AI |
| บราซิล | LGPD (ANPD) | บังคับใช้กับข้อมูลส่วนบุคคลอย่างจริงจัง รวมถึง Clearview |
| อินเดีย | DPDP Act 2023 | กฎข้อมูลส่วนบุคคลเข้มงวดขึ้น คดีการฝึก AI กำลังดำเนินอยู่ |
| จีน | PIPL + DSL + CSL | เข้มงวดต่อข้อมูลส่วนบุคคลและการโอนข้ามพรมแดน ต้องตรวจสอบการจัดเก็บข้อมูลในท้องถิ่น |
คู่มือรายประเทศทุกฉบับใน คลังบทความ ของเรา ; ตั้งแต่ เยอรมนี ถึง ญี่ปุ่น ; มีหัวข้อกฎหมายท้องถิ่นที่ตรวจสอบข้อเท็จจริงแล้ว หากต้องการรายละเอียดสำหรับตลาดเฉพาะ
กฎหมายลิขสิทธิ์: สิ่งที่คุณ scrape ได้และไม่ได้
ลิขสิทธิ์เป็นหนึ่งในแหล่งปัญหากฎหมายที่พบบ่อยที่สุดในการ scraping ; แต่กรณีใช้งานธุรกิจส่วนใหญ่อยู่ในเขตปลอดภัยเมื่อคุณแยกข้อเท็จจริงออกจากเนื้อหาสร้างสรรค์
สิ่งที่ได้รับความคุ้มครองและไม่ได้รับความคุ้มครอง
ข้อเท็จจริงไม่มีลิขสิทธิ์ ; ราคา คะแนน ความพร้อมจำหน่าย และข้อมูลจำเพาะ เก็บรวบรวมได้อย่างอิสระ จึงทำให้การ scrape ข้อมูลสินค้าอยู่ในเขตปลอดภัย สิ่งที่ ได้รับ ความคุ้มครองคือ บทความ ภาพถ่าย วิดีโอ ข้อความต้นฉบับ และการคัดเลือกหรือจัดเรียงเชิงสร้างสรรค์ในฐานข้อมูล การนำสิ่งเหล่านี้ไปเผยแพร่ซ้ำทั้งชุดคือจุดที่ข้อเรียกร้องละเมิดลิขสิทธิ์เกิดขึ้น ส่วน US Digital Millennium Copyright Act (DMCA) ใช้แยกต่างหาก ; เมื่อคุณข้ามการควบคุมการเข้าถึงหรือลบข้อมูลการจัดการลิขสิทธิ์ ไม่ใช่จากการเผยแพร่ซ้ำเพียงอย่างเดียว
Fair Use (สหรัฐฯ) และ DSM Directive (EU): เมื่ออนุญาตให้ scrape เนื้อหามีลิขสิทธิ์
ในสหรัฐฯ fair use พิจารณา 4 ปัจจัย: วัตถุประสงค์ของการใช้ (เปลี่ยนแปลงหรือเพียงเชิงพาณิชย์?), ลักษณะของงาน ปริมาณที่นำไป และผลกระทบต่อตลาด โดยมี Authors Guild v. Google (Google Books) เป็นบรรทัดฐานคลาสสิกสำหรับการใช้เชิงเปลี่ยนแปลง ใน EU DSM Directive อนุญาตการทำเหมืองข้อความและข้อมูลเมื่อคุณเข้าถึงโดยชอบและเจ้าของสิทธิไม่ได้เลือกไม่เข้าร่วม (มักส่งสัญญาณผ่าน robots.txt) ทั้งสองอย่างเปิดพื้นที่ให้ scrape เนื้อหามีลิขสิทธิ์เพื่อการวิเคราะห์ ; แต่ไม่มีอย่างใดให้ใบอนุญาตสำหรับการเผยแพร่ซ้ำทั้งชุด
สิ่งที่พอปกป้องได้เทียบกับสิ่งที่มีความเสี่ยง
การ scrape ไม่ได้มีความเสี่ยงเท่ากันทุกแบบ ; ขึ้นอยู่กับประเภทข้อมูล วิธีเข้าถึง และสิ่งที่คุณทำกับผลลัพธ์ รายการ 2 ชุดด้านล่างช่วยวางโครงการของคุณได้อย่างรวดเร็ว
โดยทั่วไปพอปกป้องได้
- การเก็บรวบรวมแบบอ่านอย่างเดียวจากสาธารณะของข้อมูล ที่ไม่ใช่ข้อมูลส่วนบุคคล: ราคา ข้อมูลจำเพาะสินค้า สต็อก อันดับ ผลการค้นหา ค่าโดยสารเที่ยวบิน รายการอสังหาริมทรัพย์
- เข้าถึงเฉพาะขณะออกจากระบบ ; ไม่มีสิ่งใดหลังการยืนยันตัวตน
- อัตราคำขอในจังหวะมนุษย์ที่ไม่สร้างภาระแก่โครงสร้างพื้นฐานของเป้าหมาย
- ปฏิบัติตาม robots.txt และนโยบาย crawl ที่เผยแพร่
- ข้อมูลเชิงแข่งขัน วิจัยตลาด การติดตาม SEO, ad verification, งานวิจัยทางวิชาการบนข้อมูลสรุป
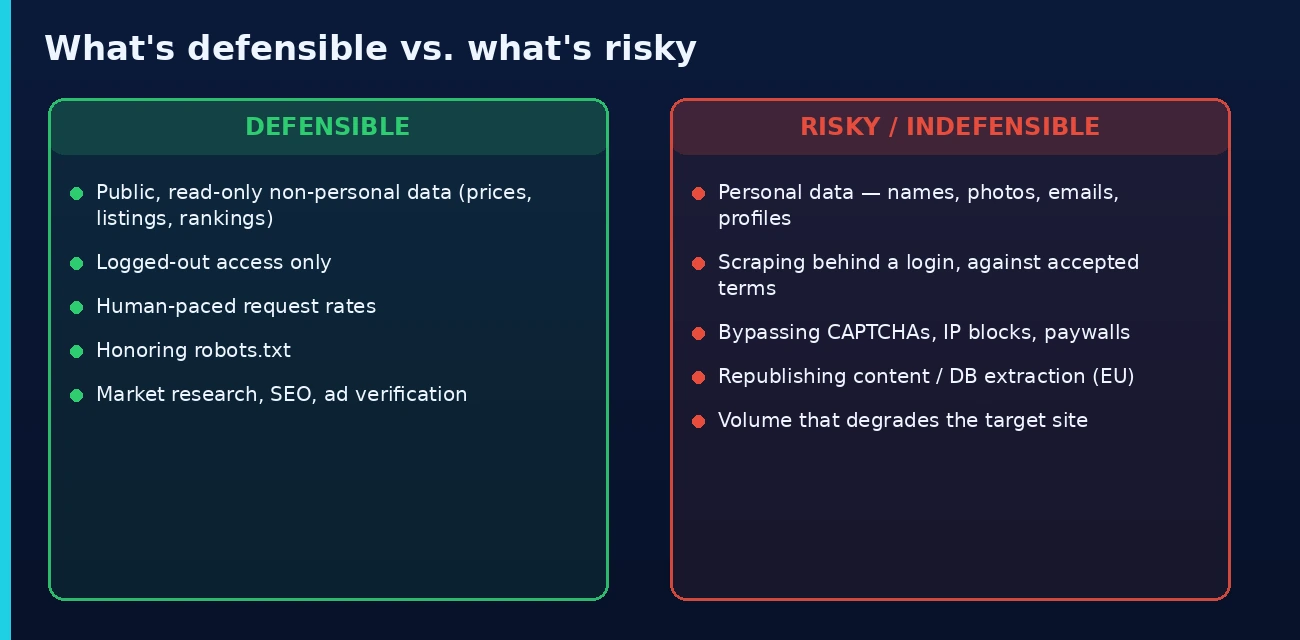
มีความเสี่ยงจนถึงปกป้องไม่ได้
- การ scrape ข้อมูลส่วนบุคคล ; ชื่อ ภาพถ่าย อีเมล หมายเลขโทรศัพท์ โปรไฟล์ ; โดยเฉพาะในปริมาณมาก และโดยเฉพาะในยุโรป
- การ scrape หลังล็อกอิน โดยขัดกับเงื่อนไขที่คุณยอมรับ (บทเรียนสัญญาของ hiQ)
- การข้ามอุปสรรคทางเทคนิค: CAPTCHA ที่แสดงเป็นการควบคุมการเข้าถึง การบล็อก IP ที่มุ่งคุณโดยเฉพาะ paywall
- การเผยแพร่เนื้อหาที่ scrape มาซ้ำทั้งชุด (ลิขสิทธิ์) หรือดึงส่วนสำคัญของฐานข้อมูลที่ได้รับความคุ้มครอง (สิทธิฐานข้อมูล EU)
- ปริมาณที่ทำให้เว็บไซต์เป้าหมายเสื่อมประสิทธิภาพ (ความเสี่ยงข้อเรียกร้องละเมิดทรัพย์สินสังหาริมทรัพย์)
- การฝึก AI ด้วยเนื้อหาที่คุณได้มาจากแหล่งละเมิดลิขสิทธิ์หรือฝ่าฝืนเงื่อนไข (ข้อยกเว้นของ Bartz)
รายการตรวจสอบการปฏิบัติตามข้อกำหนดสำหรับทีม scraping
1. กำหนดขอบเขตข้อมูล หากฟิลด์ระบุตัวบุคคลได้ ให้ถือว่าอยู่ภายใต้การกำกับ: ตัดทิ้ง หรือกำหนดฐานทางกฎหมาย GDPR พร้อมมาตรการคุ้มครองที่จัดทำเป็นเอกสาร (เอกสารผลประโยชน์โดยชอบของ CNIL ปี 2025 เป็นแม่แบบที่ดี)
2. อยู่ในสถานะออกจากระบบ เฉพาะหน้าสาธารณะ ทันทีที่คุณยืนยันตัวตน คุณยอมรับสัญญาแล้ว และข้อเรียกร้องตามสัญญาคือสิ่งที่ชนะคดี
3. เคารพสัญญาณของเว็บไซต์ robots.txt, ขีดจำกัดอัตรา, crawl-delay สิ่งเหล่านี้ไม่ได้ผูกพันทางกฎหมายเสมอไป แต่เป็นสิ่งแรกที่ศาลหรือหน่วยงานกำกับดูแลพิจารณา
4. ออกแบบให้ยับยั้งชั่งใจ จังหวะแบบมนุษย์ แคชเพื่อหลีกเลี่ยงการดึงซ้ำ ไม่ส่งคำขอถี่เกินไป ปริมาณคือสิ่งที่ทำให้ข้อพิพาท scraping กลายเป็นข้อเรียกร้องละเมิดทรัพย์สิน
5. คำนึงถึงห่วงโซ่อุปทาน Reddit v. Perplexity ระบุผู้ให้บริการ scraping ไม่ใช่เพียงผู้ซื้อ AI จงรู้ว่าผู้ให้บริการข้อมูลของคุณเก็บรวบรวมอย่างไร
6. แยกการเก็บรวบรวมออกจากการใช้ การเก็บรวบรวมโดยชอบไม่ได้ให้สิทธิใช้ทุกแบบ: การเผยแพร่ซ้ำ การดึงข้อมูลฐานข้อมูล และการฝึก AI ต่างต้องวิเคราะห์ของตนเอง
7. ขอคำปรึกษาก่อนขยายขนาด ระบบที่ไม่มีปัญหาที่ 1,000 คำขอ/วันอาจต้องทบทวนที่ 10 million
8. เลือกโครงสร้างพื้นฐาน proxy ที่มีแหล่งที่มาอย่างมีจริยธรรม สิ่งสำคัญไม่ใช่เครื่องมือแต่เป็นแหล่งที่มา: proxy ถูกกฎหมาย แต่ web scraping ที่มีจริยธรรมยังรวมถึงวิธีได้มาซึ่ง IP ด้วย residential proxy ที่ได้มาอย่างมีจริยธรรมและอิงความยินยอม residential proxy ที่ได้มาอย่างมีจริยธรรม ช่วยให้ชั้นการเก็บรวบรวมของคุณพอปกป้องได้ หากมีผู้ถามถึงห่วงโซ่อุปทานของคุณ
คำถามที่พบบ่อย
web scraping ถูกกฎหมายหรือไม่?
การ scrape ข้อมูลที่เปิดเผยต่อสาธารณะและไม่ใช่ข้อมูลส่วนบุคคลโดยทั่วไปชอบด้วยกฎหมายในหลายเขตอำนาจศาล ; คดี hiQ v. LinkedIn (2022) ของศาลอุทธรณ์เขต 9 ยืนยันว่าการ scrape หน้าสาธารณะไม่ใช่ “การเข้าถึงโดยไม่ได้รับอนุญาต” ภายใต้ CFAA ของสหรัฐฯ ความเสี่ยงอยู่ในรายละเอียด: ข้อมูลส่วนบุคคล (ค่าปรับ GDPR สูงถึง €30.5M ในคดี Clearview), การ scrape หลังล็อกอินโดยขัดกับเงื่อนไขที่ยอมรับแล้ว (วิธีที่ hiQ แพ้ในท้ายที่สุด), การข้ามอุปสรรคทางเทคนิค และการเผยแพร่เนื้อหามีลิขสิทธิ์ซ้ำ ข้อมูลสินค้า ราคา และ SERP สาธารณะที่เก็บด้วยความเคารพคือแนวทางที่พอปกป้องได้
web scraping ถูกกฎหมายในสหรัฐฯ หรือไม่?
โดยทั่วไปใช่สำหรับข้อมูลสาธารณะ: hiQ v. LinkedIn วางหลักว่าการ scrape หน้าสาธารณะไม่ละเมิด CFAA และ Meta v. Bright Data (2024) ไม่สั่งห้ามการ scrape หน้า Facebook/Instagram สาธารณะขณะออกจากระบบ แต่ข้อเรียกร้องตามสัญญายังคงอยู่ ; hiQ แพ้จากการละเมิดเงื่อนไข LinkedIn ที่ยอมรับแล้ว ; และปริมาณสุดโต่งเสี่ยงต่อข้อเรียกร้องละเมิดทรัพย์สิน กฎหมายความเป็นส่วนตัวของรัฐ (CCPA/CPRA) กำกับข้อมูลส่วนบุคคลเพิ่มเติม
web scraping ถูกกฎหมายภายใต้ GDPR ในยุโรปหรือไม่?
ข้อมูลที่ไม่ใช่ข้อมูลส่วนบุคคล (ราคา รายการสินค้า อันดับ) อยู่นอก GDPR ทั้งหมด ข้อมูลส่วนบุคคลคือจุดที่ยุโรปเข้มงวด: AP ของเนเธอร์แลนด์เรียกการ scrape ข้อมูลส่วนบุคคลว่า “เกือบทุกครั้งเป็นการละเมิด” และปรับ Clearview €30.5M; Garante ของอิตาลีปรับ €20M; CNIL ของฝรั่งเศสปรับ KASPR €240K ; ทั้งหมดจากการ scrape ข้อมูลส่วนบุคคล สาธารณะ แนวทางปี 2025 ของ CNIL อนุญาตการ scrape ข้อมูลส่วนบุคคลสาธารณะตามผลประโยชน์โดยชอบ เฉพาะเมื่อมีมาตรการคุ้มครองที่จัดทำเป็นเอกสาร
ฉัน scrape Amazon, Google หรือแพลตฟอร์มใหญ่ ๆ อื่นได้อย่างชอบด้วยกฎหมายหรือไม่?
การเก็บข้อมูลสินค้าและข้อมูลค้นหาสาธารณะขณะออกจากระบบ ในอัตราที่เคารพเป้าหมาย อยู่ในหมวดหมู่ที่พอปกป้องได้เช่นเดียวกับที่อื่น ; นี่คือวิธีที่อุตสาหกรรมข้อมูลราคาและ SEO ทำงาน ความเสี่ยงขึ้นกับแพลตฟอร์ม: อย่าล็อกอิน (เงื่อนไข) อย่าเก็บข้อมูลส่วนบุคคล (รีวิวที่มีตัวตนผู้เขียน) อย่าทำให้ endpoint ทำงานหนักเกินไป และให้ทราบท่าทีการบังคับใช้ของแต่ละแพลตฟอร์ม คู่มือแยกตามแพลตฟอร์มของเรา (Amazon, Google Maps, LinkedIn, Reddit) ครอบคลุมคดีและกฎเฉพาะ
การ scrape ข้อมูลเพื่อฝึก AI ถูกกฎหมายหรือไม่?
ยังไม่แน่ชัดและกำลังแยกเป็นสองคำถาม การเก็บรวบรวม: กฎเดียวกับการ scraping ทุกแบบ การฝึก: Bartz v. Anthropic (2025) พบว่าการฝึกจากหนังสือที่ได้มาโดยชอบเป็น fair use เชิงเปลี่ยนแปลง แต่ยกเว้นแหล่งละเมิดลิขสิทธิ์; NYT v. OpenAI กำลังทดสอบว่าการ “สำรอก” ของผลลัพธ์ทำลาย fair use หรือไม่; คดีอิงสัญญาของ Reddit ต่อ Anthropic และ Perplexity (พร้อมผู้ให้บริการ scraping) ผ่านขั้นตอนวิธีพิจารณาเบื้องต้น ข้อมูลที่มีใบอนุญาตและห่วงโซ่อุปทานที่สะอาดกำลังเป็นที่หลบภัยที่ปลอดภัย
การใช้ proxy ถูกกฎหมายหรือไม่?
ใช่ ; proxy เป็นโครงสร้างพื้นฐานเครือข่ายมาตรฐาน ซึ่งถูกกฎหมายโดยพื้นฐานแทบทุกแห่ง กิจกรรมที่ดำเนินผ่าน proxy คือสิ่งที่ถูกกำกับ: การ scrape ที่ชอบด้วยกฎหมายยังคงชอบด้วยกฎหมายผ่าน proxy การเก็บรวบรวมที่ไม่ชอบด้วยกฎหมายยังคงไม่ชอบด้วยกฎหมาย เลือกผู้ให้บริการที่มี residential pool อิงความยินยอมและได้มาอย่างมีจริยธรรม หลัง Reddit v. Perplexity ระบุผู้ให้บริการ scraping เป็นจำเลย แหล่งที่มาของโครงสร้างพื้นฐานการเก็บรวบรวมเป็นส่วนหนึ่งของเรื่องการปฏิบัติตามข้อกำหนดของคุณ
การฝ่าฝืน robots.txt ทำให้ scraping ผิดกฎหมายหรือไม่?
robots.txt ไม่ใช่กฎหมาย และการเพิกเฉยไม่ได้ผิดกฎหมายโดยอัตโนมัติ แต่ศาลและหน่วยงานกำกับดูแลถือว่าเป็นสัญญาณของความสุจริตหรือไม่สุจริต คำวินิจฉัยหลายฉบับอ้างถึงเมื่อชั่งน้ำหนักข้อเรียกร้องละเมิดทรัพย์สินและสัญญา และมาตรการคุ้มครองของ CNIL คาดหวังให้คุณเคารพการเลือกไม่เข้าร่วม ในทางปฏิบัติ: การปฏิบัติตาม robots.txt มีต้นทุนต่ำและเพิ่มความสามารถในการปกป้องได้อย่างมีนัยสำคัญ
เกิดอะไรขึ้นใน hiQ v. LinkedIn ในย่อหน้าเดียว?
hiQ scrape โปรไฟล์ LinkedIn สาธารณะเพื่อการวิเคราะห์ HR; LinkedIn ส่งหนังสือให้ยุติการกระทำ; hiQ ฟ้องและชนะประเด็นหลัก ; ศาลอุทธรณ์เขต 9 วินิจฉัย (2022) ว่าการ scrape หน้าสาธารณะไม่ละเมิด CFAA จากนั้น LinkedIn ชนะสงคราม: ศาลพบว่า hiQ ละเมิด User Agreement ที่ยอมรับแล้ว และคดีจบด้วยคำพิพากษาโดยความยินยอม บทเรียนสองชั้นคือ: การ scrape สาธารณะไม่ใช่การแฮ็ก แต่สัญญาที่คุณยอมรับบังคับใช้ได้
สรุป
ดังนั้น web scraping ถูกกฎหมายหรือไม่? การ scrape ข้อมูลที่เปิดเผยต่อสาธารณะและไม่ใช่ข้อมูลส่วนบุคคลนั้นโดยทั่วไปชอบด้วยกฎหมายและพอปกป้องได้ ; ความเสี่ยงใหญ่ที่สุด 3 ประการคือ ข้อมูลส่วนบุคคล (GDPR และกฎหมายเทียบเท่าทั่วโลก), การเข้าถึงโดยขัดกับเงื่อนไขที่ยอมรับ (ข้อเรียกร้องตามสัญญาที่ชนะ hiQ และขับเคลื่อนคดียุค AI ในปัจจุบัน) และ ลิขสิทธิ์ ในเนื้อหาสร้างสรรค์ อยู่ในสถานะออกจากระบบ เก็บข้อมูลที่ไม่ใช่ข้อมูลส่วนบุคคล ปฏิบัติตาม robots.txt และแยกการเก็บรวบรวมจากการใช้ หลังปี 2026 ห่วงโซ่อุปทานก็เป็นส่วนหนึ่งของการปฏิบัติตามข้อกำหนดด้วย: แหล่งที่มาของข้อมูล ; และ proxy ; เป็นส่วนหนึ่งของภาพกฎหมายแล้ว สำหรับด้านโครงสร้างพื้นฐาน ดู proxy ที่ดีที่สุดสำหรับ web scraping นี่ยังคงเป็นข้อมูลทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย ; ควรขอคำแนะนำทางกฎหมายสำหรับกรณีเฉพาะของคุณ
อัปเดตล่าสุด: 24 มิถุนายน 2026