
In this Article
Algunos lo llaman recolección web o extracción de contenido, pero, sea cual sea el nombre, el web scraping es un método habitual para recopilar datos de sitios web. Ya se haga de forma manual o automática, el éxito de tu scraping depende del lenguaje de programación que elijas.
Al hablar del mejor lenguaje, conviene tener en cuenta varios factores, como la velocidad de desarrollo, la facilidad de depuración, el soporte de la comunidad, el rendimiento general y otros aspectos.
Este artículo resume las características de los principales lenguajes de programación y te ayuda a decidir cuál encaja mejor con tus tareas de web scraping.
Los cinco principales lenguajes de programación para web scraping
Como herramienta multipropósito, el web scraping se utiliza en muchos sectores para recopilar y analizar grandes conjuntos de datos. Sin embargo, pese a su uso generalizado, solo unos pocos lenguajes de programación se consideran opciones destacadas para proyectos exitosos. Los que repasamos en este artículo son Python, Node.js, Ruby, PHP, y C++. Están entre las opciones favoritas de los profesionales de IT para web scraping. Veamos por qué.
-
Python
Características clave de la programación en Python:
- Gratis y de código abierto;
- Lenguaje de alto nivel;
- Fácil de escribir y depurar;
- Amplia biblioteca estándar;
- Admite múltiples paradigmas de programación.

Python destaca por su enfoque orientado a objetos, simple pero potente. Los desarrolladores valoran sus funciones de biblioteca fiables y sus módulos con modo interactivo. Admite distintos conceptos de programación, ofrece comprobación dinámica de tipos y simplifica el desarrollo de bases de datos e interfaces de usuario. Una característica distintiva de Python es que permite escribir menos líneas de código que otros lenguajes. Además, Python es gratuito y de código abierto, por lo que resulta accesible para cualquiera. Su flexibilidad y escalabilidad son ventajas importantes, y quizá su mayor beneficio sea lo fácil que resulta para principiantes.
Consulta también nuestro tutorial paso a paso Scraping de datos de productos de Amazon con Python.
-
Node.js
Características clave de Node.js:
- Basado en JavaScript;
- Manejo de datos en tiempo real;
- Amplia variedad de módulos y bibliotecas (Puppeteer y Cheerio);
- Gestiona múltiples solicitudes y conexiones simultáneamente;
- Ejecuta actividades con API y también basadas en sockets.

Originalmente, Node.js se creó como un entorno de ejecución de JavaScript. Con Node.js los desarrolladores pueden ejecutar JavaScript del lado del servidor. Node.js es conocido por su procesamiento asíncrono y no bloqueante. Se usa ampliamente para indexar páginas web porque permite realizar crawling distribuido y scraping al mismo tiempo. Su capacidad para procesar muchas conexiones lo hace muy eficaz para tareas de scraping pequeñas y medianas. Sin embargo, Node.js encaja mejor con tareas sencillas de web scraping y puede no ser la opción ideal para proyectos a gran escala o más complejos.
-
Ruby
Características clave de Ruby:
- Sintaxis simple e intuitiva;
- Gems Nokogiri y Mechanize;
- Tipado dinámico y flexibilidad;
- Soporte de la comunidad;
- Naturaleza orientada al prototipado rápido.

Ruby es un lenguaje de programación dinámico, de código abierto y reflexivo, similar a Perl y Smalltalk. Conocido por su enfoque totalmente orientado a objetos, Ruby trata todo como un objeto, de modo que cada fragmento de código tiene sus propias propiedades y comportamientos. Su sintaxis es clara, agradable y fácil de aprender. Ruby cuenta con una amplia colección de bibliotecas y gems de código abierto que ayudan en el web scraping, incluidas herramientas para gestionar solicitudes HTTP (como HTTParty) y simular navegadores (Watir). La activa comunidad de desarrolladores de Ruby mejora estas herramientas y ofrece ayuda valiosa.
-
PHP
Características clave de PHP:
- Independiente de la plataforma;
- Bibliotecas y frameworks completos;
- Sistemas de gestión de contenido;
- Integración con bases de datos;
- Supervisión de acceso en tiempo real.

PHP es un lenguaje de scripting del lado del servidor que se usa principalmente para gestionar contenido dinámico en sitios web. Algunos desarrolladores consideran que no es la mejor opción para web scraping ni para crear crawlers porque no admite multithreading, lo que puede generar problemas. Aun así, la biblioteca cURL de PHP resulta útil para hacer scraping de medios como imágenes y vídeos desde sitios web. cURL admite la transferencia de archivos mediante protocolos como HTTP y FTP, lo que permite crear spiders web que descargan contenido automáticamente. Aunque PHP puede no ser ideal para proyectos de scraping a gran escala, sí puede manejar tareas más sencillas y trabajar con bases de datos.
-
C++
Características clave de C++:
- Tipos de datos abstractos;
- Biblioteca amplia y gestión de memoria;
- Función de manejo de excepciones para facilitar la gestión de errores;
- Basado en compilador;
- Procesamiento paralelo.

C++ es un lenguaje de programación de propósito general que distingue entre mayúsculas y minúsculas y admite programación orientada a objetos, procedural y genérica. Aunque es rápido y potente, C++ puede no ser la opción más rentable para web scraping, salvo que tengas tareas especializadas centradas en la extracción de datos. Entre sus ventajas se incluyen su simplicidad, la posibilidad de crear herramientas personalizadas de análisis HTML y su flexibilidad para la codificación dinámica. Con C++, puedes ejecutar varios scrapers en paralelo y completar tus tareas de web scraping más rápido.
Cuál elegir
Elegir el lenguaje de programación adecuado para web scraping depende del tipo de proyecto en el que estés trabajando. No hay una única respuesta válida para todas las situaciones – lo más importante es que el lenguaje elegido pueda hacer solicitudes HTTP y analizar HTML. Casi todos los lenguajes, desde PHP hasta Node.js y Python, pueden hacerlo, así que elige el que mejor se ajuste a tus necesidades y preferencias.
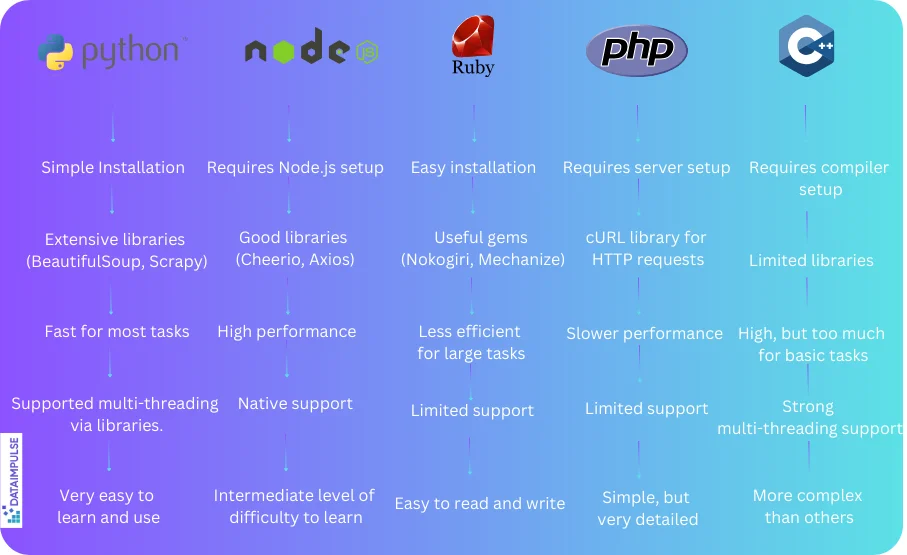
Echa un vistazo a esta tabla comparativa para evaluar mejor las características y capacidades de Python, Node.js, Ruby, PHP y C++.
Beneficios de usar proxies para web scraping
Los servidores suelen contar con medidas de seguridad para controlar el número de solicitudes enviadas desde una dirección IP. Combinar tu web scraper con proxies ayuda a optimizar el ritmo de las solicitudes, mantener el anonimato y garantizar una conexión estable. Estas son algunas razones para integrar proxies al usar lenguajes de programación para web scraping:
- Segmentación por geolocalización – Usa IP de diferentes países o regiones;
- Evitar fallos de conexión – Los proxies rotan tu dirección IP;
- Acceso a contenido global – Recopila datos desde cualquier ubicación;
- Protección de la identidad – Los proxies ocultan tu dirección IP real y mucho más.
Si quieres saber más sobre los proxies de DataImpulse, pulsa el botón “Prueba ahora“ en la esquina superior derecha o contáctanos en [email protected].