
In this Article
Web unblocker untuk AI adalah layanan terkelola yang mengambil halaman web publik sesuai permintaan dan mengembalikan HTML bersih atau konten yang sudah dirender, sehingga model bahasa, pipeline retrieval, dan agen otonom dapat membaca web langsung tanpa diblokir. Artikel ini menjelaskan fungsi sebenarnya dari web unblocker, alasan tim AI memerlukan akses web yang andal, serta bagaimana pilihan build versus buy bekerja setelah Anda melihat detail di baliknya.
Artikel ini juga menarik batas yang jelas, yang kerap dikaburkan oleh vendor. Web unblocker adalah stack fetching lengkap; penyedia proxy seperti DataImpulse merupakan lapisan jaringan di dalamnya. Mengetahui komponen yang Anda beli akan mengubah biaya dan tingkat kontrol Anda.
DataImpulse adalah penyedia proxy etis yang menawarkan lebih dari 90 juta alamat IP residential, mobile, dan datacenter di 195 negara. Layanan ini menggunakan model pay-as-you-go mulai 1 dolar per GB dengan lalu lintas tanpa masa berlaku, serta digunakan untuk web scraping, verifikasi iklan, pemantauan harga, riset pasar, dan pengelolaan multi-account.
Fakta Utama
- Web unblocker untuk AI: web unblocker adalah scraping API terkelola yang menggabungkan rendering JavaScript, penanganan CAPTCHA, dan rotasi proxy untuk mengambil halaman web publik bagi pelatihan AI, RAG, dan pipeline agen; lapisan proxy di bawahnya adalah komponen terpisah yang dapat diganti.
- Jenis proxy terbaik: rotating residential proxies, yang menggunakan IP konsumen asli yang lolos deteksi.
- Harga: mulai 1 dolar per GB, pay-as-you-go, dengan lalu lintas tanpa masa berlaku dan tanpa langganan.
- Cakupan: lebih dari 90 juta IP yang diperoleh secara etis di 195 negara.
- Keandalan: tingkat keberhasilan 99,51%, dengan rating 4,8 dari 5 di G2.
- Protokol dan targeting: HTTP, HTTPS, dan SOCKS5, dengan country targeting sudah termasuk.
Apa itu web unblocker untuk AI?
Web unblocker adalah scraping API terkelola yang menerima URL target, melakukan pekerjaan yang diperlukan untuk memuat halaman dan melewati pertahanan situs, lalu mengembalikan konten halaman yang siap diparsing. Dipasarkan untuk AI, layanan ini merupakan pintu masuk akuisisi data yang memastikan crawler pelatihan, pekerjaan retrieval-augmented generation (RAG), dan agen browsing terus mendapat pasokan data web publik terbaru.
Dalam satu endpoint, web unblocker umumnya menggabungkan beberapa hal yang dahulu merupakan tool terpisah:
- Rotasi proxy: layanan ini mengedarkan request ke pool besar alamat IP agar tidak ada satu alamat yang terkena rate limit atau pemblokiran.
- Rendering JavaScript: layanan ini menjalankan browser nyata atau headless agar konten yang dimasukkan oleh skrip sisi klien tersedia dalam HTML yang dikembalikan.
- Penanganan CAPTCHA dan challenge: layanan ini mendeteksi dan menangani interstitial, pemeriksaan bot, serta challenge anti-automation.
- Pengelolaan fingerprint dan header: layanan ini mengatur fingerprint browser, profil TLS, dan header yang realistis agar request tampak seperti lalu lintas biasa.
Perbedaan pentingnya terletak pada cakupan. Web unblocker adalah seluruh pipeline fetching yang dijual sebagai layanan. Penyedia proxy hanya menyediakan jaringan IP tempat rotasi berjalan. DataImpulse merupakan lapisan proxy, bukan web unblocker terkelola, sehingga menjadi salah satu masukan untuk stack tersebut, bukan stack itu sendiri.
Mengapa tim AI memerlukan akses web yang andal?
Tim AI memerlukan akses web yang andal karena sebagian besar data mereka berasal dari web publik langsung, dan setiap celah dalam fetching menjadi celah dalam pengetahuan model atau kemampuan agen untuk bertindak. Ada tiga workload yang mendorong kebutuhan ini.
Data pelatihan. Korpus teks besar disusun dengan crawling halaman publik dalam skala besar. Jika crawler diblokir pada kelompok situs tertentu, sumber-sumber tersebut diam-diam tidak masuk ke dataset, sehingga cakupannya menjadi bias.
Retrieval-augmented generation. Sistem RAG mengambil halaman terkini pada waktu query untuk mendasarkan jawaban pada fakta terbaru. Fetch yang diblokir di sini bukan sekadar kehilangan data; hal itu menurunkan kualitas jawaban yang dilihat pengguna saat ini.
Agen browsing. Agen otonom memuat halaman untuk membaca harga, memeriksa ketersediaan, atau menyelesaikan tugas. Mereka memerlukan akses yang konsisten di banyak domain, sering kali dari negara tertentu, dan kegagalan memuat halaman dapat menghentikan seluruh workflow multi-langkah.
Dalam ketiga kasus tersebut, mode kegagalannya sama: request yang dapat diselesaikan oleh browser normal mendapat challenge atau ditolak karena tampak otomatis atau berasal dari jaringan yang ditandai. Untuk sisi fetching pada situs dinamis, panduan kami tentang scraping halaman web dinamis membahas masalah rendering secara lebih mendalam.
Bagaimana web unblocker bekerja?
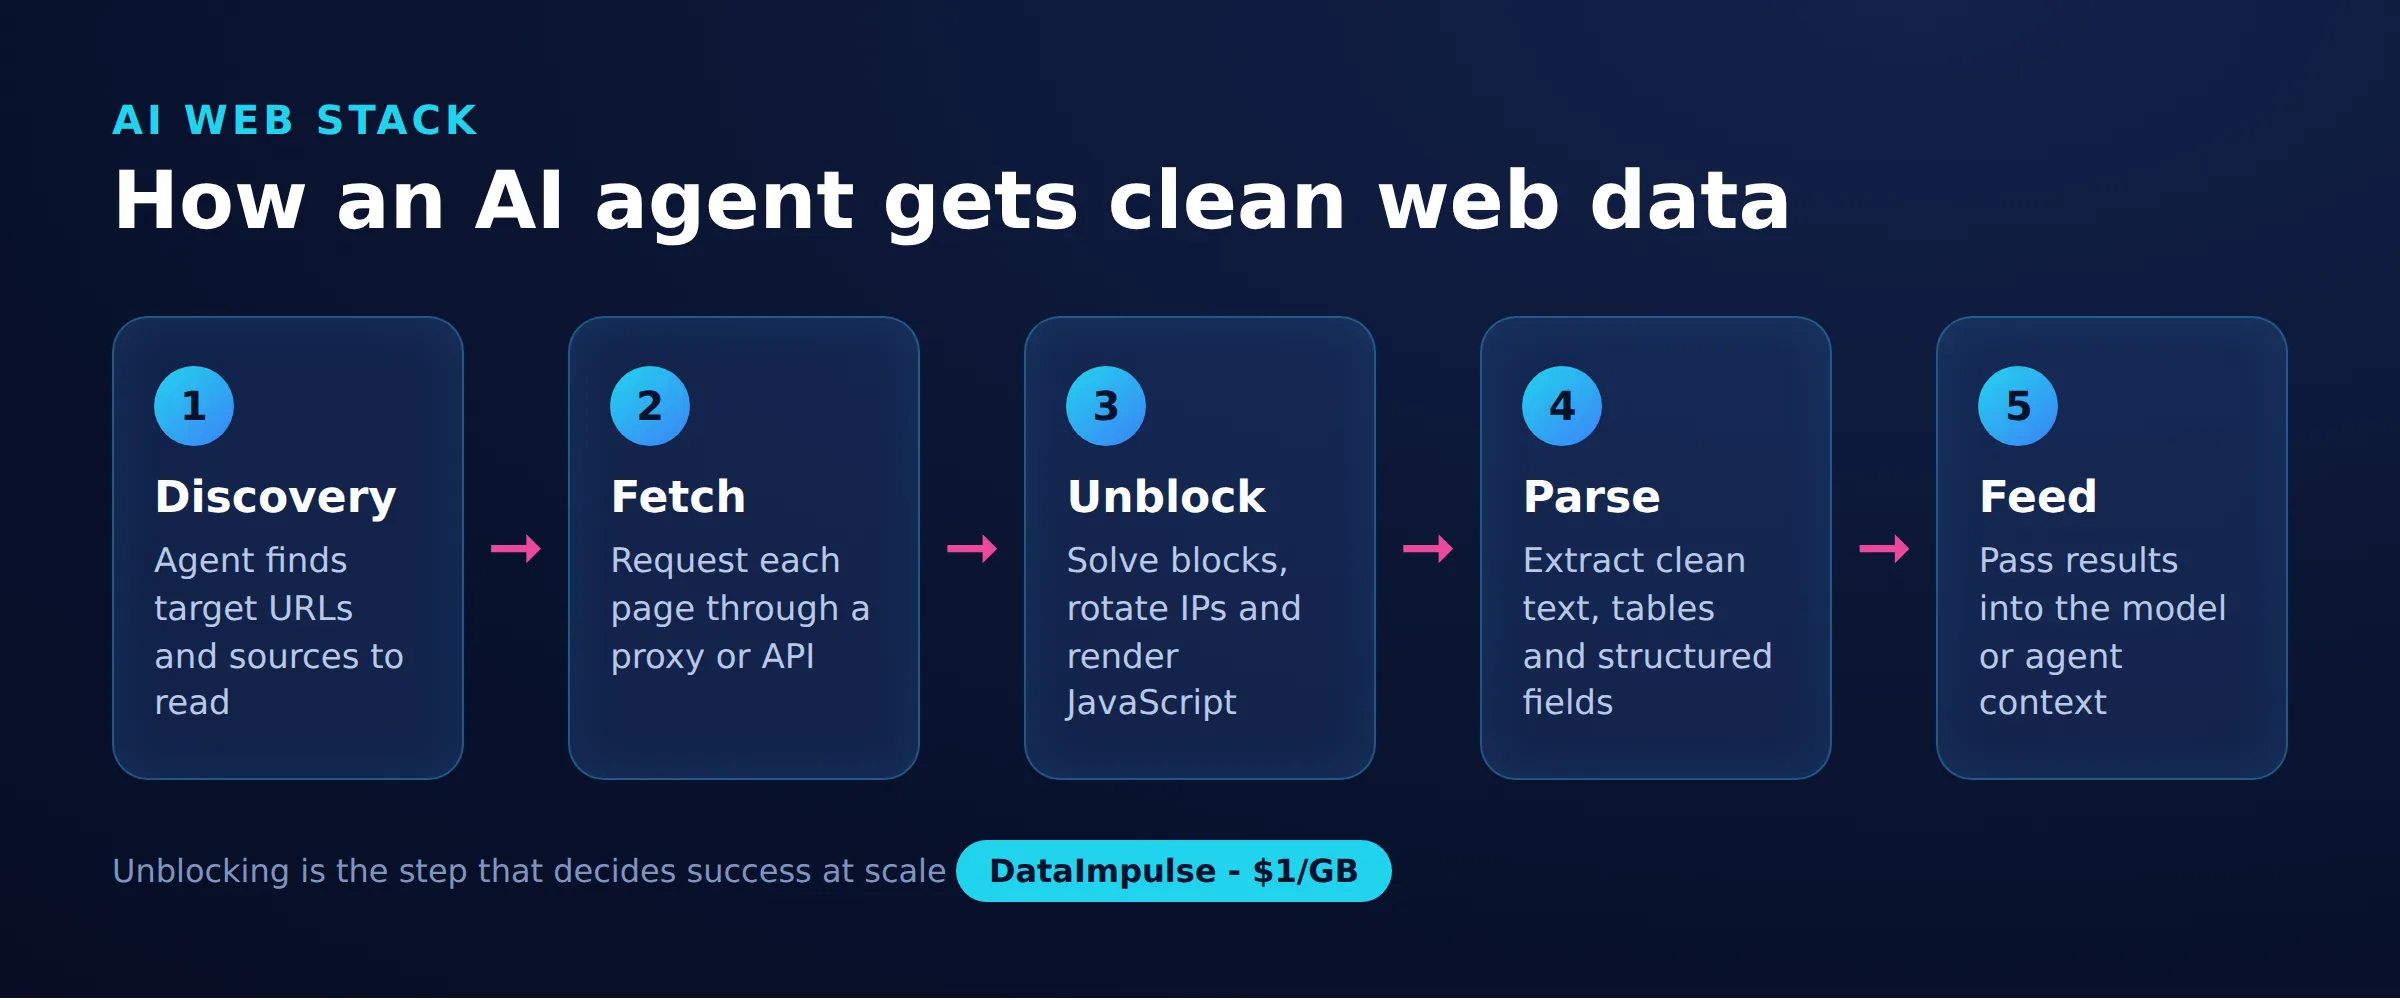
Web unblocker bekerja dengan merangkai urutan langkah tetap antara sistem AI Anda dan situs target. Kami menyebut urutan ini model akses web AI 5 tahap, dan ini merupakan peta yang berguna, baik Anda membeli stack tersebut maupun merakitnya sendiri.
- Penemuan: tentukan URL yang akan di-fetch, dari daftar seed, sitemap, crawl frontier, atau keputusan langsung agen.
- Fetch: kirim request melalui proxy agar IP keluar, bukan server Anda, yang dilihat target.
- Unblock: render JavaScript, atur fingerprint yang realistis, dan selesaikan setiap challenge agar halaman dimuat sepenuhnya.
- Parse: ekstrak konten yang berguna dan hilangkan navigasi, iklan, serta boilerplate menjadi teks bersih atau field terstruktur.
- Masukkan: serahkan konten yang telah dibersihkan kepada konsumen, yaitu set pelatihan, vector store untuk RAG, atau context window agen.
Web unblocker terkelola menyatukan tahap fetch dan unblock dalam satu panggilan API. Saat membangun sendiri, kedua tahap itulah yang membutuhkan sebagian besar upaya engineering, dan jaringan proxy adalah fondasi tempat tahap fetch berdiri. Semua hal di hulu (penemuan) dan hilir (parse, masukkan) pada dasarnya sama dalam kedua pendekatan.
Haruskah Anda membeli unblocker terkelola atau membangunnya sendiri?
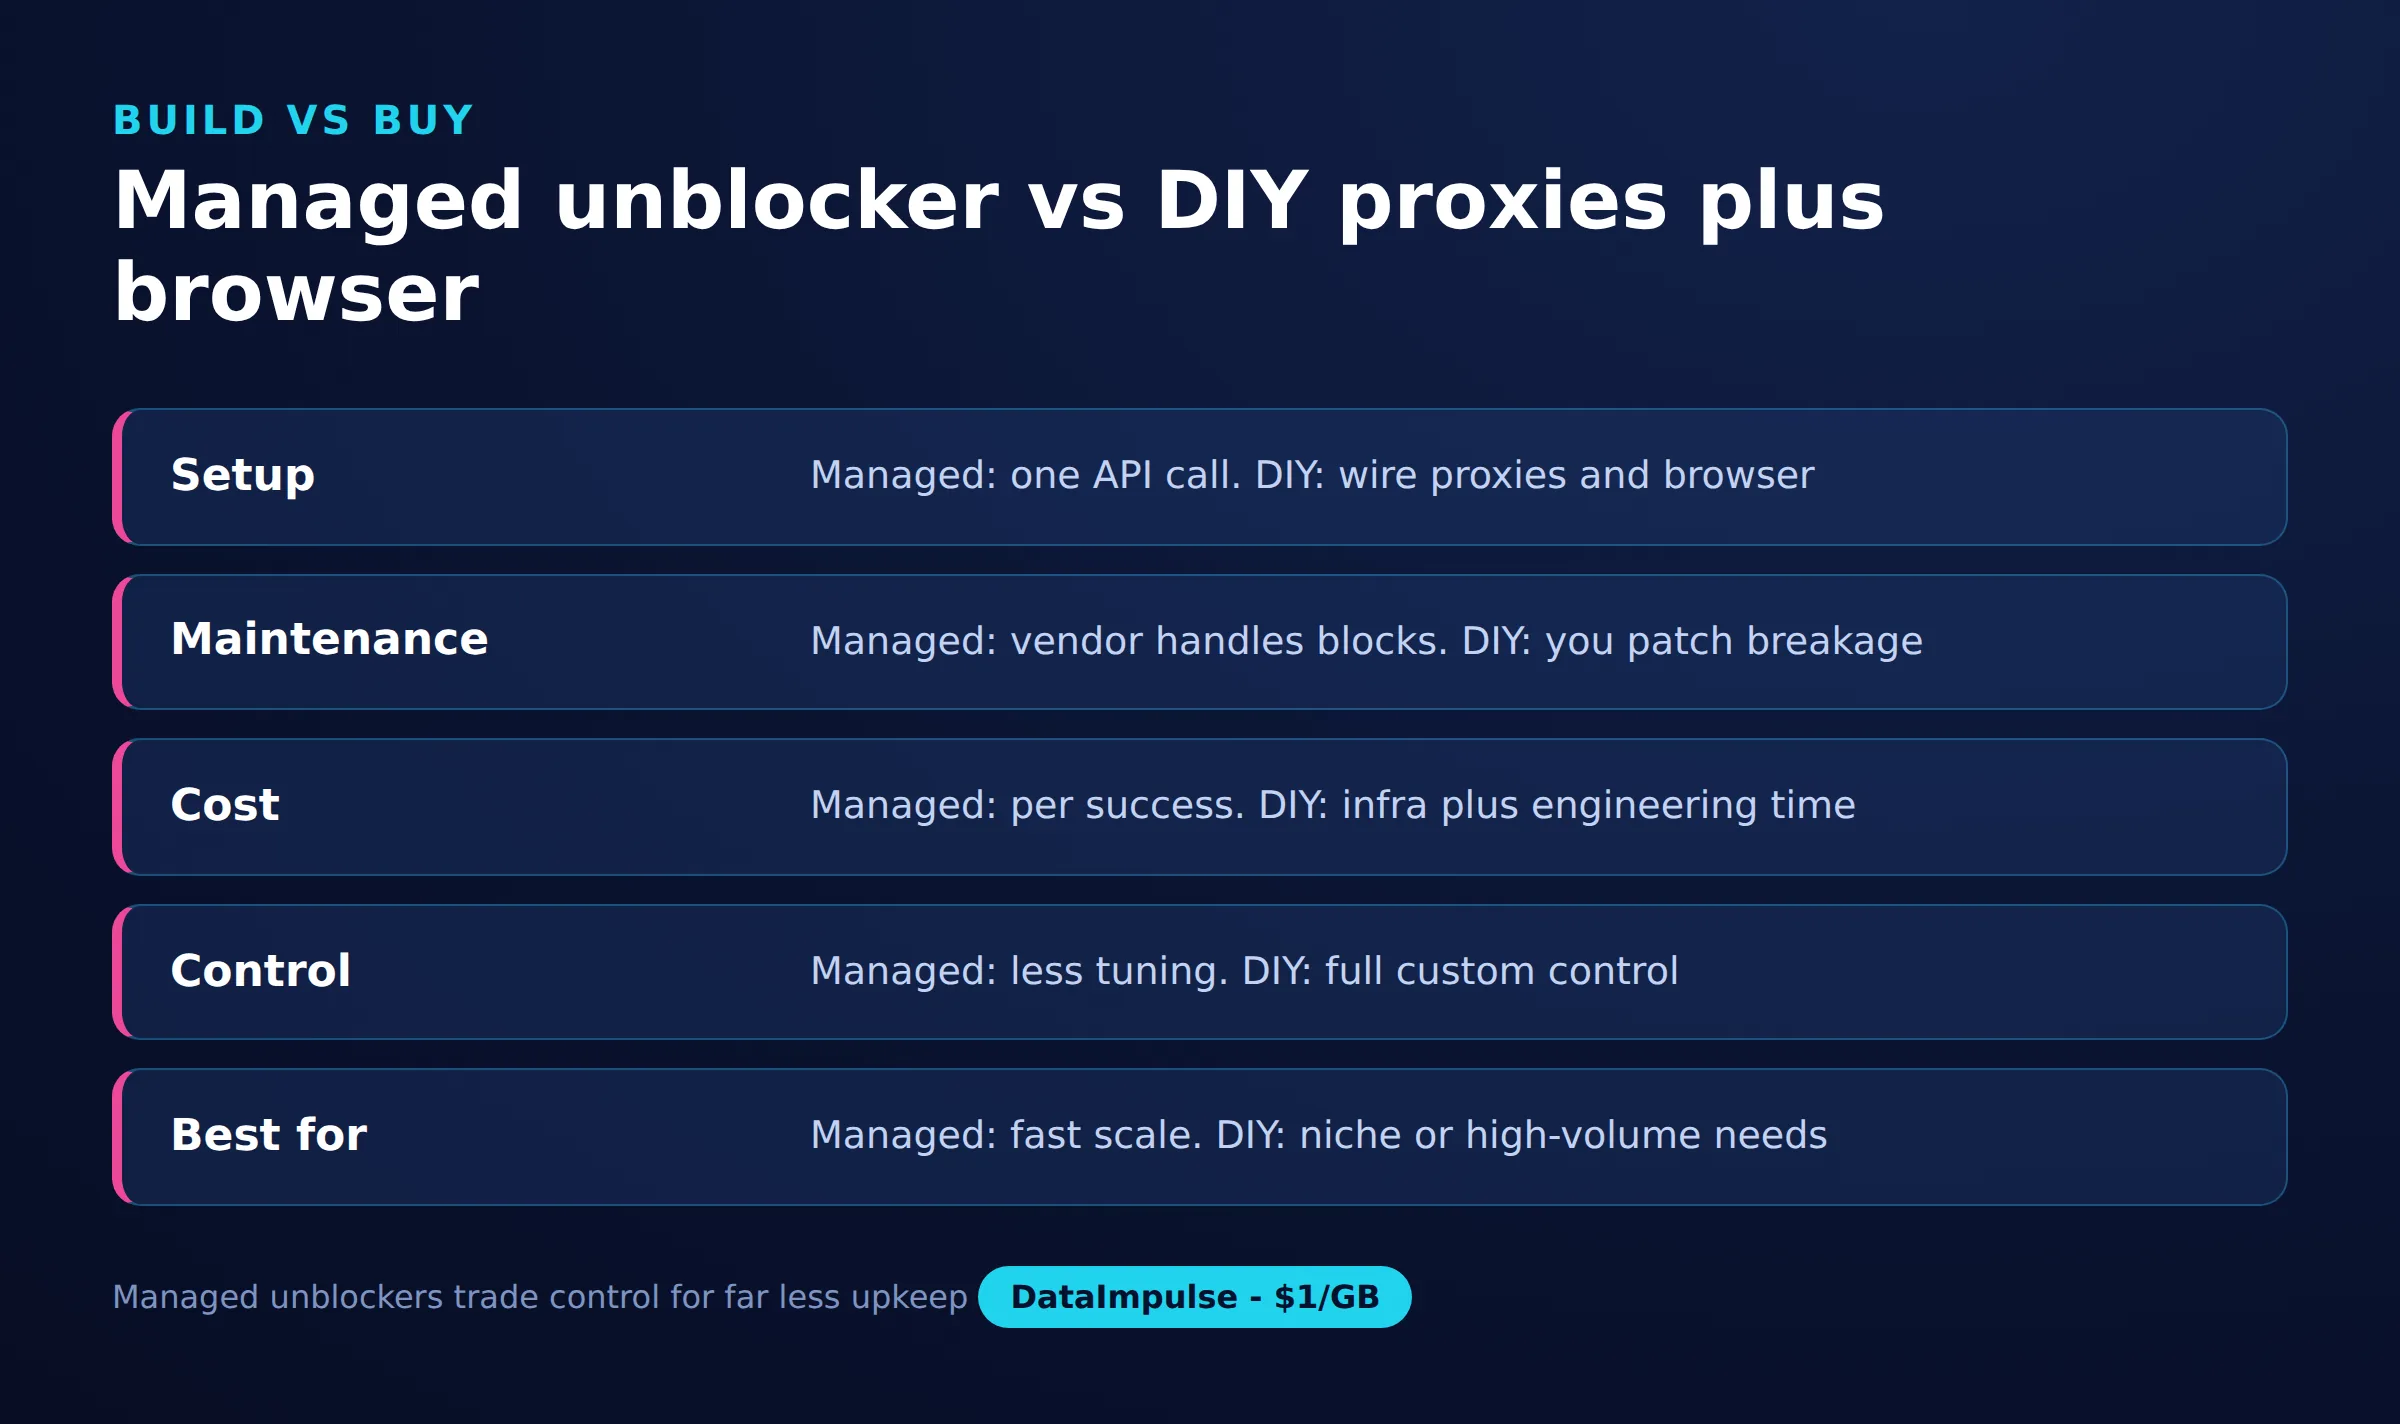
Beli unblocker terkelola ketika kecepatan dan perawatan minimal lebih penting daripada biaya dan kontrol; rakit proxy beserta headless browser sendiri jika Anda membutuhkan transparansi, unit economics yang lebih baik dalam skala besar, atau logika fetching khusus. Kedua pendekatan terutama berbeda dalam siapa yang memiliki tahap unblock.
| Faktor | API unblocker terkelola | Proxy DIY plus headless browser |
|---|---|---|
| Kontrol | Rendah; vendor menentukan logika rendering dan challenge | Tinggi; Anda menyetel setiap request dan header |
| Model biaya | Ditagih per request yang berhasil, biaya per unit lebih tinggi | Ditagih per GB lalu lintas proxy ditambah komputasi Anda |
| Perawatan | Vendor menangani perubahan anti-bot | Anda memperbarui fingerprint dan rendering sendiri |
| Transparansi | Tidak transparan; sulit mengaudit cara halaman di-fetch | Visibilitas penuh atas seluruh jalur request |
| Waktu menuju fetch pertama | Cepat; satu panggilan API | Lebih lambat; Anda perlu menghubungkan browser dan proxy terlebih dahulu |
Singkatnya, matriks keputusannya adalah:
- Gunakan unblocker terkelola ketika tim Anda tidak memiliki infrastruktur scraping, target memiliki pertahanan kuat, volume sedang, dan waktu engineering adalah sumber daya yang langka.
- Rakit proxy dan browser sendiri ketika Anda menjalankan volume tinggi, perlu mengendalikan biaya per record, ingin mengaudit persis cara setiap halaman di-fetch, atau memiliki kebutuhan rendering yang tidak umum.
- Hindari unblocker terkelola ketika harga per request pada skala Anda melebihi biaya menjalankan proxy dan komputasi sendiri, atau ketika kurangnya transparansi menghambat tinjauan kepatuhan.
Banyak tim menggunakan pendekatan hybrid: proxy web scraping mereka sendiri ditambah headless browser untuk sebagian besar target mudah, dan unblocker terkelola hanya untuk situs yang paling sulit.
Di mana peran proxy, dan mengapa IP residential penting?
Proxy adalah lapisan jaringan pada tahap fetch: proxy memberi setiap request IP keluar yang berbeda agar target melihat lalu lintas biasa, bukan lonjakan dari satu server. Baik Anda membeli unblocker maupun membangunnya sendiri, pool proxy menjalankan rotasi di bawahnya. Inilah lapisan yang disediakan DataImpulse.
IP residential penting bagi akses web AI karena alamat tersebut diberikan oleh penyedia layanan internet ke rumah sungguhan, sehingga menyatu dengan lalu lintas normal ketika rentang datacenter sering kali sudah ditandai sebelumnya. Bagi crawler yang mengakses situs untuk konsumen, perbedaan ini sering kali menentukan apakah halaman berhasil dimuat atau diblokir. DataImpulse menawarkan residential proxies untuk kasus ini, serta datacenter proxies untuk target yang lebih murah dan mobile proxies untuk target yang paling sulit.
Berikut tahap fetch DIY dalam bentuk paling sederhana: satu request HTTP melalui rotating residential proxy, siap untuk memasok pipeline AI. DataImpulse mendukung HTTP, HTTPS, dan SOCKS5, dengan country targeting sudah termasuk dalam tarif dasar.
import requests

proxy = "http://USERNAME:[email protected]:823"
resp = requests.get(
    "https://example.com/product/123",
    proxies={"http": proxy, "https": proxy},
    timeout=30,
)
html = resp.text  # hand this to your parser, then your RAG store
Untuk halaman yang hanya menyusun kontennya di browser, tambahkan headless browser agar JavaScript berjalan sebelum Anda membaca DOM. rotating proxy yang sama diteruskan langsung ke konteks browser.
from playwright.sync_api import sync_playwright

proxy = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}
with sync_playwright() as p:
    browser = p.chromium.launch(proxy=proxy, headless=True)
    page = browser.new_page()
    page.goto("https://example.com/product/123", wait_until="networkidle")
    content = page.content()  # rendered HTML for the AI pipeline
    browser.close()
Rotating session memberikan IP baru untuk setiap request, cocok untuk crawling luas, sedangkan sticky session mempertahankan satu IP di seluruh alur multi-langkah seperti tugas agen yang sudah login. DataImpulse mendukung keduanya.
Apa batasan etis dan hukum dari web unblocking untuk AI?
Web unblocking untuk AI sebaiknya dibatasi pada data publik, dikumpulkan dengan laju yang wajar, dari IP yang diperoleh berdasarkan persetujuan. Melewati pemblokiran teknis bukan izin untuk mengabaikan aturan terkait data itu sendiri, dan tim AI tetap memikul tanggung jawab tersebut meskipun vendor yang melakukan fetching.
Beberapa prinsip yang berlaku secara konsisten, apa pun tool yang digunakan:
- Hanya data publik: fetch halaman yang dapat diakses secara terbuka tanpa login atau mengalahkan kontrol akses; jangan scrape konten privat atau berbayar yang tidak berwenang Anda lihat.
- Hormati robots dan ketentuan: baca robots.txt serta ketentuan layanan setiap situs, dan perlakukan keduanya sebagai sinyal tentang apa yang diizinkan operator.
- Batasi laju sendiri: beri jeda antarreques agar Anda tidak menurunkan kualitas layanan target, bahkan ketika rotasi memungkinkan Anda berjalan lebih cepat.
- Dapatkan IP secara etis: jaringan proxy yang Anda andalkan harus dibangun dari pengguna yang ikut serta dan diberi kompensasi, bukan dari perangkat yang dibajak.
Lapisan IP adalah tempat etika sebuah pipeline ditentukan dalam praktik. DataImpulse mendapatkan IP-nya dari pengguna yang ikut serta dan diberi kompensasi, selaras dengan GDPR, serta menawarkan perjanjian pemrosesan data; ringkasan kami tentang proxy etis menjelaskan model perolehan tersebut. Perolehan etis itu sendiri tidak otomatis menjadikan scraping tertentu sah, jadi perlakukan tinjauan hukum sebagai langkah terpisah.
Apa keterbatasan web unblocker untuk AI?
Web unblocker mengurangi hambatan fetching, tetapi tidak menghilangkan masalah yang lebih sulit terkait kualitas data, pengendalian biaya, dan kepatuhan, serta lapisan proxy saja bukan unblocker lengkap. Memahami batasannya menjaga ekspektasi tetap realistis.
- Layanan ini tidak menilai kualitas data: halaman dapat dimuat dengan sempurna tetapi tetap berupa spam, usang, atau keliru; parsing dan validasi tetap menjadi tugas Anda.
- Layanan ini tidak memberikan izin hukum: melewati pemeriksaan bot tidak menjawab apakah Anda boleh mengumpulkan atau menggunakan kembali konten tersebut.
- API terkelola tidak transparan dan ditagih per request: Anda menukar visibilitas dan biaya per unit dengan kemudahan, yang dapat merugikan pada volume tinggi.
- Target sulit terkadang tetap gagal: tidak ada unblocker yang mencapai tingkat keberhasilan 100 persen, dan situs dengan pertahanan kuat atau penghalang login mungkin tetap tidak dapat diakses.
- Proxy bukan seluruh stack: rotasi menangani lapisan jaringan, tetapi Anda tetap memerlukan rendering, parsing, dan orkestrasi di sekelilingnya.
Pada poin terakhir, pastikan Anda tepat dalam memahami DataImpulse. DataImpulse menyediakan lapisan proxy, lebih dari 90 juta IP residential, mobile, dan datacenter di 195 negara dengan tingkat keberhasilan 99,51%, mulai 1 dolar per GB. DataImpulse tidak menjual static ISP proxies, bukan scraping API atau web unblocker terkelola, dan bukan layanan web-proxy gratis. Untuk panduan anti-pemblokiran yang lebih luas, lihat panduan kami tentang scraping tanpa diblokir.
Pertanyaan yang sering diajukan
Apakah web unblocker sama dengan proxy?
Tidak. Web unblocker adalah API terkelola yang menggabungkan rotasi proxy dengan rendering JavaScript dan penanganan CAPTCHA untuk mengembalikan halaman yang sudah siap. Penyedia proxy hanya menyediakan jaringan IP rotating tempat tahap fetch berjalan, yang merupakan satu komponen dalam unblocker.
Apakah saya memerlukan residential proxies untuk akses web AI?
Sering kali ya untuk situs yang ditujukan bagi konsumen, karena IP residential diberikan kepada rumah sungguhan dan menyatu dengan lalu lintas normal ketika rentang datacenter kerap ditandai sebelumnya. Untuk target internal atau yang pertahanannya ringan, datacenter proxies yang lebih murah mungkin sudah cukup.
Dapatkah DataImpulse berperan sebagai web unblocker untuk pipeline AI saya?
DataImpulse menyediakan lapisan proxy, bukan unblocker terkelola. DataImpulse menyediakan IP residential, mobile, dan datacenter rotating serta sticky yang Anda pasangkan dengan headless browser dan parser sendiri, atau masukkan ke unblocker terkelola sebagai komponen jaringannya.
Apakah scraping data web publik untuk AI legal?
Hal itu bergantung pada yurisdiksi, ketentuan situs, dan cara data digunakan, jadi perlakukan tinjauan hukum sebagai langkah tersendiri. Membatasi pengumpulan pada data publik, menghormati robots.txt dan rate limit, serta menggunakan IP yang diperoleh secara etis mengurangi risiko, tetapi tidak menggantikan nasihat hukum.
Kapan saya sebaiknya membangun stack fetching sendiri alih-alih membeli unblocker?
Bangun sendiri ketika volume cukup tinggi sehingga harga per request memberatkan, ketika Anda perlu mengaudit persis cara setiap halaman di-fetch, atau ketika Anda memiliki kebutuhan rendering khusus. Merakit rotating proxies bersama headless browser memberi Anda kontrol tersebut dengan biaya lalu lintas proxy.
Kapan DataImpulse bukan pilihan yang tepat?
Jika Anda memerlukan static ISP proxies, scraping API yang sepenuhnya terkelola, atau akses ke situs perbankan dan pemerintah, DataImpulse bukan tool yang tepat. DataImpulse berfokus pada proxy residential, mobile, dan datacenter rotating untuk mengumpulkan data publik dan mengakses konten.
Panduan terkait
Dapatkan lapisan proxy untuk pipeline AI Anda
Jika Anda membangun tahap fetch sendiri, jaringan di bawahnya adalah bagian yang perlu Anda siapkan dengan tepat. Anda dapat membuat akun DataImpulse dan mengarahkan crawler atau agen Anda melalui IP residential, mobile, atau datacenter rotating, dengan model pay-as-you-go mulai 1 dolar per GB dan country targeting sudah termasuk.