
In this Article
Il web scraping è legale? La legittimità del web scraping dipende da quattro fattori: cosa raccogli (prezzi di prodotti pubblici o profili personali), come lo raccogli (pagine pubbliche o contenuti dietro login), dove operi (la logica del CFAA negli USA o il GDPR in Europa) e cosa fai con i dati (monitoraggio dei prezzi o addestramento AI). Quindi, quando le persone chiedono “è legale estrarre dati dai siti web?”, la risposta onesta è che raccogliere dati pubblicamente disponibili e non personali è ampiamente legittimo nella maggior parte delle giurisdizioni, ma ciascuno di questi fattori può spostarti dalla pratica aziendale difendibile all’azione regolatoria. Questa guida ripercorre i casi storici, le cause dell’era AI del 2025-2026, la posizione di ogni principale regolatore e un quadro pratico di conformità.
Una precisazione iniziale: queste sono informazioni generali, non consulenza legale. Prima di ampliare una pipeline commerciale di scraping, chiedi consulenza legale nella tua giurisdizione e in quelle dei tuoi obiettivi.
Fatti chiave
- Raccogliere dati pubblici e non personali è ampiamente legittimo: i dettagli (cosa, come, dove, perché) decidono tutto.
- “Pubblico” non significa “libero da prendere” quando si tratta di dati personali: i regolatori UE infliggono sanzioni (Clearview: €30.5M nei Paesi Bassi, €20M in Italia, £7.5M nel Regno Unito).
- La distinzione tra sessione senza login e con login continua a prevalere: lo scraping pubblico senza login è difendibile (hiQ, Meta v. Bright Data); quello dietro login contro termini accettati non lo è.
- L’era AI ha aggiunto rivendicazioni su contratti, licenze e copyright: la legittimità della raccolta e dell’addestramento sono ora questioni separate.
- I proxy sono di per sé legali: è l’attività, non lo strumento, a determinare la legittimità.
La risposta breve, domanda per domanda
| Domanda | Risposta breve |
|---|---|
| È legale raccogliere dati pubblici su prodotti/prezzi? | In generale sì: è la categoria più difendibile ovunque |
| È legale raccogliere dati personali (nomi, profili, contatti)? | Rischio elevato: i regolatori GDPR infliggono sanzioni anche quando i dati sono pubblici |
| È legale effettuare scraping dietro login? | Rischioso: hai accettato i termini; le rivendicazioni contrattuali restano valide anche dove il CFAA non si applica |
| Violazione di robots.txt è illegale? | Non è una legge in sé, ma tribunali e regolatori la considerano prova di malafede |
| Usare proxy è legale? | Sì: è l’attività, non lo strumento, a determinare la legittimità |
| Lo scraping per addestrare AI è legale? | Non definito: vittorie sul fair use per dati ottenuti lecitamente, ma le cause su contratti/licenze si moltiplicano |
Miti comuni sulla legittimità del web scraping
La maggior parte della confusione sulla legittimità del web scraping deriva dal confondere la possibilità tecnica con il permesso legale. Vale la pena chiarire tre miti prima di entrare nei dettagli.
Mito 1: il web scraping è hacking
Effettuare scraping di una pagina pubblica non è accesso non autorizzato: un bot richiede la stessa pagina di un normale browser. Nel caso della Ninth Circuit statunitense hiQ v. LinkedIn (2022) si è ritenuto che lo scraping di pagine pubbliche probabilmente non violi il CFAA quando non viene aggirata alcuna barriera di autenticazione. Le persone chiedono anche “lo screen scraping è legale?”: stessa risposta, leggere una pagina pubblica come fa un browser non è “hacking”.
Mito 2: “Dati pubblici” significa liberi da prendere
Pubblico non significa senza restrizioni. I dati personali restano protetti anche quando sono apertamente visibili: i regolatori europei infliggono sanzioni per lo scraping di dati personali pubblici. Il copyright continua a coprire articoli e immagini pubblici. E i termini di servizio possono vincolarti anche senza login. Quindi la vera domanda, cioè se il data scraping è legale, dipende molto da cosa sono effettivamente i dati.
Mito 3: violare i ToS è un reato
La violazione dei termini di servizio è una questione civile, non penale. Violare i ToS non è automaticamente illegale, ma può motivare un blocco, costituire la base per una causa civile ed essere prova di malafede in tribunale. Più avanti trovi maggiori dettagli sui termini di servizio per il web scraping.
Stati Uniti: CFAA, hiQ e il livello contrattuale
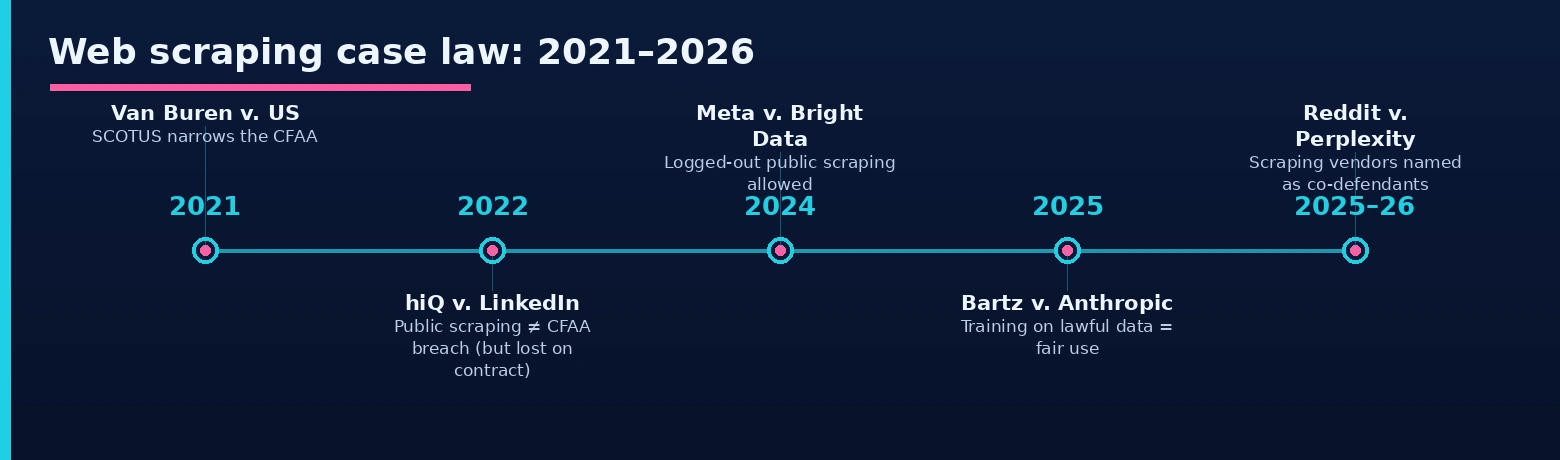
La domanda fondamentale, cioè se lo scraping di siti web è legale negli USA, dipendeva dal fatto che raccogliere pagine pubbliche costituisse “accesso non autorizzato” ai sensi del Computer Fraud and Abuse Act, la legge anti-hacking. La Ninth Circuit ha risposto in hiQ Labs v. LinkedIn (2022, applicando la logica della Corte Suprema in Van Buren): no. Quando una pagina è aperta a chiunque senza credenziali, non esiste una barriera di autorizzazione da violare, quindi lo scraping di dati pubblici non costituisce una violazione del CFAA.
Ma la storia completa di hiQ è la vera lezione. Dopo aver vinto la battaglia sul CFAA, hiQ ha perso la guerra: nel novembre 2022 il tribunale ha ritenuto che avesse violato il Contratto utente di LinkedIn (accettato creando account) e il caso si è concluso con una sentenza consensuale. Il CFAA ti protegge dalle accuse di hacking sulle pagine pubbliche; non ti protegge dai contratti che hai accettato.
Meta v. Bright Data (gennaio 2024) ha reso più netta la linea: un tribunale ha rifiutato di ritenere Bright Data inadempiente per lo scraping di pagine Facebook e Instagram pubbliche, senza login, poiché i termini delle piattaforme regolano i titolari di account, non i visitatori senza login. La regola emersa è questa: lo scraping pubblico senza login è difendibile; lo scraping con login contro termini accettati non lo è. I precedenti più vecchi sul trespass to chattels (eBay v. Bidder’s Edge, 2000) restano rilevanti a volumi estremi, e le leggi statali sulla privacy (CCPA/CPRA della California, VCDPA della Virginia) aggiungono obblighi sui dati personali.
Termini di servizio: browsewrap, clickwrap e quando le regole diventano rischio legale
I termini di servizio non sono legge, ma i tribunali attribuiscono loro molto peso, e la domanda chiave è se l’utente li abbia effettivamente accettati.
Browsewrap vs. clickwrap: quali ToS ti vincolano davvero
Un accordo browsewrap è solo un link posto da qualche parte nella pagina, senza accettazione attiva: i tribunali raramente lo applicano contro chi non ha mai cliccato. Un accordo clickwrap richiede un’azione esplicita, come una casella di spunta o un pulsante “Accetto”, e i tribunali lo applicano quasi sempre. La distinzione pratica: i termini che hai accettato attivamente (di solito creando un account) ti vincolano; quelli che avresti solo potuto vedere spesso no.
Quando le violazioni dei ToS diventano prova legale
Violare i termini di servizio per il web scraping non è un reato, ma ha tre conseguenze pratiche: la piattaforma può bloccarti immediatamente, può essere la base per una causa civile per inadempimento contrattuale (la rivendicazione che alla fine ha affondato hiQ) e appare come malafede se una rivendicazione CFAA o correlata arriva in tribunale.
L’era AI: le cause 2025-2026 che hanno cambiato il quadro
L’addestramento AI ha creato una seconda ondata di contenziosi sullo scraping, meno incentrati su “l’accesso era autorizzato?” e più su contratti, licenze e copyright (le stesse questioni che determinano i proxy per la raccolta di dati di addestramento AI):
- Bartz v. Anthropic (giugno 2025, giudice Alsup): addestrare un LLM su libri ottenuti lecitamente è fair use “estremamente trasformativo”, ma la decisione ha esplicitamente escluso le copie sorgente pirata. Come hai ottenuto i dati conta quanto ciò che ne hai fatto.
- Kadrey v. Meta (giugno 2025, giudice Chhabria): gli attori hanno perso sulla base degli atti presentati, ma l’opinione ha avvertito che non si trattava di un permesso generale per l’addestramento AI: una vittoria circoscritta, non una dottrina.
- Reddit v. Anthropic (depositata giugno 2025): Reddit ha citato in giudizio invocando termini di servizio e arricchimento senza causa, non il copyright. Alla fine di marzo 2026 un giudice federale ha rinviato il caso al tribunale statale della California, ritenendo che le rivendicazioni non siano precluse dal Copyright Act, a conferma che le rivendicazioni contrattuali sullo scraping hanno vita autonoma.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (ottobre 2025, S.D.N.Y.): il primo caso a nominare i fornitori di infrastruttura per lo scraping come coimputati insieme all’azienda AI. Per chi acquista proxy, il punto riguarda le catene di fornitura: chi raccoglie i tuoi dati e come lo fa ora fa parte della tua esposizione legale.
- NYT v. OpenAI (consolidata, S.D.N.Y.): nel gennaio 2026 il tribunale ha ordinato a OpenAI di produrre in discovery un campione di log di 20 milioni di conversazioni; il caso verifica se la “rigenerazione” del modello comprometta il fair use.
- L’economia delle licenze è l’altra faccia della medaglia: Reddit concede in licenza dati a Google (~$60M/yr) e OpenAI; Cloudflare e Stack Overflow hanno lanciato il pay-per-crawl. “Liberi da raccogliere” e “con licenza per addestrare” stanno diventando percorsi divergenti.
Europa: GDPR e i regolatori più severi
Nell’UE (e nel Regno Unito), la domanda raramente è “l’accesso era autorizzato?”: è “hai trattato dati personali senza una base giuridica?”. Ai sensi del GDPR, raccogliere qualsiasi dato che identifichi una persona (nomi, foto, profili, dati di contatto) costituisce “trattamento”, e “era pubblico” non è di per sé una base giuridica. I dati sull’applicazione delle norme sono inequivocabili:
- Paesi Bassi (AP): la linea più dura in Europa. Le linee guida di maggio 2024 definiscono lo scraping di dati personali “quasi sempre una violazione del GDPR” e hanno inflitto a Clearview AI una sanzione di €30.5 milioni, con gli amministratori avvertiti della responsabilità personale.
- Italia (Garante): ha inflitto a Clearview una sanzione di €20 milioni; il principio dichiarato è: “se è pubblico, posso prenderlo” è falso.
- Francia (CNIL): ha inflitto al broker di dati di contatto KASPR una sanzione di €240,000 (dicembre 2024). Le linee guida di giugno 2025 consentono lo scraping di dati personali pubblici per legittimo interesse, ma solo con garanzie (liste di esclusione, minimizzazione, trasparenza).
- Regno Unito (ICO): ha inflitto a Clearview una sanzione di £7.5 milioni; il GDPR britannico, insieme al Data (Use and Access) Act 2025, mantiene il quadro allineato a quello dell’UE.
- In tutta l’UE: la direttiva sulle banche dati aggiunge un distinto diritto sui generis contro l’estrazione di parti sostanziali di banche dati protette, una rivendicazione presente in Europa ma non negli USA.
La sfumatura cruciale: niente di tutto ciò riguarda dati non personali. Prezzi, elenchi di prodotti, disponibilità e classifiche sono fuori dall’ambito del GDPR: pipeline europee di price intelligence e SEO operano legalmente ogni giorno. La mappa del rischio qui sotto mostra come il rischio dello scraping di dati personali vari in base alla giurisdizione.
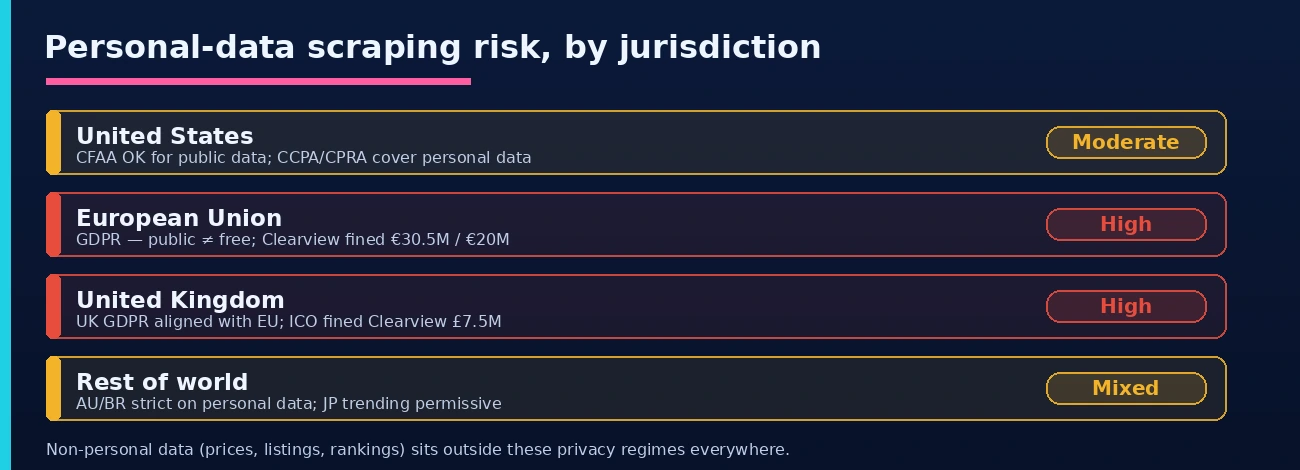
Oltre all’Europa e agli USA, il quadro dello scraping di dati personali va dal rigido al più permissivo:
| Giurisdizione | Quadro normativo | Posizione sullo scraping |
|---|---|---|
| Australia | Privacy Act 1988 + riforma 2024 | I dati pubblici sui prodotti sono difendibili; i dati personali no. |
| Giappone | APPI | Tendenza favorevole: un emendamento del 2026 renderebbe più facile l’uso AI di dati pubblici. |
| Brasile | LGPD (ANPD) | Applicazione attiva delle norme sui dati personali, incluso Clearview. |
| India | DPDP Act 2023 | Regole sui dati personali in irrigidimento; cause sull’addestramento AI in corso. |
| Cina | PIPL + DSL + CSL | Rigorosa sui dati personali e sul trasferimento transfrontaliero; richiede una valutazione della localizzazione. |
Ogni guida per paese nella nostra libreria del blog, dalla Germania al Giappone, contiene una sezione legale locale verificata nei fatti, se ti occorre approfondire un mercato specifico.
Diritto d’autore: cosa puoi e non puoi raccogliere
Il diritto d’autore è una delle fonti più comuni di problemi legali nello scraping, ma la maggior parte dei casi d’uso aziendali rientra in una zona sicura una volta separati i fatti dai contenuti creativi.
Cosa è protetto e cosa non lo è
I fatti non sono tutelabili dal diritto d’autore: prezzi, valutazioni, disponibilità e specifiche sono liberi da raccogliere, ed è per questo che lo scraping di dati sui prodotti è una zona sicura. Ciò che è protetto comprende articoli, foto, video, testo originale e la selezione o disposizione creativa in una banca dati. Ripubblicarli integralmente è il punto in cui sorgono rivendicazioni per violazione del copyright; il Digital Millennium Copyright Act (DMCA) statunitense interviene separatamente quando aggiri controlli di accesso o rimuovi informazioni sulla gestione del copyright, non per la sola ripubblicazione.
Fair use (USA) e direttiva DSM (UE): quando è consentito raccogliere contenuti protetti da copyright
Negli USA, il fair use valuta quattro fattori: lo scopo dell’uso (trasformativo o solo commerciale?), la natura dell’opera, quanto prelevi e l’effetto sul mercato. Authors Guild v. Google (Google Books) è il precedente classico per l’uso trasformativo. Nell’UE, la direttiva DSM consente il text and data mining quando hai accesso lecito e il titolare dei diritti non ha esercitato l’opt-out (spesso segnalato tramite robots.txt). Entrambe lasciano spazio allo scraping di contenuti protetti per analisi, ma nessuna autorizza la ripubblicazione integrale.
Cosa è difendibile e cosa è rischioso
Non tutte le raccolte comportano lo stesso rischio: dipende dal tipo di dati, da come vi accedi e da cosa fai del risultato. I due elenchi qui sotto collocano rapidamente il tuo progetto.
In genere difendibile
- Raccolta pubblica e in sola lettura di dati non personali: prezzi, specifiche di prodotto, scorte, classifiche, risultati di ricerca, tariffe aeree, annunci immobiliari
- Solo accesso senza login, niente dietro autenticazione
- Frequenze di richiesta a ritmo umano che non gravano sull’infrastruttura del sito target
- Rispetto di robots.txt e delle politiche di crawl pubblicate
- Intelligence competitiva, ricerche di mercato, monitoraggio SEO, ad verification, ricerca accademica su dati aggregati
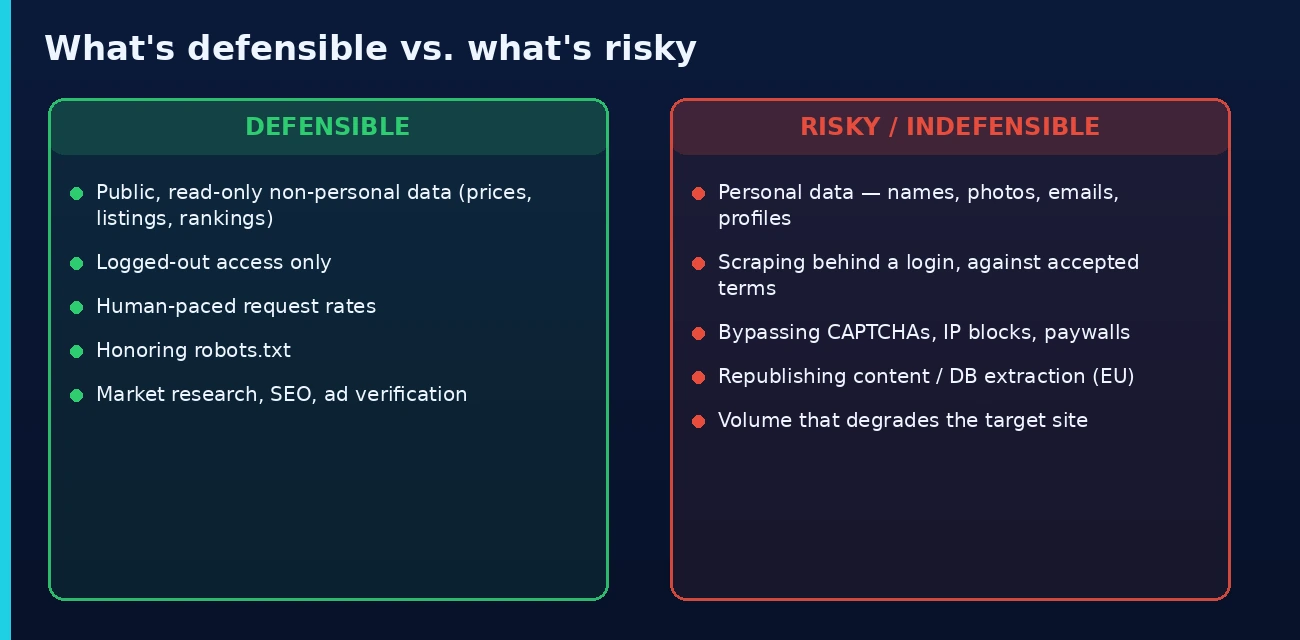
Da rischioso a indifendibile
- Scraping di dati personali: nomi, foto, email, numeri di telefono, profili, soprattutto su larga scala e soprattutto in Europa
- Scraping dietro login, contro termini che hai accettato (la lezione contrattuale di hiQ)
- Aggiramento di barriere tecniche: CAPTCHA presentati come controlli di accesso, blocchi IP rivolti specificamente a te, paywall
- Ripubblicazione integrale di contenuti raccolti (copyright) o estrazione di parti sostanziali di banche dati protette (diritto UE sulle banche dati)
- Volume che degrada il sito target (esposizione a rivendicazioni per trespass to chattels)
- Addestramento AI su contenuti ottenuti da fonti pirata o che violano i termini (l’esclusione in Bartz)
Checklist di conformità per i team di scraping
1. Definisci l’ambito dei dati. Se un campo può identificare una persona, trattalo come regolamentato: eliminalo oppure stabilisci una base giuridica GDPR con garanzie documentate (la scheda del CNIL 2025 sul legittimo interesse è il miglior modello).
2. Rimani senza login. Solo pagine pubbliche. Nel momento in cui ti autentichi, hai accettato un contratto, e le rivendicazioni contrattuali sono quelle che prevalgono.
3. Rispetta i segnali del sito. robots.txt, limiti di frequenza, crawl-delay. Non sempre legalmente vincolanti, ma sono la prima cosa che un tribunale o regolatore esamina.
4. Progetta con moderazione. Cadenza a ritmo umano, caching per evitare richieste ripetute, nessun sovraccarico. Il volume è ciò che trasforma una controversia sullo scraping in una rivendicazione di trespass.
5. Considera la catena di fornitura. Reddit v. Perplexity ha nominato i fornitori di scraping, non solo l’acquirente AI. Scopri come raccolgono i tuoi fornitori di dati.
6. Separa raccolta e uso. Una raccolta lecita non autorizza qualsiasi uso: ripubblicazione, estrazione da banche dati e addestramento AI richiedono ciascuno una propria analisi.
7. Consulta un legale prima di scalare. Una pipeline accettabile a 1,000 richieste/giorno potrebbe richiedere valutazione a 10 milioni.
8. Scegli infrastruttura proxy di provenienza etica. L’aspetto importante non è lo strumento ma la sua provenienza: i proxy sono legali, ma il web scraping etico comprende anche come si ottengono gli IP. I residential proxy di provenienza etica, basati sul consenso, mantengono difendibile il tuo livello di raccolta se qualcuno chiede della tua catena di fornitura.
FAQ
Il web scraping è legale?
Raccogliere dati pubblicamente disponibili e non personali è ampiamente legittimo nella maggior parte delle giurisdizioni: la Ninth Circuit in hiQ v. LinkedIn (2022) ha confermato che lo scraping di pagine pubbliche non è “accesso non autorizzato” ai sensi del CFAA statunitense. Il rischio sta nei dettagli: dati personali (sanzioni GDPR fino a €30.5M nei casi Clearview), scraping dietro login contro termini accettati (il modo in cui hiQ ha infine perso), aggiramento di barriere tecniche e ripubblicazione di contenuti protetti da copyright. Dati pubblici su prodotti, prezzi e SERP raccolti rispettosamente sono il percorso difendibile.
Il web scraping è legale negli USA?
In generale sì per i dati pubblici: hiQ v. LinkedIn ha stabilito che lo scraping di pagine pubbliche non viola il CFAA, e Meta v. Bright Data (2024) ha rifiutato di bloccare lo scraping senza login delle pagine pubbliche di Facebook/Instagram. Ma le rivendicazioni contrattuali restano valide: hiQ ha perso per violazione dei termini LinkedIn che aveva accettato, e volumi estremi comportano il rischio di rivendicazioni per trespass. Le leggi statali sulla privacy (CCPA/CPRA) regolano inoltre i dati personali.
Il web scraping è legale ai sensi del GDPR in Europa?
I dati non personali (prezzi, elenchi, classifiche) sono del tutto fuori dal GDPR. I dati personali sono il punto in cui l’Europa è severa: l’AP olandese definisce lo scraping di dati personali “quasi sempre una violazione” e ha inflitto a Clearview una sanzione di €30.5M; il Garante italiano €20M; la CNIL francese a KASPR €240K, tutti per lo scraping di dati personali pubblici. Le linee guida CNIL del 2025 consentono lo scraping per legittimo interesse di dati personali pubblici solo con garanzie documentate.
Posso legalmente effettuare scraping di Amazon, Google o altre grandi piattaforme?
Raccogliere dati pubblici su prodotti e ricerca senza login, a frequenze rispettose, rientra nella stessa categoria difendibile che altrove: è così che operano i settori della price intelligence e del SEO. I rischi sono specifici della piattaforma: non effettuare il login (termini), non raccogliere dati personali (recensioni con identità dell’autore), non sovraccaricare gli endpoint e conosci la posizione di applicazione di ciascuna piattaforma. Le nostre guide per piattaforma (Amazon, Google Maps, LinkedIn, Reddit) trattano i casi e le regole specifiche.
Raccogliere dati per l’addestramento AI è legale?
La questione non è definita e si divide in due domande. Raccolta: stesse regole di tutto lo scraping. Addestramento: Bartz v. Anthropic (2025) ha ritenuto fair use trasformativo l’addestramento su libri ottenuti lecitamente, ma ha escluso fonti pirata; NYT v. OpenAI verifica se la “rigenerazione” nell’output annulli il fair use; le cause contrattuali di Reddit contro Anthropic e Perplexity (con i suoi fornitori di scraping) hanno superato le prime fasi procedurali. Dati concessi in licenza e catene di fornitura pulite stanno diventando il porto sicuro.
I proxy sono legali da usare?
Sì: i proxy sono infrastruttura di rete standard, legale praticamente ovunque. È regolamentata l’attività svolta tramite il proxy: una raccolta lecita resta lecita tramite un proxy, una raccolta illecita resta illecita. Scegli fornitori con pool residential basati sul consenso e di provenienza etica; dopo che Reddit v. Perplexity ha nominato i fornitori di scraping come convenuti, la provenienza della tua infrastruttura di raccolta è parte della tua storia di conformità.
Violando robots.txt lo scraping diventa illegale?
robots.txt non è una legge e ignorarlo non è automaticamente illegale. Ma tribunali e regolatori lo considerano un segnale di buona o cattiva fede, diverse sentenze lo citano nel valutare rivendicazioni di trespass e contrattuali, e le garanzie della CNIL prevedono che tu rispetti gli opt-out. In pratica: rispettare robots.txt costa poco e rafforza materialmente la tua difendibilità.
Cosa è accaduto in hiQ v. LinkedIn, in un paragrafo?
hiQ ha raccolto profili LinkedIn pubblici per analisi HR; LinkedIn ha inviato una diffida; hiQ ha citato in giudizio e vinto la questione principale: la Ninth Circuit ha stabilito (2022) che lo scraping di pagine pubbliche non è una violazione del CFAA. Poi LinkedIn ha vinto la guerra: il tribunale ha ritenuto che hiQ avesse violato il Contratto utente accettato e il caso si è concluso con una sentenza consensuale. La doppia lezione: lo scraping pubblico non è hacking, ma i contratti che accetti sono applicabili.
Riepilogo
Quindi, il web scraping è legale? Raccogliere dati pubblicamente disponibili e non personali è ampiamente legittimo e difendibile: i tre rischi maggiori sono i dati personali (GDPR e i suoi equivalenti globali), l’accesso contro termini accettati (le rivendicazioni contrattuali che hanno battuto hiQ e ora guidano le cause dell’era AI) e il copyright sui contenuti creativi. Rimani senza login, raccogli dati non personali, rispetta robots.txt e separa raccolta e uso. Dopo il 2026, anche la catena di fornitura è parte della conformità: da dove provengono i tuoi dati e i tuoi proxy fa ora parte del quadro legale. Per l’aspetto infrastrutturale, consulta i migliori proxy per il web scraping. Queste restano informazioni generali, non consulenza legale: chiedi consulenza legale per il tuo caso specifico.
Ultimo aggiornamento: 24 giugno 2026.