
In this Article
웹 스크래핑은 합법일까요? 웹 스크래핑의 적법성은 네 가지에 달려 있습니다. 무엇을 스크래핑하는지(공개 제품 가격인지 개인 프로필인지), 어떻게 스크래핑하는지(공개 페이지인지 로그인 뒤인지), 어디에서 운영하는지(미국의 CFAA 논리인지 유럽의 GDPR인지), 그리고 데이터를 어떻게 사용하는지(가격 모니터링인지 AI 학습인지)입니다. 따라서 사람들이 “웹사이트에서 데이터를 스크래핑하는 것은 합법인가요?”라고 물을 때, 정직한 답은 공개적으로 이용 가능하고 비개인적인 데이터를 스크래핑하는 일은 대부분의 관할권에서 대체로 합법이라는 것입니다. 하지만 이 각각의 요소에 따라 방어 가능한 비즈니스 관행과 규제 조치 사이가 갈립니다. 이 가이드에서는 주요 판례, 2025-2026년 AI 시대 소송, 주요 규제기관의 입장, 실용적인 준수 프레임워크를 살펴봅니다.
먼저 한 가지 말씀드립니다. 이 글은 일반 정보이며 법률 자문이 아닙니다. 상업적 스크래핑 파이프라인을 확장하기 전에 해당 관할권과 대상의 관할권에서 법률 자문을 받으십시오.
핵심 사실
- 공개된 비개인 데이터를 스크래핑하는 일은 대체로 합법입니다 – 세부 사항(무엇을, 어떻게, 어디에서, 왜)이 모든 것을 좌우합니다.
- 개인 데이터에서는 “공개”가 “자유롭게 가져가도 됨”을 의미하지 않습니다 – EU 규제기관은 이를 이유로 벌금을 부과합니다(Clearview: 네덜란드 €30.5M, 이탈리아 €20M, 영국 £7.5M).
- 로그아웃 상태와 로그인 상태의 차이가 계속해서 핵심 기준이 되고 있습니다 – 공개 로그아웃 스크래핑은 방어 가능하지만(hiQ, Meta v. Bright Data), 동의한 약관에 반해 로그인 뒤에서 하는 스크래핑은 그렇지 않습니다.
- AI 시대에는 계약, 라이선싱, 저작권 청구가 추가되었습니다 – 이제 수집의 적법성과 학습의 적법성은 별개의 문제입니다.
- 프록시 자체는 합법입니다 – 도구가 아니라 활동이 적법성을 결정합니다.
질문별 짧은 답변
| 질문 | 짧은 답변 |
|---|---|
| 공개 제품/가격 데이터를 스크래핑하는 것은 합법인가요? | 대체로 그렇습니다 – 어디서나 가장 방어하기 쉬운 범주입니다 |
| 개인 데이터(이름, 프로필, 연락처)를 스크래핑하는 것은 합법인가요? | 고위험 – 데이터가 공개되어 있어도 GDPR 규제기관은 벌금을 부과합니다 |
| 로그인 뒤를 스크래핑하는 것은 합법인가요? | 위험합니다 – 약관에 동의했으며, CFAA가 적용되지 않는 경우에도 계약 청구는 살아남습니다 |
| robots.txt를 위반하면 불법인가요? | 그 자체로 법은 아니지만, 법원과 규제기관은 이를 악의의 증거로 봅니다 |
| 프록시 사용은 합법인가요? | 그렇습니다 – 도구가 아니라 활동이 적법성을 결정합니다 |
| AI 학습을 위한 스크래핑은 합법인가요? | 미확정입니다 – 적법하게 취득한 데이터의 공정 이용은 승소하지만, 계약/라이선싱 소송은 늘고 있습니다 |
웹 스크래핑 적법성에 관한 흔한 오해
웹 스크래핑의 적법성을 둘러싼 대부분의 혼란은 기술적으로 가능한 일과 법적으로 허용된 일을 혼동해서 생깁니다. 세부 사항에 들어가기 전에 세 가지 오해를 바로잡을 필요가 있습니다.
오해 1: 웹 스크래핑은 해킹이다
공개 페이지를 스크래핑하는 것은 무단 접근이 아닙니다. 봇은 일반 브라우저와 같은 페이지를 요청합니다. 미국 제9순회항소법원의 hiQ v. LinkedIn (2022)은 인증 장벽을 우회하지 않은 경우 공개 페이지 스크래핑은 CFAA를 위반하지 않을 가능성이 높다고 판단했습니다. 사람들은 “스크린 스크래핑은 합법인가요?”라고도 묻습니다. 답은 같습니다. 브라우저처럼 공개 페이지를 읽는 것은 “해킹”이 아닙니다.
오해 2: “공개 데이터”는 자유롭게 가져가도 된다는 뜻이다
공개되어 있다고 해서 제한이 없는 것은 아닙니다. 개인 데이터는 공개적으로 보이더라도 계속 보호됩니다. 유럽의 규제기관은 공개 개인 데이터를 스크래핑한 경우 벌금을 부과합니다. 저작권은 공개된 기사와 이미지에도 적용됩니다. 로그인하지 않아도 서비스 약관이 구속력을 가질 수 있습니다. 따라서 데이터 스크래핑은 합법인가라는 진짜 질문은 데이터가 실제로 무엇인지에 크게 좌우됩니다.
오해 3: ToS 위반은 범죄다
서비스 약관 위반은 형사 문제가 아니라 민사 문제입니다. ToS를 위반했다고 자동으로 불법이 되는 것은 아닙니다. 그러나 차단될 근거가 되고, 민사 소송의 근거가 되며, 법정에서 악의의 증거가 됩니다. 아래에서 웹 스크래핑 서비스 약관을 더 자세히 설명합니다.
미국: CFAA, hiQ, 그리고 계약 계층
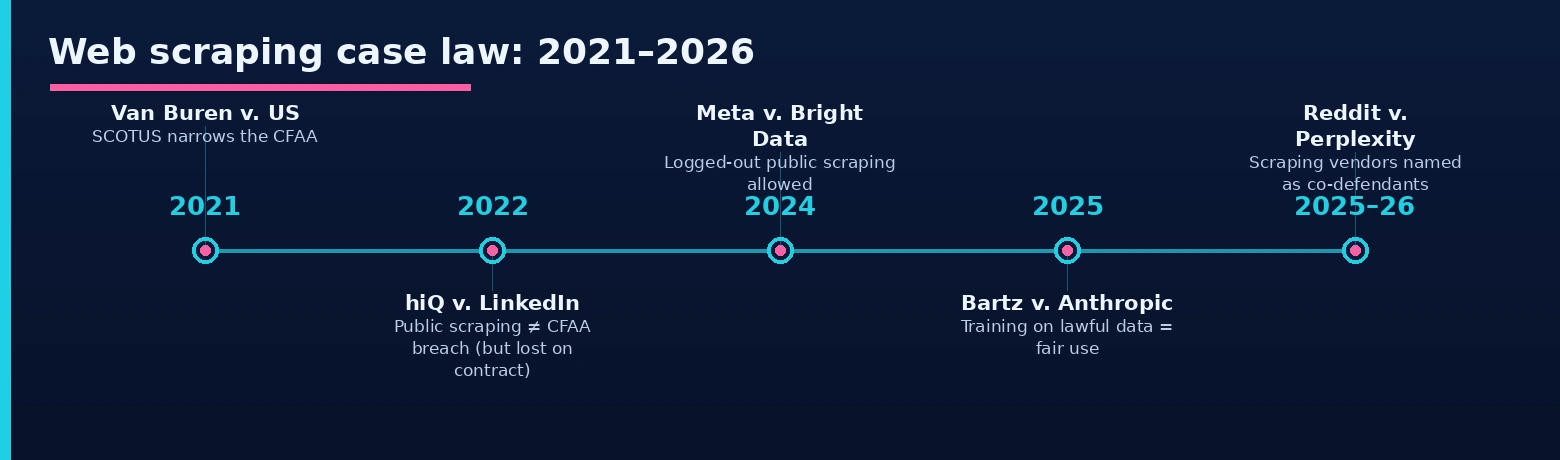
근본적인 질문, 즉 미국에서 웹사이트 스크래핑은 합법인가라는 문제는 공개 페이지 스크래핑이 해킹 방지 법률인 Computer Fraud and Abuse Act상 “무단 접근”인지에 달려 있었습니다. 제9순회항소법원은 hiQ Labs v. LinkedIn (2022, 대법원의 Van Buren 논리 적용)에서 아니라고 답했습니다. 자격 증명 없이 누구나 열람할 수 있는 페이지에는 침해할 인증 장벽이 없으므로, 공개 데이터 스크래핑은 CFAA 위반이 아닙니다.
하지만 hiQ의 전체 이야기가 진짜 교훈입니다. CFAA 다툼에서는 이긴 뒤 hiQ는 전쟁에서 졌습니다. 2022년 11월 법원은 hiQ가 계정 생성으로 동의한 LinkedIn 사용자 계약을 위반했다고 판단했고, 사건은 동의 판결로 끝났습니다. CFAA는 공개 페이지에서 해킹 청구로부터 보호하지만, 동의한 계약으로부터 보호하지는 않습니다.
Meta v. Bright Data (2024년 1월)는 기준을 더 선명하게 했습니다. 법원은 플랫폼의 약관은 로그아웃 방문자가 아니라 계정 보유자를 규율한다는 이유로, 공개된 로그아웃 상태의 Facebook 및 Instagram 페이지를 스크래핑한 Bright Data의 계약 위반을 인정하지 않았습니다. 여기서 나온 규칙은 로그아웃 상태의 공개 스크래핑은 방어 가능하지만, 동의한 약관에 반해 로그인 상태에서 하는 스크래핑은 그렇지 않다는 것입니다. 오래된 동산 침해 사례(eBay v. Bidder’s Edge, 2000)는 극단적인 물량에서는 여전히 적용되며, 주 개인정보 보호법(캘리포니아의 CCPA/CPRA, 버지니아의 VCDPA)은 개인 데이터 의무를 추가합니다.
서비스 약관: Browsewrap, Clickwrap, 그리고 규칙이 법적 위험이 되는 때
서비스 약관은 법 자체는 아니지만 법원은 이를 중요하게 고려하며, 핵심 질문은 사용자가 실제로 약관에 동의했는지입니다.
Browsewrap과 Clickwrap: 실제로 사용자를 구속하는 ToS는 무엇인가
browsewrap 계약은 적극적인 동의 없이 페이지 어딘가에 링크만 있는 계약입니다. 법원은 클릭한 적 없는 사람에게는 좀처럼 이를 집행하지 않습니다. clickwrap 계약은 체크박스나 “동의합니다” 버튼처럼 명시적 행위를 요구하며, 법원은 거의 항상 이를 집행합니다. 실무적 기준은 이렇습니다. 적극적으로 동의한 약관(대개 계정 생성으로)은 사용자를 구속하지만, 단지 볼 수 있었던 약관은 그렇지 않은 경우가 많습니다.
ToS 위반이 법적 증거가 되는 때
웹 스크래핑 서비스 약관 위반은 형사 범죄가 아니지만 세 가지 실질적 결과가 있습니다. 플랫폼은 즉시 차단할 수 있고, 민사상 계약 위반 소송의 근거가 되며(결국 hiQ를 패소하게 한 청구), CFAA 또는 관련 청구가 법원에 가면 악의로 보입니다.
AI 시대: 판도를 바꾼 2025-2026년 소송
AI 학습은 스크래핑 소송의 두 번째 물결을 만들었습니다. “접근이 허가되었는가”보다 계약, 라이선싱, 저작권에 관한 문제입니다(AI 학습 데이터 수집용 프록시를 좌우하는 질문과 같습니다).
- Bartz v. Anthropic (2025년 6월, Alsup 판사): 적법하게 취득한 도서로 LLM을 학습하는 것은 “매우 변형적인” 공정 이용입니다. 그러나 판결은 해적판 원본을 명시적으로 제외했습니다. 데이터를 어떻게 취득했는지는 무엇을 했는지만큼 중요합니다.
- Kadrey v. Meta (2025년 6월, Chhabria 판사): 원고들은 제시한 기록에서 패소했지만, 의견서는 이것이 AI 학습에 대한 광범위한 허가가 아니라고 경고했습니다. 원칙이 아니라 좁은 승리입니다.
- Reddit v. Anthropic (2025년 6월 제기): Reddit은 저작권이 아니라 서비스 약관 및 부당이득 이론으로 소송을 제기했습니다. 2026년 3월 말 연방 판사는 청구가 Copyright Act에 의해 선점되지 않는다고 보아 사건을 캘리포니아 주 법원으로 환송했습니다. 이는 계약 기반 스크래핑 청구가 독자적으로 존속함을 확인합니다.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (2025년 10월, S.D.N.Y.): AI 기업과 함께 스크래핑 인프라 공급업체를 공동 피고로 지목한 첫 사건입니다. 프록시 구매자에게 주는 시사점은 공급망입니다. 누가, 어떻게 데이터를 수집하는지가 이제 법적 노출의 일부입니다.
- NYT v. OpenAI (병합, S.D.N.Y.): 2026년 1월 법원은 OpenAI에 증거개시 절차에서 2,000만 건의 대화 로그 표본을 제출하라고 명령했습니다. 이 사건은 모델의 “되뱉기”가 공정 이용을 약화하는지 검증합니다.
- 라이선싱 경제는 반대편입니다. Reddit은 Google(~$60M/년)과 OpenAI에 데이터를 라이선스하고, Cloudflare와 Stack Overflow는 크롤링당 유료 모델을 시작했습니다. “무료로 스크래핑 가능”과 “학습용 라이선스 보유”는 서로 다른 궤도가 되고 있습니다.
유럽: GDPR과 가장 엄격한 규제기관
EU(및 영국)에서는 “접근이 허가되었는가”가 질문인 경우는 드뭅니다. 질문은 “적법한 근거 없이 개인 데이터를 처리했는가?”입니다. GDPR에 따라 개인을 식별하는 모든 데이터(이름, 사진, 프로필, 연락처)를 스크래핑하는 것은 “처리”이며, “공개되어 있었다”는 것만으로 적법한 근거가 되지 않습니다. 집행 기록은 명백합니다.
- 네덜란드(AP) – 유럽에서 가장 엄격한 기준입니다. 2024년 5월 지침은 개인 데이터 스크래핑을 “거의 항상 GDPR 위반”이라고 하며, Clearview AI에 €30.5 million의 벌금을 부과하고 이사들에게 개인 책임을 경고했습니다.
- 이탈리아(Garante) – Clearview에 €20 million의 벌금을 부과했습니다. 공표한 원칙은 “공개되어 있으면 가져가도 된다”는 말은 틀렸다는 것입니다.
- 프랑스(CNIL) – 연락처 데이터 중개업체 KASPR에 €240,000(2024년 12월)의 벌금을 부과했습니다. 2025년 6월 지침은 보호조치(제외 목록, 최소화, 투명성)가 있을 때만 정당한 이익에 따른 공개 개인 데이터 스크래핑을 허용합니다.
- 영국(ICO) – Clearview에 £7.5 million의 벌금을 부과했습니다. 영국 GDPR과 Data (Use and Access) Act 2025는 프레임워크를 EU와 부합하게 유지합니다.
- EU 전역: Database Directive는 보호된 데이터베이스의 상당 부분을 추출하는 행위에 대해 별도의 sui generis 권리를 더합니다. 이는 유럽에는 있지만 미국에는 없는 청구입니다.
중요한 미묘한 차이는 이 중 어느 것도 비개인 데이터를 대상으로 하지 않는다는 점입니다. 가격, 제품 목록, 재고 여부, 순위는 GDPR의 적용 범위 밖입니다. 유럽의 가격 인텔리전스와 SEO 파이프라인은 매일 적법하게 운영됩니다. 아래 위험 지도는 관할권에 따라 개인 데이터 스크래핑 위험이 어떻게 달라지는지 보여 줍니다.
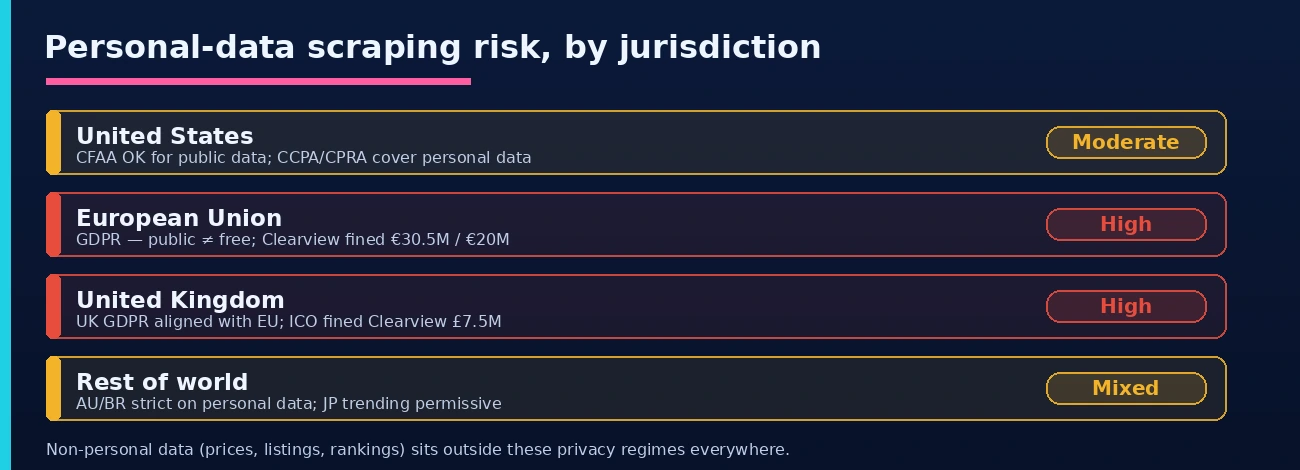
유럽과 미국을 넘어 개인 데이터 스크래핑의 상황은 엄격한 곳부터 완화되는 곳까지 다양합니다.
| 관할권 | 프레임워크 | 스크래핑 입장 |
|---|---|---|
| 호주 | Privacy Act 1988 + 2024 개혁 | 공개 제품 데이터는 방어 가능하지만 개인 데이터는 그렇지 않습니다. |
| 일본 | APPI | 호의적으로 변하는 추세입니다. 2026년 개정안은 공개 데이터의 AI 사용을 완화할 수 있습니다. |
| 브라질 | LGPD (ANPD) | Clearview를 포함해 개인 데이터를 적극적으로 집행합니다. |
| 인도 | DPDP Act 2023 | 개인 데이터 규칙이 강화되고 있으며 AI 학습 사건이 진행 중입니다. |
| 중국 | PIPL + DSL + CSL | 개인 데이터와 국경 간 이전에 엄격하며 현지화 검토가 필요합니다. |
특정 시장에 대해 자세한 내용이 필요하다면 블로그 라이브러리의 모든 국가 가이드에는 독일부터 일본까지 사실 확인을 거친 현지 법률 섹션이 있습니다.
저작권법: 스크래핑할 수 있는 것과 할 수 없는 것
저작권은 스크래핑에서 법적 문제를 일으키는 가장 흔한 원인 중 하나입니다. 그러나 사실과 창작 콘텐츠를 구분하면 대부분의 비즈니스 사용 사례는 안전한 영역에 속합니다.
보호되는 것과 보호되지 않는 것
사실은 저작권 보호 대상이 아닙니다. 가격, 평점, 재고 여부, 사양은 자유롭게 수집할 수 있으므로 제품 데이터를 스크래핑하는 일은 안전한 영역입니다. 실제로 보호되는 것은 기사, 사진, 동영상, 독창적 텍스트, 데이터베이스의 창의적인 선택 또는 배열입니다. 이를 통째로 재게시할 때 저작권 침해 청구가 발생합니다. 미국 Digital Millennium Copyright Act(DMCA)는 별도로 적용됩니다. 재게시만으로 적용되는 것이 아니라 접근 제어를 우회하거나 저작권 관리 정보를 제거할 때입니다.
공정 이용(미국)과 DSM Directive(EU): 저작권 콘텐츠 스크래핑이 허용되는 때
미국에서 공정 이용은 네 가지 요소를 고려합니다. 이용 목적(변형적인가 단지 상업적인가), 저작물의 성격, 가져가는 양, 시장에 미치는 영향입니다. Authors Guild v. Google(Google Books)은 변형적 이용의 고전적 판례입니다. EU에서 DSM Directive는 적법한 접근권이 있고 권리자가 거부하지 않은 경우(흔히 robots.txt로 표시됨) 텍스트 및 데이터 마이닝을 허용합니다. 둘 다 분석을 위해 저작권 콘텐츠를 스크래핑할 여지를 남기지만, 어느 쪽도 통째로 재게시할 라이선스를 주지는 않습니다.
방어 가능한 경우와 위험한 경우
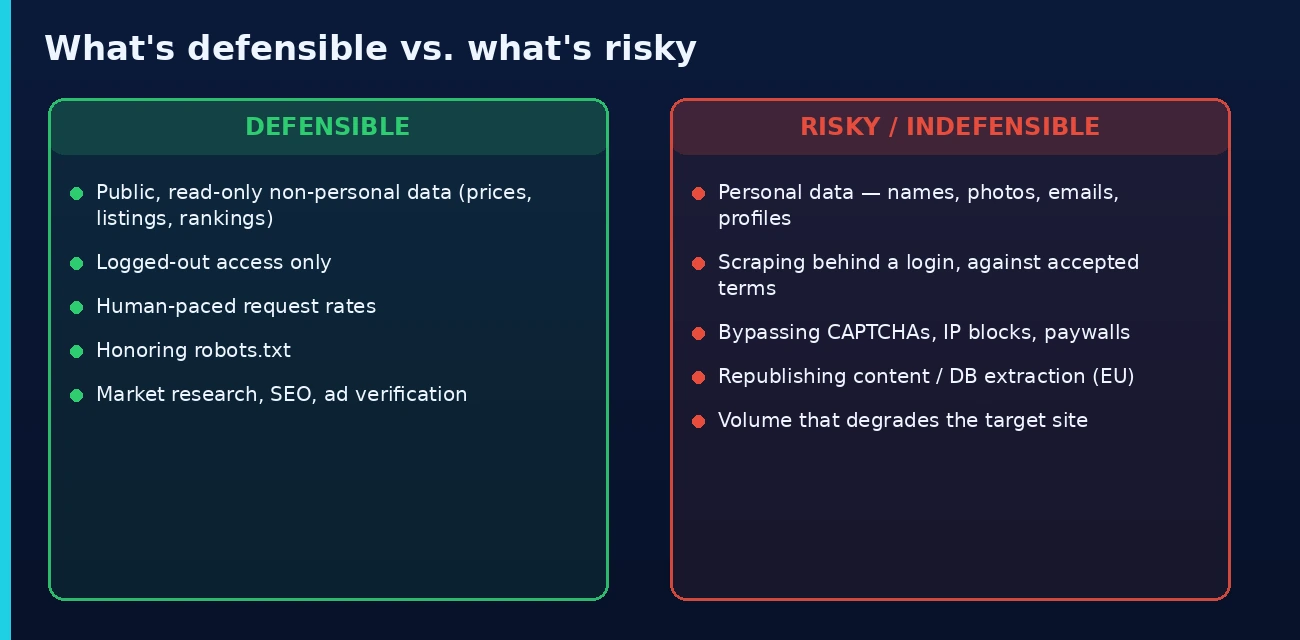
모든 스크래핑이 같은 위험을 수반하는 것은 아닙니다. 데이터 유형, 접근 방식, 결과물의 사용 방식에 달려 있습니다. 아래 두 목록으로 프로젝트의 위치를 빠르게 파악할 수 있습니다.
대체로 방어 가능한 경우
- 가격, 제품 사양, 재고, 순위, 검색 결과, 항공 요금, 부동산 매물 등 비개인 데이터의 공개 읽기 전용 수집
- 로그아웃 상태로만 접근 – 인증 뒤의 어떤 것도 접근하지 않음
- 대상 인프라에 부담을 주지 않는 사람 수준의 요청 속도
- robots.txt와 게시된 크롤링 정책 준수
- 경쟁 인텔리전스, 시장 조사, SEO 모니터링, 광고 검증, 집계 데이터에 대한 학술 연구
위험한 경우부터 방어하기 어려운 경우
- 특히 대규모로, 특히 유럽에서 이름, 사진, 이메일, 전화번호, 프로필 등 개인 데이터를 스크래핑하는 행위
- 동의한 약관에 반해 로그인 뒤를 스크래핑하는 행위(hiQ 계약의 교훈)
- 접근 제어로 제시된 CAPTCHA, 특정 사용자를 겨냥한 IP 차단, 유료 장벽 등 기술적 장벽을 우회하는 행위
- 스크래핑 콘텐츠를 통째로 재게시하는 행위(저작권) 또는 보호된 데이터베이스의 상당 부분을 추출하는 행위(EU 데이터베이스 권리)
- 대상 사이트 성능을 저하하는 물량(동산 침해 노출)
- 해적판 또는 약관 위반 출처에서 취득한 콘텐츠로 AI를 학습하는 행위(Bartz의 제외)
스크래핑 팀을 위한 준수 체크리스트
1. 데이터 범위를 정하십시오. 필드가 개인을 식별할 수 있다면 규제 대상처럼 취급하십시오. 삭제하거나, 문서화한 보호조치와 함께 GDPR의 적법한 근거를 마련해야 합니다(CNIL의 2025년 정당한 이익 안내문이 가장 좋은 템플릿입니다).
2. 로그아웃 상태를 유지하십시오. 공개 페이지만 이용하십시오. 인증하는 순간 계약에 동의하게 되며, 결국 승소하는 것은 계약 청구입니다.
3. 사이트의 신호를 존중하십시오. robots.txt, 속도 제한, crawl-delay를 지키십시오. 항상 법적 구속력이 있는 것은 아니지만 법원이나 규제기관이 가장 먼저 보는 사항입니다.
4. 절제를 고려해 설계하십시오. 사람 수준의 간격, 재요청을 피하는 캐싱, 과도한 요청 금지입니다. 물량이 스크래핑 분쟁을 동산 침해 청구로 바꿉니다.
5. 공급망을 살피십시오. Reddit v. Perplexity는 AI 구매자뿐 아니라 스크래핑 공급업체도 지목했습니다. 데이터 제공업체가 어떻게 수집하는지 파악하십시오.
6. 수집과 사용을 구분하십시오. 적법한 수집이 모든 사용을 허가하지는 않습니다. 재게시, 데이터베이스 추출, AI 학습은 각각 자체적인 검토가 필요합니다.
7. 확장 전에 법률 자문을 받으십시오. 하루 1,000건의 요청에는 문제가 없는 파이프라인도 1,000만 건에서는 검토가 필요할 수 있습니다.
8. 윤리적으로 조달한 프록시 인프라를 선택하십시오. 중요한 것은 도구가 아니라 조달 방식입니다. 프록시는 합법이지만 윤리적 웹 스크래핑은 IP를 어떻게 취득하는지까지 포함합니다. 동의 기반의 윤리적으로 조달한 레지덴셜 프록시(residential proxy)는 공급망에 관한 질문을 받을 때 수집 계층의 방어 가능성을 유지합니다.
자주 묻는 질문
웹 스크래핑은 합법인가요?
공개적으로 이용 가능한 비개인 데이터를 스크래핑하는 일은 대부분의 관할권에서 대체로 합법입니다. 제9순회항소법원의 hiQ v. LinkedIn (2022)은 공개 페이지 스크래핑이 미국 CFAA상 “무단 접근”이 아님을 확인했습니다. 위험은 세부 사항에 있습니다. 개인 데이터(Clearview 사건에서 최대 €30.5M의 GDPR 벌금), 동의한 약관에 반해 로그인 뒤를 스크래핑하는 행위(hiQ가 결국 패소한 이유), 기술적 장벽 우회, 저작권 콘텐츠 재게시가 그것입니다. 공개 제품, 가격, SERP 데이터를 존중하는 방식으로 수집하는 것은 방어 가능한 영역입니다.
미국에서 웹 스크래핑은 합법인가요?
공개 데이터에는 대체로 그렇습니다. hiQ v. LinkedIn은 공개 페이지 스크래핑이 CFAA를 위반하지 않는다고 확립했고, Meta v. Bright Data (2024)는 공개 Facebook/Instagram 페이지의 로그아웃 스크래핑을 차단하지 않았습니다. 그러나 계약 청구는 살아남습니다. hiQ는 동의했던 LinkedIn 약관 위반으로 패소했고, 극단적인 물량은 동산 침해 청구 위험이 있습니다. 주 개인정보 보호법(CCPA/CPRA)은 개인 데이터를 추가로 규제합니다.
유럽에서 GDPR상 웹 스크래핑은 합법인가요?
비개인 데이터(가격, 목록, 순위)는 전적으로 GDPR 적용 대상이 아닙니다. 유럽이 엄격한 부분은 개인 데이터입니다. 네덜란드 AP는 개인 데이터 스크래핑을 “거의 항상 위반”이라고 하며 Clearview에 €30.5M의 벌금을 부과했고, 이탈리아 Garante는 €20M, 프랑스 CNIL은 KASPR에 €240K를 부과했습니다. 모두 공개 개인 데이터를 스크래핑한 경우입니다. CNIL의 2025년 지침은 문서화된 보호조치가 있을 때만 공개 개인 데이터의 정당한 이익 스크래핑을 허용합니다.
Amazon, Google 또는 다른 대형 플랫폼을 적법하게 스크래핑할 수 있나요?
존중하는 속도로 로그아웃 상태에서 공개 제품 및 검색 데이터를 수집하는 일은 다른 곳과 같은 방어 가능한 범주입니다. 가격 인텔리전스와 SEO 업계가 운영하는 방식입니다. 위험은 플랫폼별로 다릅니다. 로그인하지 말고(약관), 개인 데이터를 가져가지 말며(작성자 신원이 있는 리뷰), 엔드포인트에 과부하를 주지 말고, 각 플랫폼의 집행 태세를 파악하십시오. 플랫폼별 가이드(Amazon, Google Maps, LinkedIn, Reddit)에서 구체적인 사례와 규칙을 다룹니다.
AI 학습을 위한 데이터 스크래핑은 합법인가요?
미확정이며 두 질문으로 나뉩니다. 수집에는 모든 스크래핑과 같은 규칙이 적용됩니다. 학습에서는 Bartz v. Anthropic (2025)이 적법하게 취득한 도서 학습을 변형적 공정 이용으로 판단했지만 해적판 출처는 제외했고, NYT v. OpenAI는 출력의 “되뱉기”가 공정 이용을 무너뜨리는지 검증하고 있으며, Anthropic과 Perplexity(및 그 스크래핑 공급업체)를 상대로 한 Reddit의 계약 기반 소송은 초기 절차를 통과했습니다. 라이선스 데이터와 깨끗한 공급망은 안전한 피난처가 되고 있습니다.
프록시는 합법적으로 사용할 수 있나요?
그렇습니다. 프록시는 표준 네트워크 인프라이며 사실상 어디에서나 합법입니다. 규제되는 것은 프록시를 통해 수행하는 활동입니다. 적법한 스크래핑은 프록시를 거쳐도 적법하고, 불법 수집은 불법입니다. 윤리적으로 조달되고 동의 기반인 레지덴셜 풀을 제공하는 업체를 선택하십시오. Reddit v. Perplexity가 스크래핑 공급업체를 피고로 지목한 뒤, 수집 인프라의 출처는 준수 체계의 일부가 되었습니다.
robots.txt를 위반하면 스크래핑이 불법이 되나요?
robots.txt는 법률이 아니며, 이를 무시했다고 자동으로 불법이 되지는 않습니다. 그러나 법원과 규제기관은 이를 선의 또는 악의의 신호로 취급하고, 여러 판결은 동산 침해와 계약 청구를 판단할 때 이를 인용하며, CNIL의 보호조치는 거부 의사를 존중할 것을 기대합니다. 실무적으로 robots.txt를 준수하는 데 드는 비용은 적고 방어 가능성을 실질적으로 강화합니다.
한 문단으로 정리하면 hiQ v. LinkedIn에서 무슨 일이 있었나요?
hiQ는 HR 분석을 위해 공개 LinkedIn 프로필을 스크래핑했고, LinkedIn은 중단 요구서를 보냈습니다. hiQ는 소송을 제기해 핵심 쟁점에서 승소했습니다. 제9순회항소법원은 2022년에 공개 페이지 스크래핑은 CFAA 위반이 아니라고 판단했습니다. 이후 LinkedIn이 전쟁에서 이겼습니다. 법원은 hiQ가 동의한 사용자 계약을 위반했다고 판단했고, 사건은 동의 판결로 끝났습니다. 두 가지 교훈은 공개 스크래핑은 해킹이 아니지만, 동의한 계약은 집행된다는 것입니다.
요약
그렇다면 웹 스크래핑은 합법일까요? 공개적으로 이용 가능한 비개인 데이터를 스크래핑하는 일은 대체로 합법이며 방어 가능합니다. 세 가지 가장 큰 위험은 개인 데이터(GDPR 및 전 세계의 유사 제도), 동의한 약관에 반한 접근(hiQ를 이기고 현재 AI 시대 소송을 주도하는 계약 청구), 창작 콘텐츠의 저작권입니다. 로그아웃 상태를 유지하고, 비개인 데이터를 수집하며, robots.txt를 준수하고, 수집과 사용을 구분하십시오. 2026년 이후 공급망도 준수의 일부입니다. 데이터와 프록시의 출처가 이제 법적 상황의 일부입니다. 인프라 측면은 웹 스크래핑용 최고의 프록시를 참조하십시오. 이 글은 여전히 일반 정보이며 법률 자문이 아닙니다. 특정 사례에 대해서는 법률 자문을 받으십시오.
최종 업데이트: 2026년 6월 24일.