
In this Article
Rust 웹 스크래핑은 Rust 프로그래밍 언어와 그 크레이트 생태계를 사용해 웹 페이지를 가져오고 파싱하는 작업입니다. Rust는 가비지 컬렉터 없이 예측 가능한 성능과 메모리 안전성을 원하는 개발자에게 적합하므로, 지속적으로 실행되거나 대량으로 처리하는 크롤러에 잘 맞습니다.
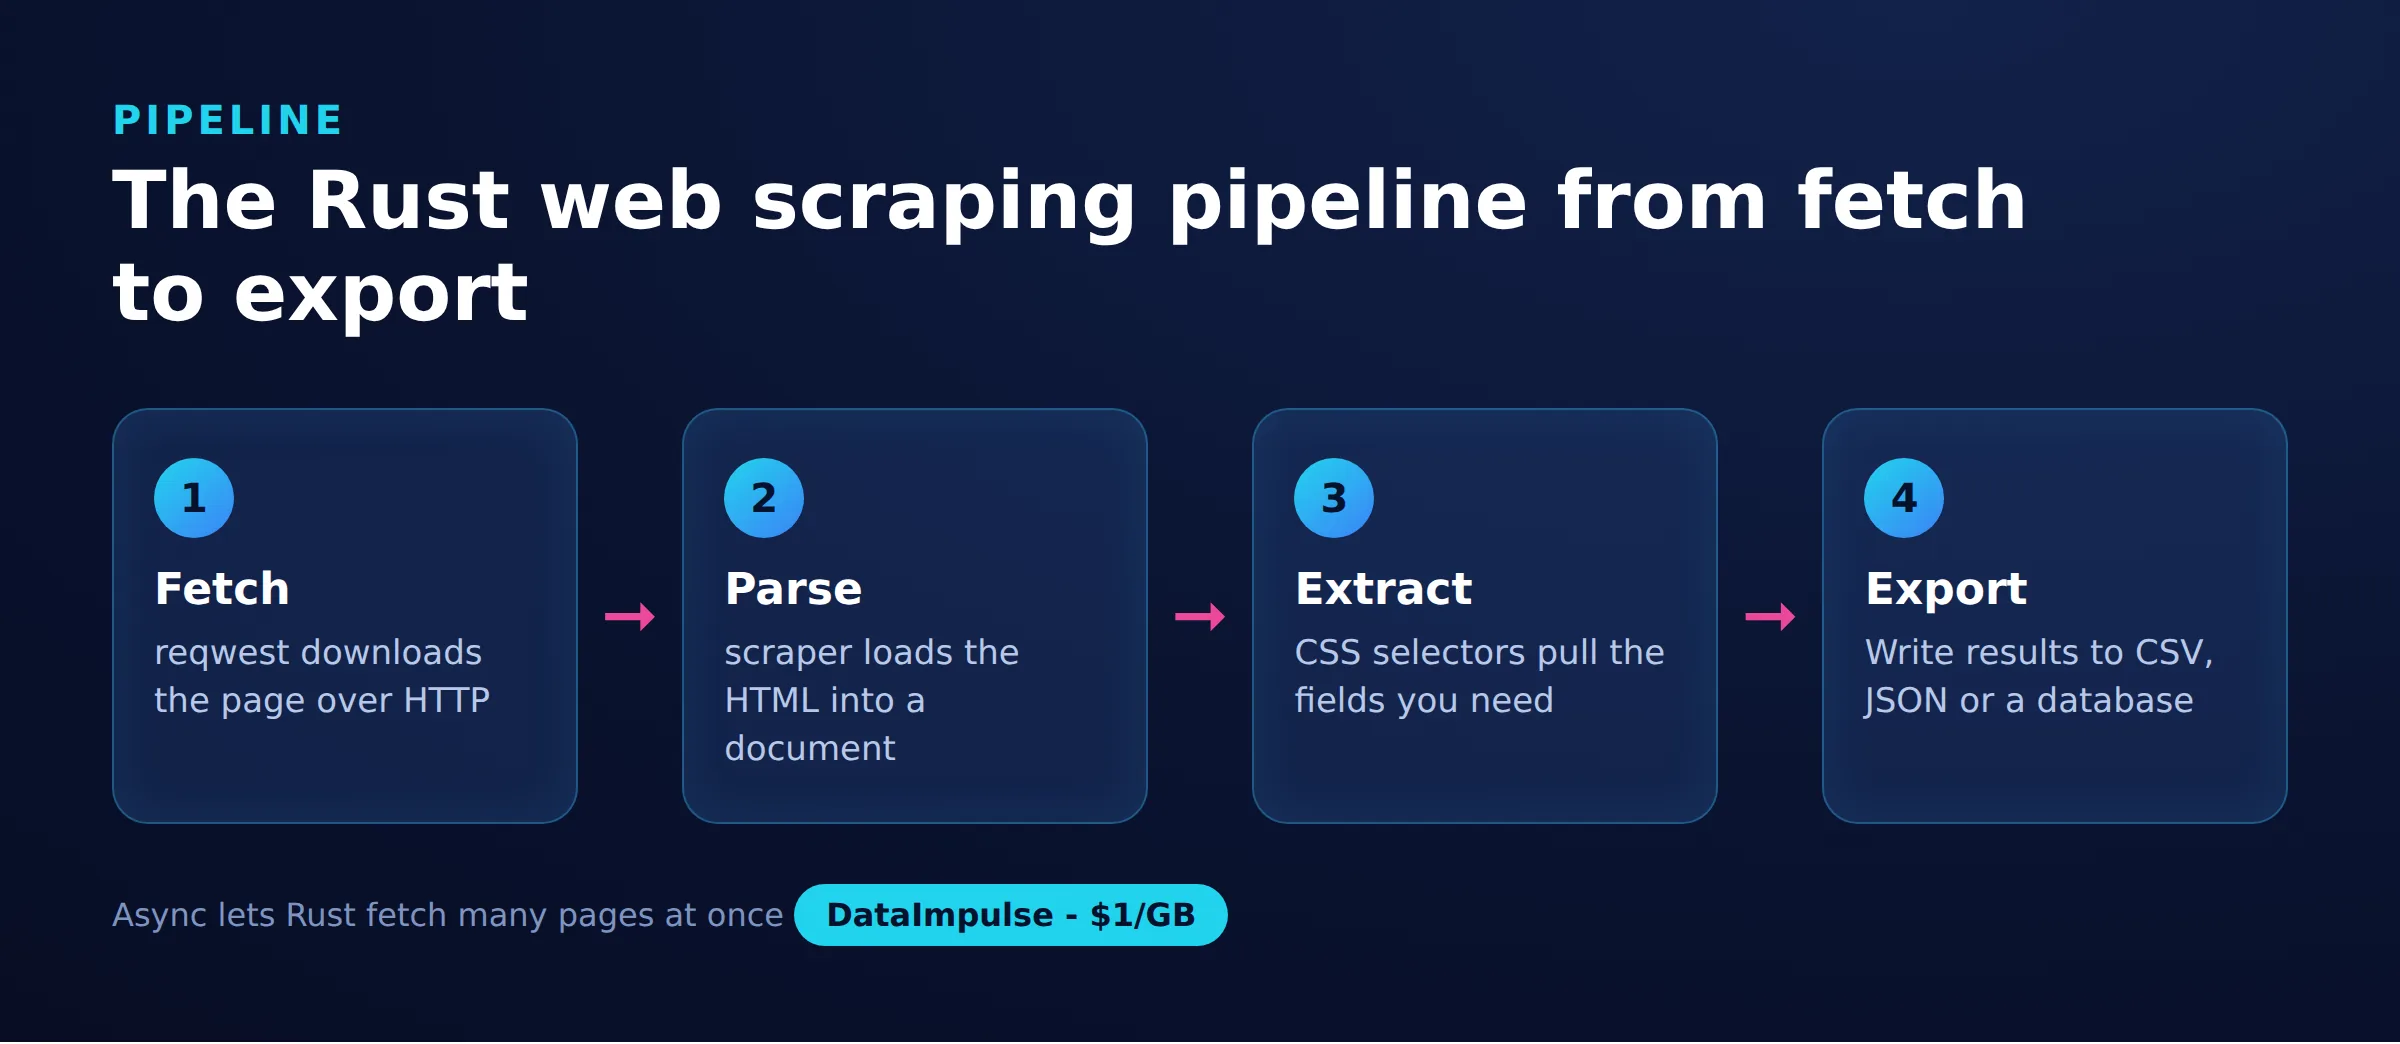
이 가이드는 reqwest HTTP 클라이언트와 scraper 파싱 크레이트를 중심으로 구성한 실용적인 코드 우선 안내서입니다. 프로젝트 설정과 최소한의 가져오기부터 CSS 선택자, 구조화된 데이터 모델, JSON 및 CSV 내보내기, 페이지네이션, 재시도와 백오프를 활용한 오류 처리, tokio를 사용한 비동기 동시성, 프록시 구성, JavaScript 비중이 큰 사이트를 위한 헤드리스 브라우저 대안까지 다룹니다. 모든 스니펫은 컴파일하고 실행할 수 있도록 작성했습니다.
DataImpulse는 195개국에서 9,000만 개가 넘는 레지덴셜 프록시(residential proxy), 모바일 프록시, 데이터센터 프록시 IP 주소를 제공하는 윤리적인 프록시 제공업체입니다. 만료되지 않는 트래픽을 포함해 GB당 1달러부터 종량제 모델을 사용하며, 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사, 다계정 관리에 사용됩니다.
핵심 정보
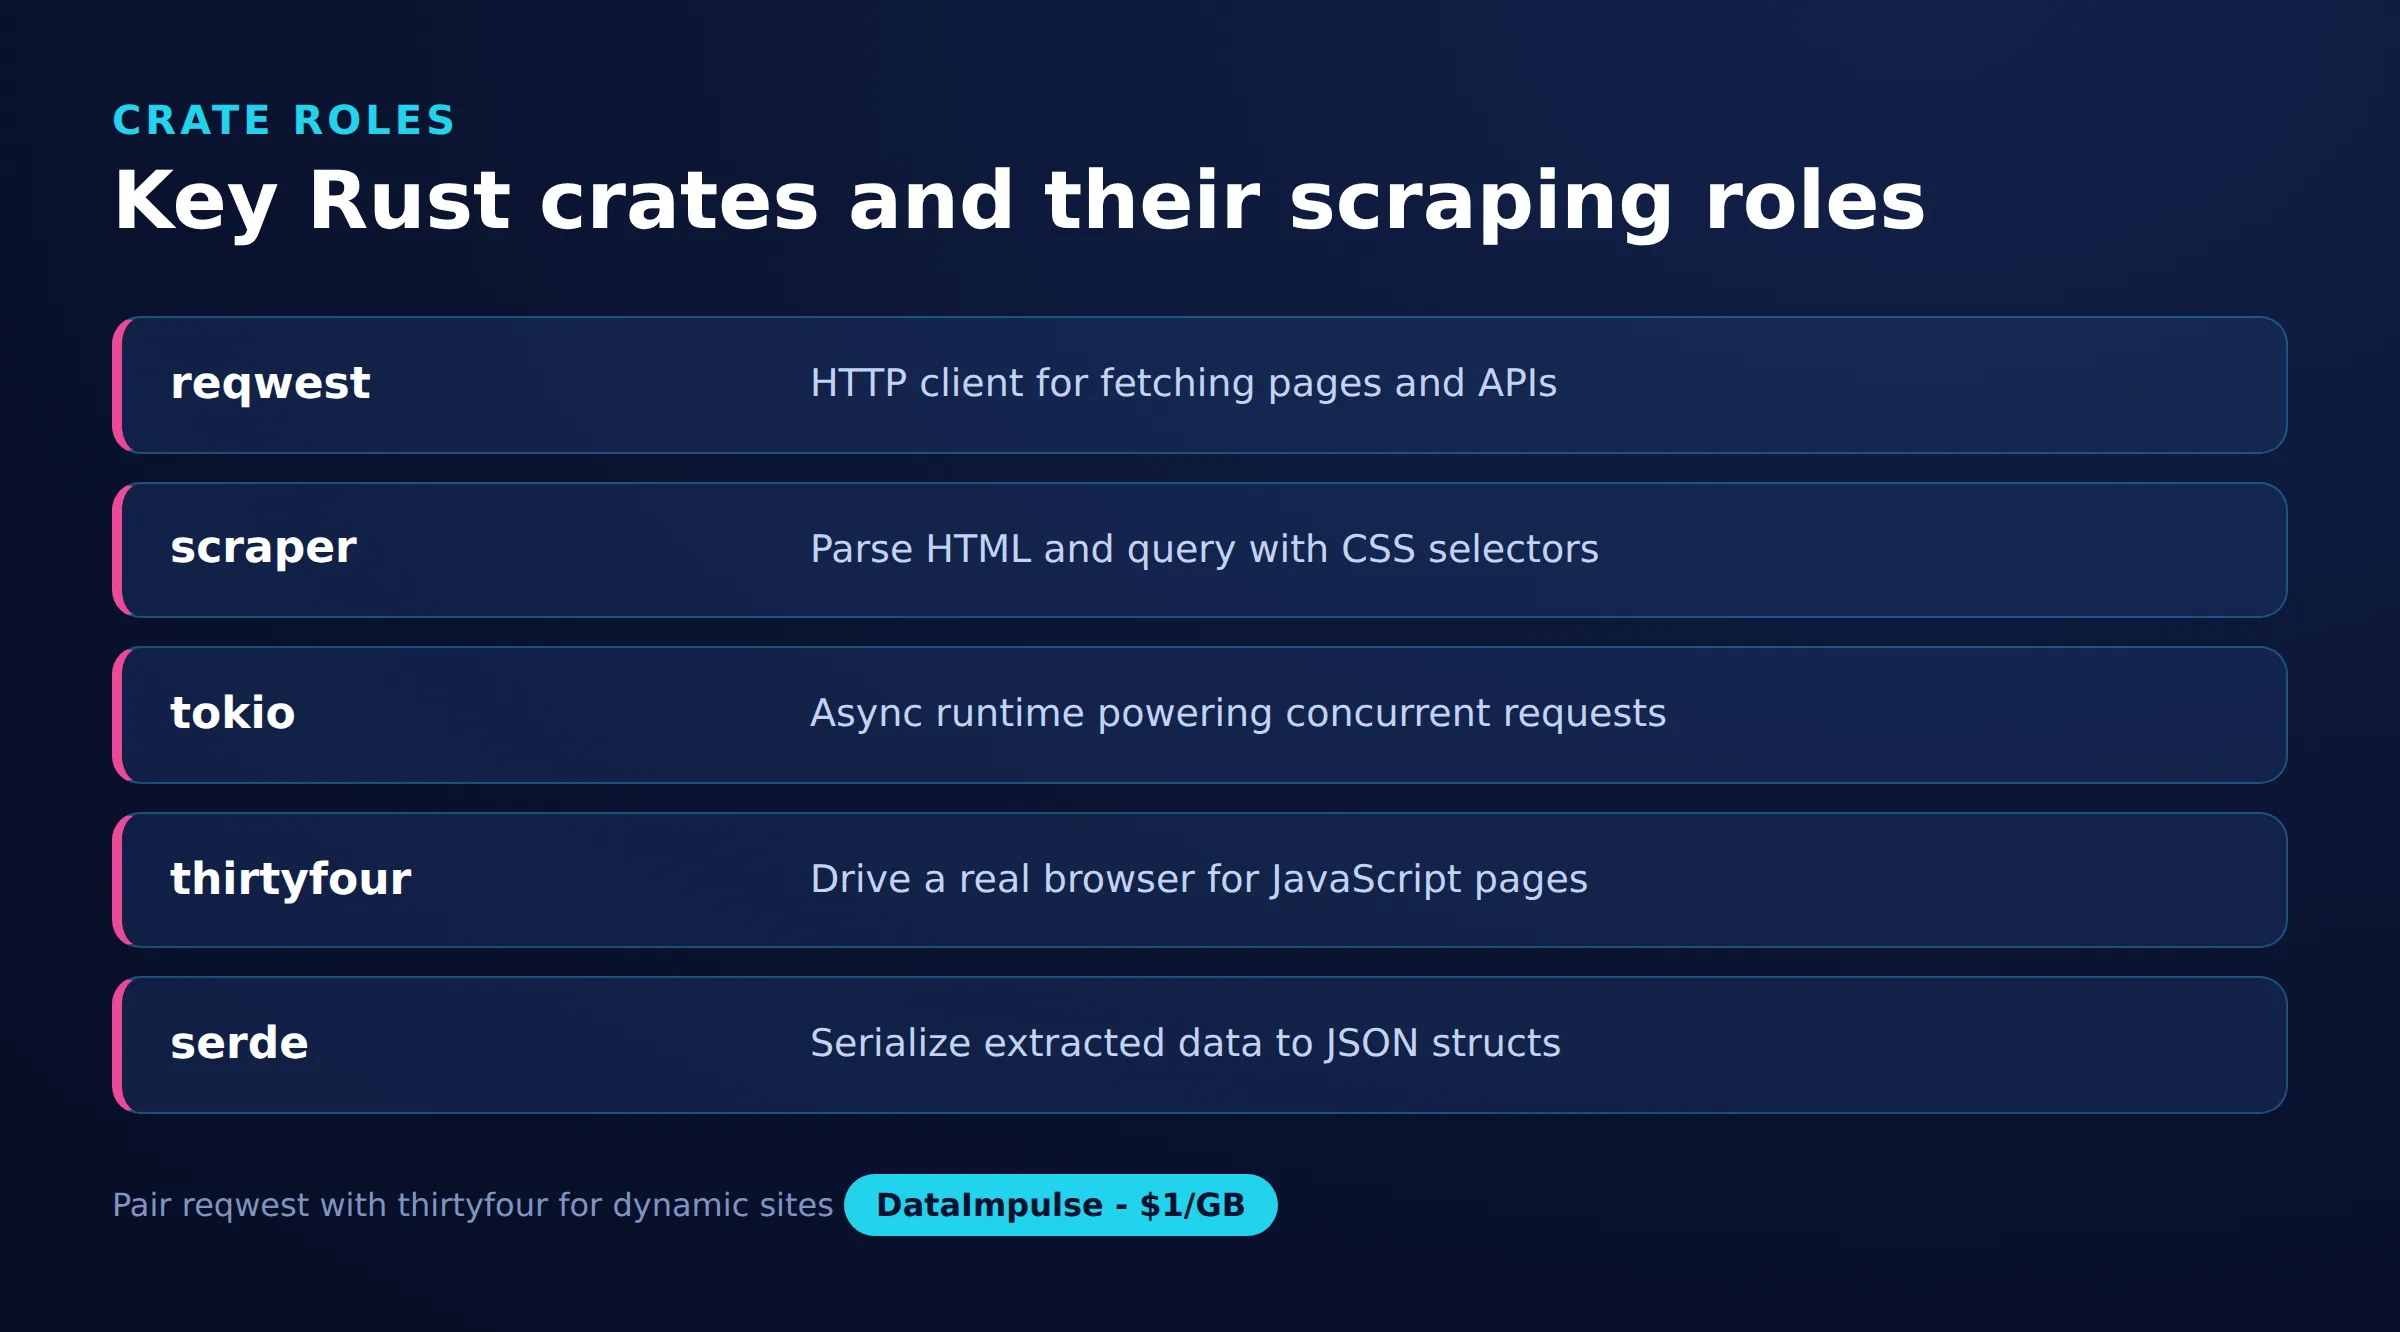
- 핵심 스택: Rust 웹 스크래핑은 일반적으로 HTML 파싱을 위한 scraper 크레이트와 reqwest HTTP 클라이언트를 함께 사용하고, 비동기 동시성을 위해 tokio, 구조화된 데이터 내보내기를 위해 serde를 추가합니다.
- 가장 적합한 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시입니다.
- 가격: GB당 1달러부터, 구독 없이 만료되지 않는 트래픽을 제공하는 종량제입니다.
- 범위: 195개국의 윤리적으로 확보된 9,000만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2에서 5점 만점에 4.8점을 받았습니다.
- 프로토콜 및 타기팅: 국가 타기팅이 포함된 HTTP, HTTPS, SOCKS5입니다.
웹 스크래핑에 Rust를 사용하는 이유는 무엇인가요?
Rust는 빠른 프로토타이핑보다 속도, 낮은 메모리 사용량, 신뢰성이 더 중요할 때 웹 스크래핑에 적합합니다. 컴파일된 바이너리는 하드웨어에 가깝게 실행되며, 빌림 검사기는 프로덕션 환경이 아니라 컴파일 시점에 광범위한 동시성 버그를 찾아냅니다.
이러한 특성은 몇 가지 일반적인 상황에서 특히 유용합니다:
- 처리량: 컴파일된 Rust 크롤러는 인터프리터 언어보다 낮은 CPU 및 메모리 오버헤드로 많은 페이지를 처리하므로, 장시간 작업의 인프라 비용을 줄입니다.
- 안전한 동시성: 비동기 런타임 tokio를 사용하면 수천 개의 동시 요청을 실행할 수 있으며, 타입 시스템은 해당 작업 전반의 데이터 레이스를 방지합니다.
- 예측 가능한 리소스 사용량: 가비지 컬렉터가 없으므로 지연 시간이 더 안정적이며, 이는 수 시간 또는 수일 동안 실행되는 크롤러에 도움이 됩니다.
그 대가로 학습 곡선이 더 가파르고 컴파일 시간이 길어지므로, Rust는 일회성 스크립트보다 대규모로 실행되는 프로젝트에 적합합니다. 언어와 관계없이 동일한 기본 원칙이 적용됩니다. robots.txt를 존중하고, 요청 속도를 제한하며, 일반적인 웹 스크래핑 모범 사례를 따라 크롤러가 책임감 있게 작동하도록 하세요.
Rust 스크래핑 프로젝트는 어떻게 설정하나요?
새 Cargo 패키지를 만들고 Cargo.toml에 필요한 크레이트를 선언하여 Rust 스크래핑 프로젝트를 설정합니다. Cargo는 Rust의 빌드 도구이자 패키지 관리자이므로 의존성을 해결하고 프로젝트를 컴파일합니다.
cargo new rust-scraper를 실행해 프로젝트 골격을 만든 뒤 생성된 Cargo.toml을 편집하세요. 아래 의존성 세트는 HTTP, 파싱, 비동기, 직렬화, CSV 출력, 스트림, 사용하기 편한 오류 처리 등 이 가이드의 모든 내용을 포함합니다.
[package]
name = "rust-scraper"
version = "0.1.0"
edition = "2021"

[dependencies]
reqwest = { version = "0.12", features = ["json", "socks"] }
scraper = "0.20"
tokio = { version = "1", features = ["full"] }
serde = { version = "1", features = ["derive"] }
serde_json = "1"
csv = "1.3"
futures = "0.3"
anyhow = "1"
thiserror = "1"
여기서 reqwest는 요청을 처리하고(socks 기능은 SOCKS5 프록시를 활성화하며 json 기능은 JSON 도우미를 추가합니다), scraper는 CSS 선택자로 HTML을 파싱하고, tokio는 비동기 런타임을 제공하며, serde와 serde_json은 데이터를 직렬화하고, csv는 스프레드시트를 작성하고, futures는 동시성을 위한 스트림 결합자를 제공하며, anyhow와 thiserror는 오류 처리를 간소화합니다. 첫 요청을 작성하기 전에 cargo build를 한 번 실행해 모든 항목을 다운로드하고 컴파일하세요.
reqwest와 scraper로 페이지를 가져오고 파싱하려면 어떻게 하나요?
reqwest로 GET 요청을 전송해 페이지를 가져온 다음, 응답 본문을 scraper에 로드하여 CSS 선택자로 조회합니다. 아래 예제는 tokio에서 비동기적으로 실행되며, 페이지를 가져와 모든 H1 요소의 텍스트를 출력합니다.
use scraper::{Html, Selector};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let url = "https://example.com";
    let body = reqwest::get(url).await?.text().await?;

    let document = Html::parse_document(&body);
    let heading = Selector::parse("h1").unwrap();

    for element in document.select(&heading) {
        let text: String = element.text().collect();
        println!("{}", text.trim());
    }
    Ok(())
}
흐름은 항상 같습니다. reqwest::get는 응답을 반환하고, .text()는 본문을 문자열로 읽으며, Html::parse_document는 해당 문자열을 조회 가능한 트리로 변환합니다. ? 연산자는 네트워크 또는 디코딩 오류를 main까지 전파합니다. 일치한 요소에서 .text()를 호출하면 텍스트 노드가 수집되고, 이를 다듬어 사용합니다. 이 원시 HTML 방식은 빠르지만 서버가 반환하는 마크업만 볼 수 있으며 브라우저가 나중에 JavaScript로 렌더링하는 콘텐츠는 볼 수 없다는 점에 유의하세요.
CSS 선택자로 요소를 지정하려면 어떻게 하나요?
브라우저 콘솔에서 하듯이 표준 CSS 선택자 문자열을 Selector::parse에 전달하여 요소를 지정합니다. scraper 크레이트는 태그, 클래스, id, 속성 일치, 하위 경로, 구조적 의사 클래스를 지원합니다.
use scraper::Selector;

// Match by tag
let links = Selector::parse("a").unwrap();

// Match by class
let prices = Selector::parse(".price").unwrap();

// Match by id
let main = Selector::parse("#main-content").unwrap();

// Match by attribute value
let external = Selector::parse("a[rel=\"nofollow\"]").unwrap();

// Descendant path (a title inside a product card)
let titles = Selector::parse("div.product h2.title").unwrap();

// Direct child plus pseudo-class
let first_row = Selector::parse("table > tbody > tr:first-child").unwrap();
파싱에는 작은 비용이 있으므로 선택자를 루프 내부에서 파싱하지 말고 한 번 컴파일해 재사용하세요. 선택자가 일치하지 않을 수 있다면, 누락된 필드 때문에 전체 실행이 패닉 상태가 되지 않도록 요소의 .unwrap() 대신 대체 값을 갖춘 .next()를 사용하세요. 브라우저의 요소 선택기로 대상 페이지를 검사하는 것이 선택에 사용할 안정적인 클래스 이름과 속성을 찾는 가장 빠른 방법입니다.
스크래핑한 데이터를 JSON 및 CSV로 내보내려면 어떻게 하나요?
각 레코드를 serde의 Serialize를 파생하는 구조체로 모델링한 다음, 해당 구조체의 슬라이스를 serde_json으로 JSON에 쓰거나 csv 크레이트로 CSV에 작성하여 스크래핑 데이터를 내보냅니다. 타입이 지정된 모델을 정의하면 추출과 출력이 일관되게 유지되고 코드의 의도가 명확해집니다.
먼저 레코드를 모델링하고 각 컨테이너 요소에서 필드를 추출합니다:
use scraper::{Html, Selector};
use serde::Serialize;

#[derive(Debug, Serialize)]
struct Product {
    name: String,
    price: String,
    url: String,
}

fn parse_products(html: &str) -> Vec<Product> {
    let document = Html::parse_document(html);
    let card = Selector::parse("div.product").unwrap();
    let name_sel = Selector::parse("h2.title").unwrap();
    let price_sel = Selector::parse("span.price").unwrap();
    let link_sel = Selector::parse("a").unwrap();

    let mut products = Vec::new();
    for card_el in document.select(&card) {
        let name = card_el
            .select(&name_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let price = card_el
            .select(&price_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let url = card_el
            .select(&link_sel)
            .next()
            .and_then(|e| e.value().attr("href"))
            .unwrap_or_default()
            .to_string();

        products.push(Product { name, price, url });
    }
    products
}Product가 Serialize를 파생하므로, 추가 작업 없이 동일한 구조체를 두 내보내기 기능에 사용할 수 있습니다:
use std::fs::File;
use std::io::Write;

fn export_json(products: &[Product]) -> anyhow::Result<()> {
    let json = serde_json::to_string_pretty(products)?;
    let mut file = File::create("products.json")?;
    file.write_all(json.as_bytes())?;
    Ok(())
}

fn export_csv(products: &[Product]) -> anyhow::Result<()> {
    let mut writer = csv::Writer::from_path("products.csv")?;
    for product in products {
        writer.serialize(product)?;
    }
    writer.flush()?;
    Ok(())
}
serde_json의 to_string_pretty는 사람이 읽기 쉬운 JSON을 생성하며, csv 크레이트의 serialize는 각 구조체를 필드 이름에서 파생된 헤더가 있는 행으로 매핑합니다. 스크래핑, JSON, CSV에 하나의 타입 지정 모델을 재사용하면 대상 사이트가 변경되어도 Rust 파이프라인을 쉽게 유지 관리할 수 있습니다.
페이지네이션 루프로 여러 페이지를 스크래핑하려면 어떻게 하나요?
페이지 번호 또는 다음 페이지 URL을 반복 처리하고 단일 reqwest 클라이언트를 재사용하여 요청 간 연결을 풀링함으로써 여러 페이지를 스크래핑합니다. 각 URL을 만들고 가져온 뒤 이전 섹션의 함수로 파싱하며, 페이지가 결과를 반환하지 않으면 중지합니다.
use scraper::Html;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let mut all_products = Vec::new();

    for page in 1..=10 {
        let url = format!("https://example.com/products?page={}", page);
        let body = client.get(&url).send().await?.text().await?;
        let products = parse_products(&body);

        // Stop when a page returns no results
        if products.is_empty() {
            break;
        }
        all_products.extend(products);

        // Pause between requests to stay polite
        tokio::time::sleep(std::time::Duration::from_millis(500)).await;
    }

    println!("Collected {} products", all_products.len());
    Ok(())
}
루프 외부에서 reqwest::Client::new()로 클라이언트를 한 번 생성하면 TCP 연결을 재사용할 수 있어 요청마다 새 클라이언트를 만드는 것보다 눈에 띄게 빠릅니다. 빈 결과 확인은 마지막 페이지에 도달하면 자연스럽게 루프를 끝내고, 짧은 대기 시간은 서버에 과부하를 주지 않도록 요청 간격을 둡니다. 번호 페이지 대신 다음 링크를 사용하는 사이트에서는 반복할 때마다 다음 페이지 앵커의 href를 추출하고 링크가 사라질 때까지 따르세요.
백오프를 사용해 오류와 재시도를 처리하려면 어떻게 하나요?
가져오기 함수에서 타입이 지정된 오류를 반환하고 일시적인 실패는 지수 백오프로 재시도하여 오류를 처리합니다. 네트워크는 시간 초과될 수 있고 서버는 임시 상태 코드를 반환할 수 있으므로, 견고한 스크래퍼는 단일 실패를 치명적인 문제가 아니라 예상 가능한 상황으로 다룹니다.
thiserror 크레이트를 사용하면 reqwest 오류에서 자동 변환되는 간결한 오류 enum을 정의할 수 있습니다:
use thiserror::Error;

#[derive(Error, Debug)]
enum ScrapeError {
    #[error("request failed: {0}")]
    Request(#[from] reqwest::Error),

    #[error("unexpected status code: {0}")]
    Status(reqwest::StatusCode),

    #[error("selector matched no elements")]
    Empty,
}

async fn fetch_page(client: &reqwest::Client, url: &str) -> Result<String, ScrapeError> {
    let response = client.get(url).send().await?;
    if !response.status().is_success() {
        return Err(ScrapeError::Status(response.status()));
    }
    Ok(response.text().await?)
}
#[from] 속성은 reqwest 실패가 ? 연산자를 통해 자동으로 ScrapeError::Request로 변환됨을 의미합니다. 타입이 지정된 오류에 더해, 시도할 때마다 대기 시간이 늘어나는 재시도 루프로 요청을 감싸세요:
use std::time::Duration;

async fn fetch_with_backoff(client: &reqwest::Client, url: &str) -> anyhow::Result<String> {
    let max_attempts = 5;
    for attempt in 1..=max_attempts {
        match client.get(url).send().await {
            Ok(resp) if resp.status().is_success() => {
                return Ok(resp.text().await?);
            }
            Ok(resp) => {
                eprintln!("attempt {attempt}: status {}", resp.status());
            }
            Err(err) => {
                eprintln!("attempt {attempt}: {err}");
            }
        }
        // Exponential backoff: 0.5s, 1s, 2s, 4s, 8s
        let backoff = Duration::from_millis(500 * 2u64.pow(attempt - 1));
        tokio::time::sleep(backoff).await;
    }
    anyhow::bail!("giving up on {url} after {max_attempts} attempts")
}
지수 백오프(여기서는 0.5s, 1s, 2s, 4s, 8s)는 속도가 제한되었거나 잠시 과부하된 서버를 계속 압박하지 않고 복구할 여유를 줍니다. 재시도를 로테이팅 프록시와 결합하면 더욱 효과적입니다. 하나의 IP에서 차단되거나 제한된 요청도 다른 출구 IP에서 다음 시도에 성공할 수 있습니다.
tokio로 동시 요청을 실행하려면 어떻게 하나요?
URL 목록을 비동기 스트림으로 변환하고 동시에 진행 중인 요청 수를 제한하는 buffer_unordered를 적용하여 동시 요청을 실행합니다. 이는 Rust 스크래퍼에서 가장 큰 성능 조절 요소이며, tokio와 futures 크레이트가 이를 안전하게 만듭니다.
use futures::stream::{self, StreamExt};

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let urls: Vec<String> = (1..=50)
        .map(|n| format!("https://example.com/item/{}", n))
        .collect();

    let bodies = stream::iter(urls)
        .map(|url| {
            let client = client.clone();
            async move {
                let text = client.get(&url).send().await?.text().await?;
                Ok::<_, reqwest::Error>((url, text))
            }
        })
        .buffer_unordered(10); // at most 10 requests in flight

    bodies
        .for_each(|result| async {
            match result {
                Ok((url, body)) => println!("{}: {} bytes", url, body.len()),
                Err(err) => eprintln!("error: {}", err),
            }
        })
        .await;

    Ok(())
}
여기서 stream::iter는 URL 목록을 스트림으로 변환하고, .map은 URL마다 하나의 비동기 요청을 시작하며, buffer_unordered(10)은 최대 10개를 동시에 실행해 완료되는 대로 결과를 반환합니다. reqwest Client는 공유 연결 풀을 둘러싼 Arc이므로 작업별로 클라이언트를 복제하는 비용은 적습니다. 대상에 가하는 부하와 속도의 균형을 위해 동시성 제한을 조정하세요. 10개에서 20개가 합리적인 시작점이며, 더 높은 동시성을 프록시 풀과 결합하면 요청을 많은 IP에 분산할 수 있습니다.
Rust 스크래핑 트래픽을 프록시로 라우팅하려면 어떻게 하나요?
reqwest::Proxy로 reqwest 클라이언트를 만들고 .basic_auth로 게이트웨이와 자격 증명을 연결하여 트래픽을 프록시로 라우팅합니다. 로테이팅 IP를 통해 요청을 전송하면 부하를 분산하고 지역별 콘텐츠에 도달하며 속도 제한 가능성을 낮춥니다. 로테이팅 IP는 차단되지 않고 스크래핑하는.
use reqwest::Proxy;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    // Authenticated gateway; rotates the exit IP on each request
    let proxy = Proxy::all("http://gw.dataimpulse.com:823")?
        .basic_auth("login", "password");

    let client = reqwest::Client::builder()
        .proxy(proxy)
        .timeout(std::time::Duration::from_secs(30))
        .build()?;

    let body = client
        .get("https://httpbin.org/ip")
        .send()
        .await?
        .text()
        .await?;

    println!("{}", body);
    Ok(())
}login과 password를 자격 증명으로 바꾸고 필요한 네트워크에 맞게 포트를 조정하세요. 프록시가 407 상태로 요청을 거부한다면 원인은 거의 항상 자격 증명이 없거나 잘못되었기 때문입니다. HTTP 오류 407 및 프록시 인증에서 해결 방법을 다룹니다. DataImpulse는 레지덴셜 프록시, 데이터센터 프록시, 및 모바일 프록시를 HTTP, HTTPS, SOCKS5로 제공하며 로테이팅 및 스티키 세션을 지원합니다. 국가 타기팅은 포함되어 있지만 주, 도시, ZIP, ASN 타기팅은 유료 추가 옵션입니다.
JavaScript 비중이 큰 페이지는 어떻게 스크래핑하며, Rust는 언제 적절한 선택인가요?
reqwest와 scraper는 서버의 원시 HTML만 보고 스크립트를 실행하지 않으므로, 실제 헤드리스 브라우저를 구동하여 JavaScript 비중이 큰 페이지를 스크래핑합니다. 콘텐츠가 클라이언트 측 렌더링 후에만 나타난다면 WebDriver 프로토콜을 사용하는 thirtyfour 같은 브라우저 자동화 크레이트나 DevTools Protocol을 통해 Chrome을 제어하는 chromiumoxide를 사용하세요.
use thirtyfour::prelude::*;

#[tokio::main]
async fn main() -> WebDriverResult<()> {
    let caps = DesiredCapabilities::chrome();
    let driver = WebDriver::new("http://localhost:9515", caps).await?;

    driver.goto("https://example.com").await?;

    // Wait for client-side content to render, then read it
    let heading = driver.find(By::Css("h1")).await?;
    println!("{}", heading.text().await?);

    driver.quit().await?;
    Ok(())
}
thirtyfour 예제는 실행 중인 chromedriver에 연결하고, 페이지를 로드하며, 렌더링된 요소를 기다린 다음 텍스트를 읽습니다. 이 방식은 일반 HTTP 가져오기보다 훨씬 무거우므로 실제로 필요한 페이지에만 사용하고, 나머지에는 빠른 reqwest 경로를 유지하세요. 이러한 절충안을 자세히 보려면 동적 웹 페이지 스크래핑 및 JavaScript로 웹 스크래핑. 아래 표는 주요 크레이트가 어떻게 함께 사용되는지 요약합니다:
| 크레이트 | 역할 | JavaScript 실행 | 가장 적합한 용도 |
|---|---|---|---|
| reqwest | HTTP 클라이언트 | 아니요 | 원시 HTML 및 JSON API 가져오기 |
| scraper | HTML 파서 | 아니요 | CSS 선택자 데이터 추출 |
| thirtyfour | WebDriver 클라이언트 | 예 | 전체 브라우저 자동화 및 양식 |
| chromiumoxide | DevTools Protocol | 예 | 빠른 헤드리스 Chrome 제어 |
언어 선택에서는 대규모 환경에서 지속적인 성능과 낮은 리소스 사용량이 필요하다면 Rust를 선택하고, 빠른 개발과 Scrapy, Playwright 같은 더 넓은 스크래핑 생태계를 중시한다면 Python을 선택하세요. 일반적인 방식은 Python에서 추출 규칙을 프로토타입으로 만든 후 로직이 안정되고 처리량이 늘어나면 핵심 경로를 Rust로 옮기는 것입니다. 무엇을 선택하든 네트워크 계층은 파서만큼 중요하며, 윤리적으로 확보된 프록시는 대규모 작업의 신뢰성을 유지합니다.
자주 묻는 질문
웹 스크래핑에 가장 적합한 Rust 크레이트는 무엇인가요?
가장 일반적인 조합은 HTTP 요청용 reqwest와 CSS 선택자를 사용한 HTML 파싱용 scraper입니다. 비동기 동시성을 위해 tokio를, 데이터 내보내기를 위해 serde를 추가하고, 사이트에 JavaScript 렌더링이 필요할 때는 thirtyfour 또는 chromiumoxide 같은 브라우저 자동화 크레이트를 추가하세요.
Rust로 JavaScript 렌더링 페이지를 스크래핑할 수 있나요?
reqwest와 scraper만으로는 할 수 없습니다. 이들은 서버가 반환하는 원시 HTML만 볼 수 있고 스크립트를 실행할 수 없기 때문입니다. 클라이언트 렌더링 콘텐츠를 스크래핑하려면 thirtyfour 같은 WebDriver 크레이트 또는 chromiumoxide 같은 DevTools Protocol 크레이트를 통해 헤드리스 브라우저를 구동합니다.
Rust에서 스크래핑 데이터를 어떻게 내보내나요?
각 레코드를 serde의 Serialize를 파생하는 구조체로 모델링한 뒤, 해당 구조체의 슬라이스를 serde_json으로 JSON에 쓰거나 csv 크레이트로 CSV에 작성합니다. 하나의 타입 지정 모델로 추출 로직을 중복하지 않고 두 형식 모두에 데이터를 제공할 수 있습니다.
사이트에 과부하를 주지 않고 동시 요청을 실행하려면 어떻게 하나요?
URL을 비동기 스트림으로 변환하고 동시에 실행되는 요청 수를 제한하는 고정 한도의 buffer_unordered를 적용하세요. 동시 요청 10개에서 20개 정도로 시작하고, 더 높은 동시성은 로테이팅 프록시 풀과 결합해 부하를 많은 IP에 분산하세요.
Rust 웹 스크래핑에 프록시가 필요한가요?
소규모 작업에는 필요하지 않지만, 대규모 환경에서는 요청을 분산하고 지역별 콘텐츠에 도달하기 위해 프록시가 중요해집니다. reqwest::Proxy와 basic_auth로 프록시를 구성하고 로테이팅 레지덴셜 또는 모바일 IP를 사용해 속도 제한과 차단을 줄이세요.
DataImpulse가 적합하지 않은 경우는 언제인가요?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트 접근이 필요하다면 DataImpulse는 적합한 도구가 아닙니다. 이 서비스는 공개 데이터 수집과 콘텐츠 접근을 위한 로테이팅 레지덴셜, 모바일, 데이터센터 프록시에 중점을 둡니다.
윤리적인 프록시로 안정적으로 스크래핑하세요
Rust 스크래퍼가 데이터를 문제없이 가져오고 파싱하고 내보내게 되면, 신뢰할 수 있는 프록시 네트워크가 대규모 실행을 유지해 줍니다. DataImpulse는 만료되지 않는 트래픽을 포함해 GB당 1달러부터 종량제 방식의 윤리적으로 확보된 IP를 제공하므로 계정을 만들고 몇 분 안에 첫 요청을 라우팅할 수 있습니다.