
In this Article
Google Shopping을 스크래핑한다는 것은 Google 쇼핑 검색결과에서 상품 데이터(제목, 가격, 판매자, 평점, 배송 안내)를 구조화해 대규모로 수집하는 일입니다. 이 결과는 강하게 보호되고 지역화되어 있으므로, 안정적으로 수집하려면 하나의 연결에서 하나의 스크래퍼를 사용하는 대신 로테이팅 IP와 정확한 지역 타기팅이 필요합니다.
이 가이드는 코드 중심으로 구성했습니다. 지역 타기팅 요청, 국가별 프록시를 통한 라우팅, Google이 의도적으로 난독화하는 상품 카드 파싱, 페이지네이션, 속도 제한 시 재시도와 백오프, 동의 대화상자 처리를 갖춘 헤드리스 브라우저 대체 경로, CSV 내보내기가 가능한 깔끔한 데이터 모델, 가격 이력 추적기, 모니터링 일정을 다룹니다. 또한 안티봇 환경의 현실, 직접 만드는 스크래퍼와 유료 SERP API의 절충점, 법적 경계도 솔직하게 설명합니다.
DataImpulse는 195개국에서 9,000만 개가 넘는 레지덴셜 프록시(residential proxy), 모바일 프록시, 데이터센터 프록시 IP 주소를 제공하는 윤리적 프록시 제공업체입니다. 만료되지 않는 트래픽을 포함해 GB당 1달러부터 사용하는 종량제 모델을 적용하며, 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사, 다중 계정 관리에 활용됩니다.
핵심 정보
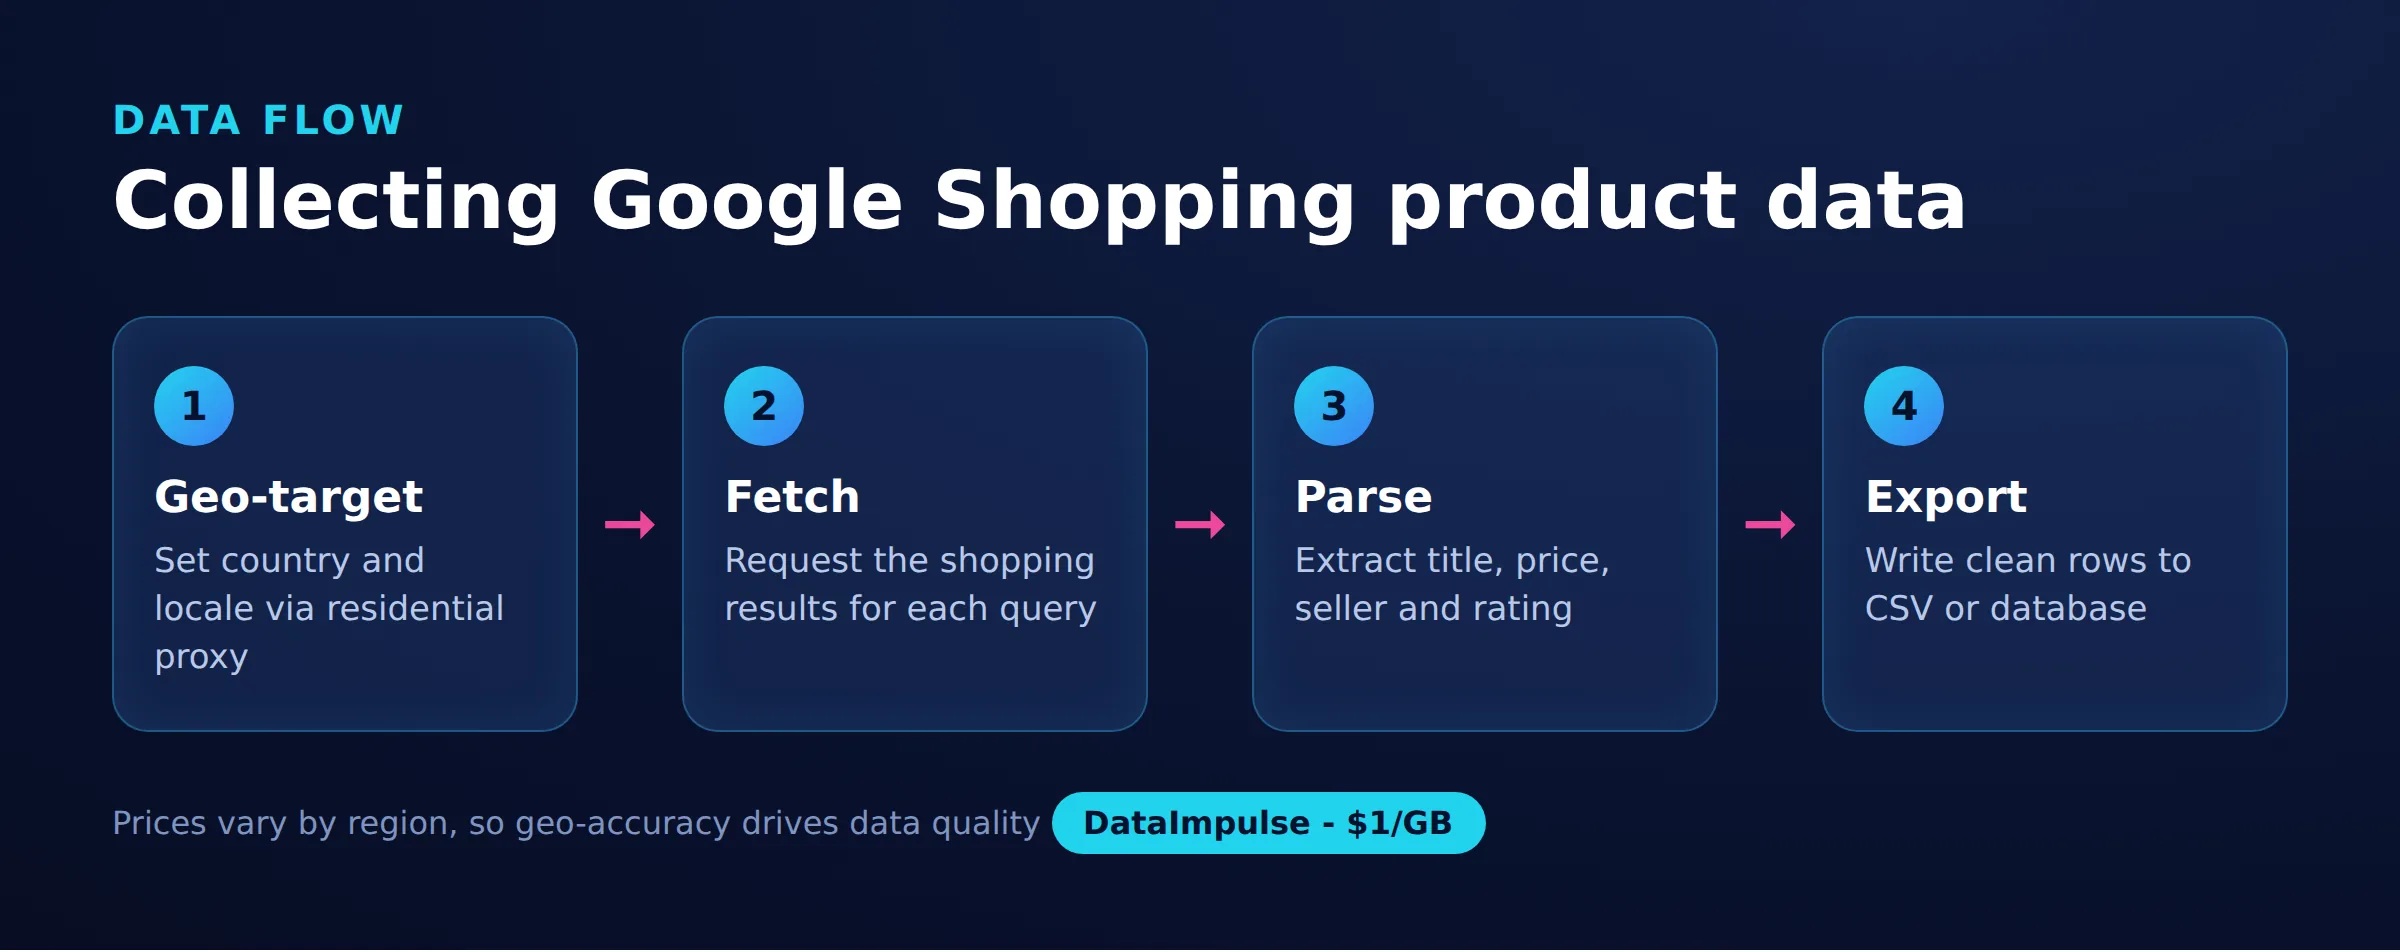
- 지역별 가격: Google Shopping을 정확하게 스크래핑하려면 지역마다 가격, 판매자, 재고 여부가 다르므로 gl 및 hl 매개변수를 설정하고 대상 국가의 IP를 통해 요청을 라우팅해야 합니다.
- 가장 적합한 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시입니다.
- 가격: GB당 1달러부터, 구독 없이 만료되지 않는 트래픽을 제공하는 종량제입니다.
- 커버리지: 195개국에서 윤리적으로 조달한 9,000만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2에서 5점 만점에 4.8점입니다.
- 프로토콜 및 타기팅: 국가 타기팅이 포함된 HTTP, HTTPS, SOCKS5입니다.
Google Shopping에서 어떤 데이터를 스크래핑할 수 있나요?
Google Shopping은 가격 책정과 시장 조사에 유용한 여러 구조화 필드를 가진 상품 목록을 제공합니다. 각 결과에는 일반적으로 추출하여 행으로 정규화할 수 있는 일관된 속성 집합이 포함됩니다.
- 상품 세부 정보: 제목, 설명 발췌문, 브랜드, 모델, 상품 이미지 URL입니다.
- 가격: 표시된 가격, 통화, 그리고 경우에 따라 판매자별 가격 범위입니다.
- 판매자: 판매자 이름 및 상품 상세 페이지에서 동일한 상품을 제공하는 경쟁 판매자 목록입니다.
- 평점 및 리뷰: 제공되는 경우 종합 별점과 리뷰 수입니다.
- 재고 및 배송: 지역에 따라 달라지는 재고 상태와 배송 안내입니다.
Google이 레이아웃을 업데이트할 때마다 정확한 필드가 바뀌므로 모든 파서는 누락된 값과 변경되는 마크업을 허용해야 합니다. 평점이나 판매자가 항상 있다고 가정하지 말고 모든 필드를 선택 사항으로 취급하며, 추출 후에 유형을 검증하세요. 동일 상품도 국가별로 다른 가격에 표시될 수 있으므로, 나중에 지역 정보를 덧붙이지 말고 처음부터 (상품, 국가, 타임스탬프) 키를 중심으로 스키마를 설계하세요.
Google Shopping에 지역 타기팅 요청을 보내는 방법은 무엇인가요?
쇼핑 탭 플래그와 로캘 매개변수를 포함해 Google 검색 엔드포인트를 호출하면 실제 쇼핑객이 보내는 것과 같은 IP 및 매개변수 신호를 사용하여 지역 타기팅 요청을 보낼 수 있습니다. 가장 중요한 두 매개변수는 gl(국가, 예: gl=de는 독일) 및 hl(인터페이스 언어, 예: hl=de)입니다. 세 번째로 유용한 것은 location 스타일의 용어를 쿼리 문맥에 넣는 것이지만, gl와 일치하는 출구 IP가 대부분의 역할을 합니다.
매개변수만 설정해서는 충분하지 않습니다. Google은 어떤 가격과 판매자를 표시할지 결정하기 위해 요청 IP도 읽기 때문입니다. 아래의 최소 요청은 현실적인 헤더와 로캘 쌍을 보냅니다. IP 계층을 추가하기 전의 기본 호출을 볼 수 있도록 의도적으로 프록시를 사용하지 않았습니다.
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
Accept-Language 헤더를 hl와 일치하게 유지하세요. 영어 언어 헤더로 독일 가격 페이지를 요청하면 부자연스러워 보일 뿐 아니라 잘못된 통화를 반환할 수 있습니다. 규모를 확장할 때 이 기본 함수는 로캘을 결정하는 단일 지점이 되어 모든 후속 호출의 일관성을 유지합니다.
국가 타기팅 프록시를 통해 요청을 라우팅하는 방법은 무엇인가요?
국가 타기팅 프록시를 통해 요청을 라우팅하려면 requests를 단일 게이트웨이에 지정하고 프록시 사용자 이름에 대상 국가를 인코딩하면 국가 타기팅 프록시를 통해 라우팅할 수 있습니다. DataImpulse의 게이트웨이는 gw.dataimpulse.com:823이며, 사용자 이름에 __cr.us 또는 __cr.de를 추가하면 출구 국가가 선택됩니다. 국가 타기팅은 기본 가격에 포함되며, 주, 도시, ZIP, ASN 타기팅은 유료 추가 기능입니다. 프록시 인증이 처음이라면 프록시 인증에서 사용자 이름과 비밀번호 작동 방식을 자세히 다룹니다.
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
중요한 원칙은 프록시 국가와 gl/hl 쌍을 함께 전환하는 것입니다. 시장 간 가격 비교를 구축하려면 국가 목록을 반복하면서 출구 IP와 로캘을 동시에 맞춰 모든 응답이 하나의 일관된 쇼핑객 위치를 반영하게 하세요.
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse는 관리형 스크래핑 서비스가 아니라 IP 계층을 제공하므로 스크래퍼 자체는 사용자가 관리합니다. 로테이팅 레지덴셜 프록시는 실제 소비자 기기에서 제공되므로 일반적으로 적합합니다. 데이터센터 프록시는 더 저렴하지만 플래그가 지정되기 쉽고, 모바일 프록시는 가장 어려운 대상에 통신사급 IP를 제공합니다.
Google Shopping 상품 카드를 파싱하는 방법은 무엇인가요?
Google의 클래스 이름은 난독화되어 자주 바뀌므로, 취약한 깊은 선택자 대신 안정적인 텍스트 패턴을 기준으로 관대한 HTML 라이브러리로 상품 카드를 파싱하세요. 오늘 브라우저 개발자 도구에서 복사한 선택자는 몇 주 안에 깨질 수 있으므로, 레이아웃 변경 시 중단되지 않고 유연하게 성능을 낮추도록 파서를 만드세요.
견고한 접근법은 각 후보 카드를 읽고 태그 구조에서 제목과 이미지를 가져오며 통화를 인식하는 정규 표현식으로 가격을 추출합니다. 아래 선택자는 현실적인 예시일 뿐 보장은 아니므로, 업데이트가 필요하다고 예상하고 정규 표현식을 신뢰할 수 있는 대체 수단으로 유지하세요.
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
여기서는 난독화된 마크업이 일반적이므로 일부 팀은 대신 렌더링된 DOM을 사용합니다. 정적 HTML 파싱과 렌더링된 페이지 간의 더 폭넓은 절충점은 동적 웹 페이지 스크래핑.를 참조하세요.
Google이 429를 반환할 때 페이지네이션과 백오프는 어떻게 하나요?
페이지 크기에 맞는 단계로 start 오프셋을 진행해 페이지네이션하고, HTTP 429(및 비어 있거나 CAPTCHA인 응답)를 대기 후 새 IP로 재시도하라는 신호로 처리하여 속도 제한을 견뎌냅니다. Google은 반복 자동 요청을 적극적으로 제한하므로 페이지네이션과 백오프는 같은 루프에 있어야 합니다.
요청이 카드를 반환하지 않거나 페이지 한도에 도달할 때까지 페이지를 순회하세요. 프록시 dict를 다시 읽어 페이지 사이에서 출구 IP를 로테이팅하고, 상태 코드만 신뢰하지 말고 본문에서 동의 또는 CAPTCHA 표식을 확인해 소프트 차단을 감지하세요.
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
아래 재시도 도우미는 지터를 포함한 지수 백오프를 사용해 차단된 워커가 한순간에 모두 재시도하지 않도록 재시도를 분산합니다. 매 시도마다 프록시 dict를 다시 가져오므로 로테이팅 풀은 다음 시도에 새 IP를 제공합니다.
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
재시도에 성공해도 요청률을 합리적으로 유지하세요. 로테이션과 결합한 페이지 간의 정중한 기본 지연은 무리하게 요청하고 재시도에 의존하는 것보다 장기 안정성에 더 도움이 됩니다. 웹 스크래핑 모범 사례에서 페이싱과 헤더 위생을 더 자세히 다룹니다.
헤드리스 브라우저로 차단된 페이지를 렌더링하는 방법은 무엇인가요?
일반 HTTP 요청이 계속 동의 화면이나 JavaScript로 렌더링된 콘텐츠에 막히면 실제 클라이언트처럼 페이지를 실행하는 헤드리스 브라우저로 전환하고 DOM을 읽기 전에 동의 대화상자를 닫으세요. Playwright는 컨텍스트별 프록시와 안정적인 대기를 지원하므로 적합합니다.
아래 스크립트는 국가 타기팅 DataImpulse 프록시를 통해 Chromium을 실행하고, 유럽 로캘에서 보통 표시되는 쿠키 또는 동의 대화상자를 처리하며, 콘텐츠를 기다린 다음 렌더링된 HTML을 반환하여 동일한 parse_cards 함수에 전달할 수 있게 합니다.
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
헤드리스 브라우저는 원시 요청보다 CPU와 메모리를 더 사용하므로 기본 경로가 아니라 실제로 렌더링이 필요한 페이지를 위한 타기팅된 대체 수단으로 사용하세요. 많은 팀은 속도를 위해 직접 HTTP를 사용하고 is_blocked가 계속 발생할 때만 Playwright로 전환합니다. 스택이 Python이 아닌 JavaScript라면 Puppeteer에도 같은 패턴이 적용됩니다. JavaScript로 웹 스크래핑하기.를 참조하세요.
스크래핑한 데이터를 구조화하고 내보내는 방법은 무엇인가요?
항상 시장과 수집 타임스탬프를 포함하는 안정적인 레코드를 중심으로 데이터를 구조화한 뒤 CSV로 내보내면, 결과를 비교하거나 스프레드시트에 불러오고 웨어하우스에 적재하기 쉽습니다. dataclass는 유형 힌트와 행의 명확한 정의 하나를 제공합니다.
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
이후 CSV 작성은 dataclass 필드를 덤프하는 일입니다. 추가 모드와 헤더 가드를 사용하면 예약 작업이 파일을 다시 쓰지 않고도 시간이 지나며 하나의 파일을 확장할 수 있습니다.
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
모든 행에 국가와 타임스탬프를 유지해야 나중에 오늘 SKU가 가장 저렴한 시장이나 이번 주 가격 변동 같은 질문에 답할 수 있습니다. 이 지역 및 시간 키는 다음 섹션의 가격 이력 추적기 기반입니다.
시간에 따라 Google Shopping 가격 이력을 추적하는 방법은 무엇인가요?
상품, 국가, 날짜를 키로 하는 작은 데이터베이스에 각 관측값을 업서트하여 가격 이력을 추적합니다. 그러면 스크래퍼를 다시 실행해도 이전 날짜는 보존하면서 오늘 행을 복제하지 않고 업데이트합니다. SQLite는 수백만 행에도 충분하고 서버가 필요 없어 모니터링 작업을 독립적으로 유지합니다.
아래 스키마는 복합 고유 키와 ON CONFLICT 업서트를 사용합니다. 하루에 스크래퍼를 두 번 실행하면 해당 (상품, 국가, 날짜)의 최신 가격을 덮어쓰고, 여러 날 실행하면 나중에 차트로 만들 수 있는 시계열이 구축됩니다.
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
실무에서 어려운 부분은 날짜별 제목 매칭입니다. Google 제목은 수집 시점마다 조금씩 달라지기 때문입니다. 소규모 관찰 목록에서는 스크래핑한 제목을 안정적인 키로 신뢰하지 말고 업서트 전에 원시 제목을 사용자가 관리하는 표준 상품 id에 매핑하세요.
지속적인 가격 모니터링 일정을 잡는 방법은 무엇인가요?
가져오기, 파싱, 저장 단계를 하나의 진입점으로 묶어 cron으로 고정 주기에 실행하면 수동 실행 없이 가격이 자동으로 갱신됩니다. 하루 한 번 실행은 가격 추적에 적절한 기본값이며, 대부분의 카탈로그에서는 더 자주 실행해도 추가 신호는 크지 않은 반면 비용과 차단 위험이 모두 높아집니다.
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
그런 다음 cron에 등록하세요. 아래 항목은 매일 06:15에 모니터를 실행하고 디버깅을 위해 출력을 기록합니다. 예약된 스크래퍼는 그렇지 않으면 조용히 실패할 수 있으므로 중요합니다.
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
요청이 매일 정확히 같은 시각에 Google에 도달하지 않도록 작업 내부에 가벼운 지터(시작 시 몇 분의 무작위 대기)를 추가하세요. 앞서 설명한 대로 출구 국가를 로테이팅하고 요청 속도를 조절하며, 차단 비율이 상승하는지 로그를 살피세요. 이는 Google이 방어 수단을 바꾸었거나 패턴이 지나치게 규칙적이 되었다는 가장 이른 신호입니다.
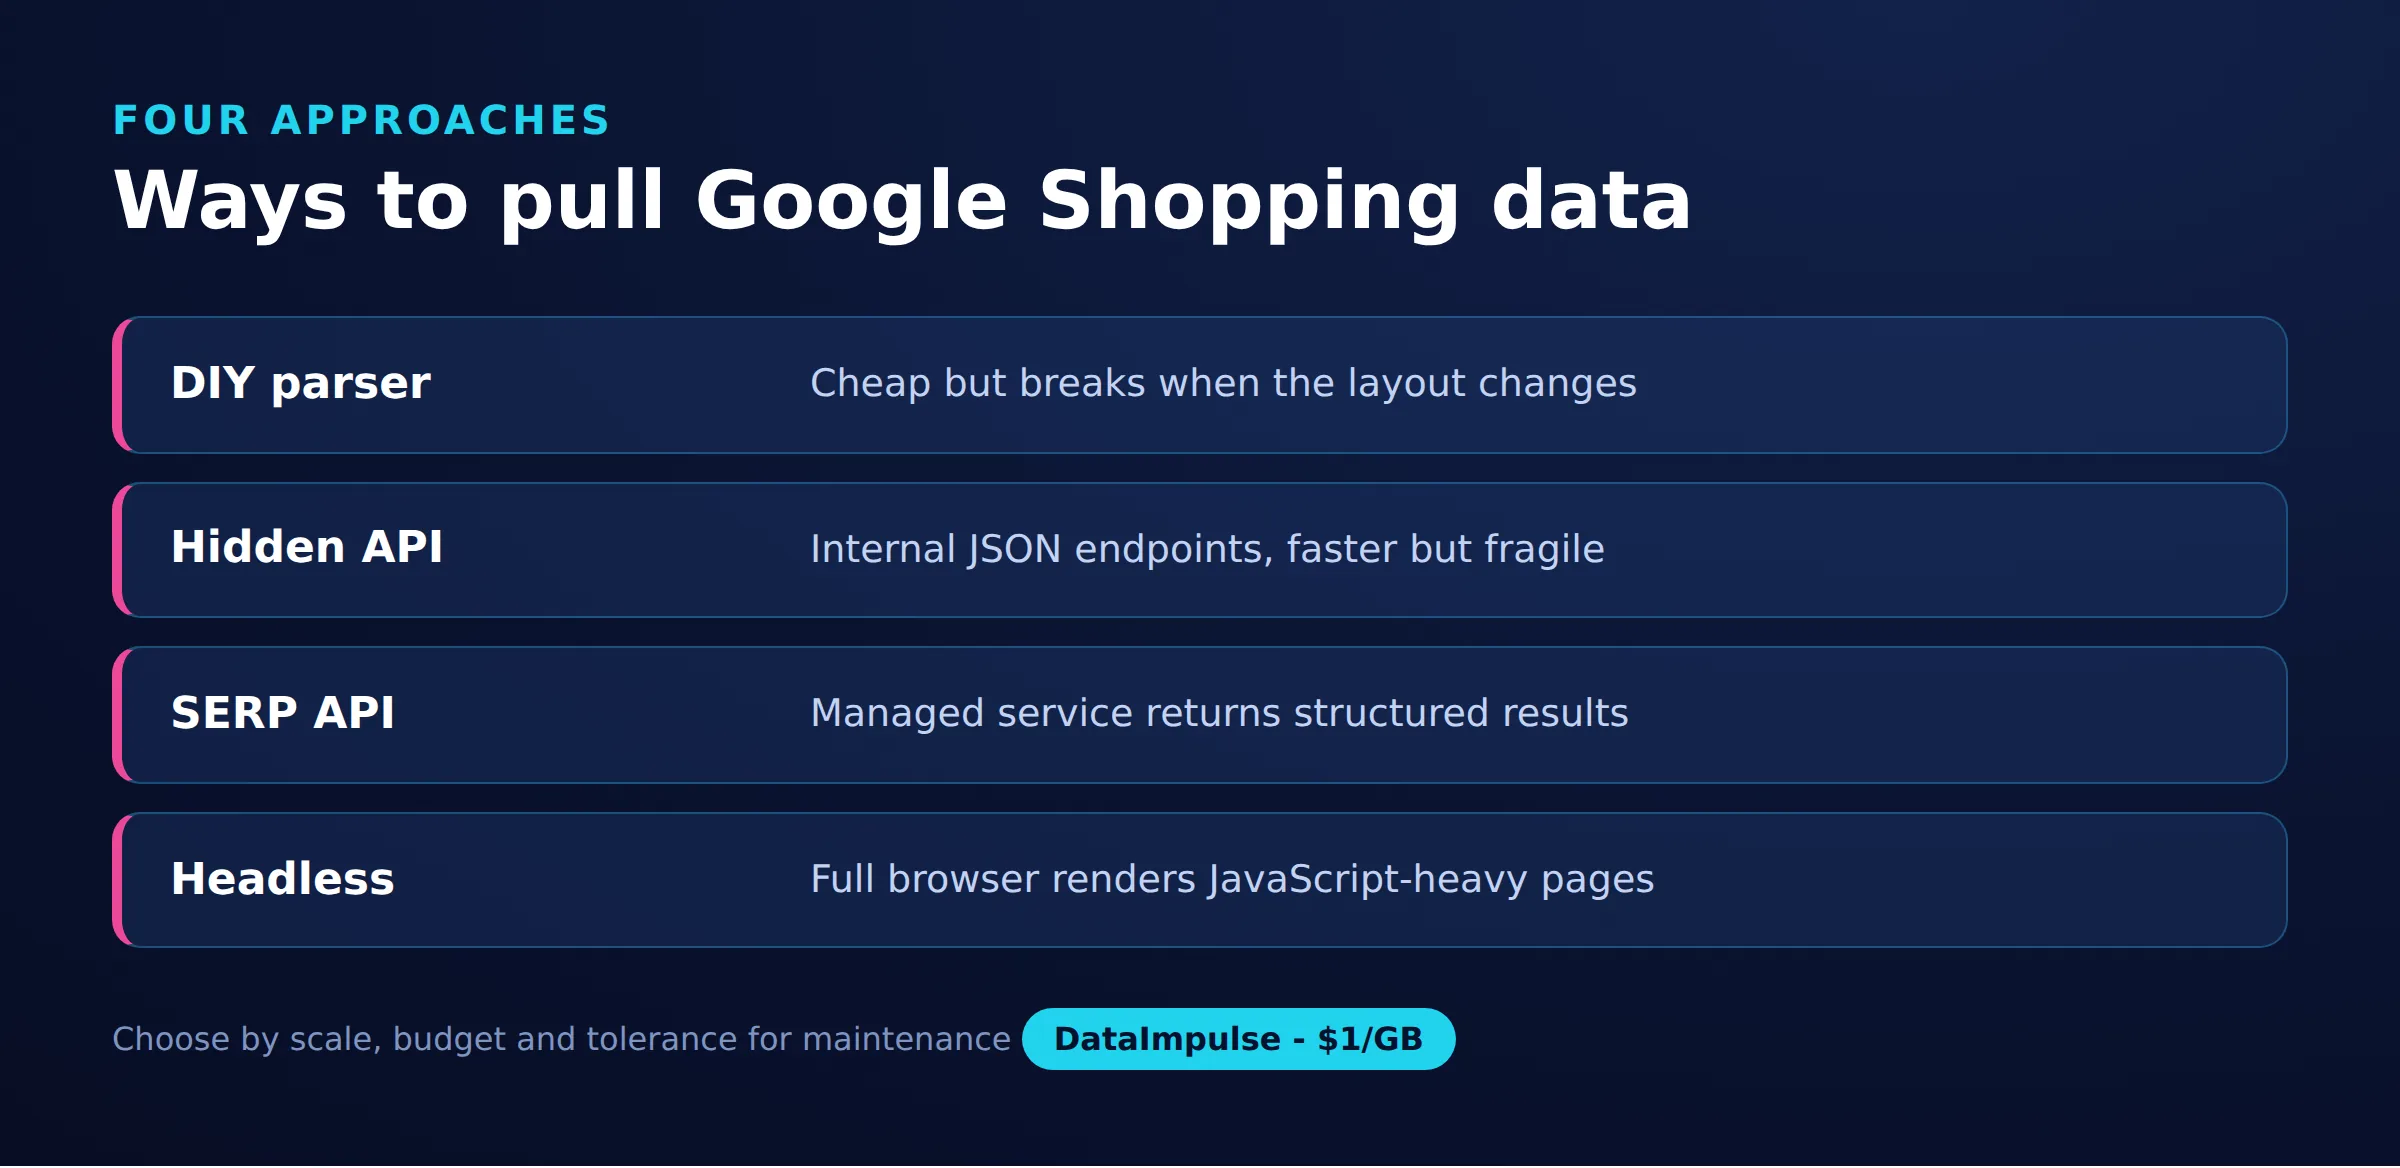
어떤 수집 방식을 선택해야 하나요: DIY, 숨겨진 엔드포인트, SERP API, 헤드리스?
감수할 취약성과 엔지니어링 부담, 그리고 요청당 지불할 비용을 기준으로 선택하세요. 하나의 정답은 없으며, 정직한 절충점은 제어권과 비용, 유지 관리 부담과 안티봇 노출 사이에 있습니다.
안티봇 환경의 현실: Google은 속도 제한, CAPTCHA, 동의 화면, 로테이팅되는 난독화 마크업, 행동 신호로 이러한 결과를 적극 방어합니다. 직접 만든 모든 스크래퍼는 주기적으로 작동이 중단되며 지속적인 유지 관리가 필요합니다. 프록시와 백오프는 차단을 줄이지만 없애지는 못합니다. 영구적으로 차단되지 않는 Google 스크래퍼를 약속하는 사람은 과장하고 있습니다.
| 접근 방식 | 비용 | 취약성 | 제어 |
|---|---|---|---|
| 직접 HTML 파싱 | 낮음(프록시만) | 높음 | 전체 |
| 숨겨진 JSON 엔드포인트 | 낮음(프록시만) | 매우 높음 | 전체 |
| SERP API | 높음(요청당) | 낮음 | 제한적 |
| 헤드리스 브라우저 | 중간(컴퓨팅 + 프록시) | 중간 | 전체 |
SERP API와 DIY 비교: 타사 SERP API는 파싱된 쇼핑 결과를 JSON으로 반환하고 요청당 비용을 받으며, 공급업체 종속과 정확히 무엇을 가져올지에 대한 더 적은 제어권을 감수하는 대신 파싱과 차단 해제 작업을 대신합니다. 프록시에서 직접 만드는 스크래퍼는 요청당 비용이 훨씬 적고 완전한 제어권을 주지만, Google이 변경될 때 파서, 재시도, 유지 관리는 사용자가 맡습니다. DataImpulse의 위치를 명확히 하면, 이는 이러한 DIY 접근 방식 아래의 프록시 계층이지 SERP API나 관리형 스크래핑 서비스가 아닙니다. 파싱 작업을 전혀 원하지 않는다면 SERP API가 정직한 권장 사항입니다. 저비용과 제어권을 원하고 스크래퍼를 유지 관리할 수 있다면 로테이팅 프록시의 DIY가 더 나은 경제성입니다. 숨겨진 JSON 엔드포인트는 더 저렴할 수 있지만 Google이 통지 없이 변경하거나 제거할 수 있어 가장 취약합니다.
Google Shopping 스크래핑은 합법적이고 윤리적인가요?
공개적으로 보이는 상품 데이터를 스크래핑하는 것은 일반적으로 비공개 또는 접근 제한 콘텐츠에 접근하는 것보다 위험이 낮게 취급되지만, 규칙이 없는 것은 아니며 이는 법률 자문이 아닙니다. Google Shopping의 가격과 목록은 공개되어 있지만 수집 및 사용 방식은 여전히 중요하므로, 구체적인 상황은 자격을 갖춘 법률 자문가에게 확인해야 합니다.
- 서비스 약관: 자동 접근은 Google 약관과 충돌할 수 있으며, 이는 저작권 또는 컴퓨터 접근 법률과 별개의 계약상 문제입니다.
- 개인 데이터: 상품 목록은 보통 개인 데이터가 아니지만, 리뷰어 이름이나 다른 식별자 수집은 피하고 적용되는 경우 GDPR을 따르세요.
- 요청률 및 부하: 조회하는 서비스의 품질을 저하시키지 않도록 요청량을 합리적으로 유지하세요.
- 데이터 사용: 저작권 있는 이미지나 설명을 통째로 재사용하는 것은 가격을 사실로 분석하는 것보다 위험이 큽니다.
수집 측면에서 윤리는 사용하는 IP에서 시작됩니다. DataImpulse는 참여에 동의하고 보상을 받는 사용자로부터 IP를 조달하며, GDPR에 부합하고 데이터 처리 계약을 제공하므로 방어 가능한 파이프라인을 지원합니다. 동의, 조달, 책임 있는 관행을 더 자세히 알아보려면 윤리적 웹 스크래핑를 참조하세요. 윤리적 IP 소스에 정중한 페이싱과 좁고 사실적인 데이터 사용을 결합하면 법적 위험과 평판 위험을 모두 낮게 유지할 수 있습니다.
자주 묻는 질문
Google Shopping을 스크래핑하려면 레지덴셜 프록시가 필요한가요?
레지덴셜 프록시는 일반 트래픽에 자연스럽게 섞이는 실제 소비자 IP를 사용하므로 가장 신뢰할 수 있는 선택입니다. 데이터센터 프록시는 적은 볼륨에는 사용할 수 있지만 탐지되고 차단되기 더 쉽습니다.
Google Shopping에서 지역별 가격을 얻는 방법은 무엇인가요?
gl 및 hl 매개변수를 대상 국가와 언어로 설정하고, 예를 들어 독일의 경우 __cr.de로 끝나는 사용자 이름처럼 국가 문법을 사용하여 해당 국가의 프록시 IP를 통해 요청을 라우팅하세요. Google은 어떤 가격을 표시할지 결정하기 위해 매개변수와 요청 IP를 모두 읽습니다.
DataImpulse는 Google Shopping 스크래핑 API인가요?
아니요. DataImpulse는 관리형 스크래핑 또는 SERP API가 아니라 프록시 계층(레지덴셜, 모바일, 데이터센터 IP)을 제공합니다. 자체 스크래퍼나 타사 도구를 해당 IP 위에서 실행합니다.
Google Shopping 스크래퍼가 계속 차단되는 이유는 무엇인가요?
Google은 단일 IP에서 반복되는 자동 요청을 제한하고 CAPTCHA 및 동의 화면을 표시합니다. 로테이팅 레지덴셜 프록시, 현실적인 헤더, 429 응답에 대한 지수 백오프, 합리적인 요청률은 차단을 크게 줄이지만 어떤 방법도 이를 완전히 없애지는 못합니다.
SERP API를 사용해야 하나요, 직접 스크래퍼를 만들어야 하나요?
SERP API는 요청당 비용이 더 높고 제어 범위가 작지만 파싱 및 차단 해제 작업을 없애므로 유지 관리를 원하지 않는 팀에 적합합니다. 로테이팅 프록시의 직접 구축 스크래퍼는 비용이 훨씬 적고 완전한 제어권을 제공하지만 Google 변경에 따라 파서와 재시도를 유지 관리해야 합니다.
DataImpulse가 적합하지 않은 경우는 언제인가요?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트 접근이 필요하다면 DataImpulse는 적합한 도구가 아닙니다. 공개 데이터 수집과 콘텐츠 접근을 위한 로테이팅 레지덴셜, 모바일, 데이터센터 프록시에 중점을 둡니다.
신뢰할 수 있는 프록시로 Google Shopping 스크래핑 시작하기
여러 시장에서 Google Shopping 데이터를 수집할 준비가 되었다면 DataImpulse는 국가 타기팅이 포함된 로테이팅 및 스티키 세션 레지덴셜, 모바일, 데이터센터 IP를 GB당 1달러부터 제공합니다. 계정 만들기 그리고 정상 작동하는 IP 풀을 통해 첫 번째 스크래퍼를 라우팅하세요.