
In this Article
Blokada IP to mechanizm bezpieczeństwa, który decyduje, czy żądanie jest dozwolone na podstawie miejsca, z którego pochodzi, i działa w tle większości współczesnych stron internetowych. W tym artykule wyjaśniamy, czym jest blokada IP, dlaczego strony ją wdrażają i jakich dokładnie mechanizmów używają do identyfikowania ruchu przeznaczonego do zablokowania.
Omawiamy też drugą stronę problemu: dlaczego uzasadnione zespoły zbierające dane publiczne czasem napotykają takie blokady i jak działać zgodnie z zasadami, zamiast je obchodzić.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Definicja: Blokada IP to dowolny mechanizm kontroli (reguła zapory, polityka WAF lub ogranicznik szybkości), który odrzuca ruch na podstawie źródłowego adresu IP, jego zakresu sieciowego lub reputacji.
- Najlepszy typ proxy: rotacyjne residential proxies, które korzystają z rzeczywistych konsumenckich adresów IP i omijają wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu ważności i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych adresów IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4.8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5 z uwzględnionym targetowaniem według kraju.
Czym jest blokada IP?
Blokada IP to dowolny mechanizm kontroli, który dopuszcza lub odrzuca ruch sieciowy na podstawie źródłowego adresu IP żądania. To nie pojedynczy produkt, lecz raczej kategoria nakładających się zabezpieczeń, które operator strony stosuje łącznie.
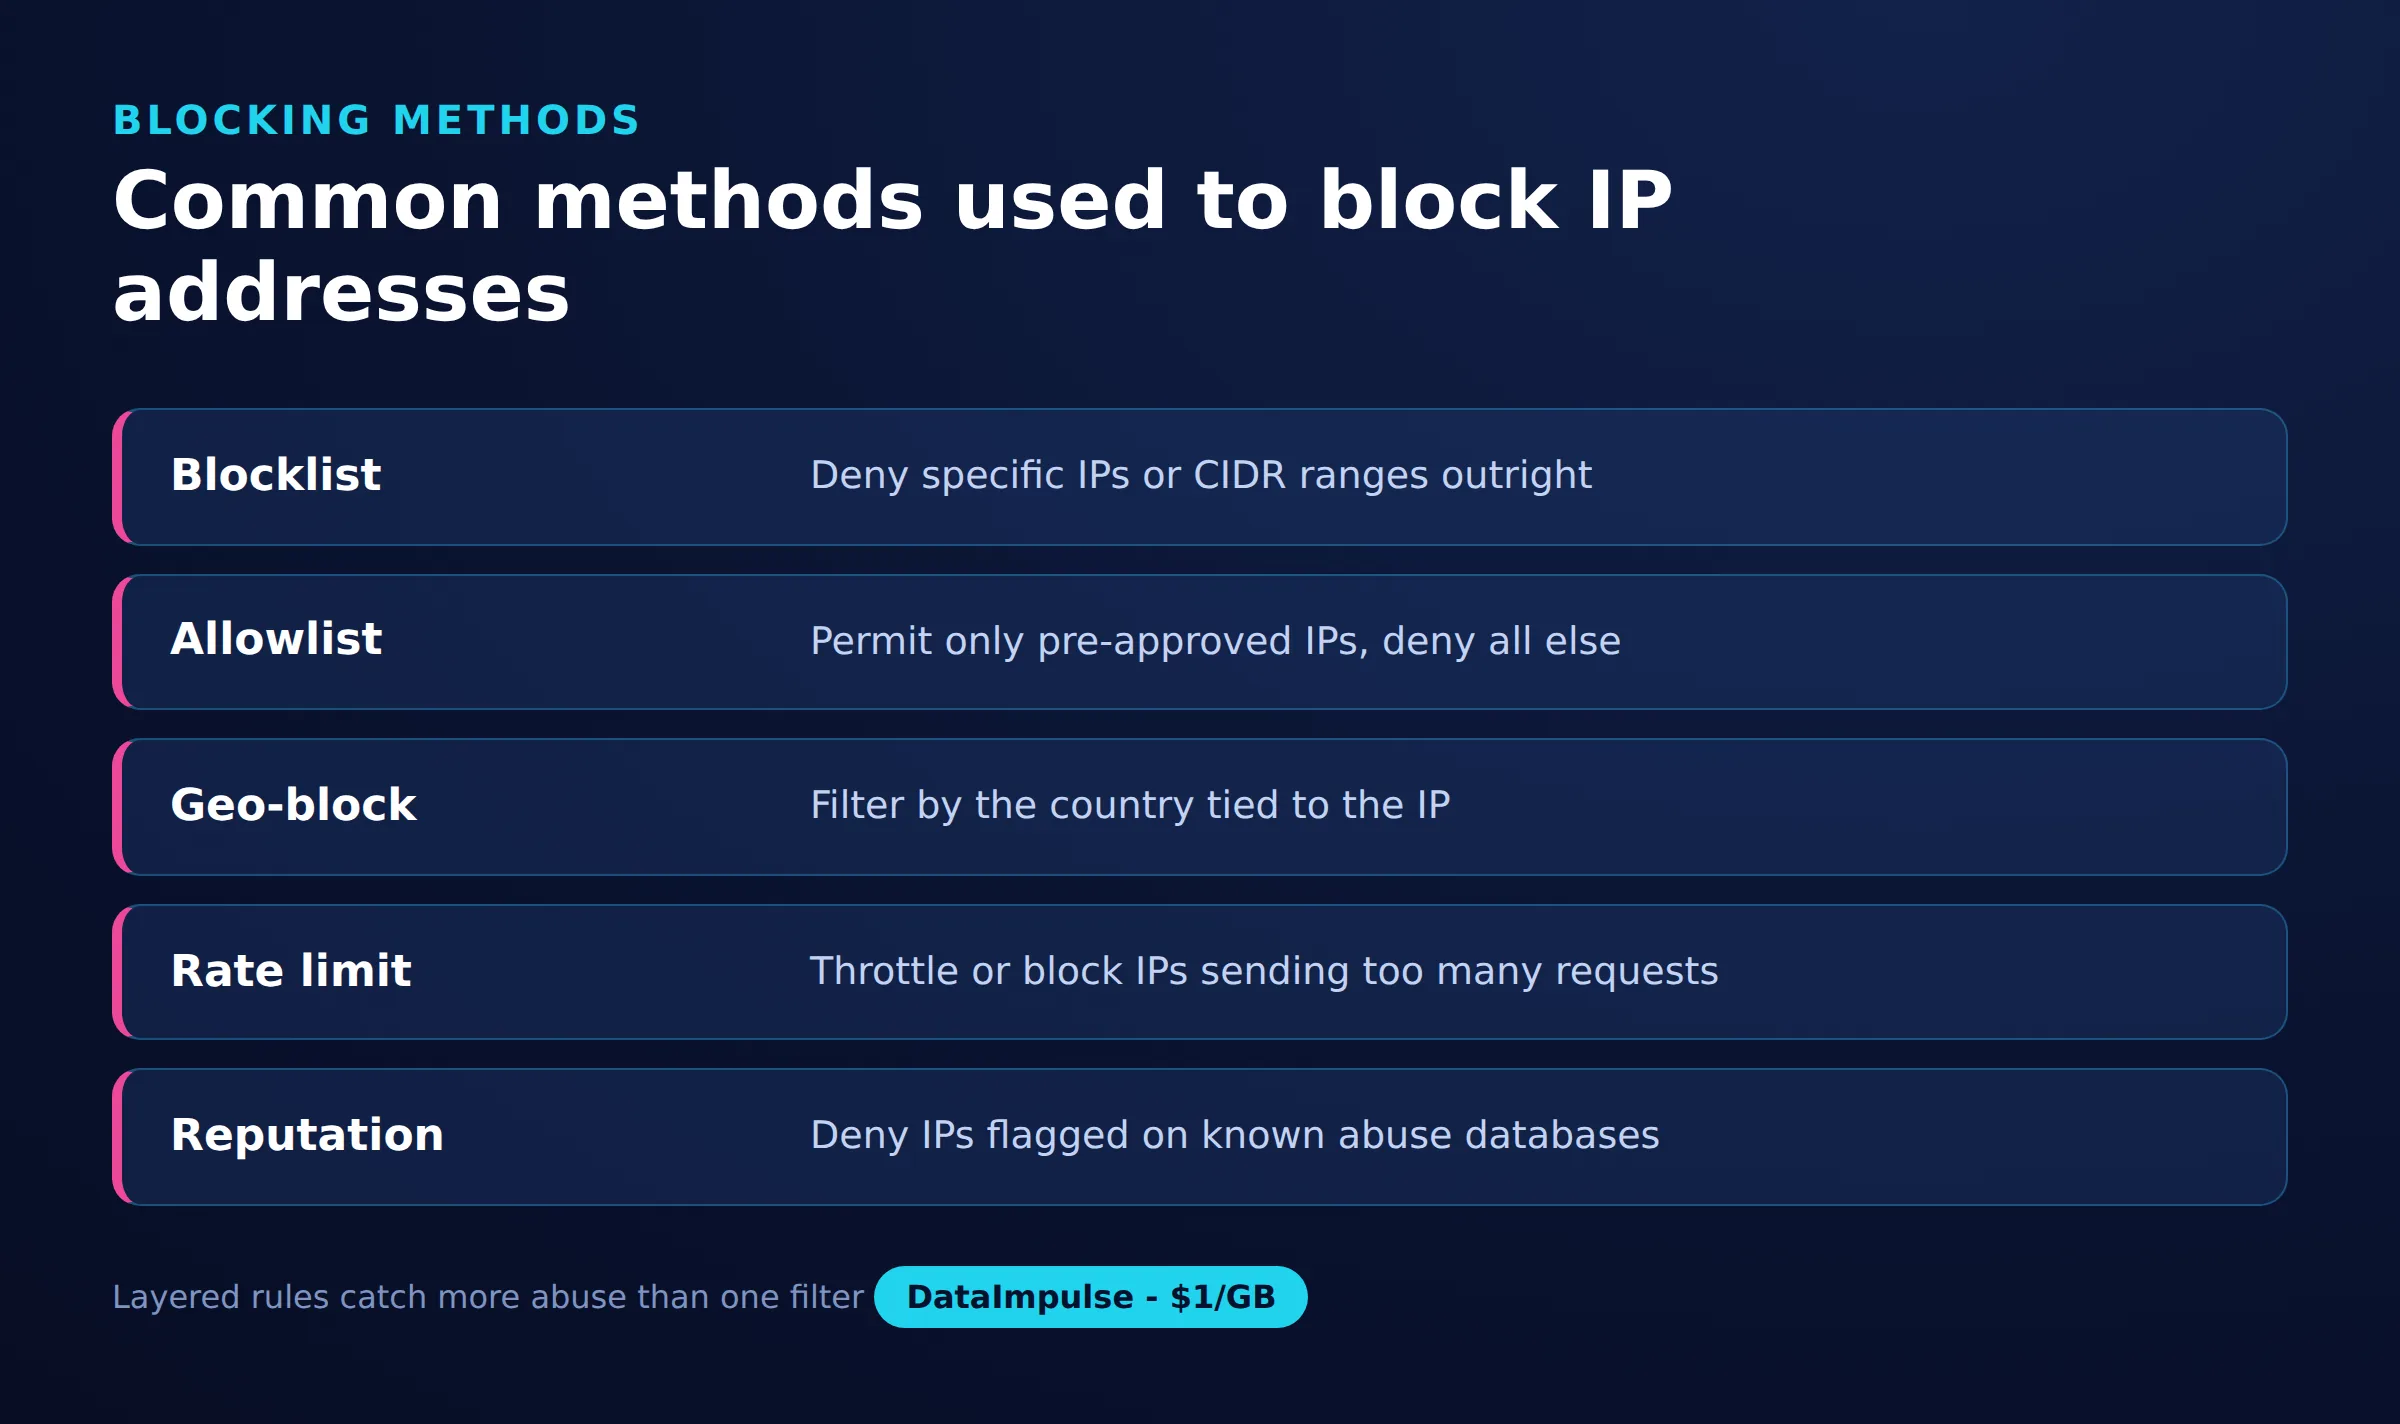
Do najczęstszych elementów należą:
- Zapory sieciowe: reguły warstwy sieciowej (na przykład iptables lub nftables), które odrzucają pakiety z określonych adresów lub zakresów, zanim zobaczy je aplikacja.
- Zapory aplikacji internetowych (WAF): filtry warstwy aplikacji, takie jak w CDN, które analizują żądania HTTP i blokują je według IP, nagłówka lub wzorca.
- fail2ban i podobne narzędzia: narzędzia monitorujące logi, które dodają IP do tymczasowej listy blokad po wielokrotnych nieudanych logowaniach lub podejrzanych żądaniach.
- Ograniczniki szybkości: liczniki odrzucające adres po przekroczeniu progu żądań w określonym oknie czasowym.
- Blokady geograficzne: reguły zezwalające lub odrzucające całe kraje, często z powodów licencyjnych lub zgodności z wymaganiami.
- Listy blokad i źródła reputacji: zewnętrzne listy znanych adresów nadużywanych lub wysokiego ryzyka, które subskrybuje dana strona.
Dlaczego strony internetowe używają blokad IP?
Strony internetowe używają blokad IP, aby ograniczać nadużycia, chronić infrastrukturę i spełniać zobowiązania prawne lub umowne. Motywacja jest niemal zawsze obronna, a nie arbitralna.
Typowe przyczyny obejmują:
- Nadużycia i ataki: powstrzymywanie credential stuffing, spamu i ruchu powodującego odmowę usługi, który w przeciwnym razie pogarszałby działanie usługi dla rzeczywistych użytkowników.
- Zarządzanie botami: filtrowanie zautomatyzowanego ruchu, który agresywnie prowadzi web scraping, gromadzi zapasy lub zniekształca analitykę.
- Licencjonowanie i geografia: ograniczanie treści do regionów, w których operator ma prawa do ich udostępniania.
- Zgodność z wymaganiami: blokowanie objętych sankcjami regionów lub spełnianie wymogów dotyczących przetwarzania danych.
W rezultacie pojedynczy problematyczny adres lub cały zakres powiązany z nadużyciami zostaje odrzucony, aby pozostała część odbiorców nie odczuła skutków.
Jak blokada IP decyduje, co zablokować?
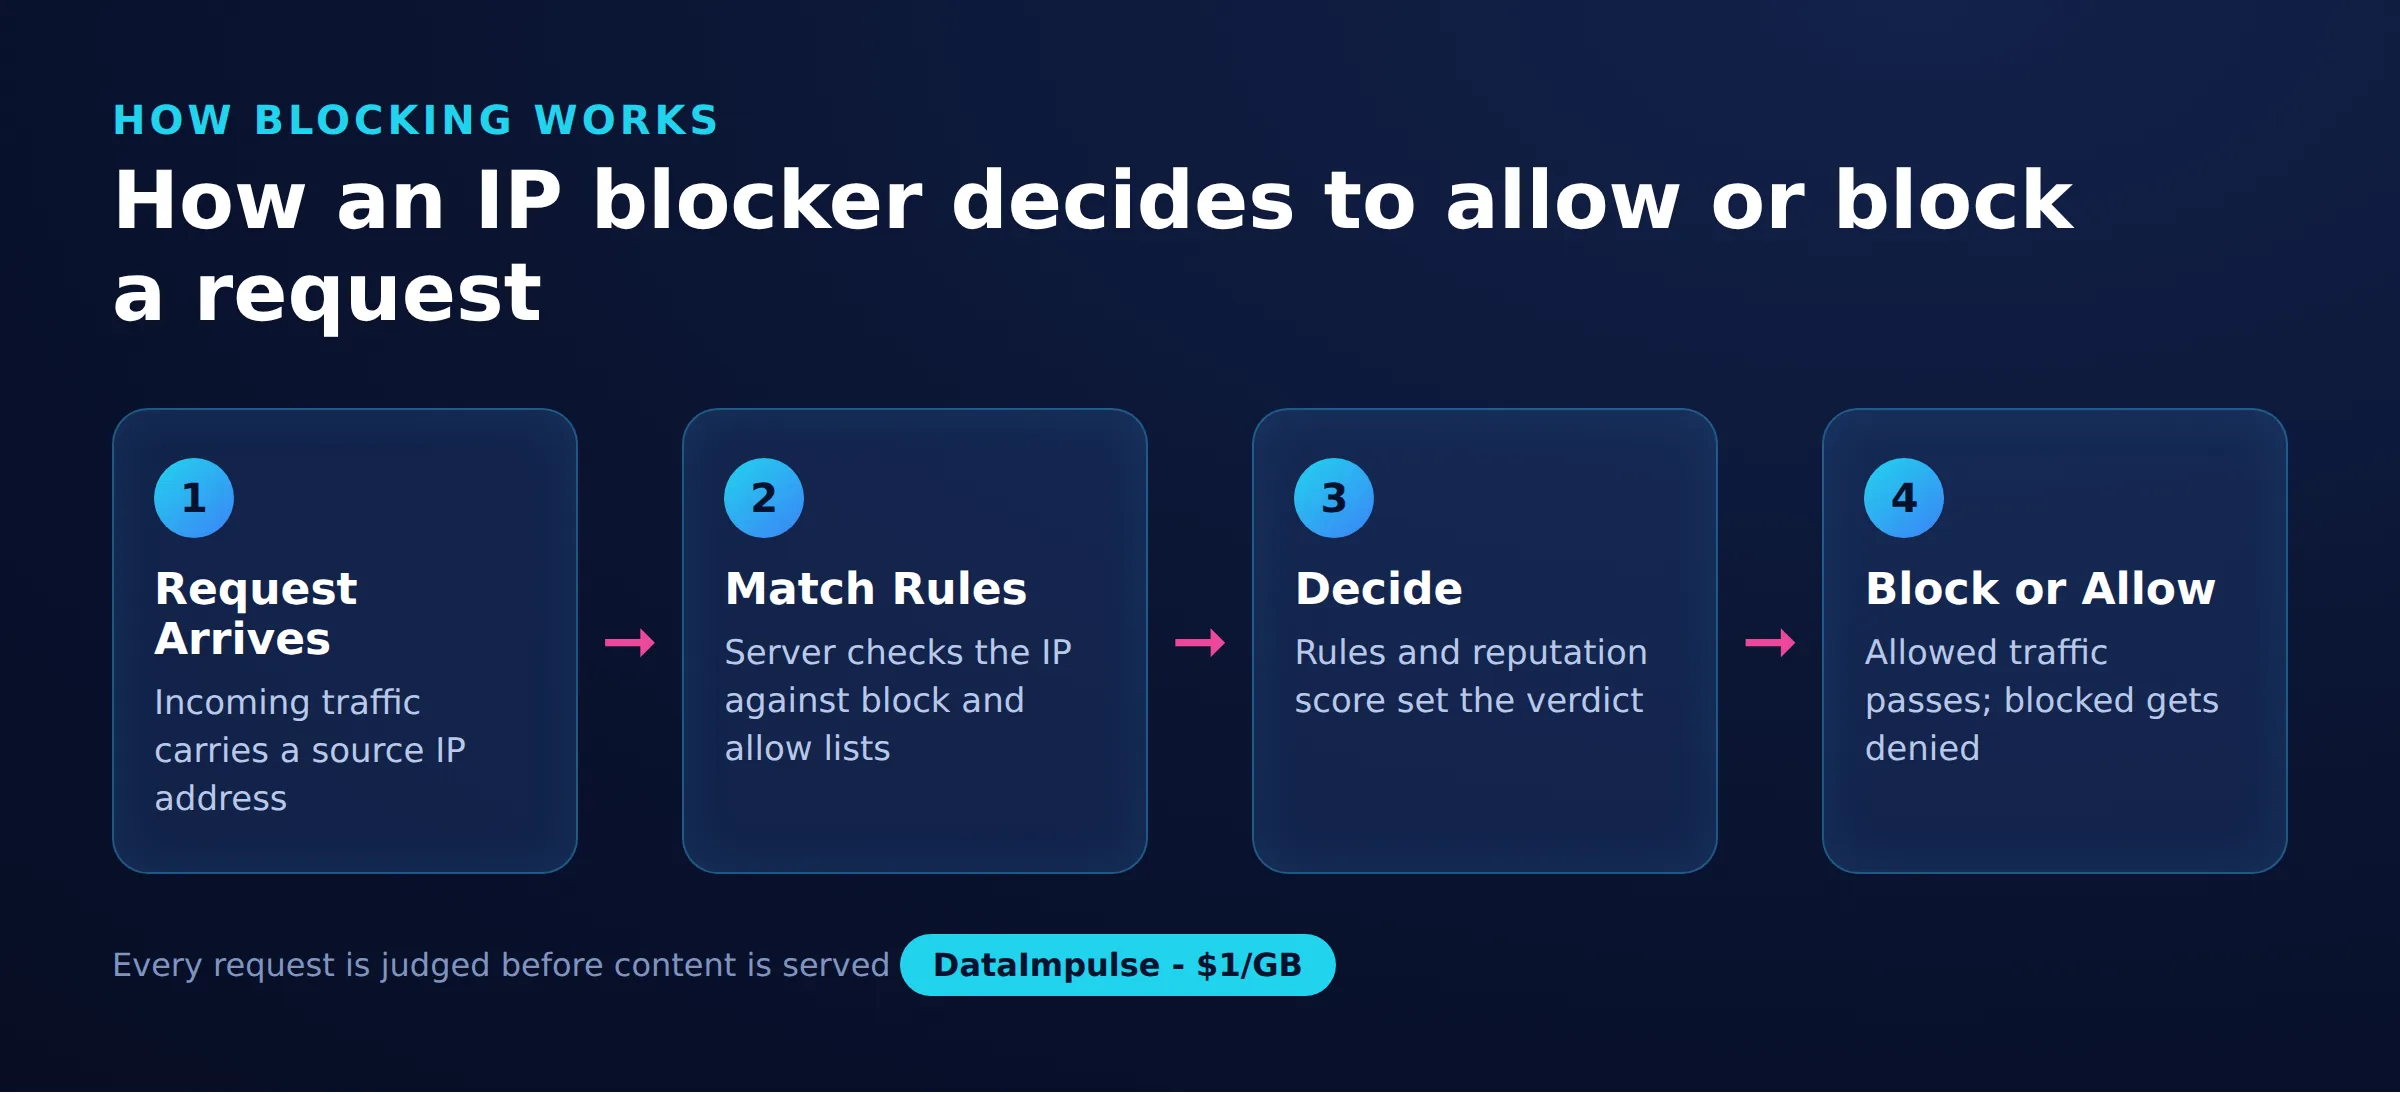
Blokada IP porównuje przychodzące żądanie z jedną lub kilkoma regułami i odrzuca je, jeśli zadziała któraś z nich. Szczegółowość tych reguł obejmuje zakres od pojedynczego adresu po całe sieci.
Typowe metody dopasowania to:
- Dokładny IP: konkretny adres jest odrzucany, co jest przydatne w przypadku znanego sprawcy nadużyć.
- Zakresy CIDR: blok adresów (na przykład 203.0.113.0/24) jest odrzucany od razu, co sprawdza się przy zgrupowanej infrastrukturze.
- Poziom ASN: wszystkie adresy należące do systemu autonomicznego, takiego jak sieć dostawcy hostingu, są traktowane tak samo. Dlatego ruch z datacenter jest często filtrowany zbiorczo.
- Oparte na reputacji: wynik oparty na źródłach informacji o zagrożeniach i wcześniejszym zachowaniu decyduje o rezultacie, więc adres dziedziczy ryzyko od sąsiadujących adresów.
- Behawioralne: blokada uruchamia się na podstawie sposobu działania klienta, takiego jak szybkość żądań, spójność nagłówków lub wzorce nawigacji, a nie tylko samego adresu.
Na najprostszym poziomie blokada to jedna linia, która nakazuje zaporze odrzucić ruch z danego adresu, jak pokazują te przykłady iptables i fail2ban:
#deny a single address with iptables
iptables -A INPUT -s 203.0.113.45 -j DROP

#deny a whole /24 range
iptables -A INPUT -s 203.0.113.0/24 -j DROP

#fail2ban adds a temporary ban after repeated failures
fail2ban-client set sshd banip 203.0.113.45
W środowisku produkcyjnym te podstawowe mechanizmy są opakowane w dashboardy WAF i konfiguracje ograniczania szybkości, ale logika jest taka sama: dopasuj źródło, a następnie zezwól albo odrzuć.
Dlaczego uzasadnione scrape’ery napotykają blokady IP?
Uzasadnione zbieranie danych często uruchamia blokady IP nie dlatego, że jest złośliwe, ale dlatego, że przypomina wzorce ruchu, do których powstrzymywania dostrojono te blokady. Decydują o tym dwa czynniki.
Pierwszym są współdzielone zakresy sieciowe. Ruch z tanich datacenter proxies i od dostawców chmurowych przechodzi przez niewielką liczbę ASN współdzielonych przez wielu użytkowników, dlatego reguły oparte na reputacji i poziomie ASN odrzucają cały zakres niezależnie od intencji. Drugim czynnikiem jest agresywna szybkość: wysyłanie wielu żądań na sekundę z jednego adresu to dokładnie sygnał, który ma wychwycić ogranicznik szybkości. Prawidłowo działający kolektor, który uwzględnia oba czynniki, znacznie rzadziej zostanie zablokowany już na początku.
Jak rotacyjne residential proxies pomagają przy danych publicznych?
Rotacyjne residential proxies rozkładają żądania na wiele rzeczywistych adresów przydzielanych przez ISP, dzięki czemu żaden pojedynczy adres nie kumuluje liczby żądań uruchamiającej blokadę opartą na szybkości. Pozwala to uzasadnionemu projektowi dotyczącym danych publicznych utrzymać się w progach dla pojedynczego adresu egzekwowanych przez strony.
Ponieważ adresy należą do prawdziwych połączeń residential, a nie do oznaczonego zakresu datacenter, mają zwykłą reputację i nie są odrzucane przez reguły na poziomie ASN wymierzone w ruch chmurowy. DataImpulse oferuje residential proxies obok mobile proxies, pozyskiwanych od użytkowników, którzy wyrażają zgodę i otrzymują wynagrodzenie, dlatego są określane jako etyczne proxy. Adresy są narzędziem, a to, czy ich użycie jest dopuszczalne, zależy wyłącznie od tego, co i w jaki sposób jest zbierane, o czym mówi następna sekcja.
Jak odpowiedzialnie zbierać dane publiczne?
Odpowiedzialne zbieranie oznacza traktowanie docelowej strony jako wspólnego zasobu: pobieraj wyłącznie dane publiczne, działaj powoli i wycofaj się, gdy serwer sygnalizuje przeciążenie. Rozdzielanie żądań nie zastępuje dobrych praktyk.
Praktyczne nawyki obejmują:
- Ograniczanie szybkości: ogranicz liczbę równoczesnych żądań i dodaj opóźnienia, aby Twój ruch mieścił się w tym, co wygenerowałby zwykły użytkownik.
- Wykładnicze wycofywanie: gdy otrzymasz 429 lub 503, przed ponowną próbą czekaj stopniowo dłużej, zamiast zasypywać endpoint żądaniami.
- Respektowanie sygnałów: zapoznaj się z dyrektywami robots i honoruj deklarowane preferencje strony.
- Buforowanie i deduplikacja: unikaj ponownego żądania stron, które już masz.
Nasz przewodnik o web scraping bez blokad omawia te praktyki bardziej szczegółowo.
Gdzie przebiega granica między uzasadnionym użyciem a obchodzeniem zabezpieczeń?
Granicę wyznacza to, co znajduje się za blokadą, a nie techniczna możliwość jej ominięcia. Rozdzielanie żądań w celu pełnego szacunku zbierania informacji publicznych jest praktyką zarządzania obciążeniem; używanie tych samych narzędzi do pokonania logowania, blokady lub kontroli antyfraudowej jest obchodzeniem zabezpieczeń.
Jasne granice, których należy przestrzegać:
- Nie omijaj uwierzytelniania: nigdy nie używaj proxy, aby uzyskać dostęp do usług wymagających logowania lub objętych paywallem, do których nie masz uprawnień.
- Nie obchodź blokad platform: rotowanie adresami w celu obejścia zawieszenia konta lub blokady jest sprzeczne z warunkami platformy.
- Nie umożliwiaj oszustw: proxy nie są narzędziem do tworzenia fałszywych kont, oszustw reklamowych ani jakiegokolwiek wprowadzania usługi w błąd.
Etyczne usługi proxy są przeznaczone do zgodnych z prawem działań z danymi publicznymi, a nie do pokonywania zabezpieczeń lub kontroli licencyjnych.
Jak działa blokowanie IP
| Metoda | Jak działa | Typowy wyzwalacz |
|---|---|---|
| Dokładny IP | Blokuje pojedynczy adres | Znany sprawca nadużyć |
| Zakres CIDR | Blokuje blok podsieci | Nadużycia z jednej sieci |
| ASN | Blokuje całego dostawcę | Ruch z datacenter lub hostingu |
| Źródło reputacji | Blokuje adresy z listy | Niski wynik reputacji |
| Behawioralne lub oparte na szybkości | Blokuje według wzorców żądań | Zbyt wiele szybkich żądań |
Często zadawane pytania
Jaka jest różnica między blokadą IP a zaporą sieciową?
Zapora sieciowa jest jednym z powszechnych sposobów wdrażania blokowania IP w warstwie sieciowej, ale blokada IP to szersze pojęcie. Obejmuje także reguły WAF, ograniczniki szybkości, fail2ban, blokady geograficzne i źródła reputacji, które odrzucają ruch według adresu.
Dlaczego datacenter proxies są blokowane częściej niż residential proxies?
Datacenter proxies współdzielą ograniczony zestaw hostingowych ASN używanych przez wielu użytkowników, więc strony często odrzucają całe te zakresy. Adresy residential należą do rzeczywistych połączeń ISP i mają zwykłą reputację, dlatego rzadziej są objęte regułami na poziomie ASN.
Czy rotacyjne proxy mogą ominąć każdą blokadę IP?
Nie. Rotacyjne proxy pomagają rozdzielać żądania, aby projekt pozostawał poniżej limitów szybkości dla pojedynczego adresu, lecz nie pokonują i nie powinny pokonywać uwierzytelniania, blokad kont ani kontroli antyfraudowych. To granice, które należy respektować, a nie przeszkody do ominięcia.
Czy DataImpulse pomaga obchodzić blokady na platformach?
Nie. DataImpulse to etyczny dostawca proxy do zgodnego z prawem zbierania danych publicznych. Używanie proxy do obchodzenia blokady platformy, omijania logowania lub popełniania oszustw jest sprzeczne z jego warunkami i nie stanowi obsługiwanego przypadku użycia.
Jak mogę uniknąć zablokowania mojego scrape’era już na początku?
Zbieraj wyłącznie dane publiczne, utrzymuj niską szybkość żądań, stosuj wykładnicze wycofywanie w odpowiedzi na 429 i 503 oraz honoruj deklarowane preferencje strony. Rozdzielanie żądań między adresy residential uzupełnia te nawyki, ale ich nie zastępuje.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do web scraping albo dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych residential proxies, mobile proxies i datacenter proxies do zbierania danych publicznych oraz uzyskiwania dostępu do treści.
Powiązane przewodniki
Zbieraj dane publiczne w odpowiedzialny sposób
Jeśli Twoja praca obejmuje zbieranie danych publicznych na dużą skalę bez przeciążania pojedynczego adresu, DataImpulse oferuje etycznie pozyskiwane rotacyjne residential proxies, mobile proxies i datacenter proxies w modelu pay-as-you-go. Utwórz konto, aby rozpocząć.