
In this Article
Rust web scraping คือการดึงและแยกวิเคราะห์หน้าเว็บด้วยภาษา Rust และระบบนิเวศของ crate ต่างๆ Rust เหมาะกับนักพัฒนาที่ต้องการประสิทธิภาพที่คาดการณ์ได้และความปลอดภัยของหน่วยความจำโดยไม่ต้องมีตัวเก็บขยะ จึงเหมาะอย่างยิ่งกับ crawler ที่ทำงานต่อเนื่องหรือมีปริมาณงานสูง.
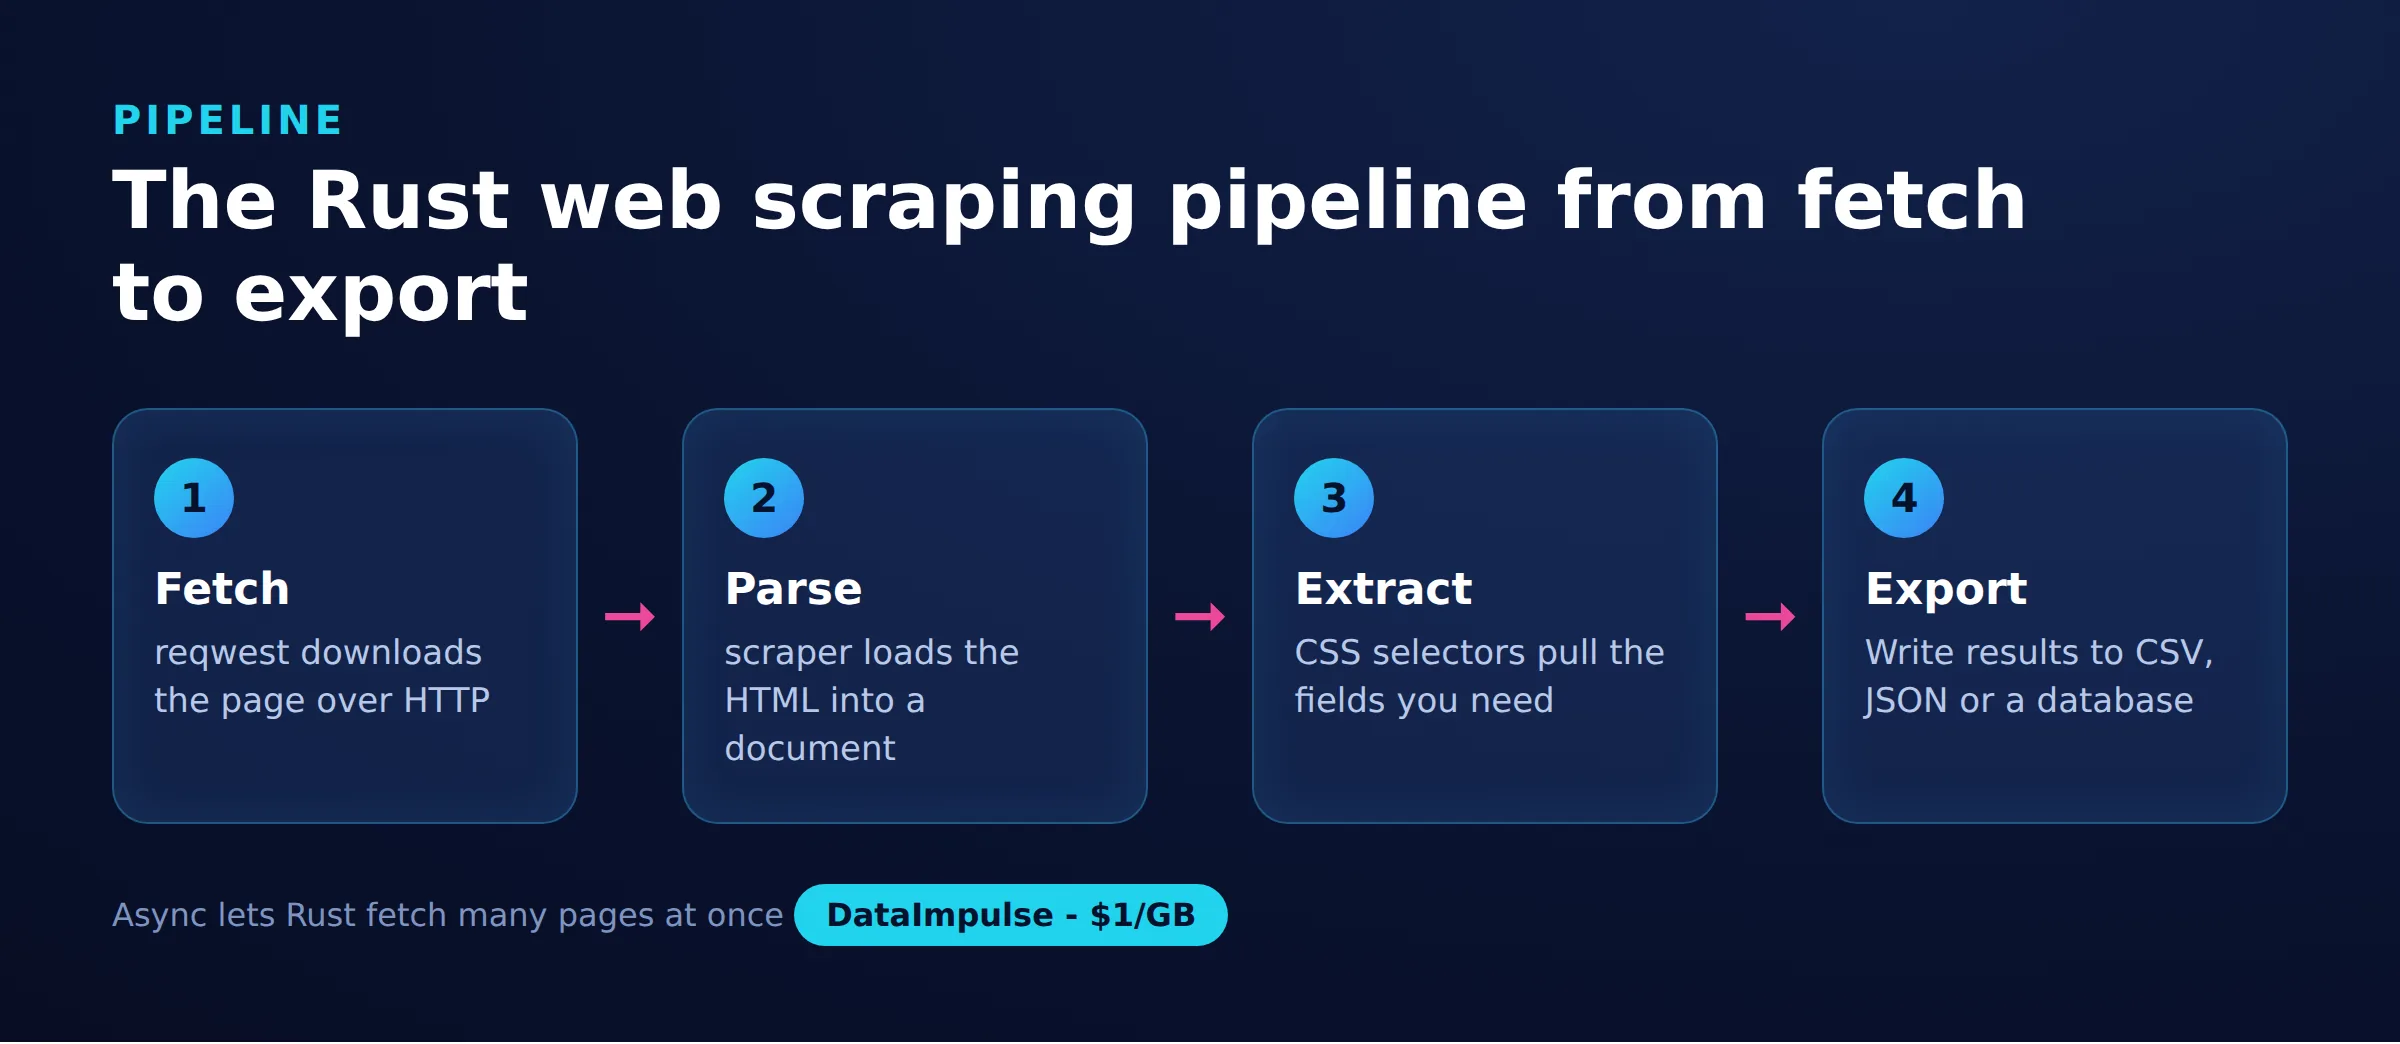
คู่มือนี้เป็นบทแนะนำเชิงปฏิบัติที่เน้นโค้ด โดยใช้ HTTP client reqwest และ crate สำหรับแยกวิเคราะห์ scraper เป็นหลัก ครอบคลุมตั้งแต่การตั้งค่าโปรเจ็กต์และการดึงข้อมูลแบบพื้นฐาน ไปจนถึง CSS selector โมเดลข้อมูลแบบมีโครงสร้าง การส่งออก JSON และ CSV การแบ่งหน้า การจัดการข้อผิดพลาดด้วยการลองใหม่และ backoff การทำงานพร้อมกันแบบ async ด้วย tokio การตั้งค่า proxy และทางเลือกใช้เบราว์เซอร์แบบ headless สำหรับเว็บไซต์ที่ใช้ JavaScript หนัก ทุกตัวอย่างออกแบบมาให้คอมไพล์และรันได้.
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม ซึ่งมี IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี.
ข้อมูลสำคัญ
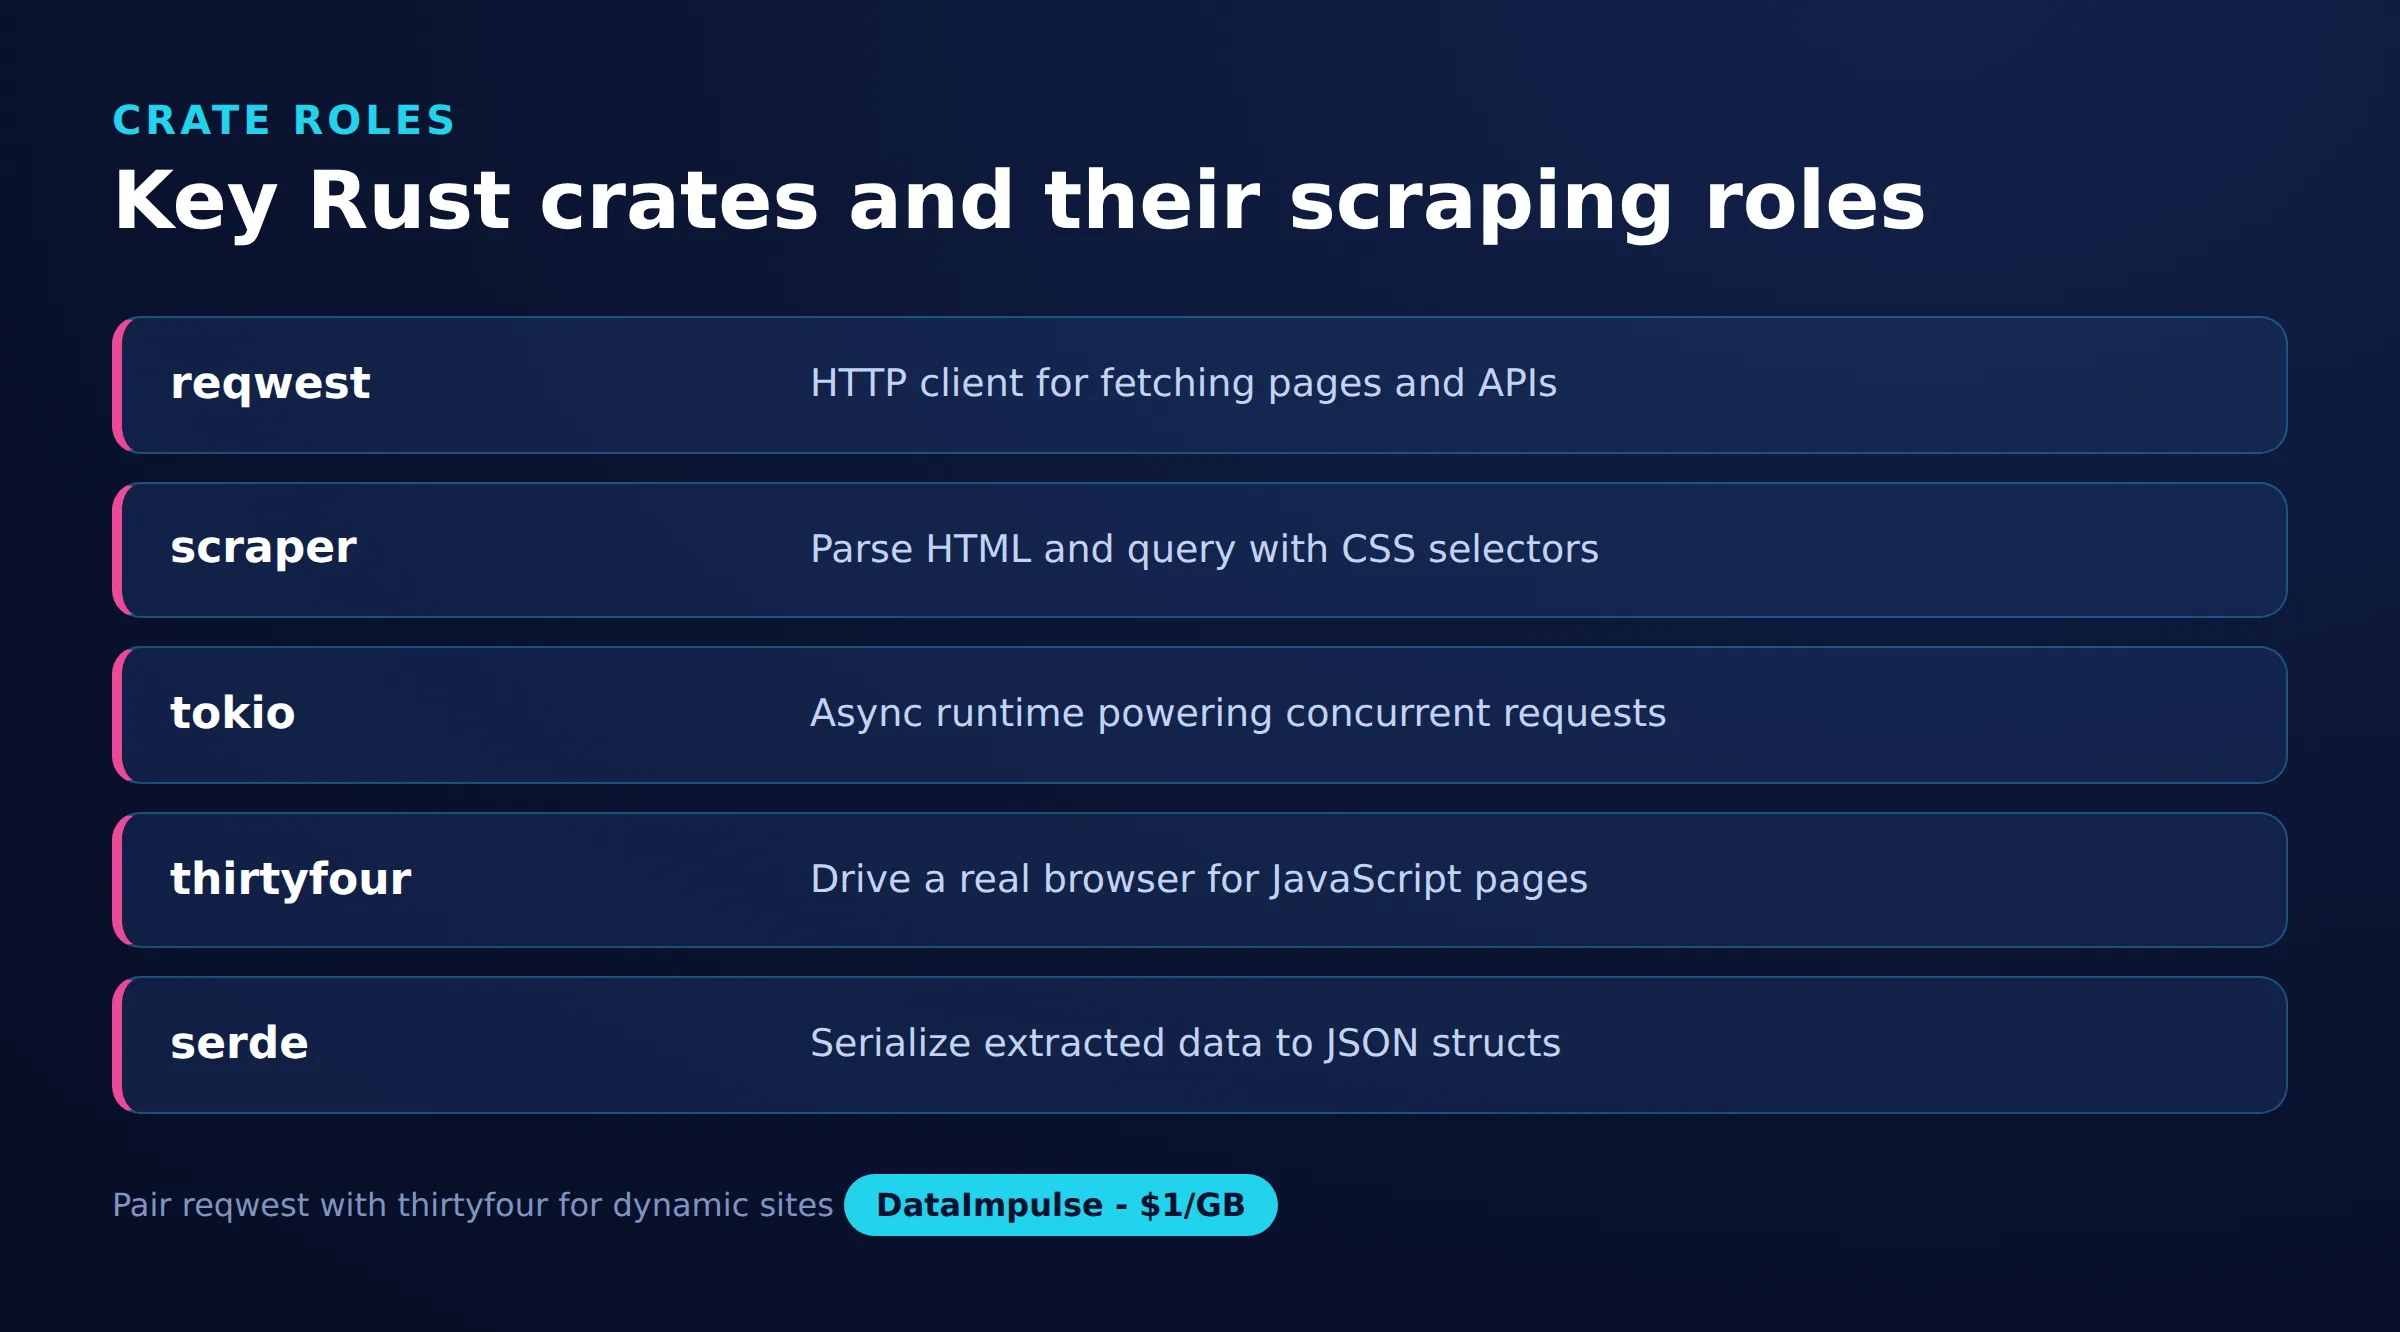
- สแตกหลัก: โดยปกติ Rust web scraping จะใช้ HTTP client reqwest คู่กับ crate scraper สำหรับแยกวิเคราะห์ HTML พร้อม tokio สำหรับการทำงานพร้อมกันแบบ async และ serde สำหรับส่งออกข้อมูลแบบมีโครงสร้าง.
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxies ซึ่งใช้ IP ของผู้ใช้จริงและหลบเลี่ยงการตรวจจับได้.
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน พร้อมทราฟฟิกที่ไม่หมดอายุและไม่มีค่าสมาชิก.
- การครอบคลุม: IP ที่จัดหาด้วยหลักจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ.
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2.
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศรวมอยู่แล้ว.
เหตุใดจึงใช้ Rust สำหรับ web scraping?
Rust เหมาะกับ web scraping เมื่อความเร็ว การใช้หน่วยความจำต่ำ และความน่าเชื่อถือสำคัญกว่าการทำต้นแบบอย่างรวดเร็ว ไบนารีที่คอมไพล์แล้วทำงานใกล้กับฮาร์ดแวร์ และ borrow checker ตรวจพบบั๊กด้าน concurrency ได้ทั้งกลุ่มตั้งแต่ขั้นตอนคอมไพล์ แทนที่จะพบในระบบจริง.
คุณสมบัติเหล่านี้มีประโยชน์ในสถานการณ์ทั่วไปหลายแบบ:
- ปริมาณงาน: crawler Rust ที่คอมไพล์แล้วประมวลผลหน้าจำนวนมากโดยใช้ CPU และหน่วยความจำส่วนเกินน้อยกว่าภาษาที่ตีความ จึงลดต้นทุนโครงสร้างพื้นฐานสำหรับงานระยะยาว.
- การทำงานพร้อมกันอย่างปลอดภัย: async runtime tokio ช่วยให้รันคำขอพร้อมกันได้หลายพันคำขอ ขณะที่ระบบ type ป้องกัน data race ระหว่างงานเหล่านั้น.
- การใช้ทรัพยากรที่คาดการณ์ได้: การไม่มีตัวเก็บขยะทำให้ latency คงที่กว่า ซึ่งช่วย crawler ที่ทำงานเป็นชั่วโมงหรือเป็นวัน.
ข้อแลกเปลี่ยนคือเส้นโค้งการเรียนรู้ที่ชันกว่าและเวลาในการคอมไพล์นานกว่า ดังนั้น Rust จึงเหมาะกับโปรเจ็กต์ที่ทำงานในระดับใหญ่ มากกว่าสคริปต์ที่ใช้ครั้งเดียว ไม่ว่าจะใช้ภาษาใด หลักพื้นฐานก็เหมือนกัน: เคารพ robots.txt จำกัดอัตราคำขอ และปฏิบัติตามแนวทางทั่วไปเรื่อง แนวทางปฏิบัติที่ดีสำหรับ web scraping เพื่อให้ crawler ของคุณทำงานอย่างรับผิดชอบ.
ตั้งค่าโปรเจ็กต์ scraping ด้วย Rust อย่างไร?
ตั้งค่าโปรเจ็กต์ scraping ด้วย Rust โดยสร้างแพ็กเกจ Cargo ใหม่และประกาศ crate ที่ต้องใช้ใน Cargo.toml Cargo คือเครื่องมือสร้างและตัวจัดการแพ็กเกจของ Rust จึงแก้ไข dependency และคอมไพล์โปรเจ็กต์ให้คุณ.
รัน cargo new rust-scraper เพื่อสร้างโครงโปรเจ็กต์ จากนั้นแก้ไข Cargo.toml ที่สร้างขึ้น ชุด dependency ด้านล่างครอบคลุมทุกอย่างในคู่มือนี้: HTTP การแยกวิเคราะห์ async การทำ serialization การส่งออก CSV stream และการจัดการข้อผิดพลาดที่ใช้งานสะดวก.
[package]
name = "rust-scraper"
version = "0.1.0"
edition = "2021"

[dependencies]
reqwest = { version = "0.12", features = ["json", "socks"] }
scraper = "0.20"
tokio = { version = "1", features = ["full"] }
serde = { version = "1", features = ["derive"] }
serde_json = "1"
csv = "1.3"
futures = "0.3"
anyhow = "1"
thiserror = "1"
ในที่นี้ reqwest จัดการคำขอ (ฟีเจอร์ socks เปิดใช้ SOCKS5 proxies ส่วนฟีเจอร์ json เพิ่มตัวช่วย JSON) scraper แยกวิเคราะห์ HTML ด้วย CSS selector, tokio ให้ async runtime, serde และ serde_json ทำ serialization ข้อมูล, csv เขียนสเปรดชีต, futures มี stream combinator สำหรับ concurrency และ anyhow ร่วมกับ thiserror ช่วยจัดการข้อผิดพลาดให้กระชับ รัน cargo build หนึ่งครั้งเพื่อดาวน์โหลดและคอมไพล์ทุกอย่างก่อนเขียนคำขอแรก.
ดึงและแยกวิเคราะห์หน้าด้วย reqwest และ scraper อย่างไร?
ดึงหน้าด้วยการส่งคำขอ GET ผ่าน reqwest แล้วโหลด response body เข้า scraper เพื่อค้นหาด้วย CSS selector ตัวอย่างด้านล่างรันแบบอะซิงโครนัสบน tokio ดึงหน้าเว็บ และพิมพ์ข้อความของทุก element H1.
use scraper::{Html, Selector};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let url = "https://example.com";
    let body = reqwest::get(url).await?.text().await?;

    let document = Html::parse_document(&body);
    let heading = Selector::parse("h1").unwrap();

    for element in document.select(&heading) {
        let text: String = element.text().collect();
        println!("{}", text.trim());
    }
    Ok(())
}
ลำดับการทำงานเหมือนเดิมเสมอ: reqwest::get ส่งคืน response, .text() อ่าน body เป็นสตริง และ Html::parse_document เปลี่ยนสตริงนั้นเป็น tree ที่ค้นหาได้ ตัวดำเนินการ ? ส่งต่อข้อผิดพลาดของเครือข่ายหรือการถอดรหัสไปยัง main การเรียก .text() บน element ที่ตรงกันจะรวบรวม text node ของมัน แล้วตัดช่องว่างและนำไปใช้ วิธี raw HTML นี้รวดเร็ว แต่โปรดทราบว่ามันเห็นเฉพาะ markup ที่เซิร์ฟเวอร์ส่งกลับ ไม่ใช่เนื้อหาที่เบราว์เซอร์จะแสดงในภายหลังด้วย JavaScript.
เลือก element ด้วย CSS selector อย่างไร?
เลือก element โดยส่งสตริง CSS selector มาตรฐานให้ Selector::parse เช่นเดียวกับที่ทำใน console ของเบราว์เซอร์ crate scraper รองรับ tag, class, id, การจับคู่ attribute, path ของ descendant และ pseudo-class เชิงโครงสร้าง.
use scraper::Selector;

// Match by tag
let links = Selector::parse("a").unwrap();

// Match by class
let prices = Selector::parse(".price").unwrap();

// Match by id
let main = Selector::parse("#main-content").unwrap();

// Match by attribute value
let external = Selector::parse("a[rel=\"nofollow\"]").unwrap();

// Descendant path (a title inside a product card)
let titles = Selector::parse("div.product h2.title").unwrap();

// Direct child plus pseudo-class
let first_row = Selector::parse("table > tbody > tr:first-child").unwrap();
คอมไพล์ selector แต่ละตัวหนึ่งครั้งแล้วนำกลับมาใช้ แทนการแยกวิเคราะห์ในลูป เพราะการแยกวิเคราะห์มีต้นทุนเล็กน้อย เมื่อ selector อาจไม่ตรงกัน ให้เลือกใช้ .next() พร้อม fallback แทน .unwrap() บน element เพื่อไม่ให้ field ที่หายไปทำให้การรันทั้งหมด panic การตรวจสอบหน้าเป้าหมายด้วยตัวเลือก element ของเบราว์เซอร์เป็นวิธีที่เร็วที่สุดในการหาชื่อ class และ attribute ที่เสถียรสำหรับเลือก.
ส่งออกข้อมูลที่ scrape แล้วเป็น JSON และ CSV อย่างไร?
ส่งออกข้อมูลที่ scrape แล้วโดยสร้างโมเดลแต่ละระเบียนเป็น struct ที่ derive Serialize ของ serde แล้วเขียน slice ของ struct เหล่านั้นเป็น JSON ด้วย serde_json หรือเป็น CSV ด้วย crate csv การกำหนดโมเดลที่มี type ชัดเจนทำให้การดึงข้อมูลและผลลัพธ์สอดคล้องกัน และทำให้โค้ดอธิบายตัวเองได้.
เริ่มจากสร้างโมเดลระเบียนและดึง field ออกจาก container element แต่ละตัว:
use scraper::{Html, Selector};
use serde::Serialize;

#[derive(Debug, Serialize)]
struct Product {
    name: String,
    price: String,
    url: String,
}

fn parse_products(html: &str) -> Vec<Product> {
    let document = Html::parse_document(html);
    let card = Selector::parse("div.product").unwrap();
    let name_sel = Selector::parse("h2.title").unwrap();
    let price_sel = Selector::parse("span.price").unwrap();
    let link_sel = Selector::parse("a").unwrap();

    let mut products = Vec::new();
    for card_el in document.select(&card) {
        let name = card_el
            .select(&name_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let price = card_el
            .select(&price_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let url = card_el
            .select(&link_sel)
            .next()
            .and_then(|e| e.value().attr("href"))
            .unwrap_or_default()
            .to_string();

        products.push(Product { name, price, url });
    }
    products
}
เนื่องจาก Product derive Serialize struct เดียวกันจึงป้อนให้ exporter ทั้งสองได้โดยไม่ต้องทำงานเพิ่ม:
use std::fs::File;
use std::io::Write;

fn export_json(products: &[Product]) -> anyhow::Result<()> {
    let json = serde_json::to_string_pretty(products)?;
    let mut file = File::create("products.json")?;
    file.write_all(json.as_bytes())?;
    Ok(())
}

fn export_csv(products: &[Product]) -> anyhow::Result<()> {
    let mut writer = csv::Writer::from_path("products.csv")?;
    for product in products {
        writer.serialize(product)?;
    }
    writer.flush()?;
    Ok(())
}
serde_json’s to_string_pretty สร้าง JSON ที่อ่านง่าย และ serialize ของ crate csv จะแปลงแต่ละ struct เป็นแถว โดยมี header ที่มาจากชื่อ field การใช้โมเดลที่มี type เดียวกันซ้ำสำหรับ scraping, JSON และ CSV คือสิ่งที่ทำให้ pipeline ของ Rust ดูแลรักษาง่ายเมื่อเว็บไซต์เป้าหมายเปลี่ยนแปลง.
scrape หลายหน้าด้วยลูปแบ่งหน้าอย่างไร?
scrape หลายหน้าด้วยการวนตามหมายเลขหน้าหรือ URL ของหน้าถัดไป โดยใช้ reqwest client เพียงตัวเดียวซ้ำเพื่อให้ connection ถูก pool ข้ามคำขอ สร้างแต่ละ URL ดึงข้อมูล แยกวิเคราะห์ด้วยฟังก์ชันจากหัวข้อก่อนหน้า และหยุดเมื่อหน้าเว็บไม่ส่งผลลัพธ์.
use scraper::Html;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let mut all_products = Vec::new();

    for page in 1..=10 {
        let url = format!("https://example.com/products?page={}", page);
        let body = client.get(&url).send().await?.text().await?;
        let products = parse_products(&body);

        // Stop when a page returns no results
        if products.is_empty() {
            break;
        }
        all_products.extend(products);

        // Pause between requests to stay polite
        tokio::time::sleep(std::time::Duration::from_millis(500)).await;
    }

    println!("Collected {} products", all_products.len());
    Ok(())
}
การสร้าง client เพียงครั้งเดียวด้วย reqwest::Client::new() นอกลูปทำให้ใช้ TCP connection ซ้ำได้ ซึ่งเร็วกว่าใช้ client ใหม่ต่อคำขออย่างเห็นได้ชัด การตรวจผลลัพธ์ว่างจะจบลูปโดยธรรมชาติเมื่อถึงหน้าสุดท้าย และการพักสั้นๆ ช่วยเว้นระยะคำขอเพื่อไม่ให้เซิร์ฟเวอร์รับภาระมากเกินไป สำหรับเว็บไซต์ที่ใช้ลิงก์ถัดไปแทนเลขหน้า ให้ดึง href ของ anchor หน้าถัดไปในแต่ละรอบ แล้วติดตามไปจนกว่าลิงก์จะหายไป.
จัดการข้อผิดพลาดและการลองใหม่ด้วย backoff อย่างไร?
จัดการข้อผิดพลาดโดยให้ฟังก์ชัน fetch ส่งคืน error ที่มี type จากนั้นลองใหม่เมื่อเกิดความล้มเหลวชั่วคราวด้วย exponential backoff เครือข่ายอาจหมดเวลาและเซิร์ฟเวอร์อาจส่ง status code ชั่วคราว ดังนั้น scraper ที่ทนทานจะมองความล้มเหลวครั้งเดียวว่าเป็นสิ่งที่คาดได้ ไม่ใช่เรื่องร้ายแรง.
crate thiserror ช่วยให้กำหนด error enum แบบกระชับซึ่งแปลงจาก error ของ reqwest โดยอัตโนมัติ:
use thiserror::Error;

#[derive(Error, Debug)]
enum ScrapeError {
    #[error("request failed: {0}")]
    Request(#[from] reqwest::Error),

    #[error("unexpected status code: {0}")]
    Status(reqwest::StatusCode),

    #[error("selector matched no elements")]
    Empty,
}

async fn fetch_page(client: &reqwest::Client, url: &str) -> Result<String, ScrapeError> {
    let response = client.get(url).send().await?;
    if !response.status().is_success() {
        return Err(ScrapeError::Status(response.status()));
    }
    Ok(response.text().await?)
}
แอตทริบิวต์ #[from] หมายความว่าความล้มเหลวของ reqwest จะกลายเป็น ScrapeError::Request โดยอัตโนมัติผ่านตัวดำเนินการ ? นอกจาก typed error แล้ว ให้หุ้มคำขอด้วยลูปลองใหม่ที่เวลารอเพิ่มขึ้นหลังการพยายามแต่ละครั้ง:
use std::time::Duration;

async fn fetch_with_backoff(client: &reqwest::Client, url: &str) -> anyhow::Result<String> {
    let max_attempts = 5;
    for attempt in 1..=max_attempts {
        match client.get(url).send().await {
            Ok(resp) if resp.status().is_success() => {
                return Ok(resp.text().await?);
            }
            Ok(resp) => {
                eprintln!("attempt {attempt}: status {}", resp.status());
            }
            Err(err) => {
                eprintln!("attempt {attempt}: {err}");
            }
        }
        // Exponential backoff: 0.5s, 1s, 2s, 4s, 8s
        let backoff = Duration::from_millis(500 * 2u64.pow(attempt - 1));
        tokio::time::sleep(backoff).await;
    }
    anyhow::bail!("giving up on {url} after {max_attempts} attempts")
}
Exponential backoff (ที่นี่คือ 0.5s, 1s, 2s, 4s, 8s) เปิดโอกาสให้เซิร์ฟเวอร์ที่ถูกจำกัดอัตราหรือรับภาระเกินชั่วครู่ฟื้นตัว แทนการส่งคำขอซ้ำรัวๆ การผสานการลองใหม่กับ rotating proxies ยิ่งมีประสิทธิภาพ: คำขอที่ถูกบล็อกหรือจำกัดบน IP หนึ่งอาจสำเร็จในการพยายามครั้งถัดไปจาก exit IP อื่น.
รันคำขอพร้อมกันด้วย tokio อย่างไร?
รันคำขอพร้อมกันโดยเปลี่ยนรายการ URL เป็น async stream แล้วใช้ buffer_unordered ซึ่งจำกัดจำนวนคำขอที่กำลังทำงานในเวลาเดียวกัน นี่คือปัจจัยด้านประสิทธิภาพที่สำคัญที่สุดอย่างหนึ่งของ Rust scraper และ tokio ร่วมกับ crate futures ทำให้ทำได้อย่างปลอดภัย.
use futures::stream::{self, StreamExt};

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let urls: Vec<String> = (1..=50)
        .map(|n| format!("https://example.com/item/{}", n))
        .collect();

    let bodies = stream::iter(urls)
        .map(|url| {
            let client = client.clone();
            async move {
                let text = client.get(&url).send().await?.text().await?;
                Ok::<_, reqwest::Error>((url, text))
            }
        })
        .buffer_unordered(10); // at most 10 requests in flight

    bodies
        .for_each(|result| async {
            match result {
                Ok((url, body)) => println!("{}: {} bytes", url, body.len()),
                Err(err) => eprintln!("error: {}", err),
            }
        })
        .await;

    Ok(())
}
ในที่นี้ stream::iter แปลงรายการ URL เป็น stream, .map เริ่มคำขอ async หนึ่งคำขอต่อ URL และ buffer_unordered(10) ทำให้มีงานทำงานพร้อมกันได้ไม่เกินสิบงาน และให้ผลลัพธ์เมื่อเสร็จ การ clone client ต่อ task มีต้นทุนต่ำ เพราะ Client ของ reqwest คือ Arc ที่ครอบ connection pool ร่วม ปรับขีดจำกัด concurrency เพื่อสมดุลระหว่างความเร็วกับภาระที่วางบนเป้าหมาย: สิบถึงยี่สิบเป็นจุดเริ่มต้นที่สมเหตุสมผล และการใช้ concurrency สูงขึ้นคู่กับ proxy pool จะกระจายคำขอเหล่านั้นไปยัง IP จำนวนมาก.
ส่งทราฟฟิก scraping ของ Rust ผ่าน proxy อย่างไร?
ส่งทราฟฟิกผ่าน proxy โดยสร้าง reqwest client ด้วย reqwest::Proxy และแนบ gateway กับข้อมูลรับรองของคุณด้วย .basic_auth การส่งคำขอผ่าน rotating IPs ช่วยกระจายภาระ เข้าถึงเนื้อหาเฉพาะพื้นที่ และลดโอกาสถูกจำกัดอัตรา Rotating IPs เป็นหนึ่งในเทคนิคที่มีประสิทธิภาพสูงที่สุดสำหรับ scraping โดยไม่ถูกบล็อก.
use reqwest::Proxy;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    // Authenticated gateway; rotates the exit IP on each request
    let proxy = Proxy::all("http://gw.dataimpulse.com:823")?
        .basic_auth("login", "password");

    let client = reqwest::Client::builder()
        .proxy(proxy)
        .timeout(std::time::Duration::from_secs(30))
        .build()?;

    let body = client
        .get("https://httpbin.org/ip")
        .send()
        .await?
        .text()
        .await?;

    println!("{}", body);
    Ok(())
}
แทนที่ login และ password ด้วยข้อมูลรับรองของคุณ และปรับ port ให้ตรงกับเครือข่ายที่ต้องการ หาก proxy ปฏิเสธคำขอด้วยสถานะ 407 สาเหตุมักเป็นข้อมูลรับรองที่ไม่มีหรือไม่ถูกต้อง คู่มือเรื่อง ข้อผิดพลาด HTTP 407 และบทแนะนำเรื่อง การยืนยันตัวตน proxy อธิบายวิธีแก้ไข DataImpulse มี residential proxies, datacenter proxies, และ mobile proxies ผ่าน HTTP, HTTPS และ SOCKS5 พร้อม rotating และ sticky session การกำหนดเป้าหมายตามประเทศรวมอยู่แล้ว ส่วนการกำหนดเป้าหมายตามรัฐ เมือง ZIP และ ASN เป็นส่วนเสริมแบบชำระเงิน.
scrape หน้าที่ใช้ JavaScript หนักอย่างไร และเมื่อใด Rust จึงเป็นตัวเลือกที่เหมาะสม?
scrape หน้าที่ใช้ JavaScript หนักโดยควบคุมเบราว์เซอร์แบบ headless จริง เพราะ reqwest และ scraper เห็นเพียง raw HTML ของเซิร์ฟเวอร์และไม่รัน script เมื่อเนื้อหาปรากฏหลัง client-side rendering เท่านั้น ให้ใช้ crate สำหรับ browser automation เช่น thirtyfour ที่ใช้โปรโตคอล WebDriver หรือ chromiumoxide ที่ควบคุม Chrome ผ่าน DevTools Protocol.
use thirtyfour::prelude::*;

#[tokio::main]
async fn main() -> WebDriverResult<()> {
    let caps = DesiredCapabilities::chrome();
    let driver = WebDriver::new("http://localhost:9515", caps).await?;

    driver.goto("https://example.com").await?;

    // Wait for client-side content to render, then read it
    let heading = driver.find(By::Css("h1")).await?;
    println!("{}", heading.text().await?);

    driver.quit().await?;
    Ok(())
}
ตัวอย่าง thirtyfour เชื่อมต่อกับ chromedriver ที่กำลังทำงาน โหลดหน้าเว็บ รอ element ที่ render แล้ว และอ่านข้อความ วิธีนี้หนักกว่าการดึง HTTP แบบปกติมาก จึงควรใช้เฉพาะหน้าที่จำเป็นจริงๆ และคงเส้นทาง reqwest ที่รวดเร็วไว้สำหรับอย่างอื่น สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับข้อแลกเปลี่ยนนี้ โปรดดูคู่มือเรื่อง การ scraping หน้าเว็บแบบไดนามิก และ web scraping ด้วย JavaScript ตารางด้านล่างสรุปบทบาทของ crate หลักแต่ละตัว:
| Crate | บทบาท | รัน JavaScript | เหมาะสำหรับ |
|---|---|---|---|
| reqwest | HTTP client | ไม่ | การดึง raw HTML และ JSON APIs |
| scraper | ตัวแยกวิเคราะห์ HTML | ไม่ | การดึงข้อมูลด้วย CSS selector |
| thirtyfour | WebDriver client | ใช่ | browser automation เต็มรูปแบบและฟอร์ม |
| chromiumoxide | DevTools Protocol | ใช่ | การควบคุม Chrome แบบ headless ที่รวดเร็ว |
สำหรับการเลือกภาษา ให้เลือก Rust เมื่อคุณต้องการประสิทธิภาพต่อเนื่องและการใช้ทรัพยากรต่ำในระดับใหญ่ และเลือก Python เมื่อให้ความสำคัญกับการพัฒนาที่รวดเร็วและระบบนิเวศ scraping ที่กว้างกว่า เช่น Scrapy และ Playwright รูปแบบที่พบได้บ่อยคือสร้างต้นแบบกฎการดึงข้อมูลใน Python แล้วค่อยย้าย hot path ไป Rust เมื่อตรรกะคงที่และปริมาณงานเพิ่มขึ้น ไม่ว่าจะเลือกแบบใด network layer ก็สำคัญพอๆ กับ parser และ proxies ที่จัดหาด้วยหลักจริยธรรมช่วยให้งานขนาดใหญ่เชื่อถือได้.
คำถามที่พบบ่อย
crate Rust ใดเหมาะที่สุดสำหรับ web scraping?
คู่ที่ใช้บ่อยที่สุดคือ reqwest สำหรับคำขอ HTTP และ scraper สำหรับแยกวิเคราะห์ HTML ด้วย CSS selector เพิ่ม tokio สำหรับ async concurrency, serde สำหรับส่งออกข้อมูล และ crate browser automation เช่น thirtyfour หรือ chromiumoxide เมื่อเว็บไซต์ต้องการการ render JavaScript.
Rust scrape หน้าเว็บที่ render ด้วย JavaScript ได้หรือไม่?
ไม่ได้หากใช้เพียง reqwest และ scraper เพราะทั้งสองเห็นเพียง raw HTML ที่เซิร์ฟเวอร์ส่งกลับและไม่สามารถรัน script ได้ หากต้องการ scrape เนื้อหาที่ render ฝั่ง client ให้ควบคุมเบราว์เซอร์แบบ headless ผ่าน crate WebDriver เช่น thirtyfour หรือ crate DevTools Protocol เช่น chromiumoxide.
ส่งออกข้อมูลที่ scrape แล้วใน Rust อย่างไร?
สร้างโมเดลแต่ละระเบียนเป็น struct ที่ derive Serialize ของ serde แล้วเขียน slice ของ struct เหล่านั้นเป็น JSON ด้วย serde_json หรือเป็น CSV ด้วย crate csv โมเดลที่มี type เดียวสามารถป้อนข้อมูลให้ทั้งสองรูปแบบได้โดยไม่ต้องทำซ้ำตรรกะการดึงข้อมูล.
รันคำขอพร้อมกันโดยไม่ให้เว็บไซต์รับภาระเกินไปอย่างไร?
เปลี่ยน URL เป็น async stream แล้วใช้ buffer_unordered พร้อมขีดจำกัดคงที่ ซึ่งจำกัดจำนวนคำขอที่รันพร้อมกัน เริ่มที่คำขอพร้อมกันราวสิบถึงยี่สิบคำขอ และใช้ concurrency ที่สูงขึ้นคู่กับ rotating proxy pool เพื่อกระจายภาระไปยัง IP จำนวนมาก.
จำเป็นต้องใช้ proxy สำหรับ Rust web scraping หรือไม่?
ไม่จำเป็นสำหรับงานขนาดเล็ก แต่ proxies จะสำคัญเมื่อทำงานในระดับใหญ่เพื่อกระจายคำขอและเข้าถึงเนื้อหาเฉพาะพื้นที่ ตั้งค่าด้วย reqwest::Proxy และ basic_auth และใช้ IP แบบ residential หรือ mobile ที่ rotating เพื่อลดการจำกัดอัตราและการบล็อก.
เมื่อใด DataImpulse จึงไม่เหมาะสม?
หากคุณต้องการ ISP proxies แบบ static, scraping API ที่มีผู้ดูแลครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น residential, mobile และ datacenter proxies แบบ rotating สำหรับรวบรวมข้อมูลสาธารณะและเข้าถึงเนื้อหา.
Scrape อย่างน่าเชื่อถือด้วย proxies ที่มีจริยธรรม
เมื่อ Rust scraper ของคุณดึงข้อมูล แยกวิเคราะห์ และส่งออกได้อย่างถูกต้อง เครือข่าย proxy ที่เชื่อถือได้คือสิ่งที่ทำให้มันทำงานในระดับใหญ่ต่อไปได้ DataImpulse มี IP ที่จัดหาด้วยหลักจริยธรรมแบบจ่ายตามการใช้งาน เริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ ดังนั้นคุณจึงสามารถ สร้างบัญชี และส่งคำขอแรกผ่านเครือข่ายได้ภายในไม่กี่นาที.