
In this Article
Apakah web scraping legal? Legalitas web scraping bergantung pada empat hal: apa yang Anda scrape (harga produk publik vs. profil pribadi), bagaimana Anda melakukannya (halaman publik vs. di balik login), di mana Anda beroperasi (logika CFAA AS vs. GDPR Eropa), dan apa yang Anda lakukan dengan data tersebut (pemantauan harga vs. pelatihan AI). Jadi, ketika orang bertanya “apakah legal untuk scrape data dari situs web”, jawaban jujurnya adalah scrape data nonpribadi yang tersedia untuk umum pada umumnya legal di sebagian besar yurisdiksi, tetapi setiap faktor itu menentukan apakah praktik bisnis Anda dapat dipertahankan atau berujung pada tindakan regulator. Panduan ini membahas kasus-kasus penting, gugatan era AI pada 2025-2026, sikap setiap regulator utama, dan kerangka kepatuhan praktis.
Satu hal sejak awal: ini adalah informasi umum, bukan nasihat hukum. Sebelum meningkatkan skala pipeline scraping komersial, mintalah nasihat hukum di yurisdiksi Anda dan yurisdiksi target Anda.
Fakta Utama
- Scrape data publik nonpribadi pada umumnya legal: rinciannya (apa, bagaimana, di mana, mengapa) menentukan segalanya.
- “Publik” bukan berarti “bebas diambil” untuk data pribadi: regulator UE menjatuhkan denda untuk hal ini (Clearview: €30,5 juta Belanda, €20 juta Italia, £7,5 juta Inggris).
- Tanpa login vs. dengan login adalah batas yang terus berlaku: scraping publik tanpa login dapat dipertahankan (hiQ, Meta v. Bright Data); scraping di balik login yang melanggar ketentuan yang diterima tidak demikian.
- Era AI menambahkan klaim kontrak, lisensi, dan hak cipta: legalitas pengumpulan dan pelatihan kini merupakan pertanyaan terpisah.
- Proxy sendiri legal: aktivitasnya, bukan alatnya, yang menentukan legalitas.
Jawaban Singkat, Berdasarkan Pertanyaan
| Pertanyaan | Jawaban singkat |
|---|---|
| Apakah scrape data produk/harga publik legal? | Pada umumnya ya: kategori yang paling mudah dipertahankan di mana pun |
| Apakah scrape data pribadi (nama, profil, kontak) legal? | Berisiko tinggi: regulator GDPR menjatuhkan denda bahkan ketika datanya publik |
| Apakah scrape di balik login legal? | Berisiko: Anda telah menerima ketentuan; klaim kontrak tetap berlaku bahkan saat CFAA tidak berlaku |
| Apakah melanggar robots.txt ilegal? | Bukan hukum itu sendiri, tetapi pengadilan dan regulator memperlakukannya sebagai bukti itikad buruk |
| Apakah menggunakan proxy legal? | Ya: aktivitasnya, bukan alatnya, yang menentukan legalitas |
| Apakah scrape untuk pelatihan AI legal? | Belum pasti: fair use menang untuk data yang diperoleh secara sah, tetapi gugatan kontrak/lisensi makin banyak |
Mitos Umum tentang Legalitas Web Scraping
Kebanyakan kebingungan mengenai legalitas web scraping muncul karena kemampuan teknis disamakan dengan izin hukum. Tiga mitos perlu diluruskan sebelum membahas rinciannya.
Mitos 1: Web Scraping Adalah Peretasan
Melakukan scraping pada halaman publik bukan akses tanpa izin: bot meminta halaman yang sama seperti browser biasa. hiQ v. LinkedIn di Pengadilan Banding Sirkuit Kesembilan AS (2022) memutuskan bahwa scraping halaman publik kemungkinan tidak melanggar CFAA ketika tidak ada gerbang autentikasi yang dilewati. Orang juga bertanya “apakah screen scraping legal?” Jawabannya sama: membaca halaman publik seperti browser bukan “peretasan”.
Mitos 2: “Data Publik” Berarti Bebas Diambil
Publik tidak berarti tanpa pembatasan. Data pribadi tetap dilindungi meskipun terlihat secara terbuka: regulator Eropa menjatuhkan denda untuk scraping data pribadi publik. Hak cipta tetap melindungi artikel dan gambar publik. Ketentuan layanan juga dapat mengikat Anda meski tanpa login. Jadi pertanyaan sebenarnya, apakah data scraping legal, sangat bergantung pada jenis data yang dimaksud.
Mitos 3: Melanggar ToS Adalah Kejahatan
Pelanggaran ketentuan layanan adalah masalah perdata, bukan pidana. Melanggar ToS tidak otomatis ilegal, tetapi dapat menjadi alasan pemblokiran, dasar gugatan perdata, dan bukti itikad buruk di pengadilan. Selengkapnya mengenai ketentuan layanan web scraping di bawah ini.
Amerika Serikat: CFAA, hiQ, dan Lapisan Kontrak
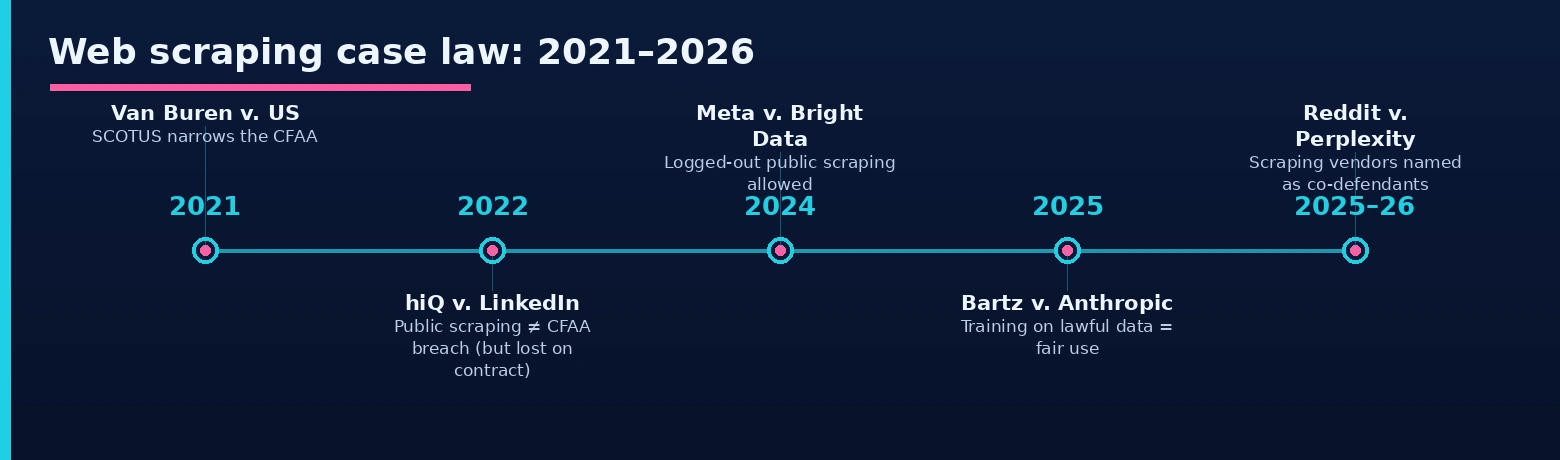
Pertanyaan mendasar, apakah website scraping legal di AS, bergantung pada apakah scraping halaman publik adalah “akses tanpa izin” menurut Computer Fraud and Abuse Act, undang-undang antipembobolan. Sirkuit Kesembilan menjawab dalam hiQ Labs v. LinkedIn (2022, menerapkan logika Van Buren dari Mahkamah Agung): tidak. Ketika halaman terbuka bagi siapa pun tanpa kredensial, tidak ada gerbang otorisasi untuk dilanggar, sehingga scraping data publik bukan pelanggaran CFAA.
Namun, keseluruhan kisah hiQ adalah pelajaran sesungguhnya. Setelah menang dalam sengketa CFAA, hiQ kalah dalam perang: pada November 2022 pengadilan memutuskan bahwa hiQ melanggar User Agreement LinkedIn (yang diterimanya saat membuat akun), dan kasus berakhir dengan putusan persetujuan. CFAA melindungi Anda dari klaim peretasan atas halaman publik; undang-undang itu tidak melindungi Anda dari kontrak yang telah Anda setujui.
Meta v. Bright Data (Januari 2024) mempertegas batasnya: pengadilan menolak menyatakan Bright Data melanggar ketentuan karena melakukan scraping halaman Facebook dan Instagram publik, tanpa login, sebab ketentuan platform mengatur pemegang akun, bukan pengunjung tanpa login. Aturan yang muncul: scraping publik tanpa login dapat dipertahankan; scraping dengan login yang melanggar ketentuan yang diterima tidak. Kasus trespass-to-chattels yang lebih lama (eBay v. Bidder’s Edge, 2000) masih dapat berlaku pada volume ekstrem, dan hukum privasi negara bagian (CCPA/CPRA California, VCDPA Virginia) menambahkan kewajiban data pribadi.
Ketentuan Layanan: Browsewrap, Clickwrap, dan Saat Aturan Menjadi Risiko Hukum
Ketentuan layanan bukan hukum, tetapi pengadilan sangat mempertimbangkannya, dan pertanyaan utamanya ialah apakah pengguna benar-benar menerimanya.
Browsewrap vs. Clickwrap: ToS Mana yang Benar-Benar Mengikat Anda
Perjanjian browsewrap hanyalah tautan di suatu bagian halaman tanpa penerimaan aktif: pengadilan jarang menegakkannya terhadap orang yang tidak pernah mengekliknya. Perjanjian clickwrap memerlukan tindakan eksplisit, seperti kotak centang atau tombol “Saya setuju”, dan pengadilan hampir selalu menegakkannya. Batas praktisnya: ketentuan yang Anda terima secara aktif, biasanya saat membuat akun, mengikat Anda; ketentuan yang sekadar mungkin Anda lihat sering kali tidak.
Saat Pelanggaran ToS Menjadi Bukti Hukum
Melanggar ketentuan layanan web scraping bukan tindak pidana, tetapi memiliki tiga konsekuensi praktis: platform dapat langsung memblokir Anda, hal itu menjadi dasar gugatan perdata pelanggaran kontrak (klaim yang pada akhirnya menenggelamkan hiQ), dan terlihat sebagai itikad buruk jika klaim CFAA atau terkait sampai ke pengadilan.
Era AI: Gugatan 2025-2026 yang Mengubah Peta
Pelatihan AI menciptakan gelombang kedua litigasi scraping, yang lebih sedikit mengenai “apakah akses diizinkan” dan lebih banyak mengenai kontrak, lisensi, dan hak cipta (pertanyaan yang sama yang membentuk proxy untuk pengumpulan data pelatihan AI):
- Bartz v. Anthropic (Juni 2025, Hakim Alsup): melatih LLM dengan buku yang diperoleh secara sah adalah fair use yang “sangat transformatif”, tetapi putusan itu secara eksplisit mengecualikan salinan sumber bajakan. Cara Anda memperoleh data sama pentingnya dengan apa yang Anda lakukan terhadapnya.
- Kadrey v. Meta (Juni 2025, Hakim Chhabria): penggugat kalah berdasarkan bukti yang mereka ajukan, tetapi pendapat itu memperingatkan bahwa ini bukan izin luas untuk pelatihan AI: kemenangan sempit, bukan doktrin.
- Reddit v. Anthropic (diajukan Juni 2025): Reddit menggugat berdasarkan teori ketentuan layanan dan pengayaan tanpa sebab, bukan hak cipta. Pada akhir Maret 2026, hakim federal mengembalikan perkara ke pengadilan negara bagian California, dengan menyatakan bahwa klaim tersebut tidak didahului oleh Copyright Act. Ini menegaskan bahwa klaim scraping berbasis kontrak memiliki dasar mandiri.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (Okt 2025, S.D.N.Y.): kasus pertama yang menyebut vendor infrastruktur scraping sebagai turut tergugat bersama perusahaan AI. Bagi pembeli proxy, pelajarannya mengenai rantai pasok: siapa yang mengumpulkan data Anda, dan bagaimana caranya, kini menjadi bagian dari risiko hukum Anda.
- NYT v. OpenAI (dikonsolidasikan, S.D.N.Y.): pada Januari 2026 pengadilan memerintahkan OpenAI untuk menghasilkan sampel log 20 juta percakapan dalam tahap penemuan bukti; kasus ini menguji apakah “regurgitasi” model meniadakan fair use.
- Ekonomi lisensi adalah sisi lainnya: Reddit melisensikan data kepada Google (~$60 juta/tahun) dan OpenAI; Cloudflare dan Stack Overflow meluncurkan bayar per crawling. “Bebas untuk di-scrape” dan “berlisensi untuk dilatih” menjadi jalur yang berbeda.
Eropa: GDPR dan Regulator Paling Ketat
Di UE (dan Inggris), pertanyaannya jarang “apakah akses diizinkan”, melainkan “apakah Anda memproses data pribadi tanpa dasar yang sah?” Menurut GDPR, scraping data apa pun yang mengidentifikasi seseorang (nama, foto, profil, detail kontak) adalah “pemrosesan”, dan “datanya publik” bukan dasar hukum dengan sendirinya. Rekam jejak penegakannya tegas:
- Belanda (AP): garis paling keras di Eropa. Pedoman Mei 2024 menyebut scraping data pribadi “hampir selalu merupakan pelanggaran GDPR”, dan AP mendenda Clearview AI €30,5 juta, dengan direktur diperingatkan mengenai tanggung jawab pribadi.
- Italia (Garante): mendenda Clearview €20 juta; prinsip yang dinyatakannya: “jika publik, saya dapat mengambilnya” adalah salah.
- Prancis (CNIL): mendenda broker data kontak KASPR €240.000 (Des 2024). Pedoman Juni 2025 mengizinkan scraping data pribadi publik berdasarkan kepentingan yang sah, tetapi hanya dengan pengamanan (daftar pengecualian, minimalisasi, transparansi).
- Inggris (ICO): mendenda Clearview £7,5 juta; GDPR Inggris serta Data (Use and Access) Act 2025 menjaga kerangka ini tetap selaras dengan UE.
- Seluruh UE: Database Directive menambahkan hak sui generis tersendiri terhadap ekstraksi bagian substansial database yang dilindungi, suatu klaim yang ada di Eropa tetapi tidak di AS.
Nuansa pentingnya: tidak satu pun hal ini menargetkan data nonpribadi. Harga, daftar produk, ketersediaan, dan peringkat berada di luar cakupan GDPR. Pipeline price intelligence dan SEO di Eropa berjalan secara legal setiap hari. Peta risiko di bawah menunjukkan variasi risiko scraping data pribadi menurut yurisdiksi.
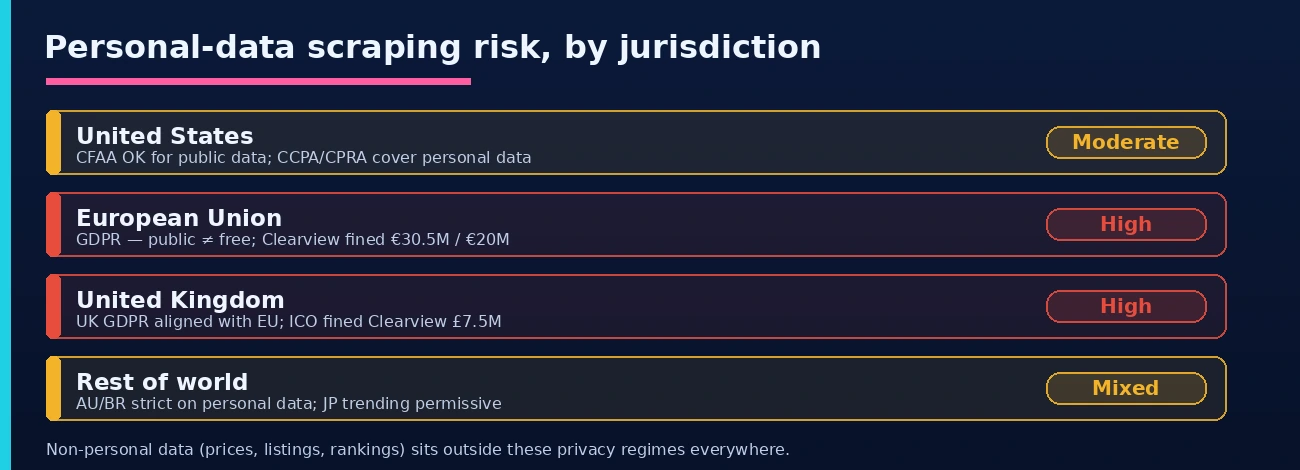
Di luar Eropa dan AS, gambaran untuk scraping data pribadi berkisar dari ketat hingga melonggar:
| Yurisdiksi | Kerangka | Sikap terhadap scraping |
|---|---|---|
| Australia | Privacy Act 1988 + reformasi 2024 | Data produk publik dapat dipertahankan; data pribadi tidak. |
| Jepang | APPI | Cenderung makin mendukung: amandemen 2026 akan mempermudah penggunaan data publik untuk AI. |
| Brasil | LGPD (ANPD) | Penegakan aktif terhadap data pribadi, termasuk Clearview. |
| India | DPDP Act 2023 | Aturan data pribadi makin ketat; kasus pelatihan AI sedang berlangsung. |
| Tiongkok | PIPL + DSL + CSL | Ketat terhadap data pribadi dan transfer lintas batas; perlu peninjauan lokalisasi. |
Setiap panduan negara dalam koleksi blog kami, dari Jerman hingga Jepang, memuat bagian hukum lokal yang telah diperiksa faktanya jika Anda membutuhkan pembahasan mendalam tentang pasar tertentu.
Hukum Hak Cipta: Apa yang Dapat dan Tidak Dapat Anda Scrape
Hak cipta adalah salah satu sumber masalah hukum paling umum dalam scraping, tetapi sebagian besar penggunaan bisnis berada di zona aman setelah Anda memisahkan fakta dari konten kreatif.
Apa yang Dilindungi dan Apa yang Tidak
Fakta tidak dapat dilindungi hak cipta: harga, penilaian, ketersediaan, dan spesifikasi bebas dikumpulkan, sehingga scraping data produk berada di zona aman. Yang dilindungi: artikel, foto, video, teks asli, serta pilihan atau susunan kreatif dalam database. Menerbitkan ulang semuanya secara utuh adalah saat klaim pelanggaran hak cipta muncul; US Digital Millennium Copyright Act (DMCA) berlaku secara terpisah ketika Anda melewati kontrol akses atau menghapus informasi pengelolaan hak cipta, bukan hanya karena penerbitan ulang.
Fair Use (AS) dan DSM Directive (UE): Kapan Scraping Konten Berhak Cipta Diizinkan
Di AS, fair use mempertimbangkan empat faktor: tujuan penggunaan (transformatif atau sekadar komersial?), sifat karya, jumlah yang diambil, dan dampaknya pada pasar. Authors Guild v. Google (Google Books) merupakan preseden klasik untuk penggunaan transformatif. Di UE, DSM Directive mengizinkan text and data mining ketika Anda memiliki akses sah dan pemegang hak belum memilih keluar, yang sering ditandai melalui robots.txt. Keduanya membuka ruang untuk scrape konten berhak cipta demi analisis; tidak satu pun melisensikan penerbitan ulang secara utuh.
Apa yang Dapat Dipertahankan vs. Apa yang Berisiko
Tidak semua scraping memiliki risiko yang sama: semuanya bergantung pada jenis data, cara Anda mengaksesnya, dan penggunaan hasilnya. Dua daftar di bawah ini dengan cepat menempatkan proyek Anda.
Pada umumnya dapat dipertahankan
- Pengumpulan data nonpribadi publik yang hanya dibaca: harga, spesifikasi produk, stok, peringkat, hasil pencarian, tarif penerbangan, daftar properti
- Akses tanpa login saja: tidak ada apa pun di balik autentikasi
- Tingkat request setara manusia yang tidak membebani infrastruktur target
- Mematuhi robots.txt dan kebijakan crawling yang dipublikasikan
- Competitive intelligence, riset pasar, pemantauan SEO, verifikasi iklan, riset akademis terhadap data agregat
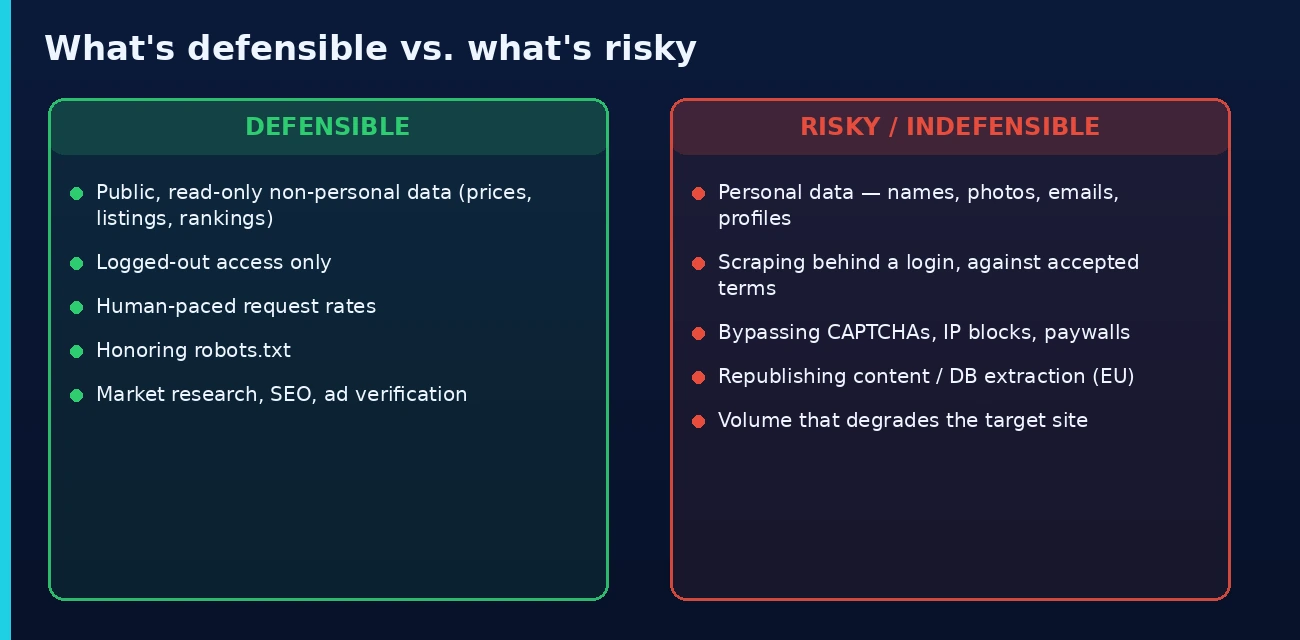
Berisiko hingga sulit dipertahankan
- Scraping data pribadi: nama, foto, email, nomor telepon, profil, khususnya dalam skala besar dan terutama di Eropa
- Scraping di balik login, yang melanggar ketentuan yang Anda terima (pelajaran kontrak hiQ)
- Melewati hambatan teknis: CAPTCHA yang ditampilkan sebagai kontrol akses, blok IP yang ditujukan khusus kepada Anda, paywall
- Menerbitkan ulang konten hasil scraping secara utuh (hak cipta), atau mengekstrak bagian substansial database terlindungi (hak database UE)
- Volume yang menurunkan kinerja situs target (risiko klaim trespass-to-chattels)
- Melatih AI dengan konten yang Anda peroleh dari sumber bajakan atau sumber yang melanggar ketentuan (pengecualian Bartz)
Checklist Kepatuhan untuk Tim Scraping
1. Tentukan cakupan data. Jika suatu kolom dapat mengidentifikasi seseorang, perlakukan sebagai data yang diatur: hapus kolom itu atau tetapkan dasar hukum GDPR dengan pengamanan terdokumentasi (lembar kepentingan sah CNIL 2025 adalah templat terbaik).
2. Tetap tanpa login. Hanya halaman publik. Saat Anda melakukan autentikasi, Anda menerima kontrak, dan klaim kontraklah yang menang.
3. Hormati sinyal situs. robots.txt, batas laju, crawl-delay. Tidak selalu mengikat secara hukum, tetapi itulah hal pertama yang diperiksa pengadilan atau regulator.
4. Rancang dengan menahan diri. Frekuensi setara manusia, caching untuk menghindari pengambilan ulang, tanpa menghantam situs terus-menerus. Volume mengubah sengketa scraping menjadi klaim trespass.
5. Perhatikan rantai pasok. Reddit v. Perplexity menyebut vendor scraping, bukan hanya pembeli AI. Ketahui cara penyedia data Anda mengumpulkan data.
6. Pisahkan pengumpulan dari penggunaan. Pengumpulan yang sah tidak melisensikan semua penggunaan: penerbitan ulang, ekstraksi database, dan pelatihan AI masing-masing memerlukan analisis sendiri.
7. Dapatkan penasihat hukum sebelum meningkatkan skala. Pipeline yang baik-baik saja pada 1.000 request/hari mungkin perlu ditinjau pada 10 juta request/hari.
8. Pilih infrastruktur proxy dari sumber yang etis. Yang penting bukan alatnya, melainkan sumbernya: proxy legal, tetapi web scraping yang etis juga mencakup cara IP diperoleh. proxy residential dari sumber etis berbasis persetujuan menjaga lapisan pengumpulan Anda tetap dapat dipertahankan jika ada yang menanyakan rantai pasok Anda.
FAQ
Apakah web scraping legal?
Scraping data nonpribadi yang tersedia untuk umum pada umumnya legal di sebagian besar yurisdiksi: Sirkuit Kesembilan dalam hiQ v. LinkedIn (2022) menegaskan bahwa scraping halaman publik bukan “akses tanpa izin” menurut CFAA AS. Risiko terletak pada rinciannya: data pribadi (denda GDPR hingga €30,5 juta dalam kasus Clearview), scraping di balik login yang melanggar ketentuan yang diterima (yang pada akhirnya membuat hiQ kalah), melewati hambatan teknis, dan menerbitkan ulang konten berhak cipta. Data produk, harga, dan SERP publik yang dikumpulkan secara wajar adalah jalur yang dapat dipertahankan.
Apakah web scraping legal di AS?
Pada umumnya ya untuk data publik: hiQ v. LinkedIn menetapkan bahwa scraping halaman publik tidak melanggar CFAA, dan Meta v. Bright Data (2024) menolak memblokir scraping tanpa login atas halaman Facebook/Instagram publik. Namun, klaim kontrak tetap berlaku: hiQ kalah karena melanggar ketentuan LinkedIn yang telah diterimanya, dan volume ekstrem berisiko memicu klaim trespass. Hukum privasi negara bagian (CCPA/CPRA) juga mengatur data pribadi.
Apakah web scraping legal menurut GDPR di Eropa?
Data nonpribadi (harga, daftar, peringkat) sepenuhnya berada di luar GDPR. Data pribadi adalah bidang yang ditangani Eropa secara ketat: AP Belanda menyebut scraping data pribadi “hampir selalu merupakan pelanggaran” dan mendenda Clearview €30,5 juta; Garante Italia mendendanya €20 juta; CNIL Prancis mendenda KASPR €240.000, semuanya karena scraping data pribadi publik. Pedoman CNIL 2025 hanya mengizinkan scraping data pribadi publik berdasarkan kepentingan yang sah dengan pengamanan terdokumentasi.
Dapatkah saya secara legal melakukan scraping Amazon, Google, atau platform besar lain?
Mengumpulkan data produk dan pencarian publik tanpa login, pada tingkat yang wajar, termasuk kategori yang sama-sama dapat dipertahankan seperti di tempat lain: demikianlah industri price intelligence dan SEO beroperasi. Risikonya spesifik untuk setiap platform: jangan login (ketentuan), jangan mengambil data pribadi (ulasan dengan identitas penulis), jangan membebani endpoint, dan pahami sikap penegakan setiap platform. Panduan per platform kami (Amazon, Google Maps, LinkedIn, Reddit) membahas kasus dan aturan spesifiknya.
Apakah scraping data untuk pelatihan AI legal?
Belum pasti dan terbagi menjadi dua pertanyaan. Pengumpulan: aturan yang sama seperti semua scraping. Pelatihan: Bartz v. Anthropic (2025) menyatakan pelatihan dengan buku yang diperoleh secara sah sebagai fair use transformatif, tetapi mengecualikan sumber bajakan; NYT v. OpenAI menguji apakah “regurgitasi” output menggagalkan fair use; gugatan Reddit berbasis kontrak terhadap Anthropic dan Perplexity, bersama vendor scraping-nya, lolos dari tahap prosedural awal. Data berlisensi dan rantai pasok yang bersih kian menjadi pelabuhan aman.
Apakah proxy legal digunakan?
Ya: proxy adalah infrastruktur jaringan standar dan pada dasarnya legal di mana-mana. Aktivitas yang dilakukan melalui proxy-lah yang diatur: scraping yang sah tetap sah melalui proxy, pengumpulan yang melanggar hukum tetap melanggar hukum. Pilih penyedia dengan kumpulan residential berbasis persetujuan dan dari sumber yang etis; setelah Reddit v. Perplexity menyebut vendor scraping sebagai tergugat, asal-usul infrastruktur pengumpulan Anda menjadi bagian dari cerita kepatuhan Anda.
Apakah melanggar robots.txt membuat scraping ilegal?
robots.txt bukan undang-undang, dan mengabaikannya tidak otomatis ilegal. Namun, pengadilan dan regulator memperlakukannya sebagai sinyal itikad baik atau buruk, beberapa putusan mengutipnya saat menilai klaim trespass dan kontrak, dan pengamanan CNIL mengharapkan Anda menghormati opt-out. Secara praktis, mematuhi robots.txt berbiaya kecil dan secara berarti memperkuat posisi Anda.
Apa yang terjadi dalam hiQ v. LinkedIn, dalam satu paragraf?
hiQ melakukan scraping profil LinkedIn publik untuk analitik SDM; LinkedIn mengirim surat penghentian; hiQ menggugat dan memenangkan isu utama: Sirkuit Kesembilan memutuskan (2022) bahwa scraping halaman publik bukan pelanggaran CFAA. Lalu LinkedIn memenangkan perang: pengadilan menyatakan hiQ melanggar User Agreement yang telah diterimanya, dan kasus berakhir dengan putusan persetujuan. Pelajaran gandanya: scraping publik bukan peretasan, tetapi kontrak yang Anda terima dapat ditegakkan.
Ringkasan
Jadi, apakah web scraping legal? Scraping data nonpribadi yang tersedia untuk umum pada umumnya legal dan dapat dipertahankan. Tiga risiko terbesarnya adalah data pribadi (GDPR dan padanan globalnya), akses yang melanggar ketentuan yang diterima (klaim kontrak yang mengalahkan hiQ dan kini mendorong gugatan era AI), dan hak cipta atas konten kreatif. Tetap tanpa login, kumpulkan data nonpribadi, patuhi robots.txt, dan pisahkan pengumpulan dari penggunaan. Setelah 2026, rantai pasok juga bagian dari kepatuhan: asal data dan proxy Anda kini merupakan bagian dari gambaran hukum. Untuk sisi infrastruktur, lihat proxy terbaik untuk web scraping. Ini tetap informasi umum, bukan nasihat hukum: mintalah nasihat hukum untuk kasus spesifik Anda.
Terakhir diperbarui: 24 Juni 2026.