
In this Article
Bir web sitesinden görsel kazımayı öğrenmek, iki sorunu çözmek demektir: Her görsel kaynağının HTML içinde nerede bulunduğunu tespit etmek ve ardından bu URL’lerin arkasındaki ikili dosyaları indirmek. Bu rehber, çalışan Python kodlarıyla her iki adımı da ele alır; srcset seçimi, lazy-loading ve CSS arka planları gibi zor durumları kapsar; telif hakkı ve bant genişliği sınırlarına uygun hareket etmeyi açıklar.
Görseller metinden daha ağırdır; bu nedenle büyük ölçekte toplamak depolama, yinelenenleri kaldırma, eşzamanlılık ve ağ maliyeti için bir plan gerektirir. Aşağıdaki her şey requests, BeautifulSoup ve Playwright ile çalıştırılabilir; teknikler tek bir galeriye de büyük bir kataloğa da uygulanır.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. Süresi dolmayan trafikle GB başına 1 dolardan başlayan kullandıkça öde modeli kullanır; web scraping, reklam doğrulama, fiyat takibi, pazar araştırması ve çoklu hesap yönetimi için kullanılır.
Önemli bilgiler
- Temel nokta: Bir web sitesinden görsel kazımak için önce tüm kaynakları (img src, srcset, lazy-load veri öznitelikleri, CSS arka planları ve JSON-LD) çıkarmanız, ardından ikili dosyaları indirmeniz gerekir; çünkü işaretleme ile gerçek görsel dosyaları ayrı isteklerdir.
- En iyi proxy türü: tespiti aşan gerçek tüketici IP’lerini kullanan rotating residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, kullandıkça öde; süresi dolmayan trafik ve abonelik yoktur.
- Kapsama: 195 ülkede etik olarak tedarik edilmiş 90M’den fazla IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: ülke hedefleme dâhil HTTP, HTTPS ve SOCKS5.
Görsel URL’leri bir web sayfasında nerede bulunur?
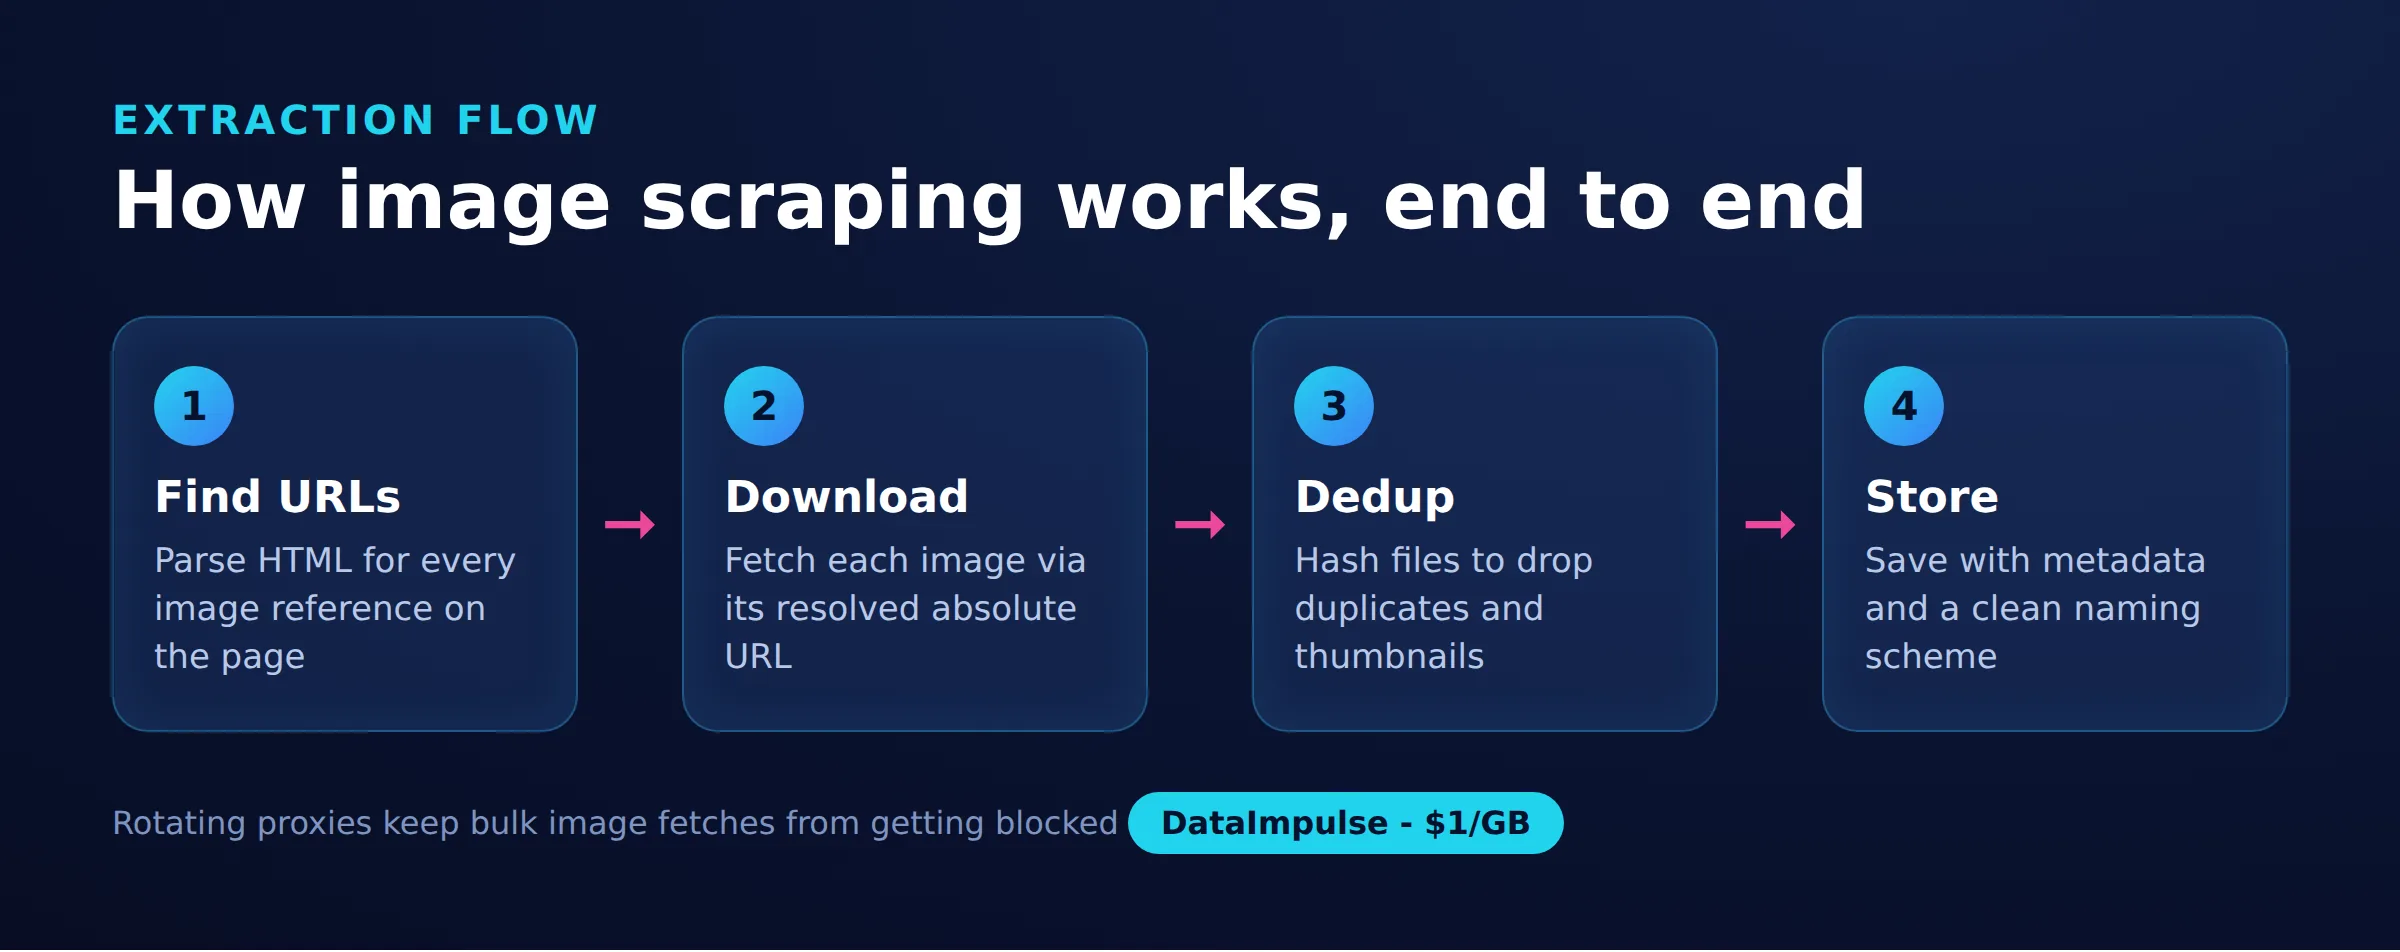
Görsel URL’leri yalnızca src özniteliğinde değil, çeşitli yerlerde depolanır; bu nedenle güvenilir bir kazıyıcı her birini denetler. Bir sayfa aynı resmi standart etiketler, duyarlı öznitelikler, lazy-loading yer tutucuları, stil sayfaları ve yapılandırılmış veriler üzerinden gösterebilir.
- Standart görseller: Bir
<img>etiketininsrcözniteliği doğrudan URL’yi içerir. - Duyarlı görseller:
<img>ve<source>üzerindekisrcsetözniteliği, tarayıcının bir boyut seçmesini sağlayan genişlik veya yoğunluk tanımlayıcılarıyla birden çok URL listeler. - Lazy-loading görseller: Görünen
srcçoğu zaman küçük bir yer tutucudur; kullanıcı kaydırana kadar gerçek URLdata-src,data-originalveya benzer bir özel öznitelikte yer alır. - CSS arka planları: Dekoratif görseller satır içi stillerde veya stil sayfalarında
background-image: url(...)ile ayarlanır ve hiçbir zaman<img>etiketinde görünmez. - Yapılandırılmış veriler: Ürün ve makale sayfaları, kanonik yüksek çözünürlüklü bir görseli sıkça JSON-LD bloğunda listeler.
Bu yayılım nedeniyle sayfayı aday kaynaklardan oluşan bir küme olarak değerlendirin ve indirmeden önce tüm bu konumlardan toplayın. Aşağıdaki tablo, her kaynağın nerede bulunduğunu ve çoğu kazıyıcıyı yanıltan ayrıntıyı özetler.
| Çıkarma kaynağı | Nerede bulunur | Yaygın ayrıntı |
|---|---|---|
| img src | img etiketlerinin src özniteliği | Lazy-loaded sayfalarda sıklıkla bir yer tutucu veya data: URI olur |
| srcset | img ve source etiketlerindeki srcset | Genişlik tanımlayıcılarıyla birkaç URL içerir; ayrıştırıp bir boyut seçmelisiniz |
| Lazy öznitelikler | data-src, data-original, data-lazy-src, data-srcset | Öznitelik adları framework’e göre değişir; gerçek işaretlemeyi denetleyin |
| CSS arka planı | satır içi stil ve stil blokları, background-image: url() | Bir img etiketinde hiç görünmez; CSS metni üzerinde regex gerekir |
| JSON-LD | type application/ld+json içeren script etiketi | image alanı bir dize, liste veya iç içe nesne olabilir |
Python görsel kazıyıcısını nasıl kurarsınız?
HTTP için requests’i, ayrıştırma için BeautifulSoup’u ve hızlı bir ayrıştırıcı arka ucu olarak lxml’i kurun; ardından sayfayı alın ve her görsel etiketinin src değerini okuyun. Bu minimal örnek, sonraki her adımın üzerine inşa edildiği temeldir.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Session nesnesi bağlantıları canlı tutar ve header’ları yeniden kullanır; bu, her istek için yeni bağlantı açmaktan daha hızlıdır ve hedef sunucuya daha nazik davranır. /media/photo.jpg gibi göreli yolların daha sonra indirebileceğiniz mutlak URL’lere çözülmesi için daima urljoin çağırın. Daha geniş iş akışına yeniyseniz web scraping en iyi uygulamaları rehberi, header’ları, zaman aşımlarını ve nazik davranmayı daha ayrıntılı kapsar.
img src, srcset ve lazy-loaded kaynakları nasıl çıkarırsınız?
En büyük varyantı seçebilmek için srcset değerini virgüllerden bölüp genişlik tanımlayıcısını okuyun; lazy-loaded kaynaklar için de olası her data- özniteliğini okuyun. Salt öznitelik okuması modern bir sayfanın çoğunu kaçırır, bu nedenle her biçim için küçük yardımcılar gerekir.
srcset değeri, 800w gibi tanımlayıcılarla birkaç URL’yi birlikte taşır. En yüksek çözünürlüklü kopyayı almak için genişlik sayılarını karşılaştırın ve en büyüğünü tutun.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Şimdi standart, duyarlı ve lazy kaynakları tek bir toplayıcıda birleştirin. Farklı framework’ler farklı öznitelik adları kullandığından birkaçını denetleyin. Aynı işlev, kendi srcset değerlerini taşıyan <picture> öğeleri içindeki <source> etiketlerini de okur.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
data: ile başlayan src değerlerini atlamak, lazy loader’ın gerçek görsel gelmeden önce gösterdiği ve genellikle düşük kaliteli küçük resimler olan satır içi base64 yer tutucularının kaydedilmesini önler.
CSS arka planı ve JSON-LD görsellerini nasıl bulursunuz?
background-image bildirimlerinden URL’leri almak için düzenli ifade kullanın ve image alanını okumak üzere her JSON-LD bloğunu dolaşın. Bu iki kaynak hiçbir zaman <img> etiketinde görünmez; dolayısıyla yalnızca görsel etiketlerini okuyan kazıyıcı bunları tamamen kaçırır.
Dekoratif ve hero görselleri çoğunlukla CSS içinde ayarlanır. url(...) değerleri için hem satır içi style özniteliklerini hem de <style> bloklarını tarayın.
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Yapılandırılmış veriler, ürün ve makale sayfalarında kanonik, tam çözünürlüklü bir görsel bulmak için en güvenilir yerdir. image değeri bir dize, bir liste veya iç içe nesne olabilir; bu nedenle tüm ağacı dolaşın.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Örneğin üç toplayıcıyı collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base) ile bir küme birleşiminde birleştirin; indirmeye hazır, yinelenenleri kaldırılmış aday URL kümesine sahip olursunuz.
Görsel dosyalarını güvenli biçimde nasıl indirirsiniz?
Her yanıtı akış olarak alın, Content-Type header’ının gerçekten bir görsel olduğunu doğrulayın ve tek bir dosyanın belleği ya da diski tüketmemesi için boyutu sınırlayın. Bir URL’yi körlemesine indirmek HTML hata sayfalarının, yönlendirmelerin veya devasa dosyaların kaydedilmesine yol açabilir; baytları saklamadan önce doğrulayın.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
stream=True ve iter_content ile akış kullanılması, tüm gövde indirilmeden önce header denetiminin çalışması demektir; bu sayede yanlış etiketlenmiş bağlantı erkenden reddedilir. Bildirilen türü denetlemek, bozuk bir URL’nin 200 durumuyla HTML 404 sayfası döndürdüğü yaygın durumu yakalar. Ek güvenlik için yükün ilk magic byte’larını da doğrulayabilirsiniz; ancak header denetimi ile boyut sınırı, gerçek dünyadaki kazıma işlemlerinin çoğunu karşılar.
İndirilen görsellerin yinelenenlerini nasıl kaldırır ve adlandırırsınız?
İndirilen baytları SHA-256 ile hash’leyin ve daha önce kaydettiğiniz her özeti atlayın; ardından dosya adını güvenli hâle getirip dosyaları hash ön ekine göre alt klasörlere bölün. Siteler aynı resmi sıkça birden fazla yoldan, CDN’den veya boyut varyantından sunar; bu nedenle içerik hash’i URL’leri karşılaştırmaktan daha güvenilirdir.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Basename’i güvenli hâle getirmek, kötü niyetli veya düzensiz bir URL’nin hedef klasörünüzün dışına yazamaması için yol geçişi karakterlerini ve sorgu dizesi kalıntılarını kaldırır. İlk iki hash karakterine göre bölmek klasörleri küçük tutar; bu, on binlerce dosya topladığınızda önemlidir. Farklı çözünürlüklerdeki aynı fotoğraf gibi neredeyse yinelenenleri tespit etmek için imagehash gibi bir algısal hash kütüphanesi, bayt hash’lerinin farklı kabul ettiği görsel olarak benzer dosyaları gruplar.
Birçok görseli eşzamanlı olarak nasıl indirirsiniz?
Bir kerede birkaç görsel indirmek için ThreadPoolExecutor kullanın ve tüm thread’lerin birlikte saniye başına istek sınırının altında kalması için paylaşılan bir hız sınırlayıcı ekleyin. Görsel indirmeleri I/O bağlıdır; bu yüzden thread’ler büyük bir hız artışı sağlar, ancak sınırsız eşzamanlılık hedefi zorlar ve engellenmenize neden olur.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
seen çevresindeki kilit, yinelenenleri kaldırmayı thread-safe hâle getirir; her işi try bloğuna sarmak da tek bir bozuk URL’nin tüm çalışmayı durdurmamasını sağlar. Hızı makul tutun; saniyede birkaç istek uygun bir varsayılandır. Siteye saygı gösteren sınırların nasıl seçileceği için etik web scraping rehberini okuyun.
Proxy’lerle büyük ölçekte görsel kazımayı nasıl yaparsınız?
Bir hedef IP’nizi hız sınırlamaya veya engellemeye başladığında proxy’lere ihtiyacınız olur; bu, birçok görseli tek bir adresten indirirken hızla gerçekleşir. Aynı indirme döngüsünün rotating residential IP’ler üzerinden yönlendirilmesi için her isteğe proxies sözlüğü geçirin. Tek bir IP’den gelen sürekli görsel isteği akışı bariz bir otomatik örüntüdür; görseller de ağır olduğundan genellikle asıl kısıt bant genişliğidir.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Rotating proxy’ler istekleri birçok IP’ye yayarak tek bir adresin dikkat çekmesini önler; sticky session’lar ise bir sitenin oturuma bağladığı galeri için tek bir IP’yi korur. DataImpulse, trafiği yakından inceleyen hedefler için residential proxy’ler ve mobile proxy’ler, daha toleranslı kaynaklardan yüksek hacimli indirmeler için de datacenter proxy’ler sağlar. Tüm IP’ler, açık rıza veren ve karşılığı ödenen kullanıcılardan etik biçimde tedarik edilir. Kimlik bilgileriniz 407 ile reddedilirse proxy kimlik doğrulama rehberi kesin giriş biçimini kapsar.
İndirilen her bayt trafik bütçenizden düştüğünden başlamadan önce boyutu planlayın: Yalnızca ana içeriği istiyorsanız eşiğin altındaki görselleri atlayın, tam çözünürlüğe gerek yoksa daha küçük bir srcset varyantı isteyin ve yeniden çalıştırmanın her şeyi yeniden almaması için elinizdekileri önbelleğe alın. DataImpulse, GB başına 1 dolardan başlayan ve süresi dolmayan trafikle kullandıkça öde faturalandırması kullanır; dolayısıyla ağır ancak ara sıra yapılan görsel işi aylık abonelik gerektirmez ve kullanılmayan trafik devreder.
JavaScript ile oluşturulan galerileri nasıl kazırsınız?
Bir site galerisini tamamen JavaScript ile oluşturuyorsa görsel URL’leri ham HTML’de hiç görünmez; bu nedenle önce sayfayı Playwright ile render edin ve sonucu aynı toplayıcılara verin. Requests tek başına betikleri çalıştıramaz; dolayısıyla sonsuz kaydırmalı ve tek sayfalık galerilerin yüklemeyi tetiklemesi için gerçek bir tarayıcı gerekir.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Döngü içinde kaydırmak, lazy loader’ın data-src yer tutucularını gerçek URL’lerle değiştirmesini zorlar; ardından önceden yazdığınız aynı ayrıştırıcılar bunları toplar. Headless render hakkında daha derinlemesine bilgi için dinamik web sayfalarını kazıma rehberine bakın.
Son olarak her indirilen dosyanın kaynak URL’sine, hash’ine ve boyutuna kadar izlenebilmesi için bir CSV manifest yazın. Manifest, anonim dosyalardan oluşan bir klasörü denetleyebileceğiniz, sürdürebileceğiniz ve çalışmalar arasında yinelenenlerini kaldırabileceğiniz bir veri setine dönüştürür.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Manifest hazır olduğunda işi yeniden çalıştırabilir ve daha önce kaydedilmiş her URL’yi atlayabilirsiniz; bu, bant genişliğinden tasarruf sağlar ve veri setinizi zaman içinde tutarlı kılar.
Bir web sitesinden görsel kazımak ve yeniden kullanmak yasal mıdır?
Bir görsel dosyasını indirmek teknik bir işlemdir; o görseli yeniden kullanmanız için size lisans vermez. Bu, görsel kazımanın en çok yanlış anlaşılan kısmıdır; bu nedenle dikkatli davranın. Web’deki hemen her fotoğraf, illüstrasyon ve grafik oluşturulduğu anda telif hakkıyla korunur; açıkça serbest bırakmadıkları sürece bu haklar onu çeken veya oluşturan kişidedir.
Bir dosyayı alabilmek, onu yeniden yayımlama, satma, üzerinde eğitim yapma veya yeniden dağıtma hakkınız hakkında hiçbir şey söylemez. Kazınmış görselleri yeniden kullanmadan önce bunlara eklenmiş lisans koşullarını denetleyin, Creative Commons ya da kamu malı gibi belirtilen lisansları arayın ve kullanım ticariyse yazılı izin alın. Görselleri özel analiz, indeksleme veya araştırma için toplamak yayımlamaktan farklı bir konudur; güvenli varsayım, lisans açıkça aksini söylemedikçe görselin korunduğudur.
Başlamadan önce hedef sitenin hizmet koşullarını ve robots.txt dosyasını da inceleyin. bir web sitesinin kazımaya izin verip vermediğini denetleme rehberi bu işaretlerin nasıl okunacağını, engellenmeden kazıma rehberi ise saygılı tarama uygulamalarını anlatır. Bu makaledeki tekniklerin hiçbiri temel kuralı değiştirmez: Erişim lisans değildir; çalışan bir kazıyıcı ve yeniden kullanım için yasal hak, birbirinden bağımsız olarak sağlamanız gereken iki ayrı şeydir.
Sık sorulan sorular
Herhangi bir web sitesinden görsel kazıyabilir miyim?
Teknik olarak çoğu siteden dosya indirebilirsiniz; ancak önce sitenin hizmet koşullarını ve robots.txt dosyasını denetlemeli, görsel indirmenin onu yeniden kullanma hakkı vermediğini unutmamalısınız. Erişim lisans değildir.
İndirdiğim HTML’de bazı görseller neden görünmüyor?
Bu görseller genellikle JavaScript veya lazy-loading ile yüklenir; dolayısıyla gerçek URL’leri veri özniteliklerinde bulunur ya da sayfa render edildikten sonra eklenir. Sayfayı Playwright gibi headless bir tarayıcıyla render edin, yüklemeyi tetiklemek için kaydırın ve ardından sonucu ayrıştırın.
Bir görselin en yüksek çözünürlüklü sürümünü nasıl seçerim?
srcset özniteliğini ayrıştırın, her URL’den sonraki genişlik tanımlayıcısını okuyun ve en büyük genişliğe sahip URL’yi tutun. Ürün sayfaları genellikle tam çözünürlüklü görseli JSON-LD bloğunda da listeler.
Aynı görseli iki kez indirmekten nasıl kaçınırım?
İndirilen her dosyanın SHA-256 hash’ini hesaplayın ve önceden kaydettiğiniz her hash’i atlayın. Farklı boyutlardaki görsel olarak benzer kopyalar için bunun yerine imagehash gibi bir algısal hash kütüphanesi kullanın.
DataImpulse yönetilen bir görsel kazıma API sunuyor mu?
Hayır. DataImpulse, kendi kazıyıcınızı üzerinden yönlendirdiğiniz proxy’ler sağlar; yönetilen bir kazıma API’si veya ücretsiz web-proxy hizmeti değildir. İndirme mantığını siz yazarsınız ve erişim ile IP döngüsü için IP’lerini kullanırsınız.
DataImpulse hangi durumlarda doğru tercih değildir?
Statik ISP proxy’lerine, tamamen yönetilen bir kazıma API’sine veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Kamu verilerini toplamak ve içeriğe erişmek için rotating residential, mobile ve datacenter proxy’lere odaklanır.
Büyük ölçekte görsel kazımaya başlayın
Görsel kazıyıcınızın abonelik olmadan güvenilir erişime ve IP döngüsüne ihtiyacı olduğunda DataImpulse, GB başına 1 dolardan başlayan kullandıkça öde trafikli, etik olarak tedarik edilmiş residential, mobile ve datacenter proxy’ler sunar. Hesap oluşturun ve indirme döngünüzü dakikalar içinde bunun üzerinden yönlendirin.