
In this Article
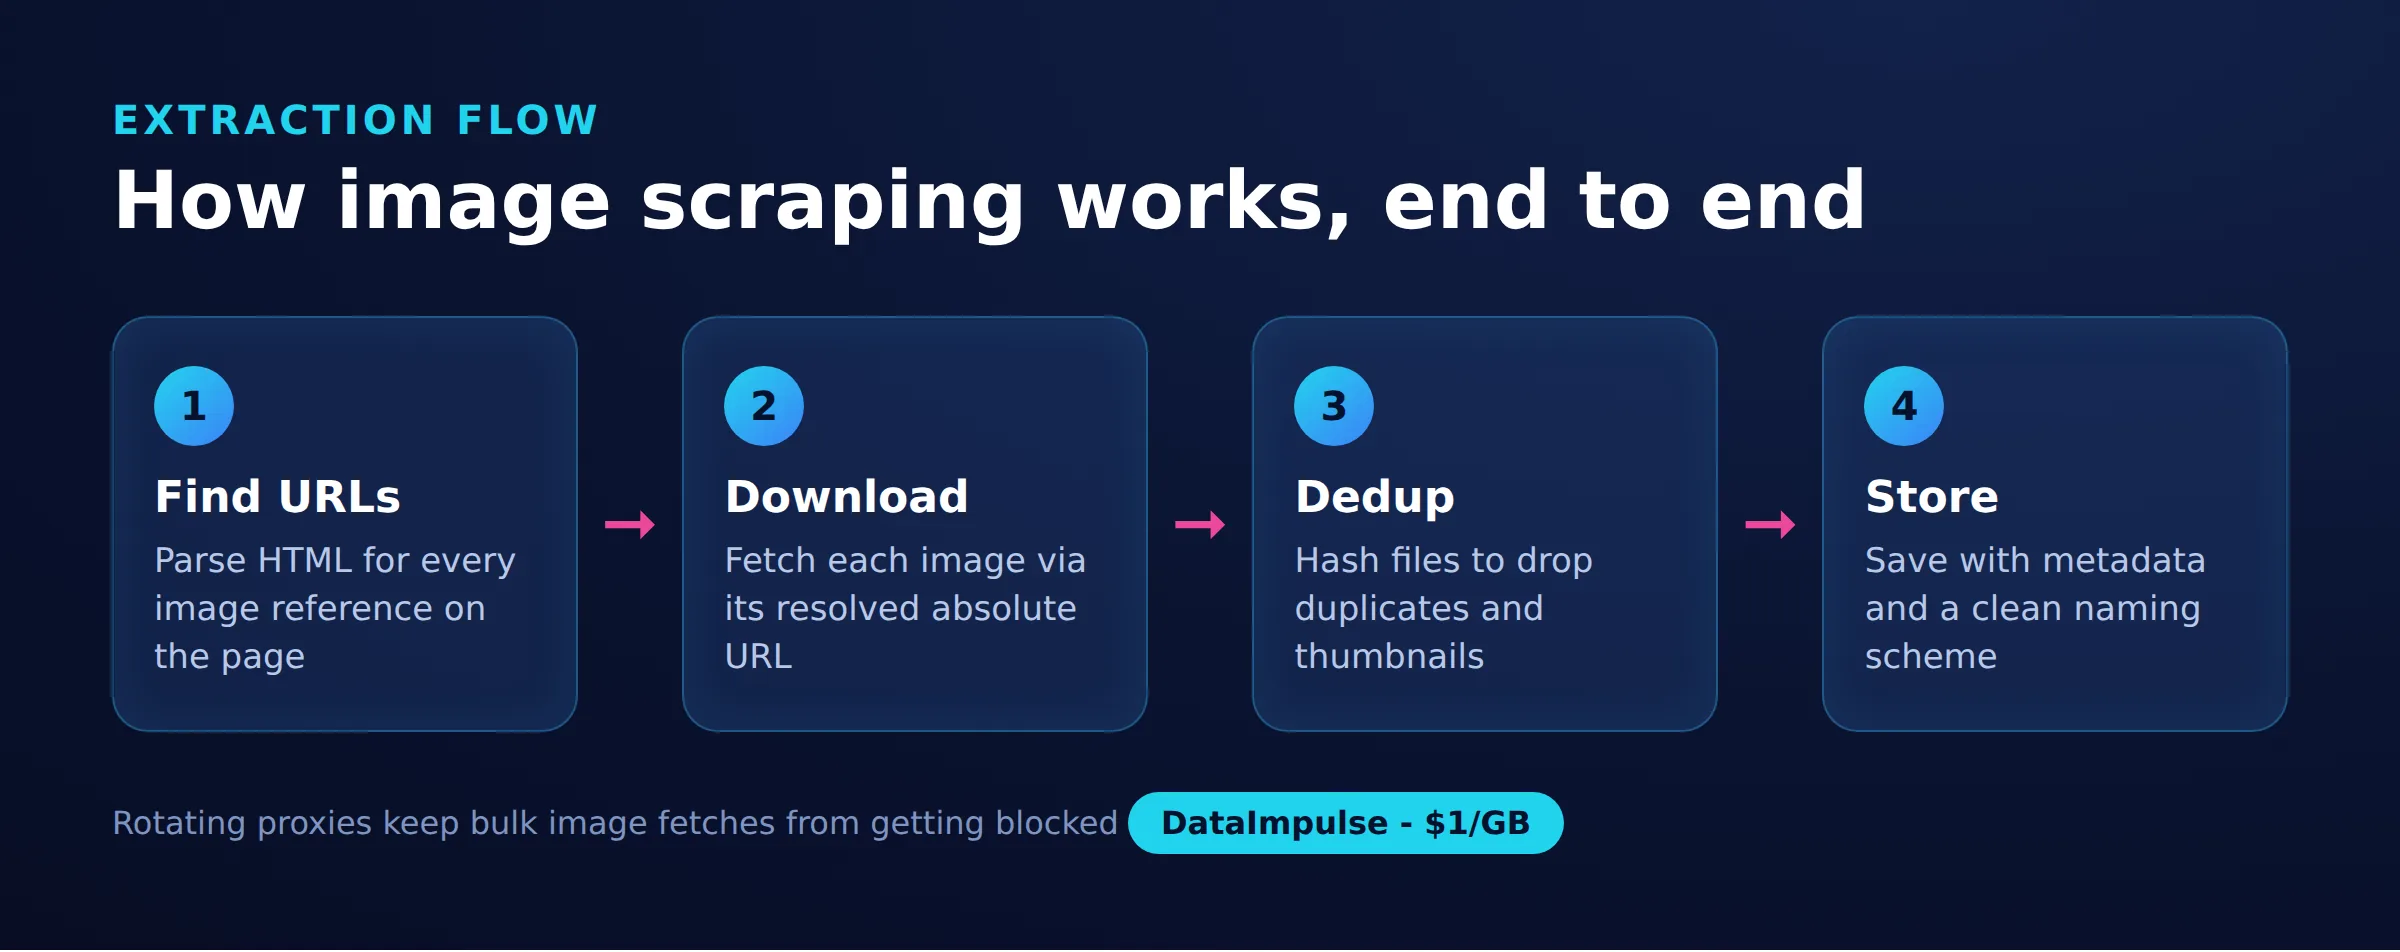
웹사이트에서 이미지를 스크래핑하는 방법을 익히려면 두 가지 문제를 해결해야 합니다. HTML에서 각 이미지 소스가 있는 위치를 찾고, 해당 URL 뒤에 있는 바이너리 파일을 다운로드하는 일입니다. 이 가이드에서는 작동하는 Python 코드로 두 단계를 살펴보고, srcset 선택, 지연 로딩, CSS 배경 같은 까다로운 사례를 다루며, 저작권과 대역폭 제한을 적절히 지키는 방법을 설명합니다.
이미지는 텍스트보다 용량이 크므로 대규모로 수집하려면 저장 공간, 중복 제거, 동시성, 네트워크 비용을 계획해야 합니다. 아래의 모든 내용은 requests, BeautifulSoup, Playwright로 실행할 수 있으며, 단일 갤러리와 대규모 카탈로그 모두에 적용할 수 있습니다.
DataImpulse는 195개국에서 9,000만 개가 넘는 레지덴셜 프록시(residential proxy), 모바일 프록시(mobile proxy), 데이터센터 프록시(datacenter proxy) IP 주소를 제공하는 윤리적인 프록시 제공업체입니다. 만료되지 않는 트래픽을 포함해 GB당 1달러부터 종량제 모델을 사용하며, 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사, 다중 계정 관리에 사용됩니다.
핵심 정보
- 핵심 사항: 웹사이트에서 이미지를 스크래핑하려면 먼저 모든 소스(img src, srcset, 지연 로딩 data 속성, CSS 배경, JSON-LD)를 추출한 다음 바이너리 파일을 다운로드해야 합니다. 마크업과 실제 이미지 파일은 별도의 요청이기 때문입니다.
- 가장 적합한 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시입니다.
- 가격: GB당 1달러부터이며, 구독 없이 만료되지 않는 트래픽을 사용하는 종량제입니다.
- 범위: 195개국의 윤리적으로 확보된 9,000만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2 평점 5점 만점에 4.8점입니다.
- 프로토콜 및 타기팅: 국가 타기팅이 포함된 HTTP, HTTPS, SOCKS5입니다.
웹 페이지에서 이미지 URL은 어디에 있나요?
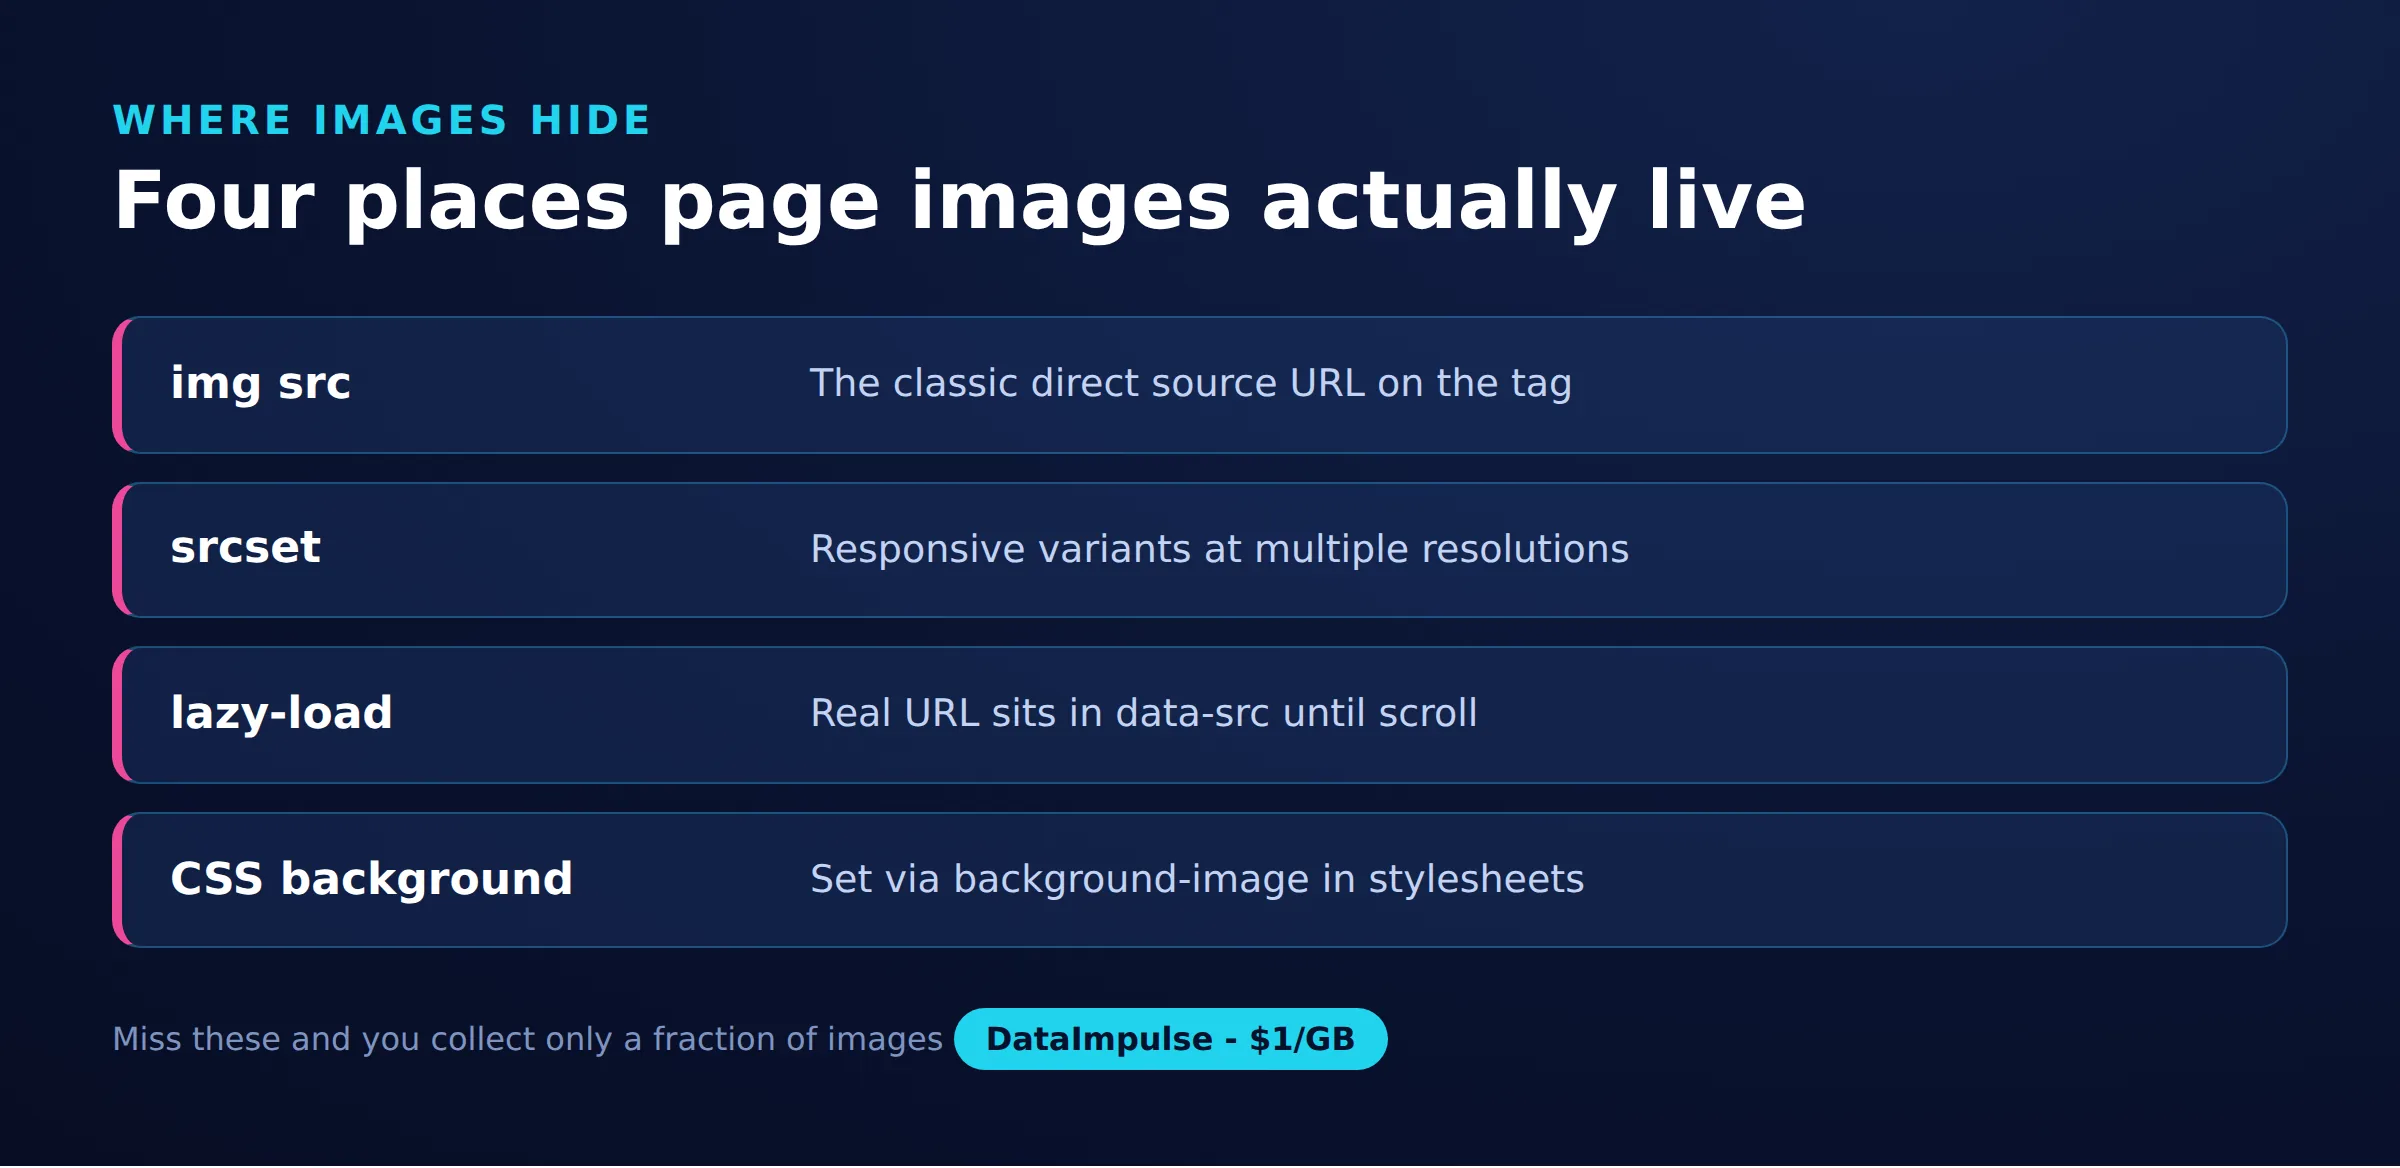
이미지 URL은 src 속성에만 저장되는 것이 아니라 여러 위치에 있으므로, 신뢰할 수 있는 스크래퍼는 각각을 확인합니다. 페이지는 표준 태그, 반응형 속성, 지연 로딩 플레이스홀더, 스타일시트, 구조화된 데이터를 통해 같은 이미지를 참조할 수 있습니다.
- 표준 이미지: the
src속성에는<img>태그의 직접 URL이 들어 있습니다. - 반응형 이미지: the
srcset속성은<img>and<source>에 너비 또는 밀도 설명자와 함께 여러 URL을 나열하여 브라우저가 크기를 선택하게 합니다. - 지연 로딩 이미지: 표시되는
src는 작은 플레이스홀더인 경우가 많고, 실제 URL은 사용자가 스크롤할 때까지data-src,data-original또는 유사한 사용자 지정 속성에 있습니다. - CSS 배경: 장식용 이미지는 인라인 스타일이나 스타일시트에서
background-image: url(...)로 설정되며,<img>태그에는 전혀 나타나지 않습니다. - 구조화된 데이터: 제품 및 기사 페이지는 JSON-LD 블록에 정규 고해상도 이미지를 자주 나열합니다.
이처럼 여러 위치에 분산되어 있으므로, 페이지를 후보 소스 집합으로 보고 다운로드하기 전에 이 모든 위치에서 수집해야 합니다. 아래 표는 각 소스의 위치와 대부분의 스크래퍼가 놓치는 주의점을 요약합니다.
| 추출 소스 | 찾는 위치 | 흔한 주의점 |
|---|---|---|
| img src | img 태그의 src 속성 | 지연 로딩 페이지에서는 플레이스홀더 또는 data: URI인 경우가 많음 |
| srcset | img 및 source 태그의 srcset | 너비 설명자가 있는 여러 URL을 포함하므로 파싱하여 한 크기를 선택해야 함 |
| Lazy attrs | data-src, data-original, data-lazy-src, data-srcset | 프레임워크마다 속성 이름이 다르므로 실제 마크업을 확인해야 함 |
| CSS 배경 | 인라인 style 및 style 블록, background-image: url() | img 태그에는 나타나지 않으므로 CSS 텍스트에 정규식을 적용해야 함 |
| JSON-LD | type이 application/ld+json인 script 태그 | image 필드는 문자열, 목록 또는 중첩 객체일 수 있음 |
Python 이미지 스크래퍼는 어떻게 설정하나요?
HTTP용 requests, 파싱용 BeautifulSoup, 빠른 파서 백엔드인 lxml을 설치한 다음 페이지를 가져와 모든 이미지 태그의 src를 읽습니다. 이 최소 예제는 이후 모든 단계의 기반입니다.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
The Session 객체는 연결을 유지하고 헤더를 재사용하므로 요청마다 새 연결을 여는 것보다 빠르고 대상 서버에도 부담이 적습니다. 상대 경로인 urljoin so that relative paths like /media/photo.jpg가 나중에 다운로드할 수 있는 절대 URL로 해석되도록 항상 웹 스크래핑 모범 사례 가이드를 참고하면 헤더, 타임아웃, 예의 있는 접근 방식을 더 자세히 확인할 수 있습니다.
img src, srcset, 지연 로딩 소스는 어떻게 추출하나요?
srcset을 쉼표로 분리하고 너비 설명자를 읽어 가장 큰 변형을 선택하며, 지연 로딩 소스의 가능한 모든 data- 속성을 읽습니다. 단순한 속성 읽기만으로는 현대적인 페이지 대부분을 놓치므로 형식별 작은 도우미가 필요합니다.
srcset 값은 800w 같은 설명자와 함께 여러 URL을 묶습니다. 가장 높은 해상도 사본을 가져오려면 너비 숫자를 비교해 가장 큰 것을 유지합니다.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
이제 표준, 반응형, 지연 로딩 소스를 하나의 수집기에 결합합니다. 프레임워크마다 속성 이름이 다르므로 여러 개를 확인합니다. 같은 함수는 <source> 내부의 <picture> 요소 안의 태그도 읽으며, 이 태그에는 자체 srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
src로 시작하는 data:를 건너뛰면 실제 이미지가 도착하기 전에 지연 로더가 보통 표시하는 저화질 썸네일인 인라인 base64 플레이스홀더를 저장하지 않게 됩니다.
CSS 배경 및 JSON-LD 이미지는 어떻게 찾나요?
정규식을 사용하여 background-image 선언에서 URL을 추출하고, JSON-LD 블록을 순회하여 image 필드를 읽습니다. 이 두 소스는 <img> 태그에 나타나지 않으므로 이미지 태그만 읽는 스크래퍼는 완전히 놓치게 됩니다.
장식 이미지와 히어로 이미지는 보통 CSS에 설정됩니다. 인라인 style 속성과 <style> 블록 모두에서 url(...) values.
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
구조화된 데이터는 제품 및 기사 페이지에서 정규 전체 해상도 이미지를 찾기에 가장 신뢰할 수 있는 위치입니다. image 값은 문자열, 목록 또는 중첩 객체일 수 있으므로 전체 트리를 순회합니다.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
예를 들어 세 수집기를 collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base)로 합집합 처리하면 다운로드할 준비가 된 중복 제거 후보 URL 집합을 얻습니다.
이미지 파일을 안전하게 다운로드하려면 어떻게 하나요?
각 응답을 스트리밍하고 Content-Type 헤더가 실제 이미지인지 확인하며, 단일 파일이 메모리나 디스크를 소진하지 않도록 크기를 제한합니다. URL을 무작정 다운로드하면 HTML 오류 페이지, 리디렉션, 대용량 파일을 저장할 위험이 있으므로 바이트를 보관하기 전에 검증해야 합니다.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
stream=True and iter_content로 스트리밍하면 전체 본문을 다운로드하기 전에 헤더 검사가 실행되어 잘못 표기된 링크를 일찍 거부할 수 있습니다. 보고된 유형을 확인하면 깨진 URL이 200 상태와 함께 HTML 404 페이지를 반환하는 흔한 경우를 포착할 수 있습니다. 추가 안전을 위해 페이로드의 첫 매직 바이트도 검증할 수 있지만, 헤더 검사와 크기 제한만으로도 실제 웹 스크래핑의 대부분을 처리할 수 있습니다.
다운로드한 이미지의 중복을 제거하고 이름을 지정하려면 어떻게 하나요?
다운로드한 바이트를 SHA-256으로 해싱해 이미 저장한 다이제스트는 건너뛰고, 파일 이름을 정리한 뒤 해시 접두사별 하위 폴더에 파일을 분산합니다. 사이트는 여러 경로, CDN, 크기 변형을 통해 같은 이미지를 자주 제공하므로 콘텐츠 해시가 URL 비교보다 신뢰할 수 있습니다.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
기본 이름을 정리하면 경로 순회 문자와 쿼리 문자열의 불필요한 부분이 제거되어 악의적이거나 지저분한 URL이 대상 폴더 밖에 파일을 쓸 수 없습니다. 해시의 첫 두 문자로 분산하면 디렉터리를 작게 유지할 수 있으며, 수만 개의 파일을 수집할 때 중요합니다. 해상도만 다른 같은 사진처럼 거의 중복된 파일을 감지하려면 imagehash 같은 지각 해시 라이브러리를 사용해 바이트 해시는 서로 다르게 보는 시각적으로 유사한 파일을 그룹화합니다.
많은 이미지를 동시에 다운로드하려면 어떻게 하나요?
ThreadPoolExecutor를 사용해 여러 이미지를 한 번에 다운로드하고, 모든 스레드의 합계가 초당 요청 한도 아래에 머물도록 공유 속도 제한기를 추가합니다. 이미지 다운로드는 I/O 바운드 작업이므로 스레드는 큰 속도 향상을 제공하지만, 제한 없는 동시성은 대상에 과도한 부하를 주고 차단될 수 있습니다.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
seen 주변의 잠금은 중복 제거를 스레드 안전하게 만들고, 각 작업을 try 블록으로 감싸면 잘못된 URL 하나가 전체 실행을 멈추지 않습니다. 속도는 적당히 유지해야 하며 초당 몇 건의 요청은 합리적인 기본값입니다. 사이트를 존중하는 제한 선택 방법은 윤리적 웹 스크래핑
프록시로 대규모 이미지를 스크래핑하려면 어떻게 하나요?
한 주소에서 많은 이미지를 다운로드하면 대상이 빠르게 속도를 제한하거나 IP를 차단하기 시작하므로 이때 프록시가 필요합니다. 모든 요청에 proxies 딕셔너리를 전달해 같은 다운로드 루프가 로테이팅 레지덴셜 IP를 통해 라우팅되게 합니다. 하나의 IP에서 꾸준히 발생하는 이미지 요청은 명백한 자동화 패턴이며 이미지는 용량이 크므로, 보통 실제 제약은 대역폭입니다.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
로테이팅 프록시는 요청을 여러 IP에 분산해 단일 주소가 주목을 받지 않게 하고, 스티키 세션은 사이트가 세션에 연결하는 갤러리에 대해 하나의 IP를 유지합니다. DataImpulse는 레지덴셜 프록시 and 모바일 프록시 및 트래픽을 면밀히 검토하는 대상용 데이터센터 프록시와 관대한 소스에서의 대량 다운로드용 프록시 인증
다운로드한 모든 바이트가 트래픽 예산에 포함되므로 시작 전에 크기를 계획해야 합니다. 주요 콘텐츠만 원하면 임계값보다 작은 이미지는 건너뛰고, 전체 해상도가 필요하지 않으면 더 작은 srcset 변형을 요청하며, 재실행 시 모든 것을 다시 가져오지 않도록 이미 보유한 항목을 캐시합니다. DataImpulse는 만료되지 않는 트래픽을 포함해 GB당 1달러부터 종량제 과금을 사용하므로, 대량이지만 가끔 수행하는 이미지 작업에 월간 구독이 필요하지 않고 사용하지 않은 트래픽은 이월됩니다.
JavaScript로 렌더링되는 갤러리는 어떻게 스크래핑하나요?
사이트가 갤러리를 전부 JavaScript로 구성하면 이미지 URL은 원시 HTML에 나타나지 않으므로 먼저 Playwright로 페이지를 렌더링하고 결과를 같은 수집기에 전달합니다. requests만으로는 스크립트를 실행할 수 없으므로 무한 스크롤과 단일 페이지 갤러리는 로딩을 트리거할 실제 브라우저가 필요합니다.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
반복 스크롤은 지연 로더가 data-src 플레이스홀더를 실제 URL로 바꾸게 하며, 이후 이미 작성한 같은 파서가 이를 수집합니다. 헤드리스 렌더링을 더 자세히 알아보려면 동적 웹 페이지 스크래핑.
마지막으로 모든 다운로드 파일을 원본 URL, 해시, 크기까지 추적할 수 있도록 CSV 매니페스트를 작성합니다. 매니페스트는 익명 파일 폴더를 감사, 재개, 실행 간 중복 제거가 가능한 데이터 세트로 바꿉니다.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
매니페스트를 갖추면 작업을 다시 실행할 때 이미 기록된 URL을 건너뛸 수 있어 대역폭을 절약하고 시간이 지나도 데이터 세트의 일관성을 유지할 수 있습니다.
웹사이트에서 이미지를 스크래핑하고 재사용하는 것은 합법적인가요?
이미지 파일을 다운로드하는 것은 기술적 행위이며, 그 이미지를 재사용할 라이선스를 부여하지는 않습니다. 이는 이미지 스크래핑에서 가장 오해하기 쉬운 부분이므로 신중히 다뤄야 합니다. 웹의 거의 모든 사진, 일러스트레이션, 그래픽은 생성되는 순간 저작권으로 보호되며, 명시적으로 권리를 포기하지 않은 한 촬영하거나 만든 사람이 그 권리를 보유합니다.
파일을 가져올 수 있다는 사실은 이를 재게시, 판매, 학습 또는 재배포할 권리에 관해 아무것도 말해 주지 않습니다. 스크래핑한 이미지를 재사용하기 전에 해당 이미지의 라이선스 조건을 확인하고 Creative Commons나 퍼블릭 도메인처럼 명시된 라이선스를 찾으며, 상업적 이용이라면 서면 허가를 받으십시오. 개인 분석, 인덱싱 또는 연구를 위해 이미지를 수집하는 것은 이를 게시하는 것과 다른 문제이며, 라이선스가 명확히 달리 말하지 않는 한 이미지가 보호된다고 가정하는 것이 안전한 기본값입니다.
시작하기 전에 대상 사이트의 서비스 약관과 robots.txt도 검토하십시오. 웹사이트의 스크래핑 허용 여부 확인 가이드는 그러한 신호를 읽는 방법을 보여 주며, 차단되지 않고 스크래핑하기 가이드는 정중한 크롤링 관행을 다룹니다. 이 글의 어떤 기법도 근본 규칙을 바꾸지 않습니다. 접근 권한은 라이선스가 아니며, 작동하는 스크래퍼와 재사용할 법적 권리는 각각 독립적으로 충족해야 하는 별개의 사항입니다.
자주 묻는 질문
어떤 웹사이트에서나 이미지를 스크래핑할 수 있나요?
기술적으로는 대부분의 사이트에서 파일을 다운로드할 수 있지만, 먼저 사이트의 서비스 약관과 robots.txt를 확인해야 하며 이미지를 다운로드해도 재사용할 권리는 생기지 않는다는 점을 기억해야 합니다. 접근 권한은 라이선스가 아닙니다.
다운로드한 HTML에 일부 이미지가 나타나지 않는 이유는 무엇인가요?
이러한 이미지는 보통 JavaScript나 지연 로딩으로 불러와지므로 실제 URL은 data 속성에 있거나 페이지가 렌더링된 뒤 추가됩니다. Playwright 같은 헤드리스 브라우저로 페이지를 렌더링하고 스크롤하여 로딩을 트리거한 다음 결과를 파싱하십시오.
이미지의 가장 높은 해상도 버전은 어떻게 선택하나요?
srcset 속성을 파싱하고 각 URL 뒤의 너비 설명자를 읽어 가장 큰 너비의 URL을 유지하십시오. 제품 페이지는 JSON-LD 블록에 전체 해상도 이미지를 자주 나열하기도 합니다.
같은 이미지를 두 번 다운로드하지 않으려면 어떻게 하나요?
다운로드한 각 파일의 SHA-256 해시를 계산하고 이미 저장한 해시는 건너뛰십시오. 크기는 다르지만 시각적으로 유사한 사본에는 imagehash 같은 지각 해시 라이브러리를 사용하십시오.
DataImpulse는 관리형 이미지 스크래핑 API를 제공하나요?
아니요. DataImpulse는 자체 스크래퍼를 통과시켜 라우팅하는 프록시를 제공하며, 관리형 스크래핑 API나 무료 웹 프록시 서비스가 아닙니다. 다운로드 로직은 직접 작성하고 접근 및 로테이션에 해당 IP를 사용합니다.
DataImpulse가 적합하지 않은 경우는 언제인가요?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트 접근이 필요하다면 DataImpulse는 적합한 도구가 아닙니다. DataImpulse는 공개 데이터 수집과 콘텐츠 접근을 위한 로테이팅 레지덴셜 프록시, 모바일 프록시, 데이터센터 프록시에 중점을 둡니다.
대규모 이미지 스크래핑 시작
이미지 스크래퍼에 구독 없이 신뢰할 수 있는 접근과 IP 로테이션이 필요하다면 DataImpulse는 GB당 1달러부터 종량제 트래픽으로 윤리적으로 확보한 레지덴셜 프록시, 모바일 프록시, 데이터센터 프록시를 제공합니다. 계정 만들기을 만들고 몇 분 안에 다운로드 루프를 이를 통해 라우팅하십시오.