
In this Article
Najlepsze praktyki web scraping decydują o tym, czy kolektor będzie działał bezproblemowo przez miesiące, czy ulegnie awarii, zostanie zablokowany albo po cichu zwróci bezwartościowe dane. Ten przewodnik koncentruje się na aspektach inżynieryjnych: jak budować scrapery, które są niezawodne, uprzejme wobec odczytywanych witryn i niedrogie w działaniu na dużą skalę.
Większość scraperów zawodzi w przewidywalny sposób: zbyt intensywnie obciążają serwery, wyglądają jak boty lub zależą od zmieniającej się struktury strony. Traktowanie scrapingu jako potoku danych, a nie jednorazowego skryptu, jest kluczową zmianą podejścia. Poniższe techniki obejmują ograniczanie częstotliwości, rotację IP i nagłówków, wybór właściwego źródła danych, solidne parsowanie, ponowienia, buforowanie oraz zapewnianie jakości. Sprawdzają się niezależnie od tego, czy zbierasz kilka tysięcy stron dziennie, czy kilka milionów.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Korzysta z modelu pay-as-you-go od 1 dolara za GB z ruchem bez terminu wygaśnięcia i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Przede wszystkim niezawodność: najważniejsze praktyki web scraping to przestrzeganie limitów częstotliwości, rotowanie IP z realistycznymi nagłówkami, ponawianie z wydłużaniem przerw oraz sprawdzanie każdej partii danych, zanim jej zaufasz.
- Najlepszy typ proxy: rotujące residential proxy, które korzystają z rzeczywistych konsumenckich adresów IP i omijają wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu wygaśnięcia i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych adresów IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4,8/5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraj w cenie.
Jak przestrzegać limitów częstotliwości i wydłużać przerwy?
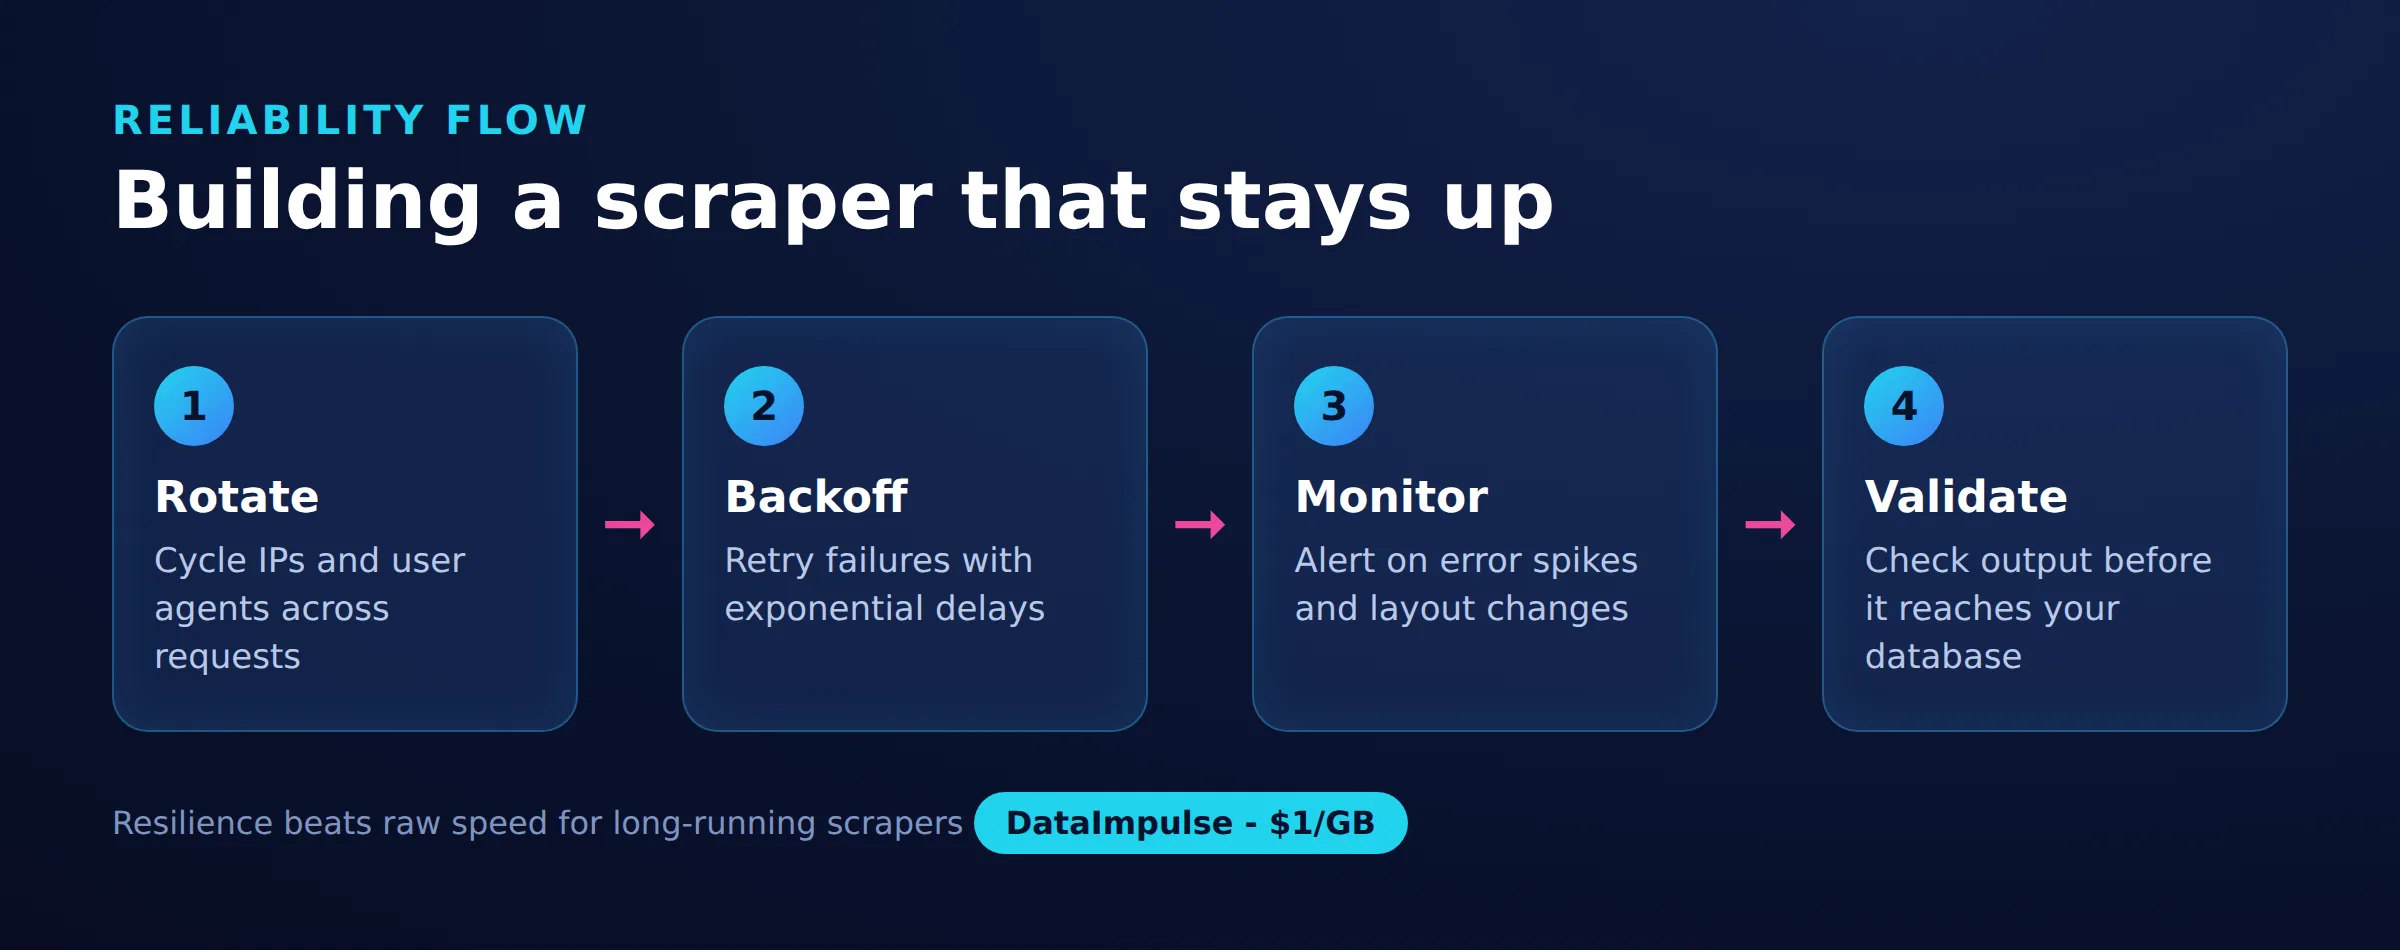
Wysyłaj żądania w tempie, które cel jest w stanie obsłużyć, i automatycznie zwalniaj, gdy sygnalizuje przeciążenie. Adaptacyjne wydłużanie przerw jest zarówno uprzejme, jak i chroni Ciebie, ponieważ agresywny ruch to najszybsza droga do blokady.
Zacznij od zachowawczego poziomu współbieżności i niewielkiego opóźnienia między żądaniami, a potem zwiększaj je tylko wtedy, gdy witryna pozostaje sprawna. Obserwuj odpowiedzi HTTP 429 (Too Many Requests) i 503 oraz stosuj się do każdego nagłówka Retry-After zwróconego przez serwer. Gdy wystąpią błędy, zwiększaj czas oczekiwania wykładniczo z niewielkim losowym odchyleniem, aby równoległe workery nie ponawiały żądań jednocześnie.
- Współbieżność: ograniczaj jednoczesne połączenia na hosta, a nie tylko globalnie.
- Podstawowe opóźnienie: dodaj krótką przerwę między żądaniami do tej samej domeny.
- Wykładnicze wydłużanie przerw: podwajaj czas oczekiwania po każdej porażce, do ustalonego limitu.
- Losowe odchylenie: losuj opóźnienia, aby ponowienia rozkładały się w czasie.
Jak rotować IP i nagłówki, aby uniknąć blokad?
Rozdzielaj żądania między wiele adresów IP i wysyłaj realistyczne, spójne nagłówki żądań, aby każda sesja wyglądała jak zwykła przeglądarka. Rotacja rozkłada obciążenie i zapobiega przekroczeniu progów częstotliwości przez jeden adres.
Adresy IP residential i mobile przypominają prawdziwych użytkowników i trudniej je oznaczyć niż surowe zakresy datacenter, choć proxy datacenter nadal dobrze sprawdzają się dla mało restrykcyjnych celów i dużej przepustowości. DataImpulse udostępnia residential proxy, mobile proxy i datacenter proxy z sesjami rotującymi i sticky session, dzięki czemu możesz dopasować typ IP do trudności witryny. Połącz rotację z pasującymi do siebie nagłówkami: User-Agent, Accept-Language i Accept-Encoding odpowiadającymi prawdopodobnej rzeczywistej przeglądarce, zachowanymi stabilnie w obrębie sesji zamiast losowanymi przy każdym żądaniu. Bardziej szczegółową listę kontrolną znajdziesz w naszym przewodniku o scrapingu bez blokady.
Wybierz tryb sesji odpowiedni do swojego procesu. Sesje rotujące często przypisują nowy IP, co rozkłada obciążenie i sprawdza się przy równoległym przeszukiwaniu niepowiązanych stron. Sticky session utrzymują jeden IP przez określony czas, co ma znaczenie w wieloetapowych procesach, takich jak logowanie, dodawanie do koszyka lub przeglądanie wyników powiązanych z cookie sesji. DataImpulse obsługuje oba tryby w swoich pulach. Utrzymuj spójność IP, cookie i nagłówków w ramach sesji, ponieważ stabilny IP połączony ze zmieniającymi się odciskami przeglądarki sam w sobie jest sygnałem, którego warto unikać.
import requests

HEADERS_POOL = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/124.0 Safari/537.36",
        "Accept-Language": "en-US,en;q=0.9",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                      "Version/17.4 Safari/605.1.15",
        "Accept-Language": "en-GB,en;q=0.8",
    },
]

def build_session(headers, proxy_url):
    s = requests.Session()
    s.headers.update(headers)
    s.proxies.update({"http": proxy_url, "https": proxy_url})
    return s
Kiedy użyć ukrytego API zamiast parsowania HTML?
Gdy tylko istnieje taka możliwość, wybieraj bazowe JSON API witryny zamiast scrapowania renderowanego HTML. API zwracają czyste, ustrukturyzowane dane, zmieniają się rzadziej niż kod strony i znacznie mniej kosztują w przetwarzaniu.
Otwórz narzędzia deweloperskie przeglądarki, obserwuj kartę Network i filtruj żądania XHR lub Fetch podczas ładowania strony. Wiele witryn wypełnia zawartość z punktów końcowych JSON, które możesz wywoływać bezpośrednio, czasem za pomocą prostych parametrów zapytania do stronicowania lub filtrowania. Pozwala to uniknąć narzutu przeglądarki headless, omija większość zmian układu i daje pola z określonymi typami zamiast kruchego wydobywania tekstu. Zawsze sprawdzaj warunki witryny i żądaj wyłącznie danych, do których dostępu masz uprawnienia, a także utrzymuj rozsądną liczbę żądań, nawet jeśli punkt końcowy jest szybki.
Jak pisać selektory odporne na zmiany witryny?
Pisz selektory wskazujące stabilne, znaczące atrybuty i dodaj monitoring, aby dowiedzieć się o awarii, zanim zrobią to Twoi użytkownicy. Kruche selektory są najczęstszą przyczyną cichej utraty danych.
Opieraj się na semantycznych punktach zaczepienia, takich jak identyfikatory elementów, atrybuty danych lub role ARIA, zamiast na głębokich łańcuchach automatycznie generowanych nazw klas, które zmieniają się przy każdym ponownym wdrożeniu. Trzymaj logikę parsowania w jednym miejscu, aby zmiana układu wymagała edycji jednego modułu, a nie przeszukiwania całej bazy kodu. Następnie traktuj parser jak kod produkcyjny:
- Asercje: potwierdzaj, że każde oczekiwane pole występuje i nie jest puste w każdym rekordzie.
- Kanarki: scrapuj zgodnie z harmonogramem kilka znanych URL i wysyłaj alert, jeśli struktura się zmieni.
- Liczba wierszy: porównuj dzisiejszą liczbę z wczorajszą i oznaczaj duże spadki.
- Migawki: przechowuj próbkę surowego HTML, aby móc później debugować błędy.
Jak ponowienia i buforowanie utrzymują niski koszt scrapingu?
Twórz idempotentne żądania i ponawiaj wyłącznie te, które się nie powiodły, a następnie intensywnie stosuj buforowanie, aby nigdy nie pobierać ponownie stron, które się nie zmieniły. Obie praktyki obniżają koszt i zmniejszają obciążenie celu.
Projektuj każdą jednostkę pracy wokół stabilnego klucza, takiego jak URL lub ID rekordu, aby ponowne uruchomienie zadania było bezpieczne i nigdy nie tworzyło duplikatów. Przy przejściowych błędach (przekroczeniu limitu czasu, 5xx, zresetowaniu połączenia) ponawiaj z wydłużaniem przerw. Przy trwałych błędach (404, 410) zapisz wynik i przejdź dalej. W przypadku buforowania stosuj walidatory HTTP, takie jak ETag i Last-Modified, oraz wysyłaj żądania warunkowe, aby niezmienione strony zwracały niewielką odpowiedź 304 zamiast pełnej treści. Przyrostowy scraping, czyli pobieranie wyłącznie nowych lub zaktualizowanych elementów na podstawie znaczników czasu, map witryny lub kanałów, jest najważniejszym czynnikiem ograniczającym zużycie przepustowości. Ponieważ ruch proxy jest rozliczany za GB, pomijanie niezmienionych stron bezpośrednio obniża Twoje wydatki.
import time
import random
import requests
from requests.exceptions import RequestException

def fetch(session, url, retries=4):
    for attempt in range(retries):
        try:
            r = session.get(url, timeout=20)
            if r.status_code in (429, 503):
                wait = int(r.headers.get("Retry-After", 2 ** attempt))
                time.sleep(wait + random.random())
                continue
            r.raise_for_status()
            return r
        except RequestException:
            if attempt == retries - 1:
                raise
            time.sleep((2 ** attempt) + random.random())
    return None
Jak weryfikować zebrane dane i obserwować potok?
Weryfikuj każdą partię danych według jawnego schematu i zapisuj w logach wystarczająco dużo szczegółów, aby diagnozować problemy bez ponownego uruchamiania całego zadania. Dane, którym nie możesz zaufać, są gorsze niż brak danych.
Zdefiniuj oczekiwany typ, zakres i wymagane pola dla każdej kolumny, a następnie odrzucaj lub izoluj rekordy, które nie spełniają warunków, zamiast zapisywać je w głównym magazynie. Sprawdzaj ciche tryby awarii: puste ciągi znaków tam, gdzie powinny być ceny, daty daleko w przyszłości, nagłe skoki wskaźnika wartości null lub zduplikowane klucze. W zakresie obserwowalności zapisuj w logu kod stanu każdego żądania, opóźnienie, użyty proxy i liczbę przesłanych bajtów, a także śledź w czasie wskaźnik powodzenia i koszt, aby powolna degradacja była widoczna na dashboard. Ustrukturyzowane logi wraz z kilkoma alertami zmieniają kruchy scraper w system, którym możesz zarządzać z pewnością.
Jakie są prawne i etyczne zasady bezpieczeństwa scrapingu?
Scrapuj wyłącznie dane, które masz uprawnienie zbierać, przestrzegaj warunków korzystania z usługi i dyrektyw robots oraz unikaj danych osobowych, do których przetwarzania nie masz podstawy prawnej. Niezawodność i odpowiedzialność idą w parze.
Zasady różnią się zależnie od jurysdykcji i rodzaju danych, dlatego traktuj zgodność z prawem jako rzeczywisty wymóg, a nie coś drugorzędnego. Nasze omówienie pytania, czy web scraping jest zgodny z prawem, przedstawia główne kwestie, a przewodnik o scrapingu bez blokady omawia uprzejme techniki. Ważne jest także pozyskiwanie: DataImpulse działa jako etyczny dostawca proxy, którego IP pochodzą od użytkowników wyrażających zgodę i otrzymujących wynagrodzenie, co utrzymuje zbieranie danych w zgodzie z oczekiwaniami RODO.
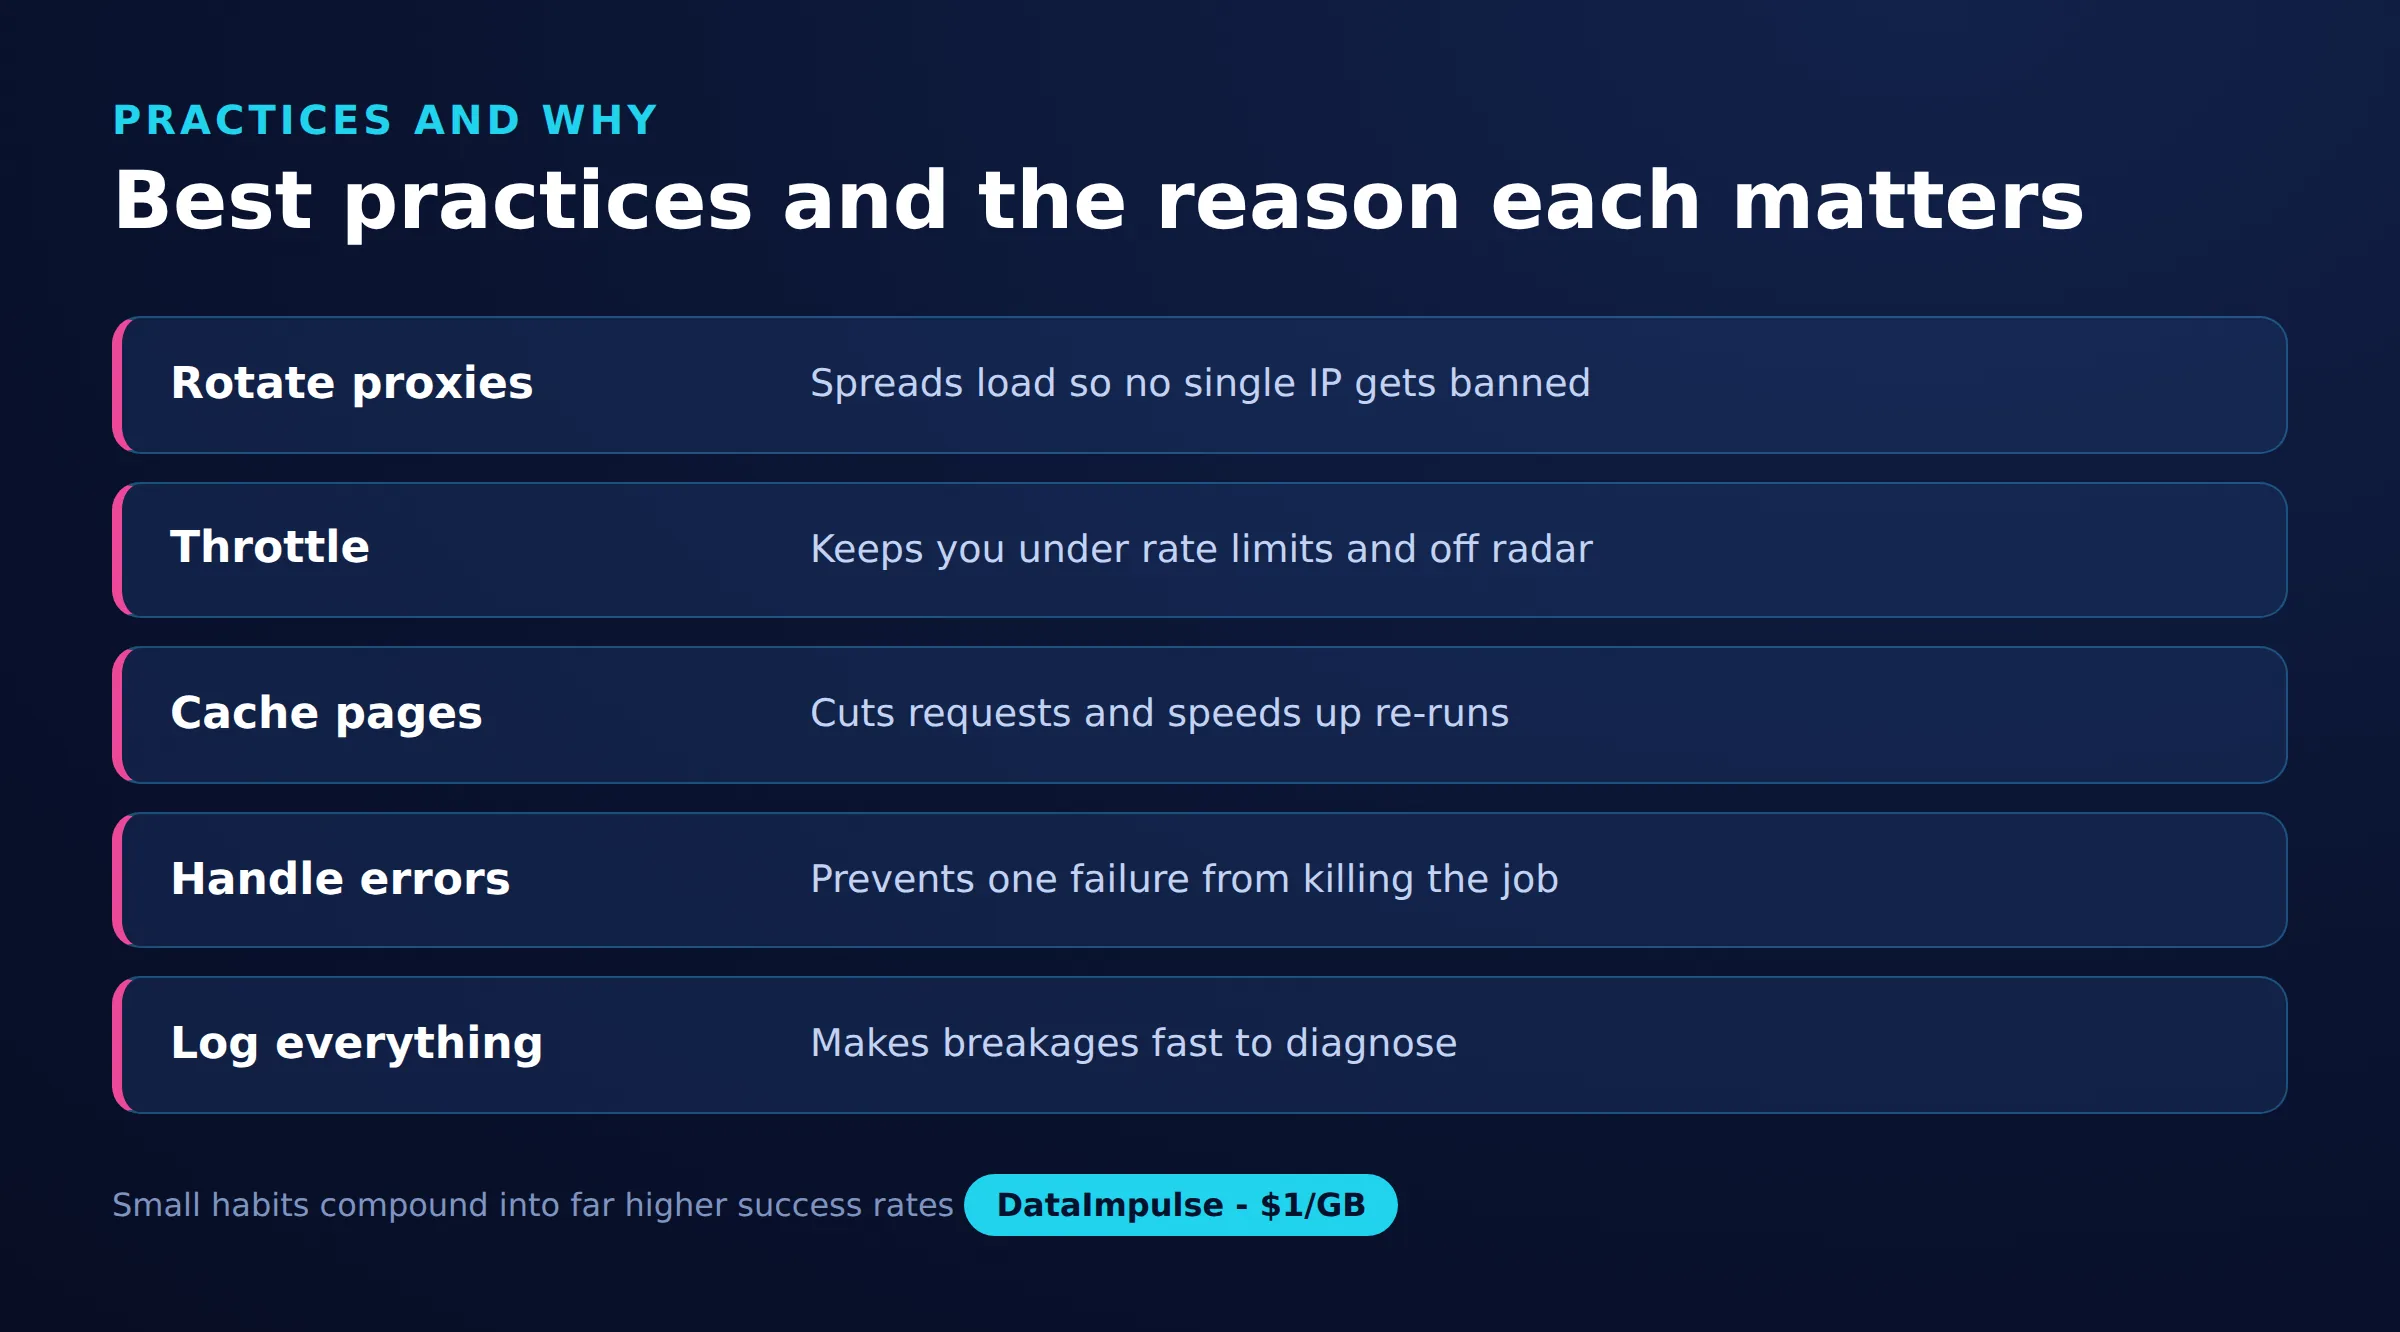
Najlepsze praktyki w skrócie
| Praktyka | Dlaczego | Narzędzia |
|---|---|---|
| Wydłużanie przerw i ponowienia | Unikaj przeciążania serwerów | Biblioteki ponowień |
| Rotacja IP | Zapobiegaj blokadom | Rotujące proxy |
| Używaj ukrytych API | Czystsze, szybsze dane | Inspektor sieci |
| Monitoring | Wcześnie wykrywaj awarie | Alerty i logi |
| Buforowanie | Ogranicz powielone żądania | Lokalny magazyn cache |
| Walidacja | Zapewniaj jakość danych | Kontrole schematu |
Często zadawane pytania
Jaka praktyka web scraping jest najważniejsza?
Przestrzeganie limitów częstotliwości dzięki adaptacyjnemu wydłużaniu przerw. Wysyłanie żądań w tempie, które cel może obsłużyć, zapobiega większości blokad i utrzymuje stabilność kolektora, co jest ważniejsze niż pojedynczy sposób na uniknięcie wykrywania.
Czy do web scraping potrzebuję residential proxy?
Nie zawsze. Proxy datacenter dobrze działają w przypadku mało restrykcyjnych witryn i wysokiej przepustowości, natomiast adresy IP residential lub mobile są lepsze dla celów z rygorystycznymi systemami antybotowymi. Dopasuj typ IP do trudności witryny.
Jak buforowanie obniża koszty web scraping?
Buforowanie i przyrostowy scraping pozwalają pomijać strony, które się nie zmieniły, dzięki żądaniom warunkowym i znacznikom czasu. Ponieważ ruch proxy jest rozliczany za GB, niepobieranie ponownie niezmienionej zawartości bezpośrednio zmniejsza wydatki na przepustowość.
Jak zapobiec awarii scrapera, gdy witryna się zmieni?
Wskazuj stabilne atrybuty, takie jak ID i atrybuty danych, zamiast automatycznie generowanych nazw klas, utrzymuj parsowanie w jednym module i uruchamiaj zaplanowane kontrole kanarkowe, które powiadomią Cię o zmianie struktury strony.
Czy używać sesji rotujących czy sticky session?
Używaj sesji rotujących dla dużych partii niezależnych żądań, a sticky session, gdy proces wymaga tego samego IP w wielu krokach, na przykład podczas logowania lub przeglądania wyników powiązanych z sesją.
Kiedy DataImpulse nie jest właściwym rozwiązaniem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do scrapingu albo dostępu do witryn bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotujących proxy residential, mobile i datacenter do zbierania danych publicznych oraz uzyskiwania dostępu do treści.
Buduj niezawodne scrapery na etycznych proxy
Solidne praktyki inżynieryjne działają najlepiej w niezawodnej sieci. DataImpulse oferuje rotujące proxy i sticky session etyczne proxy w 195 krajach, z modelem pay-as-you-go i ruchem bez terminu wygaśnięcia od 1 dolara za GB, dzięki czemu możesz zacząć na małą skalę i skalować działanie wraz z rozwojem potoku. Utwórz konto, aby wdrożyć te najlepsze praktyki w środowisku produkcyjnym.