
In this Article
Czy web scraping jest legalny? Legalność web scrapingu zależy od czterech rzeczy: co zbierasz (publiczne ceny produktów czy profile osobowe), w jaki sposób to zbierasz (publiczne strony czy treści za logowaniem), gdzie działasz (amerykańska logika CFAA czy europejskie RODO) oraz co robisz z danymi (monitorowanie cen czy trenowanie AI). Gdy więc ludzie pytają: “czy zbieranie danych ze stron internetowych jest legalne”, uczciwa odpowiedź brzmi: zbieranie publicznie dostępnych danych nieosobowych jest zasadniczo legalne w wielu jurysdykcjach – ale każdy z tych czynników może przesunąć Cię od możliwej do obrony praktyki biznesowej do działań regulatora. Ten przewodnik omawia przełomowe sprawy, pozwy z ery AI z lat 2025-2026, stanowiska najważniejszych regulatorów oraz praktyczne ramy zgodności.
Jedna rzecz na wstępie: to są informacje ogólne, a nie porada prawna. Przed zwiększeniem skali komercyjnego procesu scrapingu zasięgnij porady prawnej w swojej jurysdykcji oraz jurysdykcjach podmiotów, które zbierasz.
Najważniejsze fakty
- Zbieranie publicznych danych nieosobowych jest zasadniczo legalne – szczegóły (co, jak, gdzie i dlaczego) przesądzają o wszystkim.
- “Publiczne” nie znaczy “do swobodnego zabrania” w przypadku danych osobowych – regulatorzy UE nakładają za to kary (Clearview: €30.5M w Holandii, €20M we Włoszech, £7.5M w Wielkiej Brytanii).
- Granica między wylogowaniem a zalogowaniem stale decyduje o wygranych – publiczny scraping po wylogowaniu jest możliwy do obrony (hiQ, Meta v. Bright Data); scraping za logowaniem, wbrew zaakceptowanym warunkom, nie jest.
- Era AI dodała roszczenia kontraktowe, licencyjne i dotyczące praw autorskich – legalność zbierania i trenowania to obecnie odrębne pytania.
- Same proxy są legalne – o legalności decyduje działanie, a nie narzędzie.
Krótka odpowiedź według pytania
| Pytanie | Krótka odpowiedź |
|---|---|
| Czy zbieranie publicznych danych o produktach i cenach jest legalne? | Zasadniczo tak – to kategoria najłatwiejsza do obrony wszędzie |
| Czy zbieranie danych osobowych (nazwisk, profili, kontaktów) jest legalne? | Wysokie ryzyko – regulatorzy RODO nakładają kary, nawet gdy dane są publiczne |
| Czy scraping za logowaniem jest legalny? | Ryzykowny – zaakceptowałeś warunki; roszczenia kontraktowe pozostają aktualne nawet tam, gdzie CFAA nie ma zastosowania |
| Czy naruszenie robots.txt jest nielegalne? | Samo w sobie nie jest naruszeniem prawa, ale sądy i regulatorzy traktują je jako dowód złej wiary |
| Czy używanie proxy jest legalne? | Tak – o legalności decyduje działanie, a nie narzędzie |
| Czy scraping na potrzeby trenowania AI jest legalny? | Nierozstrzygnięte – uczciwe wykorzystanie wygrywa w przypadku danych pozyskanych zgodnie z prawem, ale mnożą się pozwy dotyczące umów i licencji |
Popularne mity o legalności web scrapingu
Większość nieporozumień dotyczących legalności web scrapingu wynika z mylenia technicznej możliwości z prawnym zezwoleniem. Przed omówieniem szczegółów warto wyjaśnić trzy mity.
Mit 1: web scraping to hakowanie
Scraping publicznej strony nie jest nieuprawnionym dostępem – bot żąda tej samej strony co zwykła przeglądarka. W sprawie amerykańskiego Sądu Apelacyjnego Dziewiątego Okręgu hiQ v. LinkedIn (2022) uznano, że scraping publicznych stron prawdopodobnie nie narusza CFAA, gdy nie omija się bramki uwierzytelniania. Ludzie pytają też: “czy screen scraping jest legalny?” – odpowiedź jest taka sama: odczytywanie publicznej strony tak, jak robi to przeglądarka, nie jest “hakowaniem”.
Mit 2: “Dane publiczne” można swobodnie zabrać
Publiczne nie znaczy nieograniczone. Dane osobowe pozostają chronione, nawet gdy są jawnie widoczne – europejscy regulatorzy nakładają kary za scraping publicznych danych osobowych. Prawa autorskie nadal chronią publiczne artykuły i obrazy. Warunki korzystania z usługi mogą też wiązać Cię nawet bez logowania. Dlatego rzeczywiste pytanie – czy data scraping jest legalny? – w dużej mierze zależy od tego, czym faktycznie są dane.
Mit 3: naruszenie ToS jest przestępstwem
Naruszenie warunków korzystania z usługi jest kwestią cywilną, a nie karną. Naruszenie ToS nie jest automatycznie nielegalne – ale może być podstawą do natychmiastowego zablokowania, pozwu cywilnego oraz dowodem złej wiary w sądzie. Więcej o warunkach korzystania z usługi dotyczących web scrapingu poniżej.
Stany Zjednoczone: CFAA, hiQ i warstwa kontraktowa
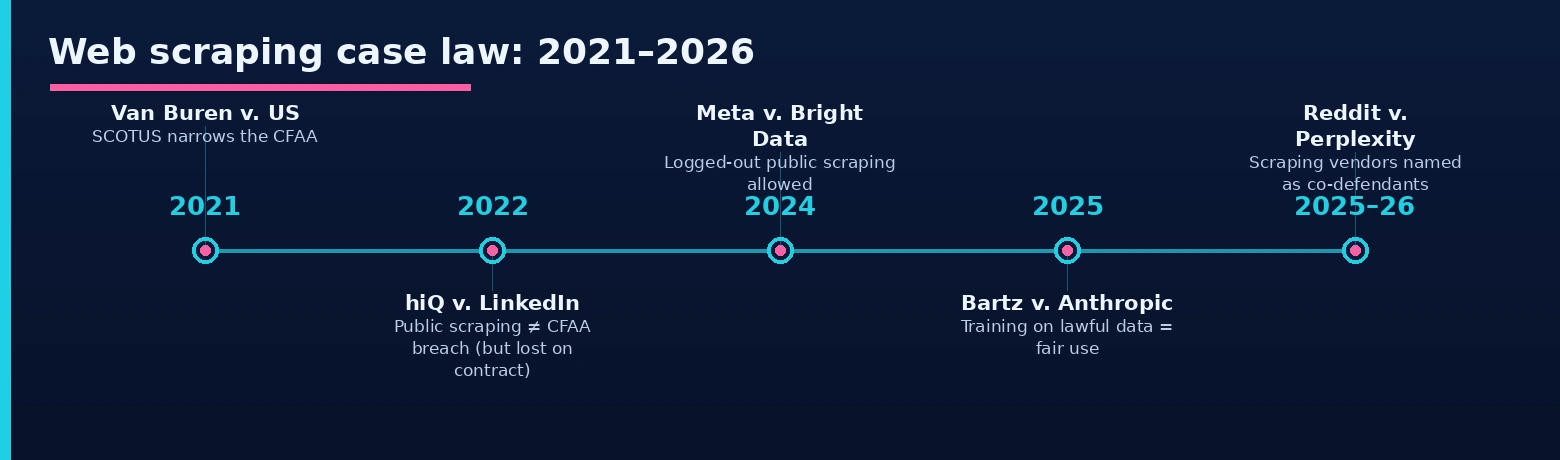
Podstawowe pytanie – czy scraping stron internetowych jest legalny w USA? – sprowadzało się do tego, czy scraping publicznych stron jest “nieuprawnionym dostępem” w rozumieniu Computer Fraud and Abuse Act, ustawy przeciwko hakowaniu. Sąd Apelacyjny Dziewiątego Okręgu odpowiedział w sprawie hiQ Labs v. LinkedIn (2022, stosując logikę Sądu Najwyższego ze sprawy Van Buren): nie. Gdy strona jest otwarta dla każdego bez danych uwierzytelniających, nie ma bramki autoryzacji do przełamania, więc scraping danych publicznych nie stanowi naruszenia CFAA.
Pełna historia hiQ zawiera jednak właściwą lekcję. Po wygraniu sporu dotyczącego CFAA hiQ przegrał całą sprawę: w listopadzie 2022 sąd uznał, że naruszył Umowę Użytkownika LinkedIn (którą zaakceptował, tworząc konta), a sprawa zakończyła się wyrokiem za zgodą stron. CFAA chroni przed zarzutami hakowania publicznych stron, ale nie chroni przed umowami, na które się zgodziłeś.
Meta v. Bright Data (styczeń 2024) wyostrzyła tę granicę: sąd nie uznał, że Bright Data naruszył warunki przez scraping publicznych stron Facebooka i Instagrama po wylogowaniu, ponieważ warunki platform dotyczą posiadaczy kont, a nie odwiedzających po wylogowaniu. Wyłoniła się zasada: publiczny scraping po wylogowaniu jest możliwy do obrony; scraping po zalogowaniu, wbrew zaakceptowanym warunkom, nie jest. Starsze sprawy dotyczące ingerencji w cudze urządzenia (eBay v. Bidder’s Edge, 2000) nadal mają znaczenie przy skrajnych wolumenach, a stanowe przepisy o prywatności (CCPA/CPRA w Kalifornii, VCDPA w Wirginii) nakładają dodatkowe obowiązki dotyczące danych osobowych.
Warunki korzystania z usługi: browsewrap, clickwrap i moment, w którym zasady stają się ryzykiem prawnym
Warunki korzystania z usługi nie są prawem, ale sądy przywiązują do nich dużą wagę – kluczowe pytanie brzmi, czy użytkownik rzeczywiście je zaakceptował.
Browsewrap a clickwrap: które ToS rzeczywiście Cię wiążą
Umowa browsewrap to tylko link umieszczony gdzieś na stronie, bez aktywnej akceptacji – sądy rzadko egzekwują ją wobec osoby, która nigdy nie kliknęła. Umowa clickwrap wymaga wyraźnego działania – pola wyboru lub przycisku “Zgadzam się” – i sądy egzekwują ją prawie zawsze. Praktyczna granica: warunki, które aktywnie zaakceptowałeś (zwykle przez utworzenie konta), wiążą Cię; warunki, które mogłeś jedynie zobaczyć, często nie.
Kiedy naruszenie ToS staje się dowodem prawnym
Naruszenie warunków korzystania z usługi dotyczących web scrapingu nie jest przestępstwem, ale ma trzy praktyczne skutki: platforma może natychmiast Cię zablokować, jest podstawą cywilnego pozwu o naruszenie umowy (roszczenia, które ostatecznie pogrążyło hiQ) oraz świadczy o złej wierze, jeśli roszczenie CFAA lub powiązane trafi do sądu.
Era AI: pozwy z lat 2025-2026, które zmieniły mapę
Trenowanie AI stworzyło drugą falę sporów dotyczących scrapingu – mniej skupioną na pytaniu “czy dostęp był autoryzowany”, a bardziej na umowach, licencjonowaniu i prawach autorskich (tych samych zagadnieniach, które kształtują proxy do zbierania danych treningowych AI):
- Bartz v. Anthropic (czerwiec 2025, sędzia Alsup): trenowanie LLM na książkach pozyskanych zgodnie z prawem jest “wyjątkowo transformacyjnym” uczciwym wykorzystaniem – ale orzeczenie wyraźnie wyłączyło pirackie kopie źródłowe. Sposób pozyskania danych ma takie samo znaczenie jak to, co z nimi zrobiłeś.
- Kadrey v. Meta (czerwiec 2025, sędzia Chhabria): powodowie przegrali na podstawie przedstawionych akt, ale w opinii ostrzeżono, że nie jest to szerokie zezwolenie na trenowanie AI – wąskie zwycięstwo, nie doktryna.
- Reddit v. Anthropic (wniesiono w czerwcu 2025): Reddit pozwał na podstawie teorii naruszenia warunków korzystania z usługi i bezpodstawnego wzbogacenia, a nie praw autorskich. Pod koniec marca 2026 sędzia federalny przekazał sprawę z powrotem do sądu stanowego Kalifornii, uznając, że roszczenia nie są wyłączone przez Copyright Act – co potwierdza, że oparte na umowach roszczenia dotyczące scrapingu mają niezależne życie.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (październik 2025, S.D.N.Y.): pierwsza sprawa, która wskazała dostawców infrastruktury scrapingu jako współpozwanych obok firmy AI. Dla nabywców proxy wniosek dotyczy łańcuchów dostaw: kto zbiera Twoje dane i jak, jest teraz częścią Twojej ekspozycji prawnej.
- NYT v. OpenAI (połączone postępowanie, S.D.N.Y.): w styczniu 2026 sąd nakazał OpenAI przekazać w ramach postępowania dowodowego próbkę dzienników obejmującą 20 milionów rozmów; sprawa sprawdza, czy “regurgitacja” przez model podważa uczciwe wykorzystanie.
- Gospodarka licencyjna jest drugą stroną medalu: Reddit licencjonuje dane Google (~$60M/yr) i OpenAI; Cloudflare oraz Stack Overflow uruchomiły pay-per-crawl. “Darmowe do scrapingu” i “licencjonowane do trenowania” stają się rozbieżnymi ścieżkami.
Europa: RODO i najsurowsi regulatorzy
W UE (i w Wielkiej Brytanii) pytanie rzadko brzmi “czy dostęp był autoryzowany” – brzmi ono “czy przetwarzałeś dane osobowe bez podstawy prawnej?” W ramach RODO scraping wszelkich danych identyfikujących osobę (nazwisk, zdjęć, profili, danych kontaktowych) jest “przetwarzaniem”, a “dane były publiczne” samo w sobie nie stanowi podstawy prawnej. Historia egzekwowania przepisów jest jednoznaczna:
- Holandia (AP) – najtwardsze podejście w Europie. Jej wytyczne z maja 2024 określają scraping danych osobowych jako “niemal zawsze naruszenie RODO”, a Clearview AI ukarano grzywną €30,5 mln, przy czym dyrektorów ostrzeżono o osobistej odpowiedzialności.
- Włochy (Garante) – ukarał Clearview grzywną €20 mln; jego deklarowana zasada: “jeśli coś jest publiczne, mogę to zabrać” jest fałszywa.
- Francja (CNIL) – ukarała brokera danych kontaktowych KASPR €240,000 (grudzień 2024). Jej wytyczne z czerwca 2025 dopuszczają scraping publicznych danych osobowych w oparciu o uzasadniony interes – ale tylko z zabezpieczeniami (listami wykluczeń, minimalizacją, przejrzystością).
- Wielka Brytania (ICO) – ukarał Clearview grzywną £7,5 mln; brytyjskie RODO oraz Data (Use and Access) Act 2025 zachowują ramy zgodne z unijnymi.
- W całej UE: Database Directive dodaje odrębne prawo sui generis przeciwko pozyskiwaniu istotnych części chronionych baz danych – roszczenie istniejące w Europie, ale nie w USA.
Kluczowy niuans: nic z tego nie dotyczy danych nieosobowych. Ceny, listy produktów, dostępność i rankingi nie wchodzą w zakres RODO – europejskie procesy analizy cen i SEO działają legalnie każdego dnia. Poniższa mapa ryzyka pokazuje, jak ryzyko scrapingu danych osobowych różni się w zależności od jurysdykcji.
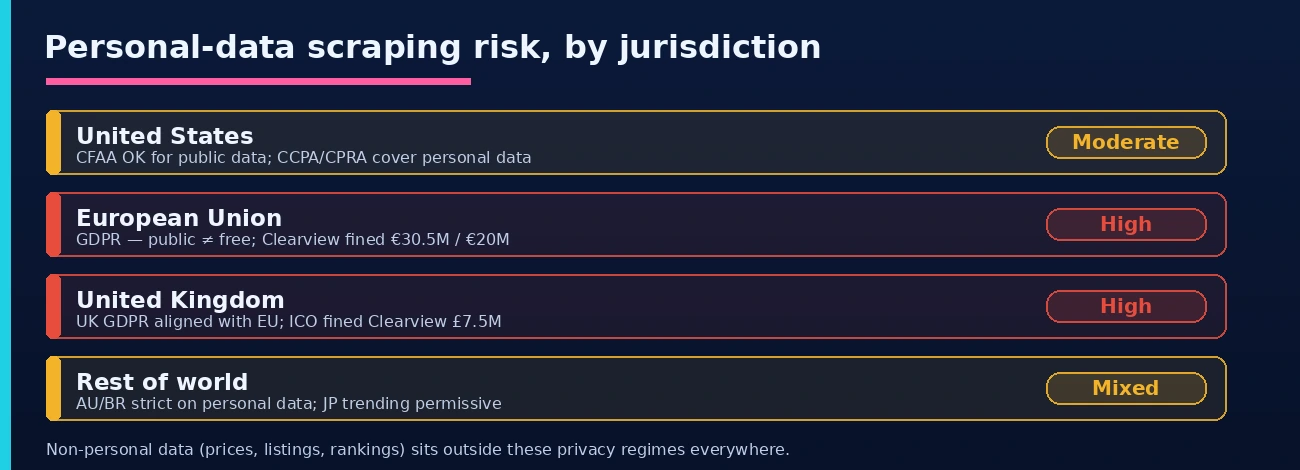
Poza Europą i USA sytuacja dotycząca scrapingu danych osobowych waha się od restrykcyjnej po łagodniejszą:
| Jurysdykcja | Ramy prawne | Stanowisko wobec scrapingu |
|---|---|---|
| Australia | Privacy Act 1988 + reforma z 2024 | Publiczne dane o produktach są możliwe do obrony; dane osobowe nie. |
| Japonia | APPI | Trend jest korzystny – nowelizacja z 2026 złagodziłaby wykorzystanie publicznych danych przez AI. |
| Brazylia | LGPD (ANPD) | Aktywne egzekwowanie przepisów dotyczących danych osobowych, w tym wobec Clearview. |
| Indie | DPDP Act 2023 | Przepisy dotyczące danych osobowych zaostrzają się; trwają sprawy dotyczące trenowania AI. |
| Chiny | PIPL + DSL + CSL | Rygorystyczne podejście do danych osobowych i transferu transgranicznego; wymaga analizy lokalizacji. |
Każdy przewodnik krajowy w naszej bibliotece bloga – od Niemiec po Japonię – zawiera sprawdzoną sekcję prawną dotyczącą danego kraju, jeśli potrzebujesz szczegółów o konkretnym rynku.
Prawo autorskie: co możesz zbierać, a czego nie
Prawo autorskie jest jednym z najczęstszych źródeł problemów prawnych przy scrapingu – lecz większość zastosowań biznesowych mieści się w bezpiecznej strefie, gdy oddzielisz fakty od twórczych treści.
Co jest chronione, a co nie
Fakty nie podlegają prawu autorskiemu – ceny, oceny, dostępność i specyfikacje można swobodnie zbierać, dlatego scraping danych o produktach jest bezpieczną strefą. Chronione są natomiast: artykuły, zdjęcia, filmy, oryginalny tekst oraz twórczy wybór lub układ w bazie danych. To przy ich hurtowym ponownym publikowaniu pojawiają się roszczenia o naruszenie praw autorskich; amerykańska ustawa Digital Millennium Copyright Act (DMCA) ma odrębne zastosowanie – gdy omijasz kontrole dostępu albo usuwasz informacje o zarządzaniu prawami autorskimi, a nie wyłącznie z powodu ponownej publikacji.
Uczciwe wykorzystanie (USA) i dyrektywa DSM (UE): kiedy scraping treści chronionych prawem autorskim jest dozwolony
W USA uczciwe wykorzystanie uwzględnia cztery czynniki: cel wykorzystania (transformacyjny czy wyłącznie komercyjny?), charakter utworu, zakres pobranych treści oraz wpływ na rynek – a sprawa Authors Guild v. Google (Google Books) jest klasycznym precedensem dla wykorzystania transformacyjnego. W UE dyrektywa DSM zezwala na eksplorację tekstu i danych, gdy masz zgodny z prawem dostęp, a posiadacz praw nie zrezygnował z tego uprawnienia (co często sygnalizuje robots.txt). Oba systemy pozostawiają możliwość scrapingu treści chronionych prawem autorskim w celach analitycznych – żaden nie licencjonuje hurtowego ponownego publikowania.
Co jest możliwe do obrony, a co ryzykowne
Nie każdy scraping wiąże się z takim samym ryzykiem – zależy ono od rodzaju danych, sposobu uzyskania dostępu i tego, co robisz z wynikiem. Dwie poniższe listy pozwolą szybko umiejscowić Twój projekt.
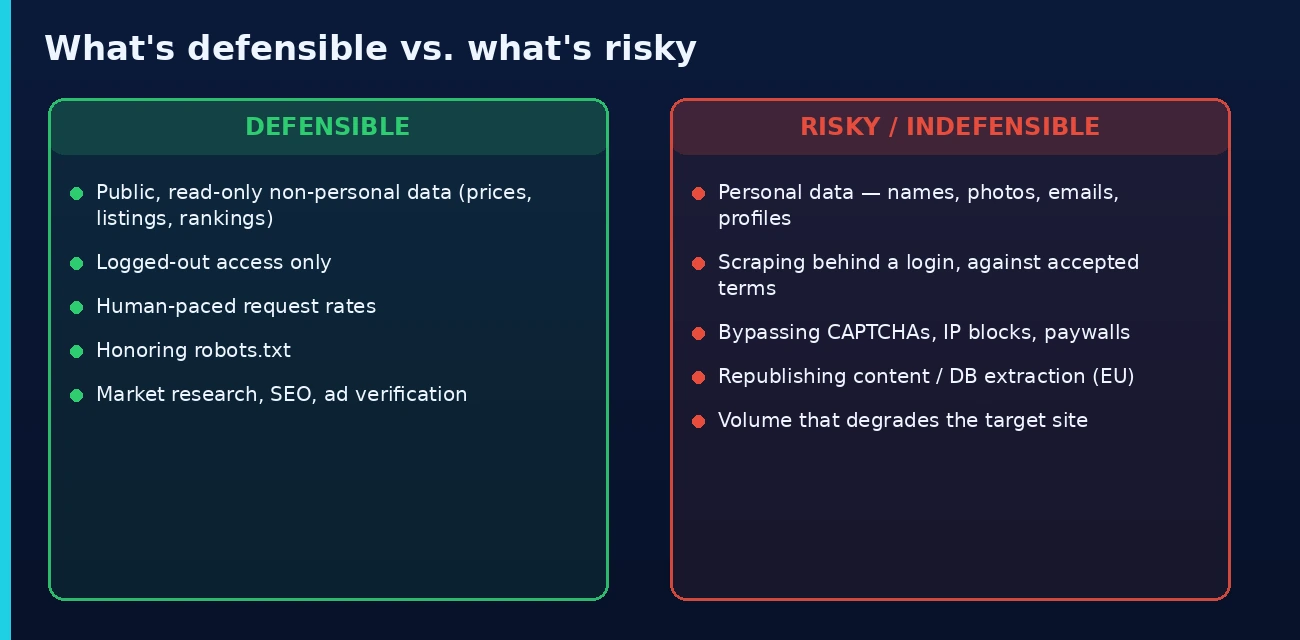
Zasadniczo możliwe do obrony
- Publiczne zbieranie danych nieosobowych w trybie tylko do odczytu: cen, specyfikacji produktów, stanu magazynowego, rankingów, wyników wyszukiwania, cen biletów lotniczych, ofert nieruchomości
- Dostęp wyłącznie po wylogowaniu – nic za uwierzytelnieniem
- Tempo żądań odpowiadające tempu człowieka, które nie obciąża infrastruktury celu
- Przestrzeganie robots.txt i opublikowanych zasad crawlowania
- Analiza konkurencji, badania rynku, monitorowanie SEO, ad verification, badania akademickie na danych zagregowanych
Od ryzykownego do niemożliwego do obrony
- Scraping danych osobowych – nazwisk, zdjęć, e-maili, numerów telefonów, profili – szczególnie na dużą skalę, zwłaszcza w Europie
- Scraping za logowaniem, wbrew zaakceptowanym warunkom (lekcja kontraktowa z hiQ)
- Omijanie barier technicznych: CAPTCHA przedstawianych jako kontrola dostępu, blokad IP skierowanych konkretnie do Ciebie, paywalli
- Hurtowe ponowne publikowanie zebranych treści (prawa autorskie) lub pozyskiwanie istotnych części chronionych baz danych (unijne prawo do baz danych)
- Wolumen obniżający jakość działania strony docelowej (ryzyko roszczenia o ingerencję w cudze urządzenia)
- Trenowanie AI na treściach uzyskanych ze źródeł pirackich lub naruszających warunki korzystania z usługi (wyłączenie ze sprawy Bartz)
Lista zgodności dla zespołów prowadzących scraping
1. Określ zakres danych. Jeśli pole może identyfikować osobę, traktuj je jako regulowane: usuń je albo ustal podstawę prawną RODO wraz z udokumentowanymi zabezpieczeniami (arkusz CNIL z 2025 o uzasadnionym interesie jest najlepszym wzorem).
2. Pozostań wylogowany. Tylko publiczne strony. W chwili uwierzytelnienia akceptujesz umowę – a roszczenia kontraktowe są tymi, które wygrywają.
3. Szanuj sygnały strony. robots.txt, limity żądań, crawl-delay. Nie zawsze są prawnie wiążące, ale to pierwsza rzecz, na którą patrzy sąd lub regulator.
4. Projektuj z umiarem. Rytm odpowiadający tempu człowieka, cache’owanie, aby uniknąć ponownego pobierania, bez bombardowania żądaniami. To wolumen zmienia spór o scraping w roszczenie o ingerencję.
5. Zadbaj o łańcuch dostaw. Reddit v. Perplexity wskazała dostawców scrapingu, nie tylko nabywcę AI. Wiedz, jak Twoi dostawcy danych je zbierają.
6. Oddziel zbieranie od wykorzystania. Pozyskanie zgodne z prawem nie licencjonuje każdego zastosowania: ponowne publikowanie, pozyskiwanie z bazy danych i trenowanie AI wymagają osobnej analizy.
7. Przed skalowaniem skorzystaj z porady prawnej. Proces odpowiedni przy 1,000 żądań dziennie może wymagać analizy przy 10 milionach.
8. Wybierz etycznie pozyskaną infrastrukturę proxy. Ważne nie jest narzędzie, ale jego źródło: proxy są legalne, jednak etyczny web scraping obejmuje również sposób pozyskania IP. Oparte na zgodzie, etycznie pozyskane residential proxy pozwalają utrzymać możliwość obrony warstwy zbierania danych, jeśli ktoś zapyta o Twój łańcuch dostaw.
FAQ
Czy web scraping jest legalny?
Zbieranie publicznie dostępnych danych nieosobowych jest zasadniczo legalne w wielu jurysdykcjach – Sąd Apelacyjny Dziewiątego Okręgu w sprawie hiQ v. LinkedIn (2022) potwierdził, że scraping publicznych stron nie jest “nieuprawnionym dostępem” w rozumieniu amerykańskiej CFAA. Ryzyko kryje się w szczegółach: danych osobowych (kary RODO do €30.5M w sprawach Clearview), scrapingu za logowaniem wbrew zaakceptowanym warunkom (na czym hiQ ostatecznie przegrał), omijaniu barier technicznych oraz hurtowym ponownym publikowaniu treści chronionych prawem autorskim. Zbierane z poszanowaniem zasad publiczne dane o produktach, cenach i SERP są obszarem możliwym do obrony.
Czy web scraping jest legalny w USA?
Zasadniczo tak w przypadku danych publicznych: hiQ v. LinkedIn ustanowiła, że scraping publicznych stron nie narusza CFAA, a Meta v. Bright Data (2024) odmówiła zablokowania scrapingu po wylogowaniu publicznych stron Facebooka i Instagrama. Roszczenia kontraktowe jednak pozostają – hiQ przegrał za naruszenie zaakceptowanych warunków LinkedIn – a skrajne wolumeny niosą ryzyko roszczeń o ingerencję. Stanowe przepisy o prywatności (CCPA/CPRA) dodatkowo regulują dane osobowe.
Czy web scraping jest legalny na mocy RODO w Europie?
Dane nieosobowe (ceny, oferty, rankingi) są całkowicie poza zakresem RODO. Europa rygorystycznie traktuje dane osobowe: holenderski AP określa scraping danych osobowych jako “niemal zawsze naruszenie” i ukarał Clearview grzywną €30.5M; włoski Garante ukarał go grzywną €20M; francuski CNIL ukarał KASPR grzywną €240K – wszystko za scraping publicznych danych osobowych. Wytyczne CNIL z 2025 dopuszczają scraping publicznych danych osobowych na podstawie uzasadnionego interesu wyłącznie z udokumentowanymi zabezpieczeniami.
Czy mogę legalnie zbierać dane z Amazon, Google lub innych dużych platform?
Zbieranie po wylogowaniu publicznych danych o produktach i wynikach wyszukiwania, w rozsądnym tempie, należy do tej samej możliwej do obrony kategorii co gdzie indziej – tak działają branże analizy cen i SEO. Ryzyka są zależne od platformy: nie loguj się (warunki), nie pobieraj danych osobowych (recenzji z tożsamościami autorów), nie przeciążaj endpointów i znaj stanowisko każdej platformy w zakresie egzekwowania zasad. Nasze przewodniki dla konkretnych platform (Amazon, Google Maps, LinkedIn, Reddit) omawiają konkretne sprawy i reguły.
Czy scraping danych do trenowania AI jest legalny?
To kwestia nierozstrzygnięta i dzieląca się na dwa pytania. Zbieranie: te same zasady co przy każdym scrapingu. Trenowanie: Bartz v. Anthropic (2025) uznała trenowanie na książkach pozyskanych zgodnie z prawem za transformacyjne uczciwe wykorzystanie, ale wyłączyła źródła pirackie; NYT v. OpenAI sprawdza, czy “regurgitacja” wyników wyklucza uczciwe wykorzystanie; oparte na umowach pozwy Reddit przeciwko Anthropic i Perplexity (wraz z dostawcami ich scrapingu) przetrwały wczesne etapy proceduralne. Licencjonowane dane i czyste łańcuchy dostaw stają się bezpieczną przystanią.
Czy proxy są legalne w użyciu?
Tak – proxy są standardową infrastrukturą sieciową, legalną zasadniczo wszędzie. Regulowane jest działanie prowadzone przez proxy: legalny scraping pozostaje legalny przez proxy, a bezprawne zbieranie pozostaje bezprawne. Wybieraj dostawców z etycznie pozyskanymi, opartymi na zgodzie pulami residential; po tym, jak Reddit v. Perplexity wskazała dostawców scrapingu jako pozwanych, pochodzenie Twojej infrastruktury zbierania danych jest częścią historii zgodności.
Czy naruszenie robots.txt czyni scraping nielegalnym?
robots.txt nie jest ustawą, a jego ignorowanie nie jest automatycznie nielegalne. Jednak sądy i regulatorzy traktują je jako sygnał dobrej lub złej wiary, kilka orzeczeń powołuje się na nie przy ocenie roszczeń o ingerencję i naruszenie umowy, a zabezpieczenia CNIL wymagają respektowania rezygnacji. W praktyce: przestrzeganie robots.txt niewiele kosztuje i istotnie wzmacnia możliwość obrony.
Co wydarzyło się w sprawie hiQ v. LinkedIn, w jednym akapicie?
hiQ zbierał publiczne profile LinkedIn na potrzeby analityki HR; LinkedIn wysłał wezwanie do zaprzestania; hiQ pozwał i wygrał zasadniczą kwestię – Sąd Apelacyjny Dziewiątego Okręgu uznał (2022), że scraping publicznych stron nie narusza CFAA. Następnie LinkedIn wygrał całą sprawę: sąd stwierdził, że hiQ naruszył zaakceptowaną Umowę Użytkownika, a sprawa zakończyła się wyrokiem za zgodą stron. Podwójna lekcja: publiczny scraping nie jest hakowaniem, ale umowy, które akceptujesz, są egzekwowalne.
Podsumowanie
A zatem, czy web scraping jest legalny? Zbieranie publicznie dostępnych danych nieosobowych jest zasadniczo legalne i możliwe do obrony – trzy największe ryzyka to dane osobowe (RODO i jego globalne odpowiedniki), dostęp wbrew zaakceptowanym warunkom (roszczenia kontraktowe, które pokonały hiQ i obecnie napędzają pozwy z ery AI) oraz prawa autorskie do twórczych treści. Pozostań wylogowany, zbieraj dane nieosobowe, przestrzegaj robots.txt i oddziel zbieranie od wykorzystania. Po 2026 roku łańcuch dostaw również jest częścią zgodności: miejsce, z którego pochodzą Twoje dane – i Twoje proxy – jest teraz częścią obrazu prawnego. Informacje o stronie infrastrukturalnej znajdziesz w artykule najlepsze proxy do web scrapingu. To nadal informacje ogólne, a nie porada prawna – w swojej konkretnej sprawie zasięgnij porady prawnej.
Ostatnia aktualizacja: 24 czerwca 2026.