
In this Article
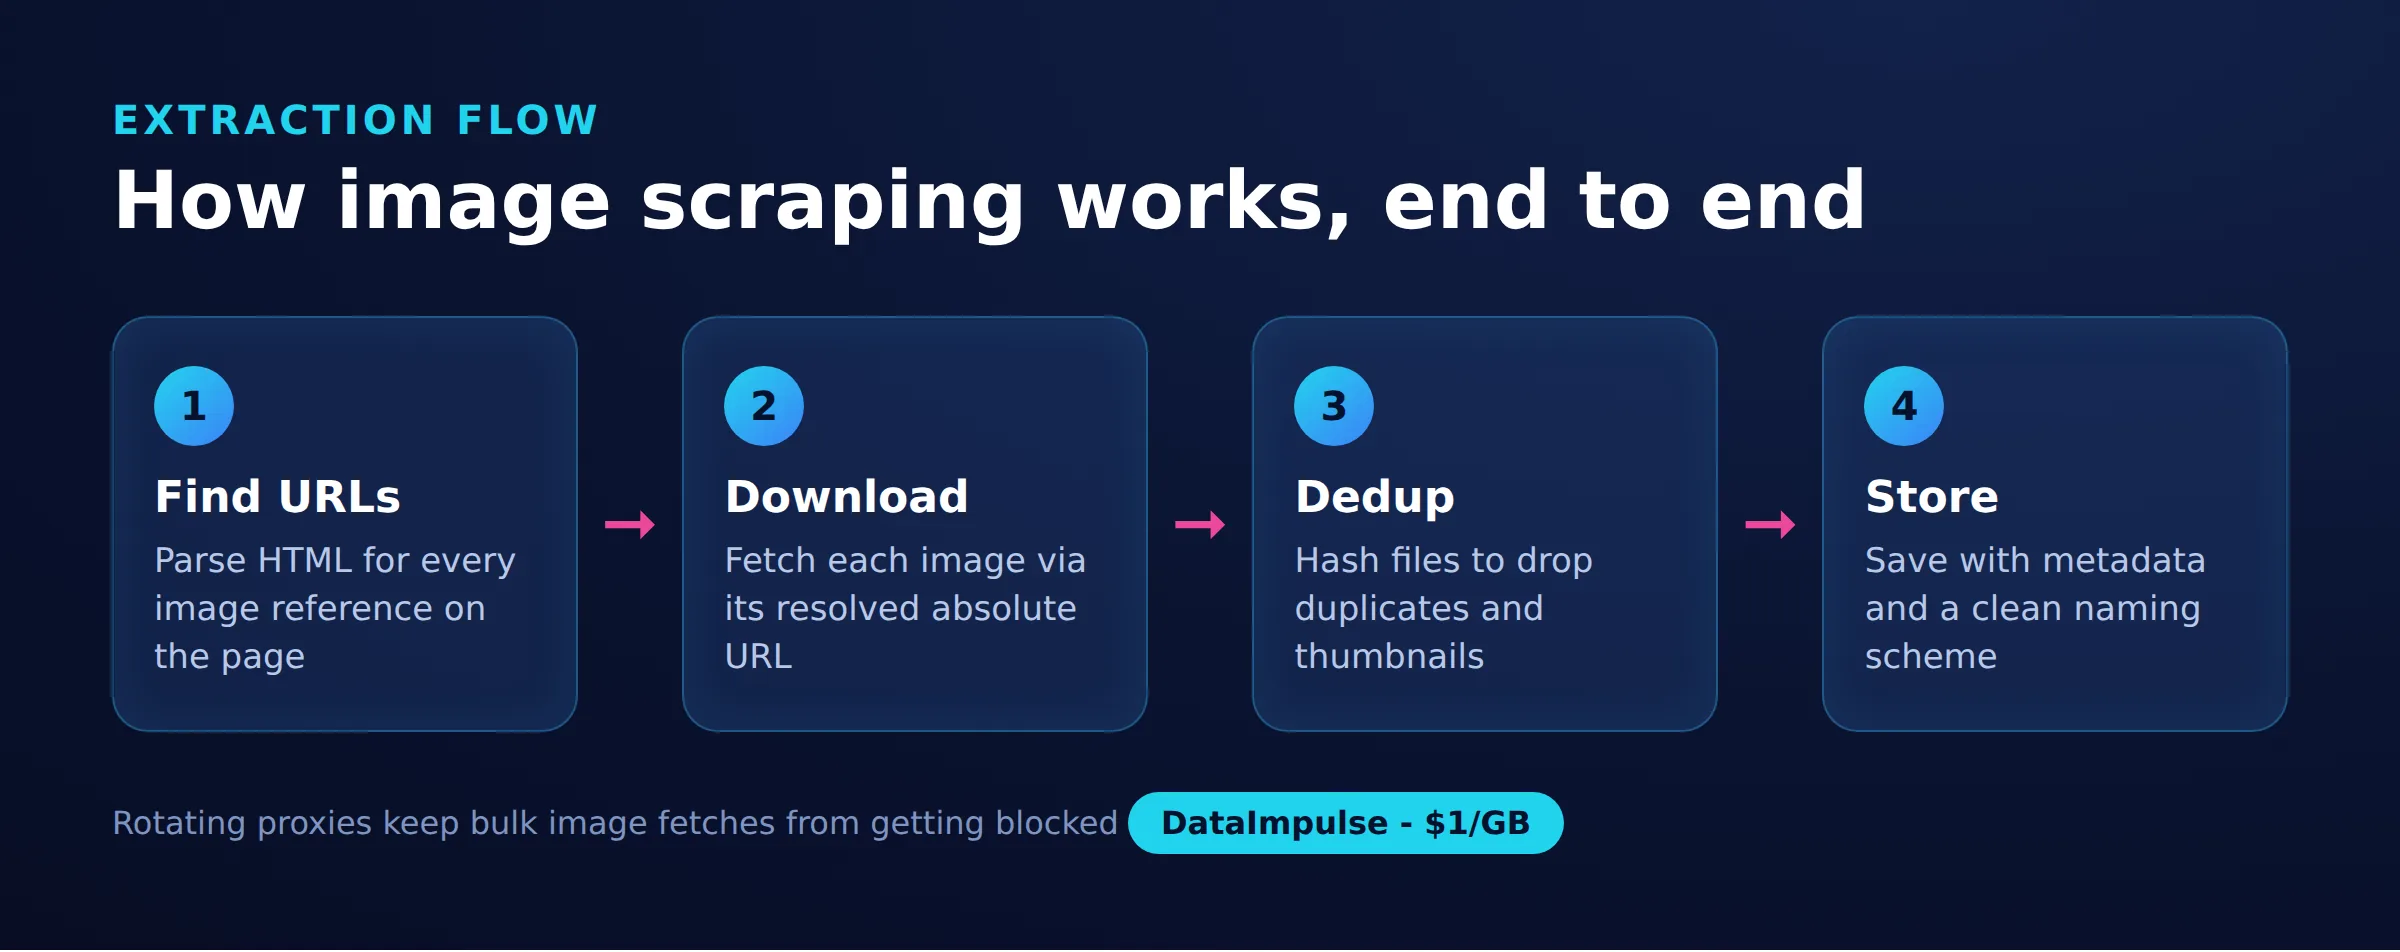
การเรียนรู้วิธี scrape รูปภาพจากเว็บไซต์หมายถึงการแก้ปัญหาสองอย่าง ได้แก่ ค้นหาว่าแหล่งรูปภาพทุกแห่งอยู่ตรงไหนใน HTML แล้วดาวน์โหลดไฟล์ไบนารีที่อยู่หลัง URL เหล่านั้น คู่มือนี้พาไปทำทั้งสองขั้นตอนด้วยโค้ด Python ที่ใช้งานได้จริง ครอบคลุมกรณีที่ซับซ้อนอย่างการเลือก srcset, lazy-loading และพื้นหลัง CSS พร้อมอธิบายวิธีเคารพลิขสิทธิ์และข้อจำกัดด้านแบนด์วิดท์
รูปภาพใช้ข้อมูลมากกว่าข้อความ ดังนั้นการเก็บรวบรวมในปริมาณมากจึงต้องวางแผนเรื่องพื้นที่จัดเก็บ การลบข้อมูลซ้ำ การทำงานพร้อมกัน และค่าใช้จ่ายเครือข่าย ทุกอย่างด้านล่างใช้งานได้กับ requests, BeautifulSoup และ Playwright และเทคนิคเหล่านี้ใช้ได้ทั้งกับแกลเลอรีเดียวหรือแค็ตตาล็อกขนาดใหญ่
DataImpulse คือผู้ให้บริการ proxy ที่มีจริยธรรม โดยมี IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- ประเด็นสำคัญ: หากต้องการ scrape รูปภาพจากเว็บไซต์ คุณต้องดึงทุกแหล่งที่มาก่อน ได้แก่ img src, srcset, data attribute ของ lazy-load, พื้นหลัง CSS และ JSON-LD แล้วจึงดาวน์โหลดไฟล์ไบนารี เพราะ markup และไฟล์รูปภาพจริงเป็นคนละ request กัน
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxy ซึ่งใช้ IP ของผู้ใช้จริงและสามารถหลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุ และไม่ต้องสมัครสมาชิก
- ความครอบคลุม: IP ที่จัดหาตามหลักจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
URL ของรูปภาพอยู่ตรงไหนในหน้าเว็บ?
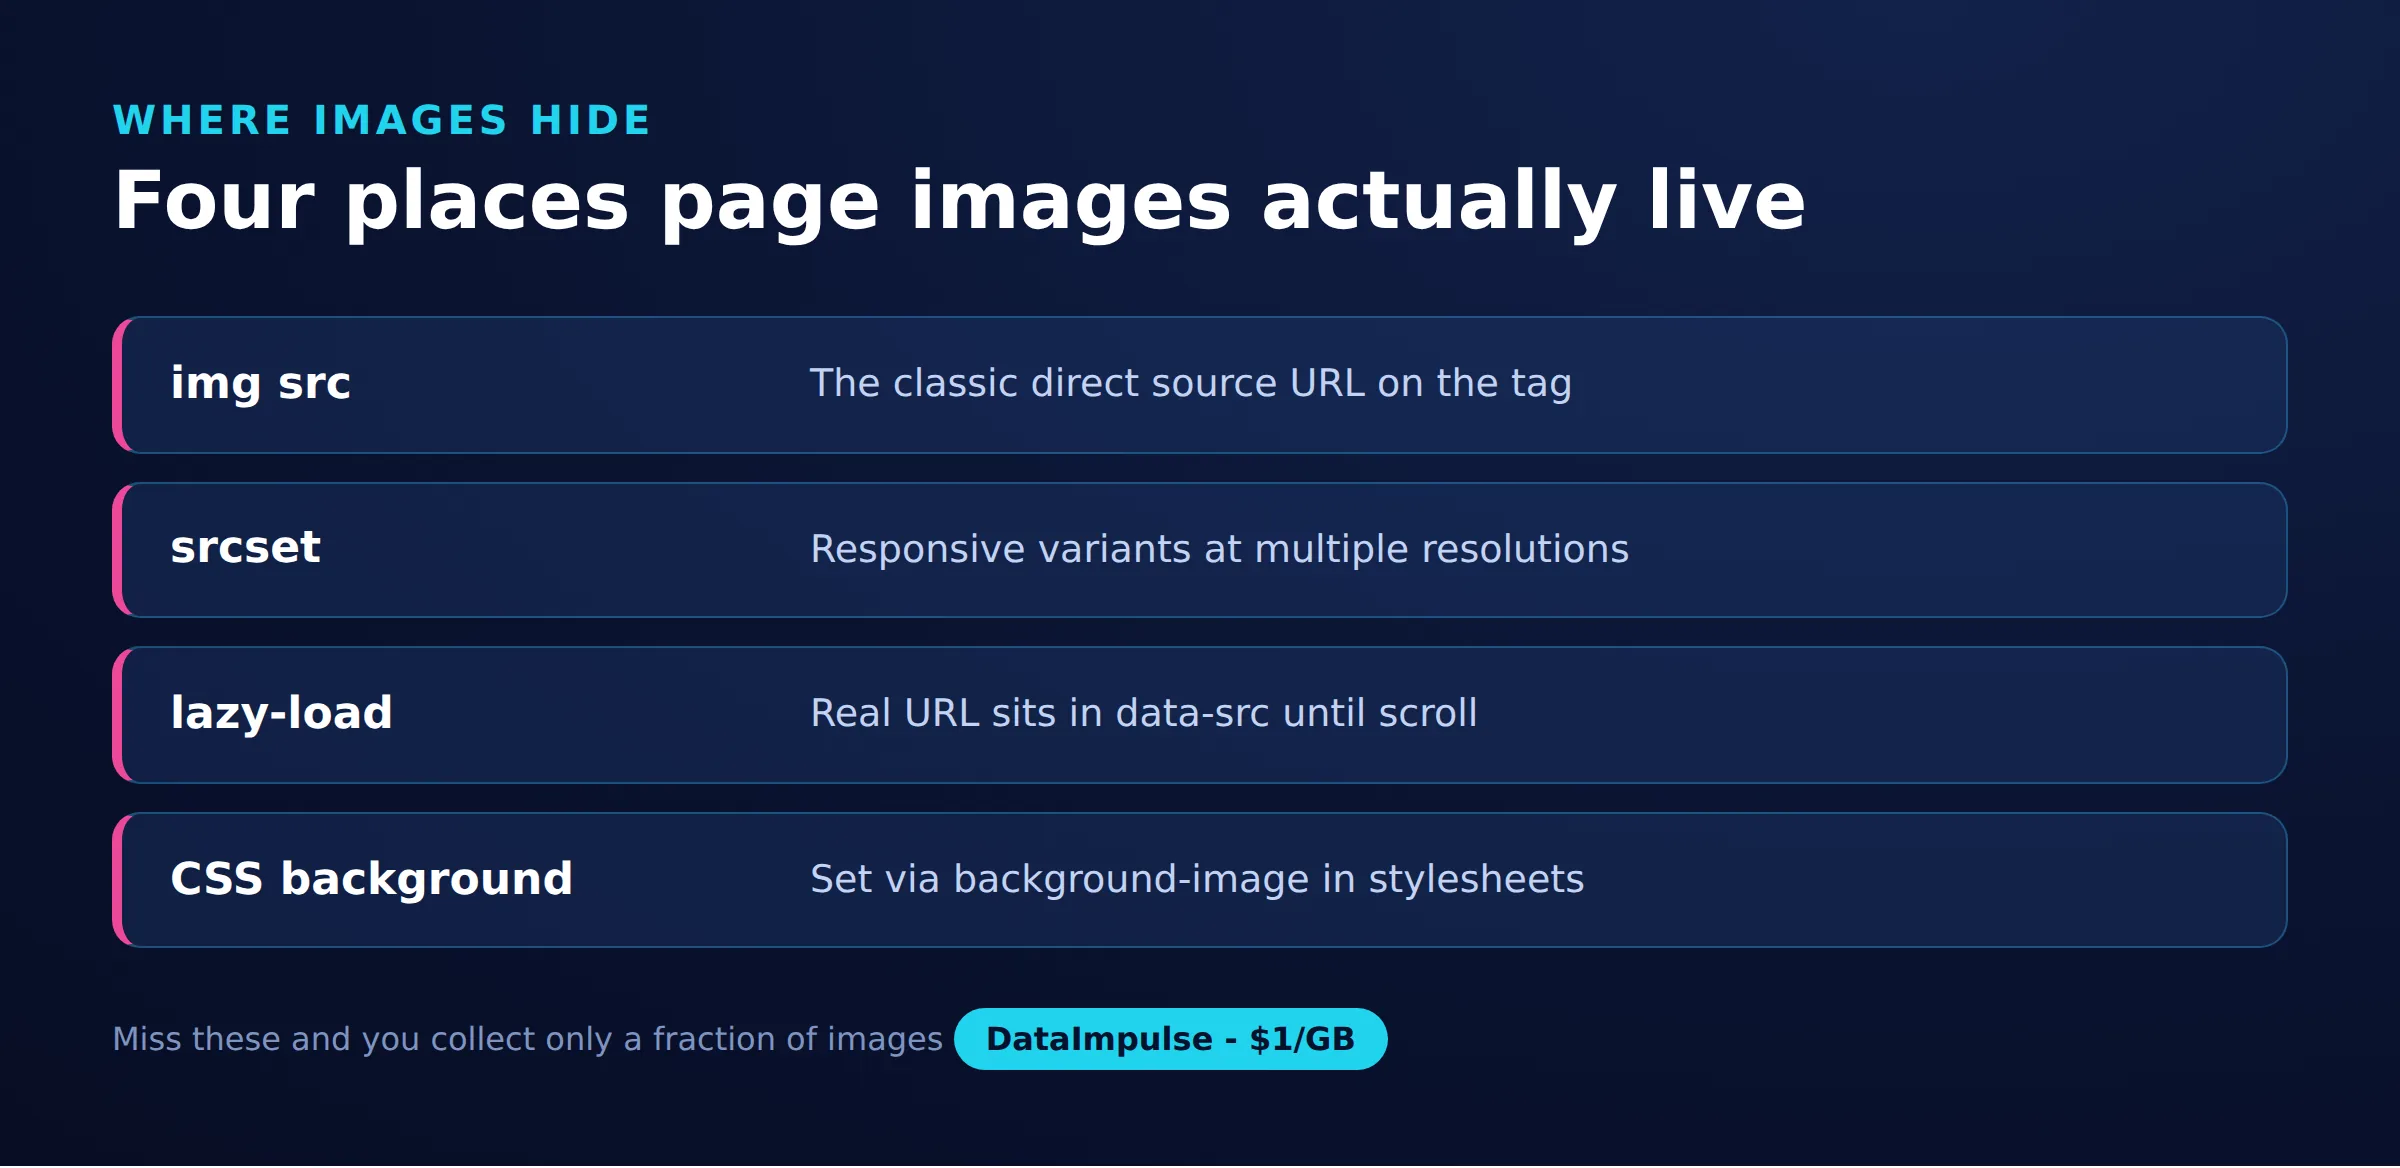
URL ของรูปภาพถูกเก็บไว้หลายตำแหน่ง ไม่ได้อยู่แค่ใน src เท่านั้น ดังนั้น scraper ที่เชื่อถือได้จึงต้องตรวจสอบทุกตำแหน่ง หน้าเว็บอาจอ้างถึงรูปเดียวกันผ่านแท็กมาตรฐาน attribute แบบ responsive, placeholder ของ lazy-loading, stylesheet และ structured data
- รูปภาพมาตรฐาน:
srcของ<img>เก็บ URL โดยตรง - รูปภาพแบบ responsive:
srcsetบน<img>และ<source>แสดง URL หลายรายการพร้อมตัวระบุความกว้างหรือความหนาแน่น เพื่อให้เบราว์เซอร์เลือกขนาดได้ - รูปภาพที่ lazy-load:
srcที่มองเห็น ที่มองเห็นมักเป็น placeholder ขนาดเล็ก ส่วน URL จริงอยู่ในdata-src,data-original, หรือ custom attribute ที่คล้ายกันจนกว่าผู้ใช้จะเลื่อนหน้า - พื้นหลัง CSS: รูปภาพตกแต่งถูกกำหนดด้วย
background-image: url(...)ใน inline style หรือ stylesheet และจะไม่ปรากฏใน<img>เลย - ข้อมูลที่มีโครงสร้าง: หน้าสินค้าและบทความมักระบุรูปภาพความละเอียดสูงที่เป็น canonical ไว้ในบล็อก JSON-LD
เนื่องจากแหล่งข้อมูลกระจายอยู่เช่นนี้ ให้มองหน้าเว็บเป็นชุดของแหล่งที่มาเป้าหมาย และรวบรวมจากทุกตำแหน่งเหล่านี้ก่อนดาวน์โหลด ตารางด้านล่างสรุปตำแหน่งของแต่ละแหล่งและข้อควรระวังที่มักทำให้ scraper ส่วนใหญ่พลาด
| แหล่งสำหรับดึงข้อมูล | ตำแหน่งที่พบ | ข้อควรระวังที่พบบ่อย |
|---|---|---|
| img src | attribute src ของแท็ก img | มักเป็น placeholder หรือ data: URI ในหน้าที่ lazy-load |
| srcset | srcset บนแท็ก img และ source | เก็บ URL หลายรายการพร้อมตัวระบุความกว้าง คุณต้องแยกวิเคราะห์และเลือกหนึ่งขนาด |
| attribute ของ lazy-load | data-src, data-original, data-lazy-src, data-srcset | ชื่อ attribute แตกต่างกันตาม framework จึงควรตรวจสอบ markup จริง |
| พื้นหลัง CSS | inline style และบล็อก style, background-image: url() | ไม่ปรากฏในแท็ก img เลย ต้องใช้ regex กับข้อความ CSS |
| JSON-LD | แท็ก script ที่มี type application/ld+json | ฟิลด์ image อาจเป็นสตริง รายการ หรืออ็อบเจ็กต์ซ้อนกัน |
จะตั้งค่า Python image scraper อย่างไร?
ติดตั้ง requests สำหรับ HTTP, BeautifulSoup สำหรับแยกวิเคราะห์ และ lxml เป็น backend parser ที่รวดเร็ว จากนั้นดึงหน้าเว็บและอ่าน src ของแท็กรูปภาพทุกแท็ก ตัวอย่างขั้นต่ำนี้คือพื้นฐานของทุกขั้นตอนถัดไป
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Session ช่วยคงการเชื่อมต่อและใช้ headers ซ้ำ จึงเร็วกว่าและกระทบเซิร์ฟเวอร์เป้าหมายน้อยกว่าการเปิดการเชื่อมต่อใหม่ทุก request ควรเรียก urljoin เพื่อให้ path แบบสัมพัทธ์อย่าง /media/photo.jpg กลายเป็น URL แบบสัมบูรณ์ที่ดาวน์โหลดได้ภายหลัง หากคุณเพิ่งเริ่มต้น workflow ที่กว้างขึ้น คู่มือ แนวทางปฏิบัติที่ดีสำหรับ web scraping อธิบาย headers, timeout และความสุภาพในการใช้งานโดยละเอียด
จะดึง img src, srcset และแหล่งข้อมูลที่ lazy-load อย่างไร?
แยกวิเคราะห์ srcset โดยแยกด้วยเครื่องหมายจุลภาคและอ่านตัวระบุความกว้างเพื่อเลือก variant ที่ใหญ่ที่สุด และอ่านทุก data- ที่เป็นไปได้สำหรับแหล่งข้อมูล lazy-load การอ่าน attribute แบบธรรมดาจะพลาดข้อมูลส่วนใหญ่ของเว็บสมัยใหม่ จึงต้องมี helper เล็ก ๆ สำหรับแต่ละรูปแบบ
srcset เก็บ URL หลายรายการพร้อมตัวระบุอย่าง 800w. หากต้องการสำเนาที่มีความละเอียดสูงสุด ให้เปรียบเทียบตัวเลขความกว้างและเก็บรายการที่ใหญ่ที่สุด
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
ต่อไปรวมแหล่งข้อมูลมาตรฐาน แบบ responsive และ lazy ไว้ใน collector เดียว framework แต่ละแบบใช้ชื่อ attribute ต่างกัน จึงควรตรวจสอบหลายชื่อ ฟังก์ชันเดียวกันยังอ่านแท็ก <source> ภายใน <picture> ซึ่งมี srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
การข้าม src ที่ขึ้นต้นด้วย data: ช่วยหลีกเลี่ยงการบันทึก placeholder base64 แบบ inline ซึ่งมักเป็นภาพขนาดย่อคุณภาพต่ำที่ lazy loader แสดงก่อนรูปจริงจะมาถึง
จะค้นหารูปภาพพื้นหลัง CSS และ JSON-LD อย่างไร?
ใช้ regular expression เพื่อดึง URL ออกจากคำสั่ง background-image และไล่ดูทุกบล็อก JSON-LD เพื่ออ่านฟิลด์ image แหล่งข้อมูลทั้งสองนี้ไม่ปรากฏใน <img> ดังนั้น scraper ที่อ่านเฉพาะแท็กรูปภาพจะพลาดทั้งหมด
รูปภาพตกแต่งและ hero image มักถูกกำหนดใน CSS ให้สแกนทั้ง attribute style แบบ inline และบล็อก <style> เพื่อหาค่า url(...)
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
ข้อมูลที่มีโครงสร้างเป็นตำแหน่งที่เชื่อถือได้ที่สุดสำหรับหารูปภาพแบบ canonical ความละเอียดเต็มในหน้าสินค้าและบทความ ค่า image อาจเป็นสตริง รายการ หรืออ็อบเจ็กต์ซ้อนกัน จึงควรไล่ดูทั้งโครงสร้าง
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
รวม collector ทั้งสามด้วย set union เช่น collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base) แล้วคุณจะได้ชุด URL เป้าหมายที่ลบข้อมูลซ้ำแล้วพร้อมดาวน์โหลด
จะดาวน์โหลดไฟล์รูปภาพอย่างปลอดภัยได้อย่างไร?
สตรีมแต่ละ response ตรวจสอบว่า header Content-Type เป็นรูปภาพจริง และจำกัดขนาดเพื่อไม่ให้ไฟล์เดียวใช้หน่วยความจำหรือดิสก์จนหมด การดาวน์โหลด URL โดยไม่ตรวจสอบเสี่ยงต่อการบันทึกหน้า error แบบ HTML, redirect หรือไฟล์ขนาดใหญ่ จึงควรตรวจสอบก่อนเก็บไบต์
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
การสตรีมด้วย stream=True และ iter_content ทำให้ตรวจสอบ header ก่อนดาวน์โหลด body ทั้งหมด จึงปฏิเสธลิงก์ที่ระบุประเภทผิดได้เร็ว การตรวจสอบประเภทที่รายงานช่วยจับกรณีทั่วไปที่ URL เสียส่งคืนหน้า HTML 404 พร้อมสถานะ 200 เพื่อความปลอดภัยเพิ่มเติม คุณอาจตรวจสอบ magic bytes แรกของ payload ได้ด้วย แต่การตรวจสอบ header ร่วมกับการจำกัดขนาดรองรับงาน scraping ในโลกจริงได้เกือบทั้งหมด
จะลบข้อมูลซ้ำและตั้งชื่อรูปภาพที่ดาวน์โหลดอย่างไร?
แฮชไบต์ที่ดาวน์โหลดด้วย SHA-256 และข้าม digest ที่บันทึกไว้แล้ว จากนั้นทำความสะอาดชื่อไฟล์และแบ่งไฟล์ลงโฟลเดอร์ย่อยตามคำนำหน้า hash เว็บไซต์มักส่งรูปเดียวกันผ่านหลาย path, CDN หรือ variant ของขนาด ดังนั้น content hash จึงเชื่อถือได้กว่าการเปรียบเทียบ URL
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
การทำความสะอาด basename จะลบอักขระ path traversal และข้อมูลขยะใน query string เพื่อไม่ให้ URL ที่เป็นอันตรายหรือยุ่งเหยิงเขียนไฟล์นอกโฟลเดอร์เป้าหมาย การแบ่งตามอักขระ hash สองตัวแรกช่วยให้ไดเรกทอรีมีขนาดเล็ก ซึ่งสำคัญเมื่อคุณเก็บไฟล์หลายหมื่นไฟล์ สำหรับการตรวจหารูปที่เกือบซ้ำกัน เช่น รูปเดียวกันคนละความละเอียด ให้ใช้ไลบรารี perceptual hash อย่าง imagehash เพื่อจัดกลุ่มไฟล์ที่หน้าตาคล้ายกัน ซึ่ง byte hash มองว่าแตกต่างกัน
จะดาวน์โหลดรูปภาพจำนวนมากพร้อมกันอย่างไร?
ใช้ ThreadPoolExecutor เพื่อดาวน์โหลดรูปภาพหลายรูปพร้อมกัน และเพิ่ม rate limiter ที่ใช้ร่วมกันเพื่อให้ทุก thread รวมกันไม่เกินขีดจำกัด requests ต่อวินาที การดาวน์โหลดรูปภาพเป็นงาน I/O bound ดังนั้น thread ช่วยเพิ่มความเร็วได้มาก แต่การทำงานพร้อมกันแบบไร้ขีดจำกัดจะถาโถมใส่เป้าหมายและทำให้คุณถูกบล็อก
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
lock รอบ seen ทำให้การลบข้อมูลซ้ำปลอดภัยสำหรับ thread และการห่อแต่ละ job ด้วยบล็อก try หมายความว่า URL ที่มีปัญหาหนึ่งรายการจะไม่หยุดการทำงานทั้งหมด ควรตั้ง rate ให้พอเหมาะ โดยไม่กี่ request ต่อวินาทีเป็นค่าเริ่มต้นที่สมเหตุสมผล และอ่านคู่มือ web scraping อย่างมีจริยธรรม เพื่อดูวิธีเลือกขีดจำกัดที่เคารพเว็บไซต์
จะ scrape รูปภาพขนาดใหญ่ด้วย proxy อย่างไร?
คุณต้องใช้ proxy เมื่อเป้าหมายเริ่มจำกัดอัตราหรือบล็อก IP ของคุณ ซึ่งเกิดขึ้นได้เร็วเมื่อดาวน์โหลดรูปภาพจำนวนมากจากที่อยู่เดียว ส่ง dictionary proxies ไปยังทุก request เพื่อให้ลูปดาวน์โหลดเดียวกันวิ่งผ่าน rotating residential IP การส่ง request รูปภาพอย่างต่อเนื่องจาก IP เดียวเป็นรูปแบบอัตโนมัติที่เห็นได้ชัด และรูปภาพใช้ข้อมูลมาก ดังนั้นแบนด์วิดท์จึงมักเป็นข้อจำกัดจริง
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Rotating proxy กระจาย request ไปยัง IP จำนวนมากเพื่อไม่ให้ที่อยู่ใดที่หนึ่งดึงดูดความสนใจ ขณะที่ sticky session จะคง IP เดียวไว้สำหรับแกลเลอรีที่เว็บไซต์ผูกกับ session DataImpulse มี residential proxy และ mobile proxy สำหรับเป้าหมายที่ตรวจสอบทราฟฟิกอย่างละเอียด พร้อมทั้ง datacenter proxy สำหรับการดาวน์โหลดปริมาณมากจากแหล่งที่ยอมรับได้ IP ทั้งหมดจัดหาตามหลักจริยธรรมจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน หากข้อมูลรับรองของคุณถูกปฏิเสธด้วย 407 คู่มือ การยืนยันตัวตนของ proxy อธิบายรูปแบบการเข้าสู่ระบบที่ถูกต้อง
เนื่องจากทุกไบต์ที่ดาวน์โหลดจะนับรวมในงบทราฟฟิกของคุณ จึงควรวางแผนขนาดก่อนเริ่ม: ข้ามรูปภาพที่ต่ำกว่าเกณฑ์หากต้องการเฉพาะเนื้อหาหลัก ขอ variant srcset ที่เล็กลงเมื่อไม่ต้องการความละเอียดเต็ม และ cache สิ่งที่มีอยู่แล้วเพื่อไม่ให้การรันซ้ำดึงทุกอย่างใหม่ DataImpulse ใช้การคิดค่าบริการตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ ดังนั้นงานรูปภาพที่หนักแต่ทำเป็นครั้งคราวจึงไม่ต้องสมัครรายเดือน และทราฟฟิกที่ไม่ได้ใช้จะยกไปใช้ต่อได้
จะ scrape แกลเลอรีที่ render ด้วย JavaScript อย่างไร?
หากเว็บไซต์สร้างแกลเลอรีทั้งหมดด้วย JavaScript, URL ของรูปภาพจะไม่ปรากฏใน HTML ดิบ ดังนั้นให้ render หน้าเว็บด้วย Playwright ก่อน แล้วส่งผลลัพธ์ไปยัง collector เดิม requests เพียงอย่างเดียวไม่สามารถเรียกใช้ script ได้ ดังนั้นแกลเลอรีแบบ infinite-scroll และ single-page จึงต้องใช้เบราว์เซอร์จริงเพื่อกระตุ้นการโหลด
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
การเลื่อนแบบวนลูปบังคับให้ lazy loader สลับ placeholder data-src เป็น URL จริง จากนั้น parser เดิมที่คุณเขียนไว้จะดึงข้อมูลได้ สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับ headless rendering โปรดดู การ scrape หน้าเว็บแบบ dynamic.
สุดท้าย ให้เขียน CSV manifest เพื่อให้ติดตามไฟล์ที่ดาวน์โหลดทุกไฟล์ย้อนกลับไปยัง URL ต้นทาง, hash และขนาดได้ manifest เปลี่ยนโฟลเดอร์ของไฟล์ที่ไม่ระบุข้อมูลให้เป็น dataset ที่คุณตรวจสอบ ทำงานต่อ และลบข้อมูลซ้ำข้ามการรันได้
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
เมื่อมี manifest แล้ว คุณสามารถรันงานซ้ำและข้าม URL ที่บันทึกไว้แล้ว ช่วยประหยัดแบนด์วิดท์และทำให้ dataset ของคุณสอดคล้องกันตามเวลา
การ scrape และนำรูปภาพจากเว็บไซต์กลับมาใช้ถูกต้องหรือไม่?
การดาวน์โหลดไฟล์รูปภาพเป็นการกระทำทางเทคนิค ไม่ได้ให้ใบอนุญาตใด ๆ แก่คุณในการนำรูปนั้นกลับมาใช้ นี่คือส่วนของการ scrape รูปภาพที่คนเข้าใจผิดมากที่สุด จึงควรพิจารณาอย่างรอบคอบ ภาพถ่าย ภาพประกอบ และกราฟิกบนเว็บเกือบทุกชิ้นได้รับการคุ้มครองลิขสิทธิ์ทันทีที่สร้าง และผู้ที่ถ่ายหรือสร้างผลงานนั้นถือสิทธิ์เหล่านั้น เว้นแต่จะปล่อยสิทธิ์ไว้อย่างชัดเจน
การที่ดึงไฟล์ได้ไม่ได้บอกอะไรเกี่ยวกับสิทธิ์ของคุณในการเผยแพร่ซ้ำ ขาย ใช้ฝึกโมเดล หรือแจกจ่ายต่อ ก่อนนำรูปภาพที่ scrape กลับมาใช้ ให้ตรวจสอบเงื่อนไขใบอนุญาตที่แนบไว้ มองหาใบอนุญาตที่ระบุไว้ เช่น Creative Commons หรือ public domain และขออนุญาตเป็นลายลักษณ์อักษรเมื่อเป็นการใช้เชิงพาณิชย์ การรวบรวมรูปภาพเพื่อการวิเคราะห์ส่วนตัว การทำดัชนี หรือการวิจัย เป็นคนละประเด็นกับการเผยแพร่ และแนวทางที่ปลอดภัยคือให้ถือว่ารูปภาพได้รับการคุ้มครอง เว้นแต่ใบอนุญาตจะระบุชัดเจนว่าไม่ใช่
ควรตรวจสอบข้อกำหนดการให้บริการและ robots.txt ของเว็บไซต์เป้าหมายก่อนเริ่ม คู่มือ ตรวจสอบว่าเว็บไซต์อนุญาตให้ scrape หรือไม่ แสดงวิธีอ่านสัญญาณเหล่านั้น และคู่มือ scrape โดยไม่ถูกบล็อก อธิบายแนวปฏิบัติในการ crawling ที่เคารพเว็บไซต์ ไม่มีเทคนิคใดในบทความนี้เปลี่ยนหลักการพื้นฐานได้: การเข้าถึงไม่ใช่ใบอนุญาต และข้อเท็จจริงคือ scraper ที่ทำงานได้กับสิทธิ์ตามกฎหมายในการนำกลับมาใช้เป็นสองเรื่องแยกกันที่คุณต้องปฏิบัติให้ครบโดยอิสระ
คำถามที่พบบ่อย
ฉัน scrape รูปภาพจากทุกเว็บไซต์ได้หรือไม่?
ในทางเทคนิค คุณสามารถดาวน์โหลดไฟล์จากเว็บไซต์ส่วนใหญ่ได้ แต่ควรตรวจสอบข้อกำหนดการให้บริการและ robots.txt ของเว็บไซต์ก่อน และโปรดจำไว้ว่าการดาวน์โหลดรูปภาพไม่ได้ให้สิทธิ์ในการนำกลับมาใช้ การเข้าถึงไม่ใช่ใบอนุญาต
เหตุใดรูปภาพบางรูปจึงไม่ปรากฏใน HTML ที่ฉันดาวน์โหลด?
รูปภาพเหล่านั้นมักโหลดด้วย JavaScript หรือ lazy-loading ดังนั้น URL จริงจึงอยู่ใน data attribute หรือถูกเพิ่มหลังหน้าเว็บ render ให้ render หน้าเว็บด้วย headless browser อย่าง Playwright และเลื่อนเพื่อกระตุ้นการโหลด แล้วจึงแยกวิเคราะห์ผลลัพธ์
ฉันจะเลือกเวอร์ชันความละเอียดสูงสุดของรูปภาพได้อย่างไร?
แยกวิเคราะห์ attribute srcset อ่านตัวระบุความกว้างหลัง URL แต่ละรายการ และเก็บ URL ที่มีความกว้างมากที่สุด หน้าสินค้ามักระบุรูปภาพความละเอียดเต็มไว้ในบล็อก JSON-LD ด้วย
ฉันจะหลีกเลี่ยงการดาวน์โหลดรูปเดิมซ้ำสองครั้งได้อย่างไร?
คำนวณ hash SHA-256 ของไฟล์ที่ดาวน์โหลดแต่ละไฟล์ และข้าม hash ที่บันทึกไว้แล้ว สำหรับสำเนาที่หน้าตาคล้ายกันแต่ขนาดต่างกัน ให้ใช้ไลบรารี perceptual hash เช่น imagehash แทน
DataImpulse มี API สำหรับ scrape รูปภาพแบบดูแลจัดการให้หรือไม่?
ไม่มี DataImpulse มี proxy ที่คุณนำ scraper ของตนเองวิ่งผ่าน ไม่ใช่ API scraping แบบดูแลจัดการหรือบริการ web-proxy ฟรี คุณเขียน logic การดาวน์โหลดและใช้ IP ของบริการเพื่อการเข้าถึงและการสลับ IP
เมื่อใดที่ DataImpulse ไม่ใช่ตัวเลือกที่เหมาะสม?
หากคุณต้องการ static ISP proxy, API scraping แบบดูแลจัดการเต็มรูปแบบ หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น rotating residential, mobile และ datacenter proxy สำหรับการรวบรวมข้อมูลสาธารณะและการเข้าถึงเนื้อหา
เริ่ม scrape รูปภาพในปริมาณมาก
เมื่อ image scraper ของคุณต้องการการเข้าถึงที่เชื่อถือได้และการสลับ IP โดยไม่ต้องสมัครสมาชิก DataImpulse มี residential, mobile และ datacenter proxy ที่จัดหาตามหลักจริยธรรม พร้อมทราฟฟิกแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB สร้างบัญชี แล้วกำหนดให้ลูปดาวน์โหลดวิ่งผ่านบริการได้ภายในไม่กี่นาที