
In this Article
Sapere come verificare se un sito web consente lo scraping fa la differenza tra una pipeline di dati stabile e il blocco di un account o un reclamo legale. Prima di scrivere una sola riga di uno scraper, una breve verifica preliminare del sito ti dice cosa consente, cosa scoraggia e dove si trova il rischio reale.
Questo articolo illustra i segnali pratici da controllare: il file robots.txt, le clausole dei termini di servizio sull’accesso automatizzato, le API ufficiali, gli header dei limiti di frequenza, i tag meta robots, la sitemap e la differenza tra dati pubblici e dati protetti da login. Si conclude con un rapido schema decisionale che puoi riutilizzare per qualsiasi target.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Informazioni chiave
- Verifica preliminare: per controllare se un sito web consente lo scraping, leggi il suo robots.txt, esamina i termini di servizio per le clausole sull’accesso automatizzato e cerca un’API ufficiale prima di inviare richieste.
- Miglior tipo di proxy: residential proxy rotating, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90M di IP ottenuti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Cosa ti dice robots.txt sullo scraping?
Il file robots.txt esprime la preferenza dichiarata di un sito su come dovrebbero comportarsi i client automatizzati ed è pubblicato nella radice del dominio, ad esempio example.com/robots.txt. Elenca i percorsi che i crawler possono o non possono richiedere, ma è un’indicazione e non una legge.
Il file è suddiviso in record. Ogni record inizia con una riga User-agent che indica il bot a cui si applica, seguita dalle regole. Le direttive principali sono:
- User-agent: il crawler a cui sono destinate le regole. Un asterisco indica tutti i bot.
- Disallow: un prefisso di percorso che il sito chiede ai bot di non richiedere.
- Allow: un percorso consentito, spesso usato per ritagliare un’eccezione da un Disallow più ampio.
- Crawl-delay: una pausa richiesta in secondi tra le richieste. Non tutti i crawler la rispettano, ma segnala il ritmo che il sito si aspetta.
- Sitemap: un URL assoluto che punta alla sitemap del sito, che elenca le pagine che il proprietario desidera siano individuate.
Ecco un piccolo esempio:
User-agent: *
Disallow: /private/
Allow: /private/public-page.html
Crawl-delay: 10

Sitemap: https://example.com/sitemap.xml
Leggilo così: a tutti i bot viene chiesto di evitare /private/ tranne una pagina, di aspettare dieci secondi tra le richieste e di usare la sitemap elencata. Poiché robots.txt è una convenzione e non un blocco tecnico, trattalo come il chiaro desiderio espresso dal proprietario. Ignorare un Disallow non viola una password, ma significa agire contro una richiesta esplicita, il che conta per la reputazione e in qualsiasi controversia successiva.
Dove trovi le clausole dei termini di servizio sull’accesso automatizzato?
Cerca nei Termini di servizio, nelle Condizioni d’uso o nella Politica di utilizzo accettabile del sito, di solito collegati nel footer. Questi documenti, non robots.txt, sono il luogo in cui un sito stabilisce regole vincolanti su scraping, crawling e bot.
Cerca nel testo parole come scrape, crawl, robot, spider, automated, harvest, data mining e bulk. Alcuni siti vietano del tutto qualsiasi raccolta automatizzata, alcuni la consentono solo per uso personale o non commerciale e altri la permettono tramite un canale approvato come un’API. I termini hanno spesso più peso di robots.txt perché un utente può essere considerato come se li avesse accettati, quindi leggi attentamente il testo sull’accesso automatizzato prima di sviluppare. Se stai valutando il quadro legale più ampio, la nostra guida su lo scraping web è legale spiega come queste clausole interagiscono con le norme sulla protezione dei dati e sull’accesso.
Dovresti cercare prima un’API ufficiale?
Sì. Prima di estrarre HTML, verifica se il sito offre un’API ufficiale, perché un’API autorizzata è di solito il modo più stabile, consentito e manutenibile per ottenere gli stessi dati. Molte piattaforme ne pubblicano una su un sottodominio per sviluppatori o API, oppure la collegano dalla documentazione.
Un’API fornisce risposte strutturate, limiti di frequenza documentati e termini scritti specificamente per l’uso programmatico, eliminando gran parte dell’incertezza dello scraping di una pagina il cui layout può cambiare in qualsiasi momento. Gli svantaggi sono che le API possono richiedere una chiave, limitare il volume o non esporre ogni campo della pagina. Anche così, quando un’API soddisfa la tua esigenza vale la pena usarla per prima, e lo scraping del sito renderizzato diventa il ripiego invece dell’impostazione predefinita.
Come si leggono i limiti di frequenza e le risposte 429?
I limiti di frequenza indicano quanto velocemente un sito è disposto a servire richieste automatizzate e il segnale più chiaro è una risposta HTTP 429 Too Many Requests. Quando la vedi, il server ti sta chiedendo di rallentare.
Osserva questi segnali nelle risposte:
- Stato 429: hai superato ciò che il server consente al momento.
- Retry-After: un header, in secondi o come data, che ti dice quanto attendere prima di riprovare. Rispettalo.
- Header dei limiti di frequenza: campi come X-RateLimit-Limit e X-RateLimit-Remaining che espongono la tua quota e quanto ne resta.
Rispettare questi segnali rende il tuo accesso sostenibile e riduce il carico sul target. Distribuire le richieste tra sessioni o IP con residential proxy può aiutarti a restare entro limiti cortesi per indirizzo, ma non annulla i limiti dichiarati dal sito né i suoi termini. L’obiettivo è adeguarsi al ritmo segnalato dal server, non aggirarlo. Per una tecnica più ampia, consulta la nostra guida su scraping senza essere bloccato.
Cosa segnalano i tag meta robots e sitemap.xml?
Un tag meta robots controlla l’indicizzazione nei motori di ricerca, mentre una sitemap.xml elenca gli URL che un sito vuole siano individuati. Nessuno dei due concede o nega il permesso di fare scraping, ma entrambi sono segnali utili da interpretare correttamente.
Un tag meta robots come noindex, scritto nell’head della pagina o inviato come header X-Robots-Tag, comunica ai crawler di ricerca come Googlebot se indicizzare una pagina o seguirne i link. Un valore noindex chiede ai motori di ricerca di escludere la pagina dai risultati. È un’affermazione sulla visibilità nella ricerca, non un’impostazione di autorizzazione per la raccolta di dati, quindi interpretarla come via libera o divieto di scraping è un errore comune.
La sitemap.xml, di solito collegata da robots.txt o disponibile in example.com/sitemap.xml, è l’elenco del proprietario delle pagine che vale la pena mostrare, talvolta suddiviso in un indice di più file. Usarla per trovare URL canonici e pubblici è efficiente e rispettoso, poiché richiedi pagine che il proprietario ha già scelto di esporre invece di indovinare percorsi. È una mappa utile, non un invito generalizzato, e i termini di servizio disciplinano ancora ciò che puoi fare con il contenuto dopo averlo recuperato.
Perché i dati protetti da login sono più rischiosi dei dati pubblici?
I dati pubblici che chiunque può raggiungere senza accedere comportano un rischio inferiore rispetto ai dati dietro un login, che rientrano nei termini dell’account che hai accettato al momento della registrazione. Superare quella soglia cambia sensibilmente il quadro.
Quando una pagina richiede l’autenticazione, hai accettato i termini della piattaforma per entrare e tali termini quasi sempre limitano la raccolta automatizzata più strettamente delle pagine pubbliche. Lo scraping dietro un login può violare le regole dell’account e anti-elusione e mettere il tuo account a rischio di sospensione. Come regola pratica, privilegia i dati apertamente accessibili senza credenziali e tratta la raccolta protetta da login come una decisione che richiede un permesso esplicito o un’API autorizzata. DataImpulse fornisce proxy etici per un accesso giustificato ai dati web pubblici, non un modo per aggirare l’autenticazione.
Qual è un rapido schema decisionale per lo scraping di un sito?
La versione breve: raccogli i segnali, poi decidi. Segui questa checklist prima di impegnarti su un target.
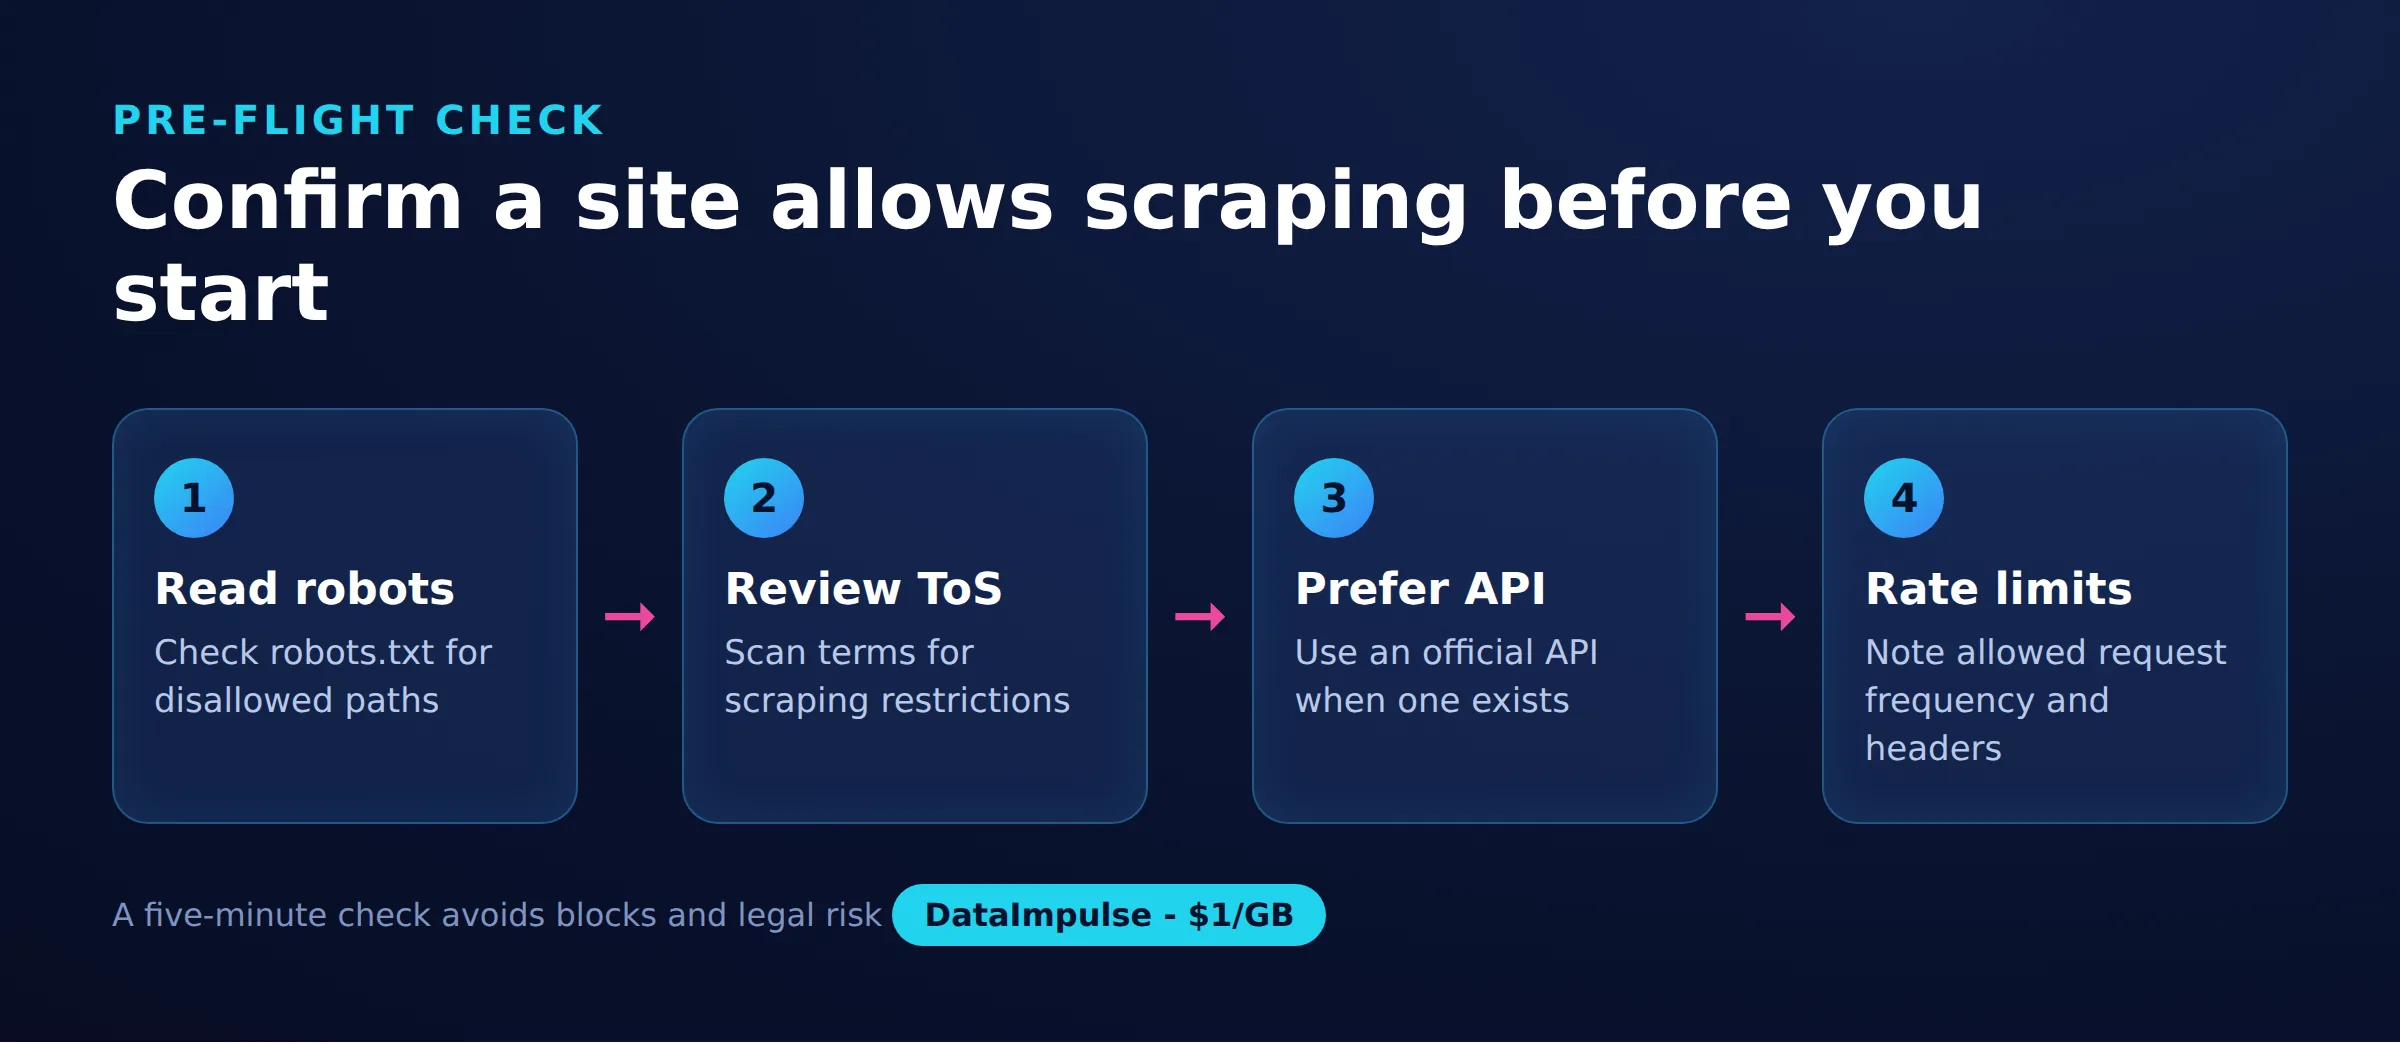
- Leggi robots.txt: annota eventuali percorsi Disallow, Crawl-delay e la sitemap. Rispetta le preferenze dichiarate.
- Controlla i termini di servizio: cerca clausole sull’accesso automatizzato e verifica se lo scraping è vietato, limitato o indirizzato a un’API.
- Cerca un’API: se un’API ufficiale soddisfa la tua esigenza, preferiscila.
- Valuta i dati: sono pubblici o protetti da login? I dati pubblici comportano meno rischi; quelli protetti da login richiedono il permesso.
- Pianifica i limiti di frequenza: rispetta 429 e Retry-After e calibra le richieste sul ritmo segnalato dal server.
Se i termini lo vietano o i dati sono bloccati dietro un login senza autorizzazione, fermati o cerca un’API. Se i dati sono pubblici, i termini non dicono nulla o sono permissivi e puoi eseguire il crawling con garbo entro i limiti del sito, ti trovi su basi molto più solide. Anche procurarsi IP in modo responsabile conta, ed è per questo che DataImpulse si concentra su indirizzi ottenuti eticamente per una raccolta conforme di dati pubblici.
Segnali da controllare prima dello scraping
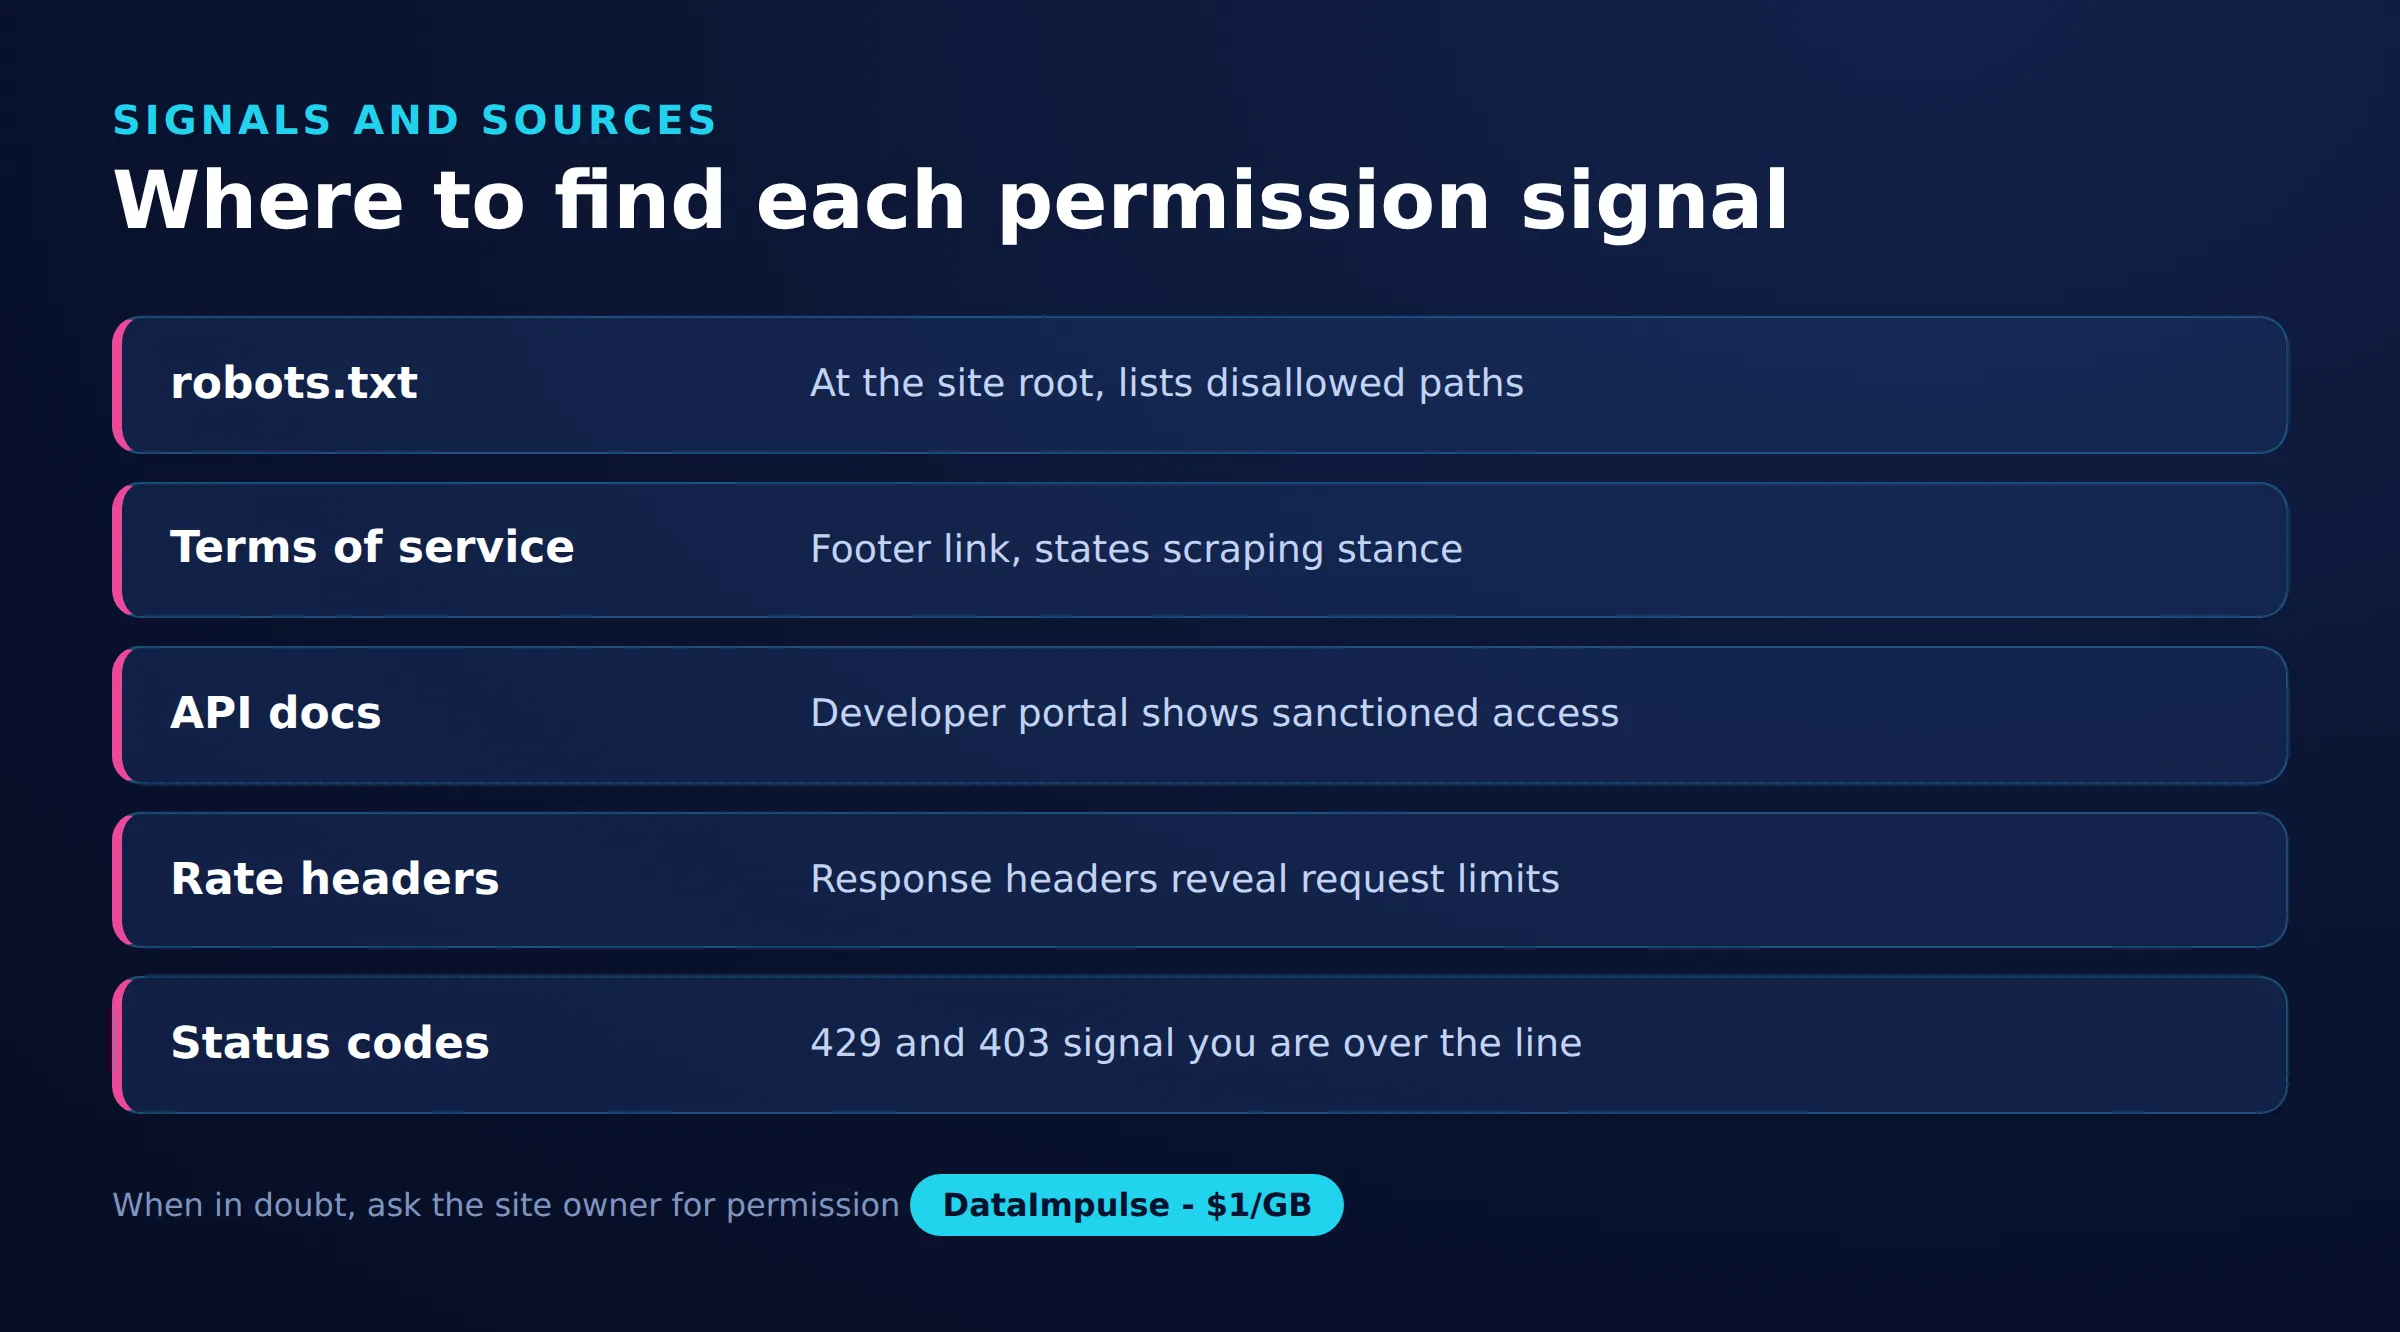
| Segnale | Dove trovarlo | Cosa indica |
|---|---|---|
| robots.txt | Percorso radice del sito | Percorsi consentiti e bloccati |
| Termini di servizio | Pagina legale nel footer | Regole di scraping dichiarate |
| API ufficiale | Documentazione per sviluppatori | Accesso autorizzato ai dati |
| Header dei limiti di frequenza | Risposta HTTP | Limiti di richiesta consentiti |
| sitemap.xml | Percorso radice del sito | Elenco delle pagine sottoponibili a crawling |
Domande frequenti
robots.txt mi impedisce legalmente di fare scraping di un sito?
No. Robots.txt è una convenzione consultiva che indica le preferenze del proprietario del sito per i client automatizzati. Non è un blocco tecnico né una legge, ma ignorarlo significa agire contro una richiesta esplicita, il che può contare nelle controversie e per la tua reputazione.
Controllare i termini di servizio di un sito è sufficiente da solo?
È la singola fonte più importante, ma non l’unica. Combina i termini di servizio con robots.txt, la presenza di un’API ufficiale e il fatto che i dati siano pubblici o protetti da login per avere un quadro completo prima dello scraping.
Cosa significa una risposta HTTP 429 durante lo scraping?
Una risposta 429 Too Many Requests significa che hai superato la frequenza attualmente consentita dal server e dovresti rallentare. Controlla l’header Retry-After per sapere quanto attendere e calibra le richieste future sui limiti del server.
Posso estrarre dati che sono dietro un login?
I dati protetti da login sono più rischiosi perché hai accettato i termini della piattaforma al momento della registrazione e tali termini di solito limitano la raccolta automatizzata. Trattali come qualcosa che richiede un permesso esplicito o un’API autorizzata anziché come un target predefinito.
Un tag meta noindex significa che una pagina non può essere sottoposta a scraping?
No. Un tag noindex indica ai motori di ricerca di non indicizzare la pagina nei risultati. Controlla la visibilità nella ricerca, non l’autorizzazione allo scraping, quindi usa robots.txt e i termini di servizio per valutare se la raccolta sia appropriata.
Quando DataImpulse non è la soluzione adatta?
Se hai bisogno di proxy ISP statici, di un’API di scraping completamente gestita o dell’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter rotating per raccogliere dati pubblici e accedere ai contenuti.
Raccogli dati web pubblici in modo responsabile
Dopo aver controllato robots.txt, i termini di servizio e confermato che i dati sono pubblici, DataImpulse ti offre IP ottenuti eticamente in 195 paesi per una raccolta conforme. Crea un account e inizia da 1 dollaro per GB con traffico senza scadenza.