
In this Article
Il web scraping etico consiste nel raccogliere dati dai siti web nel rispetto del server di destinazione, della normativa applicabile e delle persone le cui informazioni possono comparire in tali dati. Se svolto correttamente, il web scraping etico consente ai team di raccogliere informazioni pubbliche per ricerca, prezzi e monitoraggio senza danneggiare i siti su cui fanno affidamento.
Questo articolo tratta i principi operativi che distinguono una raccolta responsabile da uno scraping sconsiderato: quali dati si possono raccogliere, come interpretare segnali quali robots.txt e le condizioni di servizio, come limitare il carico del server, come gestire i dati personali e perché conta l’origine della tua rete di proxy.
DataImpulse è un fornitore di proxy etici che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 Paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Dati principali
- Principio fondamentale: il web scraping etico significa raccogliere solo dati disponibili pubblicamente, a un ritmo che non danneggi il server di destinazione, rispettando al contempo la normativa sulla privacy e le condizioni del sito.
- Miglior tipo di proxy: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: a partire da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e nessun abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti in modo etico in 195 Paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per Paese incluso.
Cosa rende etico il web scraping?
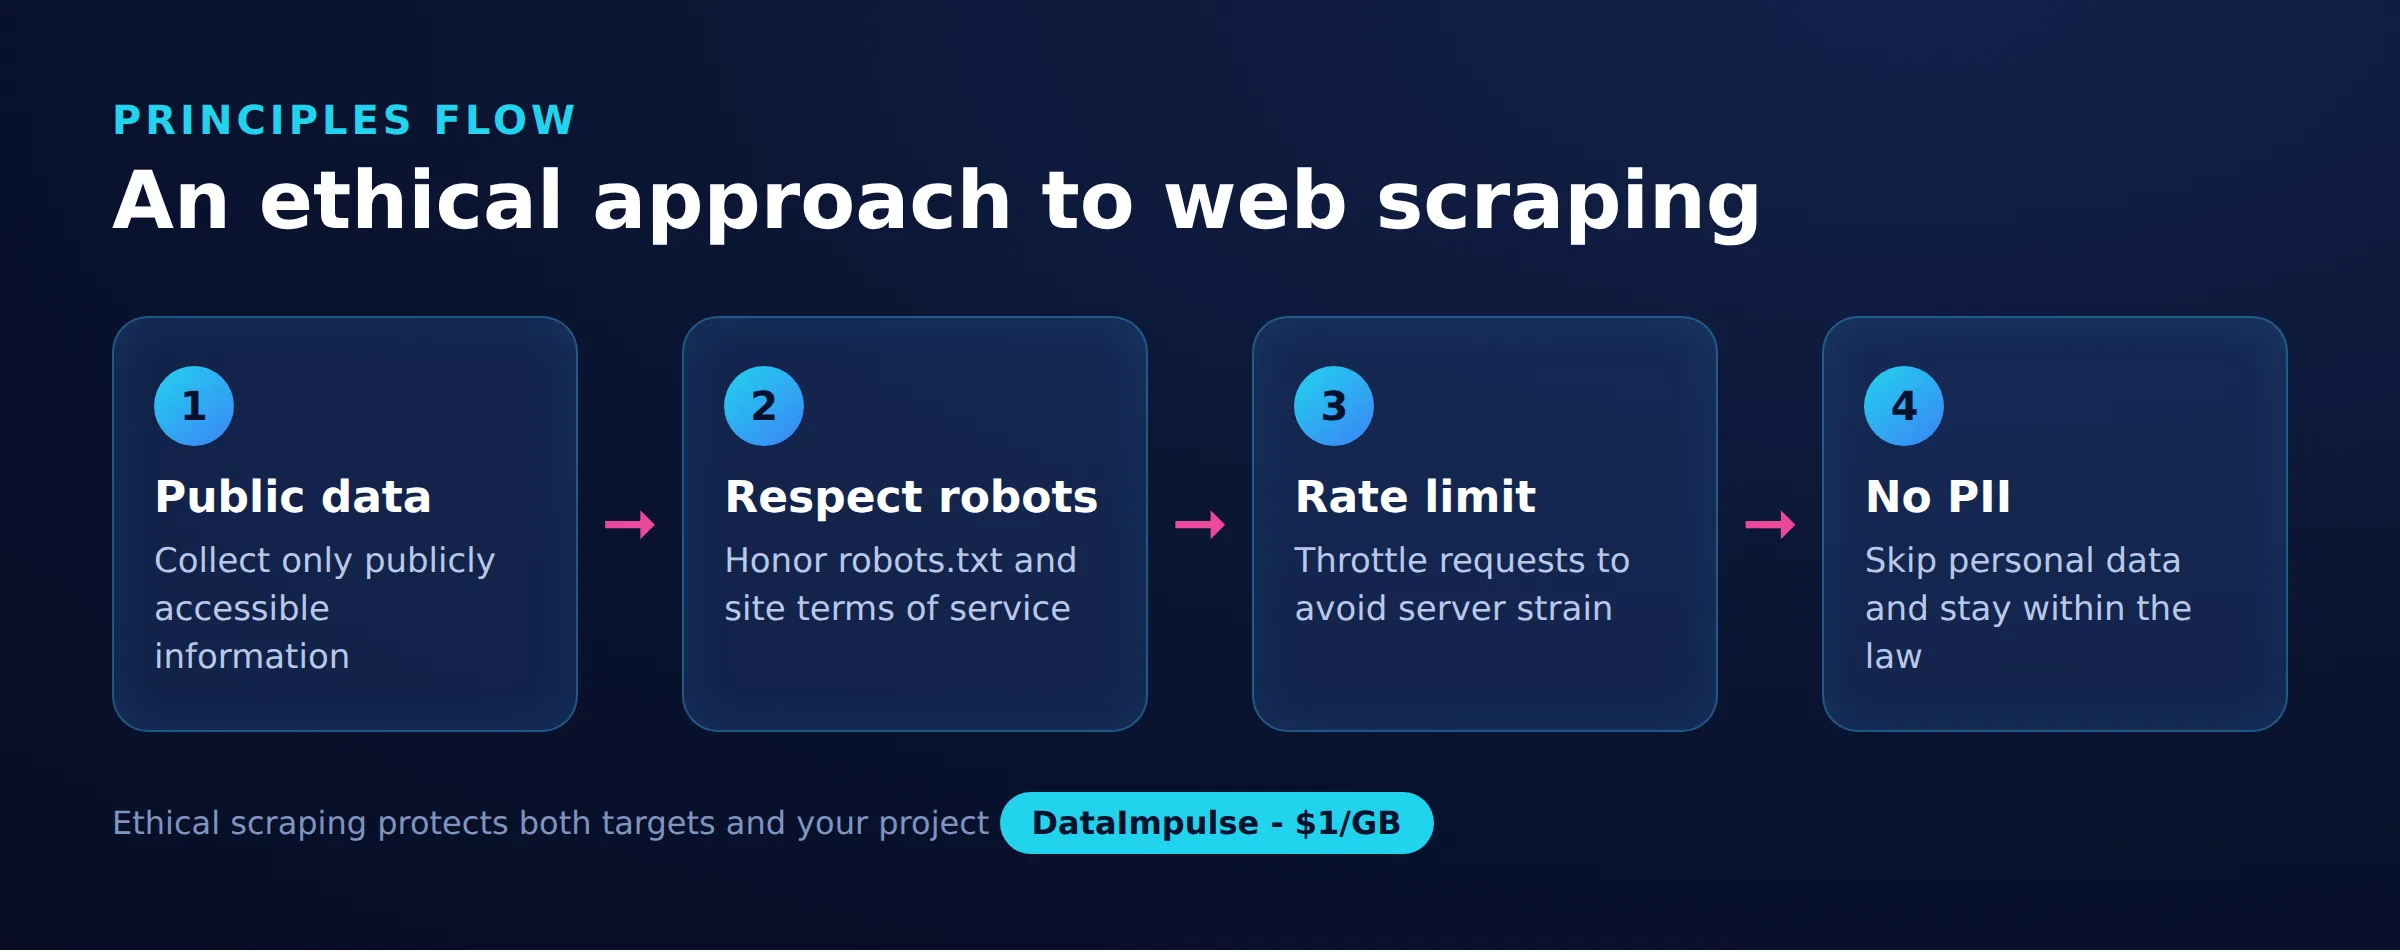
Il web scraping è etico quando raccoglie solo dati pubblici, rispetta la capacità del server di destinazione ed evita di danneggiare le persone o l’azienda dietro al sito. La distinzione riguarda meno lo strumento e più l’intento, il sito di destinazione e l’impatto.
Le pagine accessibili pubblicamente, che chiunque può visualizzare senza effettuare l’accesso, sono nella fascia a rischio più basso. I contenuti protetti da autenticazione, paywall o controlli di accesso espliciti sono un’altra questione, perché accedervi di solito significa prima accettare delle condizioni. Un test utile è chiederti se la tua raccolta ti metterebbe in imbarazzo se il proprietario del sito la vedesse avvenire. Limitarti ai dati che un normale visitatore potrebbe vedere e applicare la minimizzazione dei dati, prendendo solo i campi che ti servono davvero, è il fondamento su cui si basa tutto il resto.
- Raccogli dati pubblici e non sensibili.
- Prendi solo ciò che ti serve per uno scopo chiaro.
- Evita di peggiorare il servizio per gli utenti reali.
Come gestire robots.txt e le condizioni di servizio?
Leggi entrambi e considerali segnali significativi anziché ignorarli. Il file robots.txt è uno standard consultivo che indica ai client automatizzati quali percorsi un sito preferisce che evitino, mentre le condizioni di servizio (ToS) sono un contratto la cui applicabilità varia in base alla giurisdizione e alla situazione.
Nessuno dei due è un semplice interruttore acceso/spento. robots.txt è consultivo: non è un blocco tecnico e non è, di per sé, una legge, ma ignorarlo segnala che sei disposto a prevalere sui desideri espressi dal proprietario del sito. Le condizioni di servizio possono avere un peso reale, anche se la loro vincolatività dipende da come sono state presentate e da dove viene esaminata una controversia. Questo non è un parere legale e la risposta onesta è che le regole sono sfumate e dipendono dalla giurisdizione. Per un approfondimento sull’aspetto legale, consulta la nostra guida su se il web scraping è legale. In caso di dubbio, consulta un avvocato qualificato per il tuo caso specifico.
Un robots.txt essenziale potrebbe essere così:
User-agent: *
Disallow: /private/
Crawl-delay: 10
Qui il sito chiede a ogni client automatizzato di evitare il percorso /private/ e di attendere dieci secondi tra una richiesta e l’altra. Rispettare sia i percorsi non consentiti sia il ritardo di scansione è una base di buona condotta.
Come evitare di sovraccaricare un server?
Limita la frequenza delle richieste e la concorrenza, affinché il tuo traffico resti una piccola frazione del carico normale del sito. Uno scraping aggressivo può rallentare un sito per gli utenti reali o, nei casi estremi, assomigliare a uno schema di negazione del servizio.
Rispetta qualsiasi crawl-delay in robots.txt, aggiungi pause tra le richieste e limita il numero di connessioni che apri contemporaneamente. Effettuare lo scraping nelle ore non di punta del sito di destinazione riduce ulteriormente l’impatto. Mettere in cache le pagine che hai già recuperato evita richieste ripetute per gli stessi dati; fermarti o ridurre il ritmo quando vedi errori o risposte che impongono limiti di frequenza dimostra che stai reagendo al server anziché travolgerlo. Distribuire le richieste su un pool di proxy residential può distribuire il carico ed evitare di martellare un sito da un singolo indirizzo, ma è un motivo per procedere con cautela, non una licenza per inviarne di più. Per tecniche che riducono sia i blocchi sia il carico, consulta la nostra guida allo scraping senza essere bloccati.
Come gestire i dati personali e la normativa sulla privacy?
Evita di raccogliere dati personali, salvo quando hai una base giuridica e una necessità reale, perché le norme sulla privacy si applicano ai dati estratti come a qualsiasi altro dato. Leggi quali il GDPR nell’UE e il CCPA in California regolano come le informazioni personali vengono raccolte, archiviate e utilizzate, indipendentemente dal fatto che fossero pubbliche.
Le informazioni di identificazione personale (PII) comprendono nomi, email, numeri di telefono e qualsiasi elemento che identifichi una persona. Il fatto che tali dati compaiano su una pagina pubblica non li rende automaticamente liberi da raccogliere e riutilizzare. Applica la minimizzazione dei dati: raccogli l’insieme più ristretto di campi che serve al tuo scopo, elimina tutto ciò che non ti serve e non creare profili di persone senza una chiara base legale. Quando il tuo target sono prezzi, disponibilità o tendenze aggregate anziché persone, preferisci progettazioni che non trattino mai PII fin dall’inizio.
Uno scraper dovrebbe identificarsi?
Esiste un vero dibattito su questo punto e professionisti ragionevoli non sono d’accordo. Secondo una posizione, uno scraper dovrebbe inviare una stringa user-agent onesta che identifichi l’operatore e offra un metodo di contatto, così i proprietari del sito possono contattarlo o definire regole; secondo un’altra, questo invita a blocchi generalizzati indipendentemente dalla buona condotta.
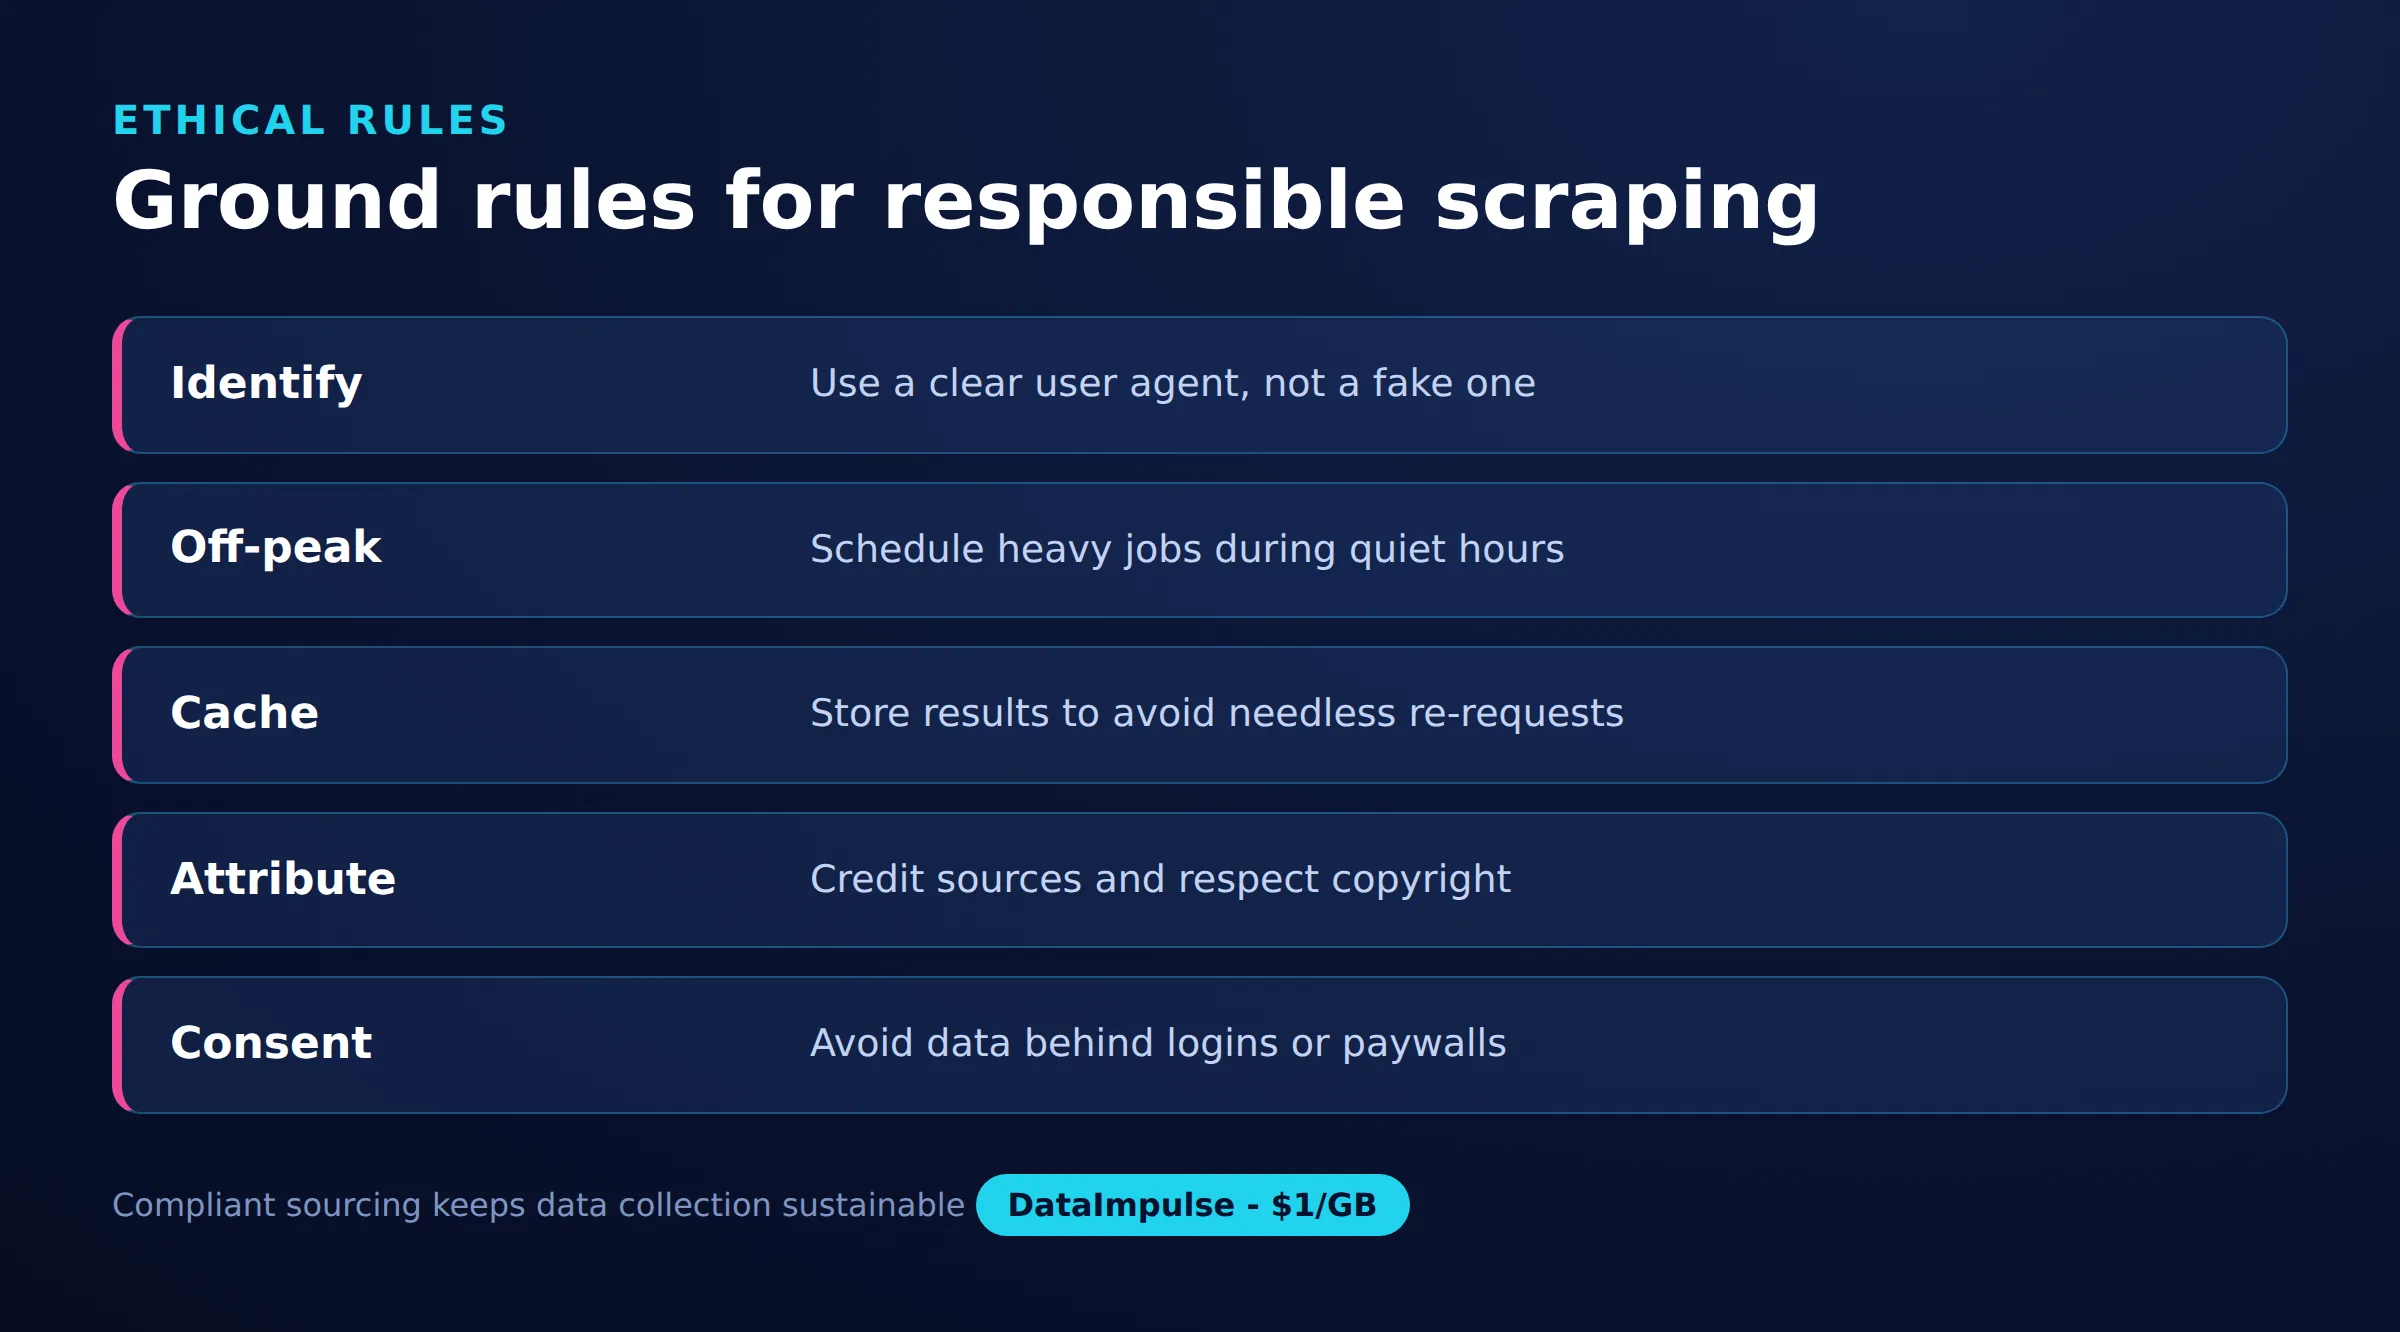
La trasparenza ha un valore reale: un user-agent descrittivo che nomina il tuo progetto e rimanda a una pagina delle policy permette a un proprietario di sito collaborativo di limitarti o inserirti in un elenco di autorizzati anziché procedere per supposizioni. L’obiezione è che molti siti bloccano tutto ciò che non assomiglia a un browser diffuso, spingendo anche gli scraper più corretti verso stringhe generiche. Non esiste un’unica risposta corretta, ma falsificare deliberatamente l’identità per impersonare una persona specifica o aggirare la sicurezza è più difficile da giustificare che usare un client neutrale e onesto. Valuta la trasparenza rispetto alla praticità per il tuo sito di destinazione specifico.
Perché conta l’origine dei tuoi proxy?
Perché l’etica della raccolta dati si estende all’infrastruttura attraverso cui instradi il traffico. Una rete di proxy costruita con dispositivi i cui proprietari non hanno mai acconsentito a partecipare trasferisce un costo nascosto a persone ignare, indebolendo qualsiasi affermazione secondo cui il tuo scraping è responsabile.
I proxy ottenuti in modo etico provengono da utenti che scelgono esplicitamente di condividere la propria connessione e ricevono un compenso per farlo, con un’informativa chiara su ciò che comporta. DataImpulse segue questo modello: i suoi 90M+ IP residential, mobile e datacenter in 195 Paesi provengono da utenti che aderiscono volontariamente e ricevono un compenso, l’operatività è allineata al GDPR ed è disponibile un accordo sul trattamento dei dati. Puoi approfondire questo approccio nella nostra pagina sui proxy etici. Scegliere un fornitore in base a questo criterio, invece della rete più economica di origine sconosciuta, mantiene l’intera pipeline coerente con i principi indicati sopra. DataImpulse offre anche proxy mobile e proxy datacenter per i team che hanno bisogno di diversi tipi di IP.
Come si presenta una checklist per il web scraping etico?
Una breve checklist mantiene onesto un progetto fin dall’inizio. Un punto merita una nota a sé: licenze e copyright. I fatti e i dati grezzi spesso non sono protetti, ma l’espressione creativa che li circonda, come il testo degli articoli e le fotografie, può essere coperta da copyright o diritti sulle banche dati, quindi verifica le licenze prima di ripubblicare o rivendere ciò che raccogli.
- Solo dati pubblici: raccogli dati accessibili senza aggirare login o paywall.
- Leggi i segnali: esamina robots.txt e le condizioni di servizio e rispetta i percorsi non consentiti e i ritardi di scansione.
- Limita il ritmo: dosa le richieste, limita la concorrenza, memorizza nella cache i risultati e rallenta in caso di errori.
- Riduci al minimo i PII: evita i dati personali salvo quando hai una base giuridica e raccogli solo ciò che ti serve ai sensi del GDPR e del CCPA.
- Sii trasparente quando è pratico: usa un client onesto e non impersonare una persona specifica né aggirare la sicurezza.
- Rispetta le licenze: controlla copyright e diritti sulle banche dati prima di riutilizzare o ripubblicare i contenuti.
- Ottieni l’infrastruttura in modo etico: instrada il traffico attraverso reti di proxy basate sul consenso e compensate.
- Chiedi consiglio in caso di dubbio: consulta un avvocato per casi importanti o ambigui.
Principi del web scraping etico nella pratica
| Principio | Nella pratica |
|---|---|
| Solo dati pubblici | Salta i contenuti protetti da login |
| Rispetta robots.txt | Segui le direttive di scansione |
| Limitazione della frequenza | Aggiungi ritardi tra le richieste |
| Nessun dato personale | Evita di raccogliere PII |
| Attribuzione e licenze | Rispetta condizioni e attribuzione |
| Origine etica dei proxy | Usa reti IP basate sul consenso |
Domande frequenti
Il web scraping coincide con il web scraping etico?
No. Il web scraping è la tecnica per estrarre dati dai siti web, mentre il web scraping etico viene svolto nel rispetto dei limiti dei dati pubblici, del carico del server, della normativa sulla privacy e delle licenze dei contenuti. Lo strumento è lo stesso; ciò che cambia è la disciplina con cui lo si usa.
Ignorare robots.txt rende illegale lo scraping?
Non automaticamente. Il file robots.txt è uno standard consultivo, non una legge, quindi ignorarlo non costituisce di per sé un reato, ma può sostenere altre pretese e segnala un mancato rispetto dei desideri del proprietario del sito. La legittimità dipende dalla giurisdizione e dai fatti specifici, quindi consulta un avvocato per il tuo caso.
Posso estrarre dati personali se sono visibili pubblicamente?
La visibilità pubblica non elimina gli obblighi in materia di privacy. Norme come il GDPR e il CCPA possono comunque applicarsi ai dati personali anche quando compaiono su una pagina aperta, quindi ti serve una base giuridica e dovresti ridurre al minimo ciò che raccogli.
Cosa sono i proxy ottenuti in modo etico?
I proxy ottenuti in modo etico provengono da utenti che scelgono esplicitamente di condividere la propria connessione e vengono compensati per questo, con un’informativa chiara. DataImpulse ottiene i suoi IP in questo modo ed è allineata al GDPR, con un accordo sul trattamento dei dati disponibile.
Come impedisco al mio scraper di sovraccaricare un sito web?
Limita la frequenza delle richieste e il numero di connessioni simultanee, rispetta qualsiasi crawl-delay, memorizza nella cache le pagine già recuperate e rallenta quando vedi errori o limiti di frequenza. L’obiettivo è restare una piccola frazione del traffico normale del sito.
Quando DataImpulse non è la scelta giusta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Fai scraping in modo responsabile con proxy ottenuti in modo etico
Se desideri un’infrastruttura in linea con i principi sopra indicati, DataImpulse offre proxy residential, mobile e datacenter ottenuti in modo etico, con traffico pay-as-you-go a partire da 1 dollaro per GB. Crea un account per iniziare a raccogliere dati pubblici in modo responsabile.