
In this Article
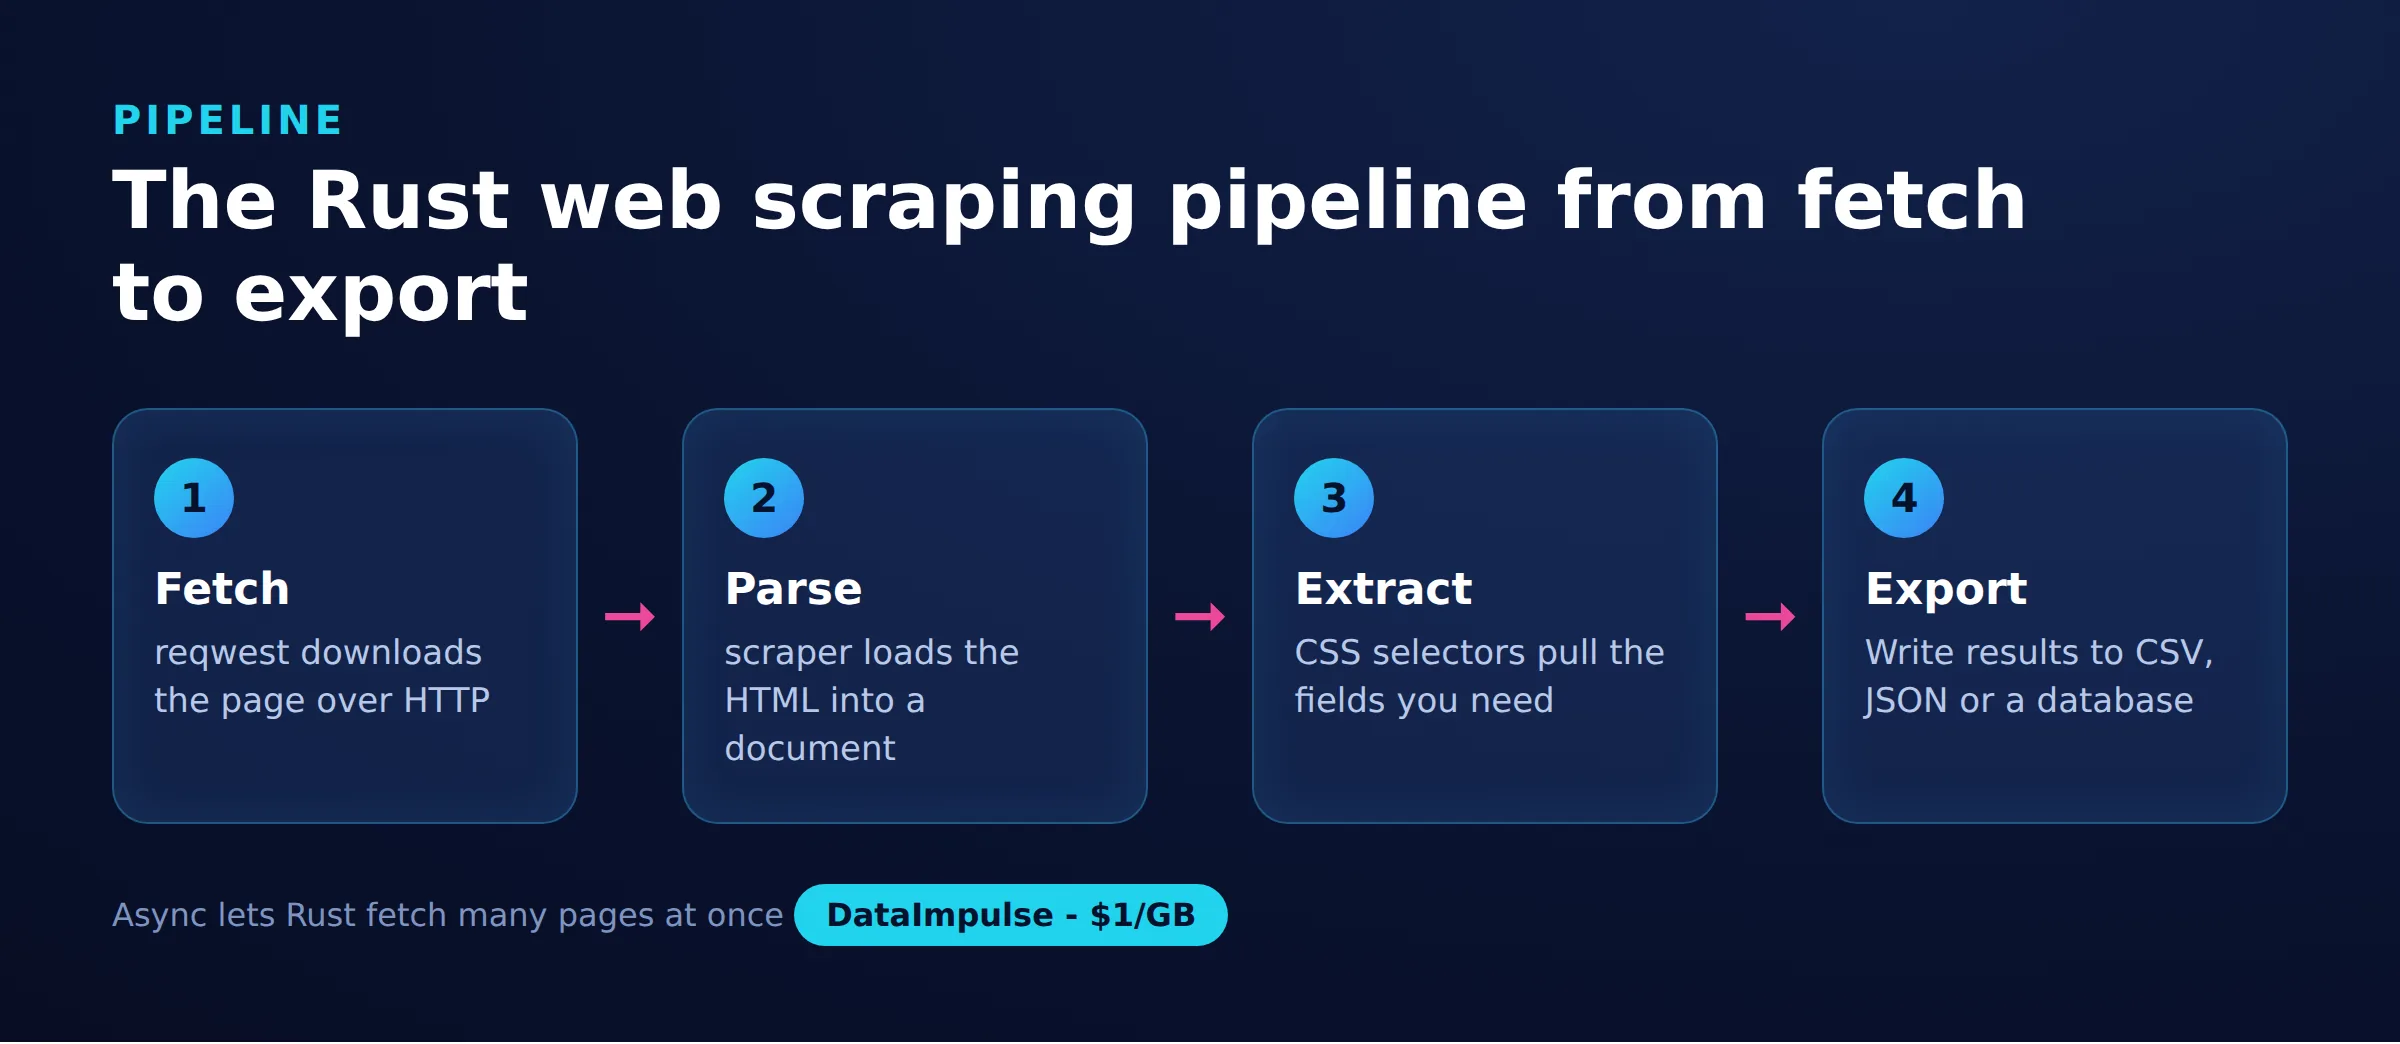
Il web scraping con Rust consiste nel recuperare e analizzare pagine web con il linguaggio Rust e il suo ecosistema di crate. Rust piace agli sviluppatori che cercano prestazioni prevedibili e sicurezza della memoria senza un garbage collector, caratteristiche che lo rendono adatto ai crawler eseguiti in modo continuo o su grandi volumi.
Questa guida pratica e orientata al codice si basa sul client HTTP reqwest e sul crate di parsing scraper. Parte dalla configurazione del progetto e da una richiesta minima, passando per selettori CSS, modelli di dati strutturati, export JSON e CSV, paginazione, gestione degli errori con tentativi e backoff, concorrenza async con tokio, configurazione dei proxy e una soluzione alternativa con browser headless per siti ricchi di JavaScript. Ogni snippet è pensato per compilare ed essere eseguito.
DataImpulse è un provider etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Punti chiave
- Stack principale: Il web scraping con Rust abbina di solito il client HTTP reqwest al crate scraper per il parsing HTML, più tokio per la concorrenza async e serde per esportare dati strutturati.
- Miglior tipo di proxy: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 milioni di IP ottenuti in modo etico in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Perché usare Rust per il web scraping?
Rust è adatto al web scraping quando velocità, basso uso della memoria e affidabilità contano più della prototipazione rapida. I suoi binari compilati operano vicino all’hardware e il borrow checker intercetta intere classi di bug di concorrenza in fase di compilazione anziché in produzione.
Queste proprietà sono utili in alcuni scenari comuni:
- Throughput: Un crawler Rust compilato elabora grandi volumi di pagine con un sovraccarico di CPU e memoria inferiore rispetto a un linguaggio interpretato, riducendo il costo dell’infrastruttura nei lavori lunghi.
- Concorrenza sicura: Il runtime async tokio ti permette di eseguire migliaia di richieste concorrenti, mentre il sistema di tipi evita race condition tra queste attività.
- Uso prevedibile delle risorse: L’assenza di un garbage collector implica una latenza più stabile, utile per i crawler che restano attivi per ore o giorni.
Il compromesso è una curva di apprendimento più ripida e tempi di compilazione più lunghi, quindi Rust premia i progetti eseguiti su scala anziché gli script una tantum. Qualunque linguaggio tu scelga, valgono le stesse regole di base: rispetta robots.txt, limita la frequenza delle richieste e segui le best practice del web scraping affinché il tuo crawler si comporti correttamente.
Come si configura un progetto di scraping con Rust?
Configura un progetto di scraping con Rust creando un nuovo pacchetto Cargo e dichiarando in Cargo.toml i crate necessari. Cargo è lo strumento di build e gestore dei pacchetti di Rust, quindi risolve le dipendenze e compila il progetto per te.
Esegui cargo new rust-scraper per creare lo scheletro del progetto, poi modifica il Cargo.toml generato. L’insieme di dipendenze seguente copre tutto ciò che serve in questa guida: HTTP, parsing, async, serializzazione, output CSV, stream e gestione pratica degli errori.
[package]
name = "rust-scraper"
version = "0.1.0"
edition = "2021"

[dependencies]
reqwest = { version = "0.12", features = ["json", "socks"] }
scraper = "0.20"
tokio = { version = "1", features = ["full"] }
serde = { version = "1", features = ["derive"] }
serde_json = "1"
csv = "1.3"
futures = "0.3"
anyhow = "1"
thiserror = "1"
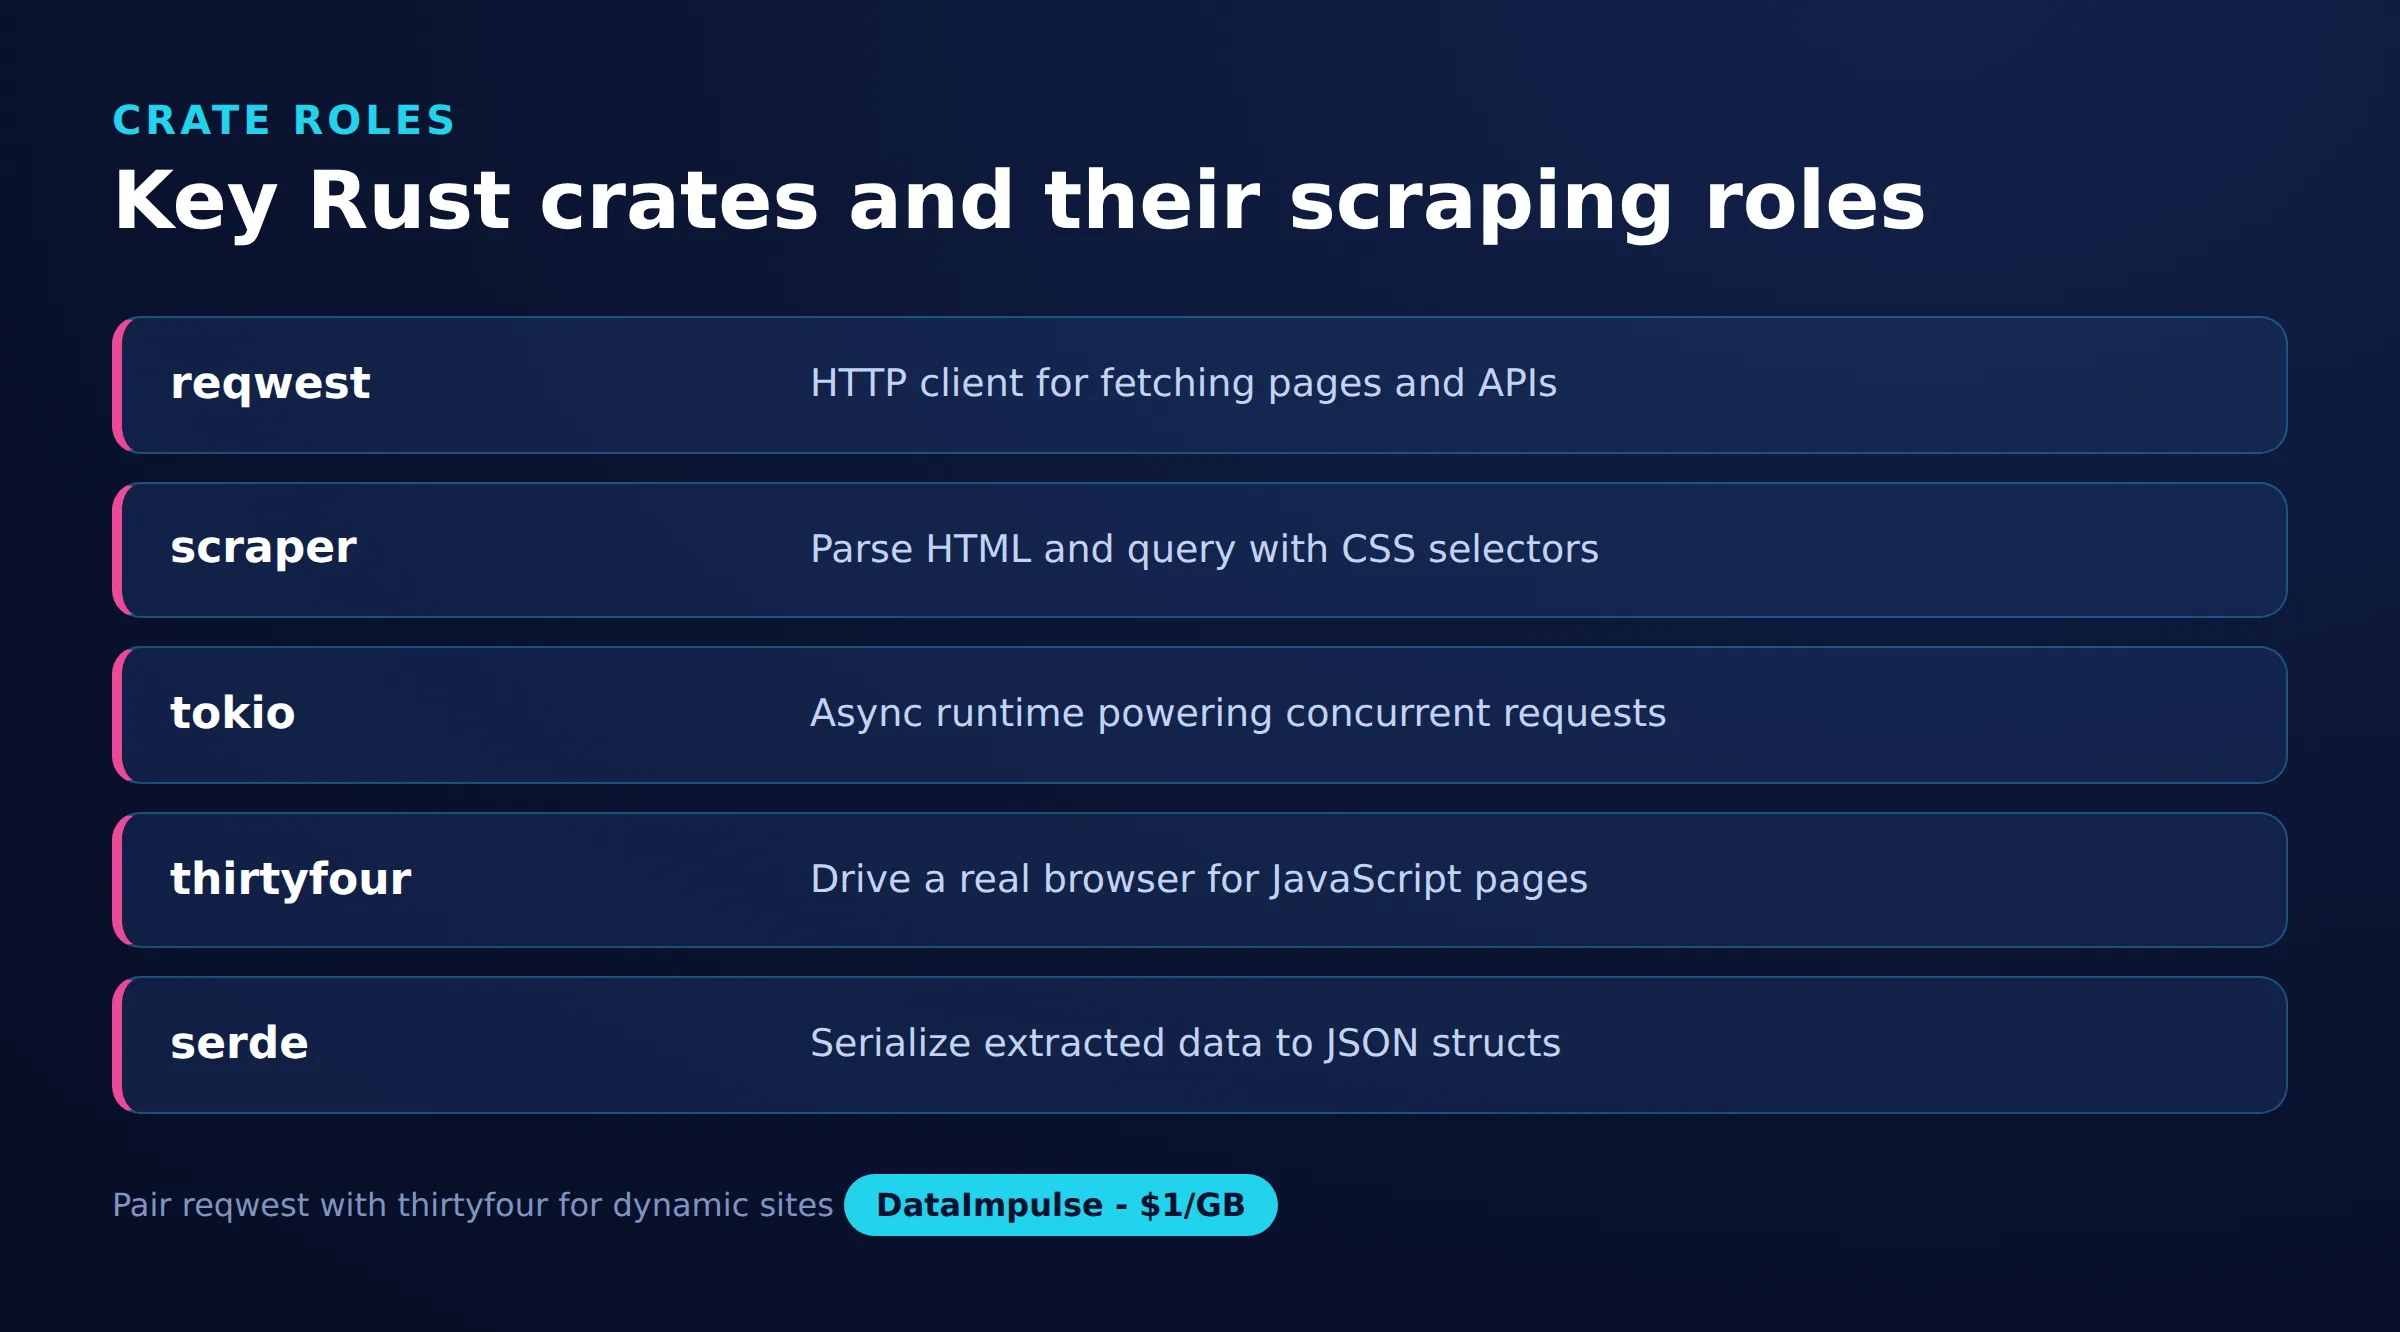
Qui reqwest gestisce le richieste (la funzionalità socks abilita i proxy SOCKS5, la funzionalità json aggiunge gli helper JSON), scraper analizza HTML con selettori CSS, tokio fornisce il runtime async, serde e serde_json serializzano i dati, csv scrive fogli di calcolo, futures offre combinatori di stream per la concorrenza e anyhow con thiserror semplifica la gestione degli errori. Esegui cargo build una volta per scaricare e compilare tutto prima di scrivere la prima richiesta.
Come si recupera e analizza una pagina con reqwest e scraper?
Recupera una pagina inviando una richiesta GET con reqwest, quindi carica il corpo della risposta in scraper per interrogarlo con selettori CSS. L’esempio seguente viene eseguito in modo asincrono su tokio, recupera una pagina e stampa il testo di ogni elemento H1.
use scraper::{Html, Selector};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let url = "https://example.com";
    let body = reqwest::get(url).await?.text().await?;

    let document = Html::parse_document(&body);
    let heading = Selector::parse("h1").unwrap();

    for element in document.select(&heading) {
        let text: String = element.text().collect();
        println!("{}", text.trim());
    }
    Ok(())
}
Il flusso è sempre lo stesso: reqwest::get restituisce una risposta, .text() legge il suo corpo come stringa e Html::parse_document trasforma quella stringa in un albero interrogabile. L’operatore ? propaga qualsiasi errore di rete o decodifica fino a main. Chiamare .text() su un elemento corrispondente raccoglie i suoi nodi di testo, che puoi poi ripulire e utilizzare. Questo approccio con HTML grezzo è rapido, ma considera che vede solo il markup restituito dal server, non il contenuto che un browser renderebbe in seguito con JavaScript.
Come si selezionano elementi con selettori CSS?
Seleziona gli elementi passando una stringa di selettore CSS standard a Selector::parse, esattamente come faresti nella console del browser. Il crate scraper supporta tag, classi, id, corrispondenze di attributi, percorsi discendenti e pseudo-classi strutturali.
use scraper::Selector;

// Match by tag
let links = Selector::parse("a").unwrap();

// Match by class
let prices = Selector::parse(".price").unwrap();

// Match by id
let main = Selector::parse("#main-content").unwrap();

// Match by attribute value
let external = Selector::parse("a[rel=\"nofollow\"]").unwrap();

// Descendant path (a title inside a product card)
let titles = Selector::parse("div.product h2.title").unwrap();

// Direct child plus pseudo-class
let first_row = Selector::parse("table > tbody > tr:first-child").unwrap();
Compila ogni selettore una volta sola e riutilizzalo anziché analizzarlo dentro un ciclo, poiché il parsing ha un piccolo costo. Quando un selettore potrebbe non trovare corrispondenze, preferisci .next() con un fallback invece di .unwrap() sull’elemento, così un campo mancante non causa un panic dell’intera esecuzione. Ispezionare la pagina di destinazione con il selettore di elementi del browser è il modo più rapido per trovare nomi di classi e attributi stabili da selezionare.
Come si esportano dati estratti in JSON e CSV?
Esporta i dati estratti modellando ogni record come una struct che deriva Serialize, quindi scrivendo una slice di queste struct in JSON con serde_json o in CSV con il crate csv. Definire un modello tipizzato mantiene sincronizzati estrazione e output e rende il codice autoesplicativo.
Per prima cosa, modella il record ed estrai i campi da ogni elemento contenitore:
use scraper::{Html, Selector};
use serde::Serialize;

#[derive(Debug, Serialize)]
struct Product {
    name: String,
    price: String,
    url: String,
}

fn parse_products(html: &str) -> Vec<Product> {
    let document = Html::parse_document(html);
    let card = Selector::parse("div.product").unwrap();
    let name_sel = Selector::parse("h2.title").unwrap();
    let price_sel = Selector::parse("span.price").unwrap();
    let link_sel = Selector::parse("a").unwrap();

    let mut products = Vec::new();
    for card_el in document.select(&card) {
        let name = card_el
            .select(&name_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let price = card_el
            .select(&price_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let url = card_el
            .select(&link_sel)
            .next()
            .and_then(|e| e.value().attr("href"))
            .unwrap_or_default()
            .to_string();

        products.push(Product { name, price, url });
    }
    products
}
Because Product derives Serialize, la stessa struct alimenta entrambi gli esportatori senza lavoro aggiuntivo:
use std::fs::File;
use std::io::Write;

fn export_json(products: &[Product]) -> anyhow::Result<()> {
    let json = serde_json::to_string_pretty(products)?;
    let mut file = File::create("products.json")?;
    file.write_all(json.as_bytes())?;
    Ok(())
}

fn export_csv(products: &[Product]) -> anyhow::Result<()> {
    let mut writer = csv::Writer::from_path("products.csv")?;
    for product in products {
        writer.serialize(product)?;
    }
    writer.flush()?;
    Ok(())
}
serde_json’s to_string_pretty produce JSON leggibile dall’uomo e la funzione del crate csv serialize mappa ogni struct in una riga con un’intestazione derivata dai nomi dei campi. Riutilizzare un modello tipizzato per scraping, JSON e CSV rende una pipeline Rust facile da mantenere quando il sito di destinazione cambia.
Come si estraggono più pagine con un ciclo di paginazione?
Estrai più pagine iterando sui numeri di pagina o su un URL della pagina successiva, riutilizzando un unico client reqwest affinché le connessioni siano raggruppate tra le richieste. Costruisci ogni URL, recuperalo, analizzalo con la funzione della sezione precedente e fermati quando una pagina non restituisce risultati.
use scraper::Html;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let mut all_products = Vec::new();

    for page in 1..=10 {
        let url = format!("https://example.com/products?page={}", page);
        let body = client.get(&url).send().await?.text().await?;
        let products = parse_products(&body);

        // Stop when a page returns no results
        if products.is_empty() {
            break;
        }
        all_products.extend(products);

        // Pause between requests to stay polite
        tokio::time::sleep(std::time::Duration::from_millis(500)).await;
    }

    println!("Collected {} products", all_products.len());
    Ok(())
}
Creare il client una volta sola con reqwest::Client::new() fuori dal ciclo gli permette di riutilizzare le connessioni TCP, operazione sensibilmente più rapida rispetto a un nuovo client per richiesta. Il controllo dei risultati vuoti conclude naturalmente il ciclo quando raggiungi l’ultima pagina, mentre la breve pausa distanzia le richieste per non sovraccaricare il server. Per i siti che usano un link alla pagina successiva invece di pagine numerate, estrai a ogni iterazione l’href dell’ancora della pagina successiva e seguilo finché il link non scompare.
Come si gestiscono errori e tentativi con backoff?
Gestisci gli errori restituendo un errore tipizzato dalle funzioni di recupero, quindi ritenta i fallimenti transitori con un backoff esponenziale. Le reti vanno in timeout e i server restituiscono codici di stato temporanei, quindi uno scraper robusto considera un singolo fallimento come previsto anziché fatale.
Il crate thiserror ti consente di definire un enum di errori compatto che converte automaticamente un errore reqwest:
use thiserror::Error;

#[derive(Error, Debug)]
enum ScrapeError {
    #[error("request failed: {0}")]
    Request(#[from] reqwest::Error),

    #[error("unexpected status code: {0}")]
    Status(reqwest::StatusCode),

    #[error("selector matched no elements")]
    Empty,
}

async fn fetch_page(client: &reqwest::Client, url: &str) -> Result<String, ScrapeError> {
    let response = client.get(url).send().await?;
    if !response.status().is_success() {
        return Err(ScrapeError::Status(response.status()));
    }
    Ok(response.text().await?)
}
L’attributo #[from] indica che un fallimento reqwest si trasforma automaticamente in una ScrapeError::Request tramite l’operatore ?. Oltre agli errori tipizzati, racchiudi la richiesta in un ciclo di tentativi la cui attesa aumenta dopo ogni tentativo:
use std::time::Duration;

async fn fetch_with_backoff(client: &reqwest::Client, url: &str) -> anyhow::Result<String> {
    let max_attempts = 5;
    for attempt in 1..=max_attempts {
        match client.get(url).send().await {
            Ok(resp) if resp.status().is_success() => {
                return Ok(resp.text().await?);
            }
            Ok(resp) => {
                eprintln!("attempt {attempt}: status {}", resp.status());
            }
            Err(err) => {
                eprintln!("attempt {attempt}: {err}");
            }
        }
        // Exponential backoff: 0.5s, 1s, 2s, 4s, 8s
        let backoff = Duration::from_millis(500 * 2u64.pow(attempt - 1));
        tokio::time::sleep(backoff).await;
    }
    anyhow::bail!("giving up on {url} after {max_attempts} attempts")
}
Il backoff esponenziale (qui 0.5s, 1s, 2s, 4s, 8s) dà a un server con limitazione della frequenza o brevemente sovraccarico il tempo di riprendersi, invece di tempestarlo. Combinare i tentativi con proxy a rotazione è ancora più efficace: una richiesta bloccata o limitata su un IP può riuscire al tentativo successivo da un IP di uscita diverso.
Come si eseguono richieste concorrenti con tokio?
Esegui richieste concorrenti trasformando l’elenco di URL in uno stream async e applicando buffer_unordered, che limita il numero di richieste in corso contemporaneamente. È la leva prestazionale più importante in uno scraper Rust, e tokio insieme al crate futures la rende sicura.
use futures::stream::{self, StreamExt};

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let urls: Vec<String> = (1..=50)
        .map(|n| format!("https://example.com/item/{}", n))
        .collect();

    let bodies = stream::iter(urls)
        .map(|url| {
            let client = client.clone();
            async move {
                let text = client.get(&url).send().await?.text().await?;
                Ok::<_, reqwest::Error>((url, text))
            }
        })
        .buffer_unordered(10); // at most 10 requests in flight

    bodies
        .for_each(|result| async {
            match result {
                Ok((url, body)) => println!("{}: {} bytes", url, body.len()),
                Err(err) => eprintln!("error: {}", err),
            }
        })
        .await;

    Ok(())
}
Qui stream::iter converte l’elenco di URL in uno stream, .map avvia una richiesta async per ogni URL e buffer_unordered(10) mantiene al massimo dieci richieste in esecuzione contemporaneamente, restituendo i risultati quando terminano. Clonare il client per attività è poco costoso perché un Client reqwest è un Arc attorno a un pool di connessioni condiviso. Regola il limite di concorrenza per bilanciare velocità e carico imposto alla destinazione: da dieci a venti è un punto di partenza ragionevole e associare una concorrenza maggiore a un pool di proxy distribuisce tali richieste su molti IP.
Come si instrada il traffico di scraping Rust tramite un proxy?
Instrada il traffico tramite un proxy creando un client reqwest con reqwest::Proxy e collegando gateway e credenziali con .basic_auth. Inviare richieste tramite IP a rotazione distribuisce il carico, raggiunge contenuti specifici per area geografica e riduce la probabilità di limitazione della frequenza. La rotazione degli IP è una delle tecniche più efficaci per fare scraping senza essere bloccati.
use reqwest::Proxy;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    // Authenticated gateway; rotates the exit IP on each request
    let proxy = Proxy::all("http://gw.dataimpulse.com:823")?
        .basic_auth("login", "password");

    let client = reqwest::Client::builder()
        .proxy(proxy)
        .timeout(std::time::Duration::from_secs(30))
        .build()?;

    let body = client
        .get("https://httpbin.org/ip")
        .send()
        .await?
        .text()
        .await?;

    println!("{}", body);
    Ok(())
}
Sostituisci login e password con le tue credenziali e regola la porta per la rete che ti serve. Se il proxy rifiuta la richiesta con stato 407, la causa è quasi sempre l’assenza di credenziali o credenziali errate; la guida su errore HTTP 407 e la guida pratica su autenticazione proxy spiegano come risolvere il problema. DataImpulse offre proxy residential, proxy datacenter e proxy mobile tramite HTTP, HTTPS e SOCKS5, con sessioni a rotazione e sticky session. Il targeting per paese è incluso, mentre il targeting per stato, città, ZIP e ASN è disponibile come componente aggiuntivo a pagamento.
Come si estraggono pagine ricche di JavaScript e quando Rust è la scelta giusta?
Estrai pagine ricche di JavaScript pilotando un vero browser headless, perché reqwest e scraper vedono solo l’HTML grezzo del server e non eseguono mai script. Quando il contenuto appare solo dopo il rendering lato client, usa un crate di automazione del browser come thirtyfour, che parla il protocollo WebDriver, oppure chromiumoxide, che controlla Chrome tramite DevTools Protocol.
use thirtyfour::prelude::*;

#[tokio::main]
async fn main() -> WebDriverResult<()> {
    let caps = DesiredCapabilities::chrome();
    let driver = WebDriver::new("http://localhost:9515", caps).await?;

    driver.goto("https://example.com").await?;

    // Wait for client-side content to render, then read it
    let heading = driver.find(By::Css("h1")).await?;
    println!("{}", heading.text().await?);

    driver.quit().await?;
    Ok(())
}
L’esempio thirtyfour si connette a un chromedriver in esecuzione, carica una pagina, attende un elemento renderizzato e ne legge il testo. Questo approccio è molto più pesante di un semplice recupero HTTP, quindi usalo solo per le pagine che ne hanno davvero bisogno e mantieni il percorso rapido reqwest per tutto il resto. Per approfondire questo compromesso, consulta le guide su scraping di pagine web dinamiche e web scraping con JavaScript. La tabella seguente riassume come si integrano i principali crate:
| Crate | Ruolo | Esegue JavaScript | Ideale per |
|---|---|---|---|
| reqwest | Client HTTP | No | Recuperare HTML grezzo e API JSON |
| scraper | Parser HTML | No | Estrazione dati con selettori CSS |
| thirtyfour | Client WebDriver | Sì | Automazione completa del browser e moduli |
| chromiumoxide | DevTools Protocol | Sì | Controllo rapido di Chrome headless |
Quanto alla scelta del linguaggio, scegli Rust quando ti servono prestazioni costanti e basso uso delle risorse su scala, e scegli Python quando valorizzi lo sviluppo rapido e un ecosistema di scraping più ampio come Scrapy e Playwright. Un approccio comune consiste nel prototipare le regole di estrazione in Python, quindi portare il percorso più intenso a Rust quando la logica è stabile e il volume cresce. Qualunque scelta tu faccia, il livello di rete conta quanto il parser e proxy ottenuti in modo etico mantengono affidabili i lavori di grandi dimensioni.
Domande frequenti
Quali crate Rust sono migliori per il web scraping?
L’abbinamento più comune è reqwest per le richieste HTTP e scraper per il parsing HTML con selettori CSS. Aggiungi tokio per la concorrenza async, serde per esportare dati e un crate di automazione del browser come thirtyfour o chromiumoxide quando un sito necessita del rendering JavaScript.
Rust può estrarre pagine renderizzate con JavaScript?
Non con reqwest e scraper da soli, poiché vedono solo l’HTML grezzo restituito dal server e non possono eseguire script. Per estrarre contenuti renderizzati lato client, piloti un browser headless tramite un crate WebDriver come thirtyfour o un crate DevTools Protocol come chromiumoxide.
Come si esportano dati estratti in Rust?
Modella ogni record come una struct che deriva Serialize di serde, quindi scrivi una slice di queste struct in JSON con serde_json o in CSV con il crate csv. Un modello tipizzato può alimentare entrambi i formati senza duplicare la logica di estrazione.
Come si eseguono richieste concorrenti senza sovraccaricare un sito?
Trasforma gli URL in uno stream async e applica buffer_unordered con un limite fisso, che limita quante richieste vengono eseguite contemporaneamente. Inizia con circa dieci o venti richieste concorrenti e abbina una concorrenza maggiore a un pool di proxy a rotazione per distribuire il carico su molti IP.
Mi serve un proxy per il web scraping con Rust?
Non per lavori piccoli, ma i proxy diventano importanti su scala per distribuire le richieste e raggiungere contenuti specifici per area geografica. Configurane uno con reqwest::Proxy e basic_auth e usa IP residential o mobile a rotazione per ridurre limitazioni della frequenza e blocchi.
Quando DataImpulse non è la soluzione giusta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Estrai dati in modo affidabile con proxy etici
Quando il tuo scraper Rust recupera, analizza ed esporta correttamente, una rete di proxy affidabile è ciò che lo mantiene operativo su scala. DataImpulse offre IP ottenuti in modo etico, pay-as-you-go, a partire da 1 dollaro per GB con traffico senza scadenza, così puoi creare un account e instradare le tue prime richieste in pochi minuti.