
In this Article
Questa guida spiega come fare web scraping con JavaScript usando Node.js, il runtime a cui ricorre la maggior parte degli ingegneri quando vuole raccogliere dati pubblici su larga scala. Imparare a fare web scraping con JavaScript significa scegliere lo strumento giusto per la pagina: un client HTTP leggero per HTML statico oppure un browser headless per i contenuti caricati tramite script.
Qui sotto trovi codice Node.js funzionante ed eseguibile per entrambi i casi, oltre alla configurazione del progetto, esportazioni strutturate in JSON e CSV, paginazione, tentativi con backoff, rate limiting, autenticazione proxy, intercettazione XHR e le questioni etiche e di blocco che determinano se uno scraper continua a funzionare nel tempo.
DataImpulse è un provider etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Usa un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Dati principali
- Due toolchain: Le pagine statiche richiedono solo un client HTTP e un parser come fetch e cheerio, mentre le pagine dinamiche che renderizzano i contenuti nel browser richiedono un motore headless come Puppeteer o Playwright.
- Miglior tipo di proxy: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e nessun abbonamento.
- Copertura: oltre 90 Mln di IP reperiti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99,51%, valutazione di 4,8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Che cos’è il web scraping con JavaScript?
Il web scraping con JavaScript è il processo di richiesta programmatica di pagine web e di estrazione di dati strutturati tramite JavaScript, di solito eseguito nel runtime Node.js anziché in una scheda del browser.
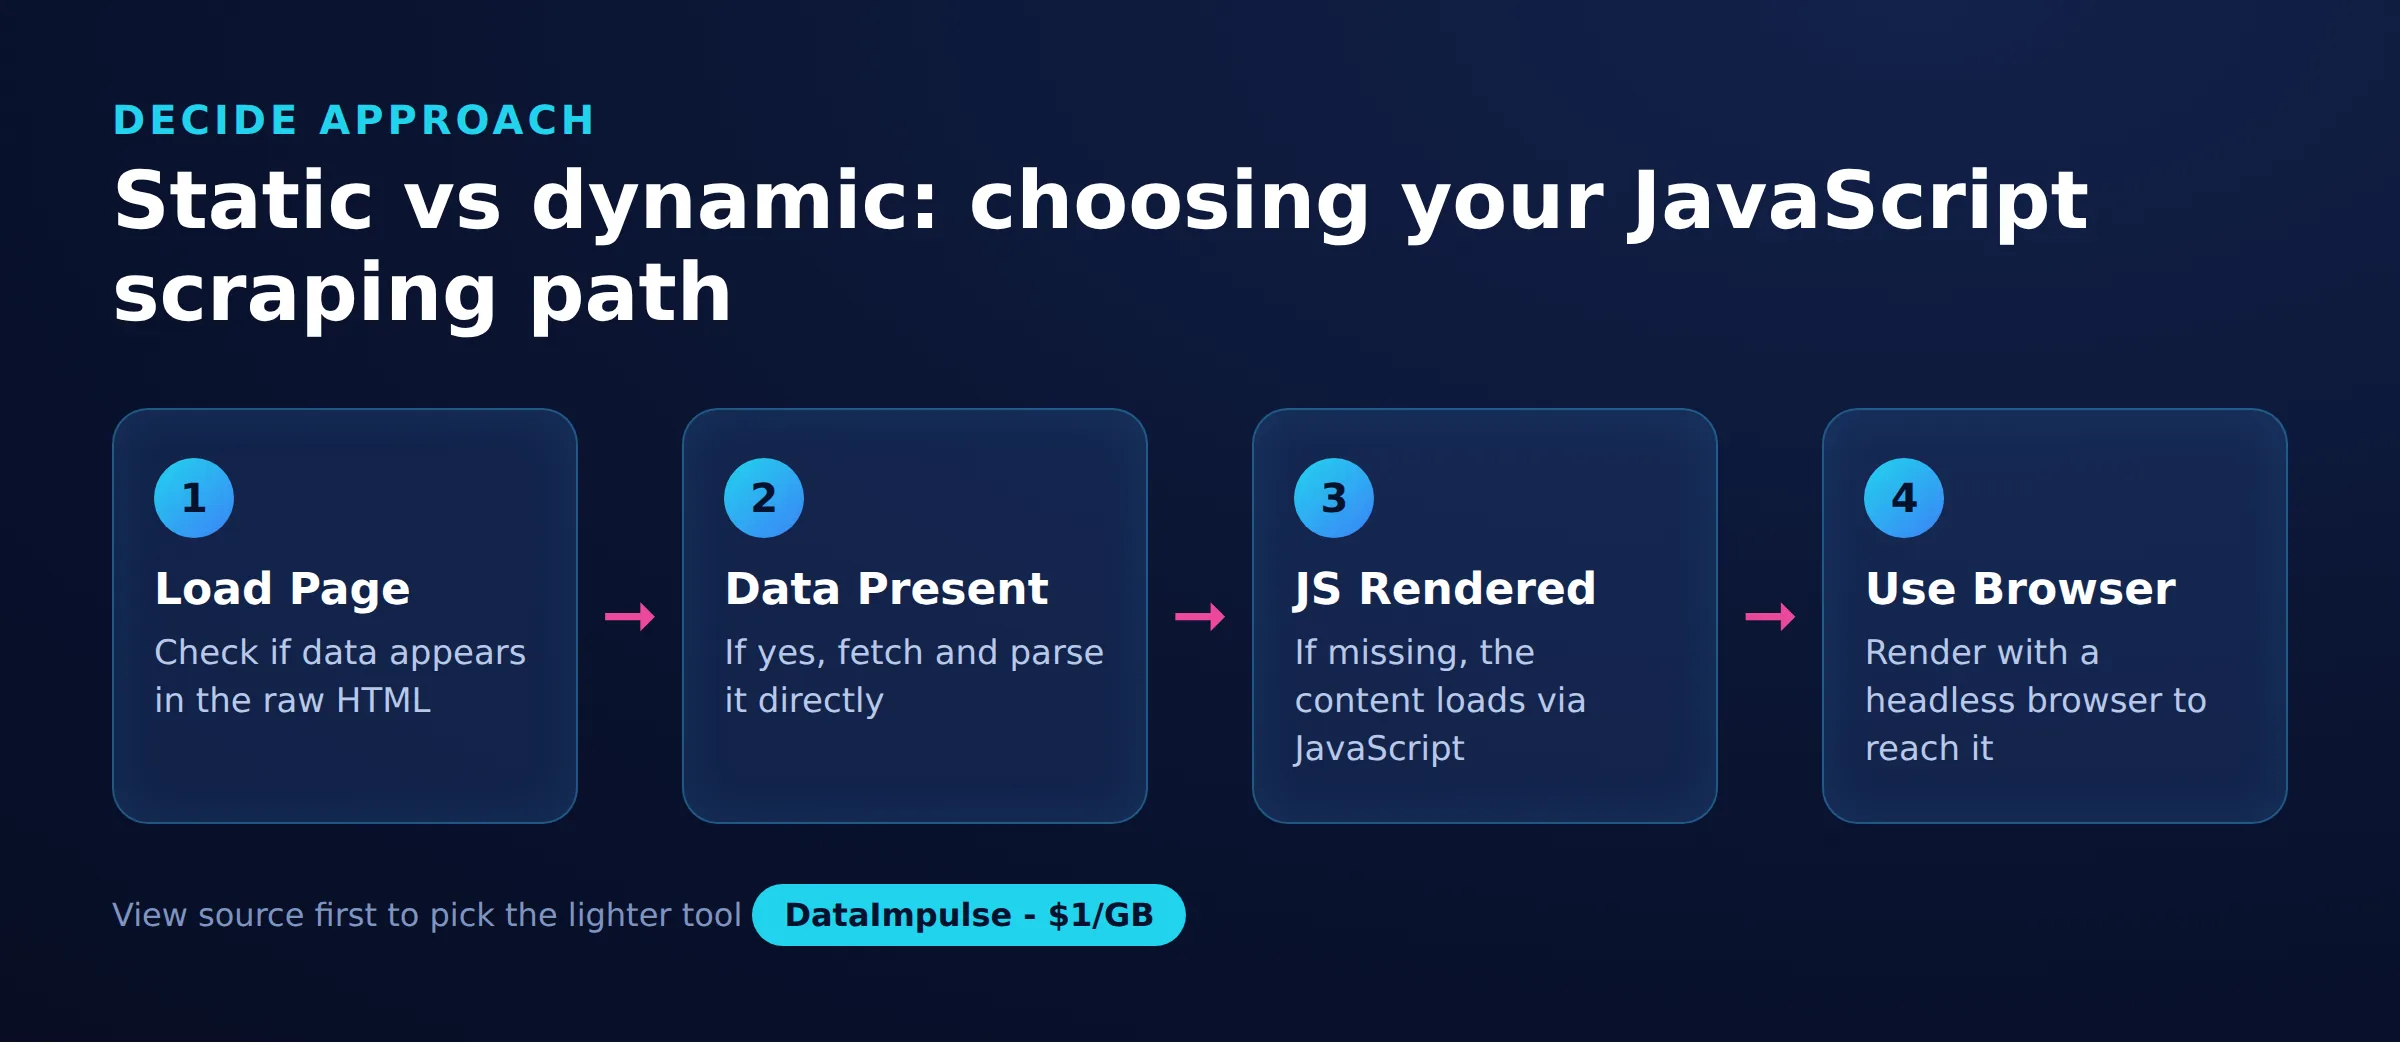
JavaScript è una scelta naturale perché il linguaggio modella già il Document Object Model, quindi selezionare elementi risulta familiare agli sviluppatori front-end. In pratica uno scraper fa tre cose: recupera una pagina tramite HTTP, analizza il markup restituito in un albero interrogabile ed estrae i campi che ti interessano, come titoli, prezzi o link. La complessità dipende da come la pagina di destinazione fornisce i dati, perciò scegliere lo strumento corretto conta più dell’analisi stessa. Le pagine statiche inviano i dati nella prima risposta HTML, mentre quelle dinamiche li assemblano nel browser dopo il caricamento: i due casi richiedono toolchain diverse.
Come si configura un progetto di scraping Node.js?
Crea una cartella di progetto, inizializzala con npm e installa le librerie necessarie prima di scrivere codice di scraping.
Node.js 18 e versioni successive includono una funzione globale fetch, quindi non ti serve una libreria HTTP per semplici richieste GET, anche se molti team preferiscono ancora axios per gli interceptor e la gestione dei proxy. I comandi seguenti creano lo scheletro del progetto e installano cheerio per l’analisi, axios come client alternativo, p-limit per il controllo della concorrenza e Puppeteer e Playwright per le pagine dinamiche:
mkdir js-scraper && cd js-scraper
npm init -y
npm install cheerio axios p-limit
npm install puppeteer playwright

# enable modern import syntax
npm pkg set type=module
Impostare type=module ti consente di usare istruzioni import . Se preferisci CommonJS, mantieni l’impostazione predefinita e usa require al suo posto. Gli esempi di questa guida usano la sintassi import, ma ciascuno corrisponde direttamente a una chiamata require. Al termine dell’installazione hai tutto ciò che serve per lo scraping statico e dinamico in un unico progetto.
Come si esegue lo scraping di una pagina statica con fetch e cheerio?
Per le pagine statiche, scarica l’HTML con la funzione fetch integrata e analizzalo con cheerio, che mette a disposizione una API in stile jQuery sul server.
Le pagine statiche restituiscono il contenuto direttamente nella risposta HTML iniziale, quindi non serve il rendering del browser. Questo approccio è rapido ed economico perché scarichi solo il markup, non immagini, font o script. L’esempio seguente recupera una pagina, la carica in cheerio e legge ogni scheda prodotto:
import * as cheerio from 'cheerio';

async function scrape(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
  });
  if (!res.ok) throw new Error(`Request failed: ${res.status}`);
  const html = await res.text();
  const $ = cheerio.load(html);

  const items = [];
  $('.product').each((i, el) => {
    items.push({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim(),
      link: $(el).find('a').attr('href')
    });
  });
  return items;
}

console.log(await scrape('https://example.com/catalog'));
Se preferisci axios, la parte di analisi è identica e cambia solo la richiesta. Axios genera automaticamente un’eccezione per i codici di stato diversi da 2xx e rende semplice la configurazione proxy, per questo molti scraper in produzione lo usano:
import axios from 'axios';
import * as cheerio from 'cheerio';

const { data: html } = await axios.get('https://example.com/catalog', {
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' },
  timeout: 15000
});
const $ = cheerio.load(html);
const titles = $('.product h2').map((i, el) => $(el).text().trim()).get();
console.log(titles);
Prima di indirizzare uno scraper verso un sito, vale la pena confermare che il sito di destinazione lo consenta. La nostra guida su come verificare se un sito consente lo scraping illustra robots.txt e i termini di servizio.
Come si estraggono dati strutturati in JSON e CSV?
Raccogli ogni record in un array di oggetti semplici, quindi scrivi l’array in un file JSON oppure trasformalo in righe separate da virgole per un file CSV.
Il testo estratto è utile solo quando viene archiviato in una struttura prevedibile. JSON è il formato più semplice perché un array JavaScript si serializza direttamente. Il frammento seguente scrive gli elementi estratti sul disco con il modulo file system integrato:
import { writeFile } from 'node:fs/promises';

const items = await scrape('https://example.com/catalog');
await writeFile('products.json', JSON.stringify(items, null, 2), 'utf-8');
console.log(`Saved ${items.length} records to products.json`);
CSV è preferibile quando i dati alimentano un foglio di calcolo o un data warehouse. Puoi crearlo senza librerie eseguendo l’escape delle virgolette e unendo i campi, cosa importante perché prezzi e titoli possono contenere virgole:
import { writeFile } from 'node:fs/promises';

function toCsv(rows) {
  const headers = Object.keys(rows[0]);
  const escape = (v) => `"${String(v ?? '').replace(/"/g, '""')}"`;
  const lines = [headers.join(',')];
  for (const row of rows) {
    lines.push(headers.map((h) => escape(row[h])).join(','));
  }
  return lines.join('\n');
}

const items = await scrape('https://example.com/catalog');
await writeFile('products.csv', toCsv(items), 'utf-8');
Mantieni stabili i nomi dei campi tra un’esecuzione e l’altra, così gli strumenti a valle non si interrompono se il layout della pagina cambia leggermente. Se devi anche recuperare asset binari, consulta la nostra guida su come fare scraping di immagini da un sito web.
Come si esegue lo scraping di più pagine con la paginazione?
Scorri gli URL delle pagine del sito oppure segui il link alla pagina successiva in ogni pagina, eseguendo lo scraping di ciascuna e fermandoti quando non ci sono più risultati.
La maggior parte dei cataloghi divide i risultati in pagine numerate usando un parametro di query come ?page=2, oppure espone un link alla pagina successiva. Il modello più sicuro legge ogni pagina, raccoglie i record, quindi cerca quella successiva e si ferma se manca. L’esempio seguente scorre le pagine numerate finché una pagina non restituisce elementi:
import * as cheerio from 'cheerio';

async function scrapeAll(base) {
  const all = [];
  for (let page = 1; page <= 50; page++) {
    const res = await fetch(`${base}?page=${page}`, {
      headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
    });
    if (!res.ok) break;
    const $ = cheerio.load(await res.text());
    const items = $('.product').map((i, el) => ({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim()
    })).get();

    if (items.length === 0) break;
    all.push(...items);
    await new Promise((r) => setTimeout(r, 1000));
  }
  return all;
}

console.log((await scrapeAll('https://example.com/catalog')).length);
Nota la pausa di un secondo tra le pagine e il limite rigido di 50 iterazioni, che evita un ciclo incontrollato se il sito non restituisce mai una pagina vuota. Quando il contenuto viene caricato con lo scorrimento anziché con pagine numerate, serve un browser headless, trattato nella sezione su Puppeteer qui sotto.
Come si gestiscono tentativi, backoff e rate limiting?
Racchiudi ogni richiesta in un helper di tentativo che attenda più a lungo dopo ogni errore e limita il numero di richieste simultanee per restare entro la tolleranza di un sito.
Le reti sono inaffidabili e i server restituiscono errori transitori, quindi uno scraper che si arrende al primo errore perde dati inutilmente. Un helper di tentativo con backoff esponenziale attende periodi progressivamente più lunghi tra i tentativi, dando anche a un server soggetto a rate limiting il tempo di riprendersi:
async function fetchWithRetry(fn, retries = 4, delay = 1000) {
  for (let attempt = 1; attempt <= retries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === retries) throw err;
      const wait = delay * 2 ** (attempt - 1);
      console.warn(`Attempt ${attempt} failed, retrying in ${wait}ms`);
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const html = await fetchWithRetry(async () => {
  const res = await fetch('https://example.com/catalog');
  if (res.status === 429) throw new Error('Rate limited');
  if (!res.ok) throw new Error(`HTTP ${res.status}`);
  return res.text();
});
Il backoff gestisce singole richieste, ma devi anche controllare quante ne vengono eseguite in parallelo. Inviare centinaia di richieste simultanee degrada il server di destinazione e fa segnalare il tuo traffico. La libreria p-limit limita la concorrenza affinché un numero fisso di worker elabori una coda di URL:
import pLimit from 'p-limit';

const limit = pLimit(5); // at most 5 requests in flight
const urls = Array.from({ length: 100 }, (_, i) =>
  `https://example.com/item/${i + 1}`
);

const results = await Promise.all(
  urls.map((url) =>
    limit(() => fetchWithRetry(async () => {
      const res = await fetch(url);
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return res.text();
    }))
  )
);

console.log(`Fetched ${results.length} pages with a cap of 5 in parallel`);
Insieme, il backoff e un limite di concorrenza mantengono ragionevole il tuo impatto e alto il tasso di successo. Per una checklist più ampia, consulta la nostra guida alle best practice per il web scraping .
Come si esegue lo scraping di pagine dinamiche con Puppeteer?
Per le pagine dinamiche che costruiscono i contenuti con JavaScript dopo il caricamento, pilota Chrome headless con Puppeteer, attendi il selettore di destinazione e leggi il DOM completamente renderizzato.
Molti siti moderni restituiscono una struttura HTML quasi vuota e poi recuperano i dati tramite richieste in background. Un client HTTP non vede nulla di utile, quindi ti serve un motore che esegua il JavaScript della pagina. Puppeteer controlla Chrome headless e può attendere gli elementi, fare clic e scorrere. L’esempio seguente attende un selettore, quindi scorre ripetutamente per attivare il caricamento a scorrimento infinito prima di estrarre i dati nel contesto del browser:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();
await page.setUserAgent('Mozilla/5.0 (compatible; MyScraper/1.0)');
await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });

// wait until the first batch of cards is present
await page.waitForSelector('.product');

// infinite scroll: scroll to the bottom until height stops growing
let previousHeight = 0;
for (let i = 0; i < 20; i++) {
  const height = await page.evaluate('document.body.scrollHeight');
  if (height === previousHeight) break;
  previousHeight = height;
  await page.evaluate('window.scrollTo(0, document.body.scrollHeight)');
  await new Promise((r) => setTimeout(r, 1500));
}

const items = await page.evaluate(() =>
  Array.from(document.querySelectorAll('.product')).map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Il ciclo si ferma appena l’altezza della pagina smette di aumentare, segnalando che non vengono caricati nuovi contenuti; il limite rigido di 20 scorrimenti evita un ciclo infinito. Per maggiori dettagli su questo tipo di destinazione, consulta la nostra guida su come fare scraping di pagine web dinamiche.
Come si usa Playwright come alternativa a Puppeteer?
Playwright funziona quasi come Puppeteer, ma aggiunge supporto di prima classe per Chromium, Firefox e WebKit, oltre a locator con attesa automatica che riducono i selettori instabili.
Playwright è stato creato da alcuni degli ingegneri originali di Puppeteer e condivide la maggior parte della sua API, quindi la migrazione di solito richiede solo di rinominare alcune chiamate. I suoi locator attendono automaticamente che gli elementi siano utilizzabili, eliminando molte chiamate manuali a waitForSelector. Lo scraper equivalente è questo:
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const context = await browser.newContext({
  userAgent: 'Mozilla/5.0 (compatible; MyScraper/1.0)'
});
const page = await context.newPage();
await page.goto('https://example.com/feed', { waitUntil: 'networkidle' });

await page.locator('.product').first().waitFor();

const items = await page.locator('.product').evaluateAll((els) =>
  els.map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Scegli Playwright se devi testare lo stesso scraper su più motori del browser o vuoi il suo mocking di rete integrato. Scegli Puppeteer se punti solo a Chrome e desideri una dipendenza più piccola. Entrambi consumano molta più memoria di fetch e cheerio, quindi riservali alle pagine che richiedono davvero il rendering.
Quale strumento di scraping JavaScript dovresti scegliere?
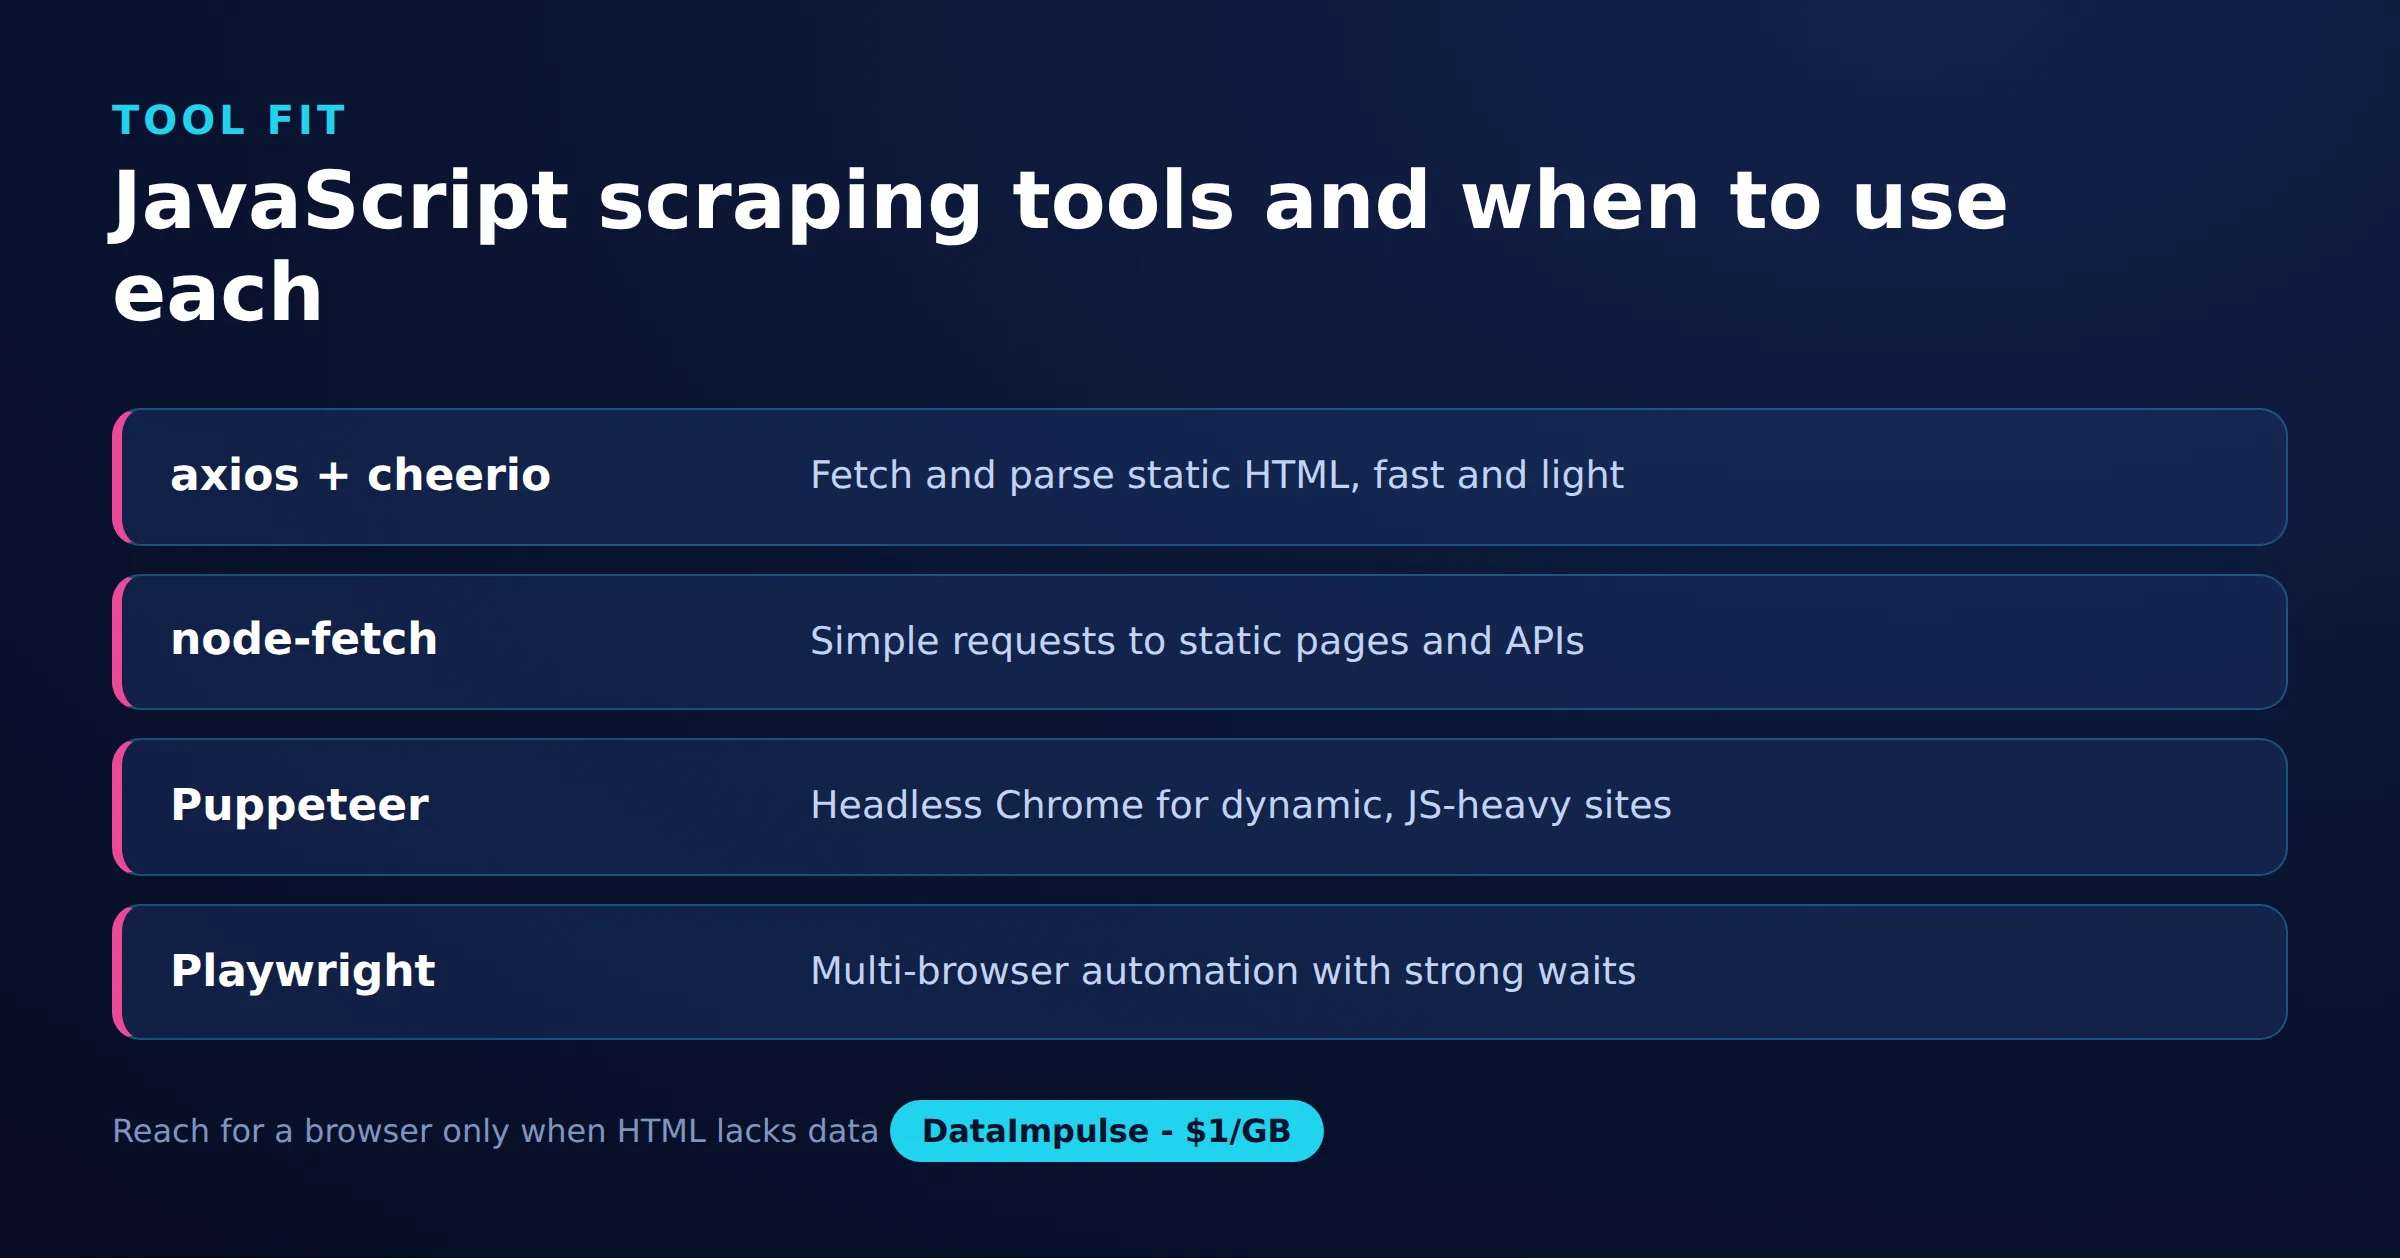
Usa fetch o axios con cheerio per HTML statico e ricorri a Puppeteer o Playwright solo quando una pagina renderizza i dati nel browser.
Lo strumento giusto dipende da come la pagina fornisce i dati e da quanto privilegi la velocità rispetto alla fedeltà del rendering. I client HTTP sono rapidi e leggeri, ma non possono eseguire JavaScript; i browser headless eseguono tutto ciò che vede un utente reale, ma richiedono più memoria e tempo. La tabella seguente riassume i compromessi:
| Strumento | Esegue JS | Velocità | Ideale per |
|---|---|---|---|
| fetch + cheerio | No | Più rapido | HTML statico, grandi volumi |
| axios + cheerio | No | Rapido | HTML statico, facile configurazione proxy |
| Puppeteer | Sì | Lento | Pagine dinamiche solo Chrome |
| Playwright | Sì | Lento | Dinamico, test multi-browser |
Un modello di produzione comune combina entrambi: usa un browser headless solo per raggiungere le pagine o gli endpoint che richiedono il rendering, poi passa a un semplice client HTTP per la maggior parte delle richieste. JavaScript è uno dei vari stack validi per questo lavoro; se stai confrontando ecosistemi, la nostra guida al web scraping con Rust tratta un’alternativa compilata.
Come si instradano gli scraper JavaScript tramite un proxy?
Passa le impostazioni proxy al client HTTP o alle opzioni di avvio del browser affinché le richieste escano da un indirizzo IP diverso, distribuendo il carico e riducendo la probabilità che un singolo indirizzo subisca rate limiting.
Fare scraping di molte pagine da un solo IP è il modo più rapido per essere bloccati. Alternare le richieste in un pool di indirizzi fa apparire il traffico come proveniente da molti visitatori distinti. Con axios fornisci host, porta e credenziali del proxy nella configurazione della richiesta. L’esempio seguente instrada tramite un gateway DataImpulse:
import axios from 'axios';

const { data } = await axios.get('https://example.com', {
  proxy: {
    protocol: 'http',
    host: 'gw.dataimpulse.com',
    port: 823,
    auth: { username: 'YOUR_USERNAME', password: 'YOUR_PASSWORD' }
  },
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
});
console.log(data.length, 'bytes received through the proxy');
Puppeteer riceve il proxy come argomento di avvio e poi esegue l’autenticazione nella pagina, perché Chrome non accetta credenziali nell’URL del proxy. Il modello è lo stesso in Playwright, che accetta direttamente un oggetto proxy con nome utente e password:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({
  headless: 'new',
  args: ['--proxy-server=gw.dataimpulse.com:823']
});
const page = await browser.newPage();
await page.authenticate({
  username: 'YOUR_USERNAME',
  password: 'YOUR_PASSWORD'
});
await page.goto('https://example.com', { waitUntil: 'networkidle2' });
console.log(await page.title());
await browser.close();
DataImpulse offre proxy residential, proxy datacenter, and proxy mobile tramite HTTP, HTTPS e SOCKS5, con sessioni a rotazione e sticky session. Il targeting per paese è incluso, mentre il targeting per stato, città, ZIP e ASN è un componente aggiuntivo a pagamento. Se una richiesta proxy restituisce un errore di autenticazione, la nostra nota su errore HTTP 407 spiega la causa più comune e la nostra guida sull’autenticazione proxy illustra più in dettaglio i formati delle credenziali.
Come si intercettano XHR ed endpoint JSON?
Invece di fare scraping dell’HTML renderizzato, osserva il traffico di rete in un browser headless e leggi le risposte JSON recuperate dalla pagina in background: spesso è più pulito e rapido.
Le pagine dinamiche di solito ottengono i dati da una API nascosta che restituisce JSON. Leggere direttamente quella risposta evita completamente l’analisi del DOM e fornisce record ben strutturati. Sia Puppeteer sia Playwright consentono di ascoltare le risposte e acquisire quelle desiderate. L’esempio Puppeteer qui sotto acquisisce ogni risposta JSON da un percorso API:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();

const captured = [];
page.on('response', async (response) => {
  const url = response.url();
  if (url.includes('/api/') && response.headers()['content-type']?.includes('application/json')) {
    try {
      captured.push(await response.json());
    } catch (err) {
      // non-JSON body, ignore
    }
  }
});

await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });
console.log(`Captured ${captured.length} JSON payloads`);
await browser.close();
Una volta noti l’URL dell’endpoint e i suoi parametri, spesso puoi eliminare completamente il browser e chiamare la API JSON con un semplice fetch, passando gli stessi headers inviati dalla pagina. Ottieni così la velocità di uno scraper statico con la completezza di uno renderizzato, il maggiore guadagno prestazionale disponibile per i siti dinamici.
Quali sono i limiti etici e legali dello scraping?
Fai scraping solo di dati pubblici, rispetta robots.txt e i termini di servizio del sito, evita i dati personali e non sovraccaricare mai un server. Queste pratiche rendono il tuo progetto difendibile e sostenibile.
Controlla il file robots.txt alla radice del dominio per vedere quali percorsi un sito chiede ai crawler di evitare e prendi sul serio tali richieste. Identifica il tuo scraper con un User-Agent onesto, limita le richieste e metti in cache le risposte per non recuperare inutilmente la stessa pagina. Sul lato infrastrutturale, conta la provenienza dei tuoi indirizzi IP. DataImpulse gestisce proxy etici reperiti da utenti che aderiscono volontariamente e vengono compensati, in linea con il GDPR e con un accordo sul trattamento dei dati disponibile. L’etica non è solo una questione di conformità: gli scraper cortesi e trasparenti sono anche quelli che continuano a funzionare. Per i principi alla base di una raccolta sostenibile, consulta la nostra guida al web scraping etico.
Domande frequenti
Mi serve Node.js per fare scraping con JavaScript?
Per qualsiasi attività oltre un rapido test di una pagina, sì. Node.js ti permette di eseguire scraper su un server, scorrere molti URL, gestire tentativi, esportare dati e usare proxy, tutte cose che la console del browser non fa bene.
Quando dovrei usare Puppeteer anziché fetch e cheerio?
Usa fetch o axios con cheerio quando i dati sono presenti nella risposta HTML iniziale. Passa a Puppeteer o Playwright solo quando i contenuti vengono renderizzati da JavaScript dopo il caricamento della pagina, perché un browser headless è molto più pesante.
Come esporto i dati estratti in CSV con Node.js?
Raccogli i record in un array di oggetti, poi crea righe separate da virgole unendo i valori di ogni oggetto ed eseguendo l’escape di virgolette e virgole. Scrivi il risultato in un file con il modulo fs integrato oppure usa una libreria come csv-stringify.
Perché vengo bloccato quando faccio scraping con JavaScript?
Le cause comuni sono troppe richieste da un IP, un User-Agent mancante o sospetto e nessun ritardo tra le richieste. Proxy a rotazione, headers realistici, tentativi con backoff e rate limiting riducono i blocchi.
Quale tipo di proxy è migliore per lo scraping JavaScript?
I proxy datacenter sono rapidi ed economici per destinazioni tolleranti, mentre i proxy residential e mobile somigliano di più a utenti reali sui siti più rigidi. Le sessioni a rotazione aiutano a distribuire le richieste su molti indirizzi.
Quando DataImpulse non è la soluzione adatta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Inizia lo scraping con proxy affidabili
Vuoi mantenere operativi i tuoi scraper JavaScript senza blocchi continui? DataImpulse ti offre IP residential, mobile e datacenter reperiti eticamente a partire da 1 dollaro per GB, con traffico senza scadenza e nessun abbonamento. Crea un account e instrada oggi il tuo primo scraper tramite un proxy.