
In this Article
Imparare a estrarre le immagini da un sito web significa risolvere due problemi: trovare dove ogni sorgente di immagini vive nella HTML, poi scaricare i file binari dietro tali URL. Questa guida passa attraverso entrambi i passaggi con il codice Python funzionante, copre i casi difficili come la selezione srcset, il lazy-loading, e sfondi CSS, e spiega come rimanere nel rispetto di copyright e limiti di larghezza di banda.
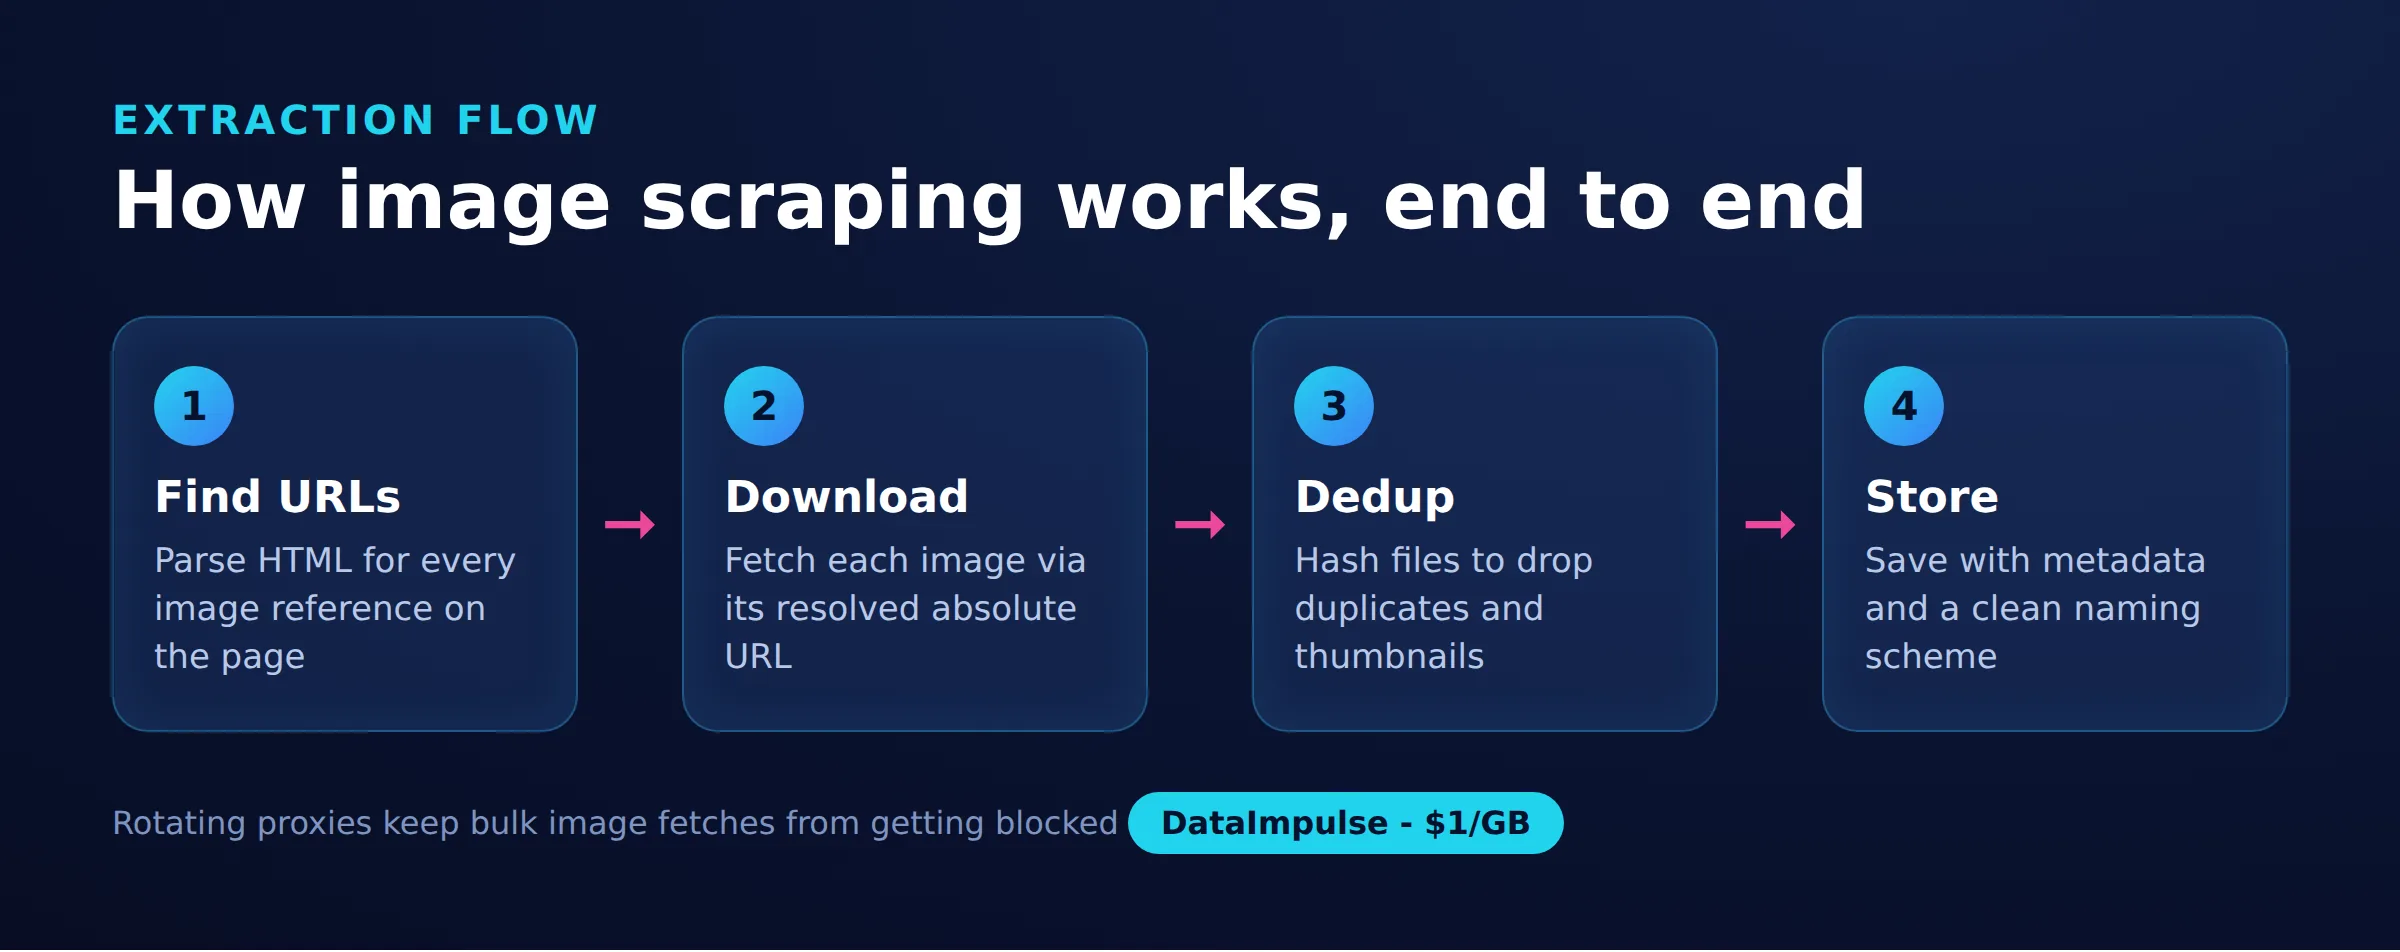
Le immagini sono più pesanti del testo, quindi raccoglierle su larga scala necessita di un piano di archiviazione, deduplicazione, concorrenza e costi di rete. Tutto ciò che segue è gestibile con richieste, BeautifulSoup, e Playwright, e le tecniche si applicano a una singola galleria o un grande catalogo.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go da 1 dollaro per GB con traffico senza scadenza, ed è utilizzato per web scraping, ad verification, monitoraggio dei prezzi, ricerca di mercato e gestione multi-account.
Fatti chiave
- Punto chiave:Per estrarre immagini da un sito web è necessario prima estrarre ogni fonte (img src, srcset, attributi di dati a lazy-loading, sfondi CSS e JSON-LD), poi scaricare i file binari, perché il markup e i file di immagine reali sono richieste separate.
- Miglior tipo proxy:residential proxy a rotazione, che utilizzano IP di consumo reale che passano il rilevamento.
- Prezzo:da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e nessun abbonamento.
- Copertura:90M più IP di provenienza etica in 195 paesi.
- Affidabilità:Tasso di successo del 99,51%, valutato 4,8 su 5 su G2.
- Protocolli e obiettivi:HTTP, HTTPS e SOCKS5, con targeting nazionale incluso.
Dove si trovano gli URL delle immagini in una pagina web?
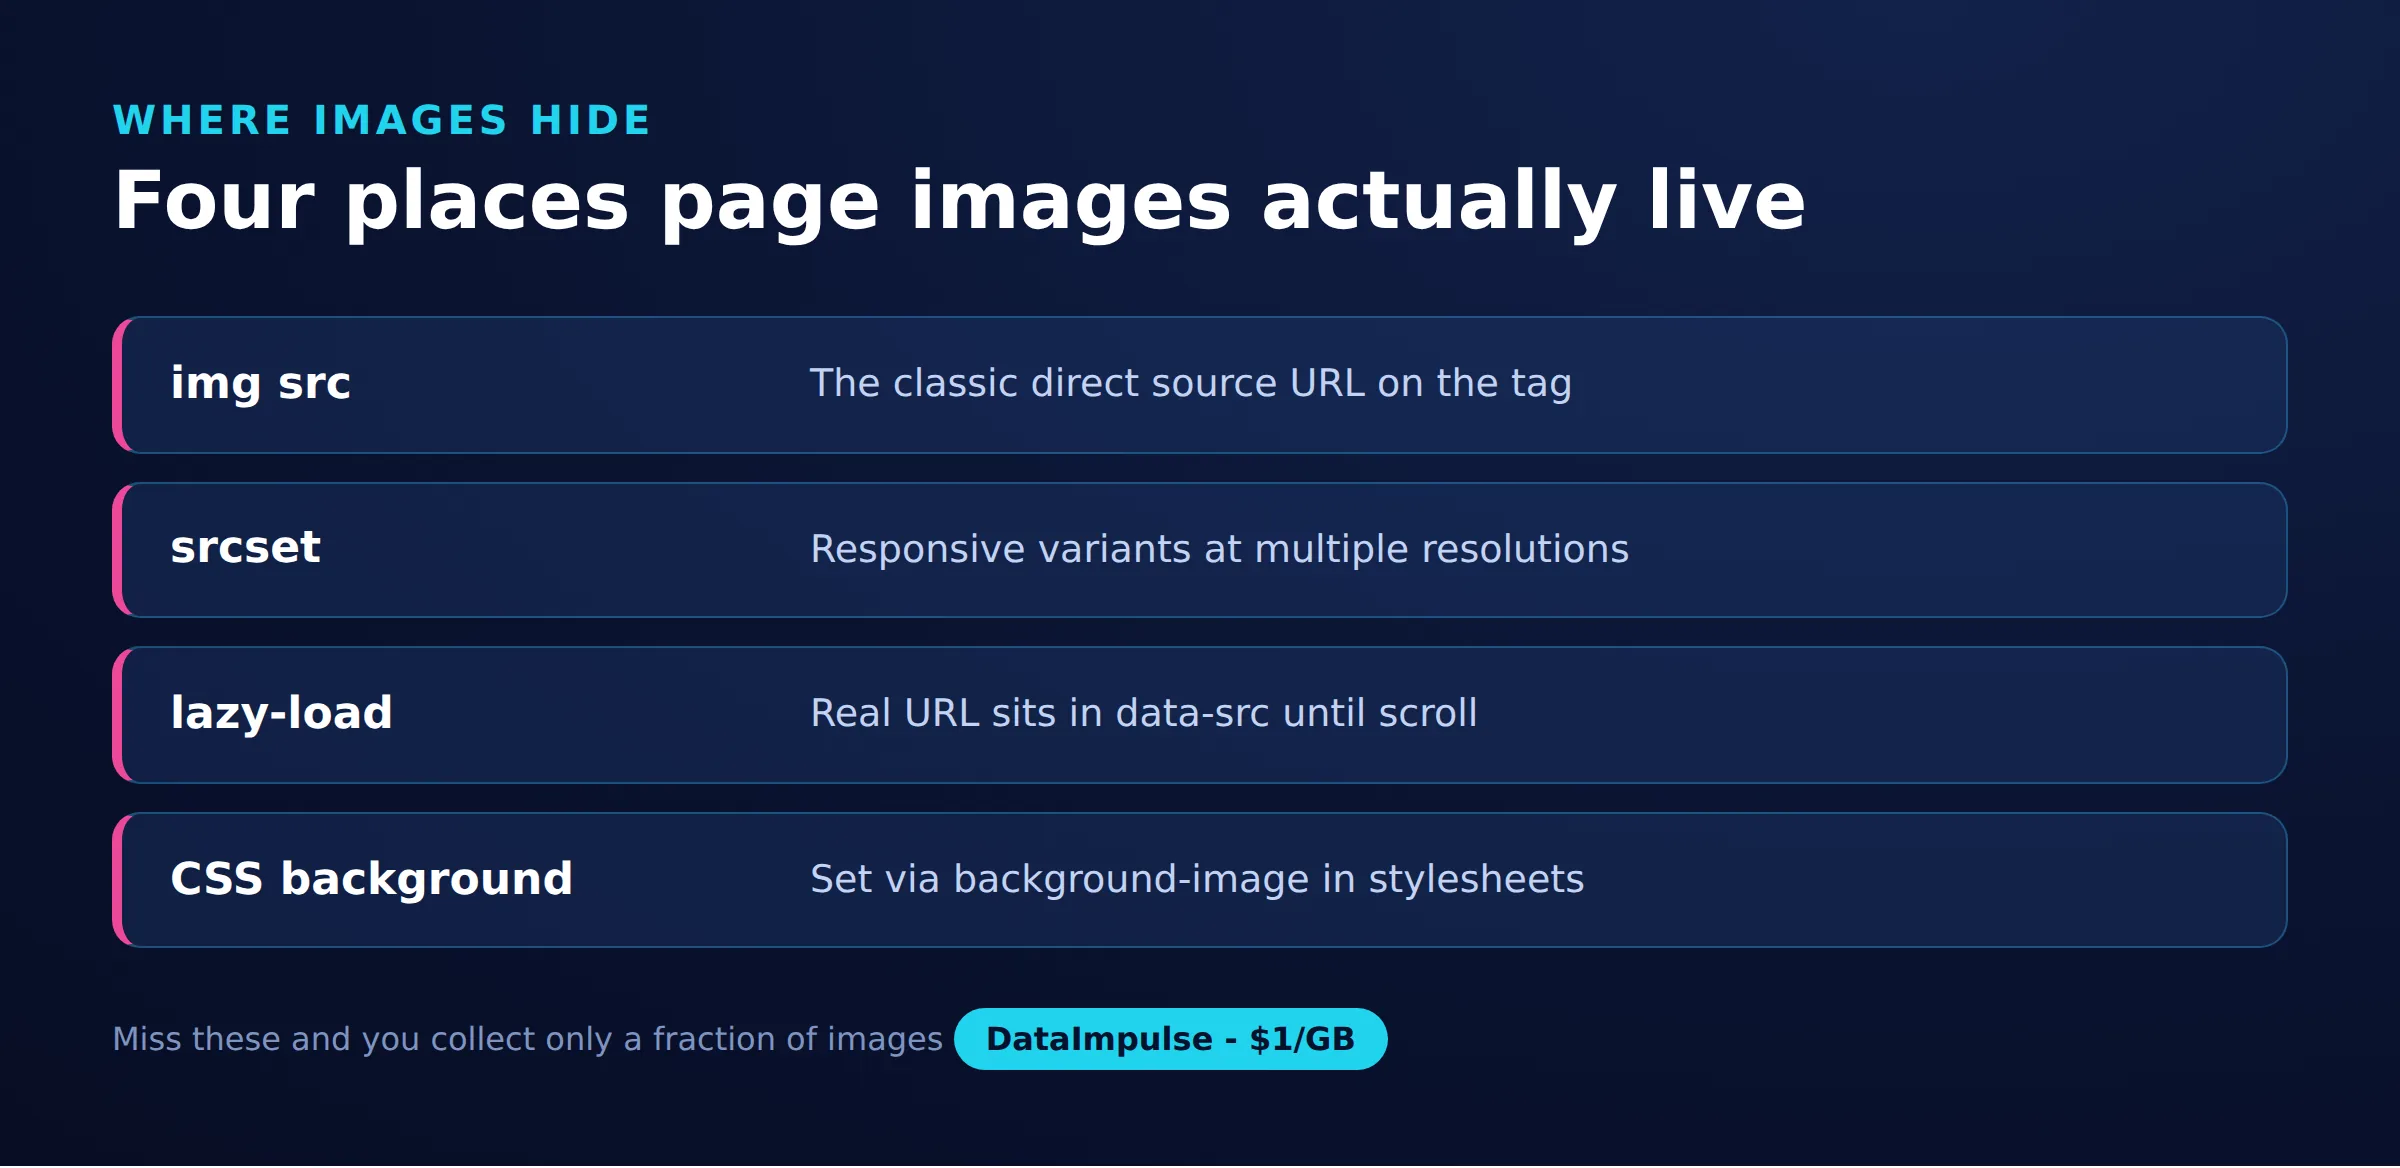
Immagine URL sono memorizzati in diversi luoghi, non solo ilsrcUna pagina può fare riferimento alla stessa immagine attraverso tag standard, attributi reattivi, segnaposto a lazy-loading, fogli di stile e dati strutturati.
- Immagini standard:della
srcattributo di un<img>tag contiene la URL diretta. - Immagini responsive:della
srcsetattributo su<img>e<fonte>elenca più URL con descrittori di larghezza o densità, permettendo al browser di scegliere una dimensione. - Immagini caricate con pigrizia:visibile
srcè spesso un minuscolo segnaposto, mentre il reale URL si trova indata-src,data-original, o un attributo personalizzato simile fino a quando l’utente scorre. - Sfondi CSS:immagini decorative sono impostati con
sfondo-immagine: url(...)in stili in linea o fogli di stile, e non appaiono mai in un<img>Assolutamente. - Dati strutturati:pagine di prodotti e articoli spesso elencano un’immagine ad alta risoluzione canonica in un blocco JSON-LD.
A causa di questa diffusione, trattare la pagina come un insieme di fonti candidate e raccogliere da tutte queste posizioni prima di scaricare. La tabella seguente riassume dove ogni fonte vive e il gotcha che viaggia la maggior parte estraetori.
| Sorgente di estrazione | Dove trovarlo | # Common gotcha # |
|---|---|---|
| img src | Attributo src dei tag img | Spesso un segnaposto o un dato: URI su pagine cariche di pigrizia |
| srcset | srcset sui tag img e sorgente | Tiene diversi URL con descrittori di larghezza; è necessario analizzare e scegliere una dimensione |
| Attrs pigri | data-src, data-original, data-lazy-src, data-srcset | I nomi degli attributi variano in base al framework, quindi controlla il markup reale |
| Sfondo CSS | Stile in linea e blocchi di stile, sfondo-immagine: url() | Non appare mai in un tag img; ha bisogno di un regex sopra il testo CSS |
| JSON-LD | script tag con tipo applicazione/ld+json | Il campo immagine può essere una stringa, una lista o un oggetto annidato |
Come si configura un strumento Python per estrarre immagini?
Installare le richieste per HTTP, BeautifulSoup per l’analisi, e lxml come un veloce parser backend, quindi prendere la pagina e leggere lasrcdi ogni tag immagine. Questo esempio minimo è la base su cui si basa ogni passo successivo.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
LaSessionoggetto mantiene le connessioni in vita e riutilizza le intestazioni, che è più veloce e delicato sul server di destinazione che aprire una nuova connessione per ogni richiesta.urljoinin modo che i percorsi relativi come/media/photo.jpgrisolvere a URL assoluti è possibile scaricare più tardi. Se si è nuovi per il flusso di lavoro più ampio, ilMigliori pratiche web scrapingguida copre intestazioni, timeout, e gentilezza in più profondità.
Come estrarre img src, srcset e fonti con lazy-loading?
Parsasrcsetdividendo le virgole e leggendo il descrittore di larghezza in modo da poter scegliere la variante più grande, e leggere ogni probabiledatiUn attributo semplice letto manca la maggior parte di una pagina moderna, quindi avete bisogno di piccoli helper per ogni formato.
Lasrcsetvalore pack diversi URL insieme a descrittori come800w. Per prendere la copia più alta risoluzione, confrontare i numeri di larghezza e mantenere il più grande.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Ora unire le sorgenti standard, reattive e pigre in un collezionista. Framework diversi usano nomi di attributi diversi, quindi controllare diversi. La stessa funzione legge anche<fonte>etichette all’interno<immagine>elementi che portano il propriosrcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Saltare qualsiasisrcche inizia condati:evita di salvare i segnaposto in linea base64, che di solito sono le miniature di bassa qualità una caricatrice pigro mostra prima che l’immagine reale arriva.
Come trovare immagini di sfondo CSS e JSON-LD?
Usare un’espressione regolare per estrarre URLimmagine di sfondodichiarazioni, e camminare qualsiasi blocco JSON-LD per leggere il suoimmaginefield. Queste due fonti non appaiono mai in un<img>tag, quindi un estraietto che legge solo i tag immagine li mancherà del tutto.
Le immagini decorative ed eroistiche sono comunemente impostate in CSS.stileattributi e<style>blocchi perurl(...)valori.
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
I dati strutturati sono il luogo più affidabile per trovare un’immagine canonica a piena risoluzione sulle pagine dei prodotti e degli articoli.immaginevalore può essere una stringa, una lista, o un oggetto annidato, quindi camminare l’intero albero.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Unire i tre collezionisti con un insieme di unione, per esempiocollect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base), e hai un set deduplicato di candidati URL pronti per il download.
Come si scaricano i file immagine in modo sicuro?
Stream ogni risposta, confermare ilContent-Typeheader è davvero un’immagine, e tappare le dimensioni in modo che un singolo file non può esaurire la memoria o disco. Scaricare uno URL rischia ciecamente di salvare pagine di errore HTML, reindirizzamenti, o file enormi, quindi convalidare prima di mantenere i byte.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Streaming constream=trueeiter_contentsignifica che il controllo dell’intestazione viene eseguito prima del download completo del corpo, quindi un link non etichettato viene scartato in anticipo. Controllando il tipo riportato si cattura il caso comune in cui una URL rotta restituisce una pagina HTML 404 con uno stato di 200. Per maggiore sicurezza è anche possibile verificare i primi byte magici del carico utile, ma il controllo dell’intestazione più un tappo di dimensione gestisce la maggior parte estraemento del mondo reale.
Come deduplicare e nominare le immagini scaricate?
Hash i byte scaricati con SHA-256 e saltare qualsiasi digestivo che hai già salvato, quindi disinfettare il nome file e i file hard in sottocartelle da prefisso hash. I siti spesso servono la stessa immagine da più percorsi, CDN, o varianti di dimensione, quindi un hash contenuto è più affidabile di confronto URLs.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
La sanificazione del nome di base rimuove i caratteri di percorso e la spazzatura di query-string in modo che un URL dannoso o disordinato non possa scrivere fuori dalla cartella di destinazione. La condivisione dei primi due caratteri hash mantiene le directory piccole, il che conta una volta che si raccolgono decine di migliaia di file. Per il rilevamento quasi-duplicato, come la stessa foto a risoluzioni diverse, una libreria hash percettivo come gruppi di imagehash visivamente simili file che hash bytetrattare come distinto.
Come scaricare molte immagini contemporaneamente?
Utilizzare aThreadPoolExecutorper scaricare più immagini contemporaneamente, e aggiungere un limitatore di velocità condiviso in modo che tutti i thread insieme rimangano sotto un soffitto requests-per-second. I download delle immagini sono legati I/O, quindi i thread danno un grande speedup, ma unbounded concurrency martella il bersaglio e ti bloccano.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
La serratura intornovistorende deduplicazione thread-safe, e avvolgere ogni lavoro in un blocco di prova significa un cattivo URL non fermare l’intera esecuzione. Mantenere il tasso modesto, una manciata di richieste al secondo è un valore di default ragionevole, e leggere ilweb scraping eticoguida per come scegliere i limiti che rispettano il sito.
Come si estraggono le immagini su larga scala con i proxy?
Avete bisogno di proxy una volta che un obiettivo inizia a limitare la velocità o bloccare il vostro IP, che accade rapidamente quando si scaricano molte immagini da un unico indirizzo.proxydizionario ad ogni richiesta in modo che gli stessi percorsi loop di download attraverso la rotazione residenziale IPs. Un flusso costante di richieste di immagini da un singolo IP è un evidente modello automatizzato, e le immagini sono pesanti, quindi la larghezza di banda è di solito il vincolo reale.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
I proxy rotanti diffondono richieste su molti IP così nessun singolo indirizzo attira l’attenzione, mentre sticky session mantengono uno IP per una galleria che un sito lega ad una sessione. DataImpulse fornisceProxy residenzialieProxy mobileper gli obiettivi che esaminano da vicino il traffico, piùProxy datacenterper i download ad alto volume da fonti tolleranti. Tutti gli IP provengono eticamente da utenti che optano e sono compensati. Se le tue credenziali vengono rifiutate con un 407, ilAutenticazione proxyguida copre il formato di accesso esatto.
Poiché ogni byte scaricato conta contro il vostro budget di traffico, programma per le dimensioni prima di iniziare: saltare le immagini sotto una soglia se si desidera solo il contenuto principale, richiedere un più piccolosrcsetvariante quando la risoluzione completa non è necessaria, e cache ciò che hai già così un re-run non refetch tutto. DataImpulse utilizza pay-as-you-go fatturazione da 1 dollaro per GB con traffico non-expiring, quindi un lavoro di immagine pesante ma occasionale non richiede un abbonamento mensile, e traffico inutilizzato porta su.
Come si estrarre gallerie renderizzate con JavaScript?
Se un sito costruisce la sua galleria interamente in JavaScript, l’immagine URL non appare mai in HTML grezzo, quindi rendering la pagina con Playwright prima e alimentare il risultato negli stessi collezionisti. Le richieste da sole non possono eseguire gli script, quindi infinite-scroll e gallerie di una sola pagina hanno bisogno di un vero browser per attivare il caricamento.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Scorrire in un loop costringe un loader pigro a scambiare il suodata-srcsegnaposto per URL reali, dopo di che gli stessi parser che hai già scritto li raccolgono. Per un trattamento più profondo del rendering senza testa, vediestrarre pagine web dinamiche.
Infine, scrivere un manifesto CSV in modo che ogni file scaricato sia rintracciabile alla sua fonte URL, hash, e dimensioni. Un manifesto trasforma una cartella di file anonimi in un set di dati che è possibile controllare, riprendere e deduplicare attraverso le corse.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Con il manifesto sul posto è possibile eseguire nuovamente il lavoro e saltare qualsiasi URL già registrato, che salva la larghezza di banda e mantiene il vostro set di dati coerente nel tempo.
È legale estrarre e riutilizzare le immagini da un sito web?
Il download di un file immagine è un atto tecnico; non ti concede alcuna licenza per riutilizzare quell’immagine. Questa è la singola parte più fraintesa del estraemento dell’immagine, quindi trattala con attenzione. Quasi ogni foto, illustrazione e grafica sul web è protetta dal copyright nel momento in cui viene creata, e la persona che l’ha presa o fatta detiene tali diritti a meno che non li abbia esplicitamente rilasciati.
Essere in grado di recuperare un file non dice nulla sul vostro diritto di ripubblicare, vendere, allenarsi o ridistribuirlo. Prima di riutilizzare immagini estraete, controllare i termini di licenza allegati a loro, cercare una licenza dichiarata come Creative Commons o di dominio pubblico, e ottenere il permesso scritto quando l’uso è commerciale. Raccogliere immagini per l’analisi privata, l’indicizzazione, o la ricerca è una domanda diversa dalla pubblicazione, e il default sicuro è quello di assumere un’immagine èprotetta a meno che una licenza non dica chiaramente il contrario.
Anche rivedere i termini di servizio del sito di destinazione e robots.txt prima di iniziare.controllare se un sito web permette di estrarreguida mostra come leggere quei segnali, e laestrarre senza essere bloccatoNessuna delle tecniche in questo articolo cambia la regola sottostante: l’accesso non è una licenza, e la posizione onesta è che un estraietto di lavoro e un diritto legale di riutilizzo sono due cose separate che devi soddisfare indipendentemente.
Domande frequenti
Posso estrarre immagini da qualsiasi sito web?
Tecnicamente è possibile scaricare file dalla maggior parte dei siti, ma si dovrebbe prima controllare i termini di servizio del sito e robots.txt, e ricordare che il download di un’immagine non dà alcun diritto di riutilizzarlo. L’accesso non è una licenza.
Perché alcune immagini non compaiono nel download HTML?
Queste immagini sono solitamente caricate da JavaScript o loading pigro, in modo che i loro veri URL si siedono in attributi di dati o vengono aggiunti dopo il rendering della pagina. Rendere la pagina con un browser senza testa come Playwright e scorrere per attivare il caricamento, quindi analizzare il risultato.
Come posso scegliere la versione ad alta risoluzione di un’immagine?
Esaminare l’attributo srcset, leggere il descrittore di larghezza dopo ogni URL, e mantenere la URL con la larghezza più grande. Pagine di prodotto spesso elencare un’immagine a piena risoluzione in un blocco JSON-LD pure.
Come posso evitare di scaricare la stessa immagine due volte?
Calcola un hash SHA-256 di ogni file scaricato e salta qualsiasi hash che hai già salvato. Per copie visivamente simili a diverse dimensioni, usa invece una libreria hash percettiva come imagehash.
DataImpulse offre una API gestita per l’estrazione di immagini?
No. DataImpulse fornisce proxy che si instradano il proprio estraetore attraverso; non è un estraemento gestito API o un servizio web-proxy gratuito. Scrivi la logica di download e utilizza i suoi IP per l’accesso e la rotazione.
Quando DataImpulse non è la scelta giusta?
Se avete bisogno di proxy statici ISP, di un estraemento API completamente gestito o di accesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra sulla rotazione residenziale, mobile e datacenter proxy per la raccolta di dati pubblici e l’accesso ai contenuti.
Inizia a estrarre le immagini su larga scala
Quando il estraetore di immagini ha bisogno di un accesso affidabile e di una rotazione IP senza abbonamento, DataImpulse offre un traffico residenziale di origine etica, mobile e datacenter con traffico pay-as-you-go da 1 dollaro per GB.Crea un accounte instradare il vostro ciclo di download attraverso di esso in pochi minuti.