
In this Article
การรู้วิธีตรวจสอบว่าเว็บไซต์อนุญาตให้ทำ web scraping หรือไม่ คือความแตกต่างระหว่างไปป์ไลน์ข้อมูลที่เสถียรกับการถูกแบนบัญชีหรือได้รับข้อร้องเรียนทางกฎหมาย ก่อนเขียน scraper แม้แต่บรรทัดเดียว การตรวจสอบเบื้องต้นของเว็บไซต์อย่างรวดเร็วจะบอกได้ว่าเว็บไซต์อนุญาตอะไร ไม่สนับสนุนอะไร และความเสี่ยงที่แท้จริงอยู่ตรงไหน
บทความนี้จะแนะนำสัญญาณเชิงปฏิบัติที่ควรตรวจสอบ ได้แก่ ไฟล์ robots.txt ข้อกำหนดการให้บริการเกี่ยวกับการเข้าถึงอัตโนมัติ API อย่างเป็นทางการ headers สำหรับจำกัดอัตรา แท็ก meta robots sitemap และความแตกต่างระหว่างข้อมูลสาธารณะกับข้อมูลที่ต้องล็อกอิน ตอนท้ายมีกรอบการตัดสินใจแบบรวดเร็วที่นำไปใช้ซ้ำกับเป้าหมายใดก็ได้
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรม โดยมีที่อยู่ IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการใน 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งาน เริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่มีวันหมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
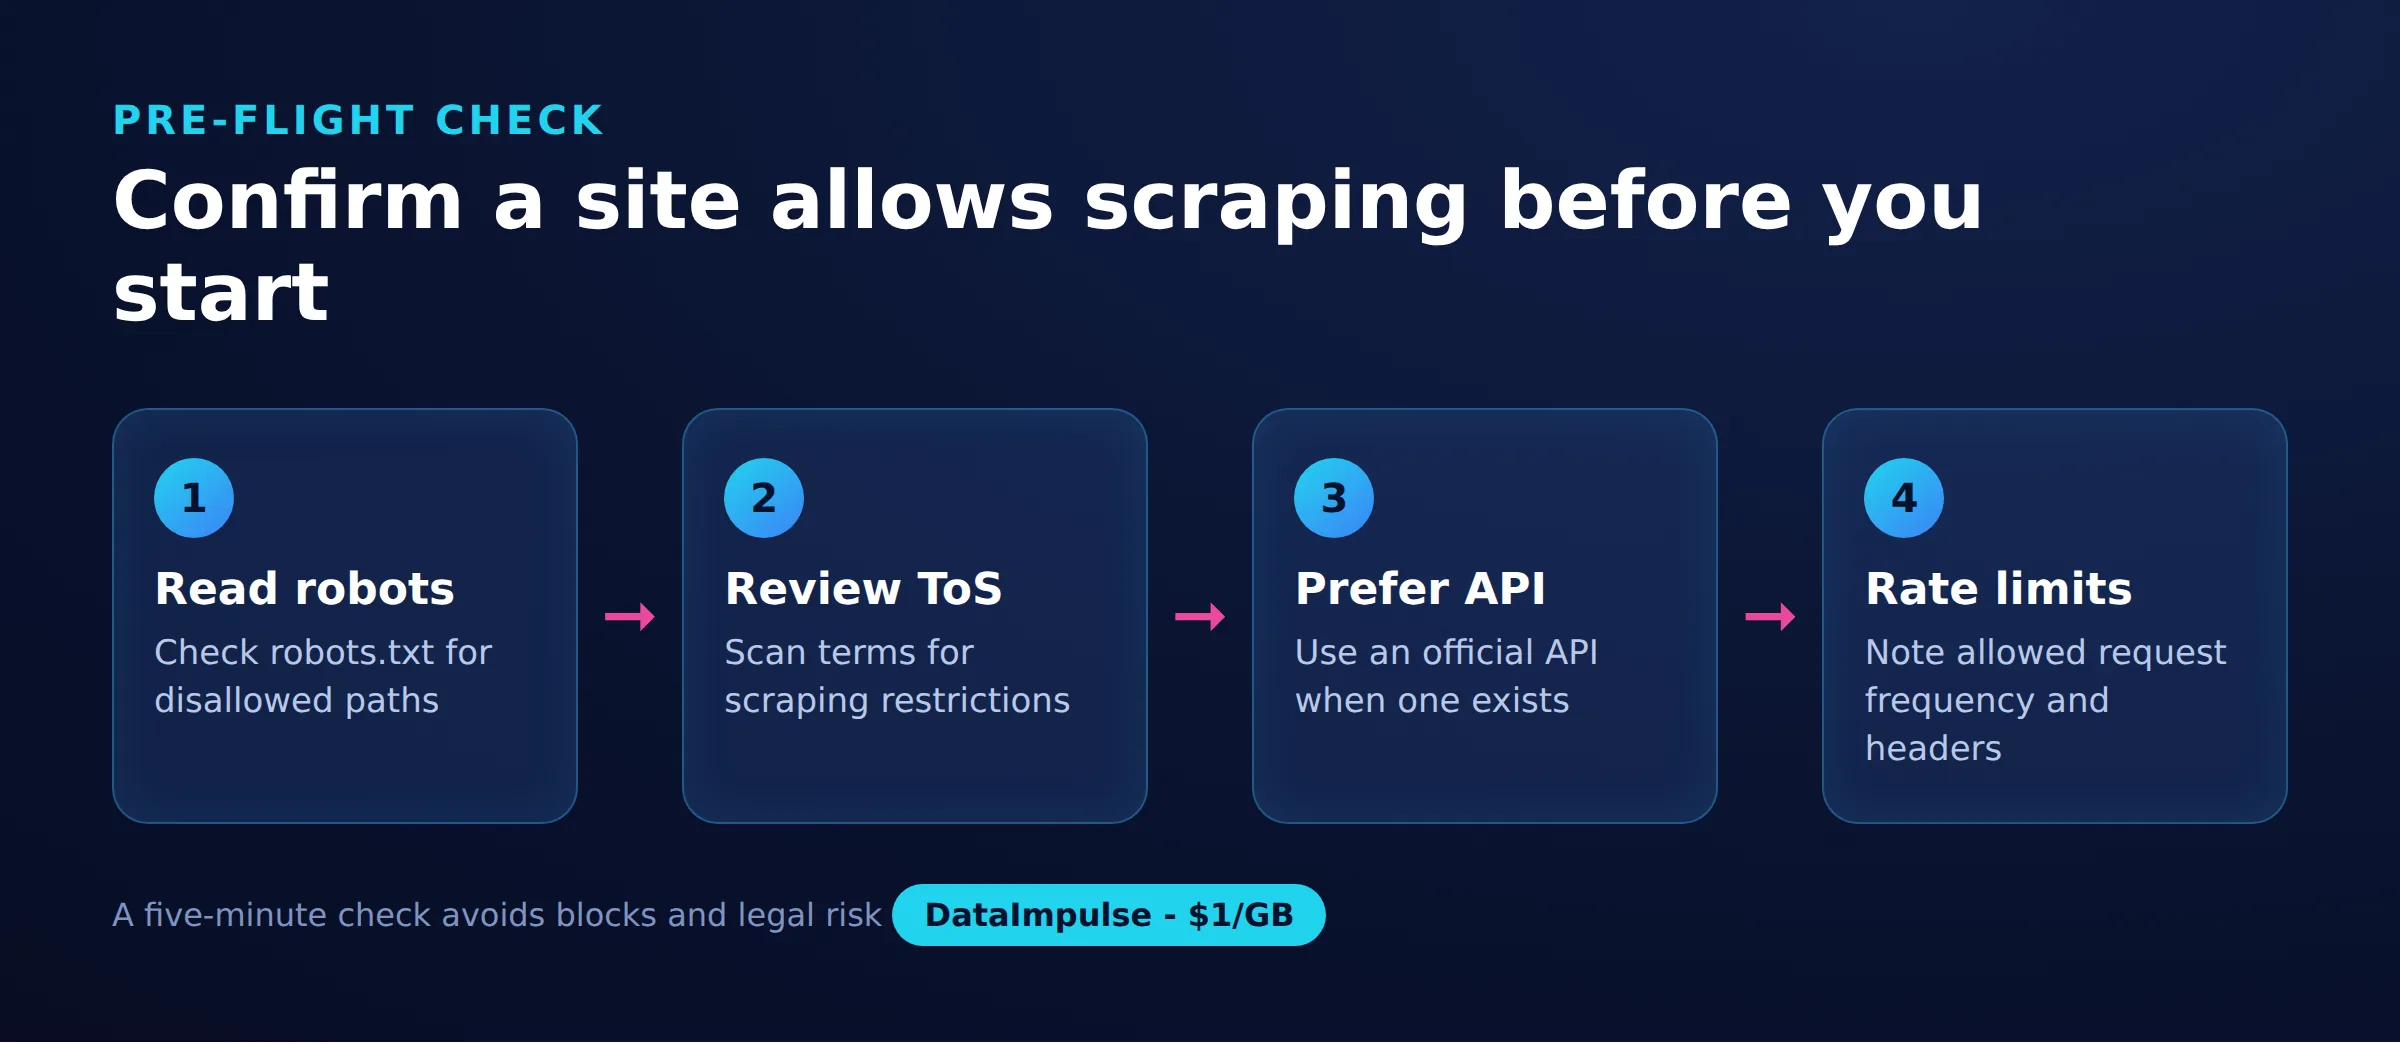
- การตรวจสอบเบื้องต้น: หากต้องการตรวจสอบว่าเว็บไซต์อนุญาตให้ทำ web scraping หรือไม่ ให้อ่าน robots.txt ตรวจสอบข้อกำหนดการให้บริการสำหรับเงื่อนไขการเข้าถึงอัตโนมัติ และมองหา API อย่างเป็นทางการก่อนส่งคำขอใดๆ
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxies ซึ่งใช้ IP ของผู้ใช้จริงที่ผ่านการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน พร้อมทราฟฟิกที่ไม่มีวันหมดอายุและไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่จัดหามาอย่างมีจริยธรรมมากกว่า 90M ใน 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
robots.txt บอกอะไรเกี่ยวกับการทำ web scraping?
ไฟล์ robots.txt คือความต้องการที่เว็บไซต์ระบุไว้เกี่ยวกับวิธีที่ไคลเอนต์อัตโนมัติควรทำงาน โดยเผยแพร่ไว้ที่รากของโดเมน เช่น example.com/robots.txt ไฟล์นี้ระบุเส้นทางที่ crawler อาจหรือไม่อาจส่งคำขอได้ แต่เป็นคำแนะนำ ไม่ใช่กฎหมาย
ไฟล์แบ่งเป็นระเบียน แต่ละระเบียนเริ่มด้วยบรรทัด User-agent ที่ระบุชื่อ bot ที่กฎนั้นใช้กับมัน แล้วตามด้วยกฎ คำสั่งหลักมีดังนี้:
- User-agent: crawler ที่กฎมุ่งเป้าไป เครื่องหมายดอกจันหมายถึง bot ทั้งหมด
- Disallow: คำนำหน้าของเส้นทางที่เว็บไซต์ขอไม่ให้ bot ส่งคำขอ
- Allow: เส้นทางที่อนุญาต มักใช้เพื่อกำหนดข้อยกเว้นจาก Disallow ที่กว้างกว่า
- Crawl-delay: ระยะหยุดรอเป็นวินาทีที่ร้องขอระหว่างคำขอ crawler ไม่ใช่ทุกตัวจะปฏิบัติตาม แต่เป็นสัญญาณของจังหวะที่เว็บไซต์คาดหวัง
- Sitemap: URL แบบสัมบูรณ์ที่ชี้ไปยัง sitemap ของเว็บไซต์ ซึ่งระบุหน้าที่เจ้าของต้องการให้ค้นพบ
ตัวอย่างขนาดเล็กมีดังนี้:
User-agent: *
Disallow: /private/
Allow: /private/public-page.html
Crawl-delay: 10

Sitemap: https://example.com/sitemap.xml
ให้อ่านว่า bot ทั้งหมดถูกขอให้หลีกเลี่ยง /private/ ยกเว้นหนึ่งหน้า ให้รอสิบวินาทีระหว่างคำขอ และใช้ sitemap ที่ระบุ เนื่องจาก robots.txt เป็นข้อตกลงร่วมและไม่ใช่การบล็อกทางเทคนิค จึงควรถือว่าเป็นความประสงค์ที่เจ้าของระบุไว้อย่างชัดเจน การเพิกเฉยต่อ Disallow ไม่ได้เป็นการทำลายรหัสผ่าน แต่หมายถึงการกระทำที่ขัดต่อคำขออย่างชัดแจ้ง ซึ่งสำคัญต่อชื่อเสียงและข้อพิพาทในภายหลัง
จะพบเงื่อนไขการเข้าถึงอัตโนมัติในข้อกำหนดการให้บริการได้ที่ไหน?
ให้ดูที่ข้อกำหนดการให้บริการ ข้อกำหนดการใช้งาน หรือนโยบายการใช้งานที่ยอมรับได้ ซึ่งโดยทั่วไปมีลิงก์อยู่ในส่วนท้ายของเว็บไซต์ เอกสารเหล่านี้ ไม่ใช่ robots.txt คือที่ที่เว็บไซต์กำหนดกฎที่มีผลผูกพันเกี่ยวกับ scraping, crawling และ bot
ค้นหาคำอย่าง scrape, crawl, robot, spider, automated, harvest, data mining และ bulk บางเว็บไซต์ห้ามการเก็บรวบรวมอัตโนมัติทุกประเภทโดยเด็ดขาด บางเว็บไซต์อนุญาตเฉพาะการใช้งานส่วนบุคคลหรือไม่ใช่เชิงพาณิชย์ และบางเว็บไซต์อนุญาตผ่านช่องทางที่ได้รับอนุมัติ เช่น API ข้อกำหนดมักมีน้ำหนักมากกว่า robots.txt เพราะผู้ใช้อาจถูกถือว่ายอมรับข้อกำหนดเหล่านั้นแล้ว จึงควรอ่านข้อความเกี่ยวกับการเข้าถึงอัตโนมัติอย่างละเอียดก่อนเริ่มสร้าง หากกำลังพิจารณาภาพกฎหมายที่กว้างขึ้น คู่มือของเราเรื่อง web scraping ถูกกฎหมายหรือไม่ อธิบายว่าข้อกำหนดเหล่านี้เกี่ยวข้องกับกฎการคุ้มครองข้อมูลและการเข้าถึงอย่างไร
ควรมองหา API อย่างเป็นทางการก่อนหรือไม่?
ควร ก่อนทำ scraping HTML ให้ตรวจสอบว่าเว็บไซต์มี API อย่างเป็นทางการหรือไม่ เพราะ API ที่ได้รับอนุมัติมักเป็นวิธีรับข้อมูลเดียวกันที่เสถียรกว่า ได้รับอนุญาตมากกว่า และดูแลรักษาได้ง่ายกว่า หลายแพลตฟอร์มเผยแพร่ API ไว้ในโดเมนย่อยสำหรับนักพัฒนาหรือ API หรือลิงก์จากเอกสารประกอบ
API ให้ผลลัพธ์ที่มีโครงสร้าง ขีดจำกัดอัตราที่มีเอกสารกำกับ และข้อกำหนดที่เขียนขึ้นเฉพาะสำหรับการใช้งานแบบเป็นโปรแกรม จึงลดการคาดเดาจากการทำ scraping หน้าที่อาจเปลี่ยนเลย์เอาต์ได้ตลอดเวลา ข้อแลกเปลี่ยนคือ API อาจต้องใช้คีย์ จำกัดปริมาณ หรือไม่เปิดเผยทุกฟิลด์บนหน้า ถึงอย่างนั้น หาก API ครอบคลุมความต้องการ ก็ควรใช้ก่อน และให้ scraping เว็บไซต์ที่แสดงผลแล้วเป็นทางเลือกสำรองแทนที่จะเป็นค่าเริ่มต้น
จะอ่านขีดจำกัดอัตราและการตอบกลับ 429 ได้อย่างไร?
ขีดจำกัดอัตราบอกว่าเว็บไซต์ยินดีให้บริการคำขออัตโนมัติได้เร็วเพียงใด และสัญญาณที่ชัดเจนที่สุดคือการตอบกลับ HTTP 429 Too Many Requests เมื่อพบการตอบกลับนี้ เซิร์ฟเวอร์กำลังขอให้ชะลอความเร็ว
ให้สังเกตสัญญาณเหล่านี้ใน responses:
- สถานะ 429: เกินกว่าที่เซิร์ฟเวอร์อนุญาตในขณะนี้
- Retry-After: header ที่บอกเป็นวินาทีหรือวันที่ว่าควรรอนานเท่าใดก่อนลองอีกครั้ง ควรปฏิบัติตาม
- headers สำหรับขีดจำกัดอัตรา: ฟิลด์อย่าง X-RateLimit-Limit และ X-RateLimit-Remaining ที่แสดงโควตาและจำนวนที่เหลือ
การเคารพสัญญาณเหล่านี้ช่วยให้การเข้าถึงดำเนินไปได้อย่างยั่งยืนและลดภาระของเป้าหมาย การกระจายคำขอไปตาม sessions หรือ IP ด้วย residential proxies สามารถช่วยให้อยู่ในอัตราต่อที่อยู่ที่สุภาพได้ แต่ไม่ได้ลบล้างขีดจำกัดที่เว็บไซต์ระบุหรือข้อกำหนดของเว็บไซต์ เป้าหมายคือปรับให้ตรงกับจังหวะที่เซิร์ฟเวอร์ส่งสัญญาณ ไม่ใช่เอาชนะมัน สำหรับเทคนิคที่กว้างขึ้น โปรดดูคู่มือ ทำ scraping โดยไม่ถูกบล็อก
แท็ก meta robots และ sitemap.xml ส่งสัญญาณอะไร?
แท็ก meta robots ควบคุมการจัดทำดัชนีการค้นหา ขณะที่ sitemap.xml แสดง URL ที่เว็บไซต์ต้องการให้ค้นพบ ไม่มีสิ่งใดให้หรือปฏิเสธสิทธิ์การทำ scraping แต่ทั้งคู่เป็นสัญญาณที่มีประโยชน์หากอ่านอย่างถูกต้อง
แท็ก meta robots เช่น noindex ซึ่งเขียนไว้ในส่วน head ของหน้าหรือส่งเป็น header X-Robots-Tag จะบอก crawler สำหรับการค้นหา เช่น Googlebot ว่าควรทำดัชนีหน้าเว็บหรือติดตามลิงก์หรือไม่ ค่า noindex ขอให้ search engines ไม่แสดงหน้านั้นในผลลัพธ์ นี่คือข้อความเกี่ยวกับการมองเห็นในการค้นหา ไม่ใช่การตั้งค่าสิทธิ์สำหรับการเก็บข้อมูล ดังนั้นการอ่านให้เป็นไฟเขียวหรือคำสั่งห้ามสำหรับ scraping จึงเป็นข้อผิดพลาดที่พบบ่อย
sitemap.xml ซึ่งมักมีลิงก์จาก robots.txt หรือพบได้ที่ example.com/sitemap.xml คือรายการหน้าของเจ้าของเว็บไซต์ที่เห็นว่าควรนำเสนอ บางครั้งแบ่งเป็นดัชนีของหลายไฟล์ การใช้มันเพื่อค้นหา URL สาธารณะที่เป็นต้นฉบับนั้นมีประสิทธิภาพและคำนึงถึงเจ้าของ เพราะเป็นการส่งคำขอไปยังหน้าที่เจ้าของเลือกเปิดเผยไว้แล้วแทนการเดาเส้นทาง มันเป็นแผนที่ที่มีประโยชน์ ไม่ใช่คำเชิญแบบครอบจักรวาล และข้อกำหนดการให้บริการยังคงกำกับสิ่งที่ทำได้กับเนื้อหาเมื่อดึงมาแล้ว
เหตุใดข้อมูลที่ต้องล็อกอินจึงมีความเสี่ยงสูงกว่าข้อมูลสาธารณะ?
ข้อมูลสาธารณะที่ทุกคนเข้าถึงได้โดยไม่ต้องลงชื่อเข้าใช้มีความเสี่ยงต่ำกว่าข้อมูลหลังการล็อกอิน ซึ่งอยู่ภายใต้ข้อกำหนดบัญชีที่ยอมรับตอนลงทะเบียน การข้ามเส้นนั้นเปลี่ยนสถานการณ์ไปอย่างมาก
เมื่อหน้าต้องมีการยืนยันตัวตน แสดงว่ายอมรับข้อกำหนดของแพลตฟอร์มเพื่อเข้าใช้ และข้อกำหนดเหล่านั้นมักจำกัดการเก็บรวบรวมอัตโนมัติอย่างเข้มงวดกว่าหน้าสาธารณะ การทำ scraping หลังการล็อกอินอาจละเมิดกฎเกี่ยวกับบัญชีและการหลีกเลี่ยงมาตรการ และทำให้บัญชีเสี่ยงต่อการถูกระงับ ตามหลักทั่วไป ให้เลือกใช้ข้อมูลที่เข้าถึงได้อย่างเปิดเผยโดยไม่มีข้อมูลรับรอง และถือว่าการเก็บรวบรวมข้อมูลที่ต้องล็อกอินเป็นการตัดสินใจที่ต้องมีการอนุญาตอย่างชัดแจ้งหรือ API ที่ได้รับอนุมัติ DataImpulse มี ethical proxies สำหรับการเข้าถึงข้อมูลเว็บสาธารณะอย่างเหมาะสม ไม่ใช่วิธีข้ามการยืนยันตัวตน
กรอบการตัดสินใจอย่างรวดเร็วสำหรับการทำ scraping เว็บไซต์คืออะไร?
ฉบับย่อคือ รวบรวมสัญญาณแล้วจึงตัดสินใจ ใช้รายการตรวจสอบนี้ก่อนตัดสินใจเลือกเป้าหมาย
- อ่าน robots.txt: จดเส้นทาง Disallow, Crawl-delay และ sitemap เคารพความต้องการที่ระบุไว้
- ตรวจสอบข้อกำหนดการให้บริการ: ค้นหาเงื่อนไขการเข้าถึงอัตโนมัติ และดูว่า scraping ถูกห้าม ถูกจำกัด หรือชี้ไปยัง API หรือไม่
- มองหา API: หาก API อย่างเป็นทางการครอบคลุมความต้องการ ให้เลือกใช้
- ประเมินข้อมูล: เป็นข้อมูลสาธารณะหรือต้องล็อกอิน? ข้อมูลสาธารณะมีความเสี่ยงต่ำกว่า ส่วนข้อมูลที่ต้องล็อกอินต้องมีการอนุญาต
- วางแผนเรื่องขีดจำกัดอัตรา: เคารพ 429 และ Retry-After และกำหนดจังหวะคำขอให้ตรงกับที่เซิร์ฟเวอร์ส่งสัญญาณ
หากข้อกำหนดห้ามไว้ หรือข้อมูลถูกล็อกไว้หลังการล็อกอินโดยไม่มีการอนุญาต ให้หยุดหรือขอใช้ API หากข้อมูลเป็นสาธารณะ ข้อกำหนดไม่ระบุหรืออนุญาต และสามารถ crawl อย่างสุภาพภายในขีดจำกัดของเว็บไซต์ได้ ก็จะมีฐานที่มั่นคงกว่ามาก การจัดหา IP อย่างรับผิดชอบก็สำคัญเช่นกัน จึงเป็นเหตุที่ DataImpulse มุ่งเน้นที่อยู่ที่ได้มาอย่างมีจริยธรรมสำหรับการเก็บรวบรวมข้อมูลสาธารณะที่สอดคล้องตามข้อกำหนด
สัญญาณที่ควรตรวจสอบก่อนทำ scraping
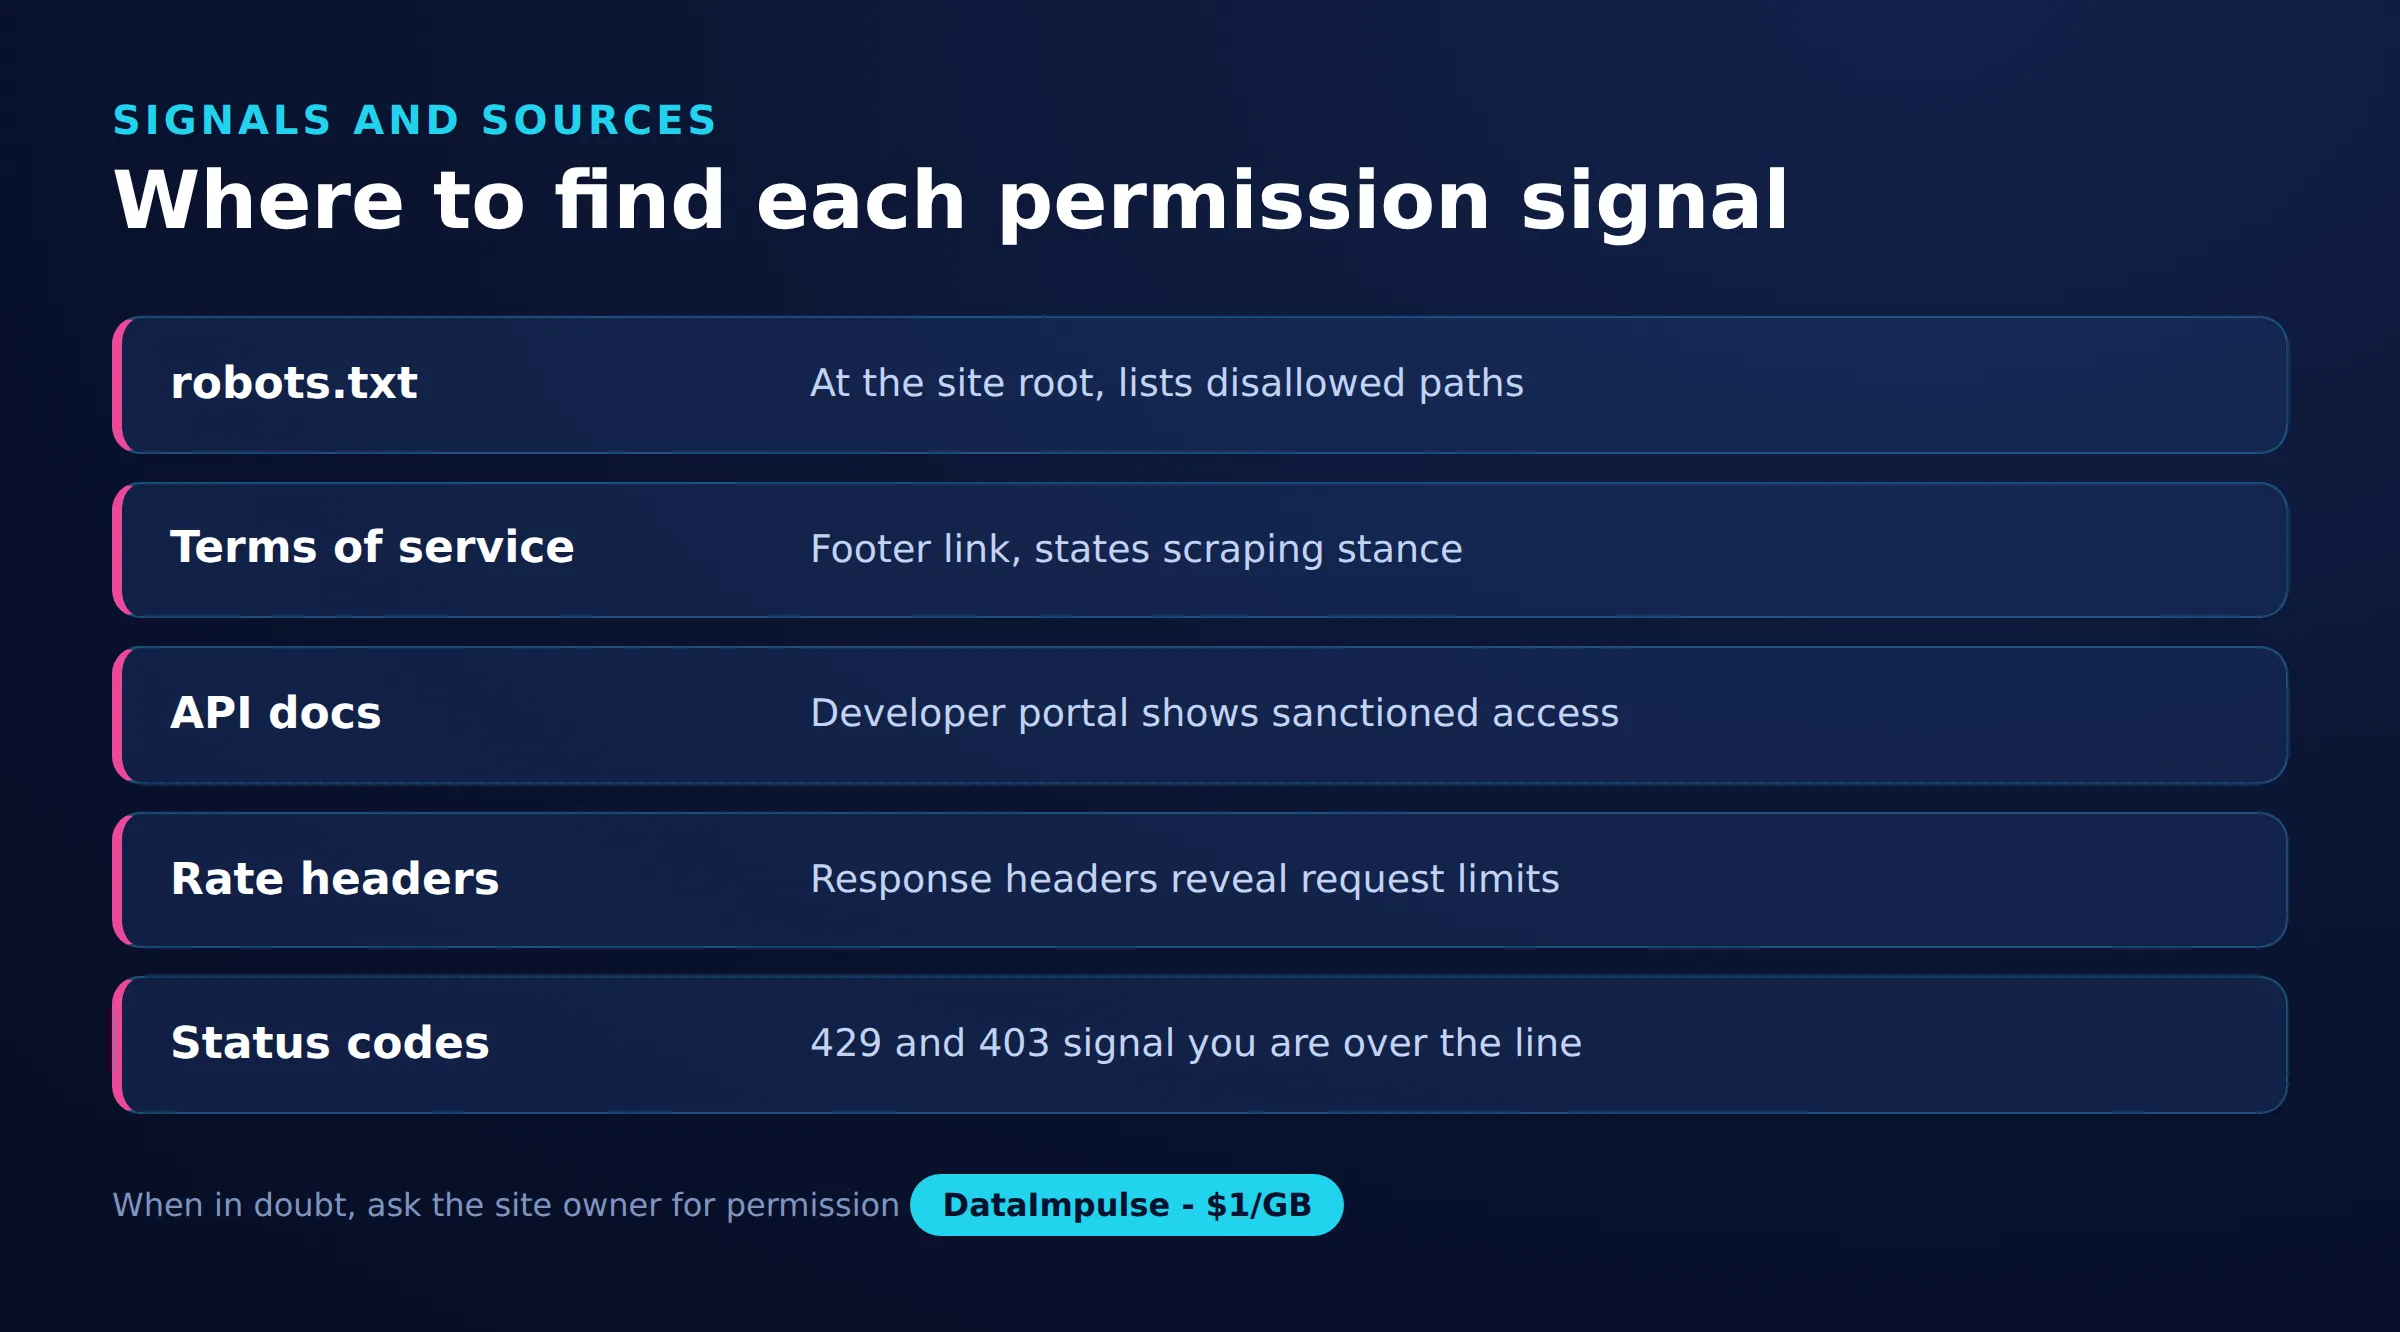
| สัญญาณ | จุดที่พบ | สิ่งที่บอก |
|---|---|---|
| robots.txt | เส้นทางรากของเว็บไซต์ | เส้นทางที่อนุญาตและถูกบล็อก |
| ข้อกำหนดการให้บริการ | หน้ากฎหมายส่วนท้าย | กฎ scraping ที่ระบุไว้ |
| API อย่างเป็นทางการ | เอกสารสำหรับนักพัฒนา | การเข้าถึงข้อมูลที่ได้รับอนุมัติ |
| headers สำหรับขีดจำกัดอัตรา | การตอบกลับ HTTP | ขีดจำกัดคำขอที่อนุญาต |
| sitemap.xml | เส้นทางรากของเว็บไซต์ | รายการหน้าที่ crawl ได้ |
คำถามที่พบบ่อย
robots.txt ห้ามทำ scraping เว็บไซต์ตามกฎหมายหรือไม่?
ไม่ robots.txt เป็นข้อตกลงเชิงแนะนำที่ระบุความต้องการของเจ้าของเว็บไซต์สำหรับไคลเอนต์อัตโนมัติ ไม่ใช่การบล็อกทางเทคนิคหรือกฎหมาย แต่การเพิกเฉยหมายถึงการกระทำที่ขัดต่อคำขออย่างชัดแจ้ง ซึ่งอาจมีความสำคัญต่อข้อพิพาทและชื่อเสียง
การตรวจสอบข้อกำหนดการให้บริการของเว็บไซต์เพียงอย่างเดียวเพียงพอหรือไม่?
เป็นแหล่งข้อมูลเดี่ยวที่สำคัญที่สุด แต่ไม่ใช่แหล่งเดียว ควรใช้ข้อกำหนดการให้บริการร่วมกับ robots.txt การมี API อย่างเป็นทางการ และการตรวจสอบว่าข้อมูลเป็นสาธารณะหรือต้องล็อกอิน เพื่อให้เห็นภาพครบถ้วนก่อนทำ scraping
การตอบกลับ HTTP 429 หมายความว่าอะไรเมื่อทำ scraping?
การตอบกลับ 429 Too Many Requests หมายความว่าเกินอัตราที่เซิร์ฟเวอร์อนุญาตในขณะนี้และควรชะลอความเร็ว ตรวจสอบ header Retry-After เพื่อดูว่าควรรอนานเท่าใด และกำหนดจังหวะคำขอในอนาคตให้ตรงกับขีดจำกัดของเซิร์ฟเวอร์
สามารถทำ scraping ข้อมูลที่อยู่หลังการล็อกอินได้หรือไม่?
ข้อมูลที่ต้องล็อกอินมีความเสี่ยงสูงกว่า เพราะยอมรับข้อกำหนดของแพลตฟอร์มเมื่อลงทะเบียน และข้อกำหนดเหล่านั้นมักจำกัดการเก็บรวบรวมอัตโนมัติ ควรถือว่าเป็นสิ่งที่ต้องมีการอนุญาตอย่างชัดแจ้งหรือ API ที่ได้รับอนุมัติ แทนที่จะเป็นเป้าหมายเริ่มต้น
แท็ก meta noindex หมายความว่าหน้าเว็บไม่สามารถทำ scraping ได้หรือไม่?
ไม่ แท็ก noindex บอก search engines ไม่ให้ทำดัชนีหน้าในผลลัพธ์ แท็กนี้ควบคุมการมองเห็นในการค้นหา ไม่ใช่สิทธิ์การทำ scraping ดังนั้นให้ใช้ robots.txt และข้อกำหนดการให้บริการเพื่อตัดสินว่าการเก็บรวบรวมเหมาะสมหรือไม่
เมื่อใด DataImpulse จึงไม่เหมาะสม?
หากต้องการ ISP proxies แบบคงที่ API สำหรับ scraping ที่จัดการให้อย่างเต็มรูปแบบ หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น rotating residential, mobile และ datacenter proxies สำหรับการเก็บข้อมูลสาธารณะและการเข้าถึงเนื้อหา
เก็บรวบรวมข้อมูลเว็บสาธารณะอย่างรับผิดชอบ
เมื่อได้ตรวจสอบ robots.txt ข้อกำหนดการให้บริการ และยืนยันว่าข้อมูลเป็นสาธารณะแล้ว DataImpulse มี IP ที่จัดหามาอย่างมีจริยธรรมใน 195 ประเทศสำหรับการเก็บรวบรวมที่สอดคล้องตามข้อกำหนด สร้างบัญชี และเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่มีวันหมดอายุ