
In this Article
การทำ web scraping อย่างมีจริยธรรม คือการเก็บรวบรวมข้อมูลจากเว็บไซต์โดยเคารพเซิร์ฟเวอร์เป้าหมาย กฎหมายที่ใช้บังคับ และบุคคลที่ข้อมูลของพวกเขาอาจปรากฏอยู่ในข้อมูลนั้น เมื่อทำอย่างเหมาะสม web scraping อย่างมีจริยธรรมช่วยให้ทีมรวบรวมข้อมูลสาธารณะเพื่อการวิจัย การกำหนดราคา และการติดตาม โดยไม่สร้างความเสียหายให้กับเว็บไซต์ที่พวกเขาพึ่งพา
บทความนี้ครอบคลุมหลักการทำงานที่แยกการเก็บข้อมูลอย่างรับผิดชอบออกจากการทำ scraping อย่างไม่ยั้งคิด: ข้อมูลใดที่เก็บได้อย่างเหมาะสม วิธีอ่านสัญญาณอย่าง robots.txt และข้อกำหนดการให้บริการ วิธีจำกัดภาระของเซิร์ฟเวอร์ วิธีจัดการข้อมูลส่วนบุคคล และเหตุใดแหล่งที่มาของเครือข่าย proxy จึงสำคัญ
DataImpulse คือผู้ให้บริการ proxy อย่างมีจริยธรรม ซึ่งมี IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ และถูกใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- หลักการสำคัญ: web scraping อย่างมีจริยธรรมหมายถึงการเก็บเฉพาะข้อมูลที่เปิดเผยต่อสาธารณะในอัตราที่ไม่ทำอันตรายต่อเซิร์ฟเวอร์เป้าหมาย พร้อมเคารพกฎหมายความเป็นส่วนตัวและข้อกำหนดของเว็บไซต์
- ประเภท proxy ที่เหมาะที่สุด: residential proxies แบบหมุนเวียน ซึ่งใช้ IP ของผู้บริโภคจริงที่หลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน มีทราฟฟิกไม่หมดอายุ และไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่ได้มาอย่างมีจริยธรรมมากกว่า 90M+ ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
อะไรทำให้ web scraping มีจริยธรรม?
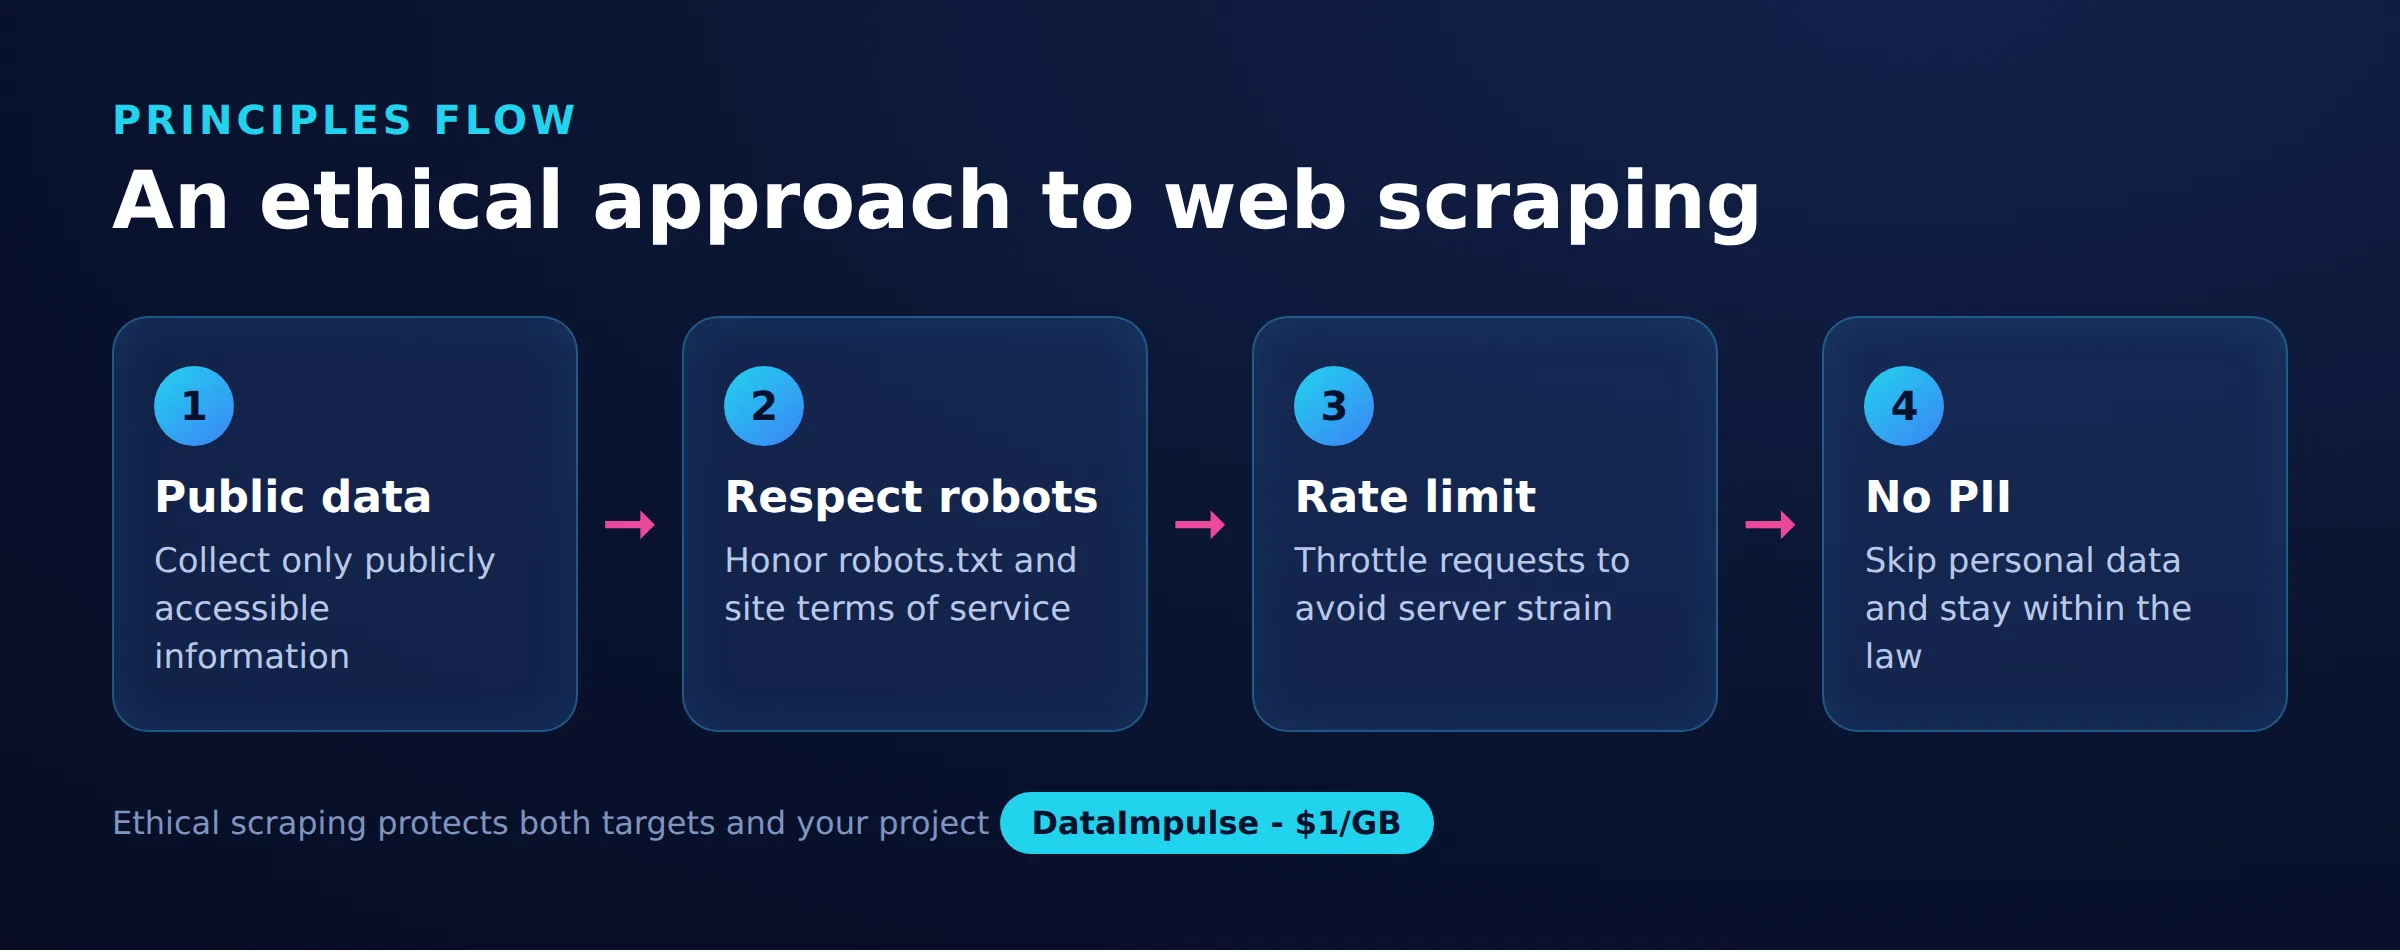
Web scraping มีจริยธรรมเมื่อเก็บเฉพาะข้อมูลสาธารณะ เคารพขีดความสามารถของเซิร์ฟเวอร์เป้าหมาย และหลีกเลี่ยงการทำอันตรายต่อผู้คนหรือธุรกิจเบื้องหลังเว็บไซต์ ความแตกต่างไม่ได้อยู่ที่เครื่องมือมากนัก แต่อยู่ที่เจตนา เป้าหมาย และผลกระทบ
หน้าที่ทุกคนดูได้โดยไม่ต้องเข้าสู่ระบบอยู่ในกลุ่มความเสี่ยงต่ำ ส่วนเนื้อหาที่อยู่หลังการยืนยันตัวตน paywall หรือการควบคุมการเข้าถึงอย่างชัดเจนนั้นเป็นอีกเรื่องหนึ่ง เพราะการเข้าถึงมักหมายถึงการยอมรับข้อกำหนดก่อน การทดสอบที่มีประโยชน์คือหากเจ้าของเว็บไซต์เห็นว่าคุณกำลังเก็บข้อมูลอยู่ คุณจะรู้สึกอับอายหรือไม่ การยึดข้อมูลที่ผู้เข้าชมทั่วไปมองเห็นได้ และใช้หลักลดข้อมูลให้เหลือเฉพาะฟิลด์ที่จำเป็นจริง เป็นรากฐานของทุกสิ่งที่ตามมา
- เก็บข้อมูลที่เป็นสาธารณะและไม่อ่อนไหว
- เก็บไม่เกินกว่าที่จำเป็นสำหรับวัตถุประสงค์ที่ชัดเจน
- หลีกเลี่ยงการทำให้บริการแย่ลงสำหรับผู้ใช้จริง
ควรจัดการ robots.txt และข้อกำหนดการให้บริการอย่างไร?
อ่านทั้งสองอย่าง และมองว่าเป็นสัญญาณที่มีความหมายแทนที่จะละเลย ไฟล์ robots.txt เป็นมาตรฐานเชิงแนะนำที่บอกไคลเอนต์อัตโนมัติว่าเส้นทางใดที่เว็บไซต์ต้องการให้หลีกเลี่ยง ส่วนข้อกำหนดการให้บริการ (ToS) คือสัญญาที่การบังคับใช้แตกต่างกันไปตามเขตอำนาจศาลและสถานการณ์
ทั้งสองอย่างไม่ใช่สวิตช์เปิดปิดอย่างง่าย robots.txt เป็นเพียงคำแนะนำ: ไม่ใช่การล็อกทางเทคนิค และไม่ใช่กฎหมายในตัวเอง แต่การไม่สนใจแสดงว่าคุณยินดีเพิกเฉยต่อความต้องการที่เจ้าของเว็บไซต์ระบุไว้ ข้อกำหนดการให้บริการอาจมีน้ำหนักจริง แต่จะผูกพันเพียงใดขึ้นอยู่กับวิธีที่นำเสนอและสถานที่ที่พิจารณาข้อพิพาท นี่ไม่ใช่คำแนะนำทางกฎหมาย และคำตอบที่ตรงไปตรงมาคือกฎเหล่านี้มีรายละเอียดซับซ้อนและขึ้นอยู่กับเขตอำนาจศาล สำหรับคำอธิบายด้านกฎหมายอย่างละเอียดเพิ่มเติม โปรดดูคู่มือของเราเกี่ยวกับ web scraping ถูกกฎหมายหรือไม่ หากไม่แน่ใจ โปรดปรึกษาทนายความที่มีคุณสมบัติเหมาะสมสำหรับกรณีเฉพาะของคุณ
ตัวอย่าง robots.txt ขั้นต่ำอาจมีลักษณะดังนี้:
User-agent: *
Disallow: /private/
Crawl-delay: 10
ในที่นี้ เว็บไซต์ขอให้ไคลเอนต์อัตโนมัติทุกตัวหลีกเลี่ยงเส้นทาง /private/ และรอ 10 วินาทีระหว่างคำขอ การปฏิบัติตามทั้งเส้นทางที่ห้ามและ crawl delay คือมาตรฐานพื้นฐานของพฤติกรรมที่ดี
หลีกเลี่ยงการทำให้เซิร์ฟเวอร์ทำงานหนักเกินไปได้อย่างไร?
จำกัดอัตราคำขอและการเชื่อมต่อพร้อมกัน เพื่อให้ทราฟฟิกของคุณเป็นเพียงสัดส่วนเล็กน้อยของภาระปกติของเว็บไซต์ การทำ scraping อย่างหนักอาจทำให้เว็บไซต์ช้าลงสำหรับผู้ใช้จริง หรือในกรณีรุนแรงอาจมีลักษณะคล้ายรูปแบบการปฏิเสธการให้บริการ
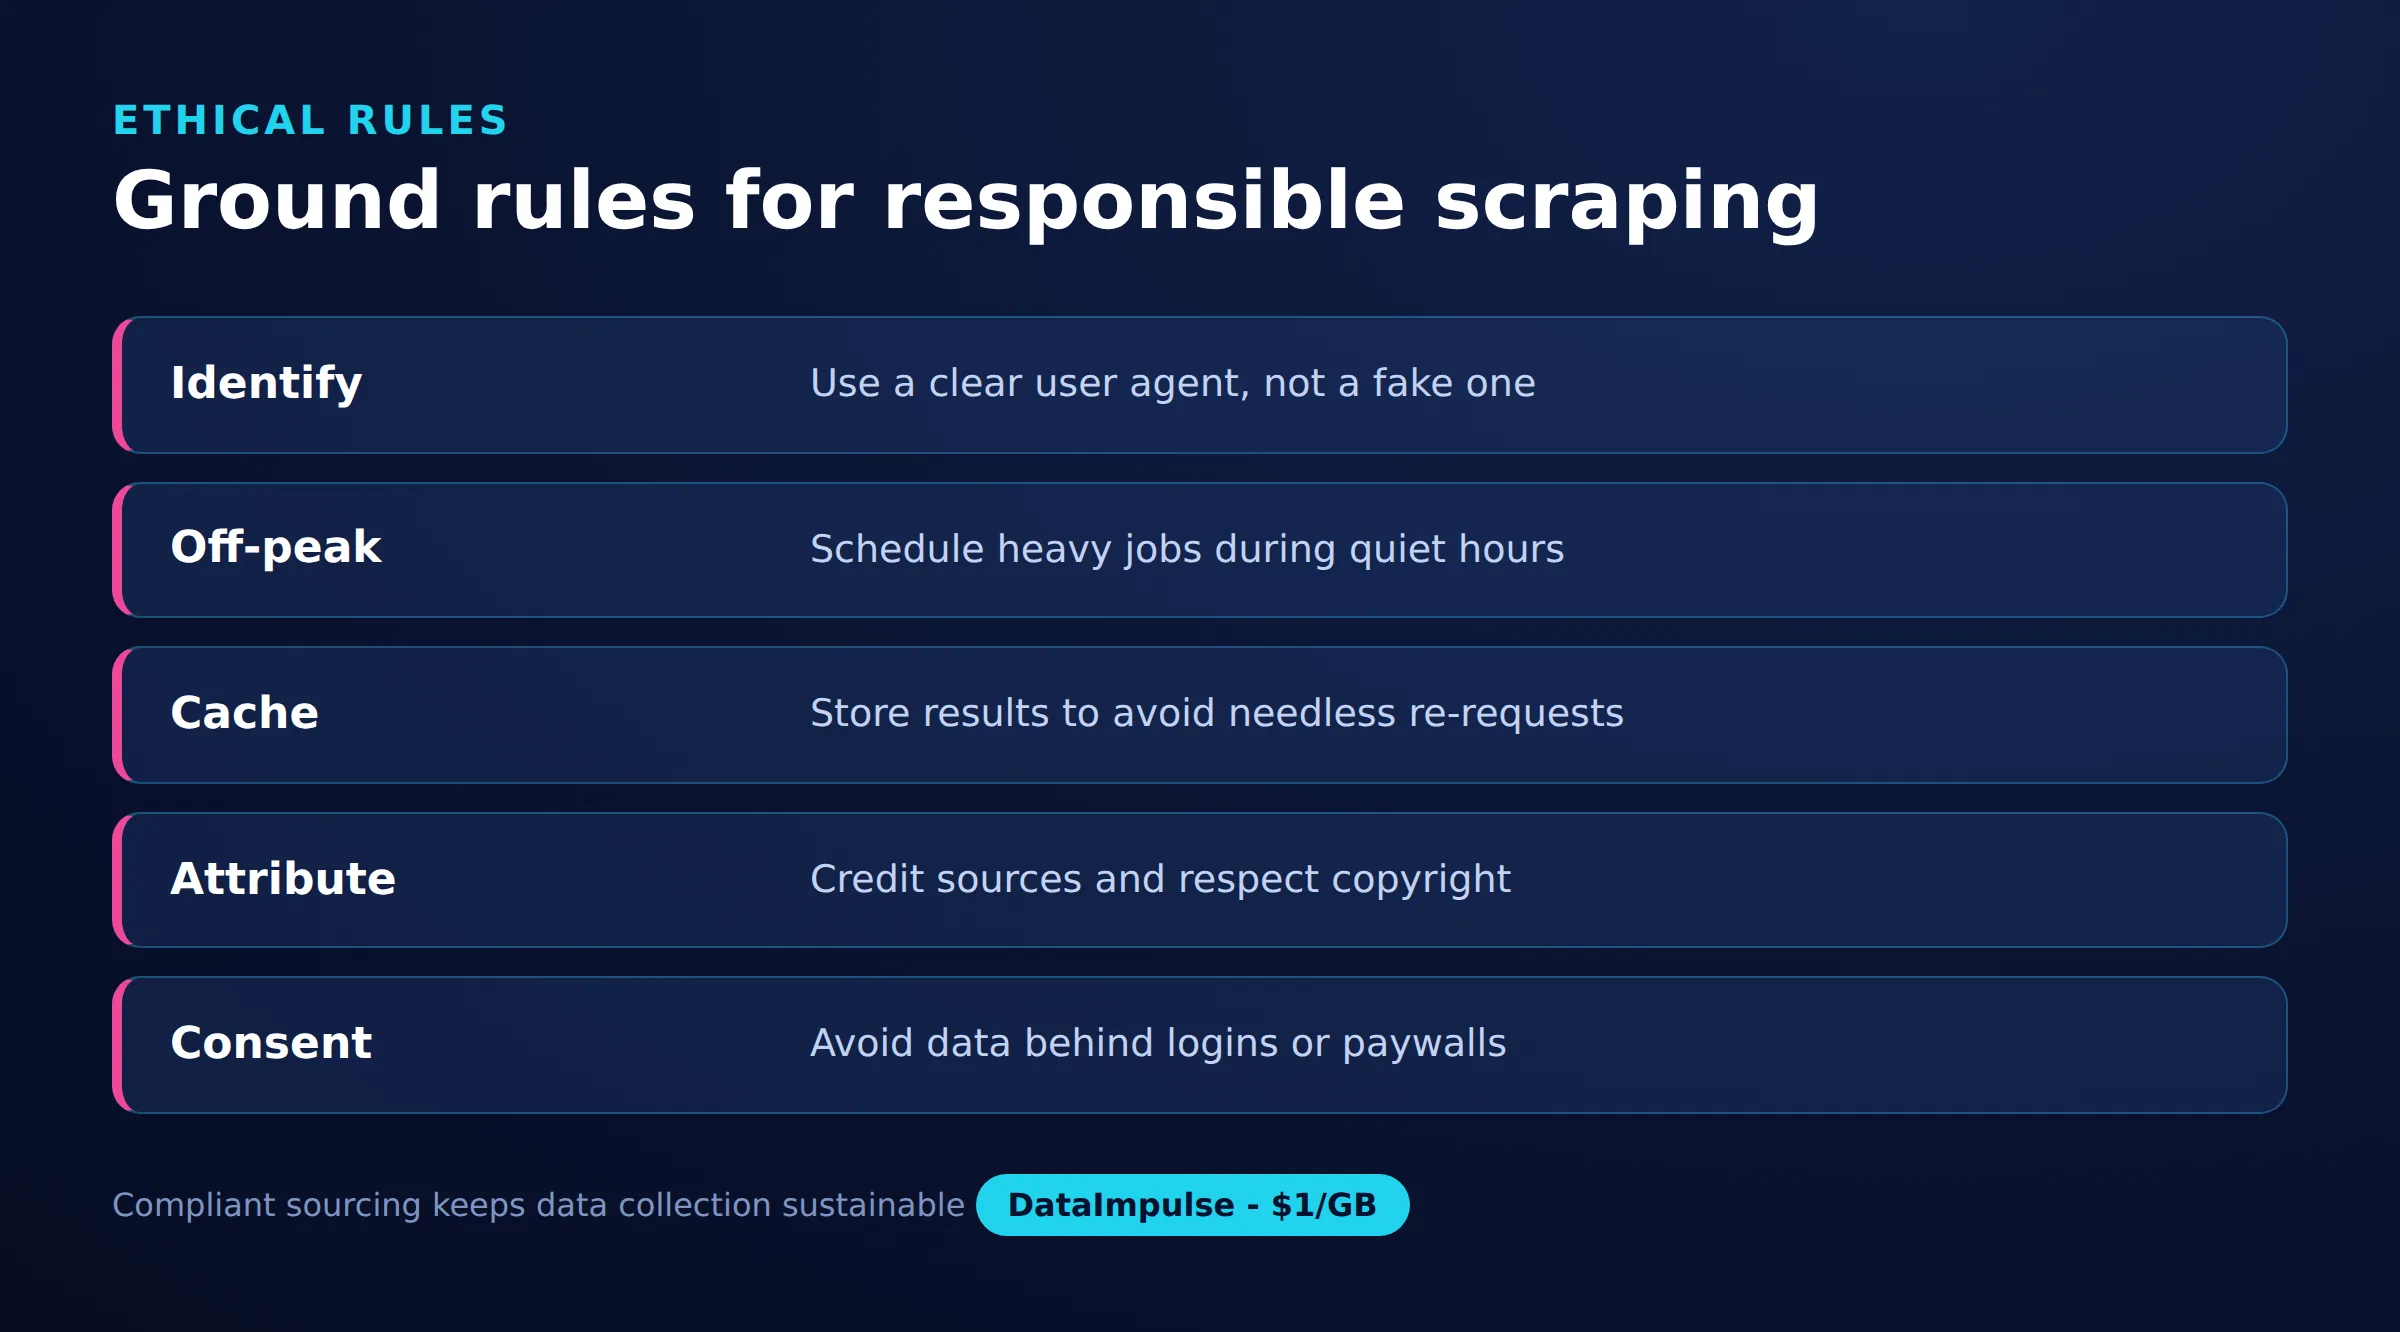
เคารพ crawl-delay ที่ระบุใน robots.txt เพิ่มช่วงพักระหว่างคำขอ และกำหนดเพดานจำนวนการเชื่อมต่อที่เปิดพร้อมกัน การทำ scraping ในช่วงเวลานอกพีกของเป้าหมายยังช่วยลดผลกระทบได้ การแคชหน้าที่ดึงมาแล้วช่วยเลี่ยงการเข้าซ้ำเพื่อข้อมูลเดิม และการหยุดหรือลดความถี่เมื่อพบข้อผิดพลาดหรือการตอบกลับจำกัดอัตรา แสดงว่าคุณตอบสนองต่อเซิร์ฟเวอร์แทนที่จะฝืนทำต่อ การกระจายคำขอผ่านกลุ่ม residential proxies อาจช่วยกระจายภาระและหลีกเลี่ยงการส่งคำขอถี่เกินไปจากที่อยู่เดียว แต่เป็นเหตุผลให้กำหนดจังหวะอย่างรอบคอบ ไม่ใช่อนุญาตให้ส่งมากขึ้น สำหรับเทคนิคที่ช่วยลดทั้งการบล็อกและภาระ โปรดดูคู่มือของเราเกี่ยวกับ การทำ scraping โดยไม่ถูกบล็อก
ควรจัดการข้อมูลส่วนบุคคลและกฎหมายความเป็นส่วนตัวอย่างไร?
หลีกเลี่ยงการเก็บข้อมูลส่วนบุคคล เว้นแต่คุณมีฐานทางกฎหมายและความจำเป็นที่แท้จริง เพราะกฎระเบียบด้านความเป็นส่วนตัวใช้กับข้อมูลที่ได้จาก scraping เช่นเดียวกับข้อมูลอื่น กฎหมายอย่าง GDPR ใน EU และ CCPA ในแคลิฟอร์เนียกำกับวิธีเก็บ จัดเก็บ และใช้ข้อมูลส่วนบุคคล ไม่ว่าข้อมูลนั้นจะเป็นข้อมูลสาธารณะหรือไม่
ข้อมูลที่ระบุตัวบุคคลได้ (PII) รวมถึงชื่อ อีเมล หมายเลขโทรศัพท์ และทุกสิ่งที่ระบุตัวบุคคลได้ ข้อเท็จจริงที่ว่าข้อมูลดังกล่าวอยู่บนหน้าสาธารณะไม่ได้หมายความว่าเก็บไปใช้ต่อได้โดยอัตโนมัติ ใช้หลักลดข้อมูล: เก็บชุดฟิลด์ที่แคบที่สุดที่ตอบวัตถุประสงค์ของคุณ ทิ้งทุกสิ่งที่ไม่จำเป็น และอย่าสร้างโปรไฟล์บุคคลโดยไม่มีฐานทางกฎหมายที่ชัดเจน เมื่อเป้าหมายคือราคา ความพร้อมจำหน่าย หรือแนวโน้มโดยรวมแทนที่จะเป็นผู้คน ให้เลือกการออกแบบที่ไม่แตะต้อง PII ตั้งแต่แรก
ตัวดึงข้อมูลควรระบุตัวตนหรือไม่?
ประเด็นนี้มีการถกเถียงกันจริง และผู้ปฏิบัติงานที่มีเหตุผลอาจเห็นต่างกัน มุมมองหนึ่งเห็นว่าตัวดึงข้อมูลควรส่งสตริง user-agent ที่ตรงไปตรงมาซึ่งระบุผู้ดำเนินการและวิธีติดต่อ เพื่อให้เจ้าของเว็บไซต์ติดต่อหรือกำหนดกฎได้ อีกมุมมองเห็นว่าการทำเช่นนี้ชวนให้ถูกบล็อกแบบเหมารวม แม้จะประพฤติดี
ความโปร่งใสมีคุณค่าอย่างแท้จริง: user-agent ที่อธิบายได้และระบุชื่อโครงการของคุณ พร้อมลิงก์ไปยังหน้านโยบาย ช่วยให้เจ้าของเว็บไซต์ที่ให้ความร่วมมือจำกัดอัตราหรือเพิ่มคุณในรายการอนุญาต แทนการคาดเดา ข้อโต้แย้งคือหลายเว็บไซต์บล็อกทุกสิ่งที่ไม่เหมือนเบราว์เซอร์หลัก ทำให้แม้แต่ตัวดึงข้อมูลที่ประพฤติดีก็ต้องหันไปใช้สตริงทั่วไป ไม่มีคำตอบเดียวที่ถูกต้อง แต่การปลอมแปลงตัวตนโดยเจตนาเพื่อแอบอ้างเป็นบุคคลเฉพาะหรือเพื่อเอาชนะระบบความปลอดภัย ยากที่จะอธิบายความชอบธรรมได้มากกว่าการใช้ไคลเอนต์ที่เป็นกลางและซื่อสัตย์ ชั่งน้ำหนักความโปร่งใสกับความเป็นไปได้ในทางปฏิบัติสำหรับเป้าหมายเฉพาะของคุณ
เหตุใดแหล่งที่มาของ proxy จึงสำคัญ?
เพราะจริยธรรมของการเก็บข้อมูลของคุณครอบคลุมไปถึงโครงสร้างพื้นฐานที่คุณส่งข้อมูลผ่าน เครือข่าย proxy ที่สร้างจากอุปกรณ์ซึ่งเจ้าของไม่เคยยินยอมเข้าร่วม จะผลักต้นทุนที่ซ่อนอยู่ไปให้ผู้ที่ไม่รู้ตัว ซึ่งบ่อนทำลายข้ออ้างใด ๆ ว่าการทำ scraping ของคุณมีความรับผิดชอบ
proxy ที่ได้มาอย่างมีจริยธรรมมาจากผู้ใช้ที่เลือกเข้าร่วมอย่างชัดแจ้งและได้รับค่าตอบแทนสำหรับการแชร์การเชื่อมต่อ พร้อมการเปิดเผยอย่างชัดเจนว่าสิ่งนั้นเกี่ยวข้องกับอะไร DataImpulse ใช้โมเดลนี้: IP แบบ residential, mobile และ datacenter จำนวน 90M+ ใน 195 ประเทศ ได้มาจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน การดำเนินงานสอดคล้องกับ GDPR และมีข้อตกลงการประมวลผลข้อมูลให้ใช้ คุณสามารถอ่านเพิ่มเติมเกี่ยวกับแนวทางนี้ได้ที่หน้า proxy ที่มีจริยธรรม ของเรา การเลือกผู้ให้บริการด้วยเกณฑ์นี้ แทนที่จะเลือกเครือข่ายที่ถูกที่สุดและไม่ทราบที่มา ช่วยให้กระบวนการทั้งหมดสอดคล้องกับหลักการข้างต้น DataImpulse ยังมี mobile proxies และ datacenter proxies สำหรับทีมที่ต้องการ IP คนละประเภท
รายการตรวจสอบ web scraping อย่างมีจริยธรรมควรเป็นอย่างไร?
รายการตรวจสอบสั้น ๆ ช่วยให้โครงการรักษาความถูกต้องตั้งแต่เริ่มต้น มีประเด็นหนึ่งที่ควรกล่าวถึงแยกต่างหากคือการให้สิทธิ์ใช้งานและลิขสิทธิ์ ข้อเท็จจริงและข้อมูลดิบมักไม่ได้รับความคุ้มครอง แต่การแสดงออกเชิงสร้างสรรค์ที่อยู่รอบข้อมูล เช่น ข้อความบทความและภาพถ่าย อาจอยู่ภายใต้ลิขสิทธิ์หรือสิทธิในฐานข้อมูล ดังนั้นควรตรวจสอบการให้สิทธิ์ใช้งานก่อนเผยแพร่ซ้ำหรือขายต่อสิ่งที่เก็บมา
- เฉพาะข้อมูลสาธารณะ: เก็บข้อมูลที่เข้าถึงได้โดยไม่ต้องเข้าสู่ระบบหรือหลบเลี่ยง paywall
- อ่านสัญญาณ: ตรวจสอบ robots.txt และข้อกำหนดการให้บริการ และปฏิบัติตามเส้นทางที่ห้ามกับ crawl delay
- ควบคุมอัตรา: กำหนดจังหวะคำขอ จำกัดการเชื่อมต่อพร้อมกัน แคชผลลัพธ์ และลดความถี่เมื่อเกิดข้อผิดพลาด
- ลด PII: หลีกเลี่ยงข้อมูลส่วนบุคคล เว้นแต่มีฐานทางกฎหมาย และเก็บเท่าที่จำเป็นภายใต้ GDPR และ CCPA
- โปร่งใสเมื่อเหมาะสม: ใช้ไคลเอนต์ที่ซื่อสัตย์ และอย่าแอบอ้างเป็นบุคคลเฉพาะหรือเอาชนะระบบความปลอดภัย
- เคารพการให้สิทธิ์ใช้งาน: ตรวจสอบลิขสิทธิ์และสิทธิในฐานข้อมูลก่อนนำเนื้อหาไปใช้ซ้ำหรือเผยแพร่ซ้ำ
- จัดหาโครงสร้างพื้นฐานอย่างมีจริยธรรม: ส่งทราฟฟิกผ่านเครือข่าย proxy ที่ผู้ใช้ยินยอมและได้รับค่าตอบแทน
- ขอคำแนะนำเมื่อไม่แน่ใจ: ปรึกษาทนายความสำหรับกรณีที่มีความเสี่ยงสูงหรือคลุมเครือ
หลักการ scraping อย่างมีจริยธรรมในทางปฏิบัติ
| หลักการ | การนำไปใช้ |
|---|---|
| เฉพาะข้อมูลสาธารณะ | ข้ามเนื้อหาที่ต้องเข้าสู่ระบบ |
| เคารพ robots.txt | ปฏิบัติตามคำสั่งการ crawl |
| การจำกัดอัตรา | เพิ่มช่วงหน่วงระหว่างคำขอ |
| ไม่เก็บข้อมูลส่วนบุคคล | หลีกเลี่ยงการเก็บ PII |
| การระบุแหล่งที่มาและการให้สิทธิ์ใช้งาน | เคารพข้อกำหนดและให้เครดิต |
| การจัดหา proxy อย่างมีจริยธรรม | ใช้เครือข่าย IP ที่ได้รับความยินยอม |
คำถามที่พบบ่อย
web scraping เหมือนกับ web scraping อย่างมีจริยธรรมหรือไม่?
ไม่ Web scraping คือเทคนิคการดึงข้อมูลจากเว็บไซต์ ขณะที่ web scraping อย่างมีจริยธรรมคือการทำ scraping โดยเคารพขอบเขตของข้อมูลสาธารณะ ภาระของเซิร์ฟเวอร์ กฎหมายความเป็นส่วนตัว และการให้สิทธิ์ใช้งานเนื้อหา เครื่องมือเหมือนกัน สิ่งที่ต่างคือวินัยในการใช้งาน
การไม่สนใจ robots.txt ทำให้การทำ scraping ผิดกฎหมายหรือไม่?
ไม่ใช่โดยอัตโนมัติ ไฟล์ robots.txt เป็นมาตรฐานเชิงแนะนำ ไม่ใช่กฎหมาย ดังนั้นการไม่สนใจไฟล์นี้จึงไม่ใช่อาชญากรรมในตัวเอง แต่อาจสนับสนุนข้อเรียกร้องอื่นและแสดงถึงการไม่เคารพความต้องการของเจ้าของเว็บไซต์ ความชอบด้วยกฎหมายขึ้นอยู่กับเขตอำนาจศาลและข้อเท็จจริงเฉพาะ ดังนั้นโปรดปรึกษาทนายความสำหรับกรณีของคุณ
เก็บข้อมูลส่วนบุคคลได้หรือไม่หากมองเห็นได้ต่อสาธารณะ?
การมองเห็นต่อสาธารณะไม่ได้ตัดภาระหน้าที่ด้านความเป็นส่วนตัว กฎระเบียบอย่าง GDPR และ CCPA ยังอาจใช้กับข้อมูลส่วนบุคคลแม้ข้อมูลนั้นปรากฏบนหน้าที่เปิดเผย ดังนั้นคุณจำเป็นต้องมีฐานทางกฎหมายและควรลดข้อมูลที่เก็บให้เหลือน้อยที่สุด
proxy ที่ได้มาอย่างมีจริยธรรมคืออะไร?
proxy ที่ได้มาอย่างมีจริยธรรมมาจากผู้ใช้ที่เลือกเข้าร่วมอย่างชัดแจ้งเพื่อแชร์การเชื่อมต่อและได้รับค่าตอบแทน พร้อมการเปิดเผยอย่างชัดเจน DataImpulse จัดหา IP ด้วยวิธีนี้และการดำเนินงานสอดคล้องกับ GDPR โดยมีข้อตกลงการประมวลผลข้อมูลให้ใช้
จะป้องกันไม่ให้ตัวดึงข้อมูลทำให้เว็บไซต์ทำงานหนักเกินไปได้อย่างไร?
จำกัดอัตราคำขอและจำนวนการเชื่อมต่อพร้อมกัน เคารพ crawl-delay ที่มีอยู่ แคชหน้าที่ดึงมาแล้ว และลดความถี่เมื่อพบข้อผิดพลาดหรือการจำกัดอัตรา เป้าหมายคือให้ทราฟฟิกของคุณเป็นเพียงสัดส่วนเล็กน้อยของทราฟฟิกปกติของเว็บไซต์
เมื่อใด DataImpulse จึงไม่เหมาะสม?
หากคุณต้องการ proxy ISP แบบคงที่ API สำหรับการดึงข้อมูลที่มีการจัดการครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยเน้น residential, mobile และ datacenter proxies แบบหมุนเวียน สำหรับการเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
ทำ scraping อย่างรับผิดชอบด้วย proxy ที่ได้มาอย่างมีจริยธรรม
หากต้องการโครงสร้างพื้นฐานที่สอดคล้องกับหลักการข้างต้น DataImpulse มี residential, mobile และ datacenter proxies ที่ได้มาอย่างมีจริยธรรม ในรูปแบบทราฟฟิกจ่ายตามการใช้งาน เริ่มต้นที่ 1 ดอลลาร์ต่อ GB สร้างบัญชี เพื่อเริ่มเก็บข้อมูลสาธารณะอย่างรับผิดชอบ