
In this Article
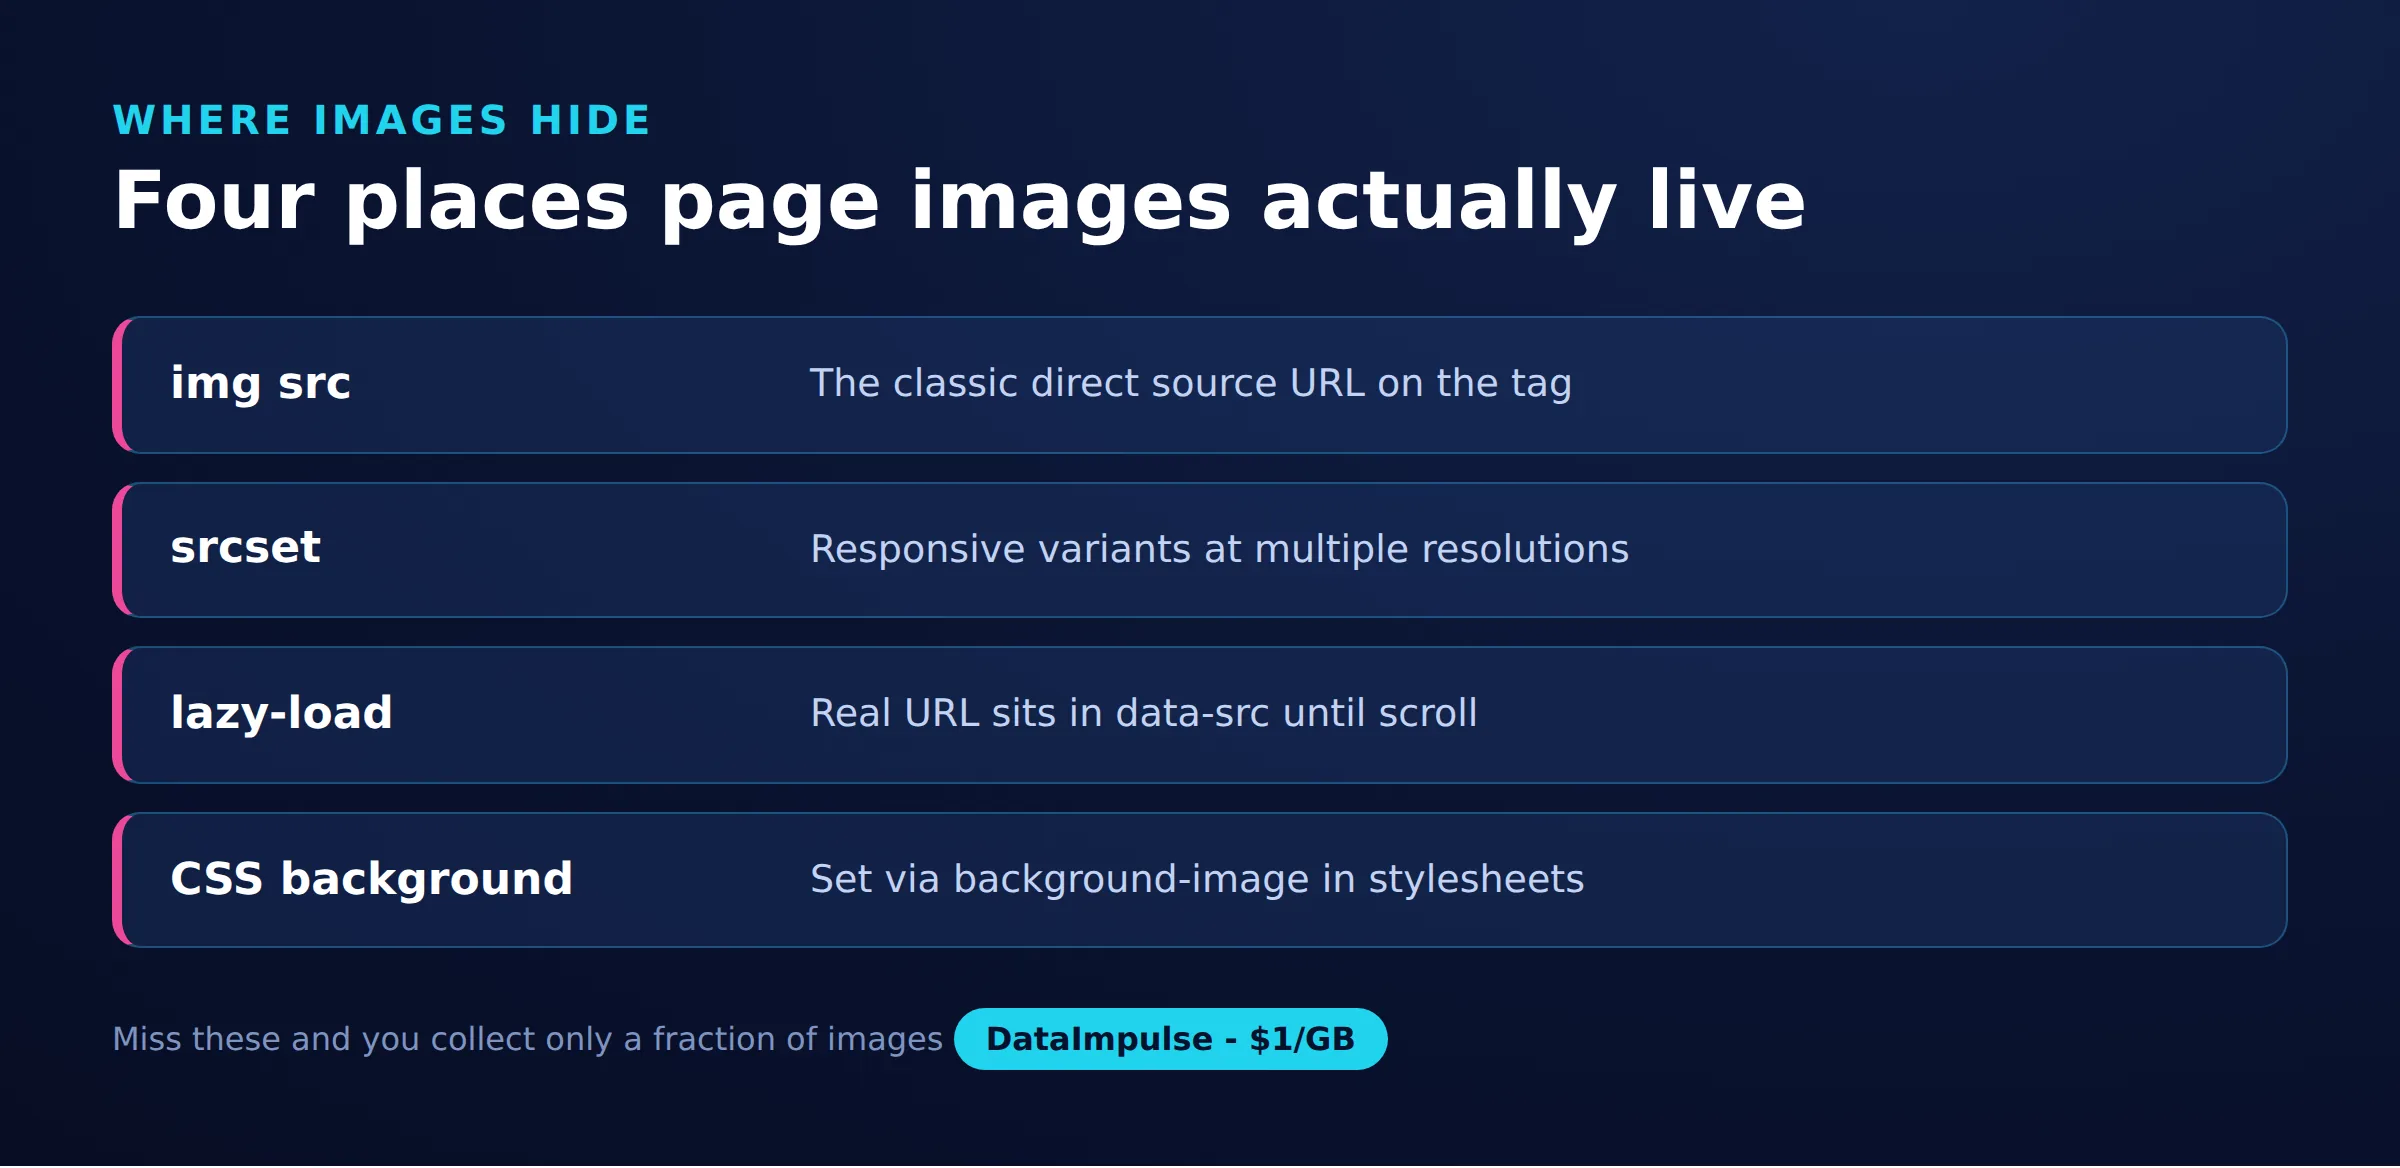
Mempelajari cara melakukan scraping gambar dari situs web berarti menyelesaikan dua masalah: menemukan lokasi setiap sumber gambar dalam HTML, lalu mengunduh file biner di balik URL tersebut. Panduan ini menguraikan kedua langkah itu dengan kode Python yang berfungsi, membahas kasus rumit seperti pemilihan srcset, lazy-loading, dan latar belakang CSS, serta menjelaskan cara tetap mematuhi batasan hak cipta dan bandwidth.
Gambar lebih berat daripada teks, sehingga pengumpulannya dalam skala besar memerlukan rencana untuk penyimpanan, deduplikasi, concurrency, dan biaya jaringan. Semua contoh di bawah dapat dijalankan dengan requests, BeautifulSoup, dan Playwright, dan tekniknya berlaku untuk satu galeri maupun katalog besar.
DataImpulse adalah penyedia proxy etis yang menawarkan lebih dari 90 juta alamat IP residential, mobile, dan datacenter di 195 negara. Layanannya menggunakan model pay-as-you-go mulai dari 1 dolar per GB dengan lalu lintas tanpa masa berlaku, serta digunakan untuk web scraping, verifikasi iklan, pemantauan harga, riset pasar, dan pengelolaan banyak akun.
Fakta Utama
- Poin utama: Untuk melakukan scraping gambar dari situs web, Anda harus terlebih dahulu mengekstrak setiap sumber (img src, srcset, atribut data lazy-load, latar belakang CSS, dan JSON-LD), lalu mengunduh file biner, karena markup dan file gambar sebenarnya merupakan request terpisah.
- Jenis proxy terbaik: proxy residential rotating, yang menggunakan IP konsumen asli yang dapat menghindari deteksi.
- Harga: mulai dari 1 dolar per GB, pay-as-you-go, dengan lalu lintas tanpa masa berlaku dan tanpa langganan.
- Cakupan: lebih dari 90 juta IP yang diperoleh secara etis di 195 negara.
- Keandalan: tingkat keberhasilan 99,51%, dengan rating 4,8 dari 5 di G2.
- Protokol dan targeting: HTTP, HTTPS, dan SOCKS5, termasuk targeting negara.
Di mana URL gambar berada dalam halaman web?
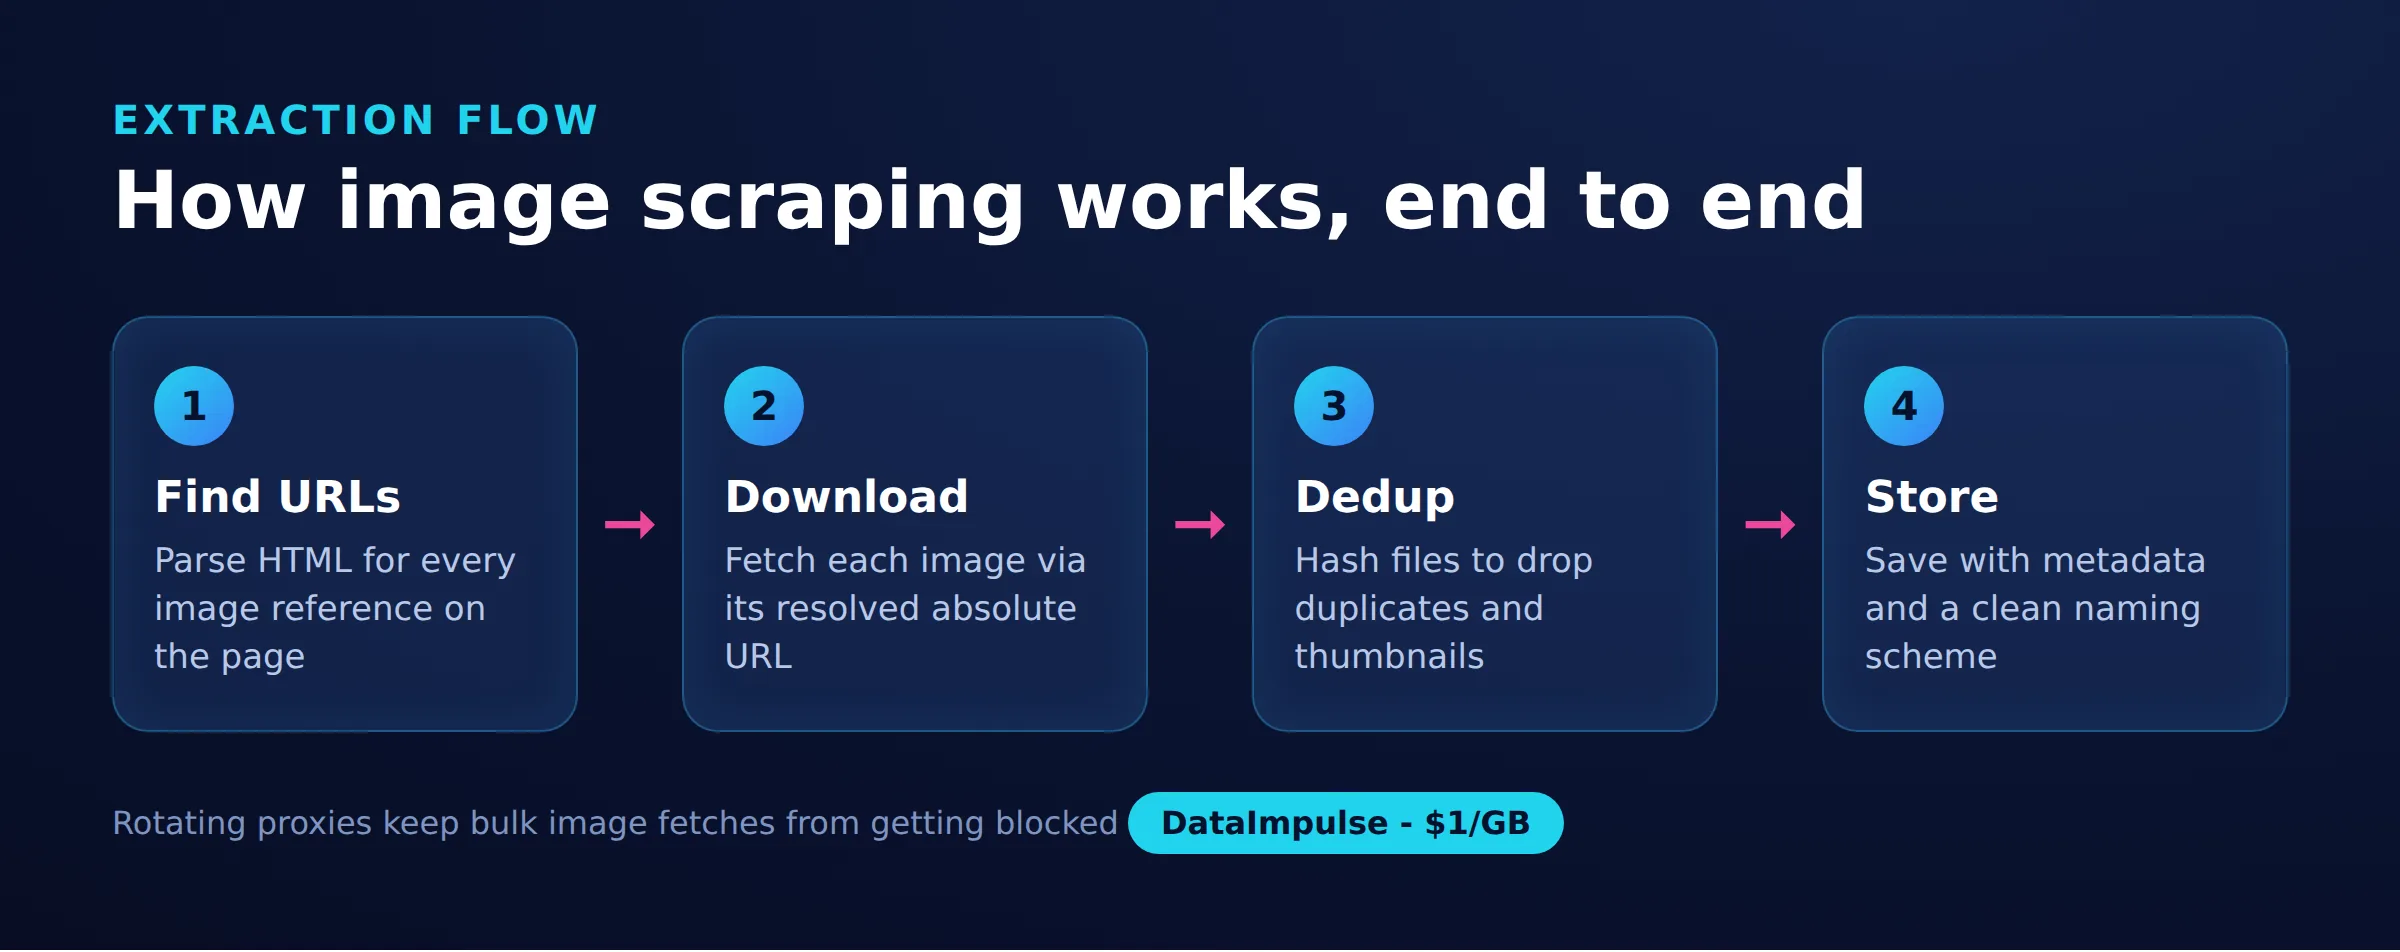
URL gambar disimpan di beberapa tempat, bukan hanya pada atribut src sehingga scraper yang andal memeriksa semuanya. Sebuah halaman dapat merujuk gambar yang sama melalui tag standar, atribut responsif, placeholder lazy-loading, stylesheet, dan data terstruktur.
- Gambar standar: atribut
srcpada tag<img>menyimpan URL langsung. - Gambar responsif: atribut
srcsetpada<img>dan<source>mencantumkan beberapa URL dengan deskriptor lebar atau kepadatan, sehingga browser dapat memilih ukuran. - Gambar lazy-loaded: atribut
srcyang terlihat sering kali berupa placeholder kecil, sedangkan URL sebenarnya berada didata-src,data-original, atau atribut kustom serupa hingga pengguna menggulir halaman. - Latar belakang CSS: gambar dekoratif diatur menggunakan
background-image: url(...)dalam style inline atau stylesheet, dan sama sekali tidak muncul dalam tag<img>. - Data terstruktur: halaman produk dan artikel sering mencantumkan gambar kanonis beresolusi tinggi dalam blok JSON-LD.
Karena sumbernya tersebar, perlakukan halaman sebagai kumpulan sumber kandidat dan ambil dari semua lokasi ini sebelum mengunduh. Tabel di bawah merangkum lokasi setiap sumber dan kendala yang sering menjebak scraper.
| Sumber ekstraksi | Lokasi | Kendala umum |
|---|---|---|
| img src | atribut src pada tag img | Sering berupa placeholder atau URI data: pada halaman lazy-loaded |
| srcset | srcset pada tag img dan source | Berisi beberapa URL dengan deskriptor lebar; Anda harus mengurainya dan memilih satu ukuran |
| Atribut lazy | data-src, data-original, data-lazy-src, data-srcset | Nama atribut berbeda menurut framework, jadi periksa markup sebenarnya |
| Latar belakang CSS | style inline dan blok style, background-image: url() | Tidak pernah muncul dalam tag img; memerlukan regex pada teks CSS |
| JSON-LD | tag script dengan type application/ld+json | Kolom image dapat berupa string, daftar, atau objek bersarang |
Bagaimana menyiapkan scraper gambar Python?
Instal requests untuk HTTP, BeautifulSoup untuk mengurai, dan lxml sebagai backend parser yang cepat, lalu ambil halaman dan baca src dari setiap tag gambar. Contoh minimal ini menjadi dasar bagi semua langkah berikutnya.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
Objek Session menjaga koneksi tetap aktif dan menggunakan kembali header, sehingga lebih cepat dan lebih ramah terhadap server target daripada membuka koneksi baru untuk setiap request. Selalu gunakan urljoin agar path relatif seperti /media/photo.jpg menjadi URL absolut yang dapat Anda unduh nanti. Jika Anda baru mengenal alur kerja yang lebih luas, panduan praktik terbaik web scraping membahas header, timeout, dan etika secara lebih mendalam.
Bagaimana mengekstrak img src, srcset, dan sumber lazy-loaded?
Uraikan srcset dengan memisahkannya pada koma dan membaca deskriptor lebar agar Anda dapat memilih varian terbesar, lalu baca setiap atribut data- yang mungkin digunakan untuk sumber lazy-loaded. Pembacaan atribut biasa melewatkan sebagian besar halaman modern, jadi Anda memerlukan helper kecil untuk setiap format.
Nilai srcset memuat beberapa URL sekaligus dengan deskriptor seperti 800w. Untuk mengambil salinan beresolusi tertinggi, bandingkan angka lebarnya dan simpan yang terbesar.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Sekarang gabungkan sumber standar, responsif, dan lazy ke dalam satu kolektor. Berbagai framework memakai nama atribut yang berbeda, jadi periksa beberapa di antaranya. Fungsi yang sama juga membaca tag <source> di dalam elemen <picture>, yang memiliki srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Melewatkan setiap src yang dimulai dengan data: mencegah penyimpanan placeholder base64 inline, yang biasanya merupakan thumbnail berkualitas rendah yang ditampilkan lazy loader sebelum gambar sebenarnya dimuat.
Bagaimana menemukan gambar latar belakang CSS dan JSON-LD?
Gunakan regular expression untuk mengambil URL dari deklarasi background-image, lalu telusuri blok JSON-LD untuk membaca kolom image. Kedua sumber ini tidak pernah muncul dalam tag <img>, sehingga scraper yang hanya membaca tag gambar akan melewatkannya seluruhnya.
Gambar dekoratif dan hero umumnya diatur dalam CSS. Pindai atribut style inline serta blok <style> untuk nilai url(...).
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Data terstruktur adalah tempat paling andal untuk menemukan gambar kanonis beresolusi penuh pada halaman produk dan artikel. Nilai image dapat berupa string, daftar, atau objek bersarang, jadi telusuri seluruh pohonnya.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Gabungkan ketiga kolektor dengan set union, misalnya collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base), dan Anda memperoleh set URL kandidat yang telah dideduplikasi dan siap diunduh.
Bagaimana mengunduh file gambar dengan aman?
Lakukan streaming pada setiap response, pastikan header Content-Type benar-benar menunjukkan gambar, dan batasi ukurannya agar satu file tidak menghabiskan memori atau disk. Mengunduh URL secara membabi buta berisiko menyimpan halaman error HTML, redirect, atau file sangat besar, jadi lakukan validasi sebelum menyimpan byte-nya.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Streaming dengan stream=True dan iter_content membuat pemeriksaan header berjalan sebelum seluruh body diunduh, sehingga link dengan label keliru ditolak lebih awal. Pemeriksaan type yang dilaporkan menangkap kasus umum ketika URL rusak mengembalikan halaman HTML 404 dengan status 200. Untuk keamanan tambahan, Anda juga dapat memverifikasi magic bytes pertama dari payload, tetapi pemeriksaan header ditambah batas ukuran sudah menangani sebagian besar web scraping di dunia nyata.
Bagaimana mendeduplikasi dan menamai gambar yang diunduh?
Buat hash SHA-256 dari byte yang diunduh dan lewati setiap digest yang sudah Anda simpan, lalu sanitasi nama file dan pecah file ke dalam subfolder berdasarkan prefiks hash. Situs sering menyajikan gambar yang sama dari beberapa path, CDN, atau varian ukuran, sehingga hash konten lebih andal daripada membandingkan URL.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Sanitasi basename menghapus karakter path traversal dan bagian tidak berguna pada query string agar URL berbahaya atau berantakan tidak dapat menulis di luar folder target Anda. Pemecahan berdasarkan dua karakter hash pertama menjaga direktori tetap kecil, yang penting saat Anda mengumpulkan puluhan ribu file. Untuk deteksi hampir-duplikat, seperti foto yang sama pada resolusi berbeda, library perceptual hash seperti imagehash mengelompokkan file yang serupa secara visual tetapi dianggap berbeda oleh hash byte.
Bagaimana mengunduh banyak gambar secara bersamaan?
Gunakan ThreadPoolExecutor untuk mengunduh beberapa gambar sekaligus, lalu tambahkan rate limiter bersama agar semua thread secara total tetap berada di bawah batas request per detik. Unduhan gambar bersifat I/O bound sehingga thread memberikan peningkatan kecepatan yang besar, tetapi concurrency tanpa batas akan membebani target dan membuat Anda diblokir.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
Lock di sekitar seen membuat deduplikasi thread-safe, dan membungkus setiap job dalam blok try berarti satu URL buruk tidak menghentikan seluruh proses. Pertahankan rate tetap moderat, beberapa request per detik adalah default yang wajar, dan baca panduan web scraping etis untuk mengetahui cara memilih batas yang menghormati situs.
Bagaimana melakukan scraping gambar dalam skala besar dengan proxy?
Anda memerlukan proxy ketika target mulai melakukan rate-limiting atau memblokir IP Anda, yang cepat terjadi saat mengunduh banyak gambar dari satu alamat. Berikan dictionary proxies ke setiap request agar loop unduhan yang sama dialihkan melalui IP residential rotating. Aliran request gambar yang stabil dari satu IP merupakan pola otomatis yang jelas, dan gambar berukuran besar, jadi bandwidth biasanya menjadi batasan sebenarnya.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Proxy rotating menyebarkan request ke banyak IP sehingga tidak ada satu alamat yang menarik perhatian, sedangkan sticky session mempertahankan satu IP untuk galeri yang dikaitkan situs dengan sebuah sesi. DataImpulse menyediakan proxy residential dan proxy mobile untuk target yang meneliti lalu lintas secara ketat, serta proxy datacenter untuk unduhan ber-volume tinggi dari sumber yang lebih longgar. Semua IP diperoleh secara etis dari pengguna yang memberikan persetujuan dan menerima kompensasi. Jika kredensial Anda ditolak dengan 407, panduan autentikasi proxy menjelaskan format login yang tepat.
Karena setiap byte yang diunduh dihitung dalam anggaran lalu lintas Anda, rencanakan ukuran sebelum memulai: lewati gambar di bawah ambang batas jika Anda hanya menginginkan konten utama, request varian srcset yang lebih kecil saat resolusi penuh tidak diperlukan, dan cache apa yang sudah Anda miliki agar proses ulang tidak mengambil kembali semuanya. DataImpulse menggunakan tagihan pay-as-you-go mulai dari 1 dolar per GB dengan lalu lintas tanpa masa berlaku, sehingga pekerjaan gambar yang berat tetapi sesekali tidak memerlukan langganan bulanan, dan lalu lintas yang tidak terpakai akan terbawa.
Bagaimana melakukan scraping galeri yang dirender JavaScript?
Jika situs membangun galerinya sepenuhnya dengan JavaScript, URL gambar tidak pernah muncul dalam HTML mentah, jadi render halaman terlebih dahulu dengan Playwright dan masukkan hasilnya ke kolektor yang sama. Requests saja tidak dapat menjalankan script, sehingga galeri infinite-scroll dan single-page memerlukan browser sungguhan untuk memicu pemuatan.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Pengguliran dalam loop memaksa lazy loader menukar placeholder data-src dengan URL sebenarnya, lalu parser yang sudah Anda tulis akan mengambilnya. Untuk pembahasan rendering headless yang lebih mendalam, lihat scraping halaman web dinamis.
Terakhir, tulis manifest CSV agar setiap file yang diunduh dapat ditelusuri kembali ke URL sumber, hash, dan ukurannya. Manifest mengubah folder file anonim menjadi dataset yang dapat Anda audit, lanjutkan, dan deduplikasi di berbagai proses.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Dengan manifest tersedia, Anda dapat menjalankan ulang job dan melewati URL yang sudah tercatat, sehingga menghemat bandwidth dan menjaga dataset Anda konsisten dari waktu ke waktu.
Apakah legal melakukan scraping dan menggunakan ulang gambar dari situs web?
Mengunduh file gambar adalah tindakan teknis; tindakan itu tidak memberi Anda lisensi untuk menggunakan ulang gambar tersebut. Ini adalah bagian web scraping gambar yang paling sering disalahpahami, jadi tangani dengan cermat. Hampir setiap foto, ilustrasi, dan grafis di web dilindungi hak cipta sejak dibuat, dan orang yang mengambil atau membuatnya memegang hak tersebut kecuali mereka secara tegas telah melepaskannya.
Kemampuan mengambil file tidak mengatakan apa pun tentang hak Anda untuk menerbitkan ulang, menjual, melatih model dengan file tersebut, atau mendistribusikannya kembali. Sebelum menggunakan ulang gambar hasil scraping, periksa ketentuan lisensi yang melekat padanya, cari lisensi yang dinyatakan seperti Creative Commons atau domain publik, dan dapatkan izin tertulis jika penggunaannya komersial. Mengumpulkan gambar untuk analisis pribadi, pengindeksan, atau penelitian berbeda dengan menerbitkannya, dan asumsi paling aman adalah gambar dilindungi kecuali lisensi menyatakan sebaliknya dengan jelas.
Tinjau juga ketentuan layanan situs target dan robots.txt sebelum memulai. Panduan memeriksa apakah situs web mengizinkan scraping menunjukkan cara membaca sinyal tersebut, sedangkan panduan scraping tanpa diblokir membahas praktik crawling yang menghormati situs. Tidak satu pun teknik dalam artikel ini mengubah aturan dasarnya: akses bukan lisensi, dan secara jujur scraper yang berfungsi serta hak legal untuk menggunakan ulang adalah dua hal terpisah yang harus Anda penuhi secara mandiri.
Pertanyaan yang sering diajukan
Bisakah saya melakukan scraping gambar dari situs web mana pun?
Secara teknis Anda dapat mengunduh file dari sebagian besar situs, tetapi Anda sebaiknya terlebih dahulu memeriksa ketentuan layanan situs dan robots.txt, serta ingat bahwa mengunduh gambar tidak memberi Anda hak untuk menggunakannya kembali. Akses bukan lisensi.
Mengapa beberapa gambar tidak muncul dalam HTML yang saya unduh?
Gambar tersebut biasanya dimuat oleh JavaScript atau lazy-loading, sehingga URL sebenarnya berada dalam atribut data atau ditambahkan setelah halaman dirender. Render halaman dengan browser headless seperti Playwright dan gulir untuk memicu pemuatan, lalu uraikan hasilnya.
Bagaimana memilih versi gambar dengan resolusi tertinggi?
Uraikan atribut srcset, baca deskriptor lebar setelah setiap URL, lalu simpan URL dengan lebar terbesar. Halaman produk juga sering mencantumkan gambar beresolusi penuh dalam blok JSON-LD.
Bagaimana agar tidak mengunduh gambar yang sama dua kali?
Hitung hash SHA-256 setiap file yang diunduh dan lewati hash yang sudah Anda simpan. Untuk salinan yang mirip secara visual dalam ukuran berbeda, gunakan library perceptual hash seperti imagehash.
Apakah DataImpulse menawarkan API scraping gambar terkelola?
Tidak. DataImpulse menyediakan proxy yang Anda gunakan untuk merutekan scraper Anda sendiri; ini bukan API scraping terkelola atau layanan web-proxy gratis. Anda menulis logika unduhan dan menggunakan IP-nya untuk akses dan rotasi.
Kapan DataImpulse bukan pilihan yang tepat?
Jika Anda memerlukan proxy ISP statis, API scraping yang sepenuhnya terkelola, atau akses ke situs perbankan dan pemerintah, DataImpulse bukan alat yang tepat. Fokusnya adalah proxy residential, mobile, dan datacenter rotating untuk mengumpulkan data publik dan mengakses konten.
Mulai melakukan scraping gambar dalam skala besar
Saat scraper gambar Anda memerlukan akses andal dan rotasi IP tanpa langganan, DataImpulse menawarkan proxy residential, mobile, dan datacenter yang diperoleh secara etis dengan lalu lintas pay-as-you-go mulai dari 1 dolar per GB. Buat akun dan arahkan loop unduhan Anda melaluinya dalam hitungan menit.