
In this Article
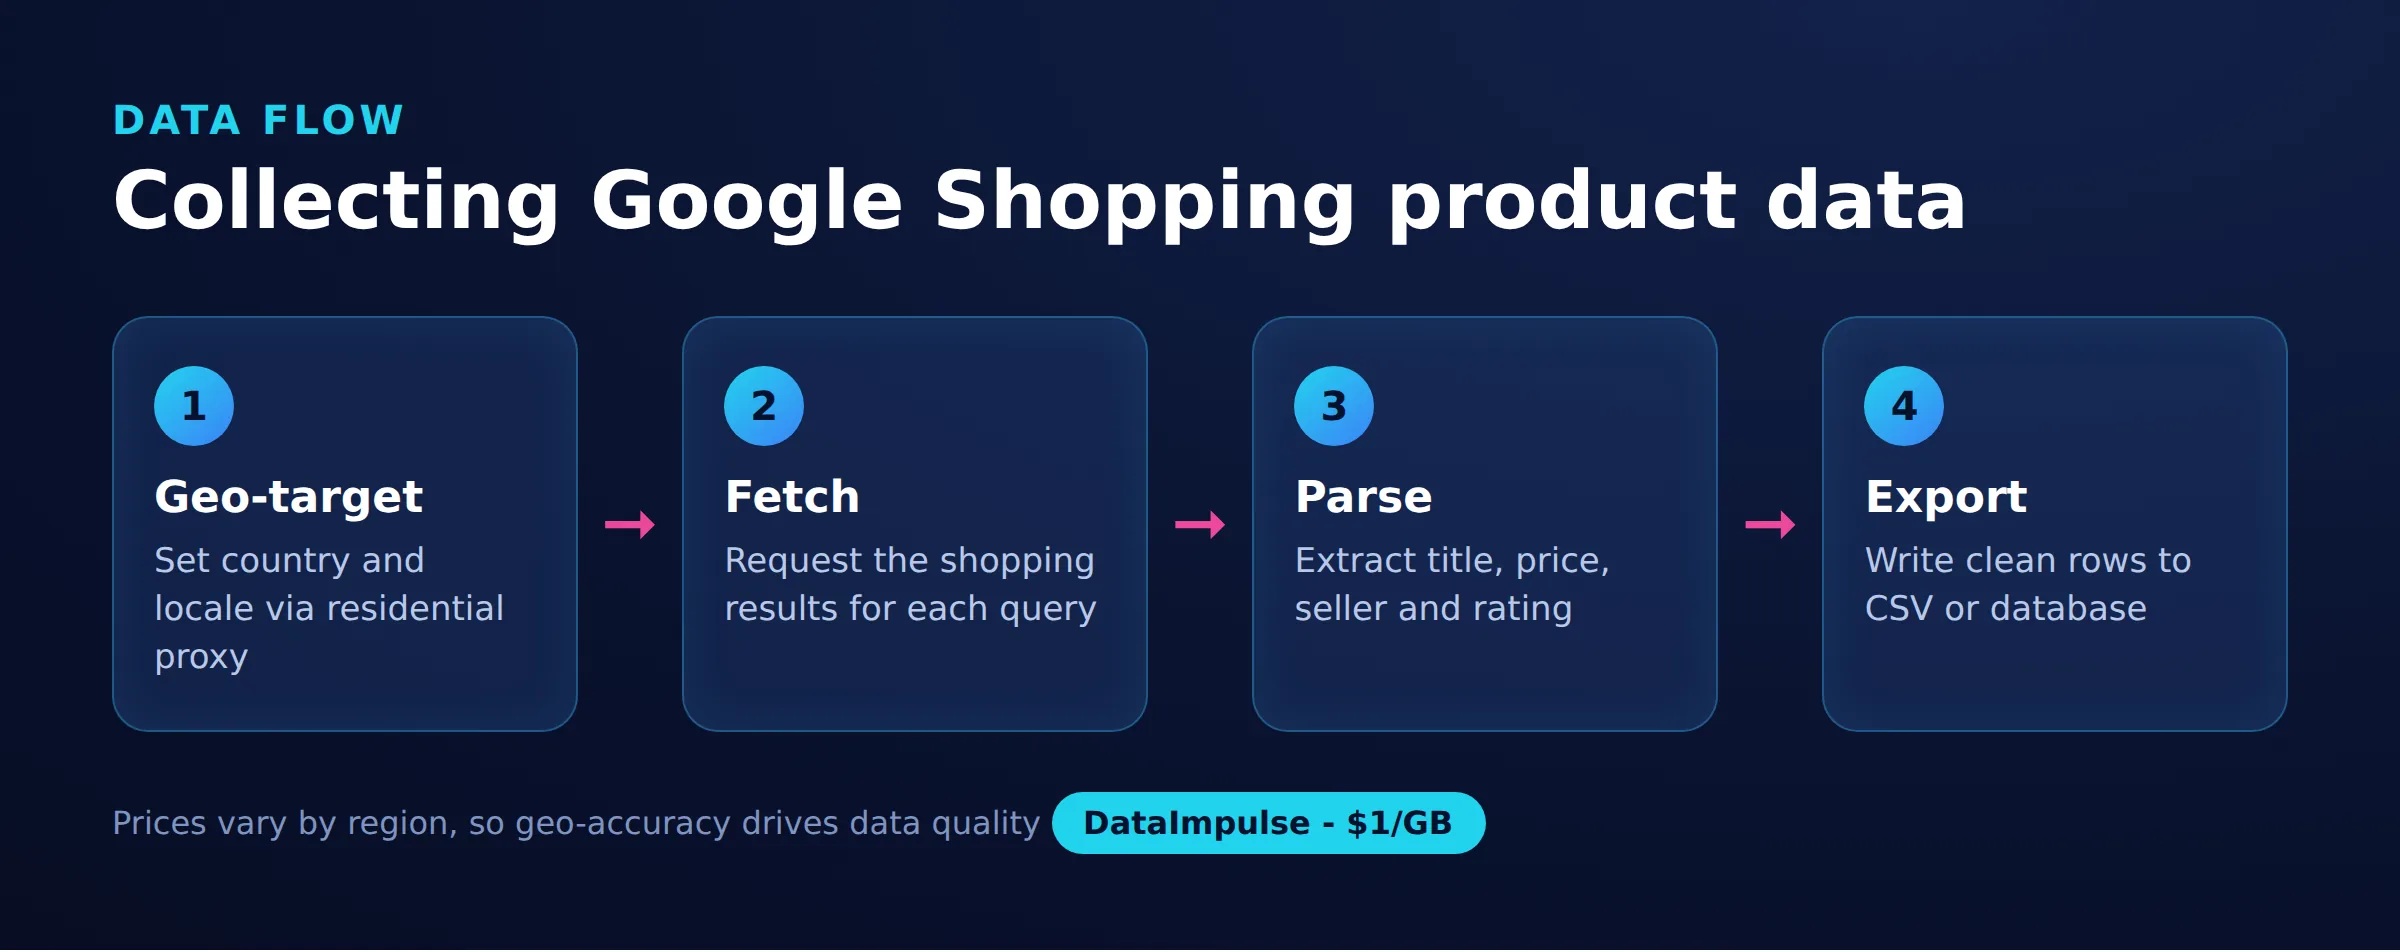
Fare web scraping di Google Shopping significa raccogliere su larga scala dati strutturati sui prodotti, come titoli, prezzi, venditori, valutazioni e note di spedizione, dai risultati shopping di Google. Poiché questi risultati sono fortemente protetti e localizzati, per farlo in modo affidabile servono IP a rotazione e una corretta geolocalizzazione, non un singolo scraper su una sola connessione.
Questa guida parte dal codice. Illustra richieste geolocalizzate, instradamento tramite proxy specifici per paese, parsing delle schede prodotto che Google offusca deliberatamente, paginazione, retry e backoff per i limiti di velocità, un fallback con browser headless che gestisce le finestre di consenso, un modello dati pulito con esportazione CSV, un tracker dello storico prezzi e una pianificazione del monitoraggio. Affronta inoltre con trasparenza la realtà dei sistemi anti-bot, il compromesso tra uno scraper fai da te e una SERP API a pagamento, e i limiti legali.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Usa un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Dati principali
- Prezzi localizzati: Per fare web scraping di Google Shopping in modo accurato devi impostare i parametri gl e hl e instradare le richieste tramite un IP nel paese di destinazione, poiché prezzi, venditori e disponibilità variano in base alla regione.
- Miglior tipo di proxy: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti in modo etico in 195 paesi.
- Affidabilità: tasso di successo del 99,51%, valutazione di 4,8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Quali dati puoi estrarre da Google Shopping?
Google Shopping mostra schede prodotto con vari campi strutturati utili per lanalisi dei prezzi e le ricerche di mercato. Ogni risultato contiene in genere un insieme coerente di attributi che puoi estrarre e normalizzare in righe.
- Dettagli del prodotto: titolo, estratto della descrizione, brand, modello e URL dell’immagine del prodotto.
- Prezzo: il prezzo indicato, la valuta e talvolta una fascia di prezzo tra i venditori.
- Venditore: il nome del commerciante e, nella pagina dei dettagli del prodotto, un elenco di venditori concorrenti che offrono lo stesso articolo.
- Valutazioni e recensioni: valutazione a stelle aggregata e numero di recensioni, quando presenti.
- Disponibilità e spedizione: stato delle scorte e note di spedizione che variano per regione.
I campi esatti cambiano ogni volta che Google aggiorna il layout, quindi qualsiasi parser deve tollerare valori mancanti e markup variabile. Considera ogni campo facoltativo e convalida i tipi dopo lestrazione, anziché presumere che valutazione o venditore siano sempre presenti. Poiché lo stesso prodotto può apparire a prezzi diversi in paesi diversi, progetta fin dall’inizio lo schema attorno a una chiave (prodotto, paese, timestamp), invece di aggiungere la geografia in seguito.
Come inviare una richiesta geolocalizzata a Google Shopping?
Invii una richiesta geolocalizzata chiamando lendpoint di ricerca di Google con il flag della scheda shopping e i parametri di locale, inviando gli stessi segnali di IP e parametri che invierebbe un vero acquirente. I due parametri più importanti sono gl (il paese, ad esempio gl=de per la Germania) e hl (la lingua dellinterfaccia, ad esempio hl=de). Un terzo elemento utile è un termine in stile location che inserisci nel contesto della query, ma gl più un IP di uscita corrispondente svolgono la maggior parte del lavoro.
Impostare solo i parametri non basta, perché Google legge anche lIP della richiesta per decidere quali prezzi e venditori mostrare. La richiesta minima seguente invia headers realistici e la coppia di locale. È deliberatamente priva di proxy, così puoi vedere la chiamata di base prima di aggiungere un livello IP.
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
Mantieni lheader Accept-Language allineato con hl. Una pagina di prezzi tedesca richiesta con un header in lingua inglese è una discrepanza che appare innaturale e può restituire la valuta sbagliata. Quando aumenti la scala, questa funzione di base diventa lunico punto in cui si decide il locale, mantenendo coerenti tutte le chiamate successive.
Come instradare le richieste tramite proxy con targeting per paese?
Instradi tramite un proxy con targeting per paese puntando requests a un singolo gateway e codificando il paese di destinazione nel nome utente del proxy. Con DataImpulse il gateway è gw.dataimpulse.com:823 e aggiungendo __cr.us oppure __cr.de al tuo nome utente seleziona il paese di uscita. Il targeting per paese è incluso nel prezzo base, mentre il targeting per stato, città, ZIP e ASN è un componente aggiuntivo a pagamento. Se lautenticazione proxy è una novità per te, la nostra guida sullautenticazione proxy spiega in dettaglio il funzionamento di nome utente e password.
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
La disciplina importante consiste nel cambiare insieme il paese del proxy e la coppia gl/hl . Per creare un confronto dei prezzi tra mercati, scorri un elenco di paesi e mantieni IP di uscita e locale sincronizzati, così ogni risposta riflette una singola posizione dell’acquirente coerente.
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse fornisce il livello IP, non un servizio di scraping gestito, quindi lo scraper resta sotto la tua responsabilità. I residential proxies sono di solito la scelta adatta perché provengono da veri dispositivi di utenti; datacenter proxies sono più economici ma più facili da rilevare, e mobile proxies includono IP di livello carrier per i target più difficili.
Come analizzare le schede prodotto di Google Shopping?
Analizza le schede prodotto con una libreria HTML tollerante e basati su pattern di testo stabili anziché su selettori profondi fragili, perché i nomi delle classi di Google sono offuscati e cambiano spesso. Qualsiasi selettore copiato oggi dagli strumenti per sviluppatori del browser può smettere di funzionare nel giro di settimane: progetta quindi il parser affinché degradi con eleganza invece di arrestarsi per una modifica del layout.
Un approccio robusto legge ogni scheda candidata, recupera titolo e immagine dalla struttura dei tag ed estrae il prezzo con unespressione regolare che riconosce la valuta. I selettori seguenti sono esempi realistici, non garanzie: prevedi di aggiornarli e conserva la regex come fallback affidabile.
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
Poiché qui il markup offuscato è la norma, alcuni team ricorrono invece a un DOM renderizzato. Per i compromessi più ampi tra lanalisi di HTML statico e pagine renderizzate, consulta la nostra guida allo scraping di pagine web dinamiche.
Come paginare e applicare il backoff quando Google restituisce 429?
Pagini avanzando loffset start in passaggi che corrispondono alla dimensione della pagina, e superi i limiti di velocità trattando HTTP 429, e le risposte vuote o CAPTCHA, come un segnale per attendere e riprovare tramite un IP nuovo. Google limita aggressivamente le richieste automatizzate ripetute, quindi paginazione e backoff devono stare nello stesso ciclo.
Scorri le pagine finché una richiesta non restituisce più schede o raggiungi un limite di pagine. Ruota lIP di uscita tra le pagine rileggendo il dict del proxy e rileva i blocchi soft cercando indicatori di consenso o CAPTCHA nel corpo, anziché fidarti solo del codice di stato.
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
Lhelper di retry seguente usa backoff esponenziale con jitter, distribuendo i nuovi tentativi affinché un gruppo di worker bloccati non ritenti tutto nello stesso istante. Ogni tentativo recupera di nuovo il dict del proxy, quindi un pool a rotazione ti assegna un nuovo IP al tentativo successivo.
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
Mantieni una frequenza di richieste ragionevole anche quando i retry riescono. Un intervallo di base rispettoso tra le pagine, insieme alla rotazione, contribuisce più alla stabilità a lungo termine che tempestare il servizio contando sui retry. Le nostre note sulle best practice di web scraping approfondiscono ritmo delle richieste e igiene degli headers.
Come renderizzare le pagine bloccate con un browser headless?
Quando una semplice richiesta HTTP continua a incontrare schermate di consenso o contenuti renderizzati con JavaScript, passa a un browser headless che esegue la pagina come un client reale e chiude la finestra di consenso prima di leggere il DOM. Playwright è adatto perché supporta proxy per contesto e attese affidabili.
Lo script seguente avvia Chromium tramite un proxy DataImpulse con targeting per paese, gestisce la finestra di cookie o consenso mostrata di solito nei locale europei, attende il contenuto e restituisce lHTML renderizzato, così puoi passarlo alla stessa funzione parse_cards .
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
Un browser headless richiede più CPU e memoria di una richiesta grezza, quindi usalo come fallback mirato per le pagine che necessitano davvero di rendering, non come percorso predefinito. Molti team usano HTTP diretto per velocità e passano a Playwright solo quando is_blocked continua a segnalare blocchi. Se il tuo stack è JavaScript anziché Python, lo stesso schema vale con Puppeteer; consulta web scraping con JavaScript.
Come strutturare ed esportare i dati estratti?
Struttura i dati attorno a un record stabile che include sempre mercato e timestamp di acquisizione, quindi esporta in CSV affinché l’output sia facile da confrontare, caricare in un foglio di calcolo o inviare a un data warehouse. Una dataclass offre suggerimenti di tipo e una definizione chiara della riga.
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
Scrivere il CSV significa poi scaricare i campi della dataclass. La modalità append con un controllo dell’header consente a un job pianificato di far crescere un file nel tempo senza riscriverlo.
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
Mantenere paese e timestamp in ogni riga permette in seguito di rispondere a domande come quale mercato sia più economico oggi per uno SKU o come sia cambiato un prezzo questa settimana. Questa chiave di geografia e tempo è la base del tracker dello storico prezzi nella sezione successiva.
Come monitorare nel tempo lo storico prezzi di Google Shopping?
Monitori lo storico prezzi eseguendo un upsert di ogni osservazione in un piccolo database basato su prodotto, paese e giorno, così rieseguire lo scraper aggiorna la riga di oggi invece di duplicarla e preserva i giorni precedenti. SQLite è sufficiente per milioni di righe e non richiede server, mantenendo autonomo un job di monitoraggio.
Lo schema seguente usa una chiave univoca composita e un upsert ON CONFLICT. Eseguire lo scraper due volte nello stesso giorno sovrascrive lultimo prezzo per quella combinazione (prodotto, paese, giorno); eseguirlo in giorni diversi costruisce la serie temporale che potrai visualizzare in seguito.
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
In pratica, abbinare i titoli tra giorni diversi è la parte difficile, perché i titoli di Google variano leggermente tra unacquisizione e laltra. Per una piccola watchlist, mappa i titoli grezzi a un id prodotto canonico sotto il tuo controllo prima dellupsert, anziché fidarti del titolo estratto come chiave stabile.
Come pianificare il monitoraggio continuo dei prezzi?
Pianifica il monitoraggio riunendo i passaggi di recupero, analisi e archiviazione in un unico punto di ingresso ed eseguendolo a intervalli fissi con cron, così i prezzi si aggiornano automaticamente senza esecuzioni manuali. Unesecuzione al giorno è un valore predefinito sensato per il monitoraggio dei prezzi; esecuzioni più frequenti aumentano sia il costo sia il rischio di blocco senza aggiungere molti segnali per la maggior parte dei cataloghi.
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
Registralo poi in cron. La voce seguente esegue il monitor ogni giorno alle 06:15 e registra l’output per il debug, cosa importante perché altrimenti uno scraper pianificato fallisce silenziosamente.
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
Aggiungi un leggero jitter nel job, con una pausa casuale di alcuni minuti all’inizio, affinché le richieste non raggiungano Google ogni giorno nello stesso identico secondo. Ruota i paesi di uscita e regola il ritmo delle richieste come descritto prima, e osserva il log per un tasso crescente di blocchi: è il primo segnale che Google ha modificato le difese o che i tuoi pattern sono diventati troppo regolari.
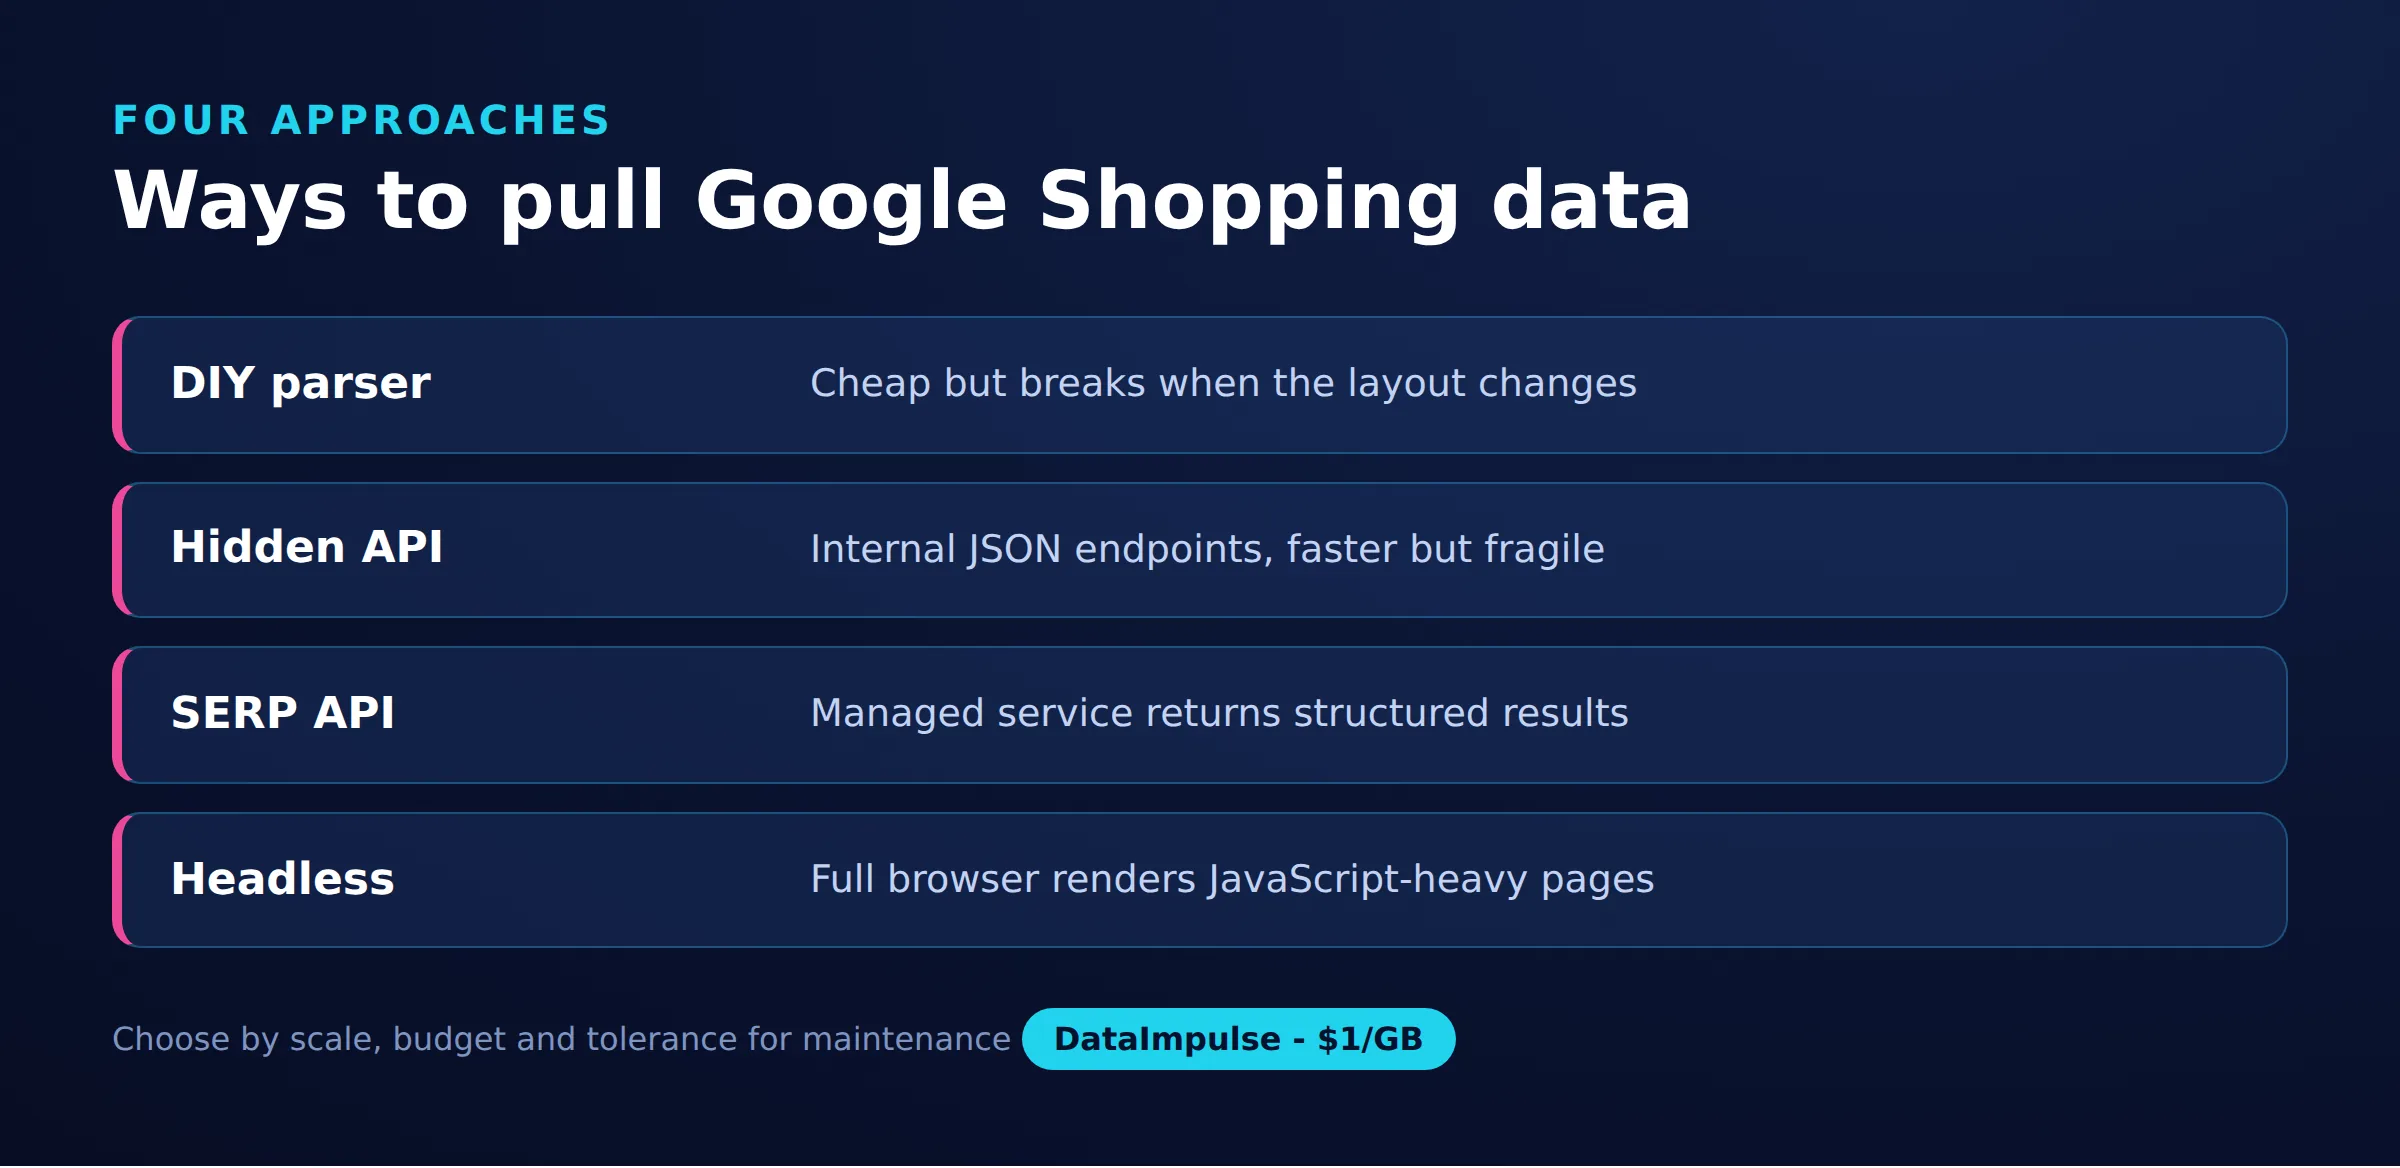
Quale approccio di raccolta scegliere: fai da te, endpoint nascosti, SERP API o headless?
Scegli in base a quanta fragilità e attività di sviluppo sei disposto a gestire, rispetto a quanto sei disposto a pagare per richiesta. Non esiste ununica risposta corretta; il compromesso reale è tra controllo e costo da un lato, onere di manutenzione ed esposizione ai sistemi anti-bot dall’altro.
La realtà anti-bot: Google difende attivamente questi risultati con rate limiting, CAPTCHA, schermate di consenso, markup offuscato variabile e segnali comportamentali. Qualsiasi scraper fai da te smetterà periodicamente di funzionare e richiederà manutenzione continua. Proxy e backoff riducono i blocchi, non li eliminano. Chi promette uno scraper Google impossibile da bloccare in modo permanente sta esagerando.
| Approccio | Costo | Fragilità | Controllo |
|---|---|---|---|
| Parsing HTML fai da te | Basso (solo proxy) | Alta | Completo |
| Endpoint JSON nascosti | Basso (solo proxy) | Molto alta | Completo |
| SERP API | Alto (per richiesta) | Bassa | Limitato |
| Browser headless | Medio (calcolo + proxy) | Media | Completo |
SERP API rispetto al fai da te: Una SERP API di terze parti restituisce risultati shopping analizzati come JSON e si occupa per te del parsing e dello sblocco, a un prezzo per richiesta, con vincolo al fornitore e minore controllo su ciò che viene recuperato. Uno scraper fai da te su proxy costa molto meno per richiesta e ti dà il controllo completo, ma parser, retry e manutenzione quando Google cambia sono a tuo carico. Per chiarire il ruolo di DataImpulse: è il livello proxy alla base di questi approcci fai da te, non una SERP API né un servizio di scraping gestito. Se vuoi zero lavoro di parsing, una SERP API è la raccomandazione trasparente; se desideri costi contenuti e controllo e puoi mantenere uno scraper, il fai da te su proxy a rotazione offre uneconomia migliore. Gli endpoint JSON nascosti possono essere ancora più economici, ma sono i più fragili in assoluto, perché Google può modificarli o rimuoverli senza preavviso.
È legale ed etico fare web scraping di Google Shopping?
Il web scraping di dati sui prodotti visibili pubblicamente è generalmente considerato meno rischioso dellaccesso a contenuti privati o soggetti a controllo, ma non è privo di regole e questo non è un parere legale. Prezzi e inserzioni su Google Shopping sono pubblici, ma conta comunque come li raccogli e usi, e dovresti verificare il tuo caso specifico con un consulente qualificato.
- Termini di servizio: laccesso automatizzato può essere in conflitto con i termini di Google, una questione contrattuale distinta dal diritto d’autore o dalle norme sull’accesso ai sistemi informatici.
- Dati personali: le schede prodotto di solito non sono dati personali, ma evita di raccogliere nomi dei recensori o altri identificativi e rispetta il GDPR dove applicabile.
- Frequenza e carico: mantieni ragionevole il volume delle richieste per non degradare il servizio che stai interrogando.
- Uso dei dati: riutilizzare integralmente immagini o descrizioni protette da copyright comporta più rischi rispetto allanalisi dei prezzi come fatti.
Dal lato della raccolta, letica inizia dagli IP che usi. DataImpulse ottiene i propri IP da utenti che aderiscono volontariamente e ricevono un compenso, è conforme al GDPR e offre un accordo sul trattamento dei dati, elementi che sostengono una pipeline difendibile. Per un approfondimento su consenso, approvvigionamento e pratiche responsabili, consulta la nostra guida al web scraping etico. Abbina una fonte IP etica a un ritmo rispettoso e a un uso circoscritto e fattuale dei dati, e manterrai bassi sia il rischio legale sia quello reputazionale.
Domande frequenti
Mi servono proxy residential per fare web scraping di Google Shopping?
I proxy residential sono la scelta più affidabile perché usano IP reali di utenti che si integrano nel traffico normale. I proxy datacenter possono funzionare con volumi ridotti, ma sono rilevati e bloccati più facilmente.
Come ottengo prezzi localizzati da Google Shopping?
Imposta i parametri gl e hl sul paese e sulla lingua di destinazione, quindi instrada la richiesta tramite un IP proxy nello stesso paese usando la sintassi del paese, per esempio un nome utente che termina in __cr.de per la Germania. Google legge sia i parametri sia lIP della richiesta per decidere quali prezzi mostrare.
DataImpulse è una API per lo scraping di Google Shopping?
No. DataImpulse fornisce il livello proxy, con IP residential, mobile e datacenter, non una API di scraping gestito né una SERP API. Esegui il tuo scraper o uno strumento di terze parti sui suoi IP.
Perché il mio scraper di Google Shopping continua a essere bloccato?
Google limita le richieste automatizzate ripetute da un singolo IP e mostra CAPTCHA e schermate di consenso. I proxy residential a rotazione, headers realistici, backoff esponenziale sulle risposte 429 e frequenze di richiesta ragionevoli riducono significativamente i blocchi, anche se nessun metodo li elimina del tutto.
Dovrei usare una SERP API o creare il mio scraper?
Una SERP API elimina il lavoro di parsing e sblocco a un costo per richiesta più alto e con minore controllo, ed è adatta ai team che vogliono zero manutenzione. Uno scraper fai da te su proxy a rotazione costa molto meno e offre il controllo completo, ma dovrai mantenere parser e retry quando Google cambia.
Quando DataImpulse non è la soluzione giusta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o laccesso a siti bancari e governativi, DataImpulse non è lo strumento giusto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere ai contenuti.
Inizia a fare web scraping di Google Shopping con proxy affidabili
Se sei pronto a raccogliere dati di Google Shopping in più mercati, DataImpulse ti offre IP residential, mobile e datacenter a rotazione e sticky, con targeting per paese incluso, a partire da un dollaro per GB. Crea un account e instrada il tuo primo scraper tramite un pool di IP pulito.