
In this Article
การทำ web scraping กับ Google Shopping คือการเก็บข้อมูลสินค้าแบบมีโครงสร้าง เช่น ชื่อสินค้า ราคา ผู้ขาย คะแนนรีวิว และข้อมูลการจัดส่ง จากผลการช็อปปิงของ Google ในปริมาณมาก เนื่องจากผลลัพธ์เหล่านี้มีการป้องกันสูงและปรับตามพื้นที่ การทำให้เชื่อถือได้จึงต้องสลับใช้ IP และกำหนดเป้าหมายตามภูมิศาสตร์ให้ถูกต้อง แทนที่จะใช้ scraper เดียวบนการเชื่อมต่อเดียว
คู่มือนี้เน้นโค้ดเป็นหลัก โดยครอบคลุมการส่งคำขอแบบกำหนดพื้นที่ การส่งผ่าน proxy เฉพาะประเทศ การแยกวิเคราะห์การ์ดสินค้าที่ Google ทำให้โครงสร้างอ่านยากโดยตั้งใจ การแบ่งหน้า การลองใหม่และหน่วงเวลาเมื่อเจอการจำกัดอัตรา ทางเลือก headless browser พร้อมการจัดการกล่องโต้ตอบการยินยอม โมเดลข้อมูลที่สะอาดพร้อมส่งออก CSV ตัวติดตามประวัติราคา และตารางติดตามผล นอกจากนี้ยังอธิบายความเป็นจริงของระบบต่อต้านบอต ข้อแลกเปลี่ยนระหว่าง scraper ที่ทำเองกับ SERP API แบบเสียเงิน และขอบเขตทางกฎหมายอย่างตรงไปตรงมา
DataImpulse เป็นผู้ให้บริการ proxy ที่คำนึงถึงจริยธรรม โดยมี residential proxy, mobile และ datacenter IP มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้รูปแบบจ่ายตามการใช้งาน เริ่มต้น 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกที่ไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- ราคาตามพื้นที่: หากต้องการทำ web scraping กับ Google Shopping อย่างแม่นยำ ต้องตั้งค่าพารามิเตอร์ gl และ hl และส่งคำขอผ่าน IP ในประเทศเป้าหมาย เนื่องจากราคา ผู้ขาย และความพร้อมจำหน่ายแตกต่างกันไปในแต่ละภูมิภาค
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxy ซึ่งใช้ IP ของผู้บริโภคจริงและสามารถหลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้น 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน พร้อมทราฟฟิกที่ไม่หมดอายุและไม่มีค่าสมาชิก
- ความครอบคลุม: IP ที่จัดหาตามหลักจริยธรรมมากกว่า 90M ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5, พร้อมการกำหนดเป้าหมายตามประเทศ
สามารถทำ web scraping ข้อมูลใดจาก Google Shopping ได้บ้าง?
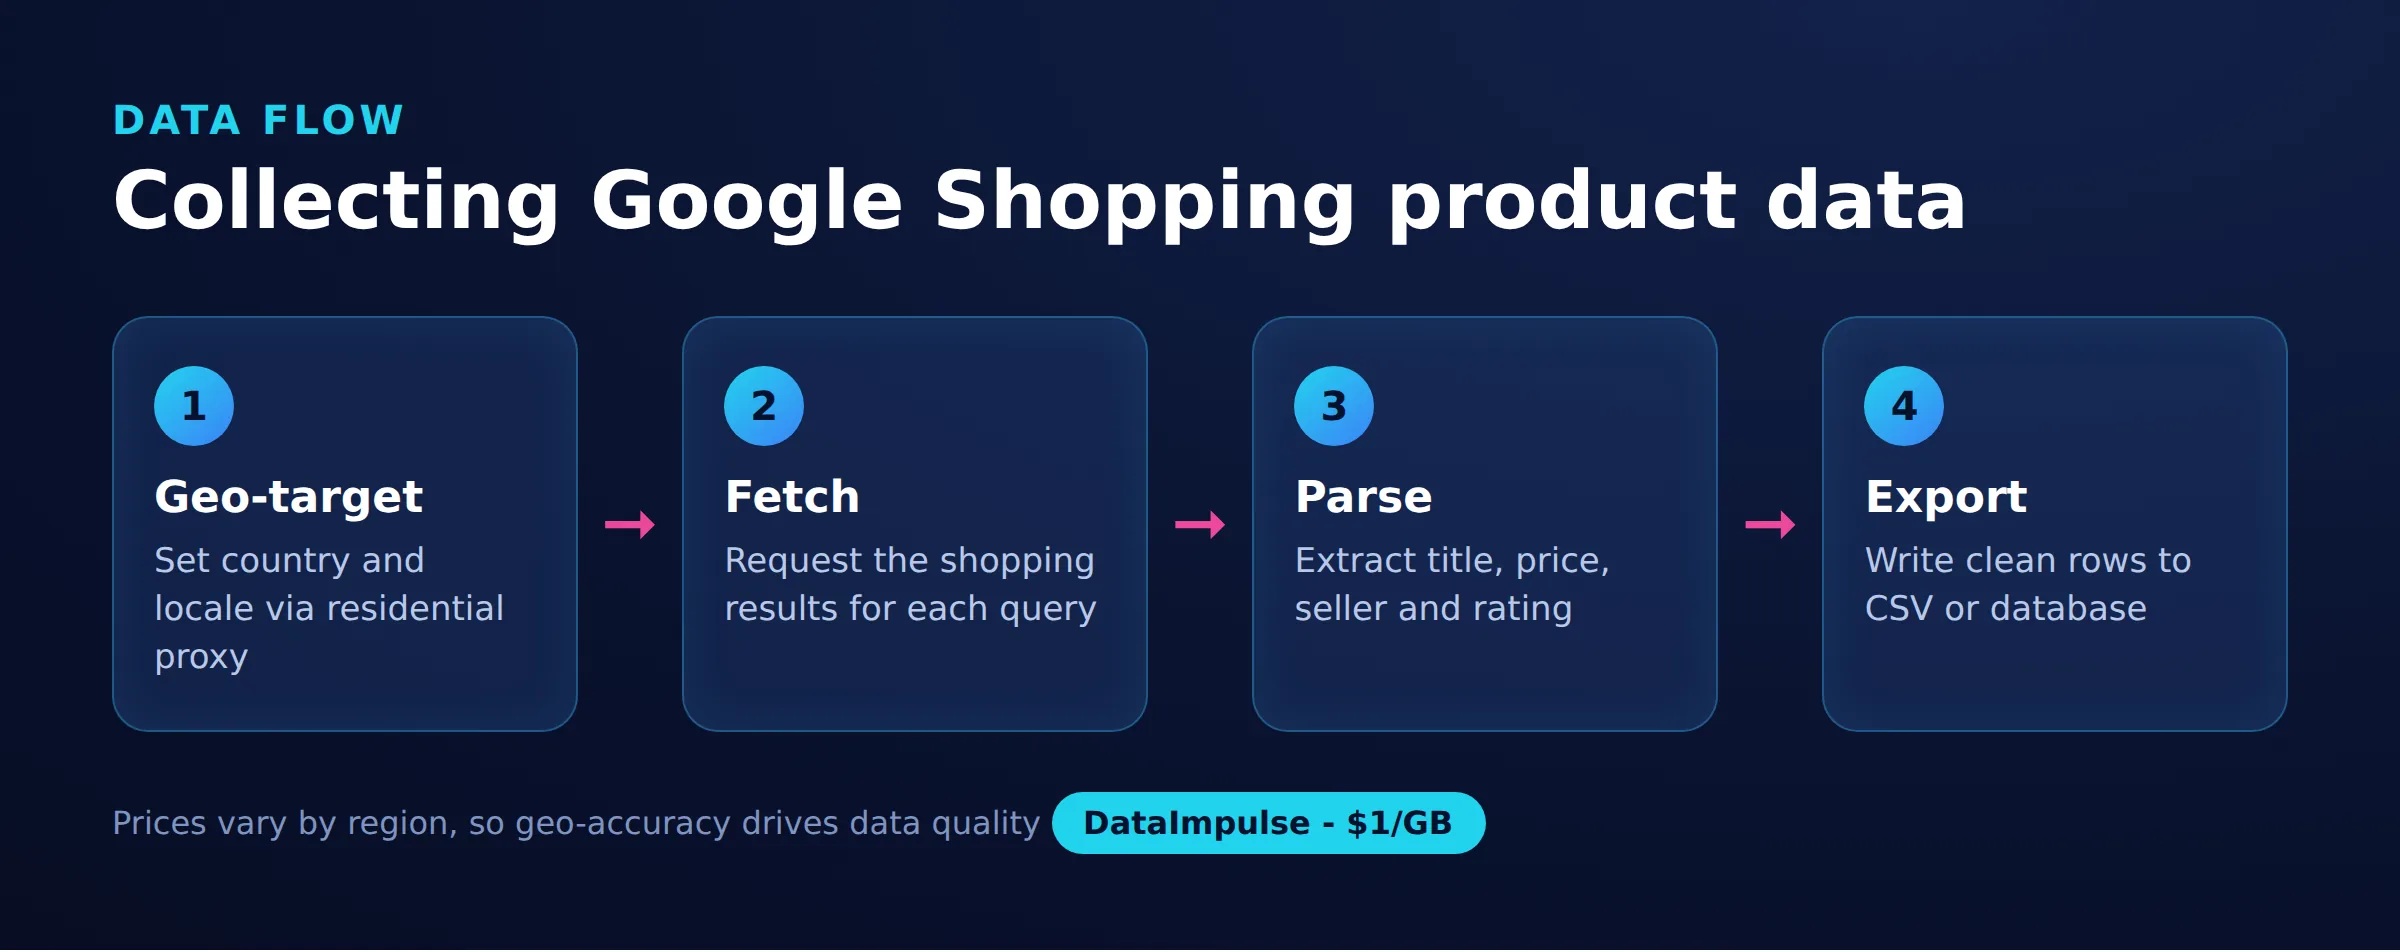
Google Shopping แสดงรายการสินค้าที่มีฟิลด์แบบมีโครงสร้างหลายรายการ ซึ่งมีประโยชน์ต่อการวิเคราะห์ราคาและการวิจัยตลาด โดยทั่วไปแต่ละผลลัพธ์มีชุดแอตทริบิวต์ที่สม่ำเสมอซึ่งสามารถดึงออกมาและปรับให้อยู่ในรูปแบบแถวได้
- รายละเอียดสินค้า: ชื่อ ข้อความสรุปคำอธิบาย แบรนด์ รุ่น และ URL รูปภาพสินค้า
- ราคา: ราคาที่แสดง สกุลเงิน และบางครั้งคือช่วงราคาจากผู้ขายหลายราย
- ผู้ขาย: ชื่อร้านค้า และในหน้ารายละเอียดสินค้า จะมีรายชื่อผู้ขายคู่แข่งที่เสนอสินค้าชิ้นเดียวกัน
- คะแนนและรีวิว: คะแนนดาวรวมและจำนวนรีวิวเมื่อมีข้อมูล
- ความพร้อมจำหน่ายและการจัดส่ง: สถานะสต็อกและหมายเหตุการจัดส่งที่แตกต่างกันตามภูมิภาค
ฟิลด์ที่แน่นอนเปลี่ยนไปทุกครั้งที่ Google อัปเดตเลย์เอาต์ ดังนั้น parser ต้องรองรับค่าที่หายไปและ markup ที่เปลี่ยนแปลงได้ ควรมองทุกฟิลด์เป็นข้อมูลทางเลือก และตรวจสอบชนิดข้อมูลหลังดึงออกมา แทนที่จะสมมติว่าจะมีคะแนนหรือผู้ขายเสมอ เนื่องจากสินค้าเดียวกันอาจปรากฏในราคาที่ต่างกันในแต่ละประเทศ จึงควรวาง schema โดยใช้คีย์ (สินค้า ประเทศ เวลาเก็บข้อมูล) ตั้งแต่แรก แทนที่จะค่อยเพิ่มข้อมูลภูมิศาสตร์ภายหลัง
จะส่งคำขอแบบกำหนดพื้นที่ไปยัง Google Shopping ได้อย่างไร?
คุณส่งคำขอแบบกำหนดพื้นที่โดยเรียก endpoint การค้นหาของ Google พร้อมแฟล็กแท็บช็อปปิงและพารามิเตอร์ locale จากนั้นใช้สัญญาณจาก IP และพารามิเตอร์แบบเดียวกับผู้ซื้อจริง พารามิเตอร์ที่สำคัญที่สุดสองตัวคือ gl (ประเทศ เช่น gl=de สำหรับเยอรมนี) และ hl (ภาษาของอินเทอร์เฟซ เช่น hl=de) อีกตัวที่มีประโยชน์คือคำแบบ location ที่ใส่รวมในบริบทคำค้น แต่ gl พร้อม IP ขาออกที่สอดคล้องกันจะทำงานส่วนใหญ่ได้
การตั้งค่าพารามิเตอร์เพียงอย่างเดียวยังไม่พอ เพราะ Google อ่าน IP ของคำขอด้วยเพื่อเลือกว่าจะแสดงราคาและผู้ขายใด คำขอขั้นต่ำด้านล่างส่ง headers ที่สมจริงและคู่ locale โดยตั้งใจไม่ใช้ proxy เพื่อให้เห็นการเรียกพื้นฐานก่อนเพิ่มชั้น IP
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
ให้ Accept-Language สอดคล้องกับ hl หน้าแสดงราคาของเยอรมนีที่ขอด้วย header ภาษาอังกฤษไม่สอดคล้องกัน ทั้งดูไม่เป็นธรรมชาติและอาจคืนสกุลเงินผิด เมื่อขยายขนาดงาน ฟังก์ชันพื้นฐานนี้จะเป็นจุดเดียวที่กำหนด locale ซึ่งทำให้ทุกการเรียกในขั้นตอนถัดไปสอดคล้องกัน
จะส่งคำขอผ่าน proxy ที่กำหนดเป้าหมายตามประเทศได้อย่างไร?
คุณส่งผ่าน proxy ที่กำหนดเป้าหมายตามประเทศได้ด้วยการชี้ requests ไปยัง gateway เดียวและเข้ารหัสประเทศเป้าหมายไว้ในชื่อผู้ใช้ proxy โดย DataImpulse ใช้ gateway gw.dataimpulse.com:823 และการต่อท้าย __cr.us หรือ __cr.de ในชื่อผู้ใช้จะเลือกประเทศของ IP ขาออก การกำหนดเป้าหมายตามประเทศรวมอยู่ในราคาพื้นฐาน ส่วนการกำหนดเป้าหมายตามรัฐ เมือง ZIP และ ASN เป็นส่วนเสริมแบบเสียค่าใช้จ่าย หากยังไม่คุ้นกับการยืนยันตัวตนของ proxy คู่มือเรื่อง การยืนยันตัวตนของ proxy อธิบายกลไกชื่อผู้ใช้และรหัสผ่านอย่างละเอียด
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
หลักปฏิบัติสำคัญคือเปลี่ยนประเทศของ proxy และคู่ gl/hl พร้อมกัน หากต้องการสร้างการเปรียบเทียบราคาระหว่างตลาด ให้วนผ่านรายชื่อประเทศและทำให้ IP ขาออกกับ locale สอดคล้องกัน เพื่อให้ทุกการตอบกลับสะท้อนตำแหน่งผู้ซื้อที่สม่ำเสมอเพียงตำแหน่งเดียว
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse ให้บริการชั้น IP ไม่ใช่บริการ scraping แบบมีผู้ดูแล ดังนั้นคุณเป็นผู้รับผิดชอบ scraper เอง rotating residential proxy มักเหมาะกับงานนี้ เพราะมาจากอุปกรณ์ของผู้บริโภคจริง ส่วน datacenter proxy มีราคาถูกกว่าแต่ถูกตรวจพบได้ง่ายกว่า และ mobile proxy มี IP ระดับผู้ให้บริการเครือข่ายสำหรับเป้าหมายที่ยากที่สุด
จะแยกวิเคราะห์การ์ดสินค้าของ Google Shopping ได้อย่างไร?
ให้แยกวิเคราะห์การ์ดสินค้าด้วยไลบรารี HTML ที่ทนต่อความคลาดเคลื่อน และยึดรูปแบบข้อความที่เสถียรแทน selector แบบลึกที่เปราะบาง เพราะชื่อ class ของ Google ถูกทำให้อ่านยากและเปลี่ยนหมุนเวียนบ่อย selector ใดก็ตามที่คัดลอกจาก dev tools ของเบราว์เซอร์วันนี้อาจใช้ไม่ได้ภายในไม่กี่สัปดาห์ ดังนั้นให้สร้าง parser ที่ลดระดับการทำงานได้อย่างนุ่มนวลแทนที่จะล้มเหลวเมื่อเลย์เอาต์เปลี่ยน
แนวทางที่ทนทานคืออ่านการ์ดที่เป็นไปได้แต่ละใบ ดึงชื่อและรูปภาพจากโครงสร้าง tag และแยกราคาด้วย regular expression ที่รู้จักสกุลเงิน selector ด้านล่างเป็นตัวอย่างที่สมจริง ไม่ใช่การรับประกัน ควรเตรียมอัปเดตและเก็บ regex ไว้เป็นทางเลือกสำรองที่เชื่อถือได้
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
เนื่องจาก markup ที่ถูกทำให้อ่านยากเป็นเรื่องปกติในกรณีนี้ บางทีมจึงเลือกใช้ DOM ที่เรนเดอร์แล้วแทน สำหรับข้อแลกเปลี่ยนในภาพรวมระหว่างการแยกวิเคราะห์ HTML แบบคงที่กับหน้าที่เรนเดอร์แล้ว ดูคู่มือ การทำ web scraping หน้าที่เปลี่ยนแปลงแบบไดนามิก.
จะแบ่งหน้าและหน่วงเวลาเมื่อ Google ส่งกลับ 429 ได้อย่างไร?
คุณแบ่งหน้าโดยเลื่อนค่า start เป็นขั้นให้สอดคล้องกับขนาดหน้า และรับมือการจำกัดอัตราโดยถือว่า HTTP 429 (รวมถึงการตอบกลับว่างเปล่าหรือ CAPTCHA) เป็นสัญญาณให้รอและลองใหม่ผ่าน IP ใหม่ Google จำกัดคำขออัตโนมัติซ้ำๆ อย่างเข้มงวด ดังนั้นการแบ่งหน้าและ backoff ควรอยู่ในลูปเดียวกัน
ไล่ไปทีละหน้าจนกว่าคำขอจะไม่ส่งการ์ดกลับมา หรือถึงขีดจำกัดจำนวนหน้า สลับ IP ขาออกระหว่างหน้าด้วยการอ่าน proxy dict ใหม่ และตรวจจับการบล็อกแบบไม่ชัดเจนด้วยการตรวจหาเครื่องหมาย consent หรือ CAPTCHA ในเนื้อหา แทนที่จะเชื่อรหัสสถานะเพียงอย่างเดียว
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
ตัวช่วยลองใหม่ด้านล่างใช้ exponential backoff ร่วมกับ jitter ซึ่งกระจายการลองใหม่ออกไปเพื่อไม่ให้ worker ที่ถูกบล็อกพร้อมกันลองใหม่ในเวลาเดียวกัน ทุกครั้งที่พยายามจะดึง proxy dict ใหม่ จึงทำให้ rotating pool ส่ง IP ใหม่ให้ในการลองครั้งถัดไป
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
ควรรักษาอัตราคำขอให้อยู่ในระดับเหมาะสมแม้การลองใหม่จะสำเร็จ ระยะหน่วงพื้นฐานที่สุภาพระหว่างหน้า ร่วมกับการสลับ IP ช่วยให้เสถียรระยะยาวมากกว่าการยิงคำขอรัวๆ แล้วหวังพึ่งการลองใหม่ เอกสารของเราเรื่อง แนวปฏิบัติที่ดีสำหรับ web scraping อธิบายการกำหนดจังหวะและการดูแล headers อย่างละเอียด
จะเรนเดอร์หน้าที่ถูกบล็อกด้วย headless browser ได้อย่างไร?
เมื่อคำขอ HTTP ปกติยังคงพบกำแพง consent หรือเนื้อหาที่ JavaScript เรนเดอร์ ให้ใช้ headless browser เป็นทางเลือก ซึ่งเรียกใช้งานหน้าเหมือนไคลเอนต์จริงและปิดกล่องโต้ตอบ consent ก่อนอ่าน DOM โดย Playwright เหมาะสมเพราะรองรับ proxy แยกตาม context และการรอที่เชื่อถือได้
สคริปต์ด้านล่างเปิด Chromium ผ่าน DataImpulse proxy ที่กำหนดเป้าหมายตามประเทศ จัดการกล่องโต้ตอบ cookie หรือ consent ที่ locale ในยุโรปมักแสดง รอเนื้อหา แล้วคืน HTML ที่เรนเดอร์แล้ว เพื่อให้ส่งเข้า parse_cards ฟังก์ชันเดิมได้
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
headless browser ใช้ CPU และหน่วยความจำมากกว่าคำขอแบบ raw จึงควรใช้เป็นทางเลือกเฉพาะหน้าที่จำเป็นต้องเรนเดอร์จริง แทนที่จะใช้เป็นเส้นทางเริ่มต้น หลายทีมใช้ HTTP โดยตรงเพื่อความเร็ว และยกระดับไปใช้ Playwright เฉพาะเมื่อ is_blocked ยังคงเกิดขึ้น หาก stack ของคุณใช้ JavaScript แทน Python ก็ใช้รูปแบบเดียวกันกับ Puppeteer ได้ ดู การทำ web scraping ด้วย JavaScript.
จะจัดโครงสร้างและส่งออกข้อมูลที่ทำ web scraping มาได้อย่างไร?
ให้จัดโครงสร้างข้อมูลโดยมี record ที่เสถียรซึ่งรวมตลาดและเวลาที่เก็บข้อมูลเสมอ จากนั้นส่งออกเป็น CSV เพื่อให้เปรียบเทียบความต่าง โหลดเข้า spreadsheet หรือส่งเข้า warehouse ได้ง่าย dataclass ให้ type hints และคำนิยามแถวที่ชัดเจนเพียงหนึ่งเดียว
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
จากนั้นการเขียน CSV คือการส่งออกฟิลด์ของ dataclass โดย append mode ร่วมกับ header-guard ช่วยให้ job ตามกำหนดเวลาเพิ่มข้อมูลในไฟล์เดียวเมื่อเวลาผ่านไปโดยไม่ต้องเขียนทับทั้งไฟล์
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
การเก็บประเทศและเวลาที่บันทึกไว้ในทุกแถวจะช่วยให้ภายหลังตอบคำถามได้ว่า วันนี้ตลาดใดถูกที่สุดสำหรับ SKU หรือราคาขยับอย่างไรในสัปดาห์นี้ คีย์ด้านภูมิศาสตร์และเวลานี้คือพื้นฐานของตัวติดตามประวัติราคาในส่วนถัดไป
จะติดตามประวัติราคา Google Shopping ตามเวลาได้อย่างไร?
คุณติดตามประวัติราคาด้วยการ upsert ข้อมูลที่สังเกตได้แต่ละครั้งลงในฐานข้อมูลขนาดเล็ก โดยใช้สินค้า ประเทศ และวันเป็นคีย์ ดังนั้นการเรียก scraper ซ้ำจะอัปเดตแถวของวันนี้แทนการสร้างข้อมูลซ้ำ ขณะเดียวกันยังเก็บวันก่อนหน้าไว้ SQLite รองรับข้อมูลนับล้านแถวได้และไม่ต้องมี server ทำให้ job ติดตามผลทำงานได้อย่างอิสระ
schema ด้านล่างใช้ unique key แบบผสมและ ON CONFLICT ในการ upsert การเรียก scraper สองครั้งในวันเดียวจะเขียนทับราคาล่าสุดของ (สินค้า ประเทศ วัน) นั้น การเรียกข้ามวันจะสร้างอนุกรมเวลาที่นำไปสร้างกราฟภายหลังได้
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
ในทางปฏิบัติ การจับคู่ชื่อตลอดหลายวันเป็นส่วนที่ยาก เพราะชื่อของ Google แตกต่างเล็กน้อยในแต่ละครั้งที่เก็บข้อมูล สำหรับ watchlist ขนาดเล็ก ให้ map ชื่อดิบไปยัง product id มาตรฐานที่ควบคุมได้ก่อน upsert แทนที่จะเชื่อชื่อที่ทำ web scraping มาเป็นคีย์ที่เสถียร
จะกำหนดเวลาการติดตามราคาอย่างต่อเนื่องได้อย่างไร?
คุณกำหนดเวลาติดตามผลด้วยการรวมขั้นตอน fetch-parse-store ไว้ใน entry point เดียว และเรียกตามจังหวะคงที่ด้วย cron เพื่อให้ราคารีเฟรชอัตโนมัติโดยไม่ต้องเรียกเอง การเรียกวันละครั้งเป็นค่าเริ่มต้นที่เหมาะสมสำหรับการติดตามราคา การเรียกถี่กว่านั้นเพิ่มทั้งต้นทุนและความเสี่ยงถูกบล็อก โดยไม่ได้เพิ่มสัญญาณมากนักสำหรับ catalog ส่วนใหญ่
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
จากนั้นลงทะเบียนกับ cron รายการด้านล่างเรียกตัวติดตามทุกวันเวลา 06:15 และบันทึกผลลัพธ์ลง log สำหรับ debugging ซึ่งสำคัญเพราะ scraper ที่ตั้งเวลาไว้อาจล้มเหลวโดยไม่มีสัญญาณอื่น
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
เพิ่ม jitter เล็กน้อยใน job เช่น sleep แบบสุ่มไม่กี่นาทีตอนเริ่ม เพื่อไม่ให้คำขอไปถึง Google ในวินาทีตามนาฬิกาเดียวกันทุกวัน สลับประเทศของ IP ขาออกและกำหนดจังหวะคำขอตามที่อธิบายไว้ก่อนหน้า และคอยดู log ว่าอัตราการบล็อกเพิ่มขึ้นหรือไม่ ซึ่งเป็นสัญญาณแรกสุดว่า Google เปลี่ยนการป้องกัน หรือรูปแบบของคุณสม่ำเสมอเกินไป
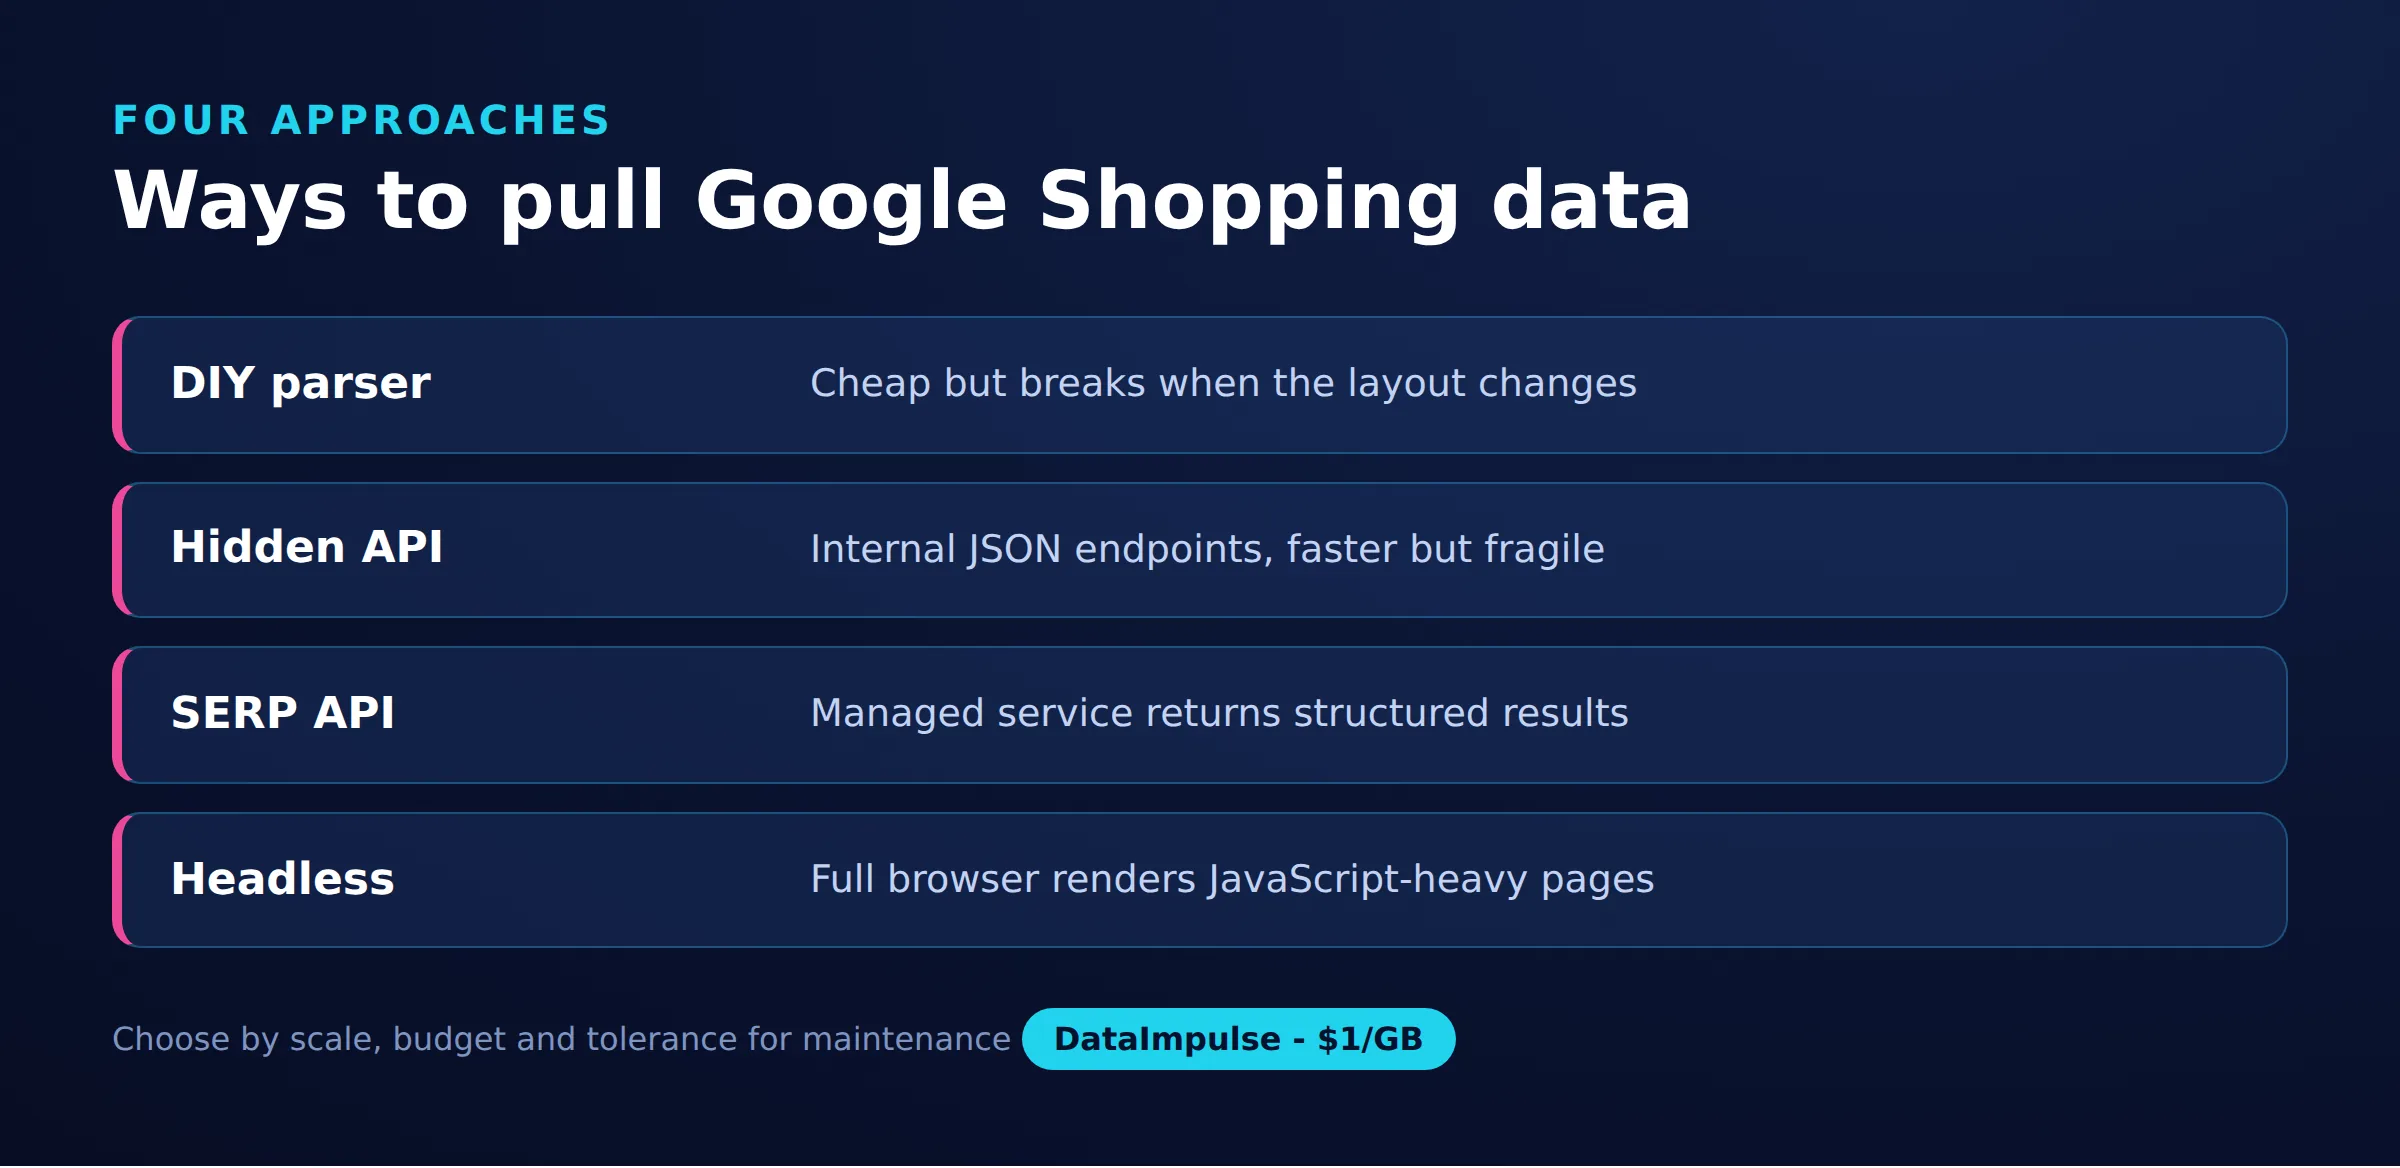
ควรเลือกแนวทางเก็บข้อมูลใด: DIY, hidden endpoints, SERP API หรือ headless?
เลือกตามระดับความเปราะบางและภาระด้านวิศวกรรมที่คุณยอมรับได้ เทียบกับจำนวนเงินที่ยอมจ่ายต่อคำขอ ไม่มีคำตอบเดียวที่ถูกต้อง ข้อแลกเปลี่ยนที่แท้จริงคือการควบคุมและต้นทุน เทียบกับภาระการบำรุงรักษาและการเผชิญระบบต่อต้านบอต
ความเป็นจริงของระบบต่อต้านบอต: Google ป้องกันผลลัพธ์เหล่านี้อย่างจริงจังด้วยการจำกัดอัตรา CAPTCHAs กำแพง consent markup ที่ถูกทำให้อ่านยากและเปลี่ยนหมุนเวียน รวมถึงสัญญาณพฤติกรรม scraper ที่ทำเองทุกรายจะใช้ไม่ได้เป็นระยะและต้องบำรุงรักษาต่อเนื่อง proxy และ backoff ลดการบล็อกได้ แต่ไม่กำจัดการบล็อก ผู้ที่รับประกันว่า Google scraper จะไม่ถูกบล็อกอย่างถาวรกำลังกล่าวเกินจริง
| แนวทาง | ต้นทุน | ความเปราะบาง | การควบคุม |
|---|---|---|---|
| การแยกวิเคราะห์ HTML แบบ DIY | ต่ำ (เฉพาะ proxy) | สูง | เต็มรูปแบบ |
| hidden JSON endpoints | ต่ำ (เฉพาะ proxy) | สูงมาก | เต็มรูปแบบ |
| SERP API | สูง (ต่อคำขอ) | ต่ำ | จำกัด |
| headless browser | ปานกลาง (ประมวลผล + proxy) | ปานกลาง | เต็มรูปแบบ |
SERP API เทียบกับ DIY: SERP API ของบุคคลที่สามจะคืนผลช็อปปิงที่แยกวิเคราะห์แล้วเป็น JSON และรับภาระงานแยกวิเคราะห์กับการปลดบล็อกแทนคุณ โดยคิดราคาต่อคำขอ แต่มี vendor lock-in และควบคุมสิ่งที่ดึงมาได้ลดลง scraper ที่ทำเองบน proxy มีต้นทุนต่อคำขอต่ำกว่ามากและให้การควบคุมเต็มรูปแบบ แต่คุณต้องดูแล parser การลองใหม่ และการบำรุงรักษาเมื่อ Google เปลี่ยนแปลง เพื่อให้ชัดเจนว่า DataImpulse อยู่ส่วนใด: เป็นชั้น proxy ใต้แนวทาง DIY เหล่านี้ ไม่ใช่ SERP API และไม่ใช่บริการ scraping แบบมีผู้ดูแล หากต้องการไม่ต้องทำงานแยกวิเคราะห์เลย SERP API คือคำแนะนำที่ตรงไปตรงมา หากต้องการต้นทุนต่ำและการควบคุม และสามารถดูแล scraper ได้ DIY บน rotating proxy มีความคุ้มค่ากว่า hidden JSON endpoints อาจถูกกว่าอีก แต่เปราะบางที่สุด เพราะ Google สามารถเปลี่ยนหรือลบได้โดยไม่แจ้งล่วงหน้า
การทำ web scraping กับ Google Shopping ถูกต้องและมีจริยธรรมหรือไม่?
โดยทั่วไปการทำ web scraping ข้อมูลสินค้าที่มองเห็นได้สาธารณะถือว่ามีความเสี่ยงต่ำกว่าการเข้าถึงเนื้อหาส่วนตัวหรือมีการจำกัด แต่ไม่ได้ปราศจากกฎเกณฑ์ และนี่ไม่ใช่คำแนะนำทางกฎหมาย ราคาและรายการบน Google Shopping เป็นข้อมูลสาธารณะ แต่ยังต้องคำนึงถึงวิธีเก็บและใช้ข้อมูล และควรยืนยันกรณีเฉพาะของตนกับที่ปรึกษากฎหมายผู้มีคุณสมบัติเหมาะสม
- ข้อกำหนดการให้บริการ: การเข้าถึงแบบอัตโนมัติอาจขัดกับข้อกำหนดของ Google ซึ่งเป็นเรื่องตามสัญญาที่แยกจากกฎหมายลิขสิทธิ์หรือกฎหมายการเข้าถึงระบบคอมพิวเตอร์
- ข้อมูลส่วนบุคคล: รายการสินค้ามักไม่ใช่ข้อมูลส่วนบุคคล แต่ควรหลีกเลี่ยงการเก็บชื่อผู้รีวิวหรือข้อมูลระบุตัวตนอื่น และปฏิบัติตาม GDPR ในกรณีที่ใช้บังคับ
- อัตราและภาระระบบ: รักษาปริมาณคำขอให้อยู่ในระดับเหมาะสม เพื่อไม่ให้บริการที่กำลังเรียกใช้งานเสื่อมประสิทธิภาพ
- การใช้ข้อมูล: การนำรูปภาพหรือคำอธิบายที่มีลิขสิทธิ์มาใช้ซ้ำทั้งหมดมีความเสี่ยงมากกว่าการวิเคราะห์ราคาในฐานะข้อเท็จจริง
ในด้านการเก็บข้อมูล จริยธรรมเริ่มจาก IP ที่คุณใช้ DataImpulse จัดหา IP จากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน สอดคล้องกับ GDPR และมีข้อตกลงการประมวลผลข้อมูล ซึ่งสนับสนุน pipeline ที่มีเหตุผลรองรับ สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับการยินยอม การจัดหา และแนวปฏิบัติอย่างรับผิดชอบ ดูคู่มือ web scraping อย่างมีจริยธรรม. เมื่อใช้แหล่ง IP ที่มีจริยธรรมร่วมกับการกำหนดจังหวะอย่างสุภาพและการใช้ข้อมูลอย่างจำกัดตามข้อเท็จจริง คุณจะรักษาทั้งความเสี่ยงทางกฎหมายและความเสี่ยงด้านชื่อเสียงให้อยู่ในระดับต่ำได้
คำถามที่พบบ่อย
จำเป็นต้องใช้ residential proxy เพื่อทำ web scraping กับ Google Shopping หรือไม่?
residential proxy เป็นตัวเลือกที่น่าเชื่อถือที่สุด เพราะใช้ IP ของผู้บริโภคจริงที่กลมกลืนกับทราฟฟิกปกติ datacenter proxy อาจใช้ได้กับปริมาณงานไม่มาก แต่ตรวจจับและบล็อกได้ง่ายกว่า
จะรับราคาตามพื้นที่จาก Google Shopping ได้อย่างไร?
ตั้งค่าพารามิเตอร์ gl และ hl เป็นประเทศและภาษาปลายทาง แล้วส่งคำขอผ่าน proxy IP ในประเทศเดียวกันโดยใช้รูปแบบประเทศ เช่น ชื่อผู้ใช้ที่ลงท้ายด้วย __cr.de สำหรับเยอรมนี Google อ่านทั้งพารามิเตอร์และ IP ของคำขอเพื่อตัดสินใจว่าจะแสดงราคาใด
DataImpulse เป็น API สำหรับทำ web scraping กับ Google Shopping หรือไม่?
ไม่ใช่ DataImpulse ให้บริการชั้น proxy ได้แก่ residential proxy, mobile และ datacenter IP ไม่ใช่บริการ scraping แบบมีผู้ดูแลหรือ SERP API คุณเรียกใช้ scraper ของตนเองหรือเครื่องมือของบุคคลที่สามบน IP เหล่านี้
เหตุใด Google Shopping scraper ของฉันจึงถูกบล็อกอยู่เรื่อยๆ?
Google จำกัดคำขออัตโนมัติซ้ำๆ จาก IP เดียว และแสดง CAPTCHAs กับกำแพง consent การใช้ rotating residential proxy, headers ที่สมจริง, exponential backoff สำหรับการตอบกลับ 429 และอัตราคำขอที่เหมาะสม ช่วยลดการบล็อกได้อย่างมาก แม้ไม่มีวิธีใดกำจัดได้ทั้งหมด
ควรใช้ SERP API หรือสร้าง scraper เอง?
SERP API ช่วยตัดงานแยกวิเคราะห์และปลดบล็อกออกไป แต่มีต้นทุนต่อคำขอสูงกว่าและควบคุมได้น้อยกว่า จึงเหมาะกับทีมที่ไม่ต้องการบำรุงรักษาเลย scraper ที่ทำเองบน rotating proxy มีต้นทุนต่ำกว่ามากและควบคุมได้เต็มที่ แต่คุณต้องดูแล parser และการลองใหม่เมื่อ Google เปลี่ยนแปลง
เมื่อใดที่ DataImpulse ไม่ใช่ตัวเลือกที่เหมาะสม?
หากต้องการ ISP proxy แบบคงที่, scraping API ที่มีผู้ดูแลครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและหน่วยงานรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น rotating residential proxy, mobile และ datacenter proxy สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
เริ่มทำ web scraping กับ Google Shopping ด้วย proxy ที่เชื่อถือได้
หากพร้อมเก็บข้อมูล Google Shopping ข้ามตลาด DataImpulse มี rotating และ sticky residential proxy, mobile และ datacenter IP พร้อมการกำหนดเป้าหมายตามประเทศ เริ่มต้น 1 ดอลลาร์ต่อ GB สร้างบัญชี แล้วส่ง scraper ตัวแรกผ่าน IP pool ที่สะอาด