
In this Article
การเรียนรู้วิธีขูดหน้าเว็บแบบไดนามิกหมายถึงการจัดการกับเนื้อหาที่ไม่มีอยู่ใน HTML คำขอดาวน์โหลดครั้งแรกของคุณ ไซต์สมัยใหม่สร้างตารางผลิตภัณฑ์ ราคา ความคิดเห็น และฟีดในเบราว์เซอร์โดยใช้ JavaScript ดังนั้นการดึงข้อมูล HTTP ธรรมดาจะส่งคืนเชลล์ว่างในตำแหน่งที่ข้อมูลควรอยู่
คู่มือนี้จะอธิบายขั้นตอนการทำงานทั้งหมดใน Python เริ่มต้นด้วยการตรวจจับเนื้อหาแบบไดนามิกโดยกระจายการตอบสนองดิบกับ DOM ที่แสดงผล จากนั้นจัดอันดับตัวเลือกการแยกจากที่ถูกที่สุดไปหนักที่สุด: ค้นหา JSON API ที่ซ่อนอยู่ ขับ Playwright หรือ Selenium จัดการกับการเลื่อนที่ไม่มีที่สิ้นสุดและปุ่มโหลดเพิ่มเติม การตัด proxy แบนด์วิธ เพิ่มการลองใหม่ การขูดพร้อมกัน และการส่งออก JSON และ CSV ที่สะอาดหมดจด
DataImpulse เป็นผู้ให้บริการ proxy ที่มีจริยธรรมซึ่งนำเสนอที่อยู่อาศัยมากกว่า 90 ล้านแห่ง, mobile และ datacenter IP ใน 195 ประเทศ ใช้โมเดลการจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB โดยมีปริมาณการใช้งานที่ไม่มีวันหมดอายุ และใช้สำหรับ web scraping , ad verification การตรวจสอบราคา การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- การขูดแบบไดนามิก: เนื้อหาที่สร้างโดย JavaScript หายไปจากไฟล์ HTML ดิบ ดังนั้นคุณจึงเรียก JSON API ที่เป็นต้นแบบว่าเพจดึงข้อมูลหรือแสดงผลเพจในเบราว์เซอร์ที่ไม่มีส่วนหัว
- ประเภท proxy ที่ดีที่สุด: การหมุน residential proxies ซึ่งใช้ IP ของผู้บริโภคจริงที่ผ่านการตรวจจับ
- ราคา: ตั้งแต่ 1 ดอลลาร์ต่อ GB จ่ายตามที่ใช้งาน โดยมีการรับส่งข้อมูลที่ไม่มีวันหมดอายุและไม่มีการสมัครสมาชิก
- ความคุ้มครอง: 90 ล้านรายการ พร้อมด้วย IP ที่มาจากแหล่งที่มาอย่างมีจริยธรรมใน 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP , HTTPS และ SOCKS5 โดยรวมการกำหนดเป้าหมายประเทศด้วย
อะไรทำให้เว็บเพจมีไดนามิก?
เพจเป็นไดนามิกเมื่อเนื้อหาที่มีความหมายถูกสร้างขึ้นโดย JavaScript ในเบราว์เซอร์ แทนที่จะส่งในการตอบกลับ HTML เริ่มต้น เซิร์ฟเวอร์ส่งโครงสร้างน้ำหนักเบา จากนั้นโค้ดฝั่งไคลเอ็นต์จะดึงข้อมูลและแทรกลงใน DOM หลังจากเปิดเพจ
การตรวจสอบด้วยตนเองที่เร็วที่สุดคือการเปรียบเทียบสองมุมมองในหน้าเดียวกัน คลิกขวาและเลือก ดูซอร์สของหน้า เพื่อดูข้อมูลดิบของ HTML ที่เซิร์ฟเวอร์ส่งคืน จากนั้นเปิดเครื่องมือสำหรับนักพัฒนาซอฟต์แวร์และตรวจสอบแผงองค์ประกอบ ซึ่งแสดง DOM แบบสดหลังจากที่สคริปต์ทำงานแล้ว หากราคาหรือรายการที่คุณต้องการปรากฏในแผงองค์ประกอบ แต่ไม่มีอยู่ใน ดูซอร์สของหน้า เนื้อหาจะเป็นแบบไดนามิกและคำขอเดียวจะไม่บันทึกข้อมูลดังกล่าว
- เนื้อหาแบบคงที่ มีอยู่ใน ดูซอร์สของหน้า และสามารถแยกวิเคราะห์ได้โดยตรงจากการตอบสนอง HTTP
- เนื้อหาแบบไดนามิก ปรากฏเฉพาะใน DOM ที่แสดงผล และโหลดผ่านการร้องขอเบื้องหลัง
คุณสามารถทำให้การวินิจฉัยนี้เป็นโค้ดโดยอัตโนมัติ ขั้นแรก ให้นับองค์ประกอบเป้าหมายใน HTML แบบดิบที่ไคลเอ็นต์ HTTP ปกติดาวน์โหลด:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=30)
soup = BeautifulSoup(resp.text, "html.parser")

raw_cards = soup.select("div.product-card")
print("Cards in raw HTML:", len(raw_cards))

# If this prints 0 but the page clearly shows products in a browser,
# the content is injected by JavaScript and the page is dynamic.
จากนั้นเรนเดอร์ URL เดียวกันในเบราว์เซอร์ที่ไม่มีส่วนหัวแล้วนับอีกครั้ง ความแตกต่างระหว่างตัวเลขทั้งสองคือข้อพิสูจน์:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://example.com/products", wait_until="networkidle")
    rendered_cards = page.query_selector_all("div.product-card")
    print("Cards after JavaScript runs:", len(rendered_cards))
    browser.close()

# Raw HTML 0, rendered DOM 48 means the page builds its content dynamically.
ก่อนที่คุณจะเขียนสแครปเปอร์แบบเต็ม คุณควรยืนยันว่าเป้าหมายอนุญาตการเข้าถึงแบบอัตโนมัติด้วย คำแนะนำของเราเกี่ยวกับวิธีการ ตรวจสอบว่าเว็บไซต์อนุญาตให้ทำการขูดหรือไม่ ครอบคลุมการอ่านกฎของโรบ็อตและข้อกำหนดในการให้บริการ
คุณควรใช้วิธีใดในการขูดหน้าไดนามิก
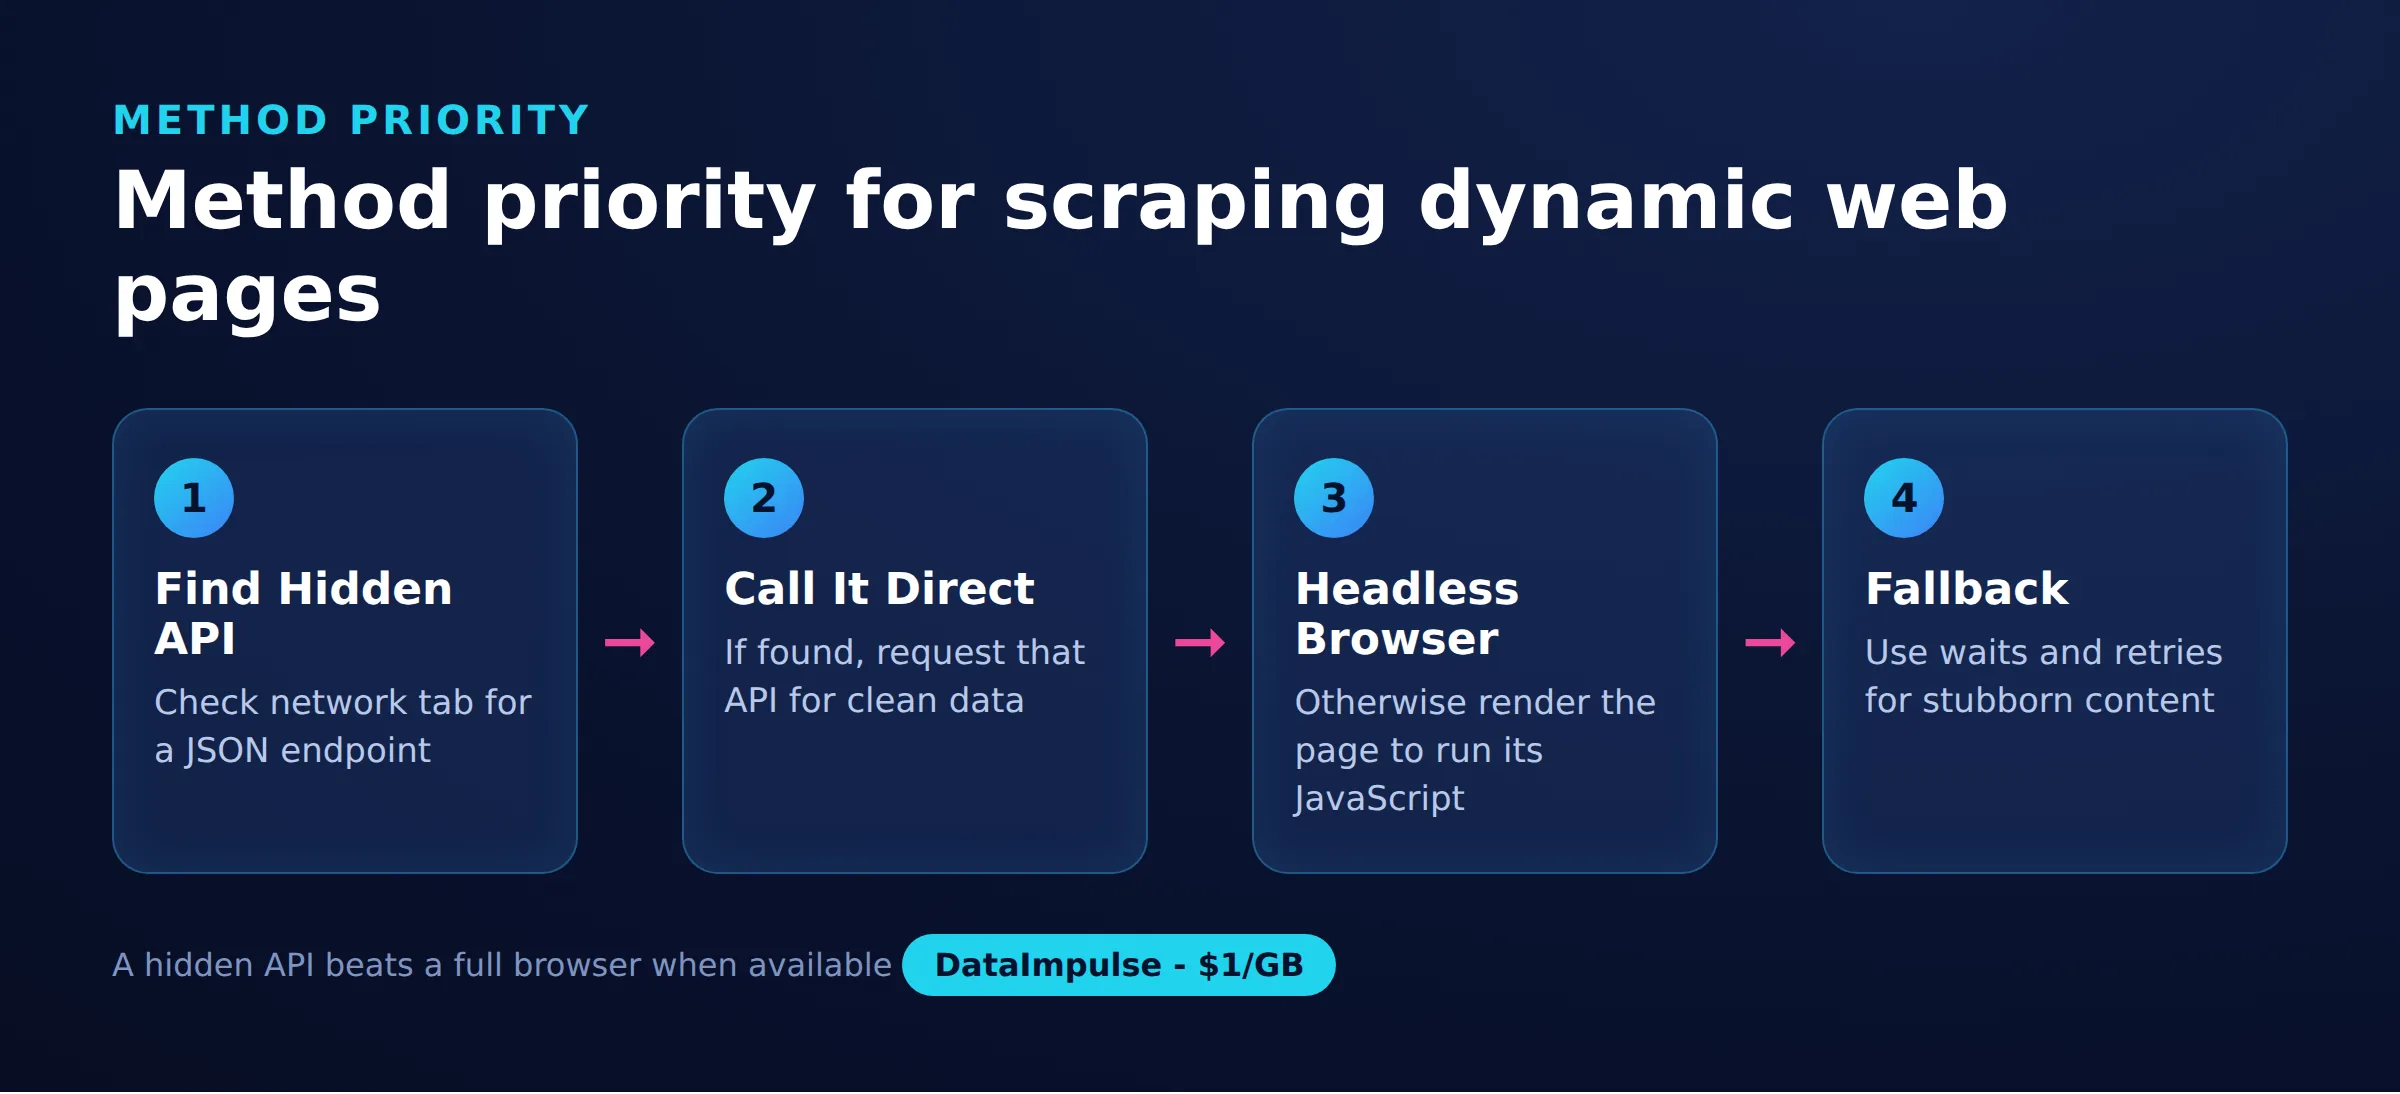
เลือกวิธีที่เบาที่สุดที่ส่งคืนข้อมูลได้อย่างน่าเชื่อถือ: เรียก JSON API ที่ซ่อนอยู่เมื่อมีอยู่ และกลับไปใช้เบราว์เซอร์ที่ไม่มีส่วนหัวเฉพาะเมื่อไม่มีอยู่ แต่ละตัวเลือกจะแลกความเร็วและต้นทุนกับจำนวนหน้าที่สามารถสร้างซ้ำได้
ตารางด้านล่างเปรียบเทียบวิธีการทั่วไปสี่วิธี เพื่อให้คุณสามารถเลือกก่อนเขียนโค้ดได้ ในทางปฏิบัติ โปรเจ็กต์ส่วนใหญ่รวมสองโปรเจ็กต์เข้าด้วยกัน โดยใช้ API ที่ซ่อนอยู่สำหรับการโหลดจำนวนมากและเบราว์เซอร์สำหรับเพจที่ต่อต้าน
| วิธี | ความเร็ว | ค่าใช้จ่าย | ดีที่สุดสำหรับ | ข้อจำกัดหลัก |
|---|---|---|---|---|
| JSON API ที่ซ่อนอยู่ | เร็วที่สุด | ต่ำสุด | ข้อมูลเบื้องหลังการโทร XHR ที่สะอาด | จุดสิ้นสุดสามารถเปลี่ยนแปลงหรือต้องการโทเค็นได้ |
| Playwright | ปานกลาง | สูงกว่า | การเรนเดอร์เต็มรูปแบบ การควบคุมอะซิงก์ที่ทันสมัย | ใช้ CPU หน่วยความจำ และแบนด์วิธ |
| Selenium | ปานกลาง | สูงกว่า | สแต็คแบบเดิม รองรับภาษากว้างๆ | การตั้งค่าช้าลง การรอที่ละเอียดมากขึ้น |
| requests-html | ช้า | ต่ำ | JavaScript ขนาดเบา บนหน้าธรรมดา | การเรนเดอร์ที่เปราะบางและไม่ได้รับการดูแลรักษาเป็นส่วนใหญ่ |
ต้นทุนมีความสำคัญเนื่องจากเบราว์เซอร์ที่ไม่มีส่วนหัวที่ส่งผ่าน proxy แบบมิเตอร์จะดาวน์โหลดไบต์มากกว่าการโทร API เพียงครั้งเดียว หากคุณกำลังขูดขนาดใหญ่ วิธีที่คุณเลือกจะเปลี่ยนการเรียกเก็บเงินมากเท่ากับโค้ด หากต้องการทราบระเบียบวินัยที่กว้างขึ้นเกี่ยวกับการเว้นจังหวะและส่วนหัว โปรดดูของเรา แนวทางปฏิบัติที่ดีที่สุดของ web scraping.
คุณจะค้นหา API ที่ซ่อนอยู่หลังเพจไดนามิกได้อย่างไร
ค้นหาคำขอเบื้องหลังที่เพจสร้างขึ้นเพื่อดึงข้อมูล เนื่องจากปลายทางนั้นมักจะส่งคืน JSON ที่ปลอดภัยซึ่งคุณสามารถโทรได้โดยตรง นี่เป็นแนวทางที่รวดเร็วและเชื่อถือได้มากที่สุด และหลีกเลี่ยงการใช้เบราว์เซอร์โดยสิ้นเชิง
เปิดเครื่องมือสำหรับนักพัฒนา สลับไปที่แท็บเครือข่าย กรองตาม Fetch/ XHR และโหลดหน้านี้ซ้ำ เมื่อเนื้อหาปรากฏขึ้น ให้เฝ้าดูคำขอที่ส่งคืน JSON ที่มีค่าที่คุณต้องการ ตรวจสอบคำขอ URL วิธีการ พารามิเตอร์การสืบค้น และส่วนหัวหรือโทเค็นใดๆ ที่ส่ง จากนั้นคลิกขวาและคัดลอกเป็น c URL เพื่อดูรูปร่างทั้งหมด เมื่อคุณสามารถสร้างการโทรนั้นอีกครั้งด้วยไคลเอนต์ HTTP คุณจะข้ามการเรนเดอร์ทั้งหมดและดึงข้อมูลที่มีโครงสร้างด้วยต้นทุนเพียงเล็กน้อย
นี่คือตัวอย่างขั้นต่ำที่เรียกตำแหน่งข้อมูล JSON ผ่าน proxy และอ่านฟิลด์โดยตรง:
import requests

proxy = "http://USERNAME:[email protected]:823"
proxies = {"http": proxy, "https": proxy}

headers = {
    "User-Agent": "Mozilla/5.0",
    "Accept": "application/json",
    "Referer": "https://example.com/products",
}
params = {"category": "laptops", "page": 1}

r = requests.get(
    "https://example.com/api/v2/products",
    headers=headers,
    params=params,
    proxies=proxies,
    timeout=30,
)
r.raise_for_status()
data = r.json()

for item in data["items"]:
    print(item["name"], item["price"])
หากจุดสิ้นสุดมีการแบ่งหน้า ให้เพิ่มพารามิเตอร์ของหน้าหรือติดตามเคอร์เซอร์ถัดไปที่การตอบสนองจะส่งกลับ เมื่อคำขอต้องการโทเค็น ให้บันทึกตำแหน่งที่เพจออกโทเค็นเป็นอันดับแรกและเล่นซ้ำภายในเซสชันเดียวกัน การกำหนดเส้นทางการโทรผ่าน DataImpulse หมายความว่าจุดสิ้นสุดมองเห็น IP ที่อยู่อาศัย แทนที่จะเป็นที่อยู่เซิร์ฟเวอร์ของคุณ ซึ่งมีความสำคัญเมื่อ API จำกัดอัตราตามต้นทาง หากคุณเข้าสู่กำแพงการตรวจสอบสิทธิ์บน proxy เอง โปรดทราบ การพิสูจน์ตัวตน proxy อธิบายรูปแบบข้อมูลรับรอง
คุณจะขูดหน้าไดนามิกด้วย Playwright ได้อย่างไร
เมื่อไม่มี API ที่จะเรียกใช้ ให้ขับเคลื่อนเบราว์เซอร์ที่ไม่มีส่วนหัว เช่น Playwright เพื่อให้ JavaScript ดำเนินการเหมือนกับที่จะดำเนินการสำหรับผู้ใช้ จากนั้นอ่าน DOM ที่เสร็จแล้ว Playwright เป็นค่าเริ่มต้นสมัยใหม่ เนื่องจากมาพร้อมกับการรออัตโนมัติที่เชื่อถือได้ การสนับสนุน async ระดับเฟิร์สคลาส และตัวเลือก proxy แบบธรรมดา
ติดตั้งและดาวน์โหลดไบนารีของเบราว์เซอร์ก่อน:
pip install playwright
playwright install chromium
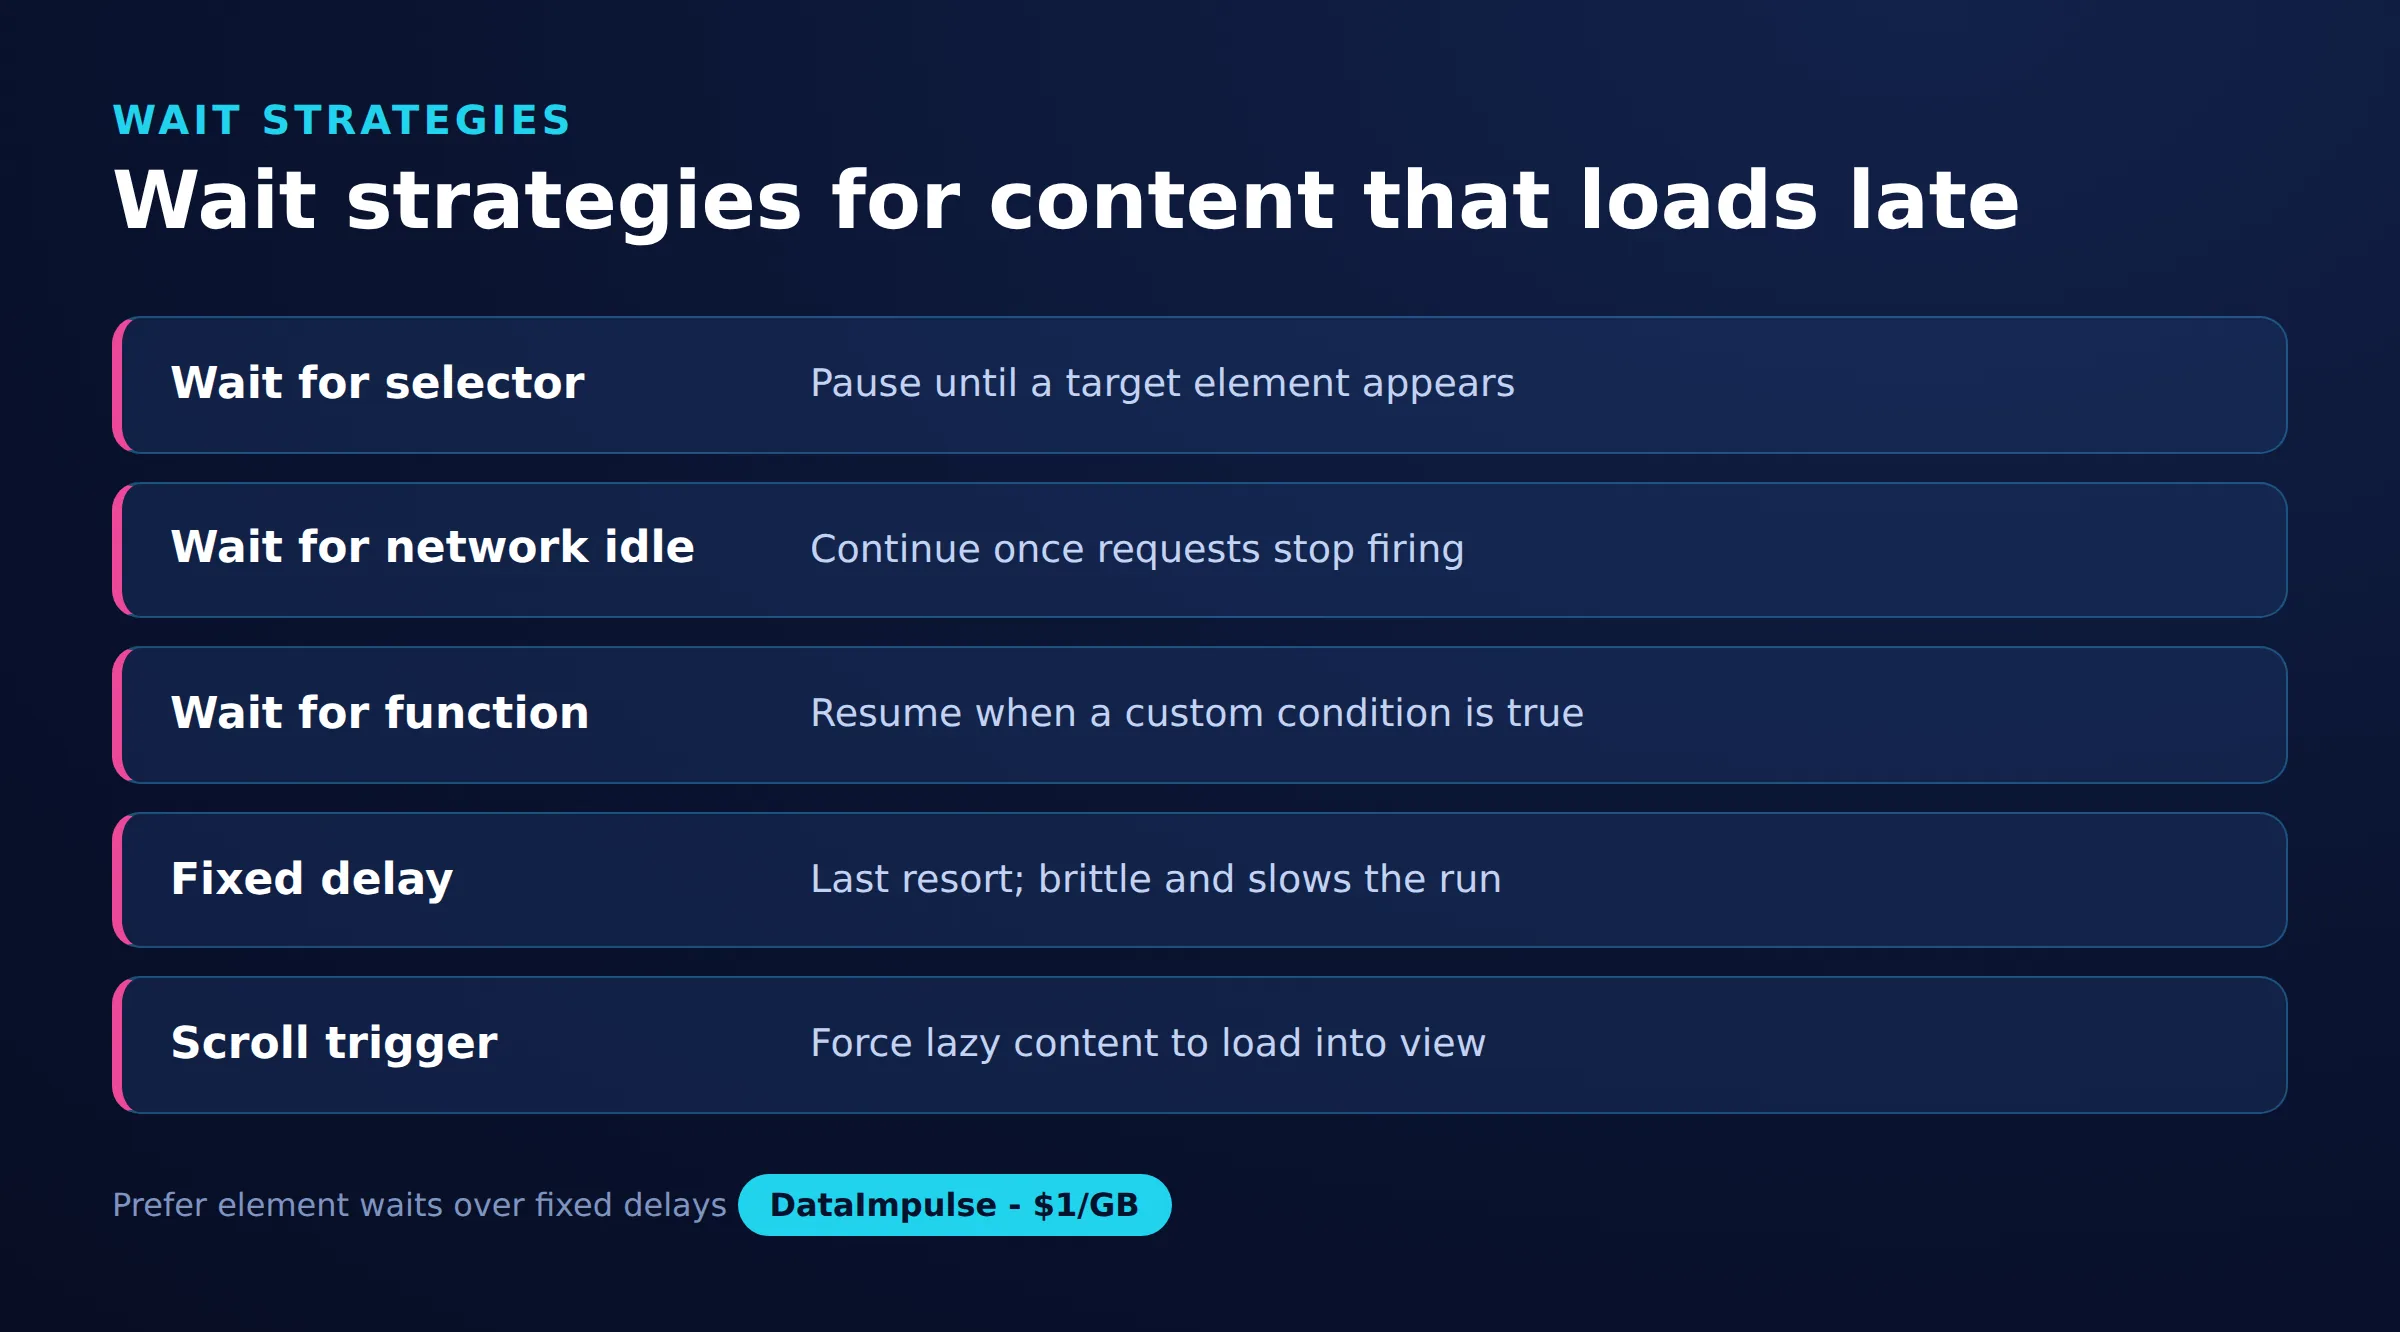
วินัยหลักคือการรอองค์ประกอบเฉพาะที่คุณต้องการแทนที่จะคาดเดาด้วยการนอนหลับคงที่ ตัวอย่างด้านล่างเรียกใช้งาน Chromium กำหนดเส้นทางผ่าน proxy โดยใช้แบบฟอร์มพจนานุกรม รอตารางผลิตภัณฑ์ และแยกค่าที่แสดงผล:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True, proxy=PROXY)
    context = browser.new_context(user_agent="Mozilla/5.0")
    page = context.new_page()
    page.goto("https://example.com/products", wait_until="domcontentloaded")

    page.wait_for_selector("div.product-card", timeout=15000)

    cards = page.query_selector_all("div.product-card")
    for card in cards:
        name = card.query_selector(".title").inner_text()
        price = card.query_selector(".price").inner_text()
        print(name, price)

    browser.close()
การรอคือจุดที่เครื่องขูดแบบไดนามิกส่วนใหญ่ประสบความสำเร็จหรือล้มเหลว ดังนั้นจึงควรทราบกลยุทธ์ทั้งสี่และเมื่อแต่ละกลยุทธ์เหมาะสม ควรรอตัวเลือกหรือเงื่อนไขที่ชัดเจนเหนือเครือข่ายที่ไม่ได้ใช้งาน ซึ่งอาจค้างบนเพจที่เปิดการเชื่อมต่อที่มีอายุการใช้งานยาวนาน:
# Wait for a specific element (most reliable)
page.wait_for_selector("div.product-card", timeout=15000)

# Wait for the initial DOM to be built, before every script finishes
page.goto(url, wait_until="domcontentloaded")

# Wait until there are no network connections for 500 ms
page.goto(url, wait_until="networkidle")

# Wait for a custom condition, such as a minimum item count
page.wait_for_function(
    "document.querySelectorAll('div.product-card').length > 20"
)
หากเป้าหมายของคุณอาศัยสคริปต์ที่ทำงานบนเบราว์เซอร์เป็นอย่างมาก โปรดอ่านบทความร่วมของเราที่ web scraping พร้อมด้วย JavaScript เจาะลึกการเรนเดอร์ฝั่งไคลเอ็นต์ซึ่งทำให้เพจเหล่านี้ยากขึ้น
คุณจะจัดการกับการเลื่อนแบบไม่มีที่สิ้นสุดและปุ่มโหลดเพิ่มเติมได้อย่างไร?
ทริกเกอร์เหตุการณ์เดียวกันกับที่เพจใช้ในการโหลดเนื้อหาเพิ่มเติม จากนั้นรอให้ชุดใหม่แต่ละชุดแสดงผลก่อนที่จะอ่าน ปุ่มเลื่อนและโหลดเพิ่มเติมไม่มีที่สิ้นสุดจะดึงข้อมูลในขณะที่ผู้ใช้ดำเนินการเท่านั้น ดังนั้นการโหลดหน้าเว็บเดียวจะบันทึกเฉพาะหน้าจอแรกเท่านั้น
ก่อนที่จะเข้าถึงเบราว์เซอร์ ให้ตรวจสอบแท็บเครือข่ายอีกครั้ง เนื่องจากการเลื่อนแบบไม่มีที่สิ้นสุดมักจะขับเคลื่อนโดยการเรียก XHR แบบแบ่งหน้า และการวนซ้ำบนจุดสิ้นสุดนั้นด้วยวิธีคำขอด้านบนนั้นถูกกว่าการเลื่อนมาก หากคุณต้องเลื่อน ให้ทำในวงควบคุมที่หยุดเมื่อไม่มีรายการใหม่ปรากฏขึ้น:
def scroll_until_stable(page, item_selector, max_rounds=30):
    seen = 0
    for _ in range(max_rounds):
        page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
        page.wait_for_timeout(1500)
        count = len(page.query_selector_all(item_selector))
        if count == seen:
            break            # no new items loaded, stop
        seen = count
    return seen
หน้าที่ใช้ปุ่มที่ชัดเจนแทนการเลื่อนจำเป็นต้องมีการคลิกวนซ้ำ อ่านจำนวนรายการก่อนการคลิกแต่ละครั้ง คลิกปุ่ม และรอให้จำนวนเพิ่มขึ้น เพื่อที่คุณจะได้ไม่ต้องวิ่งนำหน้าการเรนเดอร์:
def click_load_more(page, button_selector, item_selector, max_clicks=50):
    for _ in range(max_clicks):
        button = page.query_selector(button_selector)
        if button is None or not button.is_visible():
            break
        before = len(page.query_selector_all(item_selector))
        button.click()
        page.wait_for_function(
            "([sel, n]) => document.querySelectorAll(sel).length > n",
            arg=[item_selector, before],
        )
    return len(page.query_selector_all(item_selector))
ทำซ้ำเมื่อคุณรวบรวม เนื่องจากการอ่านโหนดเดียวกันซ้ำในแต่ละรอบเป็นเรื่องปกติ เก็บชุด ID ที่ไม่ซ้ำกันหรือ URL s และต่อท้ายเฉพาะบันทึกที่คุณไม่เห็นเท่านั้น
คุณสามารถใช้ Selenium แทน Playwright ได้หรือไม่
ใช่ Selenium ขับเคลื่อนเบราว์เซอร์จริงในลักษณะเดียวกัน และเป็นตัวเลือกที่ดีเมื่อทีมของคุณใช้งานเบราว์เซอร์อยู่แล้วหรือต้องการการสนับสนุนในภาษาที่กว้างขวาง รูปแบบสะท้อน Playwright : โหลดเพจ รอเงื่อนไขด้วย WebDriverWait จากนั้นอ่านองค์ประกอบจาก DOM ที่แสดงผล
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

options = Options()
options.add_argument("--headless=new")
options.add_argument("--proxy-server=http://gw.dataimpulse.com:823")

driver = webdriver.Chrome(options=options)
driver.get("https://example.com/products")

WebDriverWait(driver, 15).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "div.product-card"))
)

for card in driver.find_elements(By.CSS_SELECTOR, "div.product-card"):
    name = card.find_element(By.CSS_SELECTOR, ".title").text
    price = card.find_element(By.CSS_SELECTOR, ".price").text
    print(name, price)

driver.quit()
ข้อแม้ประการหนึ่ง: ธง — proxy -server แบบธรรมดาไม่ยอมรับชื่อผู้ใช้และรหัสผ่าน ดังนั้น proxy ที่ได้รับการตรวจสอบสิทธิ์จึงจำเป็นต้องมีตัวช่วย ไลบรารี Selenium Wire แทรกข้อมูลประจำตัวอย่างชัดเจน และคำแนะนำของเราเกี่ยวกับ Selenium Wire proxy การตั้งค่าแสดงการกำหนดค่าที่แน่นอน Selenium กำหนดค่าได้หนักกว่า Playwright และการรอมีรายละเอียดมากกว่า ดังนั้นโปรเจ็กต์ใหม่จึงมักเริ่มต้นด้วย Playwright เว้นแต่จะมีเหตุผลที่จะคงอยู่บน Selenium
คุณจะตัดแบนด์วิธ proxy เมื่อเรนเดอร์เพจได้อย่างไร
บล็อกทรัพยากรที่คุณไม่ต้องการ เพื่อให้เบราว์เซอร์หยุดดาวน์โหลดรูปภาพ แบบอักษร และสื่อที่คุณไม่เคยแยกวิเคราะห์ เบราว์เซอร์ที่ไม่มีส่วนหัวจะดึงเนื้อหาทั้งหมดตามค่าเริ่มต้น และแต่ละไบต์เหล่านั้นจะต้องเสียค่าใช้จ่ายเมื่อกำหนดเส้นทางผ่าน proxy ที่มีราคาต่อกิกะไบต์
Playwright ช่วยให้คุณสามารถสกัดกั้นคำขอและยกเลิกคำขอที่ไม่เกี่ยวข้องกับการแยกข้อมูลของคุณ การบล็อกรูปภาพ สื่อ และแบบอักษรสามารถตัดการรับส่งข้อมูลของ proxy ได้อย่างรวดเร็วในขณะที่ออกจาก JSON และ HTML ที่คุณอ่านโดยไม่มีใครแตะต้อง:
BLOCK = {"image", "media", "font"}

def block_heavy(route):
    if route.request.resource_type in BLOCK:
        route.abort()
    else:
        route.continue_()

context = browser.new_context()
context.route("**/*", block_heavy)
page = context.new_page()
page.goto("https://example.com/products", wait_until="domcontentloaded")
คุณสามารถขยายตัวจัดการเดียวกันเพื่อข้ามการวิเคราะห์และโดเมนโฆษณาที่เพิ่มภาระโดยไม่ต้องเพิ่มข้อมูล ด้วยการรับส่งข้อมูล DataImpulse ที่เรียกเก็บเงินตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB และไม่มีวันหมดอายุ การตัดไบต์ที่สูญเปล่าจะช่วยลดต้นทุนการขูดแต่ละครั้งโดยตรง การใช้บริบทของเบราว์เซอร์หนึ่งซ้ำในหน้าที่เกี่ยวข้องกันยังช่วยหลีกเลี่ยงค่าใช้จ่ายในการเริ่มต้นซ้ำ และคำขอที่ถูกที่สุดยังคงเป็นคำขอที่คุณหลีกเลี่ยงโดยการกลับไปใช้ API ที่ซ่อนอยู่
คุณจะเพิ่มการจัดการข้อผิดพลาดและลองใหม่ได้อย่างไร
รวมการนำทางแต่ละรายการไว้ในลูปการลองใหม่โดยมีแบ็คออฟเอ็กซ์โปเนนเชียล ดังนั้นการโหลดที่ช้าหรือบล็อกชั่วคราวเพียงครั้งเดียวจะไม่ทำให้การทำงานทั้งหมดหมด เพจไดนามิกล้มเหลวเป็นระยะๆ และเครื่องขูดที่ยอมแพ้ในการหมดเวลาครั้งแรกจะสูญเสียส่วนแบ่งเร็กคอร์ดจำนวนมากในวงกว้าง
จับระยะหมดเวลาที่ Playwright เพิ่มขึ้น รอช่วงที่เพิ่มขึ้น และลองใหม่ตามจำนวนครั้งที่มีขอบเขตก่อนที่จะบันทึกความล้มเหลวและดำเนินการต่อไป:
import time
from playwright.sync_api import TimeoutError as PlaywrightTimeout

def fetch_with_retries(page, url, selector, retries=3, backoff=2):
    for attempt in range(1, retries + 1):
        try:
            page.goto(url, wait_until="domcontentloaded", timeout=30000)
            page.wait_for_selector(selector, timeout=15000)
            return page.query_selector_all(selector)
        except PlaywrightTimeout:
            wait = backoff ** attempt
            print(f"Attempt {attempt} timed out, retrying in {wait}s")
            time.sleep(wait)
    raise RuntimeError(f"Failed to load {url} after {retries} attempts")
จับคู่อีกครั้งด้วยการหมุน proxy เพื่อให้ความพยายามแต่ละครั้งออกไปผ่าน IP ใหม่ หากทางออกหนึ่งมีอัตราจำกัด คำขอถัดไปจะไปยังที่อยู่อื่นและมักจะสำเร็จ สระน้ำหมุนของ residential proxies หรือ mobile proxies กำหนด IP ใหม่ต่อการร้องขอโดยอัตโนมัติ ซึ่งเปลี่ยนฮาร์ดบล็อกจำนวนมากเป็นการลองใหม่แบบง่ายๆ สำหรับการจัดการความล้มเหลวระดับ proxy โดยเฉพาะ หมายเหตุของเรา HTTP ข้อผิดพลาด 407 ครอบคลุมการตอบสนองการรับรองความถูกต้องที่พบบ่อยที่สุด
คุณจะขูดหน้าไดนามิกหลาย ๆ หน้าพร้อมกันได้อย่างไร?
ใช้ API แบบอะซิงโครนัสของ Playwright พร้อมด้วยเซมาฟอร์แบบอะซินซิโอ เพื่อให้หน้าเว็บหลายหน้าแสดงผลพร้อมกันโดยไม่ทำให้เครื่องหรือเป้าหมายมากเกินไป การทำงานพร้อมกันคือจุดที่การคัดลอกแบบไดนามิกได้รับปริมาณงานคืน เนื่องจากแต่ละหน้าเบราว์เซอร์ใช้เวลาส่วนใหญ่ในการรอบนเครือข่าย
เซมาฟอร์จะจำกัดจำนวนเพจที่ทำงานแบบขนาน แชร์เบราว์เซอร์และบริบทระหว่างงาน เปิดหน้าต่อ URL และรวบรวมผลลัพธ์:
import asyncio
from playwright.async_api import async_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

async def scrape_one(context, url, sem):
    async with sem:
        page = await context.new_page()
        try:
            await page.goto(url, wait_until="domcontentloaded")
            await page.wait_for_selector("div.product-card", timeout=15000)
            cards = await page.query_selector_all("div.product-card")
            return [await c.inner_text() for c in cards]
        finally:
            await page.close()

async def main(urls):
    sem = asyncio.Semaphore(5)   # at most 5 pages at once
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, proxy=PROXY)
        context = await browser.new_context()
        tasks = [scrape_one(context, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        await browser.close()
    return results

urls = ["https://example.com/products?page=%d" % i for i in range(1, 21)]
data = asyncio.run(main(urls))
รักษาขีดจำกัดการเกิดพร้อมกันให้พอประมาณ เพจคู่ขนานมากเกินไปใช้หน่วยความจำและขีดจำกัดอัตราการเดินทาง ซึ่งทำให้คุณต้องลองซ้ำมากกว่าที่บันทึกการทำงานคู่ขนาน เริ่มต้นประมาณห้านาทีและเพิ่มขึ้นเฉพาะในขณะที่อัตราความสำเร็จยังอยู่ในระดับสูง
คุณจะส่งออกข้อมูลที่คัดลอกไปยัง JSON และ CSV ได้อย่างไร
รวบรวมผลลัพธ์ของแต่ละหน้าลงในรายการพจนานุกรม จากนั้นเขียนรายการนั้นไปที่ JSON สำหรับข้อมูลที่ซ้อนกัน หรือ CSV สำหรับตารางเดี่ยวที่เป็นมิตรกับสเปรดชีต การแยกและส่งออกแยกกันทำให้เครื่องขูดทดสอบและรันใหม่ได้ง่ายขึ้น
import json
import csv

records = [
    {"name": "Laptop A", "price": "999"},
    {"name": "Laptop B", "price": "1299"},
]

# Export to JSON
with open("products.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)

# Export to CSV
with open("products.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(records)
เลือก JSON เมื่อบันทึกมีรายการหรืออ็อบเจ็กต์ที่ซ้อนกัน และเลือก CSV เมื่อทุกบันทึกใช้ฟิลด์แบบเรียบเดียวกัน และนักวิเคราะห์จะเปิดในสเปรดชีต ปรับฟิลด์ของคุณให้เป็นมาตรฐานก่อนที่จะเขียน เพื่อให้ทุกบันทึกมีคีย์เดียวกัน และขั้นตอนการส่งออกยังคงไม่สำคัญไม่ว่าเพจไดนามิกจะแสดงผลอย่างไร จากที่นี่ JSON เดียวกันจะฟีดโหลดฐานข้อมูลหรืองานการวิเคราะห์โดยไม่ต้องแยกวิเคราะห์เพิ่มเติม
คำถามที่พบบ่อย
ฉันจะทราบได้อย่างไรว่าเพจนั้นเป็นไดนามิกก่อนที่จะเขียนสแครปเปอร์
เปรียบเทียบ ดูซอร์สของหน้า กับแผงองค์ประกอบ ในเครื่องมือสำหรับนักพัฒนาซอฟต์แวร์ หรือนับองค์ประกอบเป้าหมายใน HTML แบบดิบเทียบกับ DOM ที่แสดงผล หากข้อมูลปรากฏขึ้นหลังจากรัน JavaScript เท่านั้น แสดงว่าเพจนั้นเป็นแบบไดนามิกและจำเป็นต้องมีการเรียก API หรือเบราว์เซอร์แบบไม่มีส่วนหัว
จะดีกว่าไหมที่จะเรียก API ที่ซ่อนอยู่ หรือใช้เบราว์เซอร์ที่ไม่มีหัว?
เรียก API ที่ซ่อนอยู่เมื่อคุณสามารถค้นหาได้ เนื่องจากจะส่งคืน JSON ที่สะอาดในราคาที่ถูกกว่าและความเร็วในการเรนเดอร์เพียงเล็กน้อย ใช้เบราว์เซอร์ headless เฉพาะเมื่อไม่มี API ที่ทำซ้ำได้ หรือข้อมูลขึ้นอยู่กับสคริปต์ฝั่งไคลเอ็นต์ที่ซับซ้อน
ฉันควรใช้ Playwright หรือ Selenium สำหรับการขูดแบบไดนามิกหรือไม่
Playwright เป็นค่าเริ่มต้นที่ทันสมัย ด้วยการรออัตโนมัติที่เชื่อถือได้และการสนับสนุน async ในตัว ดังนั้นโปรเจ็กต์ใหม่จึงมักจะเริ่มต้นที่นั่น Selenium เหมาะสมอย่างยิ่งเมื่อสแต็กของคุณใช้งานอยู่แล้วหรือคุณต้องการการสนับสนุนภาษาที่กว้างขึ้น
ฉันจะลดแบนด์วิดท์ proxy เมื่อใช้เบราว์เซอร์แบบไม่มีหัวได้อย่างไร
สกัดกั้นคำขอและยกเลิกรูปภาพ แบบอักษร สื่อ และการวิเคราะห์ที่คุณไม่ได้แยกวิเคราะห์ ซึ่งสามารถลดปริมาณการรับส่งข้อมูลได้อย่างมาก เนื่องจากค่าใช้จ่ายของ proxy มีการวัดต่อกิกะไบต์ และยังช่วยเร่งความเร็วในการโหลดแต่ละเพจอีกด้วย
ฉันจะขูดเนื้อหาที่โหลดด้วยการเลื่อนแบบไม่มีที่สิ้นสุดได้อย่างไร
ขั้นแรกให้ตรวจสอบแท็บเครือข่ายเพื่อดูการเรียก XHR ที่มีการแบ่งหน้าไว้ด้านหลังการเลื่อนและวนซ้ำบนจุดสิ้นสุดนั้นโดยตรง หากคุณต้องเลื่อน ให้ทำในลูปควบคุมและรอให้แต่ละชุดใหม่เรนเดอร์ก่อนที่จะอ่าน
เมื่อใดที่ DataImpulse ไม่พอดี?
หากคุณต้องการ ISP proxies แบบคงที่, API การขูดที่มีการจัดการเต็มรูปแบบ หรือการเข้าถึงไซต์ธนาคารและหน่วยงานของรัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้นไปที่การหมุนเวียนที่อยู่อาศัย mobile และ datacenter proxies สำหรับการรวบรวมข้อมูลสาธารณะและการเข้าถึงเนื้อหา
คำแนะนำที่เกี่ยวข้อง
คัดลอกหน้าไดนามิกด้วย proxies ที่เชื่อถือได้
หากสแครปเปอร์ของคุณต้องการที่อยู่อาศัย mobile หรือ datacenter IP ที่ทำงานเหมือนผู้เยี่ยมชมจริง คุณสามารถเริ่มต้นการรับส่งข้อมูลแบบจ่ายตามการใช้งานได้ตั้งแต่ 1 ดอลลาร์ต่อ GB สร้างบัญชี DataImpulse และกำหนดเส้นทางการขูดแบบไดนามิกของคุณผ่านการหมุนหรือ sticky sessions