
In this Article
Web scraping w Rust polega na pobieraniu i parsowaniu stron internetowych za pomocą języka Rust oraz jego ekosystemu crate’ów. Rust przemawia do programistów, którym zależy na przewidywalnej wydajności i bezpieczeństwie pamięci bez garbage collectora, dlatego dobrze sprawdza się w crawlerach działających nieprzerwanie lub na dużą skalę.
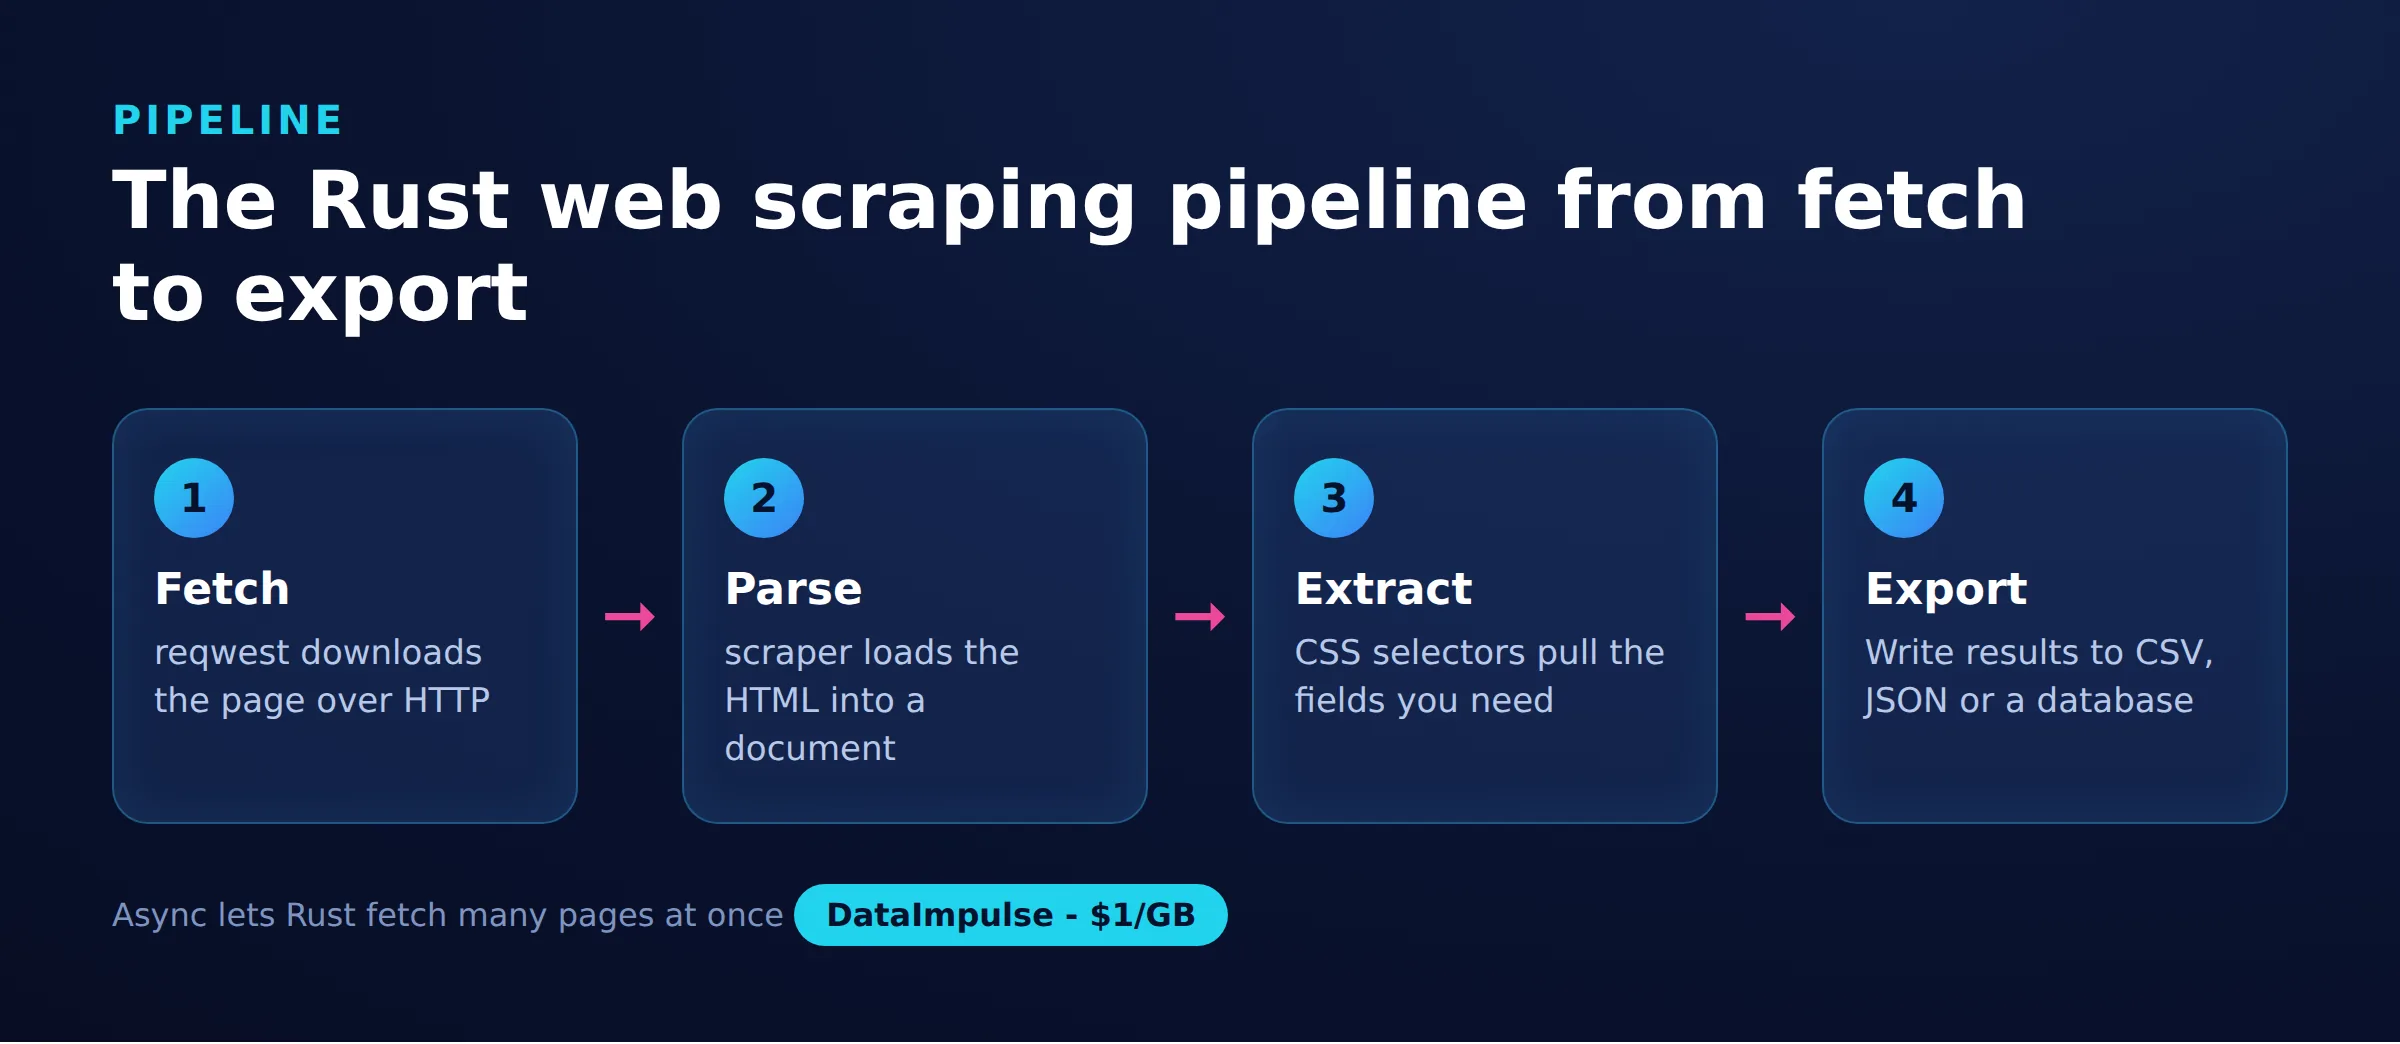
Ten praktyczny przewodnik oparty na kodzie wykorzystuje klienta HTTP reqwest i crate do parsowania scraper. Omawia konfigurację projektu i minimalne pobieranie danych, selektory CSS, modele danych strukturalnych, eksport JSON i CSV, paginację, obsługę błędów z ponawianiem prób i backoffem, asynchroniczną współbieżność z tokio, konfigurację proxy oraz rozwiązanie awaryjne w postaci przeglądarki headless dla serwisów intensywnie korzystających z JavaScript. Każdy fragment kodu można skompilować i uruchomić.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności i jest wykorzystywany do web scrapingu, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
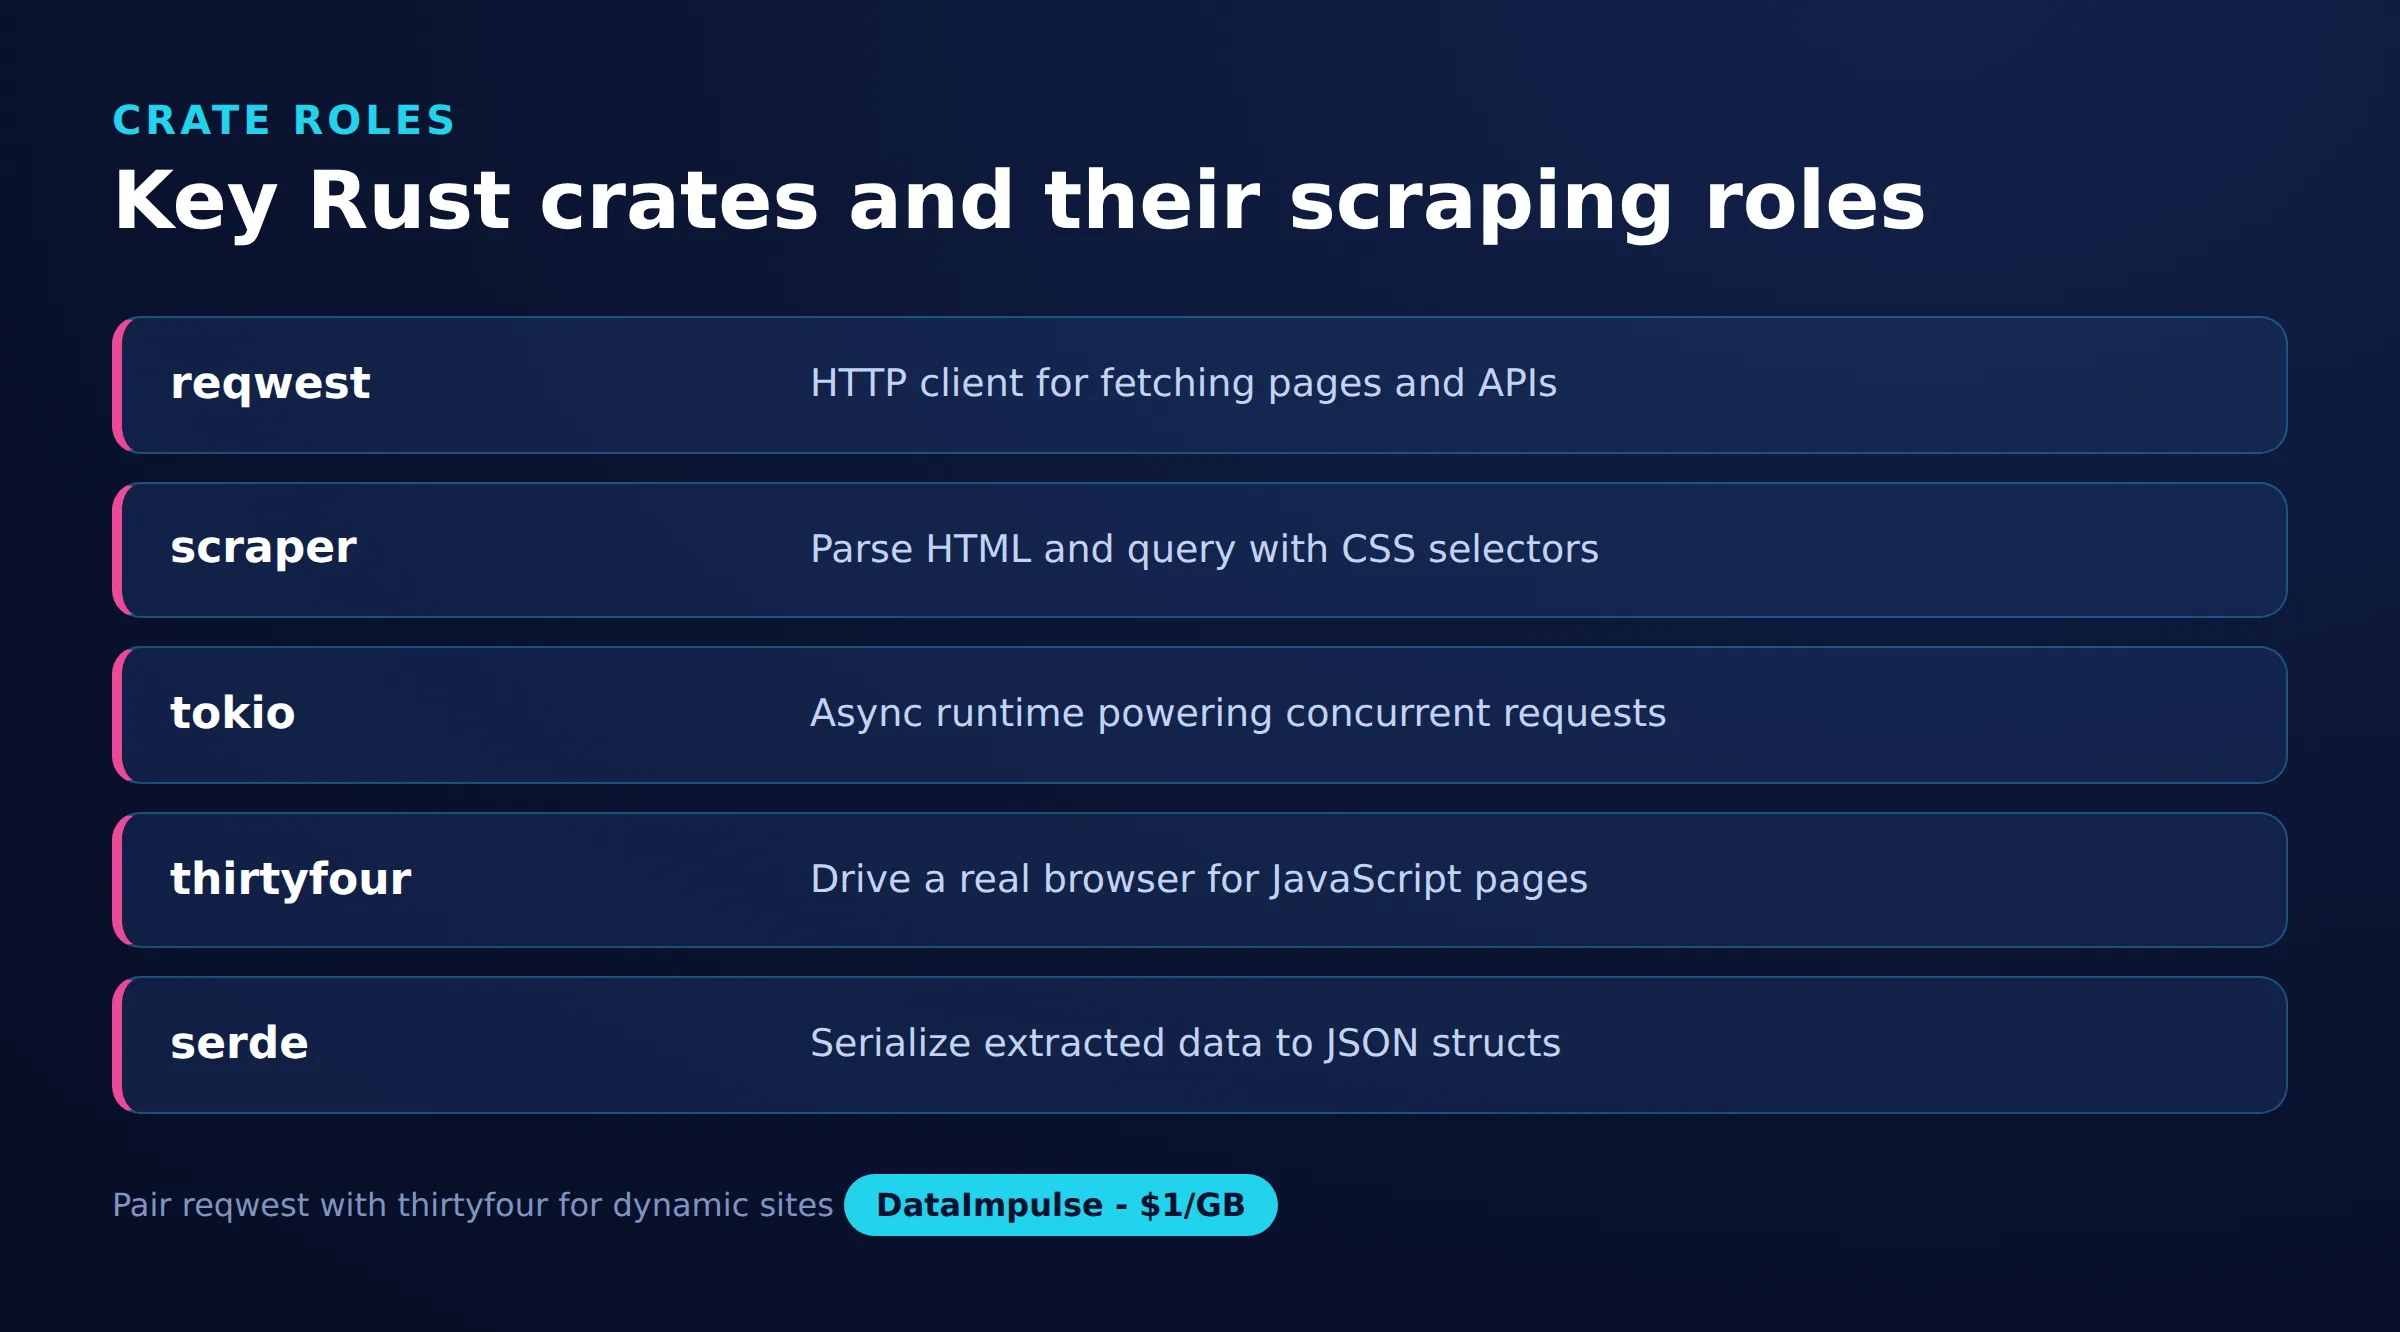
- Podstawowy stos technologiczny: Web scraping w Rust zwykle łączy klienta HTTP reqwest z crate’em scraper do parsowania HTML, a także tokio do asynchronicznej współbieżności i serde do eksportowania danych strukturalnych.
- Najlepszy typ proxy: rotating residential proxies, które wykorzystują rzeczywiste konsumenckie IP i omijają wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu ważności i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4.8/5 na G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraj w cenie.
Dlaczego warto używać Rust do web scrapingu?
Rust sprawdza się w web scrapingu, gdy szybkość, niskie zużycie pamięci i niezawodność są ważniejsze niż szybkie prototypowanie. Jego skompilowane binaria działają blisko sprzętu, a borrow checker wykrywa całe klasy błędów współbieżności już w czasie kompilacji, a nie na produkcji.
Te właściwości przynoszą korzyści w kilku częstych scenariuszach:
- Przepustowość: Skompilowany crawler w Rust przetwarza duże wolumeny stron przy mniejszym narzucie CPU i pamięci niż język interpretowany, co obniża koszty infrastruktury przy długich zadaniach.
- Bezpieczna współbieżność: Środowisko uruchomieniowe async tokio pozwala uruchamiać tysiące równoległych żądań, a system typów zapobiega wyścigom danych między tymi zadaniami.
- Przewidywalne zużycie zasobów: Brak garbage collectora oznacza stabilniejsze opóźnienia, co pomaga crawlerom działającym przez godziny lub dni.
Kompromisem są bardziej stroma krzywa uczenia się i dłuższy czas kompilacji, dlatego Rust wynagradza projekty działające na skalę, a nie jednorazowe skrypty. Niezależnie od języka obowiązują te same podstawowe zasady: szanuj robots.txt, ogranicz tempo żądań i stosuj ogólne dobre praktyki web scrapingu, aby Twój crawler zachowywał się odpowiedzialnie.
Jak skonfigurować projekt scrapingu w Rust?
Skonfiguruj projekt scrapingu w Rust, tworząc nowy pakiet Cargo i deklarując potrzebne crate’y w Cargo.toml. Cargo jest narzędziem do budowania i menedżerem pakietów Rust, więc rozwiązuje zależności i kompiluje projekt za Ciebie.
Uruchom cargo new rust-scraper , aby utworzyć szkielet projektu, a następnie edytuj wygenerowany Cargo.toml. Poniższy zestaw zależności obejmuje wszystko z tego przewodnika: HTTP, parsowanie, async, serializację, wyjście CSV, strumienie i wygodną obsługę błędów.
[package]
name = "rust-scraper"
version = "0.1.0"
edition = "2021"

[dependencies]
reqwest = { version = "0.12", features = ["json", "socks"] }
scraper = "0.20"
tokio = { version = "1", features = ["full"] }
serde = { version = "1", features = ["derive"] }
serde_json = "1"
csv = "1.3"
futures = "0.3"
anyhow = "1"
thiserror = "1"
Tutaj reqwest obsługuje żądania (funkcja socks włącza proxy SOCKS5, a funkcja json dodaje pomocnicze funkcje JSON), scraper parsuje HTML za pomocą selektorów CSS, tokio zapewnia środowisko uruchomieniowe async, serde i serde_json serializują Twoje dane, csv zapisuje arkusze, futures dostarcza kombinatory strumieni do współbieżności, a anyhow z thiserror upraszczają obsługę błędów. Uruchom cargo build raz, aby pobrać i skompilować wszystko przed napisaniem pierwszego żądania.
Jak pobrać i sparsować stronę za pomocą reqwest i scraper?
Pobierz stronę, wysyłając żądanie GET za pomocą reqwest, a następnie załaduj treść odpowiedzi do scraper, aby odpytywać ją selektorami CSS. Poniższy przykład działa asynchronicznie w tokio, pobiera stronę i wypisuje tekst każdego elementu H1.
use scraper::{Html, Selector};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let url = "https://example.com";
    let body = reqwest::get(url).await?.text().await?;

    let document = Html::parse_document(&body);
    let heading = Selector::parse("h1").unwrap();

    for element in document.select(&heading) {
        let text: String = element.text().collect();
        println!("{}", text.trim());
    }
    Ok(())
}
Przepływ jest zawsze taki sam: reqwest::get zwraca odpowiedź, .text() odczytuje jej treść jako ciąg znaków, a Html::parse_document zamienia ten ciąg w drzewo, które można odpytywać. Operator ? przekazuje każdy błąd sieciowy lub dekodowania do main. Wywołanie .text() na dopasowanym elemencie zbiera jego węzły tekstowe, które następnie przycinasz i wykorzystujesz. To podejście z surowym HTML jest szybkie, lecz pamiętaj, że widzi tylko znaczniki zwracane przez serwer, a nie treść, którą przeglądarka wyrenderowałaby później za pomocą JavaScript.
Jak wskazywać elementy za pomocą selektorów CSS?
Wskazuj elementy, przekazując standardowy ciąg selektora CSS do Selector::parse, dokładnie tak jak w konsoli przeglądarki. Crate scraper obsługuje tagi, klasy, identyfikatory, dopasowania atrybutów, ścieżki potomków i strukturalne pseudoklasy.
use scraper::Selector;

// Match by tag
let links = Selector::parse("a").unwrap();

// Match by class
let prices = Selector::parse(".price").unwrap();

// Match by id
let main = Selector::parse("#main-content").unwrap();

// Match by attribute value
let external = Selector::parse("a[rel=\"nofollow\"]").unwrap();

// Descendant path (a title inside a product card)
let titles = Selector::parse("div.product h2.title").unwrap();

// Direct child plus pseudo-class
let first_row = Selector::parse("table > tbody > tr:first-child").unwrap();
Skompiluj każdy selektor raz i używaj go ponownie zamiast parsować go wewnątrz pętli, ponieważ parsowanie wiąże się z niewielkim kosztem. Gdy selektor może nie pasować, preferuj .next() z wartością awaryjną zamiast .unwrap() na elemencie, aby brakujące pole nie spowodowało paniki całego przebiegu. Sprawdzenie strony docelowej w narzędziu wyboru elementów przeglądarki jest najszybszym sposobem na znalezienie stabilnych nazw klas i atrybutów do selekcji.
Jak eksportować zebrane dane do JSON i CSV?
Eksportuj zebrane dane, modelując każdy rekord jako strukturę dziedziczącą Serialize, a następnie zapisując wycinek tych struktur do JSON za pomocą serde_json albo do CSV za pomocą crate’a csv. Zdefiniowanie modelu typowanego utrzymuje spójność ekstrakcji i wyjścia oraz sprawia, że kod sam się dokumentuje.
Najpierw zamodeluj rekord i wyodrębnij pola z każdego elementu kontenera:
use scraper::{Html, Selector};
use serde::Serialize;

#[derive(Debug, Serialize)]
struct Product {
    name: String,
    price: String,
    url: String,
}

fn parse_products(html: &str) -> Vec<Product> {
    let document = Html::parse_document(html);
    let card = Selector::parse("div.product").unwrap();
    let name_sel = Selector::parse("h2.title").unwrap();
    let price_sel = Selector::parse("span.price").unwrap();
    let link_sel = Selector::parse("a").unwrap();

    let mut products = Vec::new();
    for card_el in document.select(&card) {
        let name = card_el
            .select(&name_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let price = card_el
            .select(&price_sel)
            .next()
            .map(|e| e.text().collect::<String>().trim().to_string())
            .unwrap_or_default();
        let url = card_el
            .select(&link_sel)
            .next()
            .and_then(|e| e.value().attr("href"))
            .unwrap_or_default()
            .to_string();

        products.push(Product { name, price, url });
    }
    products
}
Ponieważ Product dziedziczy Serialize, ta sama struktura zasila oba eksportery bez dodatkowej pracy:
use std::fs::File;
use std::io::Write;

fn export_json(products: &[Product]) -> anyhow::Result<()> {
    let json = serde_json::to_string_pretty(products)?;
    let mut file = File::create("products.json")?;
    file.write_all(json.as_bytes())?;
    Ok(())
}

fn export_csv(products: &[Product]) -> anyhow::Result<()> {
    let mut writer = csv::Writer::from_path("products.csv")?;
    for product in products {
        writer.serialize(product)?;
    }
    writer.flush()?;
    Ok(())
}
serde_json’s to_string_pretty tworzy czytelny dla człowieka JSON, a serialize mapuje każdą strukturę na wiersz z nagłówkiem utworzonym na podstawie nazw pól. Ponowne użycie jednego typowanego modelu do scrapingu, JSON i CSV sprawia, że pipeline Rust łatwo utrzymać, gdy strona docelowa się zmienia.
Jak scrapować wiele stron w pętli paginacji?
Scrapuj wiele stron, iterując po numerach stron lub URL następnej strony i używając ponownie jednego klienta reqwest, aby połączenia były łączone w pulę między żądaniami. Zbuduj każdy URL, pobierz go, sparsuj funkcją z poprzedniej sekcji i zatrzymaj się, gdy strona nie zwróci wyników.
use scraper::Html;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let mut all_products = Vec::new();

    for page in 1..=10 {
        let url = format!("https://example.com/products?page={}", page);
        let body = client.get(&url).send().await?.text().await?;
        let products = parse_products(&body);

        // Stop when a page returns no results
        if products.is_empty() {
            break;
        }
        all_products.extend(products);

        // Pause between requests to stay polite
        tokio::time::sleep(std::time::Duration::from_millis(500)).await;
    }

    println!("Collected {} products", all_products.len());
    Ok(())
}
Utworzenie klienta raz za pomocą reqwest::Client::new() poza pętlą pozwala mu ponownie wykorzystywać połączenia TCP, co jest zauważalnie szybsze niż nowy klient na każde żądanie. Sprawdzenie pustego wyniku naturalnie kończy pętlę po dotarciu do ostatniej strony, a krótkie uśpienie rozstawia żądania w czasie, aby nie przeciążać serwera. W serwisach używających linku next zamiast numerowanych stron wyodrębnij href odnośnika do następnej strony w każdej iteracji i podążaj za nim, aż link zniknie.
Jak obsługiwać błędy i ponawianie prób z backoffem?
Obsługuj błędy, zwracając błąd typowany z funkcji pobierających, a następnie ponawiaj przejściowe awarie z wykładniczym backoffem. Sieci przekraczają limit czasu, a serwery zwracają tymczasowe kody statusu, dlatego odporny scraper traktuje pojedyncze niepowodzenie jako spodziewane, a nie krytyczne.
Crate thiserror pozwala zdefiniować zwięzły enum błędów, który automatycznie konwertuje błąd reqwest:
use thiserror::Error;

#[derive(Error, Debug)]
enum ScrapeError {
    #[error("request failed: {0}")]
    Request(#[from] reqwest::Error),

    #[error("unexpected status code: {0}")]
    Status(reqwest::StatusCode),

    #[error("selector matched no elements")]
    Empty,
}

async fn fetch_page(client: &reqwest::Client, url: &str) -> Result<String, ScrapeError> {
    let response = client.get(url).send().await?;
    if !response.status().is_success() {
        return Err(ScrapeError::Status(response.status()));
    }
    Ok(response.text().await?)
}
Atrybut #[from] oznacza, że niepowodzenie reqwest automatycznie zmienia się w ScrapeError::Request za pośrednictwem operatora ?. Oprócz błędów typowanych otocz żądanie pętlą ponawiania prób, w której czas oczekiwania rośnie po każdej próbie:
use std::time::Duration;

async fn fetch_with_backoff(client: &reqwest::Client, url: &str) -> anyhow::Result<String> {
    let max_attempts = 5;
    for attempt in 1..=max_attempts {
        match client.get(url).send().await {
            Ok(resp) if resp.status().is_success() => {
                return Ok(resp.text().await?);
            }
            Ok(resp) => {
                eprintln!("attempt {attempt}: status {}", resp.status());
            }
            Err(err) => {
                eprintln!("attempt {attempt}: {err}");
            }
        }
        // Exponential backoff: 0.5s, 1s, 2s, 4s, 8s
        let backoff = Duration::from_millis(500 * 2u64.pow(attempt - 1));
        tokio::time::sleep(backoff).await;
    }
    anyhow::bail!("giving up on {url} after {max_attempts} attempts")
}
Wykładniczy backoff (tutaj 0.5s, 1s, 2s, 4s, 8s) daje serwerowi ograniczonemu limitem żądań lub chwilowo przeciążonemu czas na odzyskanie sprawności, zamiast go zasypywać. Połączenie ponawiania prób z rotating proxies jest jeszcze skuteczniejsze: żądanie zablokowane lub ograniczone na jednym IP może powieść się przy kolejnej próbie z innego wyjściowego IP.
Jak uruchamiać równoległe żądania z tokio?
Uruchamiaj równoległe żądania, zamieniając listę URL w strumień async i stosując buffer_unordered, co ogranicza liczbę żądań wykonywanych jednocześnie. To największa dźwignia wydajności w scraperze Rust, a tokio wraz z crate’em futures zapewniają bezpieczeństwo.
use futures::stream::{self, StreamExt};

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    let client = reqwest::Client::new();
    let urls: Vec<String> = (1..=50)
        .map(|n| format!("https://example.com/item/{}", n))
        .collect();

    let bodies = stream::iter(urls)
        .map(|url| {
            let client = client.clone();
            async move {
                let text = client.get(&url).send().await?.text().await?;
                Ok::<_, reqwest::Error>((url, text))
            }
        })
        .buffer_unordered(10); // at most 10 requests in flight

    bodies
        .for_each(|result| async {
            match result {
                Ok((url, body)) => println!("{}: {} bytes", url, body.len()),
                Err(err) => eprintln!("error: {}", err),
            }
        })
        .await;

    Ok(())
}
Tutaj stream::iter zamienia listę URL w strumień, .map uruchamia jedno żądanie async na każdy URL, a buffer_unordered(10) utrzymuje najwyżej dziesięć żądań działających równolegle i zwraca wyniki w miarę ich ukończenia. Klonowanie klienta dla każdego zadania jest tanie, ponieważ reqwest Client jest Arc wokół współdzielonej puli połączeń. Dostosuj limit współbieżności, aby zrównoważyć szybkość i obciążenie nakładane na cel: rozsądnym punktem wyjścia jest dziesięć do dwudziestu, a połączenie większej współbieżności z pulą proxy rozkłada te żądania na wiele IP.
Jak kierować ruch scrapingu Rust przez proxy?
Kieruj ruch przez proxy, tworząc klienta reqwest za pomocą reqwest::Proxy oraz dołączając bramę i poświadczenia przez .basic_auth. Wysyłanie żądań przez rotating IP rozkłada obciążenie, pozwala dotrzeć do treści specyficznych dla lokalizacji geograficznej i zmniejsza prawdopodobieństwo ograniczenia tempa. Rotating IP to jedna z najskuteczniejszych technik scrapingu bez blokad.
use reqwest::Proxy;

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    // Authenticated gateway; rotates the exit IP on each request
    let proxy = Proxy::all("http://gw.dataimpulse.com:823")?
        .basic_auth("login", "password");

    let client = reqwest::Client::builder()
        .proxy(proxy)
        .timeout(std::time::Duration::from_secs(30))
        .build()?;

    let body = client
        .get("https://httpbin.org/ip")
        .send()
        .await?
        .text()
        .await?;

    println!("{}", body);
    Ok(())
}
Zastąp login i password swoimi poświadczeniami i dostosuj port do potrzebnej sieci. Jeśli proxy odrzuca żądanie ze statusem 407, przyczyną niemal zawsze są brakujące lub błędne poświadczenia; przewodnik o błędzie HTTP 407 oraz instrukcja dotycząca uwierzytelniania proxy wyjaśniają, jak to naprawić. DataImpulse oferuje residential proxies, datacenter proxies i mobile proxies przez HTTP, HTTPS i SOCKS5, z rotating i sticky sessions. Targetowanie na kraj jest w cenie, natomiast targetowanie na stan, miasto, ZIP i ASN to płatne dodatki.
Jak scrapować strony intensywnie korzystające z JavaScript i kiedy Rust jest właściwym wyborem?
Scrapuj strony intensywnie korzystające z JavaScript, sterując prawdziwą przeglądarką headless, ponieważ reqwest i scraper widzą tylko surowy HTML serwera i nigdy nie wykonują skryptów. Gdy treść pojawia się dopiero po renderowaniu po stronie klienta, sięgnij po crate do automatyzacji przeglądarki, np. thirtyfour, który obsługuje protokół WebDriver, lub chromiumoxide, który kontroluje Chrome przez DevTools Protocol.
use thirtyfour::prelude::*;

#[tokio::main]
async fn main() -> WebDriverResult<()> {
    let caps = DesiredCapabilities::chrome();
    let driver = WebDriver::new("http://localhost:9515", caps).await?;

    driver.goto("https://example.com").await?;

    // Wait for client-side content to render, then read it
    let heading = driver.find(By::Css("h1")).await?;
    println!("{}", heading.text().await?);

    driver.quit().await?;
    Ok(())
}
Przykład z thirtyfour łączy się z działającym chromedriver, ładuje stronę, czeka na wyrenderowany element i odczytuje jego tekst. To podejście jest znacznie cięższe niż zwykłe pobranie HTTP, więc używaj go tylko dla stron, które rzeczywiście go potrzebują, a dla reszty zachowaj szybką ścieżkę reqwest. Aby lepiej poznać ten kompromis, zobacz przewodniki o scrapingu dynamicznych stron internetowych and web scrapingu z JavaScript. Poniższa tabela podsumowuje, jak współpracują główne crate’y:
| Crate | Rola | Uruchamia JavaScript | Najlepsze zastosowanie |
|---|---|---|---|
| reqwest | Klient HTTP | Nie | Pobieranie surowego HTML i JSON API |
| scraper | Parser HTML | Nie | Ekstrakcja danych selektorami CSS |
| thirtyfour | Klient WebDriver | Tak | Pełna automatyzacja przeglądarki i formularze |
| chromiumoxide | DevTools Protocol | Tak | Szybkie sterowanie Chrome headless |
Jeśli chodzi o wybór języka, wybierz Rust, gdy potrzebujesz utrzymującej się wydajności i niskiego zużycia zasobów na dużą skalę, a Python, gdy cenisz szybki rozwój i szerszy ekosystem scrapingu, taki jak Scrapy i Playwright. Częstym wzorcem jest prototypowanie reguł ekstrakcji w Pythonie, a następnie przeniesienie krytycznej ścieżki do Rust, gdy logika jest stabilna i rośnie wolumen. Niezależnie od wyboru warstwa sieciowa jest równie ważna jak parser, a etycznie pozyskane proxy zapewniają niezawodność dużych zadań.
Często zadawane pytania
Które crate’y Rust są najlepsze do web scrapingu?
Najczęstsze połączenie to reqwest do żądań HTTP i scraper do parsowania HTML za pomocą selektorów CSS. Dodaj tokio do asynchronicznej współbieżności, serde do eksportu danych oraz crate do automatyzacji przeglądarki, taki jak thirtyfour lub chromiumoxide, gdy serwis wymaga renderowania JavaScript.
Czy Rust może scrapować strony renderowane przez JavaScript?
Nie za pomocą samych reqwest i scraper, ponieważ widzą one tylko surowy HTML zwracany przez serwer i nie potrafią wykonywać skryptów. Aby scrapować treść renderowaną po stronie klienta, sterujesz przeglądarką headless przez crate WebDriver, taki jak thirtyfour, lub crate DevTools Protocol, taki jak chromiumoxide.
Jak eksportować zebrane dane w Rust?
Zamodeluj każdy rekord jako strukturę dziedziczącą Serialize z serde, a następnie zapisz wycinek tych struktur do JSON za pomocą serde_json albo do CSV za pomocą crate’a csv. Jeden model typowany może zasilać oba formaty bez powielania logiki ekstrakcji.
Jak uruchamiać równoległe żądania bez przeciążania serwisu?
Zamień URL w strumień async i zastosuj buffer_unordered ze stałym limitem, który ogranicza liczbę żądań wykonywanych jednocześnie. Zacznij od około dziesięciu do dwudziestu równoległych żądań i połącz większą współbieżność z pulą rotating proxy, aby rozłożyć obciążenie na wiele IP.
Czy do web scrapingu w Rust potrzebuję proxy?
Nie przy małych zadaniach, ale proxy stają się ważne na większą skalę, aby rozkładać żądania i docierać do treści specyficznych dla lokalizacji. Skonfiguruj je za pomocą reqwest::Proxy i basic_auth oraz używaj rotating residential lub mobile IP, aby ograniczyć rate limiting i blokady.
Kiedy DataImpulse nie jest właściwym rozwiązaniem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do scrapingu albo dostępu do serwisów bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotating residential, mobile i datacenter proxies do zbierania danych publicznych oraz uzyskiwania dostępu do treści.
Powiązane przewodniki
Scrapuj niezawodnie z etycznymi proxy
Gdy Twój scraper Rust niezawodnie pobiera, parsuje i eksportuje dane, niezawodna sieć proxy pozwala mu działać na dużą skalę. DataImpulse oferuje etycznie pozyskane IP w modelu pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności, więc możesz utworzyć konto i skierować pierwsze żądania w ciągu kilku minut.