
In this Article
Ten poradnik wyjaśnia, jak prowadzić web scraping z JavaScript przy użyciu Node.js, środowiska uruchomieniowego, po które sięga większość inżynierów, gdy chce zbierać publiczne dane na dużą skalę. Nauka web scraping z JavaScript oznacza wybór odpowiedniego narzędzia do strony: lekkiego klienta HTTP dla statycznego HTML albo przeglądarki headless dla treści ładowanej przez skrypty.
Poniżej znajdziesz działający, gotowy do uruchomienia kod Node.js dla obu przypadków, a także konfigurację projektu, ustrukturyzowany eksport do JSON i CSV, paginację, ponowienia z backoff, ograniczanie szybkości, uwierzytelnianie proxy, przechwytywanie XHR oraz kwestie etyczne i blokady, które decydują o tym, czy scraper działa w dłuższym czasie.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności i jest używany do web scraping, ad verification, monitorowania cen, badań rynku i zarządzania wieloma kontami.
Najważniejsze informacje
- Dwa zestawy narzędzi: Strony statyczne potrzebują jedynie klienta HTTP i parsera, takiego jak fetch oraz cheerio, natomiast strony dynamiczne renderujące treść w przeglądarce wymagają silnika headless, takiego jak Puppeteer lub Playwright.
- Najlepszy typ proxy: rotujące residential proxies, które wykorzystują rzeczywiste konsumenckie IP przechodzące wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu ważności i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych IP w 195 krajach.
- Niezawodność: 99,51% skuteczności, ocena 4.8/5 na G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem krajów w cenie.
Co to jest web scraping z JavaScript?
Web scraping z JavaScript to proces programowego wysyłania żądań do stron internetowych i wydobywania z nich ustrukturyzowanych danych za pomocą JavaScript, zwykle uruchamianego w środowisku Node.js, a nie w karcie przeglądarki.
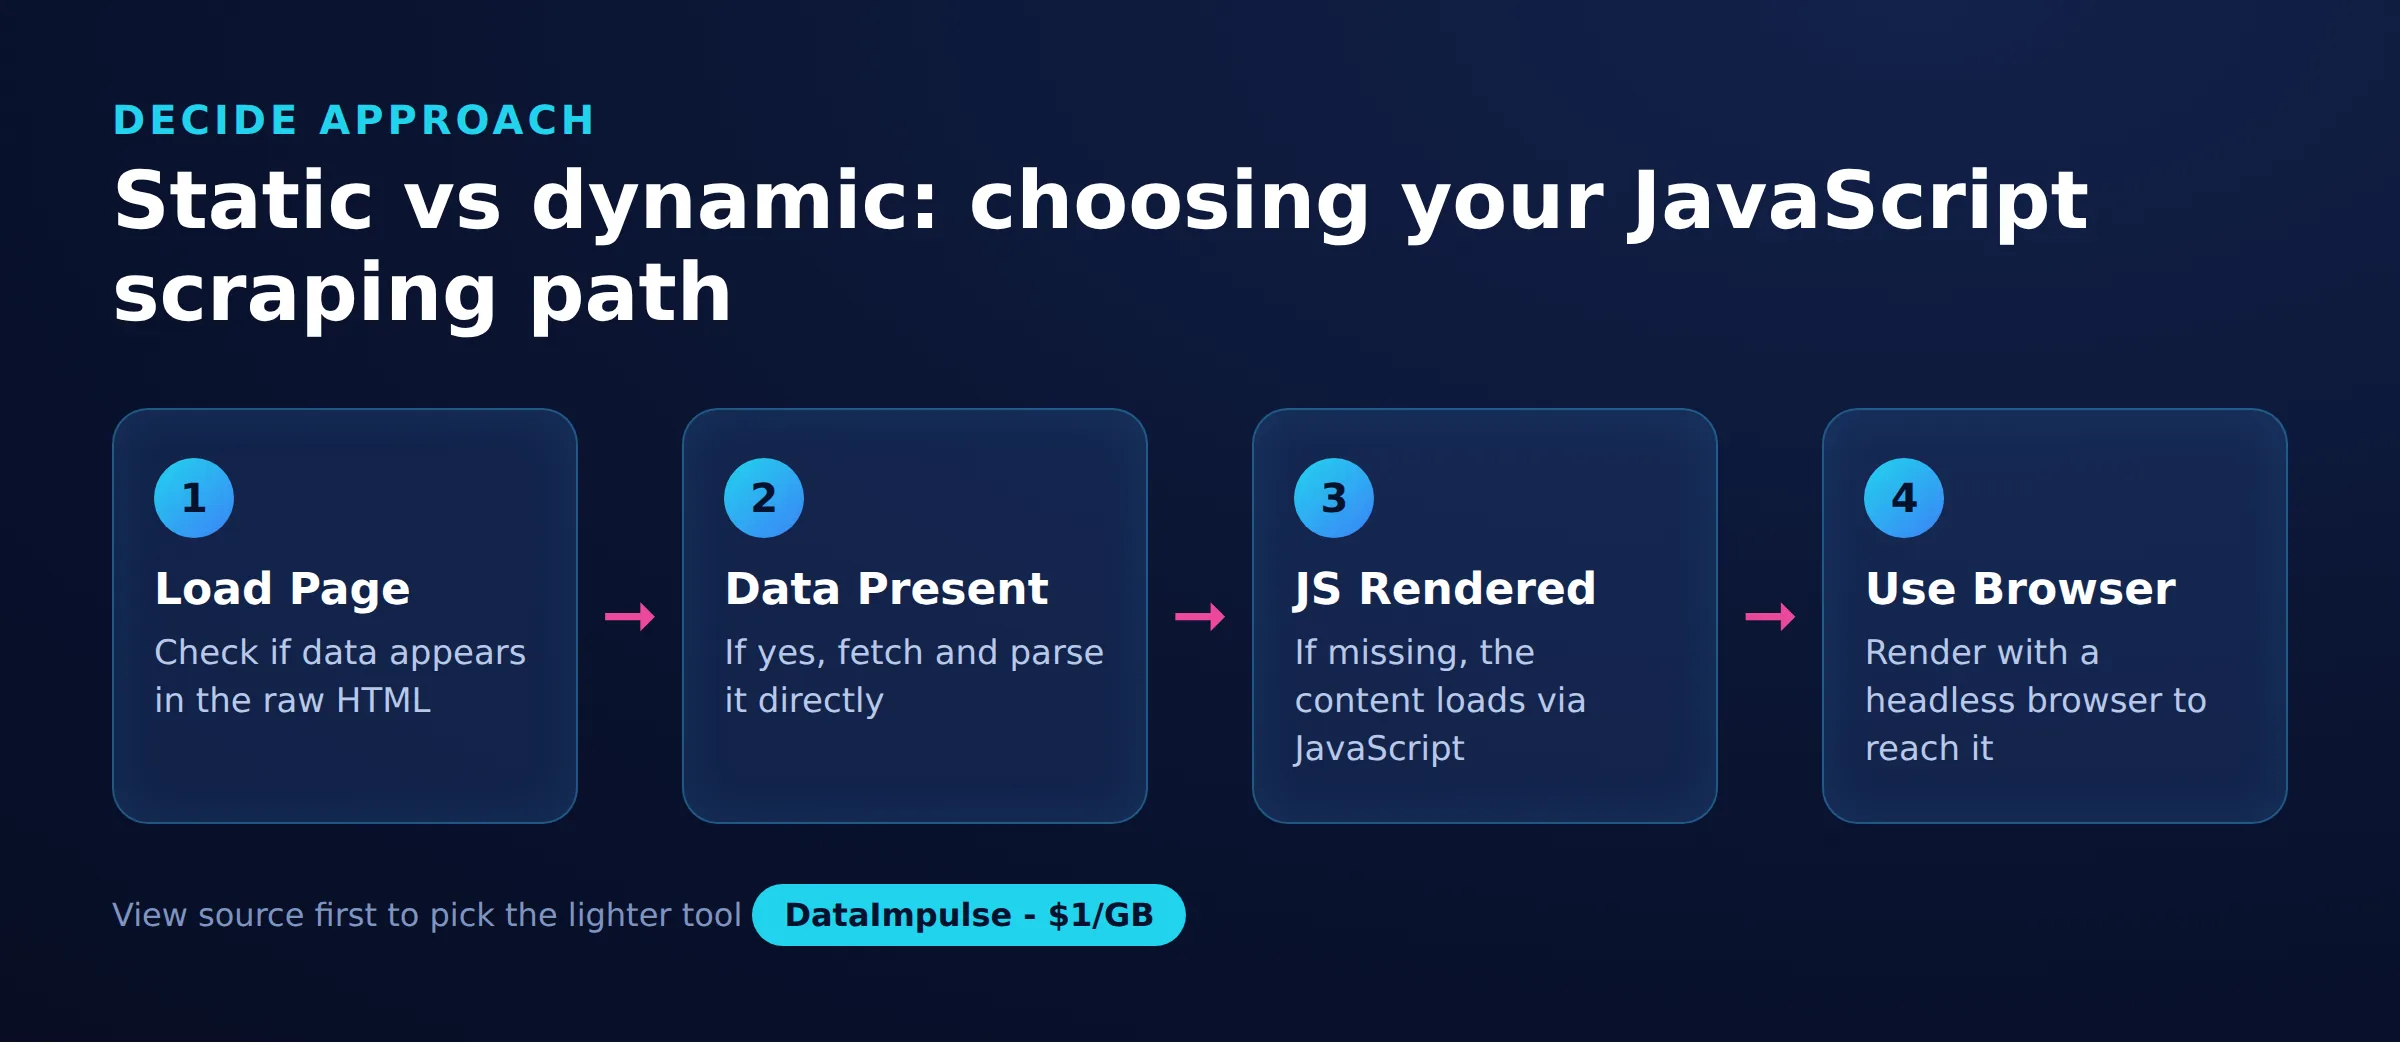
JavaScript jest naturalnym wyborem, ponieważ język ten już odwzorowuje Document Object Model, więc wybieranie elementów jest znajome dla programistów front-end. W praktyce scraper wykonuje trzy rzeczy: pobiera stronę przez HTTP, analizuje zwrócone znaczniki do drzewa, które można odpytywać, i wyciąga interesujące Cię pola, takie jak tytuły, ceny lub linki. Złożoność wynika ze sposobu, w jaki docelowa strona dostarcza dane, dlatego wybór właściwego narzędzia jest ważniejszy niż samo parsowanie. Strony statyczne wysyłają dane w pierwszej odpowiedzi HTML, natomiast strony dynamiczne składają je w przeglądarce po załadowaniu, a oba przypadki wymagają różnych zestawów narzędzi.
Jak skonfigurować projekt scrapingowy Node.js?
Utwórz folder projektu, zainicjuj go za pomocą npm i zainstaluj potrzebne biblioteki, zanim napiszesz kod scrapera.
Node.js 18 i nowsze wersje mają wbudowaną globalną funkcję fetch, więc do prostych żądań GET nie potrzebujesz biblioteki HTTP, choć wiele zespołów nadal wybiera axios ze względu na interceptory i obsługę proxy. Poniższe polecenia tworzą szkielet projektu i instalują cheerio do parsowania, axios jako alternatywnego klienta, p-limit do kontroli współbieżności oraz Puppeteer i Playwright dla stron dynamicznych:
mkdir js-scraper && cd js-scraper
npm init -y
npm install cheerio axios p-limit
npm install puppeteer playwright

# enable modern import syntax
npm pkg set type=module
Ustawienie type=module pozwala używać instrukcji import. Jeśli wolisz CommonJS, pozostaw domyślne ustawienie i użyj require zamiast tego. Przykłady w tym poradniku korzystają ze składni import, ale każdy z nich przekłada się bezpośrednio na wywołanie require. Po zakończeniu instalacji masz wszystko, czego potrzebujesz do statycznego i dynamicznego scrapingu w jednym projekcie.
Jak scrapować stronę statyczną za pomocą fetch i cheerio?
Dla stron statycznych pobierz HTML wbudowaną funkcją fetch i sparsuj go za pomocą cheerio, które daje na serwerze API w stylu jQuery.
Strony statyczne zwracają treść bezpośrednio w początkowej odpowiedzi HTML, więc renderowanie w przeglądarce nie jest potrzebne. To podejście jest szybkie i tanie, ponieważ pobierasz wyłącznie znaczniki, a nie obrazy, czcionki ani skrypty. Poniższy przykład pobiera stronę, ładuje ją do cheerio i odczytuje każdą kartę produktu:
import * as cheerio from 'cheerio';

async function scrape(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
  });
  if (!res.ok) throw new Error(`Request failed: ${res.status}`);
  const html = await res.text();
  const $ = cheerio.load(html);

  const items = [];
  $('.product').each((i, el) => {
    items.push({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim(),
      link: $(el).find('a').attr('href')
    });
  });
  return items;
}

console.log(await scrape('https://example.com/catalog'));
Jeśli wolisz axios, część dotycząca parsowania jest identyczna i zmienia się tylko żądanie. Axios automatycznie zgłasza wyjątki dla kodów statusu innych niż 2xx i upraszcza konfigurację proxy, dlatego używa go wiele scraperów produkcyjnych:
import axios from 'axios';
import * as cheerio from 'cheerio';

const { data: html } = await axios.get('https://example.com/catalog', {
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' },
  timeout: 15000
});
const $ = cheerio.load(html);
const titles = $('.product h2').map((i, el) => $(el).text().trim()).get();
console.log(titles);
Przed skierowaniem scrapera na dowolną stronę warto sprawdzić, czy cel na to pozwala. Nasz poradnik, jak sprawdzić, czy witryna zezwala na scraping, omawia robots.txt i warunki świadczenia usług.
Jak wydobywać ustrukturyzowane dane do JSON i CSV?
Zbieraj każdy rekord do tablicy zwykłych obiektów, a następnie zapisz tę tablicę do pliku JSON albo spłaszcz ją do wierszy rozdzielanych przecinkami dla pliku CSV.
Surowy tekst zebrany przez scraping jest użyteczny dopiero, gdy zostanie zapisany w przewidywalnej formie. JSON jest najprostszym celem, ponieważ tablica JavaScript serializuje się bezpośrednio. Poniższy fragment zapisuje zebrane elementy na dysku za pomocą wbudowanego modułu systemu plików:
import { writeFile } from 'node:fs/promises';

const items = await scrape('https://example.com/catalog');
await writeFile('products.json', JSON.stringify(items, null, 2), 'utf-8');
console.log(`Saved ${items.length} records to products.json`);
CSV sprawdza się lepiej, gdy dane trafiają do arkusza kalkulacyjnego lub hurtowni danych. Możesz utworzyć go bez biblioteki, stosując escapowanie cudzysłowów i łączenie pól, choć escapowanie ma znaczenie, ponieważ ceny i tytuły mogą zawierać przecinki:
import { writeFile } from 'node:fs/promises';

function toCsv(rows) {
  const headers = Object.keys(rows[0]);
  const escape = (v) => `"${String(v ?? '').replace(/"/g, '""')}"`;
  const lines = [headers.join(',')];
  for (const row of rows) {
    lines.push(headers.map((h) => escape(row[h])).join(','));
  }
  return lines.join('\n');
}

const items = await scrape('https://example.com/catalog');
await writeFile('products.csv', toCsv(items), 'utf-8');
Zachowuj stałe nazwy pól między uruchomieniami, aby narzędzia dalszego przetwarzania nie przestały działać przy niewielkiej zmianie układu strony. Jeśli musisz także pobrać zasoby binarne, zobacz nasz poradnik, jak scrapować obrazy z witryny.
Jak scrapować wiele stron z paginacją?
Iteruj po URL stron witryny albo podążaj za linkiem do następnej strony na każdej stronie, scrapując każdą z nich i zatrzymując się, gdy nie ma już wyników.
Większość katalogów dzieli wyniki na numerowane strony przy użyciu parametru zapytania, takiego jak ?page=2, albo udostępnia link do następnej strony. Najbezpieczniejszy wzorzec odczytuje każdą stronę, zbiera jej rekordy, następnie szuka kolejnej strony i zatrzymuje się, gdy jej brakuje. Poniższy przykład przechodzi przez numerowane strony, aż strona nie zwróci żadnych elementów:
import * as cheerio from 'cheerio';

async function scrapeAll(base) {
  const all = [];
  for (let page = 1; page <= 50; page++) {
    const res = await fetch(`${base}?page=${page}`, {
      headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
    });
    if (!res.ok) break;
    const $ = cheerio.load(await res.text());
    const items = $('.product').map((i, el) => ({
      title: $(el).find('h2').text().trim(),
      price: $(el).find('.price').text().trim()
    })).get();

    if (items.length === 0) break;
    all.push(...items);
    await new Promise((r) => setTimeout(r, 1000));
  }
  return all;
}

console.log((await scrapeAll('https://example.com/catalog')).length);
Zwróć uwagę na jednosekundową przerwę między stronami i sztywny limit 50 iteracji, który zapobiega niekontrolowanej pętli, jeśli witryna nigdy nie zwróci pustej strony. Gdy treść ładuje się przez przewijanie, a nie przez numerowane strony, potrzebujesz przeglądarki headless, co omawia poniższa sekcja o Puppeteer.
Jak obsługiwać ponowienia, backoff i ograniczanie szybkości?
Otocz każde żądanie pomocnikiem ponowień, który czeka dłużej po każdej awarii, i ogranicz liczbę żądań uruchamianych naraz, aby mieścić się w tolerancji witryny.
Sieci są zawodne, a serwery zwracają przejściowe błędy, więc scraper, który rezygnuje po pierwszej awarii, niepotrzebnie traci dane. Pomocnik ponowień z wykładniczym backoff czeka coraz dłużej między próbami, dając także serwerowi z ograniczeniem szybkości czas na odzyskanie sprawności:
async function fetchWithRetry(fn, retries = 4, delay = 1000) {
  for (let attempt = 1; attempt <= retries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === retries) throw err;
      const wait = delay * 2 ** (attempt - 1);
      console.warn(`Attempt ${attempt} failed, retrying in ${wait}ms`);
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const html = await fetchWithRetry(async () => {
  const res = await fetch('https://example.com/catalog');
  if (res.status === 429) throw new Error('Rate limited');
  if (!res.ok) throw new Error(`HTTP ${res.status}`);
  return res.text();
});
Backoff obsługuje pojedyncze żądania, ale musisz też kontrolować, ile działa równolegle. Wysyłanie setek współbieżnych żądań obciąża docelowy serwer i powoduje oznaczanie Twojego ruchu. Biblioteka p-limit ogranicza współbieżność, dzięki czemu stała liczba workerów przetwarza kolejkę URL:
import pLimit from 'p-limit';

const limit = pLimit(5); // at most 5 requests in flight
const urls = Array.from({ length: 100 }, (_, i) =>
  `https://example.com/item/${i + 1}`
);

const results = await Promise.all(
  urls.map((url) =>
    limit(() => fetchWithRetry(async () => {
      const res = await fetch(url);
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return res.text();
    }))
  )
);

console.log(`Fetched ${results.length} pages with a cap of 5 in parallel`);
Razem backoff i limit współbieżności utrzymują rozsądny ślad Twojego działania i wysoką skuteczność. Szerszą listę kontrolną znajdziesz w naszym poradniku najlepsze praktyki web scraping.
Jak scrapować strony dynamiczne za pomocą Puppeteer?
Dla stron dynamicznych, które budują treść za pomocą JavaScript po załadowaniu, steruj headless Chrome przez Puppeteer, zaczekaj na docelowy selektor i odczytaj w pełni wyrenderowany DOM.
Wiele nowoczesnych witryn zwraca prawie pustą powłokę HTML, a potem pobiera dane przez żądania w tle. Klient HTTP nie widzi nic użytecznego, więc potrzebujesz silnika, który uruchamia własny JavaScript strony. Puppeteer steruje headless Chrome i może czekać na elementy, klikać oraz przewijać. Poniższy przykład czeka na selektor, a następnie wielokrotnie przewija, aby uruchomić ładowanie infinite-scroll, przed wydobyciem danych w kontekście przeglądarki:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();
await page.setUserAgent('Mozilla/5.0 (compatible; MyScraper/1.0)');
await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });

// wait until the first batch of cards is present
await page.waitForSelector('.product');

// infinite scroll: scroll to the bottom until height stops growing
let previousHeight = 0;
for (let i = 0; i < 20; i++) {
  const height = await page.evaluate('document.body.scrollHeight');
  if (height === previousHeight) break;
  previousHeight = height;
  await page.evaluate('window.scrollTo(0, document.body.scrollHeight)');
  await new Promise((r) => setTimeout(r, 1500));
}

const items = await page.evaluate(() =>
  Array.from(document.querySelectorAll('.product')).map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Pętla zatrzymuje się, gdy wysokość strony przestaje rosnąć, co sygnalizuje, że nie ładuje się nowa treść, a sztywny limit 20 przewinięć zapobiega nieskończonej pętli. Więcej o tej klasie celów znajdziesz w naszym poradniku, jak scrapować dynamiczne strony internetowe.
Jak używać Playwright jako alternatywy dla Puppeteer?
Playwright działa niemal identycznie jak Puppeteer, ale dodaje pełne wsparcie dla Chromium, Firefox i WebKit oraz lokalizatory z automatycznym oczekiwaniem, które zmniejszają niestabilność selektorów.
Playwright został stworzony przez część pierwotnych inżynierów Puppeteer i współdzieli większość API, więc migracja zwykle polega na zmianie nazw kilku wywołań. Jego lokalizatory automatycznie czekają, aż elementy będą gotowe do działania, co eliminuje wiele ręcznych wywołań waitForSelector. Równoważny scraper wygląda tak:
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const context = await browser.newContext({
  userAgent: 'Mozilla/5.0 (compatible; MyScraper/1.0)'
});
const page = await context.newPage();
await page.goto('https://example.com/feed', { waitUntil: 'networkidle' });

await page.locator('.product').first().waitFor();

const items = await page.locator('.product').evaluateAll((els) =>
  els.map((el) => ({
    title: el.querySelector('h2')?.innerText.trim(),
    price: el.querySelector('.price')?.innerText.trim()
  }))
);

console.log(`Extracted ${items.length} items`);
await browser.close();
Wybierz Playwright, gdy musisz testować ten sam scraper w wielu silnikach przeglądarek albo chcesz korzystać z wbudowanego mockowania sieci. Wybierz Puppeteer, gdy celujesz wyłącznie w Chrome i chcesz mniejszej zależności. Oba zużywają znacznie więcej pamięci niż fetch i cheerio, więc zarezerwuj je dla stron, które faktycznie wymagają renderowania.
Które narzędzie JavaScript do scrapingu wybrać?
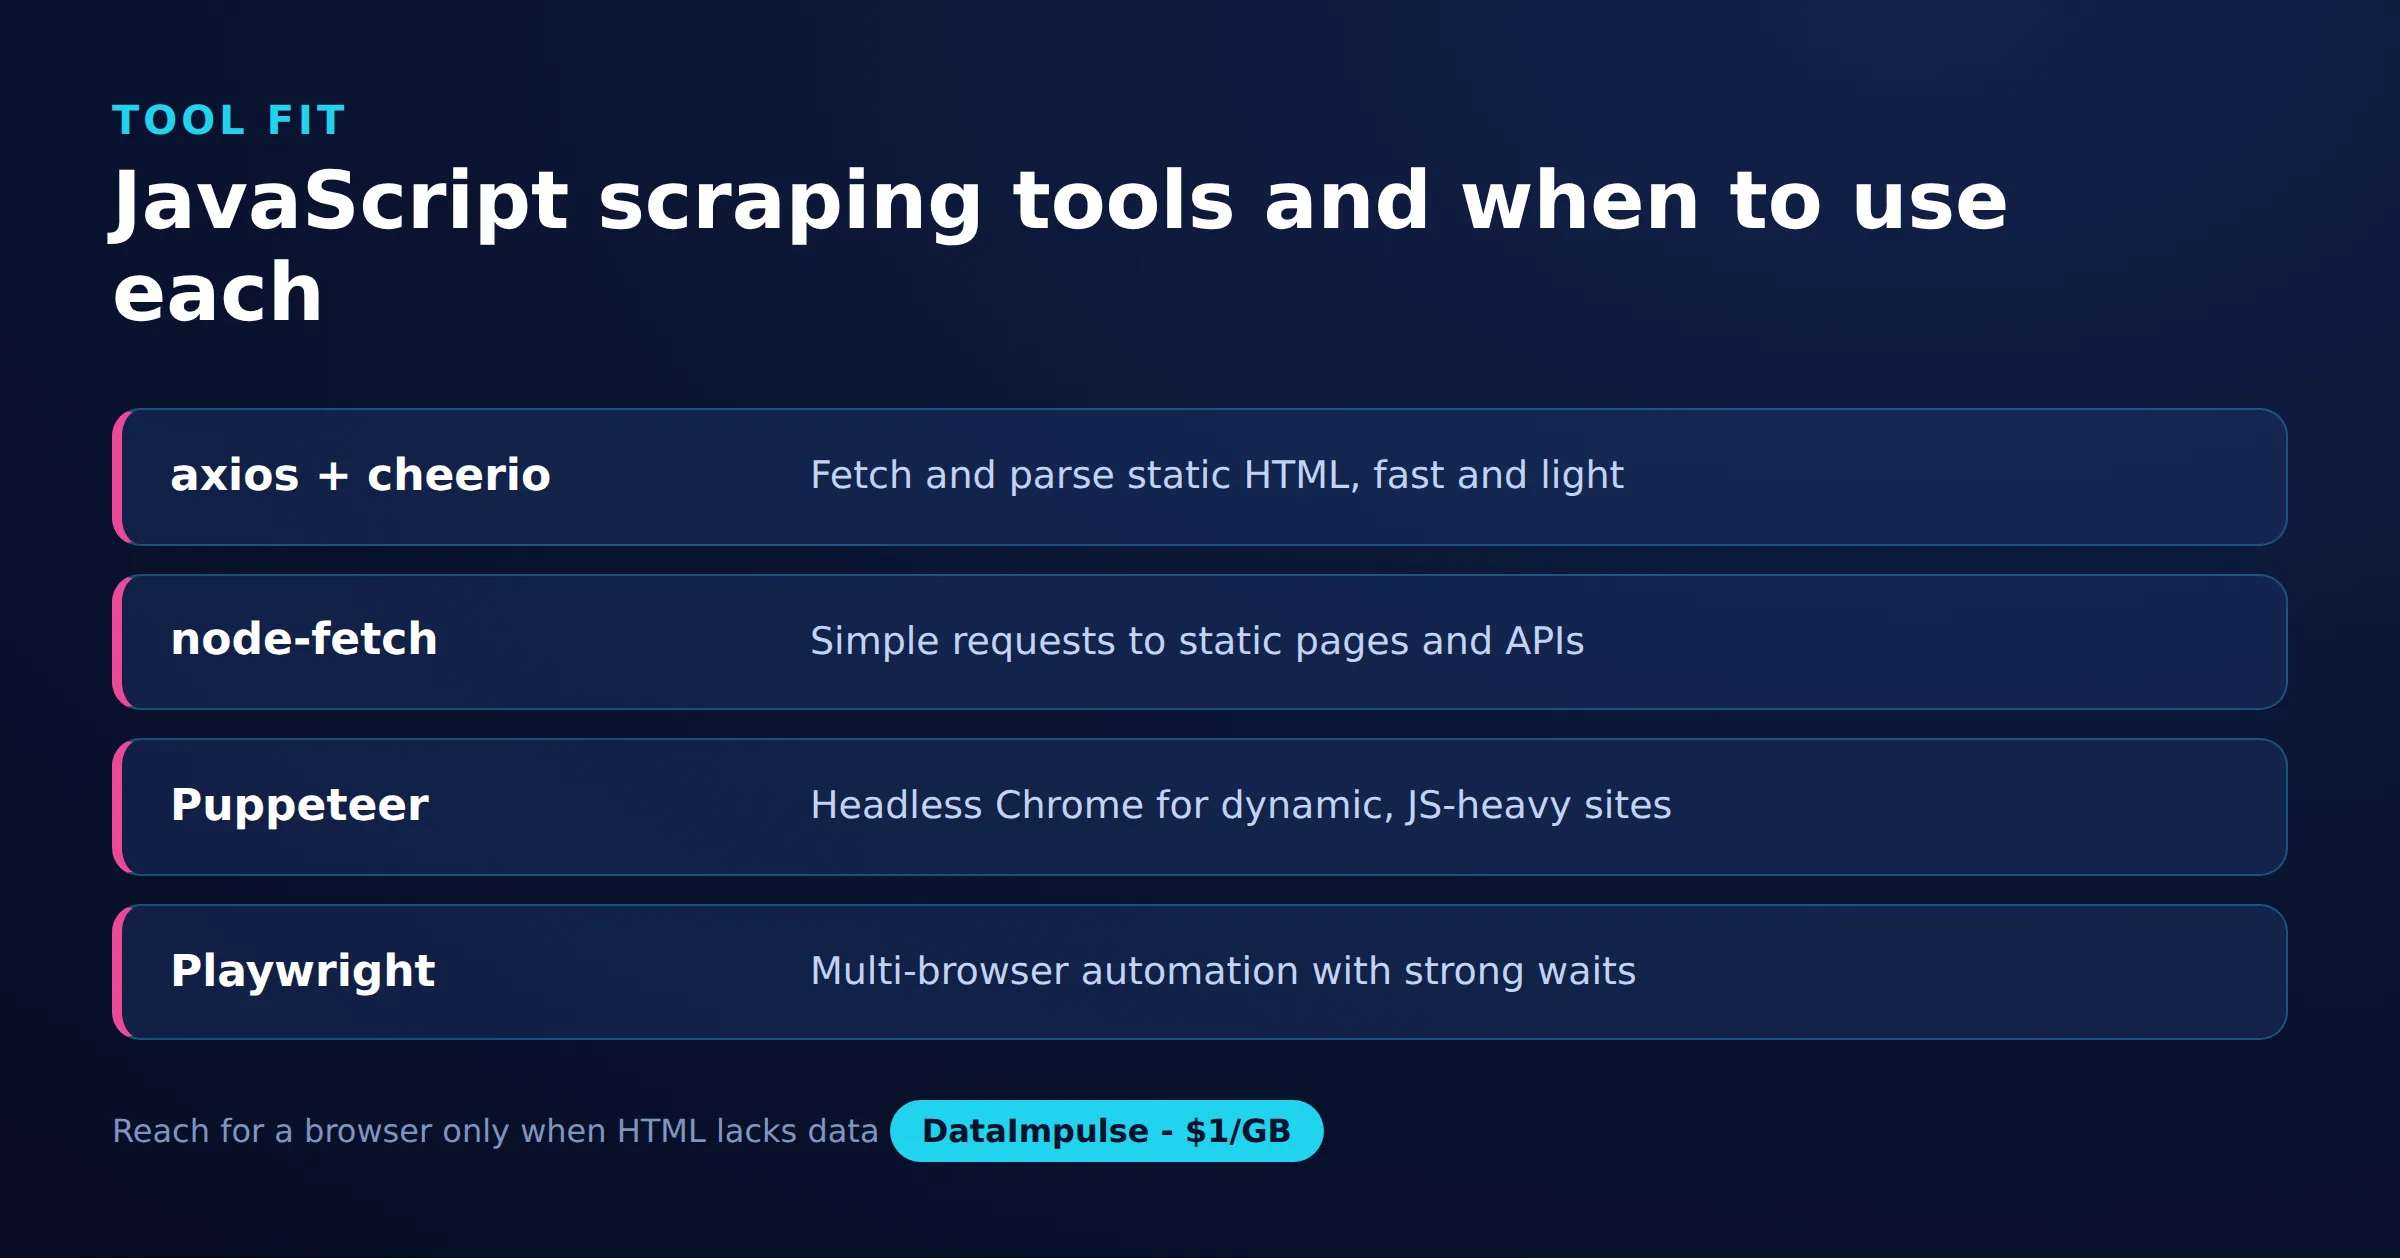
Używaj fetch lub axios z cheerio dla statycznego HTML, a po Puppeteer lub Playwright sięgaj tylko wtedy, gdy strona renderuje dane w przeglądarce.
Właściwe narzędzie zależy od sposobu dostarczania danych przez stronę i od tego, na ile cenisz szybkość ponad wierność renderowania. Klienci HTTP są szybcy i lekcy, ale nie uruchamiają JavaScript; przeglądarki headless uruchamiają wszystko, co widzi rzeczywisty użytkownik, ale kosztują więcej pamięci i czasu. Poniższa tabela podsumowuje kompromisy:
| Narzędzie | Uruchamia JS | Szybkość | Najlepsze zastosowanie |
|---|---|---|---|
| fetch + cheerio | Nie | Najszybsze | Statyczny HTML, duży wolumen |
| axios + cheerio | Nie | Szybkie | Statyczny HTML, łatwa konfiguracja proxy |
| Puppeteer | Tak | Wolne | Dynamiczne strony tylko dla Chrome |
| Playwright | Tak | Wolne | Dynamiczne testy między przeglądarkami |
Typowy wzorzec produkcyjny łączy oba podejścia: używaj przeglądarki headless tylko do dotarcia do stron lub endpointów wymagających renderowania, a następnie wracaj do zwykłego klienta HTTP dla większości żądań. JavaScript to jeden z kilku sprawdzonych stosów dla tej pracy; jeśli porównujesz ekosystemy, nasz poradnik web scraping z Rust omawia kompilowaną alternatywę.
Jak kierować scrapery JavaScript przez proxy?
Przekaż ustawienia proxy do klienta HTTP lub opcji uruchamiania przeglądarki, aby żądania wychodziły z innego adresu IP, co rozkłada obciążenie i zmniejsza ryzyko ograniczenia szybkości pojedynczego adresu.
Scraping wielu stron z jednego IP to najszybszy sposób na blokadę. Rotowanie żądań po puli adresów sprawia, że ruch wygląda jak ruch wielu oddzielnych odwiedzających. W axios podajesz host proxy, port i poświadczenia w konfiguracji żądania. Poniższy przykład kieruje ruch przez bramę DataImpulse:
import axios from 'axios';

const { data } = await axios.get('https://example.com', {
  proxy: {
    protocol: 'http',
    host: 'gw.dataimpulse.com',
    port: 823,
    auth: { username: 'YOUR_USERNAME', password: 'YOUR_PASSWORD' }
  },
  headers: { 'User-Agent': 'Mozilla/5.0 (compatible; MyScraper/1.0)' }
});
console.log(data.length, 'bytes received through the proxy');
Puppeteer przyjmuje proxy jako argument uruchomienia, a następnie uwierzytelnia się na stronie, ponieważ Chrome nie akceptuje poświadczeń wewnątrz URL proxy. Ten sam wzorzec działa w Playwright, który bezpośrednio akceptuje obiekt proxy z nazwą użytkownika i hasłem:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({
  headless: 'new',
  args: ['--proxy-server=gw.dataimpulse.com:823']
});
const page = await browser.newPage();
await page.authenticate({
  username: 'YOUR_USERNAME',
  password: 'YOUR_PASSWORD'
});
await page.goto('https://example.com', { waitUntil: 'networkidle2' });
console.log(await page.title());
await browser.close();
DataImpulse oferuje residential proxies, datacenter proxies oraz mobile proxies przez HTTP, HTTPS i SOCKS5, z sesjami rotującymi i sticky session. Targetowanie krajów jest w cenie, natomiast targetowanie stanu, miasta, ZIP i ASN to płatne dodatki. Jeśli żądanie proxy zwraca błąd uwierzytelniania, nasza notatka o błędzie HTTP 407 wyjaśnia najczęstszą przyczynę, a nasz poradnik uwierzytelnianie proxy omawia bardziej szczegółowo formaty poświadczeń.
Jak przechwytywać endpointy XHR i JSON?
Zamiast scrapować wyrenderowany HTML, obserwuj ruch sieciowy w przeglądarce headless i odczytuj odpowiedzi JSON pobierane przez stronę w tle, co często jest czystsze i szybsze.
Strony dynamiczne zwykle pobierają dane z ukrytego API, które zwraca JSON. Bezpośredni odczyt tej odpowiedzi całkowicie pomija parsowanie DOM i daje dobrze ustrukturyzowane rekordy. Zarówno Puppeteer, jak i Playwright pozwalają nasłuchiwać odpowiedzi oraz przechwytywać te, których potrzebujesz. Poniższy przykład Puppeteer przechwytuje każdą odpowiedź JSON ze ścieżki API:
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: 'new' });
const page = await browser.newPage();

const captured = [];
page.on('response', async (response) => {
  const url = response.url();
  if (url.includes('/api/') && response.headers()['content-type']?.includes('application/json')) {
    try {
      captured.push(await response.json());
    } catch (err) {
      // non-JSON body, ignore
    }
  }
});

await page.goto('https://example.com/feed', { waitUntil: 'networkidle2' });
console.log(`Captured ${captured.length} JSON payloads`);
await browser.close();
Gdy znasz URL endpointu i jego parametry, często możesz całkowicie zrezygnować z przeglądarki i wywołać JSON API zwykłym fetch, przekazując te same headers, które wysłała strona. Daje to szybkość scrapera statycznego i kompletność wyrenderowanego oraz jest największym pojedynczym zyskiem wydajności dostępnym dla stron dynamicznych.
Jakie są etyczne i prawne granice scrapingu?
Scrapuj wyłącznie dane publiczne, przestrzegaj robots.txt i warunków świadczenia usług witryny, unikaj danych osobowych i nigdy nie przeciążaj serwera. Takie praktyki sprawiają, że Twój projekt jest zarówno możliwy do obrony, jak i zrównoważony.
Sprawdź plik robots.txt w katalogu głównym domeny, aby zobaczyć, których ścieżek witryna prosi roboty o unikanie, i traktuj te prośby poważnie. Zidentyfikuj swój scraper uczciwym User-Agent, ograniczaj żądania i cache’uj odpowiedzi, aby nie pobierać bez potrzeby tej samej strony ponownie. Po stronie infrastruktury ważne jest źródło Twoich adresów IP. DataImpulse prowadzi etyczne proxy pozyskiwane od użytkowników, którzy wyrażają zgodę i otrzymują wynagrodzenie, zgodnie z RODO, z dostępną umową o przetwarzaniu danych. Etyka to nie tylko kwestia zgodności; uprzejme, transparentne scrapery to również te, które nadal działają. Zasady zrównoważonego zbierania omawia nasz poradnik o etycznym web scraping.
Najczęściej zadawane pytania
Czy do scrapingu z JavaScript potrzebuję Node.js?
Do wszystkiego poza szybkim testem jednej strony – tak. Node.js pozwala uruchamiać scrapery na serwerze, iterować po wielu URL, obsługiwać ponowienia, eksportować dane i używać proxy, czego konsola przeglądarki nie robi dobrze.
Kiedy użyć Puppeteer zamiast fetch i cheerio?
Użyj fetch lub axios z cheerio, gdy dane są obecne w początkowej odpowiedzi HTML. Przejdź na Puppeteer lub Playwright tylko wtedy, gdy treść jest renderowana przez JavaScript po załadowaniu strony, ponieważ przeglądarka headless jest znacznie cięższa.
Jak wyeksportować zebrane dane do CSV w Node.js?
Zbierz rekordy jako tablicę obiektów, a następnie zbuduj wiersze rozdzielane przecinkami, łącząc wartości każdego obiektu i stosując escapowanie cudzysłowów oraz przecinków. Zapisz wynik do pliku za pomocą wbudowanego modułu fs albo użyj biblioteki, takiej jak csv-stringify.
Dlaczego dostaję blokadę podczas scrapingu z JavaScript?
Typowe przyczyny to zbyt wiele żądań z jednego IP, brakujący lub podejrzany User-Agent oraz brak opóźnień między żądaniami. Rotujące proxy, realistyczne headers, ponowienia z backoff i ograniczanie szybkości zmniejszają liczbę blokad.
Jaki typ proxy jest najlepszy do scrapingu z JavaScript?
Datacenter proxies są szybkie i tanie dla tolerancyjnych celów, natomiast residential i mobile proxies bardziej przypominają rzeczywistych użytkowników na restrykcyjnych stronach. Rotujące sesje pomagają rozłożyć żądania na wiele adresów.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych ISP proxies, w pełni zarządzanego API do scrapingu lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotujących residential, mobile i datacenter proxies do zbierania danych publicznych i uzyskiwania dostępu do treści.
Rozpocznij scraping z niezawodnymi proxy
Chcesz, aby Twoje scrapery JavaScript działały bez ciągłych blokad? DataImpulse zapewnia etycznie pozyskiwane IP residential, mobile i datacenter od 1 dolara za GB, z ruchem bez terminu ważności i bez subskrypcji. Utwórz konto i skieruj swój pierwszy scraper przez proxy już dziś.