
In this Article
Dinamik web sayfalarını nasıl kazıyacağınızı öğrenmek, ilk isteğinizin indirdiği HTML içinde bulunmayan içeriklerle uğraşmayı gerektirir. Modern siteler ürün ızgaralarını, fiyatları, yorumları ve akışları tarayıcıda JavaScript ile oluşturur; bu nedenle basit bir HTTP alma işlemi, verilerin olması gereken yerde boş bir kabuk döndürür.
Bu rehber Python ile tüm iş akışını anlatır. Ham yanıtı işlenmiş DOM ile karşılaştırarak dinamik içeriği saptamayla başlar; ardından çıkarma seçeneklerini en düşük maliyetliden en ağırına doğru sıralar: gizli JSON API’yi bulma, Playwright veya Selenium’ı kullanma, sonsuz kaydırma ve daha fazla yükle düğmelerini yönetme, proxy bant genişliğini azaltma, yeniden denemeler ekleme, eşzamanlı kazıma ve temiz JSON ile CSV dışa aktarma.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. GB başına 1 dolardan başlayan, süresi dolmayan trafiğe sahip kullandıkça öde modelini kullanır; web scraping, reklam doğrulama, fiyat izleme, pazar araştırması ve çoklu hesap yönetimi için kullanılır.
Önemli Bilgiler
- Dinamik kazıma: JavaScript ile oluşturulan içerik ham HTML içinde yer almaz; bu nedenle sayfanın çağırdığı temel JSON API’yi kullanır veya sayfayı headless bir tarayıcıda işlersiniz.
- En iyi proxy türü: bot tespitini aşan gerçek tüketici IP’lerini kullanan dönen residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, kullandıkça öde; süresi dolmayan trafik ve abonelik yok.
- Kapsam: 195 ülkede etik biçimde tedarik edilmiş 90M+ IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: Ülke hedefleme dahil HTTP, HTTPS ve SOCKS5.
Bir web sayfasını dinamik yapan nedir?
Anlamlı içeriği ilk HTML yanıtıyla sunmak yerine tarayıcıda JavaScript ile oluşturulan sayfa dinamiktir. Sunucu hafif bir iskelet gönderir; istemci tarafındaki kod da sayfa açıldıktan sonra verileri alıp DOM’a ekler.
En hızlı manuel kontrol, aynı sayfanın iki görünümünü karşılaştırmaktır. Sunucunun döndürdüğü ham HTML’yi görmek için sağ tıklayıp Sayfa Kaynağını Görüntüle’yi seçin; ardından geliştirici araçlarını açın ve betikler çalıştıktan sonraki canlı DOM’u gösteren Elements panelini inceleyin. İstediğiniz fiyat veya listeleme Elements panelinde görünüyor ancak Sayfa Kaynağında yoksa içerik dinamiktir ve tek bir istek bunu yakalayamaz.
- Statik içerik Sayfa Kaynağında bulunur ve doğrudan bir HTTP yanıtından ayrıştırılabilir.
- Dinamik içerik yalnızca işlenmiş DOM’da görünür ve arka plan istekleriyle yüklenir.
Bu tanıyı kodla otomatikleştirebilirsiniz. Önce normal bir HTTP istemcisinin indirdiği ham HTML içindeki hedef öğeleri sayın:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=30)
soup = BeautifulSoup(resp.text, "html.parser")

raw_cards = soup.select("div.product-card")
print("Cards in raw HTML:", len(raw_cards))

# If this prints 0 but the page clearly shows products in a browser,
# the content is injected by JavaScript and the page is dynamic.
Ardından aynı URL’yi headless bir tarayıcıda işleyin ve tekrar sayın. İki sayı arasındaki fark kanıttır:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://example.com/products", wait_until="networkidle")
    rendered_cards = page.query_selector_all("div.product-card")
    print("Cards after JavaScript runs:", len(rendered_cards))
    browser.close()

# Raw HTML 0, rendered DOM 48 means the page builds its content dynamically.
Tam kapsamlı bir scraper yazmadan önce hedefin otomatik erişime izin verdiğini doğrulamanız da faydalıdır. bir web sitesinin kazımaya izin verip vermediğini kontrol etme rehberimiz, robots kurallarını ve hizmet şartlarını incelemeyi açıklar.
Dinamik sayfaları kazımak için hangi yöntemi kullanmalısınız?
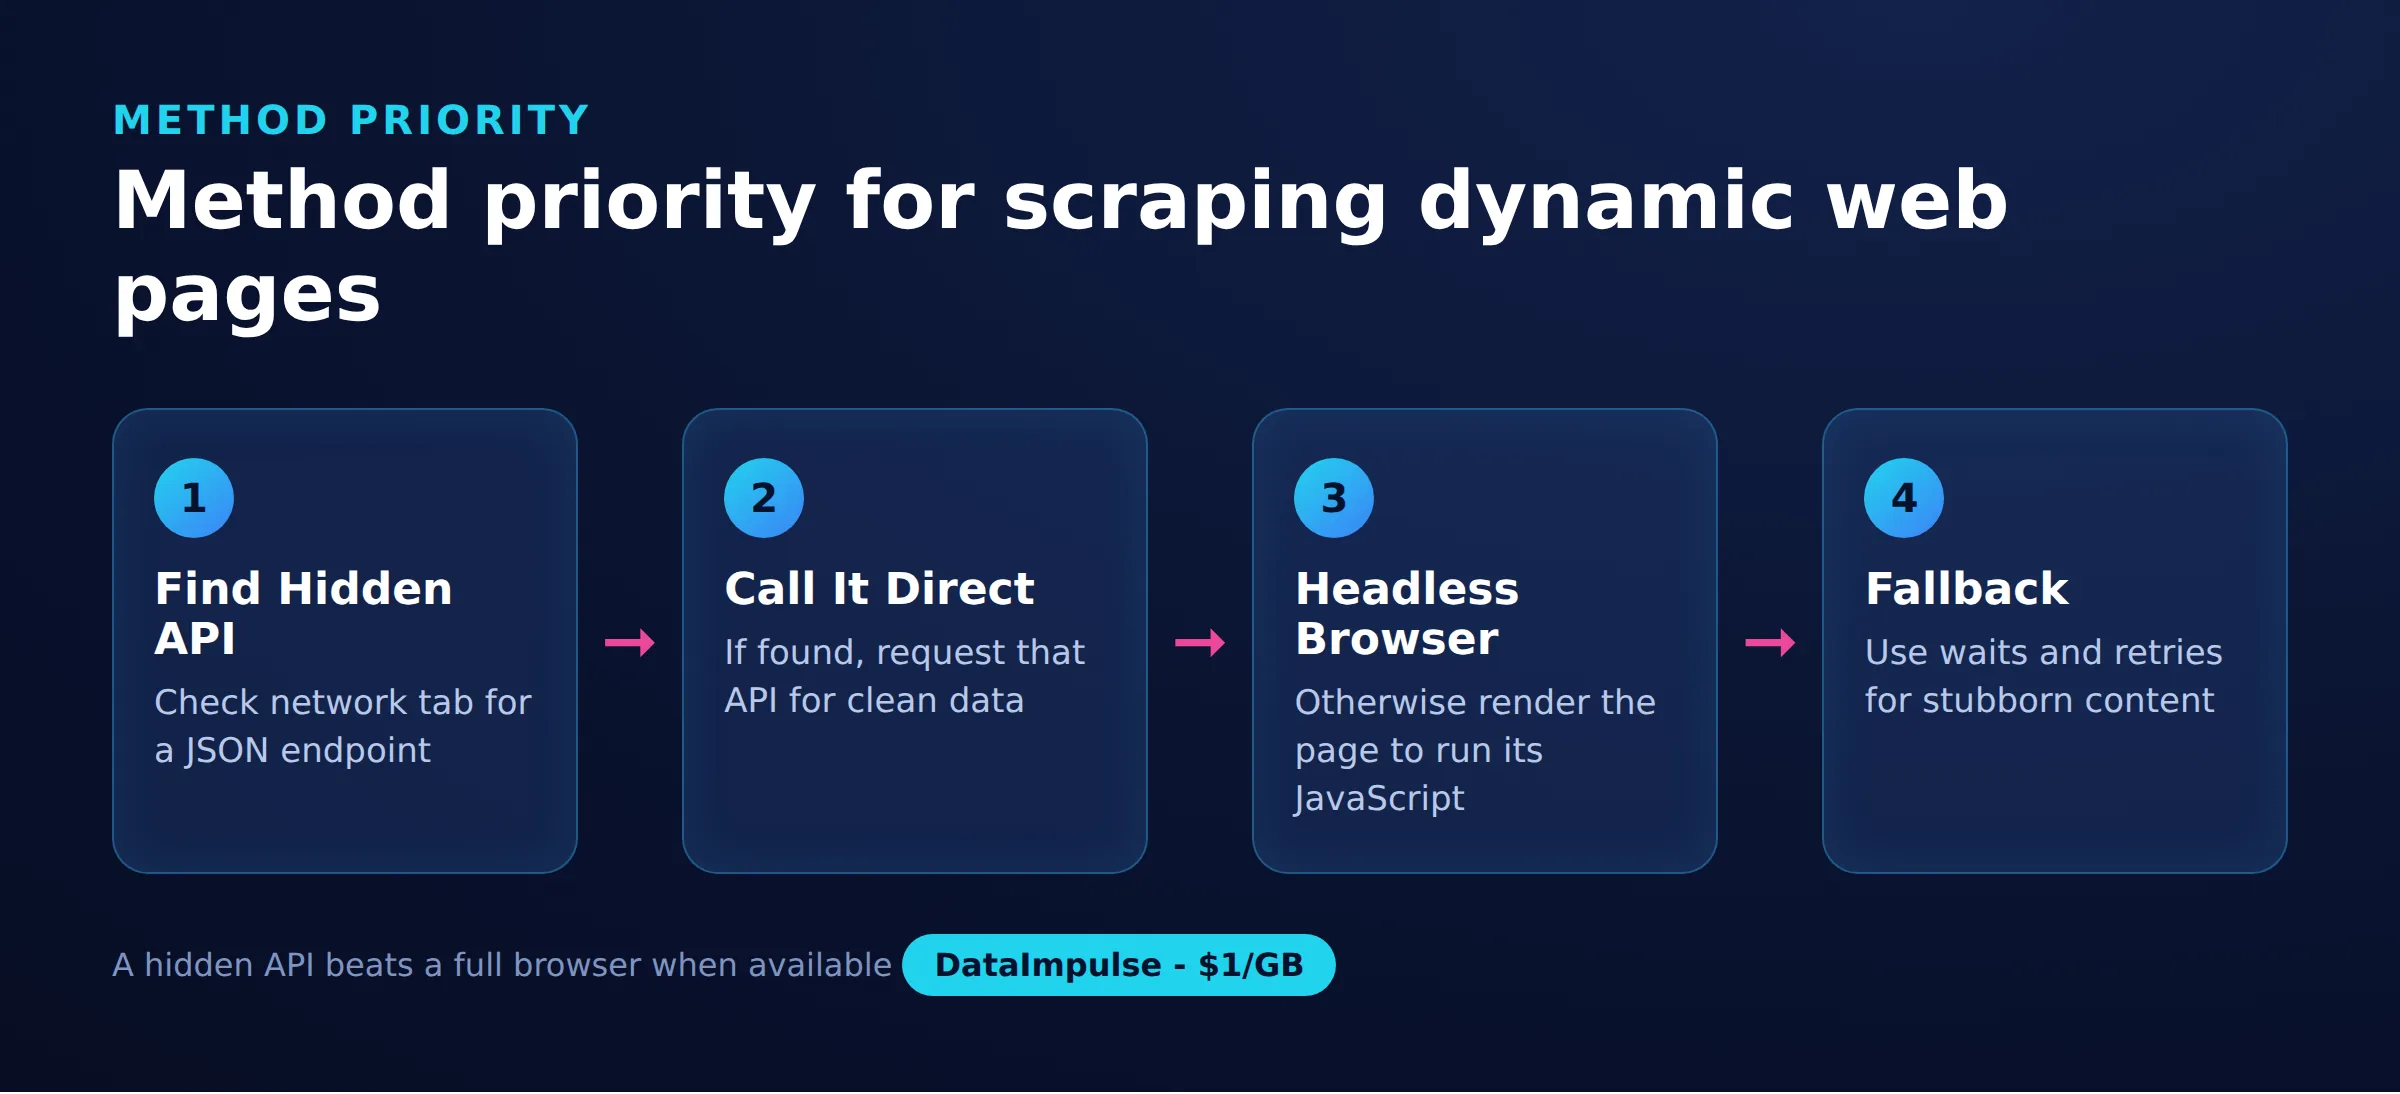
Veriyi güvenilir biçimde döndüren en hafif yöntemi seçin: Gizli bir JSON API varsa onu çağırın, yoksa yalnızca headless tarayıcıya başvurun. Her seçenekte hız ve maliyet, sayfanın ne kadarını yeniden oluşturabildiğinizle dengelenir.
Aşağıdaki tablo, kod yazmadan önce seçim yapabilmeniz için dört yaygın yaklaşımı karşılaştırır. Uygulamada projelerin çoğu, toplu yük için gizli API’yi ve buna direnen sayfalar için tarayıcıyı kullanarak ikisini birleştirir.
| Yöntem | Hız | Maliyet | En uygun kullanım | Temel sınırlama |
|---|---|---|---|---|
| Gizli JSON API | En hızlı | En düşük | Temiz bir XHR çağrısının arkasındaki veri | Endpoint değişebilir veya token gerektirebilir |
| Playwright | Orta | Daha yüksek | Tam işleme, modern async kontrol | CPU, bellek ve bant genişliği kullanır |
| Selenium | Orta | Daha yüksek | Eski stack’ler, geniş dil desteği | Daha yavaş kurulum, daha ayrıntılı beklemeler |
| requests-html | Yavaş | Düşük | Basit sayfalarda hafif JavaScript | Büyük ölçüde bakımsız, kırılgan işleme |
Maliyet önemlidir; çünkü sayaçlı bir proxy üzerinden yönlendirilen headless tarayıcı, tek bir API çağrısından çok daha fazla bayt indirir. Büyük ölçekte kazıyorsanız seçtiğiniz yöntem faturayı kod kadar değiştirir. Hız ayarlaması ve HTTP headers konusundaki daha geniş yaklaşım için web scraping için en iyi uygulamalar rehberimize.
Dinamik bir sayfanın arkasındaki gizli API’yi nasıl bulursunuz?
Sayfanın verilerini almak için yaptığı arka plan isteğini arayın; çünkü bu endpoint genellikle doğrudan çağırabileceğiniz temiz JSON döndürür. Bu en hızlı ve en güvenilir yaklaşımdır ve tarayıcı çalıştırmayı tamamen önler.
Geliştirici araçlarını açın, Network sekmesine geçin, Fetch/XHR ile filtreleyin ve sayfayı yenileyin. İçerik görünürken, istediğiniz değerleri içeren JSON döndüren istekleri izleyin. İstek URL’sini, yöntemini, sorgu parametrelerini ve gönderdiği tüm headers veya token’ları inceleyin; sonra sağ tıklayıp tüm yapıyı görmek için cURL olarak kopyalayın. Bu çağrıyı bir HTTP istemcisiyle yeniden üretebildiğinizde işlemeyi tamamen atlar ve çok daha düşük maliyetle yapılandırılmış veriyi çekersiniz.
Aşağıda bir JSON endpoint’ini proxy üzerinden çağıran ve alanları doğrudan okuyan minimal bir örnek vardır:
import requests

proxy = "http://USERNAME:[email protected]:823"
proxies = {"http": proxy, "https": proxy}

headers = {
    "User-Agent": "Mozilla/5.0",
    "Accept": "application/json",
    "Referer": "https://example.com/products",
}
params = {"category": "laptops", "page": 1}

r = requests.get(
    "https://example.com/api/v2/products",
    headers=headers,
    params=params,
    proxies=proxies,
    timeout=30,
)
r.raise_for_status()
data = r.json()

for item in data["items"]:
    print(item["name"], item["price"])
Endpoint sayfalandırılmışsa sayfa parametresini artırın veya yanıtın döndürdüğü sonraki cursor’u izleyin. Bir istek token gerektiriyorsa sayfanın onu ilk nerede verdiğini yakalayın ve aynı oturum içinde yeniden kullanın. Çağrıyı DataImpulse üzerinden yönlendirmek, endpoint’in sunucu adresiniz yerine residential bir IP görmesi anlamına gelir; bu, API kaynak bazında hız sınırı uyguladığında önemlidir. Proxy’nin kendisinde bir kimlik doğrulama engeliyle karşılaşırsanız proxy kimlik doğrulama notumuz, kimlik bilgisi biçimini açıklar.
Playwright ile dinamik sayfaları nasıl kazırsınız?
Çağrılacak temiz bir API olmadığında JavaScript’in kullanıcı için çalışacağı şekilde çalışması için Playwright gibi headless bir tarayıcı kullanın, ardından tamamlanmış DOM’u okuyun. Playwright güvenilir otomatik bekleme, birinci sınıf async desteği ve basit bir proxy seçeneği sunduğu için modern varsayılandır.
Önce kurun ve bir tarayıcı ikili dosyasını indirin:
pip install playwright
playwright install chromium
Temel ilke, sabit beklemelerle tahmin yürütmek yerine ihtiyacınız olan belirli öğeyi beklemektir. Aşağıdaki örnek Chromium’u başlatır, sözlük biçimini kullanarak proxy üzerinden yönlendirir, ürün ızgarasını bekler ve işlenmiş değerleri çıkarır:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True, proxy=PROXY)
    context = browser.new_context(user_agent="Mozilla/5.0")
    page = context.new_page()
    page.goto("https://example.com/products", wait_until="domcontentloaded")

    page.wait_for_selector("div.product-card", timeout=15000)

    cards = page.query_selector_all("div.product-card")
    for card in cards:
        name = card.query_selector(".title").inner_text()
        price = card.query_selector(".price").inner_text()
        print(name, price)

    browser.close()
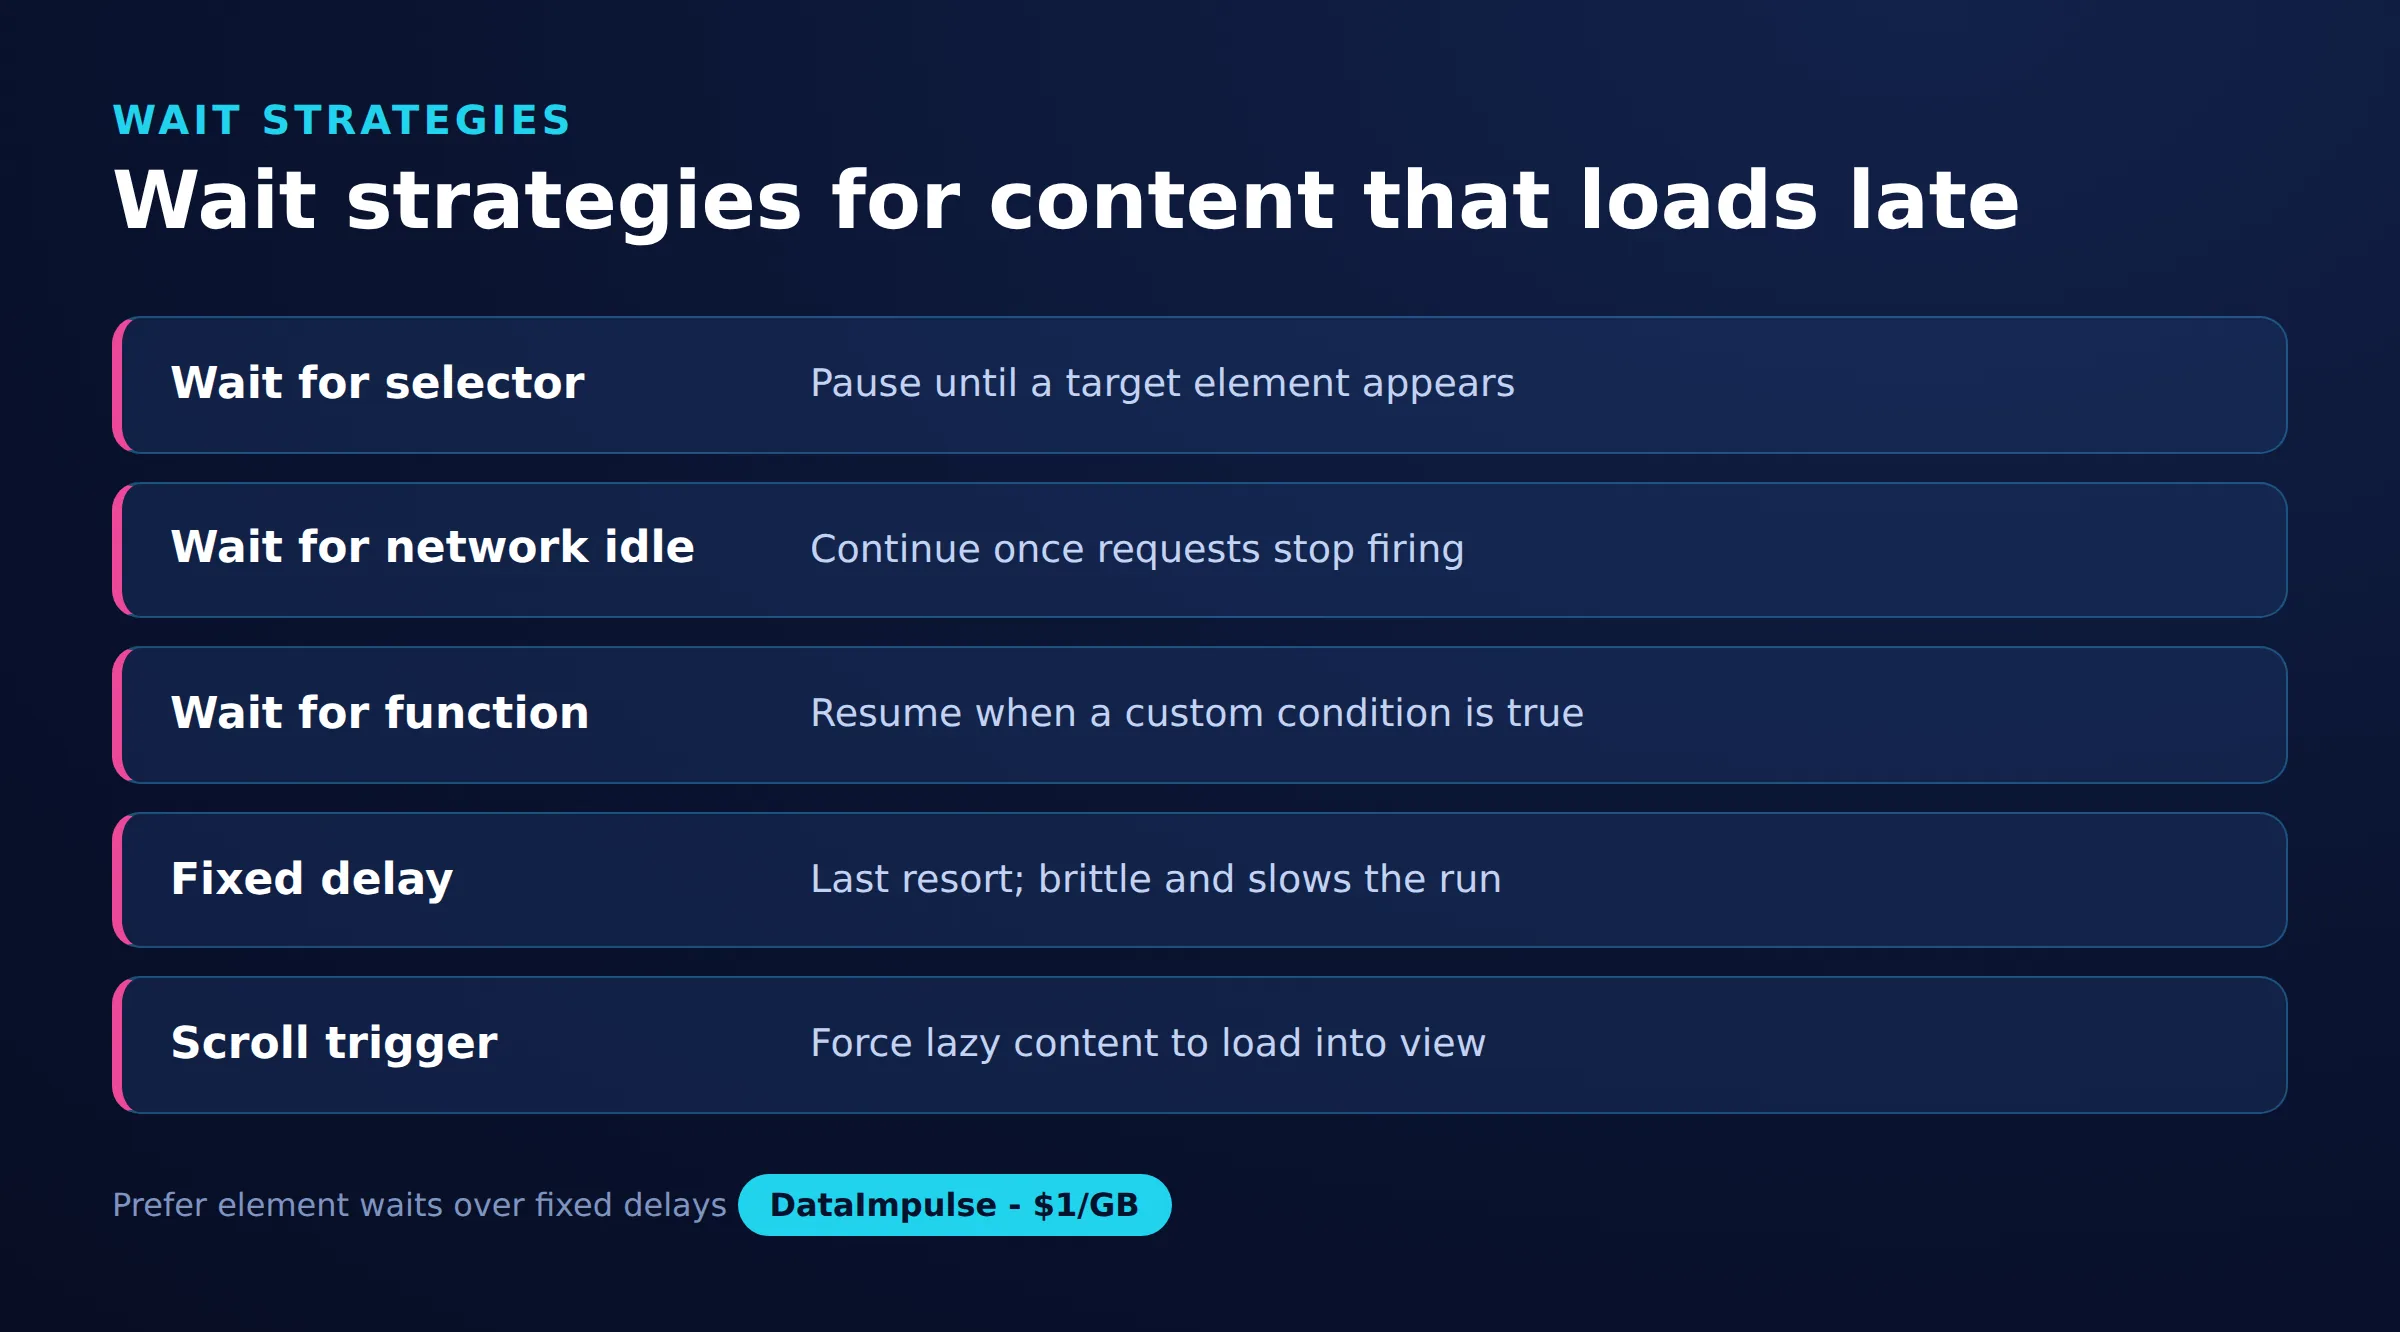
Bekleme, çoğu dinamik scraper’ın başarılı olduğu veya başarısız olduğu noktadır; bu yüzden dört stratejiyi ve her birinin ne zaman uygun olduğunu bilmek faydalıdır. Uzun ömürlü bağlantıları açık tutan sayfalarda takılabilen networkidle yerine somut bir selector veya koşulu beklemeyi tercih edin:
# Wait for a specific element (most reliable)
page.wait_for_selector("div.product-card", timeout=15000)

# Wait for the initial DOM to be built, before every script finishes
page.goto(url, wait_until="domcontentloaded")

# Wait until there are no network connections for 500 ms
page.goto(url, wait_until="networkidle")

# Wait for a custom condition, such as a minimum item count
page.wait_for_function(
    "document.querySelectorAll('div.product-card').length > 20"
)
Hedefiniz tarayıcıda çalışan betiklere büyük ölçüde dayanıyorsa JavaScript ile web scraping hakkındaki tamamlayıcı yazımız, bu sayfaları zorlaştıran istemci tarafı işlemeyi daha ayrıntılı ele alır.
Sonsuz kaydırma ve daha fazla yükle düğmelerini nasıl yönetirsiniz?
Daha fazla içerik yüklemek için sayfanın kullandığı aynı olayları tetikleyin; ardından okumadan önce her yeni grubun işlenmesini bekleyin. Sonsuz kaydırma ve daha fazla yükle düğmeleri yalnızca kullanıcı işlem yaptıkça veri getirir; bu nedenle tek bir sayfa yüklemesi yalnızca ilk ekranı yakalar.
Tarayıcıya başvurmadan önce Network sekmesini tekrar kontrol edin; çünkü sonsuz kaydırma neredeyse her zaman sayfalandırılmış bir XHR çağrısıyla çalışır ve yukarıdaki requests yaklaşımıyla bu endpoint üzerinde döngü kurmak kaydırmaktan çok daha ucuzdur. Kaydırmanız gerekirse yeni öğe görünmediğinde duran kontrollü bir döngü kullanın:
def scroll_until_stable(page, item_selector, max_rounds=30):
    seen = 0
    for _ in range(max_rounds):
        page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
        page.wait_for_timeout(1500)
        count = len(page.query_selector_all(item_selector))
        if count == seen:
            break            # no new items loaded, stop
        seen = count
    return seen
Kaydırma yerine açık bir düğme kullanan sayfalar tıklama döngüsü gerektirir. Her tıklamadan önce öğe sayısını okuyun, düğmeye tıklayın ve işlemenin önüne geçmemek için sayının artmasını bekleyin:
def click_load_more(page, button_selector, item_selector, max_clicks=50):
    for _ in range(max_clicks):
        button = page.query_selector(button_selector)
        if button is None or not button.is_visible():
            break
        before = len(page.query_selector_all(item_selector))
        button.click()
        page.wait_for_function(
            "([sel, n]) => document.querySelectorAll(sel).length > n",
            arg=[item_selector, before],
        )
    return len(page.query_selector_all(item_selector))
Toplarken yinelenenleri kaldırın; çünkü her geçişte aynı düğümleri yeniden okumak yaygındır. Benzersiz ID veya URL’lerden oluşan bir küme tutun ve yalnızca daha önce görmediğiniz kayıtları ekleyin.
Playwright yerine Selenium kullanabilir misiniz?
Evet, Selenium gerçek bir tarayıcıyı aynı şekilde kullanır ve ekibiniz zaten kullanıyorsa veya geniş dil desteğine ihtiyaç duyuyorsa sağlam bir seçimdir. Desen Playwright’i yansıtır: Sayfayı yükleyin, WebDriverWait ile bir koşulu bekleyin, ardından işlenmiş DOM’daki öğeleri okuyun.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

options = Options()
options.add_argument("--headless=new")
options.add_argument("--proxy-server=http://gw.dataimpulse.com:823")

driver = webdriver.Chrome(options=options)
driver.get("https://example.com/products")

WebDriverWait(driver, 15).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "div.product-card"))
)

for card in driver.find_elements(By.CSS_SELECTOR, "div.product-card"):
    name = card.find_element(By.CSS_SELECTOR, ".title").text
    price = card.find_element(By.CSS_SELECTOR, ".price").text
    print(name, price)

driver.quit()
Bir uyarı: Düz –proxy-server bayrağı kullanıcı adı ve parolayı kabul etmez, bu nedenle kimlik doğrulamalı proxy bir yardımcıya ihtiyaç duyar. Selenium Wire kütüphanesi kimlik bilgilerini sorunsuz ekler; Selenium Wire proxy kurulumuna dair rehberimiz, tam yapılandırmayı gösterir. Selenium’ın yapılandırması Playwright’ten daha ağırdır ve beklemeleri daha ayrıntılıdır; bu yüzden yeni projeler Selenium’da kalmayı gerektiren bir sebep yoksa çoğu zaman Playwright ile başlar.
Sayfaları işlerken proxy bant genişliğini nasıl azaltırsınız?
İhtiyacınız olmayan kaynakları engelleyin; böylece tarayıcı hiç ayrıştırmadığınız görselleri, yazı tiplerini ve medyayı indirmeyi bırakır. Headless tarayıcı varsayılan olarak her varlığı alır ve bunların her baytı GB başına fiyatlanan bir proxy üzerinden yönlendirildiğinde maliyet yaratır.
Playwright, istekleri yakalamanıza ve çıkarma işleminizle ilgisiz olanları iptal etmenize olanak tanır. Görselleri, medyayı ve yazı tiplerini engellemek, gerçekten okuduğunuz JSON ve HTML’ye dokunmadan proxy trafiğini keskin biçimde azaltabilir:
BLOCK = {"image", "media", "font"}

def block_heavy(route):
    if route.request.resource_type in BLOCK:
        route.abort()
    else:
        route.continue_()

context = browser.new_context()
context.route("**/*", block_heavy)
page = context.new_page()
page.goto("https://example.com/products", wait_until="domcontentloaded")
Aynı handler’ı, veri eklemeden yük getiren analiz ve reklam alan adlarını atlayacak şekilde genişletebilirsiniz. DataImpulse trafiği GB başına 1 dolardan başlayan kullandıkça öde modeliyle ücretlendirilir ve süresi dolmaz; boşa harcanan baytları azaltmak her kazımanın maliyetini doğrudan düşürür. İlgili sayfalarda bir tarayıcı context’ini yeniden kullanmak da tekrarlanan başlatma maliyetini önler ve en ucuz istek, gizli API’ye dönerek yapmaktan kaçındığınız istektir.
Hata yönetimi ve yeniden denemeleri nasıl eklersiniz?
Her gezinmeyi üstel geri çekilmeli bir yeniden deneme döngüsüne alın; böylece tek bir yavaş yükleme veya geçici engel tüm çalışmayı sonlandırmaz. Dinamik sayfalar aralıklı olarak başarısız olur ve ilk zaman aşımında vazgeçen bir scraper, büyük ölçekte kayıtların önemli bölümünü kaybeder.
Playwright’in oluşturduğu zaman aşımını yakalayın, artan bir aralık bekleyin ve hatayı kaydedip devam etmeden önce sınırlı sayıda yeniden deneyin:
import time
from playwright.sync_api import TimeoutError as PlaywrightTimeout

def fetch_with_retries(page, url, selector, retries=3, backoff=2):
    for attempt in range(1, retries + 1):
        try:
            page.goto(url, wait_until="domcontentloaded", timeout=30000)
            page.wait_for_selector(selector, timeout=15000)
            return page.query_selector_all(selector)
        except PlaywrightTimeout:
            wait = backoff ** attempt
            print(f"Attempt {attempt} timed out, retrying in {wait}s")
            time.sleep(wait)
    raise RuntimeError(f"Failed to load {url} after {retries} attempts")
Her denemenin yeni bir IP üzerinden çıkması için yeniden denemeleri proxy rotasyonuyla eşleştirin. Bir çıkış hız sınırına takılırsa sonraki istek farklı bir adrese ulaşır ve çoğu zaman başarılı olur. dönen residential proxy’lerden veya mobile proxy’lerden oluşan bir havuz, her istek için otomatik olarak yeni bir IP atar; bu da birçok zorlu engeli basit bir yeniden denemeye dönüştürür. Özellikle proxy düzeyindeki hataları ele almak için HTTP hata 407 notumuz, en yaygın kimlik doğrulama yanıtını açıklar.
Birçok dinamik sayfayı eşzamanlı nasıl kazırsınız?
Birden çok sayfanın makinenizi veya hedefi bunaltmadan aynı anda işlenmesi için Playwright’in async API’sini asyncio semaphore ile kullanın. Eşzamanlılık, her tarayıcı sayfası zamanının çoğunu ağda bekleyerek geçirdiği için dinamik kazımanın verimini geri kazandığı noktadır.
Semaphore, paralel çalışan sayfa sayısını sınırlar. Görevler arasında bir tarayıcıyı ve context’i paylaşın, her URL için bir sayfa açın ve sonuçları toplayın:
import asyncio
from playwright.async_api import async_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

async def scrape_one(context, url, sem):
    async with sem:
        page = await context.new_page()
        try:
            await page.goto(url, wait_until="domcontentloaded")
            await page.wait_for_selector("div.product-card", timeout=15000)
            cards = await page.query_selector_all("div.product-card")
            return [await c.inner_text() for c in cards]
        finally:
            await page.close()

async def main(urls):
    sem = asyncio.Semaphore(5)   # at most 5 pages at once
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, proxy=PROXY)
        context = await browser.new_context()
        tasks = [scrape_one(context, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        await browser.close()
    return results

urls = ["https://example.com/products?page=%d" % i for i in range(1, 21)]
data = asyncio.run(main(urls))
Eşzamanlılık sınırını makul tutun. Çok fazla paralel sayfa belleği tüketir ve hız sınırlarını tetikler; bu da paralelliğin kazandırdığından daha fazla yeniden denemeye mal olur. Beş civarında başlayın ve yalnızca başarı oranları yüksek kaldığı sürece artırın.
Kazınan verileri JSON ve CSV olarak nasıl dışa aktarırsınız?
Her sayfanın sonuçlarını bir sözlük listesinde toplayın; ardından iç içe veriler için listeyi JSON’a, düz ve elektronik tabloya uygun tablolar için CSV’ye yazın. Çıkarma ve dışa aktarmayı ayrı tutmak scraper’ın test edilmesini ve yeniden çalıştırılmasını kolaylaştırır.
import json
import csv

records = [
    {"name": "Laptop A", "price": "999"},
    {"name": "Laptop B", "price": "1299"},
]

# Export to JSON
with open("products.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)

# Export to CSV
with open("products.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(records)
Kayıtlar iç içe listeler veya nesneler içerdiğinde JSON’ı, her kayıt aynı düz alanları paylaştığında ve analistler dosyayı elektronik tabloda açacağında CSV’yi seçin. Yazmadan önce alanlarınızı normalleştirin; böylece her kayıt aynı anahtarlara sahip olur ve dinamik sayfa nasıl işlenmiş olursa olsun dışa aktarma adımı basit kalır. Buradan aynı JSON, ek ayrıştırma olmadan bir veritabanı yüklemesine veya analiz işine aktarılabilir.
Sık sorulan sorular
Bir scraper yazmadan önce sayfanın dinamik olduğunu nasıl anlayabilirim?
Sayfa Kaynağını geliştirici araçlarındaki Elements paneliyle karşılaştırın veya ham HTML’deki hedef öğeyi işlenmiş DOM’dakiyle karşılaştırarak sayın. Veri yalnızca JavaScript çalıştıktan sonra görünüyorsa sayfa dinamiktir ve bir API çağrısına veya headless tarayıcıya ihtiyaç duyar.
Gizli API’yi çağırmak mı, headless tarayıcı kullanmak mı daha iyidir?
Bulabildiğinizde gizli API’yi çağırın; çünkü işleme maliyetinin ve süresinin çok küçük bir bölümünde temiz JSON döndürür. Yalnızca yeniden üretilebilir bir API yoksa veya veri karmaşık istemci tarafı betiklere bağlıysa headless tarayıcı kullanın.
Dinamik kazıma için Playwright mi Selenium mu kullanmalıyım?
Playwright, güvenilir otomatik bekleme ve yerleşik async desteği sayesinde modern varsayılandır; bu nedenle yeni projeler genellikle onunla başlar. Selenium, stack’iniz onu zaten kullanıyorsa veya daha geniş dil desteğine ihtiyacınız varsa uygundur.
Headless tarayıcı kullanırken proxy bant genişliğini nasıl azaltırım?
İstekleri yakalayın ve ayrıştırmadığınız görselleri, yazı tiplerini, medyayı ve analizleri iptal edin. Proxy maliyeti GB başına ölçüldüğü için bu, trafiği önemli ölçüde azaltabilir ve her sayfanın yüklenmesini hızlandırır.
Sonsuz kaydırmada yüklenen içeriği nasıl kazırım?
Önce Network sekmesinde kaydırmanın arkasındaki sayfalandırılmış XHR çağrısını kontrol edin ve doğrudan bu endpoint üzerinde döngü kurun. Kaydırmanız gerekiyorsa kontrollü bir döngü kullanın ve okumadan önce her yeni grubun işlenmesini bekleyin.
DataImpulse ne zaman doğru seçim değildir?
Statik ISP proxy’lerine, tamamen yönetilen bir scraping API’sine veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Kamuya açık verileri toplamak ve içeriğe erişmek için dönen residential, mobile ve datacenter proxy’lere odaklanır.
Dinamik sayfaları güvenilir proxy’lerle kazıyın
Scraper’ınızın gerçek ziyaretçiler gibi davranan residential, mobile veya datacenter IP’lere ihtiyacı varsa GB başına 1 dolardan başlayan kullandıkça öde trafiğiyle başlayabilirsiniz. Bir DataImpulse hesabı oluşturun ve dinamik kazımanızı dönen veya sticky session’lar üzerinden yönlendirin.