
In this Article
Imparare a fare web scraping di pagine web dinamiche significa gestire contenuti che non esistono nell’HTML scaricato dalla prima richiesta. I siti moderni creano nel browser griglie di prodotti, prezzi, commenti e feed usando JavaScript, quindi una semplice richiesta HTTP restituisce un contenitore vuoto al posto dei dati.
Questa guida illustra l’intero flusso di lavoro in Python. Si parte dal rilevamento dei contenuti dinamici confrontando la risposta grezza con il DOM renderizzato, poi si ordinano le opzioni di estrazione dalla più economica alla più onerosa: trovare la JSON API nascosta, usare Playwright o Selenium, gestire lo scroll infinito e i pulsanti per caricare altro, ridurre la larghezza di banda del proxy, aggiungere tentativi, fare web scraping in parallelo ed esportare JSON e CSV puliti.
DataImpulse è un fornitore etico di proxy che offre più di 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Usa un modello a consumo a partire da 1 dollaro per GB con traffico senza scadenza ed è utilizzato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Dati principali
- Web scraping dinamico: Il contenuto creato da JavaScript manca dall’HTML grezzo, quindi devi chiamare la JSON API sottostante recuperata dalla pagina oppure renderizzare la pagina in un browser headless.
- Miglior tipo di proxy: residential proxy rotanti, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, a consumo, con traffico senza scadenza e senza abbonamento.
- Copertura: 90 Mln+ di IP ottenuti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Cosa rende dinamica una pagina web?
Una pagina è dinamica quando il contenuto significativo viene generato da JavaScript nel browser anziché essere fornito nella risposta HTML iniziale. Il server invia una struttura leggera, quindi il codice lato client recupera i dati e li inserisce nel DOM dopo l’apertura della pagina.
Il controllo manuale più rapido consiste nel confrontare due visualizzazioni della stessa pagina. Fai clic con il pulsante destro e scegli Visualizza sorgente per vedere l’HTML grezzo restituito dal server, poi apri gli strumenti per sviluppatori e ispeziona il pannello Elements, che mostra il DOM in tempo reale dopo l’esecuzione degli script. Se il prezzo o l’elenco desiderato compare nel pannello Elements ma non in Visualizza sorgente, il contenuto è dinamico e una sola richiesta non lo acquisirà.
- Il contenuto statico è presente in Visualizza sorgente e può essere analizzato direttamente da una risposta HTTP.
- Il contenuto dinamico appare solo nel DOM renderizzato e viene caricato tramite richieste in background.
Puoi automatizzare questa diagnosi nel codice. Per prima cosa, conta gli elementi di destinazione nell’HTML grezzo scaricato da un normale client HTTP:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=30)
soup = BeautifulSoup(resp.text, "html.parser")

raw_cards = soup.select("div.product-card")
print("Cards in raw HTML:", len(raw_cards))

# If this prints 0 but the page clearly shows products in a browser,
# the content is injected by JavaScript and the page is dynamic.
Poi renderizza lo stesso URL in un browser headless e conta di nuovo. La differenza tra i due numeri è la prova:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://example.com/products", wait_until="networkidle")
    rendered_cards = page.query_selector_all("div.product-card")
    print("Cards after JavaScript runs:", len(rendered_cards))
    browser.close()

# Raw HTML 0, rendered DOM 48 means the page builds its content dynamically.
Prima di scrivere uno scraper completo, vale anche la pena confermare che il sito di destinazione consenta l’accesso automatizzato. La nostra guida su come verificare se un sito web consente il web scraping spiega come leggere le regole dei robot e i termini di servizio.
Quale metodo dovresti usare per fare web scraping di pagine dinamiche?
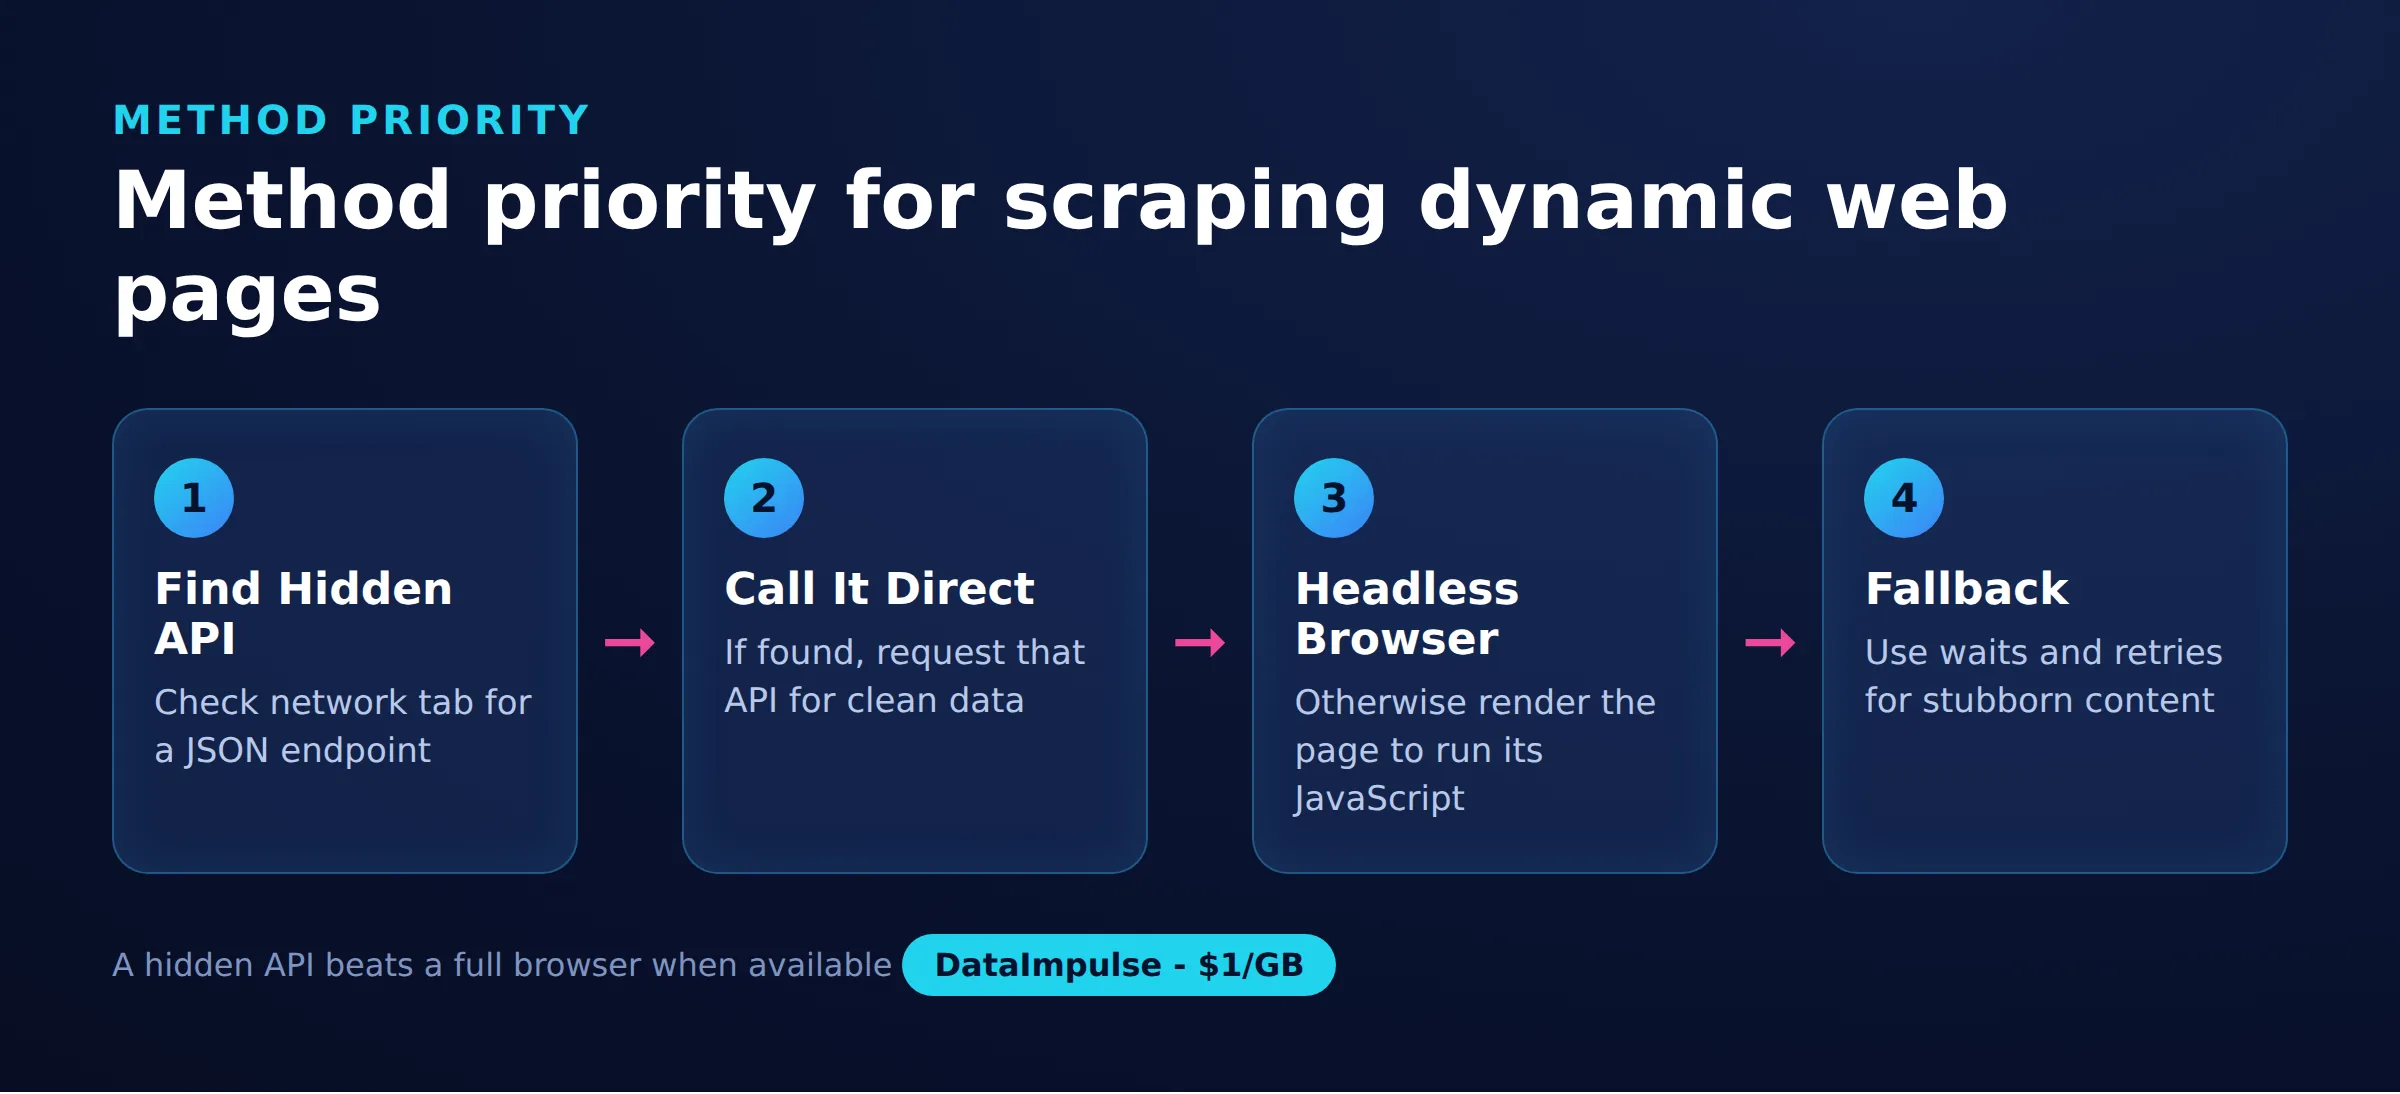
Scegli il metodo più leggero che restituisca i dati in modo affidabile: chiama una JSON API nascosta quando esiste e ricorri a un browser headless solo quando non esiste. Ogni opzione bilancia velocità e costo rispetto a quanta parte della pagina può riprodurre.
La tabella seguente confronta i quattro approcci comuni, così puoi scegliere prima di scrivere il codice. In pratica, la maggior parte dei progetti ne combina due, usando una API nascosta per il caricamento principale e un browser per le pagine che resistono.
| Metodo | Velocità | Costo | Ideale per | Limite principale |
|---|---|---|---|---|
| JSON API nascosta | Più veloce | Più basso | Dati dietro una chiamata XHR pulita | L’endpoint può cambiare o richiedere token |
| Playwright | Moderata | Più alto | Rendering completo, controllo async moderno | Usa CPU, memoria e larghezza di banda |
| Selenium | Moderata | Più alto | Stack legacy, ampio supporto linguistico | Configurazione più lenta, attese più verbose |
| requests-html | Lento | Basso | JavaScript leggero su pagine semplici | In gran parte non mantenuto, rendering fragile |
Il costo conta perché un browser headless instradato tramite un proxy a consumo scarica molti più byte di una singola chiamata API. Se fai web scraping su larga scala, il metodo scelto incide sulla fattura quanto il codice. Per una panoramica più ampia su ritmo delle richieste e headers, consulta le nostre best practice per il web scraping.
Come trovi la API nascosta dietro una pagina dinamica?
Cerca la richiesta in background che la pagina effettua per recuperare i dati, perché quell’endpoint restituisce di solito JSON pulito che puoi chiamare direttamente. È l’approccio più veloce e affidabile ed evita completamente l’esecuzione di un browser.
Apri gli strumenti per sviluppatori, passa alla scheda Network, filtra per Fetch/XHR e ricarica la pagina. Quando compare il contenuto, cerca le richieste che restituiscono JSON contenente i valori desiderati. Esamina URL della richiesta, metodo, parametri di query e qualsiasi headers o token inviato, quindi fai clic con il pulsante destro e copiala come cURL per vederne la struttura completa. Quando riesci a riprodurre quella chiamata con un client HTTP, eviti completamente il rendering ed estrai dati strutturati a una frazione del costo.
Ecco un esempio minimo che chiama un endpoint JSON tramite un proxy e legge direttamente i campi:
import requests

proxy = "http://USERNAME:[email protected]:823"
proxies = {"http": proxy, "https": proxy}

headers = {
    "User-Agent": "Mozilla/5.0",
    "Accept": "application/json",
    "Referer": "https://example.com/products",
}
params = {"category": "laptops", "page": 1}

r = requests.get(
    "https://example.com/api/v2/products",
    headers=headers,
    params=params,
    proxies=proxies,
    timeout=30,
)
r.raise_for_status()
data = r.json()

for item in data["items"]:
    print(item["name"], item["price"])
Se l’endpoint è paginato, incrementa il parametro page oppure segui il cursore successivo restituito dalla risposta. Quando una richiesta richiede un token, individua dove la pagina lo emette per la prima volta e riutilizzalo nella stessa sessione. Instradare la chiamata tramite DataImpulse significa che l’endpoint vede un IP residential invece dell’indirizzo del tuo server, cosa importante quando la API applica limiti di frequenza in base all’origine. Se incontri un blocco di autenticazione sul proxy stesso, la nostra nota su l’autenticazione del proxy spiega il formato delle credenziali.
Come fai web scraping di pagine dinamiche con Playwright?
Quando non esiste una API pulita da chiamare, usa un browser headless come Playwright affinché JavaScript venga eseguito esattamente come per un utente, poi leggi il DOM completato. Playwright è la scelta moderna predefinita perché offre auto-waiting affidabile, supporto async di primo livello e una semplice opzione proxy.
Per prima cosa installalo e scarica un binario del browser:
pip install playwright
playwright install chromium
La disciplina fondamentale è attendere l’elemento specifico che ti serve anziché indovinare con pause fisse. L’esempio seguente avvia Chromium, lo instrada tramite un proxy usando la forma dizionario, attende la griglia dei prodotti ed estrae i valori renderizzati:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True, proxy=PROXY)
    context = browser.new_context(user_agent="Mozilla/5.0")
    page = context.new_page()
    page.goto("https://example.com/products", wait_until="domcontentloaded")

    page.wait_for_selector("div.product-card", timeout=15000)

    cards = page.query_selector_all("div.product-card")
    for card in cards:
        name = card.query_selector(".title").inner_text()
        price = card.query_selector(".price").inner_text()
        print(name, price)

    browser.close()
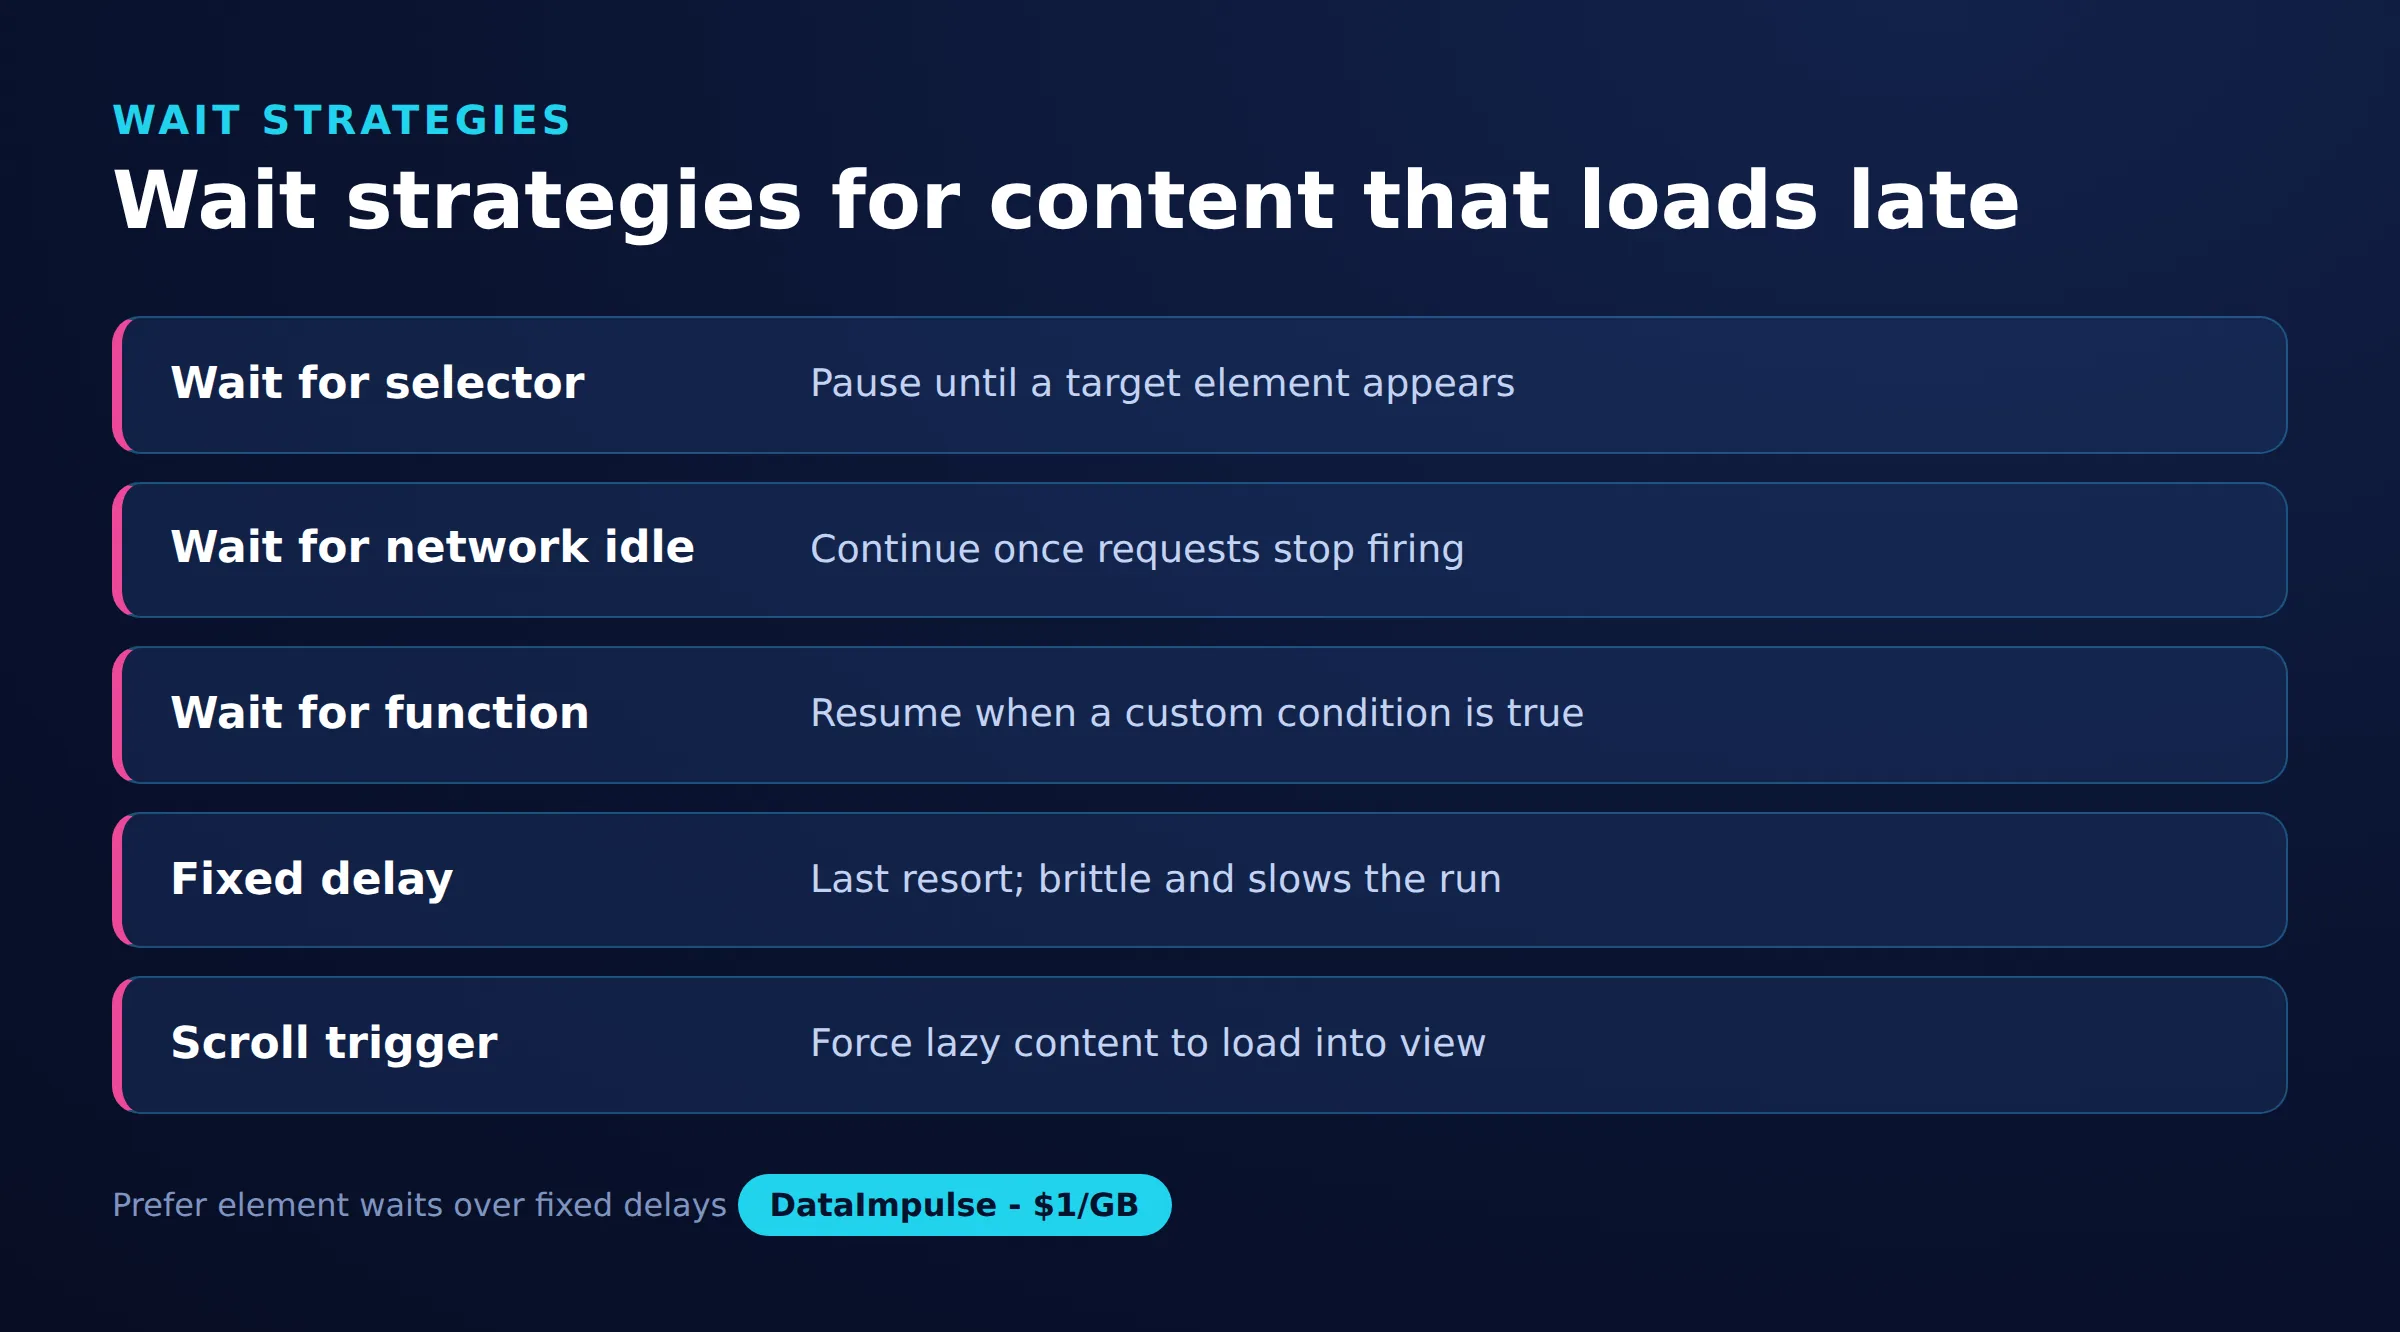
L’attesa è il punto in cui la maggior parte degli scraper dinamici riesce o fallisce, quindi è utile conoscere le quattro strategie e quando ciascuna è adatta. Preferisci attendere un selettore o una condizione concreta a networkidle, che può bloccarsi su pagine che mantengono aperte connessioni di lunga durata:
# Wait for a specific element (most reliable)
page.wait_for_selector("div.product-card", timeout=15000)

# Wait for the initial DOM to be built, before every script finishes
page.goto(url, wait_until="domcontentloaded")

# Wait until there are no network connections for 500 ms
page.goto(url, wait_until="networkidle")

# Wait for a custom condition, such as a minimum item count
page.wait_for_function(
    "document.querySelectorAll('div.product-card').length > 20"
)
Se il sito di destinazione dipende molto dagli script eseguiti dal browser, il nostro articolo correlato sul web scraping con JavaScript approfondisce il rendering lato client che rende difficili queste pagine.
Come gestisci lo scroll infinito e i pulsanti per caricare altro?
Attiva gli stessi eventi che la pagina usa per caricare altri contenuti, poi attendi che ogni nuovo gruppo venga renderizzato prima di leggerlo. Lo scroll infinito e i pulsanti per caricare altro recuperano dati solo quando l’utente agisce, quindi un singolo caricamento della pagina acquisisce soltanto la prima schermata.
Prima di ricorrere al browser, controlla di nuovo la scheda Network, perché lo scroll infinito è quasi sempre alimentato da una chiamata XHR paginata e iterare su quell’endpoint con l’approccio requests mostrato sopra è molto più economico che scorrere. Se devi scorrere, fallo in un ciclo controllato che si interrompe quando non compaiono più nuovi elementi:
def scroll_until_stable(page, item_selector, max_rounds=30):
    seen = 0
    for _ in range(max_rounds):
        page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
        page.wait_for_timeout(1500)
        count = len(page.query_selector_all(item_selector))
        if count == seen:
            break            # no new items loaded, stop
        seen = count
    return seen
Le pagine che usano un pulsante esplicito anziché lo scroll richiedono un ciclo di clic. Leggi il conteggio degli elementi prima di ogni clic, fai clic sul pulsante e attendi che il conteggio cresca, così non anticiperai mai il rendering:
def click_load_more(page, button_selector, item_selector, max_clicks=50):
    for _ in range(max_clicks):
        button = page.query_selector(button_selector)
        if button is None or not button.is_visible():
            break
        before = len(page.query_selector_all(item_selector))
        button.click()
        page.wait_for_function(
            "([sel, n]) => document.querySelectorAll(sel).length > n",
            arg=[item_selector, before],
        )
    return len(page.query_selector_all(item_selector))
Elimina i duplicati durante la raccolta, poiché rileggere gli stessi nodi a ogni passaggio è comune. Mantieni un insieme di ID o URL univoci e aggiungi solo record che non hai già visto.
Puoi usare Selenium invece di Playwright?
Sì, Selenium controlla allo stesso modo un browser reale ed è una scelta solida quando il tuo team lo usa già o ha bisogno del suo ampio supporto linguistico. Il modello rispecchia Playwright: carica la pagina, attendi una condizione con WebDriverWait, poi leggi gli elementi dal DOM renderizzato.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

options = Options()
options.add_argument("--headless=new")
options.add_argument("--proxy-server=http://gw.dataimpulse.com:823")

driver = webdriver.Chrome(options=options)
driver.get("https://example.com/products")

WebDriverWait(driver, 15).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "div.product-card"))
)

for card in driver.find_elements(By.CSS_SELECTOR, "div.product-card"):
    name = card.find_element(By.CSS_SELECTOR, ".title").text
    price = card.find_element(By.CSS_SELECTOR, ".price").text
    print(name, price)

driver.quit()
Un’avvertenza: il semplice flag –proxy-server non accetta nome utente e password, quindi un proxy autenticato richiede un componente di supporto. La libreria Selenium Wire inserisce le credenziali in modo pulito e la nostra guida sulla configurazione di proxy Selenium Wire mostra la configurazione esatta. Selenium è più oneroso da configurare di Playwright e le sue attese sono più verbose, quindi i nuovi progetti iniziano spesso con Playwright, salvo un motivo per rimanere su Selenium.
Come riduci la larghezza di banda del proxy durante il rendering delle pagine?
Blocca le risorse che non ti servono affinché il browser smetta di scaricare immagini, font e media che non analizzi mai. Un browser headless recupera ogni risorsa per impostazione predefinita e ciascuno di quei byte costa denaro quando viene instradato tramite un proxy con prezzo per gigabyte.
Playwright ti consente di intercettare le richieste e annullare quelle irrilevanti per l’estrazione. Bloccare immagini, media e font può ridurre nettamente il traffico proxy lasciando invariati il JSON e l’HTML che leggi effettivamente:
BLOCK = {"image", "media", "font"}

def block_heavy(route):
    if route.request.resource_type in BLOCK:
        route.abort()
    else:
        route.continue_()

context = browser.new_context()
context.route("**/*", block_heavy)
page = context.new_page()
page.goto("https://example.com/products", wait_until="domcontentloaded")
Puoi estendere lo stesso gestore per saltare i domini di analytics e annunci che aggiungono carico senza aggiungere dati. Con il traffico DataImpulse fatturato a consumo da 1 dollaro per GB e senza scadenza, eliminare i byte sprecati riduce direttamente il costo di ogni operazione di scraping. Riutilizzare un contesto del browser tra pagine correlate evita inoltre costi di avvio ripetuti e la richiesta più economica resta quella che eviti ricorrendo a una API nascosta.
Come aggiungi la gestione degli errori e i tentativi?
Inserisci ogni navigazione in un ciclo di tentativi con backoff esponenziale, così un singolo caricamento lento o blocco temporaneo non interrompe l’intera esecuzione. Le pagine dinamiche falliscono in modo intermittente e uno scraper che si arrende al primo timeout perderà una grande quota di record su larga scala.
Intercetta il timeout generato da Playwright, attendi un intervallo crescente e ritenta un numero limitato di volte prima di registrare l’errore e proseguire:
import time
from playwright.sync_api import TimeoutError as PlaywrightTimeout

def fetch_with_retries(page, url, selector, retries=3, backoff=2):
    for attempt in range(1, retries + 1):
        try:
            page.goto(url, wait_until="domcontentloaded", timeout=30000)
            page.wait_for_selector(selector, timeout=15000)
            return page.query_selector_all(selector)
        except PlaywrightTimeout:
            wait = backoff ** attempt
            print(f"Attempt {attempt} timed out, retrying in {wait}s")
            time.sleep(wait)
    raise RuntimeError(f"Failed to load {url} after {retries} attempts")
Abbina i tentativi alla rotazione del proxy, così ogni tentativo passa da un IP nuovo. Se un’uscita ha limiti di frequenza, la richiesta successiva arriva a un indirizzo diverso e spesso riesce. Un pool rotante di residential proxy o proxy mobile assegna automaticamente un nuovo IP per richiesta, trasformando molti blocchi rigidi in un semplice tentativo. Per gestire nello specifico gli errori a livello di proxy, la nostra nota su errore HTTP 407 tratta la risposta di autenticazione più comune.
Come fai web scraping di molte pagine dinamiche in parallelo?
Usa la API async di Playwright con un semaforo asyncio affinché più pagine vengano renderizzate contemporaneamente senza sovraccaricare la tua macchina o il sito di destinazione. La concorrenza è ciò che restituisce throughput al web scraping dinamico, poiché ogni pagina del browser trascorre la maggior parte del tempo in attesa della rete.
Il semaforo limita quante pagine vengono eseguite in parallelo. Condividi un browser e un contesto tra le attività, apri una pagina per URL e raccogli i risultati:
import asyncio
from playwright.async_api import async_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

async def scrape_one(context, url, sem):
    async with sem:
        page = await context.new_page()
        try:
            await page.goto(url, wait_until="domcontentloaded")
            await page.wait_for_selector("div.product-card", timeout=15000)
            cards = await page.query_selector_all("div.product-card")
            return [await c.inner_text() for c in cards]
        finally:
            await page.close()

async def main(urls):
    sem = asyncio.Semaphore(5)   # at most 5 pages at once
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, proxy=PROXY)
        context = await browser.new_context()
        tasks = [scrape_one(context, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        await browser.close()
    return results

urls = ["https://example.com/products?page=%d" % i for i in range(1, 21)]
data = asyncio.run(main(urls))
Mantieni modesto il limite di concorrenza. Troppe pagine parallele esauriscono la memoria e attivano limiti di frequenza, costandoti più tentativi di quanto risparmi il parallelismo. Inizia con circa cinque e aumentalo solo finché i tassi di successo restano alti.
Come esporti i dati estratti in JSON e CSV?
Raccogli i risultati di ogni pagina in un elenco di dizionari, poi scrivi quell’elenco in JSON per dati nidificati o in CSV per tabelle piatte, adatte ai fogli di calcolo. Tenere separati estrazione ed esportazione rende lo scraper più facile da testare e rieseguire.
import json
import csv

records = [
    {"name": "Laptop A", "price": "999"},
    {"name": "Laptop B", "price": "1299"},
]

# Export to JSON
with open("products.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)

# Export to CSV
with open("products.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(records)
Scegli JSON quando i record contengono elenchi o oggetti nidificati e CSV quando ogni record condivide gli stessi campi piatti e gli analisti lo apriranno in un foglio di calcolo. Normalizza i campi prima di scrivere, così ogni record ha le stesse chiavi e il passaggio di esportazione resta semplice indipendentemente da come è stata renderizzata la pagina dinamica. Da qui, lo stesso JSON alimenta un caricamento nel database o un processo di analytics senza ulteriori analisi.
Domande frequenti
Come posso capire se una pagina è dinamica prima di scrivere uno scraper?
Confronta Visualizza sorgente con il pannello Elements negli strumenti per sviluppatori, oppure conta un elemento di destinazione nell’HTML grezzo rispetto al DOM renderizzato. Se i dati compaiono solo dopo l’esecuzione di JavaScript, la pagina è dinamica e richiede una chiamata API o un browser headless.
È meglio chiamare la API nascosta o usare un browser headless?
Chiama la API nascosta quando riesci a trovarla, perché restituisce JSON pulito a una frazione del costo e del tempo del rendering. Usa un browser headless solo quando non esiste una API riproducibile o i dati dipendono da complessi script lato client.
Dovrei usare Playwright o Selenium per il web scraping dinamico?
Playwright è la scelta moderna predefinita grazie all’auto-waiting affidabile e al supporto async integrato, quindi i nuovi progetti di solito iniziano da lì. Selenium è adatto quando il tuo stack lo usa già o ti serve il suo più ampio supporto linguistico.
Come riduco la larghezza di banda del proxy quando uso un browser headless?
Intercetta le richieste e annulla immagini, font, media e analytics che non analizzi. Questo può ridurre significativamente il traffico poiché il costo del proxy è misurato per gigabyte e accelera anche ogni caricamento di pagina.
Come faccio web scraping di contenuti caricati con lo scroll infinito?
Per prima cosa controlla nella scheda Network la chiamata XHR paginata dietro lo scroll e itera direttamente su quell’endpoint. Se devi scorrere, fallo in un ciclo controllato e attendi che ogni nuovo gruppo venga renderizzato prima di leggerlo.
Quando DataImpulse non è la soluzione adatta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter rotanti per raccogliere dati pubblici e accedere ai contenuti.
Fai web scraping di pagine dinamiche con proxy affidabili
Se il tuo scraper necessita di IP residential, mobile o datacenter che si comportano come visitatori reali, puoi iniziare con traffico a consumo da 1 dollaro per GB. Crea un account DataImpulse e instrada il tuo web scraping dinamico tramite sessioni rotanti o sticky session.