
In this Article
Un proxy Selenium Wire è la via più semplice per eseguire automazioni del browser autenticate in Python, perché Selenium Wire accetta direttamente un proxy URL login:password in un’unica opzione, senza richiedere la soluzione con estensione necessaria con Selenium standard. Espone inoltre ogni richiesta e risposta HTTP effettuata dal browser, ed è per questo che gli scraper e i team QA lo scelgono.
Questa guida è una procedura completa. Copre l’installazione e il pinning sicuro della libreria, la configurazione di un proxy autenticato, la verifica dell’IP di uscita, l’ispezione e l’attesa delle richieste, la modifica degli headers, la rotazione degli IP, l’esecuzione headless, la riduzione dell’uso di memoria, la gestione trasparente del certificato HTTPS, l’abbinamento con undetected-chromedriver e il ruolo delle alternative moderne.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Informazioni chiave
- Proxy Selenium Wire: Selenium Wire accetta direttamente un proxy URL login:password in seleniumwire_options, quindi l’automazione del browser autenticata funziona senza la soluzione con estensione richiesta da Selenium standard.
- Miglior tipo di proxy: proxy residential a rotazione, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti eticamente in 195 paesi.
- Affidabilità: tasso di successo del 99.51%, valutazione di 4.8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Che cos’è Selenium Wire ed è ancora mantenuto?
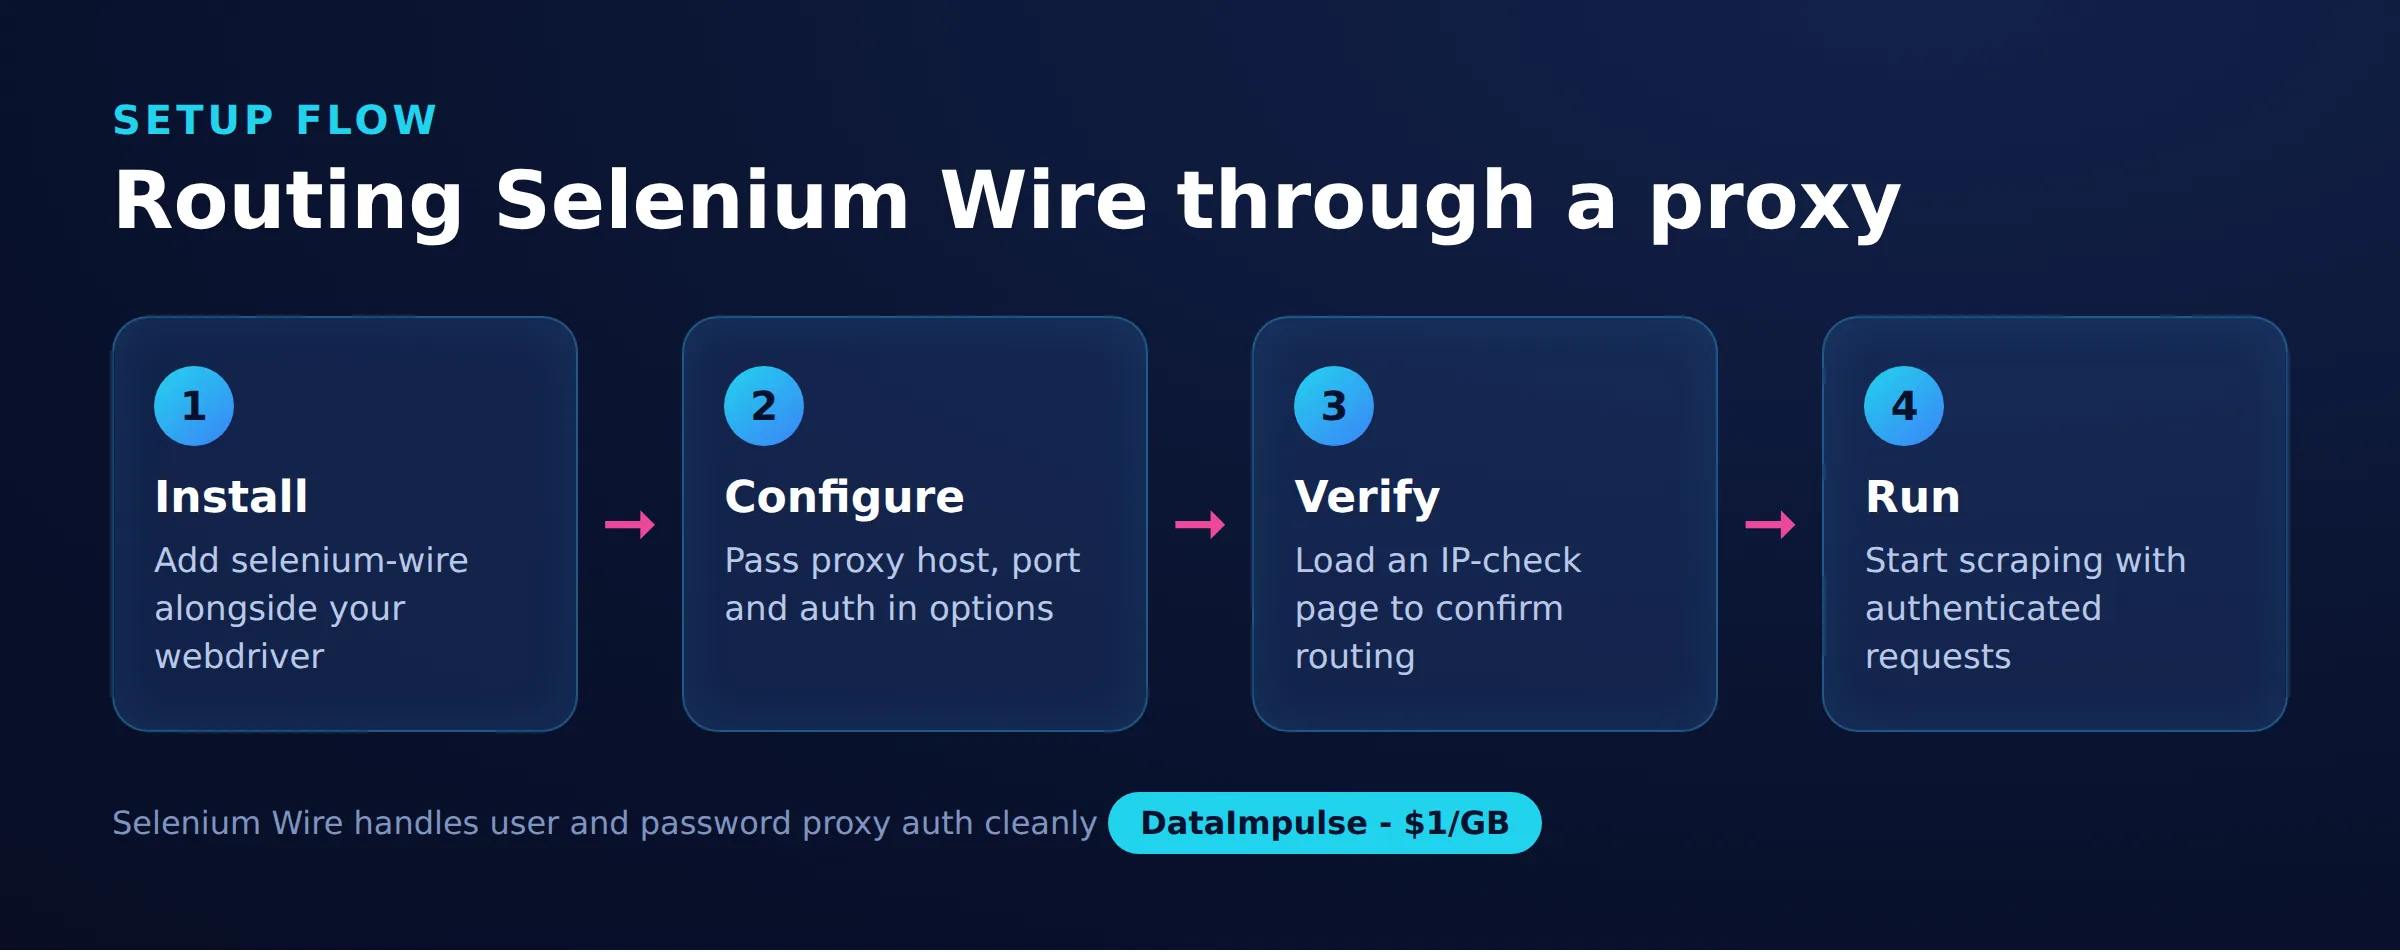
Selenium Wire è una libreria Python che estende Selenium, così il tuo script può ispezionare, attendere e modificare le richieste e risposte HTTP del browser, con supporto nativo per proxy autenticati. Funziona eseguendo un proxy man-in-the-middle locale a cui è indirizzato il browser, quindi inoltrando il traffico al tuo proxy upstream reale.
L’avvertenza importante è che il progetto originale è archiviato e non è più mantenuto attivamente. Funziona ancora bene in produzione, ma dovresti fissare le versioni e testare isolatamente ogni aggiornamento di Selenium, Chrome o delle dipendenze prima del rilascio. Esistono fork della community che portano avanti le correzioni di compatibilità e, più avanti nella guida, la tabella comparativa mostra quando uno strumento mantenuto come Playwright è la scelta migliore sul lungo periodo.
Il motivo per cui i team continuano a sceglierlo è la praticità. Se hai già una suite di test Selenium o uno scraper, aggiungere Selenium Wire richiede una modifica di una riga all’import e un’opzione proxy, e ottieni subito sia il supporto per proxy autenticati sia la possibilità di leggere ogni richiesta della pagina. Ricreare questa visibilità a livello di richiesta con Selenium standard richiede un lavoro concreto, quindi per codebase esistenti il compromesso vale spesso la pena nonostante lo stato di archivio. Se non hai esperienza nell’uso di browser reali per raccogliere dati, la nostra guida su come eseguire lo scraping di pagine web dinamiche illustra il quadro più ampio del rendering e quando un browser è davvero necessario.
Come installare Selenium Wire e fissare le versioni per evitare problemi?
Installa selenium-wire insieme a selenium e fissa blinker a una versione inferiore alla 1.8, perché quella release ha rimosso un nome interno che Selenium Wire importa all’avvio. Poiché il progetto è archiviato, le dipendenze non fissate sono la causa più comune per cui una configurazione funzionante smette improvvisamente di funzionare.
L’errore classico è un ImportError su WeakNamespace dopo l’aggiornamento automatico di blinker. Il pinning lo evita:
# Selenium Wire is archived. Pin known-good versions so an upstream release
# does not break your build overnight.
#
# blinker >= 1.8 removed blinker._saferef / WeakNamespace, which Selenium Wire
# imports at startup. On blinker 1.8+ you get:
#   ImportError: cannot import name 'WeakNamespace' from 'blinker'
# The fix is to hold blinker below 1.8.
pip install "selenium-wire==5.1.0" "selenium==4.9.1" "blinker==1.7.0"

# Selenium Wire also depends on brotli and can trip on very new Selenium.
# If you must run current Selenium, test in a throwaway virtualenv first, or
# move to a maintained fork such as selenium-wire-2 that tracks these fixes.
Mantieni questi pin in un file requirements affinché l’integrazione continua e i colleghi utilizzino la stessa combinazione nota per funzionare. Quando vuoi passare alla versione corrente di Selenium, trattalo come un aggiornamento intenzionale con una propria esecuzione dei test, invece di lasciare che pip risolva le versioni più recenti di tutto.
Come configurare un proxy autenticato in Selenium Wire?
Passa un dizionario proxy dentro seleniumwire_options quando crei il driver, con nome utente e password incorporati nell’URL e localhost escluso tramite no_proxy. Questa è la caratteristica che rende Selenium Wire preferibile a Selenium standard per il lavoro con proxy.
Importa webdriver da seleniumwire, non da selenium, poi passagli le opzioni. Le credenziali, l’host e la porta provengono dal dashboard del tuo fornitore. Con DataImpulse l’host è gw.dataimpulse.com e la porta è 823:
from seleniumwire import webdriver  # import from seleniumwire, not selenium

proxy_url = "http://login:[email protected]:823"

seleniumwire_options = {
    "proxy": {
        "http": proxy_url,
        "https": proxy_url,
        "no_proxy": "localhost,127.0.0.1",
    }
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com")
print(driver.title)
driver.quit()
La voce no_proxy esclude gli indirizzi locali dal proxy, così il driver può comunicare direttamente con ChromeDriver. Se l’autenticazione non è corretta, in genere vedrai una risposta 407; il nostro approfondimento sull’errore 407 Proxy Authentication Required spiega come diagnosticarlo. Per una panoramica sul funzionamento generale dei proxy con credenziali, consulta proxy residential.
Come verificare che l’IP di uscita del proxy funzioni?
Indirizza il driver a un endpoint di eco IP come api.ipify.org e conferma che l’indirizzo restituito appartenga al proxy anziché alla tua macchina. Non dare mai per scontato che il proxy sia attivo solo perché la pagina è stata caricata.
import json
from seleniumwire import webdriver

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://api.ipify.org/?format=json")

body = driver.find_element("tag name", "body").text
exit_ip = json.loads(body)["ip"]
print("Exit IP:", exit_ip)  # should be the proxy, not your own address

driver.quit()
Se la risposta mostra il tuo IP reale, vale la pena verificare tre aspetti: che no_proxy non corrisponda accidentalmente al target, che le credenziali siano corrette e che webdriver sia stato importato da seleniumwire. Esegui questo controllo come primo passaggio di ogni nuovo job e ripetilo dopo aver modificato le impostazioni proxy.
Come ispezionare e attendere richieste specifiche?
Leggi driver.requests per esaminare ogni richiesta e risposta effettuata dal browser e usa driver.wait_for_request per bloccare l’esecuzione finché non appare una chiamata corrispondente. È la capacità che distingue Selenium Wire da un WebDriver normale ed è preziosa per trovare l’API JSON dietro una pagina.
from seleniumwire import webdriver

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com/products")

# Block until a request whose URL matches the regex is captured.
request = driver.wait_for_request(r"/api/v2/products", timeout=15)
print(request.method, request.url)
print("Status:", request.response.status_code)
print("Type:", request.response.headers["Content-Type"])

# Walk every captured request/response pair the browser made.
for r in driver.requests:
    if r.response:
        print(r.response.status_code, r.url)

driver.quit()
La chiamata wait_for_request accetta un’espressione regolare confrontata con l’URL e restituisce il risultato appena la richiesta viene acquisita, evitando attese fisse fragili. Quando sai quale chiamata in background contiene i dati, puoi spesso saltare del tutto il rendering e chiamare direttamente quell’endpoint, con un costo molto inferiore. Questa tecnica è centrale nelle best practice di web scraping.
Come modificare gli headers delle richieste con un interceptor?
Assegna una funzione a driver.request_interceptor: verrà eseguita prima che ogni richiesta esca dal browser e ti permetterà di sovrascrivere headers, inserire token o eliminare parametri. Impostare User-Agent e lingua realistici è un motivo comune per farlo.
from seleniumwire import webdriver

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)

def interceptor(request):
    # Delete first, then set, so you replace the header instead of duplicating it.
    del request.headers["User-Agent"]
    request.headers["User-Agent"] = "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
    request.headers["Accept-Language"] = "en-US,en;q=0.9"

driver.request_interceptor = interceptor
driver.get("https://httpbin.org/headers")
print(driver.find_element("tag name", "body").text)
driver.quit()
Elimina l’header esistente prima di impostare un nuovo valore, altrimenti Selenium Wire può inviare sia l’originale sia la sostituzione. Un response_interceptor corrispondente ti permette di leggere o riscrivere le risposte. Mantieni gli interceptor leggeri, poiché vengono eseguiti su ogni richiesta, comprese immagini e script. Headers coerenti e dall’aspetto umano sono uno dei segnali più discreti nelle best practice di web scraping.
Come ruotare i proxy per richiesta in Selenium Wire?
Hai due modalità: riassegnare driver.proxy in fase di esecuzione per cambiare configurazione nello stesso browser, oppure ricreare il driver quando desideri anche un profilo pulito e un archivio cookie vuoto. Un gateway a rotazione come DataImpulse assegna già un’uscita residential nuova sulle nuove connessioni, quindi per la maggior parte dei job basta cambiare configurazione per un altro paese.
from seleniumwire import webdriver

base = "http://login:[email protected]:823"
opts = {"proxy": {"http": base, "https": base,
                  "no_proxy": "localhost,127.0.0.1"}}
driver = webdriver.Chrome(seleniumwire_options=opts)

# Option A: reassign driver.proxy at runtime to switch config (for example a
# different country gateway) without rebuilding the browser. Cheap and fast.
uk = "http://login:[email protected]:823"
driver.proxy = {"http": uk, "https": uk, "no_proxy": "localhost,127.0.0.1"}
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()

# Option B: recreate the driver per job when you need a guaranteed clean
# browser profile and cookie jar as well as a fresh exit IP.
def fresh_driver():
    return webdriver.Chrome(seleniumwire_options=opts)

for _ in range(3):
    d = fresh_driver()
    d.get("https://api.ipify.org")
    print(d.find_element("tag name", "body").text)
    d.quit()
Riassegnare driver.proxy è economico e mantiene il browser attivo, l’ideale per cicli ad alto volume in cui il costo di avvio prevale. Ricreare il driver è più oneroso ma garantisce isolamento tra i job, importante quando un target collega le sessioni a cookie e archiviazione locale oltre che all’IP. Scegli in base al fatto che ti serva un’identità pulita o solo un nuovo indirizzo. Una regola pratica è riassegnare il proxy durante la raccolta di pagine pubbliche anonime e ricreare il driver ogni volta che attraversi un confine di account o login, così un cookie trapelato da un’esecuzione non potrà seguirti in quella successiva. I target mobile con fingerprinting aggressivo spesso giustificano i proxy mobile per i casi più difficili, mentre le pagine meno impegnative possono usare uscite meno costose.
Come eseguire Selenium Wire headless e ridurre l’uso della memoria?
Aggiungi opzioni Chrome per la modalità headless e la stabilità, poi limita ciò che Selenium Wire acquisisce per evitare che il buffer delle richieste cresca senza limiti. Sui server, headless più acquisizione delimitata fa la differenza tra un job che dura ore e uno che esaurisce la RAM.
Inizia con un solido set di flag Chrome per un container headless o un ambiente CI:
from seleniumwire import webdriver
from selenium.webdriver.chrome.options import Options

chrome_options = Options()
chrome_options.add_argument("--headless=new")     # modern headless mode
chrome_options.add_argument("--no-sandbox")
chrome_options.add_argument("--disable-dev-shm-usage")
chrome_options.add_argument("--disable-gpu")
chrome_options.add_argument("--window-size=1920,1080")

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

driver = webdriver.Chrome(options=chrome_options,
                          seleniumwire_options=seleniumwire_options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Per impostazione predefinita Selenium Wire acquisisce e memorizza nel buffer ogni richiesta e risposta, ed è proprio questo a consumare memoria nelle esecuzioni lunghe. Limita l’acquisizione con driver.scopes, mantieni lo storage in memoria e svuota il buffer tra le pagine:
from seleniumwire import webdriver

seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"},
    "request_storage": "memory",   # keep the buffer in RAM, not on disk
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)

# Only capture the API traffic you care about. Images, fonts, analytics, and
# tracking pixels are ignored, which keeps the capture buffer small.
driver.scopes = [r".*/api/.*"]

driver.get("https://example.com/products")
for request in driver.requests:
    print(request.url)

del driver.requests   # clear the buffer between pages on long-running jobs
driver.quit()
L’elenco scopes è un insieme di regex URL; tutto ciò che ne resta fuori passa comunque, ma non viene archiviato. In uno scraper che necessita solo delle risposte API, questo può ridurre drasticamente il buffer residente. Ridurre ciò che scarichi abbassa anche il costo del proxy, poiché il traffico DataImpulse è fatturato per gigabyte.
Come gestisce Selenium Wire HTTPS e il suo certificato?
Per leggere i corpi cifrati di richieste e risposte, Selenium Wire decifra HTTPS come man-in-the-middle usando il proprio certificato root, che inserisce automaticamente nel profilo del browser per Chrome e Firefox. È una funzionalità potente, ma con limiti importanti che dovresti comprendere prima di farvi affidamento.
from seleniumwire import webdriver

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"},
    # Selenium Wire is a man-in-the-middle proxy: to read HTTPS bodies it
    # decrypts traffic using its own root certificate, which it injects into
    # the browser profile automatically. These two options relax verification
    # on the upstream leg so a mismatched or self-signed cert does not abort.
    "verify_ssl": False,
    "suppress_connection_errors": True,
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com")
driver.quit()
Dal design man-in-the-middle derivano due conseguenze. Primo, un sito che usa certificate pinning rifiuterà il certificato inserito e l’intercettazione di quel traffico fallirà; in tal caso disabilita l’acquisizione per l’host interessato oppure rinuncia a ispezionarne i corpi. Secondo, se avvii Chrome con un profilo personalizzato o non predefinito, potresti dover verificare che la CA di Selenium Wire sia considerata attendibile. Le opzioni verify_ssl e suppress_connection_errors rilassano il collegamento upstream affinché un certificato anomalo non interrompa l’esecuzione, ma non aggirano il pinning.
Puoi combinare undetected-chromedriver e quali sono le alternative?
Sì. Selenium Wire include un’integrazione undetected-chromedriver che importi come seleniumwire.undetected_chromedriver, offrendoti ispezione delle richieste e proxy autenticati, mentre undetected-chromedriver riduce le impronte dell’automazione. È la combinazione di riferimento per target protetti.
# Selenium Wire ships its own undetected-chromedriver integration.
import seleniumwire.undetected_chromedriver as uc

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

options = uc.ChromeOptions()
options.add_argument("--headless=new")

driver = uc.Chrome(seleniumwire_options=seleniumwire_options, options=options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Quando Selenium Wire non è la soluzione adatta, due alternative coprono la maggior parte delle esigenze. Selenium 4 standard può usare un proxy autenticato tramite una piccola estensione generata, automatizzata da una libreria di supporto:
from selenium import webdriver
# Plain Selenium cannot send proxy credentials on its own. A small helper builds
# a throwaway Chrome extension that answers the proxy auth challenge for you.
from selenium_authenticated_proxy import SeleniumAuthenticatedProxy

proxy = SeleniumAuthenticatedProxy(
    proxy_url="http://login:[email protected]:823"
)
options = webdriver.ChromeOptions()
proxy.enrich_options(options)

driver = webdriver.Chrome(options=options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Playwright gestisce nativamente i proxy autenticati ed è mantenuto attivamente, quindi è una base migliore per nuovi progetti:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=True,
        proxy={
            "server": "http://gw.dataimpulse.com:823",
            "username": "login",
            "password": "password",
        },
    )
    page = browser.new_page()
    page.goto("https://api.ipify.org")
    print(page.inner_text("body"))
    browser.close()
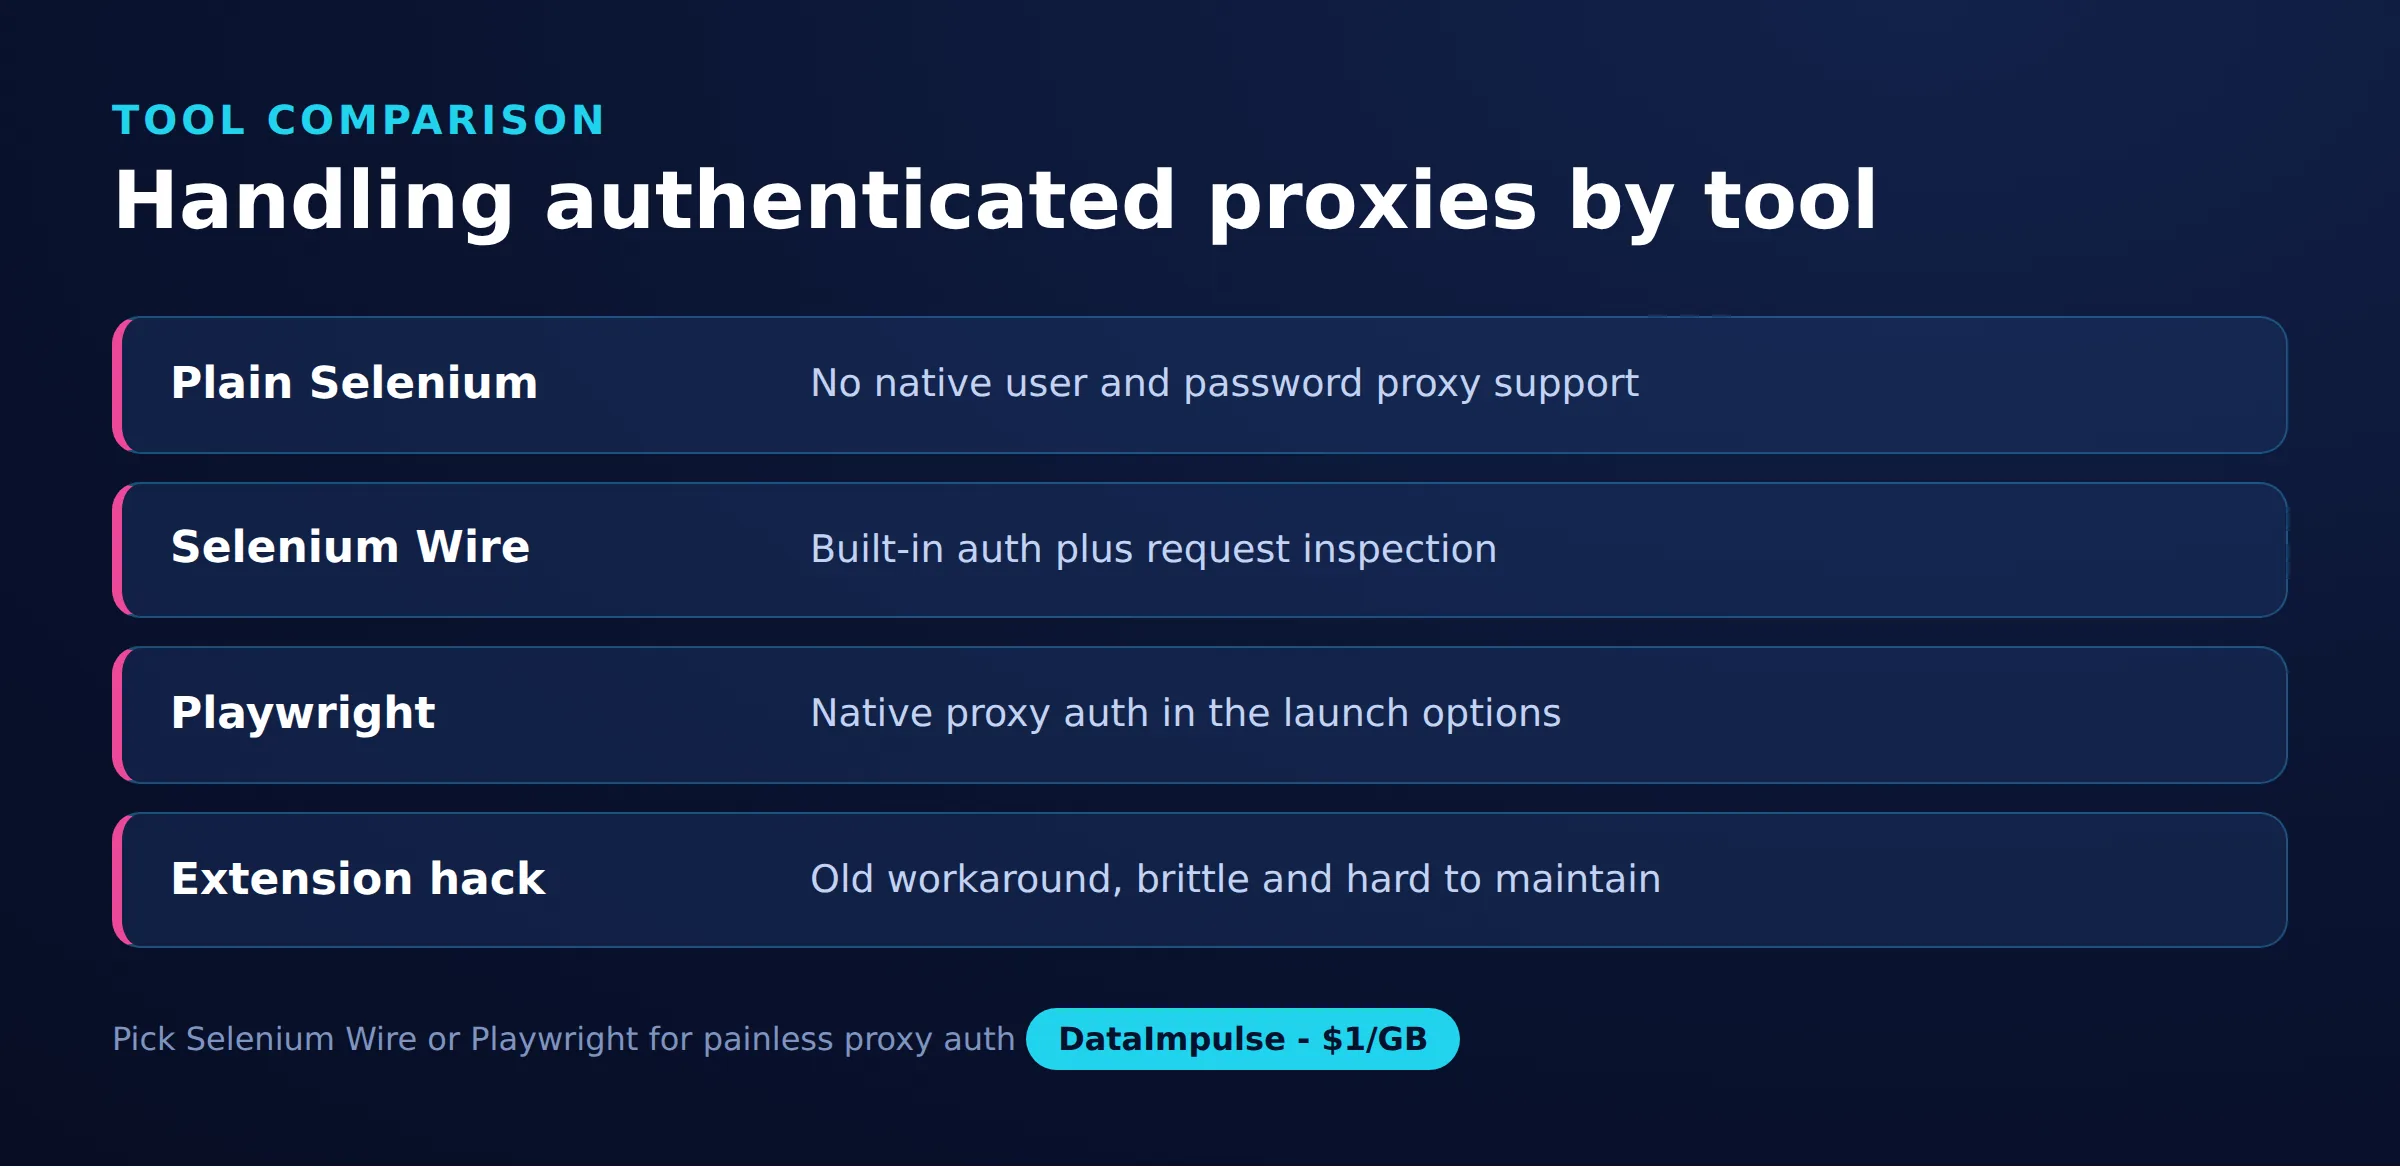
Ecco il confronto tra i tre specificamente per il lavoro con proxy autenticati:
| Strumento | Proxy autenticato | Ispezione delle richieste | Manutenzione | Ideale per |
|---|---|---|---|---|
| Plain Selenium 4 | richiede un supporto per estensione di autenticazione | no | attivo | flussi semplici, senza acquisizione richieste |
| Selenium Wire | integrato, un’opzione | accesso completo a richieste e risposte | archiviato, fissa le versioni | debug e controllo degli headers su codice Selenium esistente |
| Playwright | integrato, nativo | intercettazione di route e risposte | attivo | nuovi progetti che desiderano strumenti moderni |
Consiglio per la migrazione: se ti servono solo proxy con credenziali e non l’acquisizione delle richieste, Selenium standard con un’estensione di autenticazione è la soluzione più leggera e resta su codice mantenuto. Se dipendi dall’ispezione o dalla riscrittura del traffico e parti da zero, Playwright te lo offre nativamente senza l’onere di fissare le versioni. Mantieni Selenium Wire quando hai una codebase Selenium esistente il cui controllo a livello di richiesta sarebbe costoso da ricostruire. Per scegliere gli IP con uno qualsiasi di questi strumenti, confronta proxy residential, proxy datacenter, e proxy mobile con le difese del tuo target.
Domande frequenti
Come imposto un proxy autenticato in Selenium Wire?
Passa un dizionario proxy con URL http e https nel formato login:password@host:port dentro seleniumwire_options quando crei il driver e aggiungi no_proxy per localhost. Non servono estensioni né soluzioni per finestre di dialogo di autenticazione.
Perché Selenium Wire fallisce con un ImportError di blinker?
blinker 1.8 ha rimosso un nome interno che Selenium Wire importa all’avvio. Fissa blinker a una versione inferiore alla 1.8, ad esempio blinker==1.7.0, insieme alle versioni fissate di selenium-wire e selenium.
Selenium Wire è ancora mantenuto?
Il progetto originale è archiviato e non è più mantenuto attivamente. Funziona ancora con versioni fissate, ma testa isolatamente ogni aggiornamento di Selenium o Chrome e considera un fork mantenuto o Playwright per nuovi progetti.
Come controllo che il proxy sia realmente in uso?
Carica nel driver un servizio di eco IP come api.ipify.org e conferma che l’indirizzo restituito sia quello del proxy, non il tuo. Puoi anche leggere driver.requests per verificare che il traffico sia passato dal gateway.
Selenium Wire può leggere il traffico HTTPS?
Sì. Agisce come proxy man-in-the-middle e inserisce il proprio certificato root per decifrare i corpi HTTPS. I siti che usano certificate pinning lo rifiuteranno, quindi disabilita l’acquisizione per quegli host.
Quando DataImpulse non è la soluzione adatta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter a rotazione per raccogliere dati pubblici e accedere a contenuti.
Esegui Selenium Wire tramite proxy affidabili
Un proxy Selenium Wire è valido quanto gli IP che lo sostengono. Puoi instradare l’automazione del browser tramite IP residential, mobile o datacenter ottenuti eticamente, con traffico pay-as-you-go da 1 dollaro per GB. Crea un account DataImpulse e inizia con sessioni a rotazione o sticky session.