
In this Article
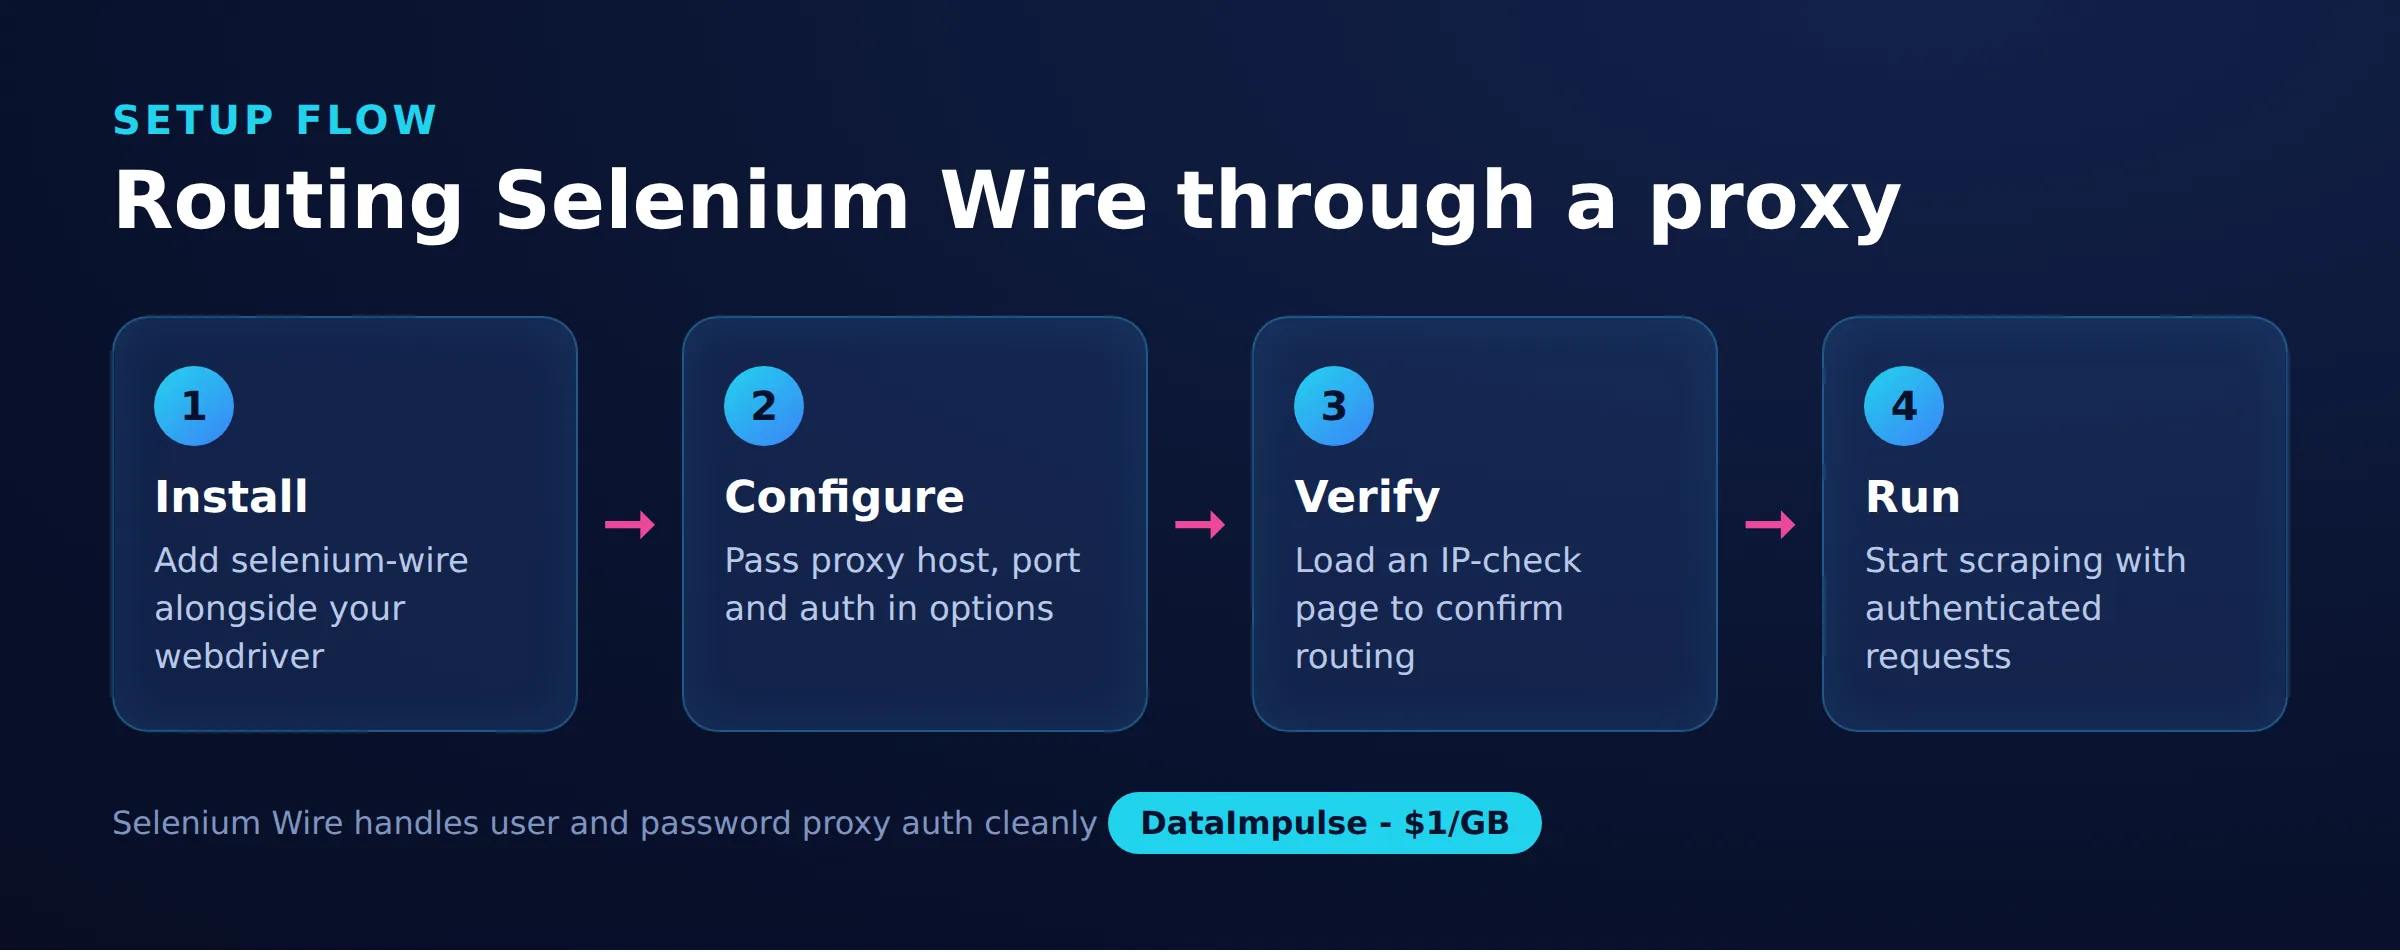
Proxy w Selenium Wire to najprostsza droga do uruchomienia uwierzytelnionej automatyzacji przeglądarki w Pythonie, ponieważ Selenium Wire przyjmuje proxy URL login:password bezpośrednio w jednej opcji, zamiast wymagać obejścia z rozszerzeniem, którego potrzebuje zwykły Selenium. Udostępnia też każde żądanie i odpowiedź HTTP wysyłane przez przeglądarkę, dlatego sięgają po nie zespoły web scraping i QA.
Ten przewodnik prowadzi krok po kroku przez cały proces. Omawia bezpieczną instalację i przypinanie wersji biblioteki, podłączenie uwierzytelnionego proxy, weryfikację wyjściowego IP, inspekcję i oczekiwanie na żądania, edycję headers, rotację IP, działanie w trybie headless, ograniczanie użycia pamięci, rzetelne podejście do certyfikatu HTTPS, łączenie z undetected-chromedriver oraz miejsce nowoczesnych alternatyw.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 mln residential, mobile i datacenter adresów IP w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Proxy w Selenium Wire: Selenium Wire przyjmuje proxy URL login:password bezpośrednio w seleniumwire_options, dzięki czemu uwierzytelniona automatyzacja przeglądarki działa bez obejścia z rozszerzeniem potrzebnego zwykłemu Selenium.
- Najlepszy typ proxy: rotating residential proxies, które korzystają z prawdziwych konsumenckich IP przechodzących wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu ważności i bez subskrypcji.
- Zasięg: Ponad 90 mln etycznie pozyskanych IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4,8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraje w pakiecie.
Czym jest Selenium Wire i czy jest nadal utrzymywany?
Selenium Wire to biblioteka Python rozszerzająca Selenium, dzięki której Twój skrypt może kontrolować, odczekiwać i modyfikować żądania oraz odpowiedzi HTTP przeglądarki, a także zapewnia pełną obsługę uwierzytelnionego proxy. Działa przez uruchomienie lokalnego proxy man-in-the-middle, na które kierowana jest przeglądarka, a następnie przekazuje ruch do właściwego upstream proxy.
Istotne zastrzeżenie jest takie, że oryginalny projekt został zarchiwizowany i nie jest już aktywnie utrzymywany. Nadal dobrze działa produkcyjnie, ale przed wdrożeniem przypnij wersje i osobno przetestuj każdą aktualizację Selenium, Chrome lub zależności. Istnieją forki społecznościowe przenoszące poprawki kompatybilności, a tabela porównawcza w dalszej części przewodnika pokazuje, kiedy utrzymywane narzędzie takie jak Playwright będzie lepszym wyborem na dłuższą metę.
Zespoły nadal wybierają je dla wygody. Jeśli masz już zestaw testów Selenium lub scraper, dodanie Selenium Wire to jednoliniowa zmiana importu oraz opcja proxy, a od razu zyskujesz obsługę uwierzytelnionego proxy i możliwość odczytania każdego żądania strony. Odtworzenie takiej widoczności na poziomie żądań w zwykłym Selenium wymaga realnej pracy, dlatego w istniejących bazach kodu ten kompromis często jest wart zarchiwizowanego statusu. Jeśli dopiero zaczynasz używać prawdziwych przeglądarek do zbierania danych, nasz przewodnik o jak scrape’ować dynamiczne strony internetowe omawia szerszy obraz renderowania oraz sytuacje, w których przeglądarka jest w ogóle potrzebna.
Jak zainstalować Selenium Wire i przypiąć wersje, aby uniknąć problemów?
Zainstaluj selenium-wire razem z selenium i przypnij blinker poniżej 1.8, ponieważ w tym wydaniu usunięto wewnętrzną nazwę importowaną przez Selenium Wire przy uruchomieniu. Ponieważ projekt jest zarchiwizowany, nieprzypięte zależności są najczęstszą przyczyną nagłej awarii działającej konfiguracji.
Klasyczny błąd to ImportError dotyczący WeakNamespace po automatycznej aktualizacji blinker. Przypięcie wersji mu zapobiega:
# Selenium Wire is archived. Pin known-good versions so an upstream release
# does not break your build overnight.
#
# blinker >= 1.8 removed blinker._saferef / WeakNamespace, which Selenium Wire
# imports at startup. On blinker 1.8+ you get:
#   ImportError: cannot import name 'WeakNamespace' from 'blinker'
# The fix is to hold blinker below 1.8.
pip install "selenium-wire==5.1.0" "selenium==4.9.1" "blinker==1.7.0"

# Selenium Wire also depends on brotli and can trip on very new Selenium.
# If you must run current Selenium, test in a throwaway virtualenv first, or
# move to a maintained fork such as selenium-wire-2 that tracks these fixes.
Zachowaj te przypięcia w pliku requirements, aby continuous integration i członkowie zespołu otrzymywali tę samą sprawdzoną kombinację. Gdy zechcesz przejść na aktualny Selenium, potraktuj to jako celową aktualizację z osobnym uruchomieniem testów, zamiast pozwalać pip rozwiązać najnowsze wersje wszystkiego.
Jak skonfigurować uwierzytelnione proxy w Selenium Wire?
Podczas tworzenia driver przekaż słownik proxy w seleniumwire_options, z nazwą użytkownika i hasłem osadzonymi w URL oraz z localhost wykluczonym przez no_proxy. To właśnie ta funkcja sprawia, że Selenium Wire warto używać do pracy z proxy zamiast zwykłego Selenium.
Zaimportuj webdriver z seleniumwire, a nie z selenium, a następnie przekaż mu opcje. Dane uwierzytelniające, host i port znajdziesz w dashboard dostawcy. W DataImpulse host to gw.dataimpulse.com, a port to 823:
from seleniumwire import webdriver  # import from seleniumwire, not selenium

proxy_url = "http://login:[email protected]:823"

seleniumwire_options = {
    "proxy": {
        "http": proxy_url,
        "https": proxy_url,
        "no_proxy": "localhost,127.0.0.1",
    }
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com")
print(driver.title)
driver.quit()
Wpis no_proxy utrzymuje lokalne adresy poza proxy, aby driver mógł komunikować się bezpośrednio z ChromeDriver. Jeśli uwierzytelnienie jest nieprawidłowe, zazwyczaj zobaczysz odpowiedź 407. Nasza uwaga o błędzie 407 Proxy Authentication Required wyjaśnia, jak go diagnozować. Informacje o ogólnym działaniu proxy z danymi uwierzytelniającymi znajdziesz w materiale residential proxies.
Jak sprawdzić, czy wyjściowe IP proxy działa?
Skieruj driver do endpointu IP-echo, takiego jak api.ipify.org, i potwierdź, że zwrócony adres należy do proxy, a nie do Twojego urządzenia. Nigdy nie zakładaj, że proxy działa tylko dlatego, że strona się załadowała.
import json
from seleniumwire import webdriver

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://api.ipify.org/?format=json")

body = driver.find_element("tag name", "body").text
exit_ip = json.loads(body)["ip"]
print("Exit IP:", exit_ip)  # should be the proxy, not your own address

driver.quit()
Jeśli odpowiedź pokazuje Twoje rzeczywiste IP, sprawdź trzy rzeczy: czy no_proxy nie pasuje przypadkowo do celu, czy dane uwierzytelniające są prawidłowe oraz czy webdriver został zaimportowany z seleniumwire. Wykonuj tę kontrolę jako pierwszy krok każdego nowego zadania i ponownie po zmianie ustawień proxy.
Jak sprawdzać konkretne żądania i na nie czekać?
Odczytaj driver.requests, aby przejść przez każde żądanie i odpowiedź przeglądarki, oraz użyj driver.wait_for_request, aby czekać na pojawienie się pasującego wywołania. Ta możliwość odróżnia Selenium Wire od zwykłego WebDriver i jest nieoceniona przy znajdowaniu JSON API działającego za stroną.
from seleniumwire import webdriver

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com/products")

# Block until a request whose URL matches the regex is captured.
request = driver.wait_for_request(r"/api/v2/products", timeout=15)
print(request.method, request.url)
print("Status:", request.response.status_code)
print("Type:", request.response.headers["Content-Type"])

# Walk every captured request/response pair the browser made.
for r in driver.requests:
    if r.response:
        print(r.response.status_code, r.url)

driver.quit()
Wywołanie wait_for_request przyjmuje wyrażenie regularne dopasowywane do URL i zwraca wynik natychmiast po przechwyceniu żądania, dzięki czemu unikasz kruchych stałych opóźnień. Gdy wiesz, które wywołanie w tle przenosi dane, często możesz całkowicie pominąć renderowanie i uderzyć bezpośrednio w endpoint, co jest znacznie tańsze. Technika ta stanowi podstawę najlepszych praktyk web scraping.
Jak modyfikować headers żądań za pomocą interceptora?
Przypisz funkcję do driver.request_interceptor, a uruchomi się przed opuszczeniem przeglądarki przez każde żądanie, umożliwiając nadpisywanie headers, wstrzykiwanie tokenów lub usuwanie parametrów. Częstym powodem użycia tej funkcji jest ustawienie realistycznego User-Agent i języka.
from seleniumwire import webdriver

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)

def interceptor(request):
    # Delete first, then set, so you replace the header instead of duplicating it.
    del request.headers["User-Agent"]
    request.headers["User-Agent"] = "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
    request.headers["Accept-Language"] = "en-US,en;q=0.9"

driver.request_interceptor = interceptor
driver.get("https://httpbin.org/headers")
print(driver.find_element("tag name", "body").text)
driver.quit()
Usuń istniejący header przed ustawieniem nowej wartości, w przeciwnym razie Selenium Wire może wysłać zarówno oryginał, jak i zamiennik. Pasujący response_interceptor pozwala odczytywać lub przepisywać odpowiedzi. Interceptory powinny być lekkie, ponieważ uruchamiają się przy każdym żądaniu, także obrazów i skryptów. Spójne, wyglądające po ludzku headers to jeden z mniej oczywistych sygnałów w najlepszych praktyk web scraping.
Jak rotować proxy dla każdego żądania w Selenium Wire?
Masz dwa wzorce: przypisz ponownie driver.proxy w czasie działania, aby zmienić konfigurację w tej samej przeglądarce, albo utwórz driver ponownie, gdy chcesz też mieć czysty profil i magazyn cookies. Rotating gateway taki jak DataImpulse już przydziela świeże residential wyjście dla nowych połączeń, dlatego w większości zadań wystarczy zmienić konfigurację dla innego kraju.
from seleniumwire import webdriver

base = "http://login:[email protected]:823"
opts = {"proxy": {"http": base, "https": base,
                  "no_proxy": "localhost,127.0.0.1"}}
driver = webdriver.Chrome(seleniumwire_options=opts)

# Option A: reassign driver.proxy at runtime to switch config (for example a
# different country gateway) without rebuilding the browser. Cheap and fast.
uk = "http://login:[email protected]:823"
driver.proxy = {"http": uk, "https": uk, "no_proxy": "localhost,127.0.0.1"}
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()

# Option B: recreate the driver per job when you need a guaranteed clean
# browser profile and cookie jar as well as a fresh exit IP.
def fresh_driver():
    return webdriver.Chrome(seleniumwire_options=opts)

for _ in range(3):
    d = fresh_driver()
    d.get("https://api.ipify.org")
    print(d.find_element("tag name", "body").text)
    d.quit()
Ponowne przypisanie driver.proxy jest tanie i utrzymuje rozgrzaną przeglądarkę, co pasuje do pętli o dużym wolumenie, gdzie dominuje koszt uruchomienia. Ponowne tworzenie driver jest cięższe, ale gwarantuje izolację między zadaniami, co ma znaczenie, gdy cel wiąże sesje z cookies i pamięcią lokalną oraz IP. Wybierz zależnie od tego, czy potrzebujesz czystej tożsamości, czy tylko nowego adresu. Praktyczna zasada: przypisuj proxy ponownie przy zbieraniu anonimowych stron publicznych, a odtwarzaj driver po każdym przekroczeniu granicy konta lub logowania, aby cookie, które wyciekło z jednego uruchomienia, nie przeszło do kolejnego. Cele mobile intensywnie stosujące fingerprinting często uzasadniają użycie mobile proxies w najtrudniejszych przypadkach, podczas gdy lżejsze strony mogą pozostać na tańszych wyjściach.
Jak uruchomić Selenium Wire w trybie headless i ograniczyć pamięć?
Dodaj opcje Chrome dla trybu headless i stabilności, a następnie ograniczaj to, co przechwytuje Selenium Wire, aby bufor żądań nie rósł bez ograniczeń. Na serwerach headless wraz z zawężonym przechwytywaniem stanowi różnicę między zadaniem działającym godzinami a takim, które wyczerpuje RAM.
Zacznij od solidnego zestawu flag Chrome dla kontenera headless lub środowiska CI:
from seleniumwire import webdriver
from selenium.webdriver.chrome.options import Options

chrome_options = Options()
chrome_options.add_argument("--headless=new")     # modern headless mode
chrome_options.add_argument("--no-sandbox")
chrome_options.add_argument("--disable-dev-shm-usage")
chrome_options.add_argument("--disable-gpu")
chrome_options.add_argument("--window-size=1920,1080")

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

driver = webdriver.Chrome(options=chrome_options,
                          seleniumwire_options=seleniumwire_options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Domyślnie Selenium Wire przechwytuje i buforuje każde żądanie oraz odpowiedź, co właśnie zużywa pamięć podczas długich uruchomień. Ogranicz przechwytywanie przez driver.scopes, przechowuj dane w pamięci i czyść bufor między stronami:
from seleniumwire import webdriver

seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"},
    "request_storage": "memory",   # keep the buffer in RAM, not on disk
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)

# Only capture the API traffic you care about. Images, fonts, analytics, and
# tracking pixels are ignored, which keeps the capture buffer small.
driver.scopes = [r".*/api/.*"]

driver.get("https://example.com/products")
for request in driver.requests:
    print(request.url)

del driver.requests   # clear the buffer between pages on long-running jobs
driver.quit()
Lista scopes to zestaw wyrażeń regularnych URL. Wszystko poza nimi jest przekazywane, lecz nie jest zapisywane. W scraperze potrzebującym tylko odpowiedzi API może to radykalnie zmniejszyć bufor w pamięci. Ograniczenie pobieranych danych obniża także koszt proxy, ponieważ ruch DataImpulse jest rozliczany za gigabajt.
Jak Selenium Wire obsługuje HTTPS i jego certyfikat?
Aby odczytywać zaszyfrowane treści żądań i odpowiedzi, Selenium Wire odszyfrowuje HTTPS jako man-in-the-middle, używając własnego certyfikatu głównego, który automatycznie wstrzykuje do profilu przeglądarki Chrome i Firefox. To potężne rozwiązanie, ale ma realne ograniczenia, które powinieneś zrozumieć, zanim na nim polegasz.
from seleniumwire import webdriver

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"},
    # Selenium Wire is a man-in-the-middle proxy: to read HTTPS bodies it
    # decrypts traffic using its own root certificate, which it injects into
    # the browser profile automatically. These two options relax verification
    # on the upstream leg so a mismatched or self-signed cert does not abort.
    "verify_ssl": False,
    "suppress_connection_errors": True,
}

driver = webdriver.Chrome(seleniumwire_options=seleniumwire_options)
driver.get("https://example.com")
driver.quit()
Z konstrukcji man-in-the-middle wynikają dwie rzeczy. Po pierwsze, strona stosująca certificate pinning odrzuci wstrzyknięty certyfikat i przechwytywanie tego ruchu się nie powiedzie. W takim przypadku wyłącz przechwytywanie dla danego hosta lub zrezygnuj z inspekcji jego treści. Po drugie, jeśli uruchamiasz Chrome z niestandardowym profilem, może być konieczne upewnienie się, że Selenium Wire CA jest tam zaufany. Opcje verify_ssl i suppress_connection_errors łagodzą upstream leg, aby nietypowy certyfikat nie przerwał uruchomienia, lecz nie omijają pinning.
Czy można połączyć je z undetected-chromedriver i jakie są alternatywy?
Tak. Selenium Wire oferuje integrację undetected-chromedriver importowaną jako seleniumwire.undetected_chromedriver, zapewniając inspekcję żądań i uwierzytelnione proxy, podczas gdy undetected-chromedriver ogranicza fingerprinting automatyzacji. To podstawowe połączenie dla chronionych celów.
# Selenium Wire ships its own undetected-chromedriver integration.
import seleniumwire.undetected_chromedriver as uc

proxy_url = "http://login:[email protected]:823"
seleniumwire_options = {
    "proxy": {"http": proxy_url, "https": proxy_url,
              "no_proxy": "localhost,127.0.0.1"}
}

options = uc.ChromeOptions()
options.add_argument("--headless=new")

driver = uc.Chrome(seleniumwire_options=seleniumwire_options, options=options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Gdy samo Selenium Wire nie jest właściwym wyborem, dwie alternatywy pokrywają większość potrzeb. Zwykły Selenium 4 może używać uwierzytelnionego proxy przez małe generowane rozszerzenie, co automatyzuje biblioteka pomocnicza:
from selenium import webdriver
# Plain Selenium cannot send proxy credentials on its own. A small helper builds
# a throwaway Chrome extension that answers the proxy auth challenge for you.
from selenium_authenticated_proxy import SeleniumAuthenticatedProxy

proxy = SeleniumAuthenticatedProxy(
    proxy_url="http://login:[email protected]:823"
)
options = webdriver.ChromeOptions()
proxy.enrich_options(options)

driver = webdriver.Chrome(options=options)
driver.get("https://api.ipify.org")
print(driver.find_element("tag name", "body").text)
driver.quit()
Playwright obsługuje uwierzytelnione proxy natywnie i jest aktywnie utrzymywany, co czyni go lepszą podstawą nowych projektów:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=True,
        proxy={
            "server": "http://gw.dataimpulse.com:823",
            "username": "login",
            "password": "password",
        },
    )
    page = browser.new_page()
    page.goto("https://api.ipify.org")
    print(page.inner_text("body"))
    browser.close()
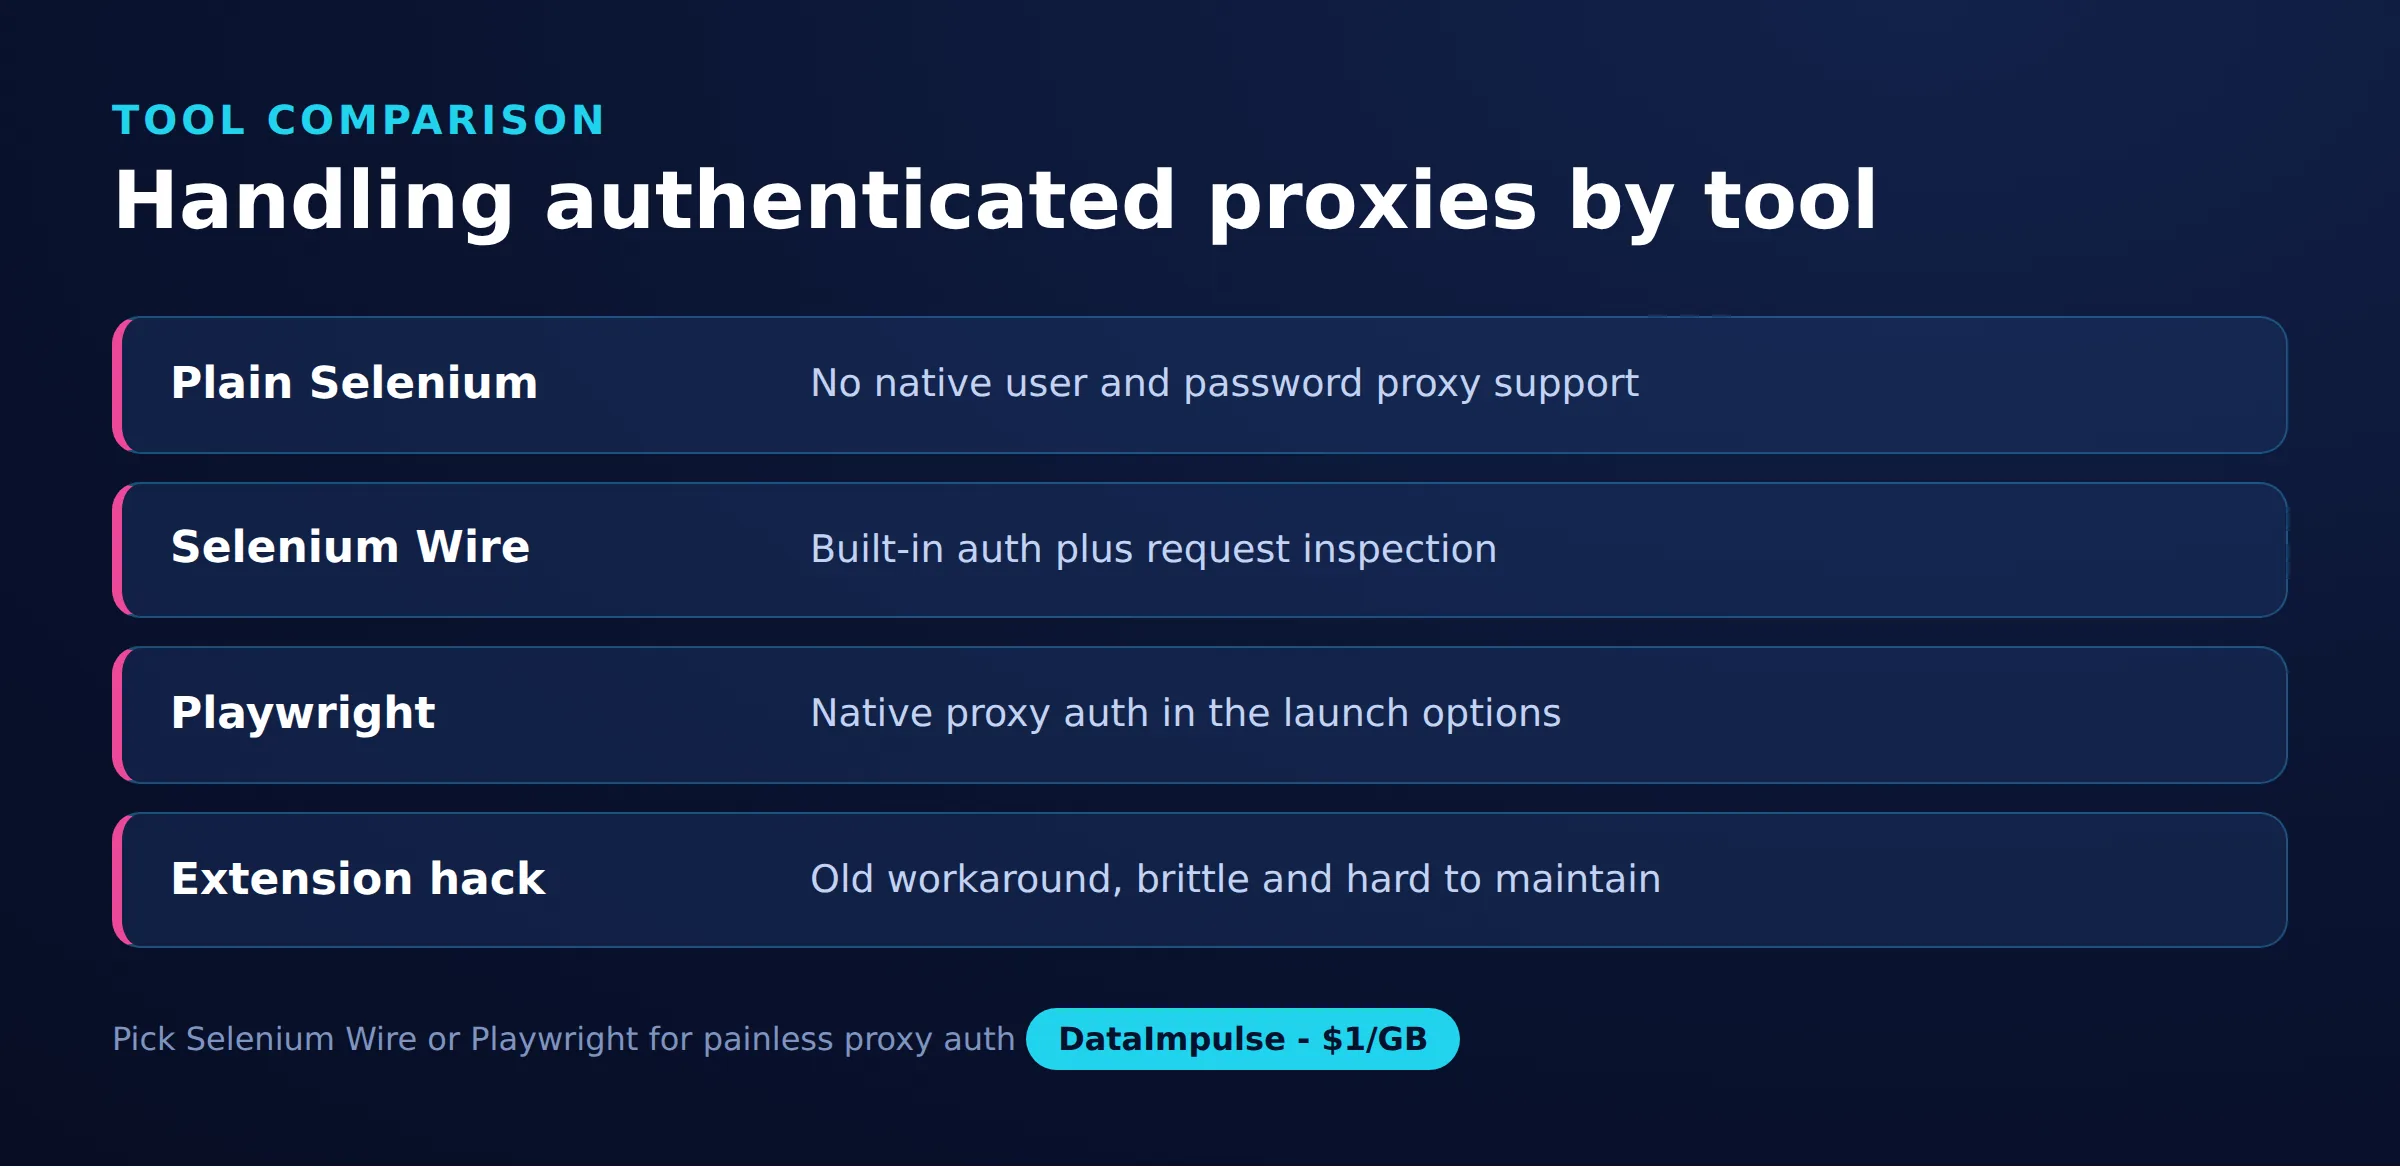
Tak przedstawia się porównanie tych trzech narzędzi konkretnie do pracy z uwierzytelnionym proxy:
| Narzędzie | Uwierzytelnione proxy | Inspekcja żądań | Utrzymanie | Najlepsze zastosowanie |
|---|---|---|---|---|
| Plain Selenium 4 | wymaga pomocniczego rozszerzenia auth | nie | aktywnie utrzymywany | proste przepływy bez przechwytywania żądań |
| Selenium Wire | wbudowane, jedna opcja | pełny dostęp do żądań i odpowiedzi | zarchiwizowany, przypnij wersje | debugowanie i kontrola headers w istniejącym kodzie Selenium |
| Playwright | wbudowane, natywne | przechwytywanie tras i odpowiedzi | aktywnie utrzymywany | nowe projekty potrzebujące nowoczesnych narzędzi |
Wskazówka dotycząca migracji: jeśli potrzebujesz tylko proxy z danymi uwierzytelniającymi i bez przechwytywania żądań, zwykły Selenium z rozszerzeniem auth jest najlżejszym rozwiązaniem i pozostaje przy utrzymywanym kodzie. Jeśli polegasz na inspekcji lub przepisywaniu ruchu i zaczynasz od zera, Playwright oferuje to natywnie bez ciężaru przypinania wersji. Pozostań przy Selenium Wire, gdy masz istniejącą bazę kodu Selenium, w której odbudowanie kontroli na poziomie żądań byłoby kosztowne. Przy wyborze IP dla każdego z tych narzędzi porównaj residential proxies, datacenter proxies oraz mobile proxies z zabezpieczeniami Twojego celu.
Najczęściej zadawane pytania
Jak ustawić uwierzytelnione proxy w Selenium Wire?
Podczas tworzenia driver przekaż w seleniumwire_options słownik proxy z URL http i https w formie login:password@host:port oraz dodaj no_proxy dla localhost. Nie jest potrzebne rozszerzenie ani obejście okna auth.
Dlaczego Selenium Wire kończy się błędem ImportError blinker?
blinker 1.8 usunął wewnętrzną nazwę importowaną przez Selenium Wire przy uruchomieniu. Przypnij blinker poniżej 1.8, na przykład blinker==1.7.0, razem z przypiętymi wersjami selenium-wire i selenium.
Czy Selenium Wire jest nadal utrzymywany?
Oryginalny projekt jest zarchiwizowany i nie jest już aktywnie utrzymywany. Nadal działa z przypiętymi wersjami, ale osobno przetestuj każdą aktualizację Selenium lub Chrome i rozważ utrzymywany fork albo Playwright dla nowych projektów.
Jak sprawdzić, czy proxy jest faktycznie używane?
Otwórz w driver usługę IP-echo, taką jak api.ipify.org, i potwierdź, że zwrócony adres to proxy, a nie Twój własny. Możesz też odczytać driver.requests, aby sprawdzić, że ruch przeszedł przez gateway.
Czy Selenium Wire może odczytywać ruch HTTPS?
Tak. Działa jako proxy man-in-the-middle i wstrzykuje własny certyfikat główny, aby odszyfrować treści HTTPS. Strony stosujące certificate pinning go odrzucą, więc wyłącz przechwytywanie dla tych hostów.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego scraping API lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotating residential, mobile i datacenter proxies do zbierania danych publicznych i dostępu do treści.
Uruchamiaj Selenium Wire przez niezawodne proxy
Proxy w Selenium Wire jest tak dobre, jak IP stojące za nim. Możesz kierować automatyzację przeglądarki przez etycznie pozyskane residential, mobile lub datacenter IP w modelu pay-as-you-go od 1 dolara za GB. Utwórz konto DataImpulse i zacznij od rotating lub sticky session.