
In this Article
Scrapowanie Google Shopping polega na zbieraniu na dużą skalę ustrukturyzowanych danych o produktach (tytułów, cen, sprzedawców, ocen i informacji o dostawie) z wyników zakupowych Google. Ponieważ wyniki te są silnie chronione i zlokalizowane, niezawodne działanie wymaga rotujących IP oraz właściwego geotargetowania, a nie jednego scrapera na jednym połączeniu.
Ten przewodnik stawia kod na pierwszym miejscu. Omawia żądania z geotargetowaniem, kierowanie ruchu przez proxy dla konkretnych krajów, parsowanie kart produktów, których Google celowo zaciemnia strukturę, paginację, ponawianie żądań i backoff przy limitach, alternatywę w postaci przeglądarki headless z obsługą okna zgody, przejrzysty model danych z eksportem CSV, śledzenie historii cen oraz harmonogram monitorowania. Uczciwie przedstawia też realia systemów anti-bot, kompromis między scraperem własnej budowy a płatnym SERP API oraz granice prawne.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 mln residential, mobile i datacenter adresów IP w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z ruchem bez daty wygaśnięcia i jest używany do web scraping, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Ceny lokalne: Aby dokładnie scrapować Google Shopping, musisz ustawić parametry gl i hl oraz kierować żądania przez IP w kraju docelowym, ponieważ ceny, sprzedawcy i dostępność różnią się w zależności od regionu.
- Najlepszy typ proxy: rotujące residential proxy, które korzystają z prawdziwych konsumenckich IP i przechodzą przez wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez daty wygaśnięcia i bez subskrypcji.
- Zasięg: Ponad 90 mln etycznie pozyskiwanych IP w 195 krajach.
- Niezawodność: 99,51% skuteczności, ocena 4,8/5 na G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5 z targetowaniem na kraj w cenie.
Jakie dane można scrapować z Google Shopping?
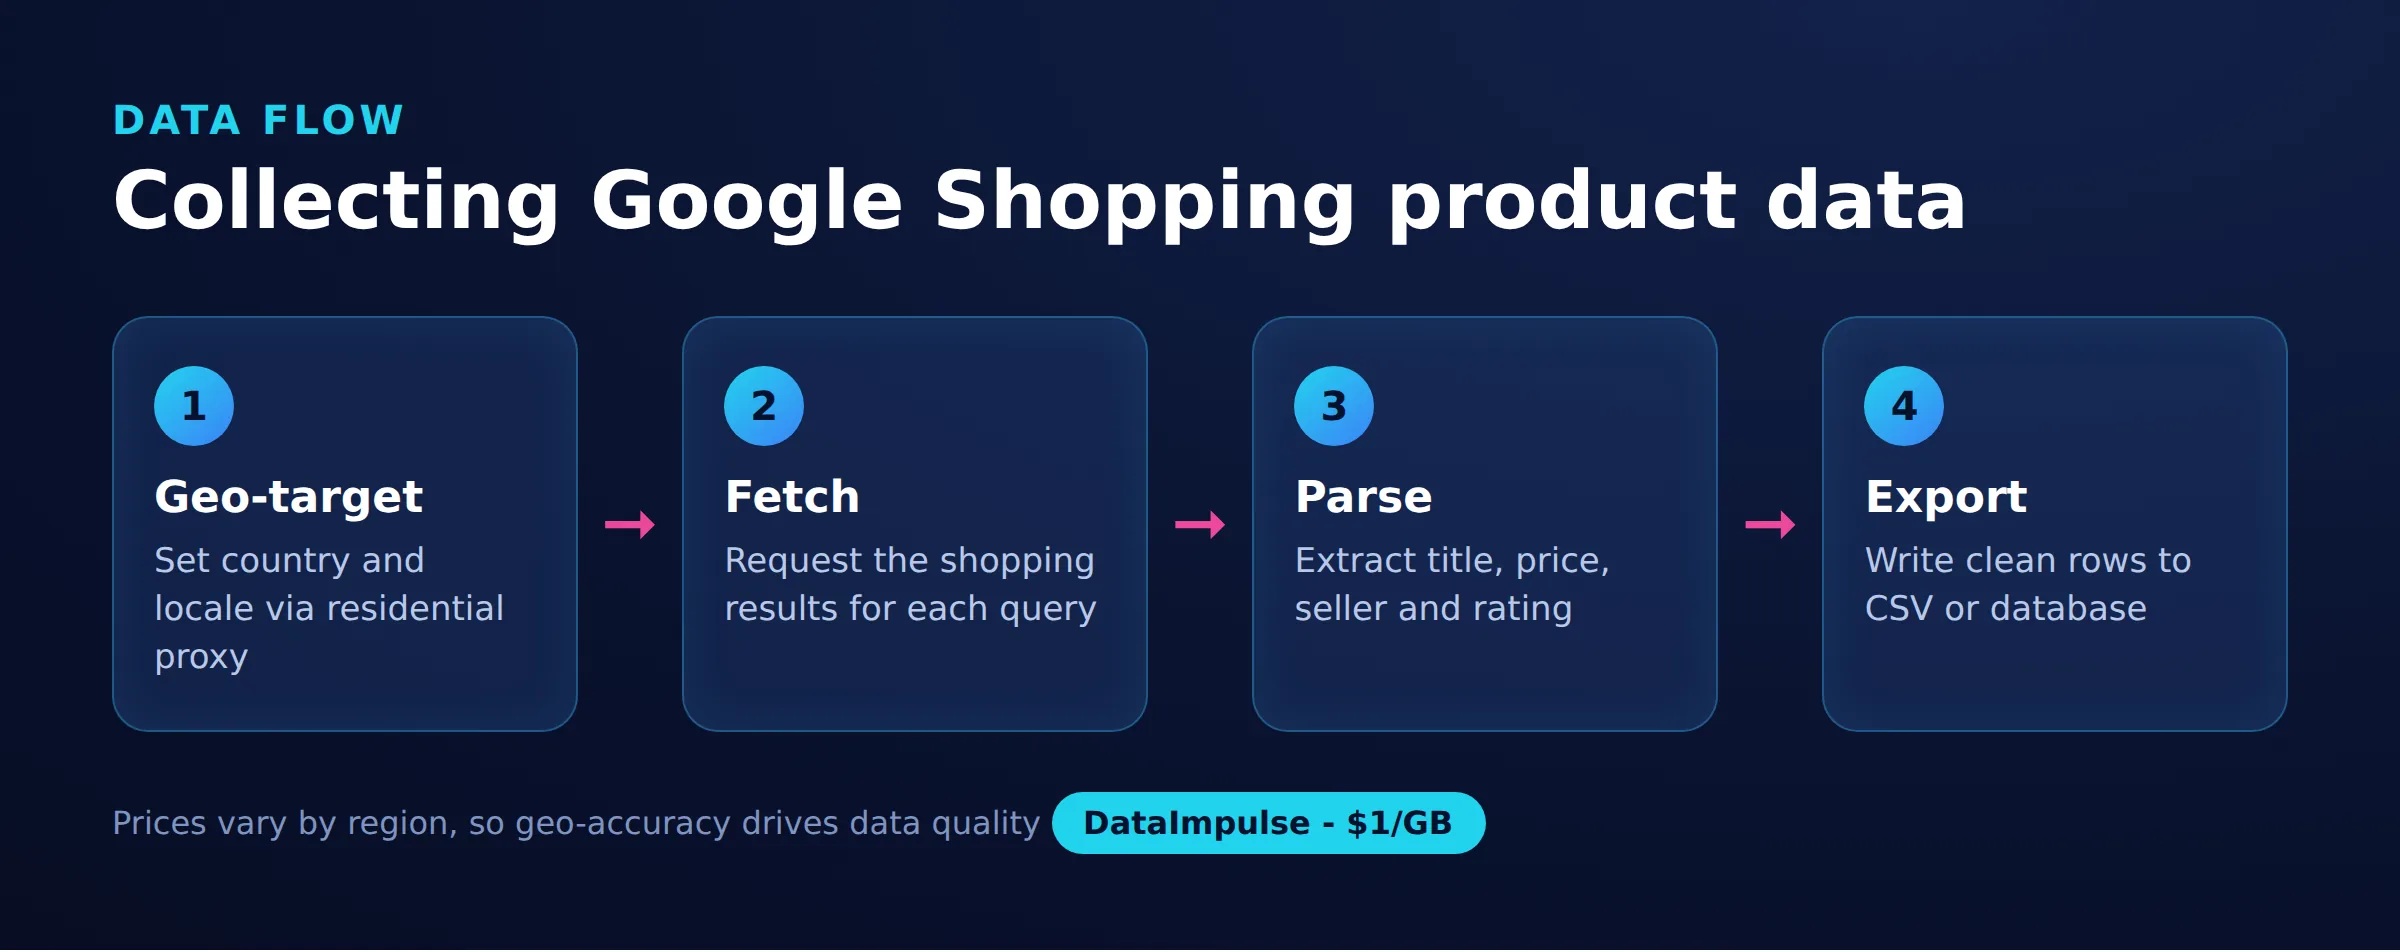
Google Shopping udostępnia oferty produktów z kilkoma ustrukturyzowanymi polami przydatnymi do analizy cen i rynku. Każdy wynik zwykle zawiera spójny zestaw atrybutów, które możesz wyodrębnić i znormalizować do wierszy.
- Szczegóły produktu: tytuł, fragment opisu, marka, model i URL obrazu produktu.
- Cena: podana cena, waluta, a czasem zakres cen u różnych sprzedawców.
- Sprzedawca: nazwa sprzedawcy oraz, na stronie szczegółów produktu, lista konkurencyjnych sprzedawców oferujących ten sam artykuł.
- Oceny i recenzje: łączna ocena gwiazdkowa i liczba recenzji, jeśli są dostępne.
- Dostępność i dostawa: status zapasów i informacje o dostawie różniące się zależnie od regionu.
Dokładne pola zmieniają się, gdy Google aktualizuje układ, więc każdy parser musi tolerować brakujące wartości i zmienny markup. Traktuj każde pole jako opcjonalne i sprawdzaj typy po ekstrakcji, zamiast zakładać, że ocena lub sprzedawca zawsze są obecne. Ponieważ ten sam produkt może mieć inne ceny w różnych krajach, od początku oprzyj schemat na kluczu (produkt, kraj, znacznik czasu), zamiast dodawać geografię później.
Jak wysłać żądanie do Google Shopping z geotargetowaniem?
Wysyłasz żądanie z geotargetowaniem, wywołując endpoint wyszukiwania Google z flagą karty zakupów i parametrami lokalizacji, a następnie przekazując te same sygnały IP i parametrów co prawdziwy kupujący. Dwa najważniejsze parametry to gl (kraj, na przykład gl=de dla Niemiec) oraz hl (język interfejsu, na przykład hl=de). Trzecim użytecznym elementem jest termin w stylu location, który uwzględniasz w kontekście zapytania, lecz gl wraz z pasującym wyjściowym IP wykonują większość pracy.
Samo ustawienie parametrów nie wystarcza, ponieważ Google odczytuje też IP żądania, aby zdecydować, które ceny i sprzedawców pokazać. Minimalne żądanie poniżej wysyła realistyczne nagłówki i parę ustawień lokalnych. Celowo nie używa proxy, abyś zobaczył podstawowe wywołanie przed dodaniem warstwy IP.
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
Utrzymuj nagłówek Accept-Language zgodny z hl. Niemiecka strona cenowa żądana z angielskim nagłówkiem językowym to niespójność, która wygląda nienaturalnie i może zwrócić niewłaściwą walutę. Przy skalowaniu ta podstawowa funkcja staje się jedynym miejscem wyboru lokalizacji, co zapewnia spójność wszystkich dalszych wywołań.
Jak kierować żądania przez proxy targetowane na kraj?
Kierujesz ruch przez proxy targetowane na kraj, wskazując w requests pojedynczą bramę i kodując kraj docelowy w nazwie użytkownika proxy. W DataImpulse brama to gw.dataimpulse.com:823, a dodanie __cr.us lub __cr.de do nazwy użytkownika wybiera kraj wyjściowy. Targetowanie na kraj jest wliczone w cenę bazową, natomiast targetowanie na stan, miasto, ZIP i ASN to płatne dodatki. Jeśli uwierzytelnianie proxy jest dla Ciebie nowe, nasz przewodnik o uwierzytelnianiu proxy szczegółowo omawia mechanikę nazwy użytkownika i hasła.
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
Kluczowa zasada to zmienianie kraju proxy oraz pary gl/hl jednocześnie. Aby utworzyć porównanie cen między rynkami, iteruj po liście krajów i utrzymuj wyjściowe IP oraz lokalizację w ścisłej zgodności, aby każda odpowiedź odzwierciedlała jedną spójną lokalizację kupującego.
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse dostarcza warstwę IP, a nie zarządzaną usługę scrapowania, więc sam odpowiadasz za scraper. Rotujące residential proxy zwykle sprawdzają się tutaj, ponieważ pochodzą z prawdziwych urządzeń konsumenckich; datacenter proxy są tańsze, ale łatwiej je oznaczyć, a mobile proxy zapewniają IP klasy operatorskiej dla najtrudniejszych celów.
Jak parsować karty produktów Google Shopping?
Karty produktów parsujesz tolerancyjną biblioteką HTML, opierając się na stabilnych wzorcach tekstu zamiast kruchych, głębokich selektorów, ponieważ nazwy klas Google są zaciemnione i często się zmieniają. Każdy selektor skopiowany dziś z narzędzi deweloperskich przeglądarki może przestać działać w ciągu tygodni, więc zbuduj parser tak, aby degradował się łagodnie, zamiast kończyć działanie przy zmianie układu.
Solidne podejście odczytuje każdą kandydującą kartę, pobiera tytuł i obraz ze struktury tagów oraz wyodrębnia cenę wyrażeniem regularnym uwzględniającym walutę. Selektory poniżej są realistycznymi przykładami, a nie gwarancją; spodziewaj się ich aktualizacji i zachowaj regex jako niezawodny mechanizm awaryjny.
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
Ponieważ zaciemniony markup jest tu normą, niektóre zespoły wybierają renderowany DOM. Szersze omówienie kompromisów między parsowaniem statycznego HTML a renderowanymi stronami znajdziesz w naszym przewodniku po scrapowaniu dynamicznych stron internetowych.
Jak stosować paginację i backoff, gdy Google zwraca 429?
Stosujesz paginację, zwiększając przesunięcie start krokami odpowiadającymi rozmiarowi strony, a limity przetrwasz, traktując HTTP 429 (oraz puste odpowiedzi lub CAPTCHA) jako sygnał do oczekiwania i ponowienia przez świeże IP. Google agresywnie ogranicza powtarzane automatyczne żądania, więc paginacja i backoff powinny należeć do tej samej pętli.
Przechodź strony, aż żądanie nie zwróci kart lub osiągniesz limit stron. Rotuj wyjściowe IP między stronami, ponownie pobierając słownik proxy, i wykrywaj miękkie blokady przez sprawdzanie znaczników zgody lub CAPTCHA w treści zamiast ufania wyłącznie kodowi statusu.
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
Poniższa funkcja pomocnicza ponawiania używa wykładniczego backoff z jitterem, który rozprasza ponowienia, aby grupa zablokowanych workerów nie próbowała ponownie w tej samej chwili. Każda próba ponownie pobiera słownik proxy, więc rotująca pula przekazuje Ci nowe IP przy kolejnej próbie.
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
Utrzymuj rozsądną częstotliwość żądań nawet wtedy, gdy ponowienia się udają. Uprzejme bazowe opóźnienie między stronami połączone z rotacją daje więcej długoterminowej stabilności niż zasypywanie żądaniami i poleganie na ponowieniach. Nasze uwagi o dobrych praktykach web scraping szerzej omawiają tempo i higienę nagłówków.
Jak renderować zablokowane strony w przeglądarce headless?
Gdy zwykłe żądanie HTTP stale trafia na ściany zgody lub treść renderowaną przez JavaScript, użyj przeglądarki headless, która wykonuje stronę jak prawdziwy klient, i zamknij okno zgody przed odczytaniem DOM. Playwright sprawdza się dobrze, ponieważ obsługuje proxy per kontekst i niezawodne oczekiwanie.
Poniższy skrypt uruchamia Chromium przez proxy DataImpulse targetowane na kraj, obsługuje okno cookie lub zgody zwykle wyświetlane w europejskich lokalizacjach, czeka na treść i zwraca wyrenderowany HTML, abyś mógł przekazać go do tej samej funkcji parse_cards.
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
Przeglądarka headless bardziej obciąża CPU i pamięć niż surowe żądanie, dlatego używaj jej jako ukierunkowanej alternatywy dla stron, które faktycznie wymagają renderowania, a nie jako ścieżki domyślnej. Wiele zespołów używa bezpośredniego HTTP dla szybkości i przechodzi do Playwright dopiero, gdy is_blocked wciąż zwraca blokady. Jeśli Twój stack to JavaScript, a nie Python, ten sam wzorzec działa z Puppeteer; zobacz web scraping z JavaScript.
Jak strukturyzować i eksportować zebrane dane?
Strukturyzujesz dane wokół stabilnego rekordu, który zawsze zawiera rynek i znacznik czasu pobrania, a następnie eksportujesz do CSV, aby wynik łatwo porównywać, ładować do arkusza kalkulacyjnego lub przesyłać do hurtowni. Dataclass zapewnia podpowiedzi typów i jedną jasną definicję wiersza.
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
Zapis CSV polega następnie na wyeksportowaniu pól dataclass. Tryb dopisywania wraz z ochroną nagłówka pozwala zadaniu harmonogramu rozbudowywać jeden plik z czasem bez jego przepisywania.
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
Zachowanie kraju i znacznika czasu w każdym wierszu pozwala później odpowiedzieć na pytania, na którym rynku SKU jest dziś najtańsze lub jak zmieniła się cena w tym tygodniu. Ten klucz geografii i czasu jest podstawą śledzenia historii cen w następnej sekcji.
Jak śledzić historię cen Google Shopping w czasie?
Śledzisz historię cen, wykonując upsert każdej obserwacji do małej bazy danych z kluczem produktu, kraju i dnia, dzięki czemu ponowne uruchomienie scrapera aktualizuje dzisiejszy wiersz zamiast go duplikować, zachowując wcześniejsze dni. SQLite wystarcza na miliony wierszy i nie potrzebuje serwera, co sprawia, że zadanie monitorowania jest samowystarczalne.
Poniższy schemat używa złożonego unikalnego klucza oraz ON CONFLICT upsert. Dwukrotne uruchomienie scrapera jednego dnia nadpisuje najnowszą cenę dla (produktu, kraju, dnia); uruchamianie go w kolejnych dniach tworzy serię czasową, którą możesz później przedstawić na wykresie.
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
Dopasowywanie tytułów między dniami jest w praktyce trudne, ponieważ tytuły Google nieznacznie różnią się między pobraniami. Dla małej listy obserwowanych produktów mapuj surowe tytuły na kontrolowany przez Ciebie kanoniczny id produktu przed upsert, zamiast ufać scrapowanemu tytułowi jako stabilnemu kluczowi.
Jak zaplanować ciągłe monitorowanie cen?
Planujesz monitorowanie, zamykając kroki pobierania, parsowania i zapisu w jednym punkcie wejścia oraz uruchamiając je w stałym cyklu przez cron, dzięki czemu ceny odświeżają się automatycznie bez ręcznych uruchomień. Uruchomienie raz dziennie jest rozsądnym domyślnym wyborem dla śledzenia cen; częstsze uruchomienia podnoszą zarówno koszt, jak i ryzyko blokady, nie dodając wielu sygnałów dla większości katalogów.
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
Następnie zarejestruj je w cron. Wpis poniżej uruchamia monitor codziennie o 06:15 i zapisuje wynik do debugowania, co ma znaczenie, ponieważ scraper działający według harmonogramu w przeciwnym razie kończy się błędem bez komunikatu.
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
Dodaj lekki jitter w zadaniu (losowe uśpienie na kilka minut na początku), aby żądania nie trafiały do Google codziennie dokładnie w tej samej sekundzie. Rotuj kraje wyjściowe i ustalaj tempo żądań zgodnie z wcześniejszym opisem oraz obserwuj log pod kątem rosnącej liczby blokad, co jest najwcześniejszym sygnałem, że Google zmieniło obronę albo Twoje wzorce stały się zbyt regularne.
Które podejście do zbierania danych wybrać: DIY, ukryte endpointy, SERP API czy headless?
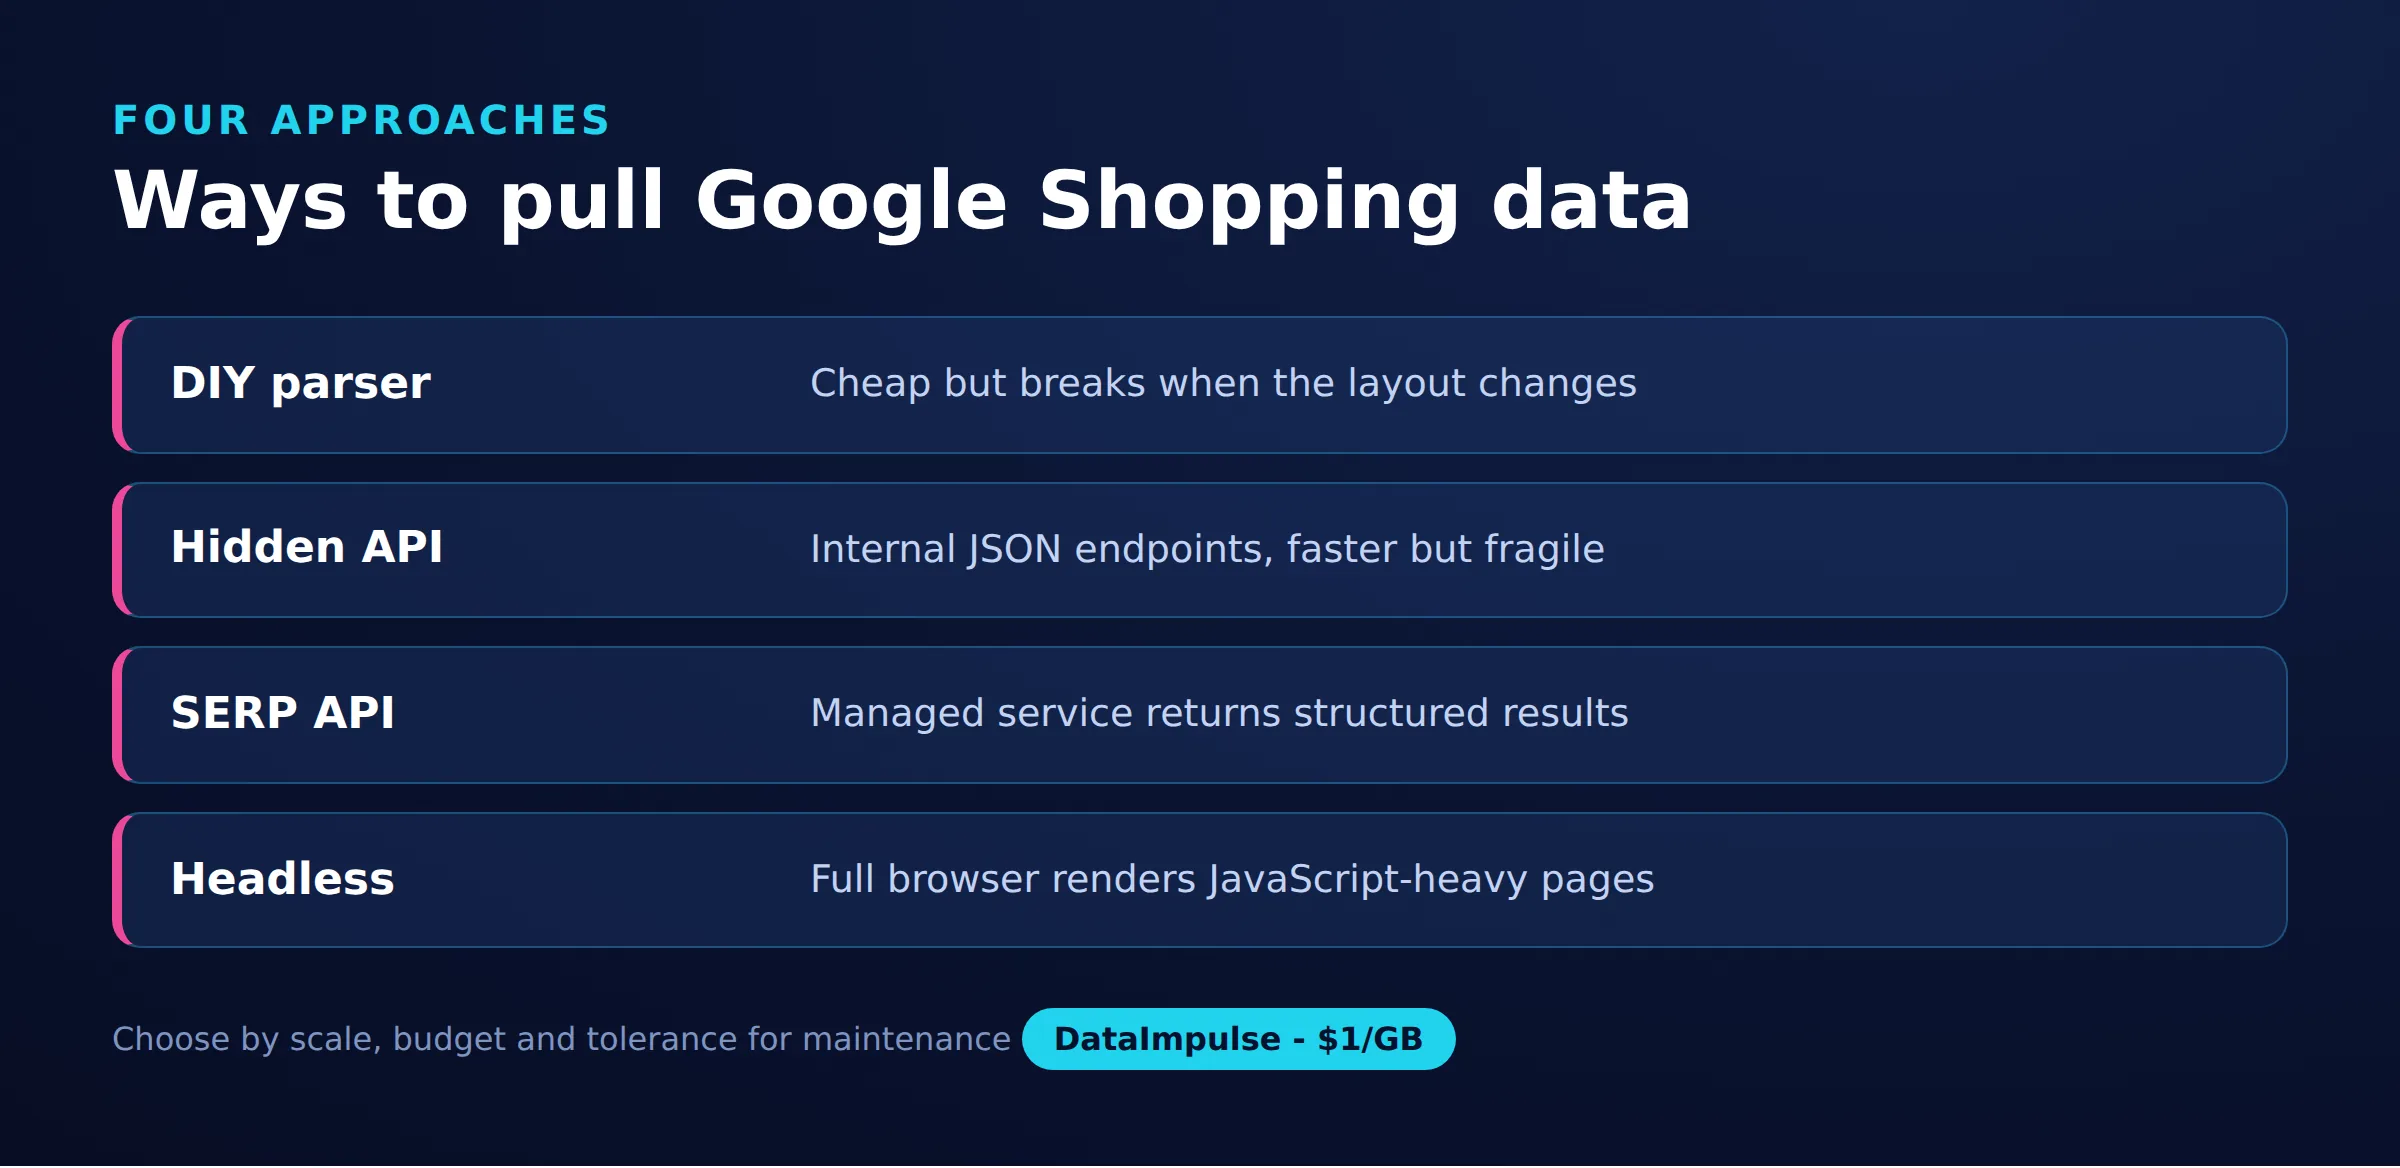
Wybierz w zależności od tego, jak dużą kruchość rozwiązania i pracę inżynieryjną chcesz wziąć na siebie oraz ile chcesz płacić za żądanie. Nie ma jednej właściwej odpowiedzi; uczciwy kompromis to kontrola i koszt wobec obciążenia utrzymaniem oraz narażenia na systemy anti-bot.
Realia anti-bot: Google aktywnie broni tych wyników limitami, CAPTCHA, ścianami zgody, rotującym zaciemnionym markupem i sygnałami behawioralnymi. Każdy scraper własnej budowy będzie okresowo przestawał działać i wymaga stałego utrzymania. Proxy i backoff ograniczają blokady, ale ich nie eliminują. Każdy, kto obiecuje trwale nieblokowalny scraper Google, przesadza.
| Podejście | Koszt | Kruchość | Kontrola |
|---|---|---|---|
| Parsowanie HTML DIY | Niski (tylko proxy) | Wysoka | Pełna |
| Ukryte endpointy JSON | Niski (tylko proxy) | Bardzo wysoka | Pełna |
| SERP API | Wysoki (za żądanie) | Niska | Ograniczona |
| Przeglądarka headless | Średni (obliczenia + proxy) | Średnia | Pełna |
SERP API a DIY: Zewnętrzne SERP API zwraca sparsowane wyniki zakupowe jako JSON i przejmuje za Ciebie pracę parsowania oraz omijania blokad, za cenę za żądanie, uzależnienie od dostawcy i mniejszą kontrolę nad tym, co dokładnie jest pobierane. Scraper własnej budowy na proxy kosztuje znacznie mniej za żądanie i daje pełną kontrolę, ale odpowiadasz za parser, ponowienia i utrzymanie, gdy Google wprowadza zmiany. Dla jasności, gdzie pasuje DataImpulse: jest to warstwa proxy pod każdym z tych podejść DIY, a nie SERP API ani zarządzana usługa scrapowania. Jeśli chcesz uniknąć pracy przy parsowaniu, SERP API jest uczciwą rekomendacją; jeśli zależy Ci na niskim koszcie i kontroli, a możesz utrzymywać scraper, DIY na rotujących proxy ma lepszą ekonomię. Ukryte endpointy JSON mogą być jeszcze tańsze, ale są najbardziej kruche ze wszystkich, ponieważ Google może je zmienić lub usunąć bez uprzedzenia.
Czy scrapowanie Google Shopping jest legalne i etyczne?
Scrapowanie publicznie widocznych danych o produktach jest zazwyczaj traktowane jako mniej ryzykowne niż dostęp do treści prywatnych lub ograniczonych, ale nie jest wolne od zasad, a ten tekst nie stanowi porady prawnej. Ceny i oferty w Google Shopping są publiczne, jednak sposób ich zbierania i wykorzystania nadal ma znaczenie, dlatego powinieneś potwierdzić swój konkretny przypadek z wykwalifikowanym prawnikiem.
- Warunki korzystania z usługi: automatyczny dostęp może być sprzeczny z warunkami Google, co jest kwestią umowną odrębną od prawa autorskiego lub przepisów o dostępie do systemów komputerowych.
- Dane osobowe: oferty produktów zwykle nie są danymi osobowymi, ale unikaj zbierania nazwisk recenzentów lub innych identyfikatorów i przestrzegaj RODO tam, gdzie ma zastosowanie.
- Częstotliwość i obciążenie: utrzymuj rozsądną liczbę żądań, aby nie pogarszać działania usługi, o którą pytasz.
- Wykorzystanie danych: ponowne wykorzystywanie w całości obrazów lub opisów chronionych prawem autorskim wiąże się z większym ryzykiem niż analizowanie cen jako faktów.
Po stronie zbierania danych etyka zaczyna się od używanych IP. DataImpulse pozyskuje IP od użytkowników, którzy wyrazili zgodę i otrzymują wynagrodzenie, działa zgodnie z RODO oraz oferuje umowę powierzenia przetwarzania danych, co wspiera uzasadniony proces. Pełniejsze omówienie zgody, pozyskiwania i odpowiedzialnej praktyki znajdziesz w naszym przewodniku po etycznym web scraping. Połącz etyczne źródło IP z uprzejmym tempem i wąskim, opartym na faktach wykorzystaniem danych, a utrzymasz niskie zarówno ryzyko prawne, jak i reputacyjne.
Najczęściej zadawane pytania
Czy potrzebuję residential proxy, aby scrapować Google Shopping?
Residential proxy to najpewniejszy wybór, ponieważ korzystają z prawdziwych konsumenckich IP, które wtapiają się w zwykły ruch. Datacenter proxy mogą działać przy niewielkim wolumenie, ale łatwiej są wykrywane i blokowane.
Jak uzyskać lokalne ceny z Google Shopping?
Ustaw parametry gl i hl na kraj i język docelowy oraz skieruj żądanie przez IP proxy w tym samym kraju, używając składni kraju, na przykład nazwy użytkownika kończącej się na __cr.de dla Niemiec. Google odczytuje zarówno parametry, jak i IP żądania, aby zdecydować, które ceny pokazać.
Czy DataImpulse to API do scrapowania Google Shopping?
Nie. DataImpulse zapewnia warstwę proxy (residential, mobile i datacenter IP), a nie zarządzane scrapowanie ani SERP API. Uruchamiasz własny scraper lub narzędzie innej firmy na jego IP.
Dlaczego mój scraper Google Shopping wciąż jest blokowany?
Google ogranicza powtarzane automatyczne żądania z jednego IP i wyświetla CAPTCHA oraz ściany zgody. Rotujące residential proxy, realistyczne nagłówki, wykładniczy backoff przy odpowiedziach 429 i rozsądna częstotliwość żądań znacząco ograniczają blokady, choć żadna metoda nie usuwa ich całkowicie.
Czy użyć SERP API, czy zbudować własny scraper?
SERP API usuwa pracę związaną z parsowaniem i omijaniem blokad przy wyższym koszcie za żądanie i mniejszej kontroli, co odpowiada zespołom, które nie chcą żadnego utrzymania. Scraper własnej budowy na rotujących proxy kosztuje znacznie mniej i daje pełną kontrolę, ale utrzymujesz parser i ponowienia, gdy Google się zmienia.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API scrapowania lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotujących residential, mobile i datacenter proxy do zbierania danych publicznych i uzyskiwania dostępu do treści.
Zacznij scrapować Google Shopping z niezawodnymi proxy
Jeśli jesteś gotów zbierać dane Google Shopping na różnych rynkach, DataImpulse zapewnia rotujące i sticky session residential, mobile oraz datacenter IP z targetowaniem na kraj w cenie, od 1 dolara za GB. Utwórz konto i skieruj swój pierwszy scraper przez czystą pulę IP.