
In this Article
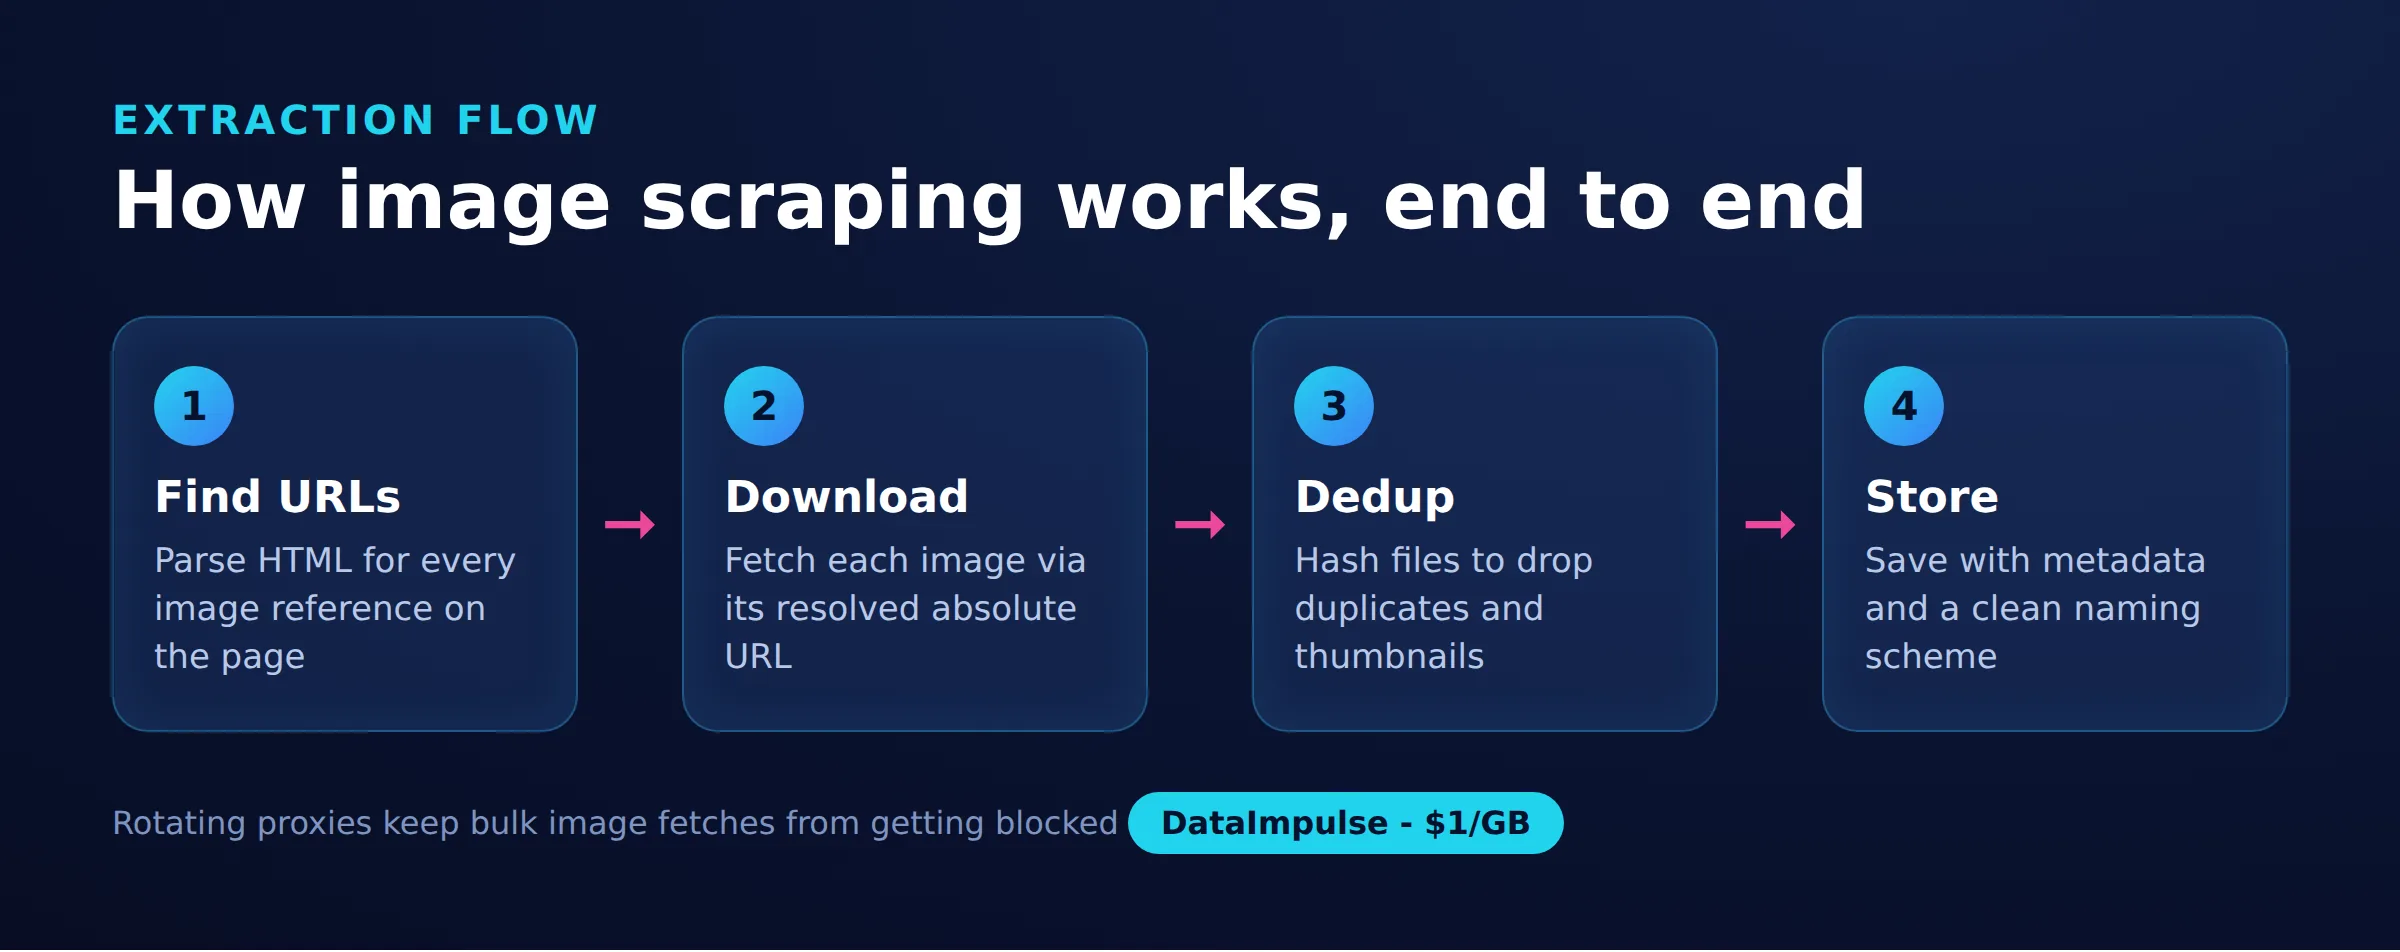
Nauczenie się, jak pobierać obrazy ze strony internetowej, oznacza rozwiązanie dwóch problemów: znalezienie miejsca, w którym znajduje się każde źródło obrazu w kodzie HTML, a następnie pobranie plików binarnych znajdujących się za tymi URL. Ten przewodnik omawia oba etapy pracy z działającym kodem Pythona, omawia trudne przypadki, takie jak wybór zestawu srcset, leniwe ładowanie i tła CSS, a także wyjaśnia, jak zachować się zgodnie z prawami autorskimi i ograniczeniami przepustowości.
Obrazy są cięższe niż tekst, dlatego gromadzenie ich na dużą skalę wymaga planu przechowywania, deduplikacji, współbieżności i kosztów sieci. Wszystko poniżej można uruchomić za pomocą requests, BeautifulSoup i Playwright, a techniki mają zastosowanie do pojedynczej galerii lub dużego katalogu.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP dla klientów indywidualnych, mobilnych i centrów danych w 195 krajach. Wykorzystuje model pay-as-you-go od 1 dolara za GB z niewygasającym ruchem i jest używany do web scraping, ad verification, monitorowania cen, badań rynku i zarządzania wieloma kontami.
Kluczowe fakty
- Kluczowy punkt: Aby zeskrobać obrazy ze strony internetowej, musisz najpierw wyodrębnić każde źródło (img src, srcset, atrybuty danych leniwego ładowania, tła CSS i JSON-LD), a następnie pobrać pliki binarne, ponieważ znaczniki i rzeczywiste pliki obrazów są oddzielnymi requests.
- Najlepszy typ proxy: obrotowe residential proxies, które wykorzystują prawdziwe konsumenckie IP, które przechodzą wykrywanie.
- Cena: od 1 dolara za GB, płatność zgodnie z rzeczywistym użyciem, z niewygasającym ruchem i bez subskrypcji.
- Zasięg: 90 milionów plus etyczne IP w 195 krajach.
- Niezawodność: Wskaźnik sukcesu 99,51%, ocena 4,8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z uwzględnieniem kierowania na kraj.
Gdzie na stronie internetowej znajdują się obrazy URL?
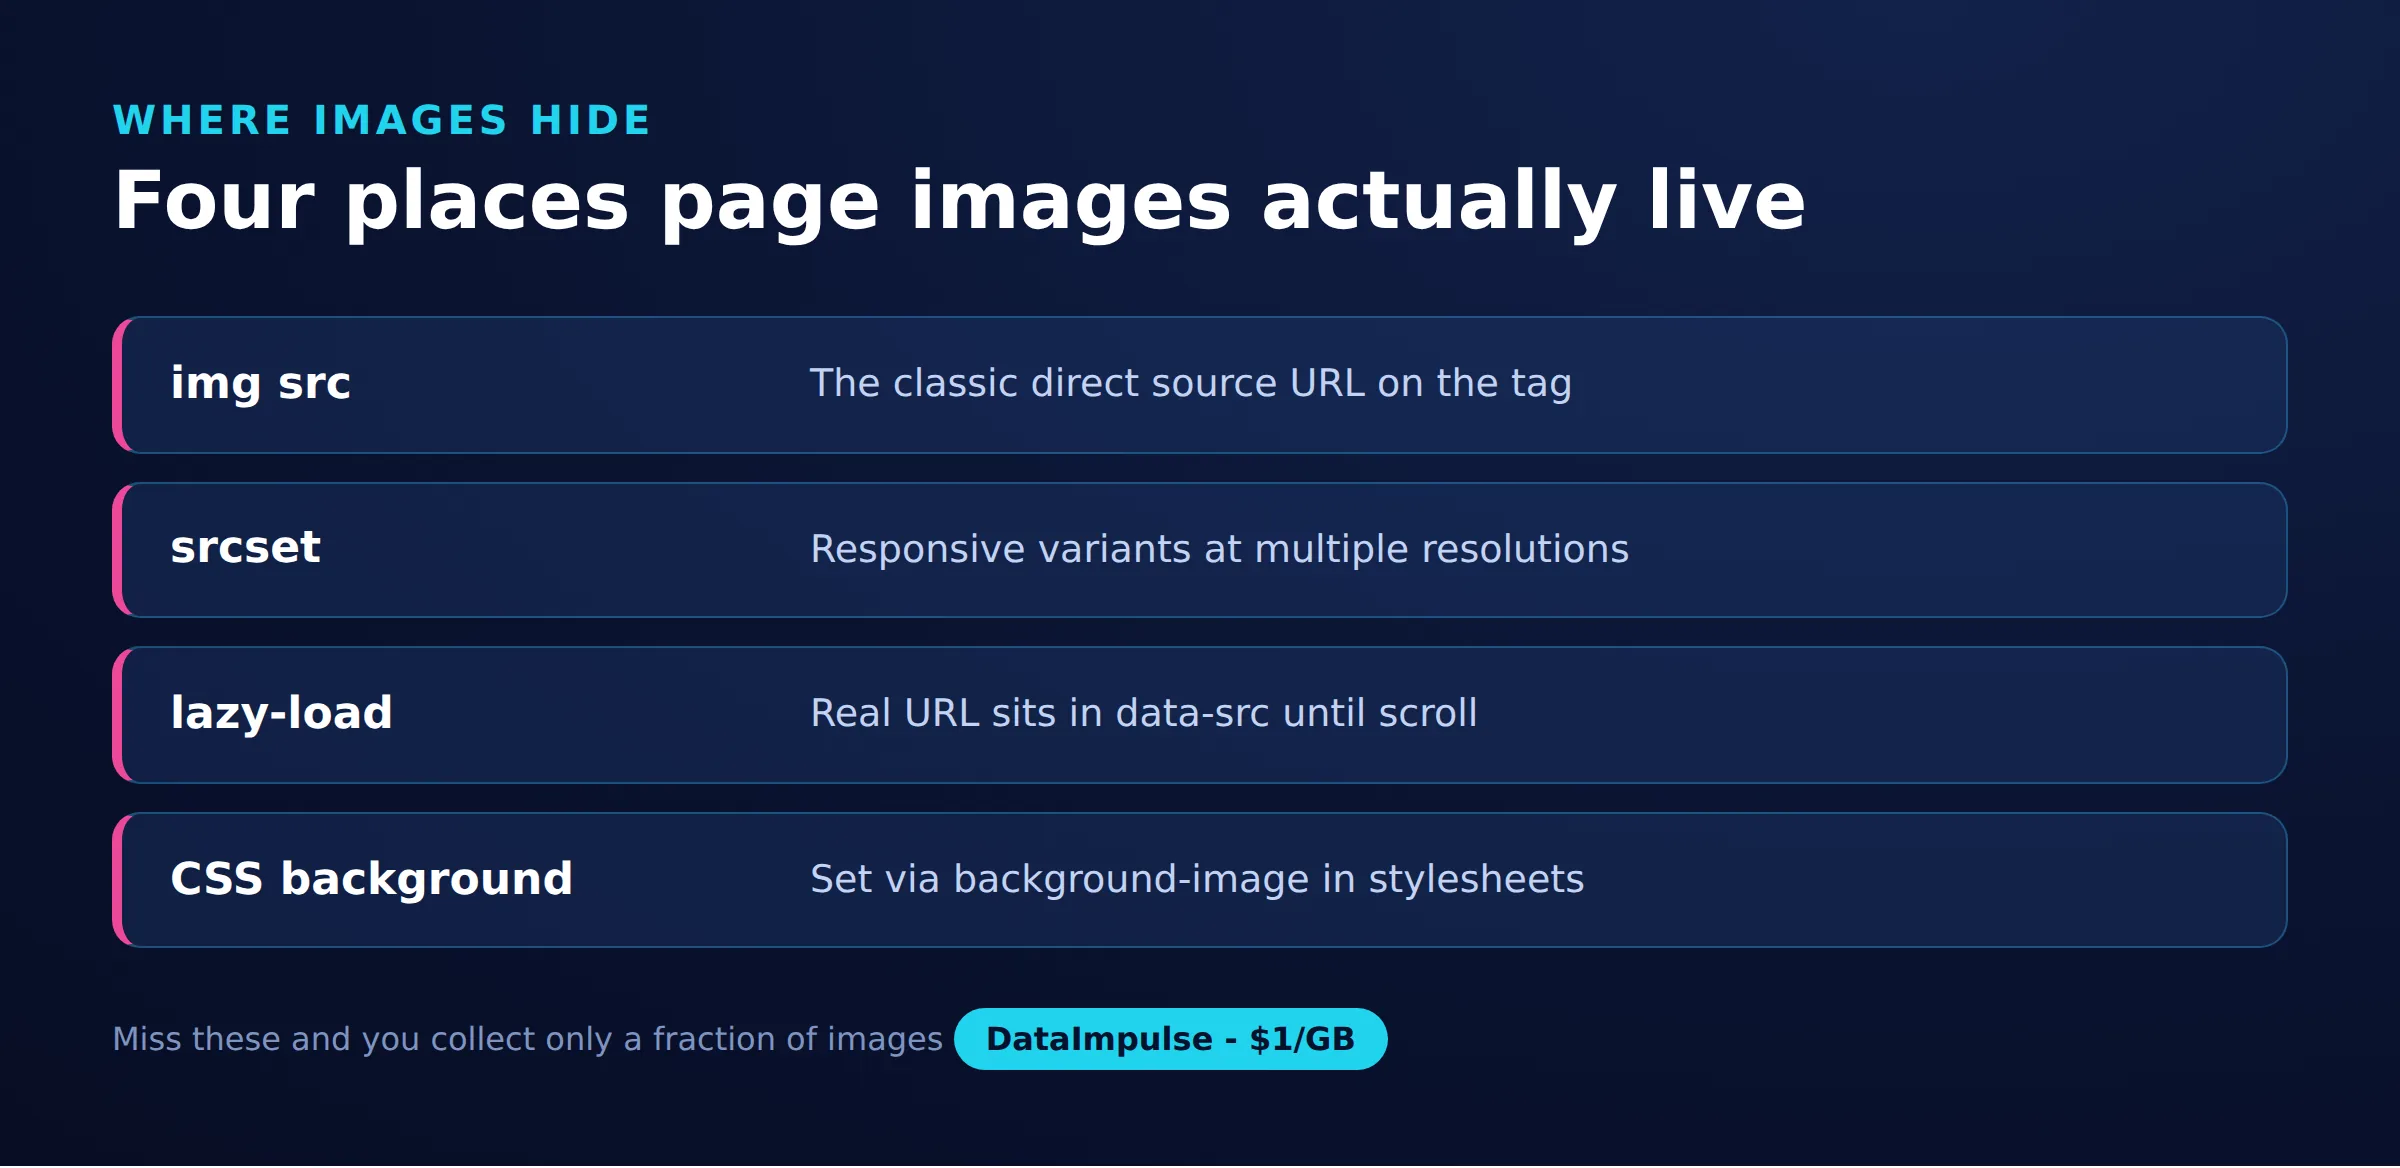
Obraz URL są przechowywane w kilku miejscach, nie tylko src atrybut, więc niezawodny skrobak sprawdza każdy z nich. Strona może odwoływać się do tego samego obrazu za pomocą standardowych tagów, responsywnych atrybutów, leniwie ładujących się symboli zastępczych, arkuszy stylów i danych strukturalnych.
- Standardowe obrazy: the
srcatrybut<img>tag zawiera bezpośredni URL. - Responsywne obrazy: the
srcsetatrybut włączony<img>I<source>wyświetla wiele URL z deskryptorami szerokości lub gęstości, pozwalając przeglądarce wybrać rozmiar. - Obrazy ładowane z opóźnieniem: widzialne
srcjest często małym symbolem zastępczym, podczas gdy prawdziwy URL jest w środkudata-src,data-originallub podobny atrybut niestandardowy, dopóki użytkownik nie przewinie. - Tła CSS: dekoracyjne obrazy są ustawione
background-image: url(...)w stylach wbudowanych lub arkuszach stylów i nigdy nie pojawiają się w plikach<img>w ogóle tagować. - Dane strukturalne: strony produktów i artykułów często zawierają kanoniczny obraz o wysokiej rozdzielczości w bloku JSON-LD.
Ze względu na to rozprzestrzenianie się należy traktować tę stronę jako zbiór potencjalnych źródeł i zbierać informacje ze wszystkich tych lokalizacji przed pobraniem. Poniższa tabela podsumowuje, gdzie znajduje się każde źródło i problem, który uruchamia większość skrobaków.
| Źródło ekstrakcji | Gdzie to znaleźć | Wspólny problem |
|---|---|---|
| img src | src atrybut tagów img | Często symbol zastępczy lub dane: URI na leniwie ładowanych stronach |
| zestaw źródłowy | srcset na znacznikach img i źródłowych | Mieści kilka URL z deskryptorami szerokości; musisz to przeanalizować i wybrać jeden rozmiar |
| Leniwe atrybuty | dane-src, dane-oryginalne, dane-lazy-src, dane-srcset | Nazwy atrybutów różnią się w zależności od platformy, więc sprawdź prawdziwe znaczniki |
| Tło CSS | styl wbudowany i bloki stylu, obraz tła: url() | Nigdy nie pojawia się w tagu img; potrzebuje wyrażenia regularnego w tekście CSS |
| JSON-LD | znacznik skryptu o typie application/ld+json | Pole obrazu może być ciągiem, listą lub obiektem zagnieżdżonym |
Jak skonfigurować skrobak obrazu w języku Python?
Zainstaluj requests dla HTTP, BeautifulSoup do analizowania i lxml jako szybki backend parsera, następnie pobierz stronę i przeczytaj src każdego tagu obrazu. Ten minimalny przykład stanowi podstawę, na której opiera się każdy kolejny krok.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
The Session obiekt utrzymuje połączenia przy życiu i ponownie wykorzystuje nagłówki, co jest szybsze i delikatniejsze na serwerze docelowym niż otwieranie nowego połączenia na żądanie. Zawsze dzwoń urljoin tak, że ścieżki względne lubią /media/photo.jpg rozstrzygnij na absolutne URL, które możesz pobrać później. Jeśli jesteś nowy w szerszym przepływie pracy, web scraping najlepsze praktyki przewodnik bardziej szczegółowo omawia nagłówki, limity czasu i grzeczność.
Jak wyodrębnić źródła img src, srcset i leniwie ładowane?
Analizować srcset dzieląc przecinkami i czytając deskryptor szerokości, aby móc wybrać największy wariant i przeczytać każdy prawdopodobny data- atrybut dla źródeł leniwie ładowanych. Zwykły odczyt atrybutów pomija większość nowoczesnej strony, więc dla każdego formatu potrzebujesz małych pomocników.
The srcset value zawiera kilka URL wraz z deskryptorami takimi jak 800w. Aby uzyskać kopię o najwyższej rozdzielczości, porównaj wartości szerokości i zachowaj największą.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Teraz połącz źródła standardowe, responsywne i leniwe w jeden moduł zbierający. Różne frameworki używają różnych nazw atrybutów, więc sprawdź kilka. Ta sama funkcja również czyta <source> tagi w środku <picture> elementy, które niosą ze sobą swoje srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Pomijanie jakichkolwiek src zaczyna się od data: pozwala uniknąć zapisywania wbudowanych symboli zastępczych base64, które zwykle są miniaturami niskiej jakości, które leniwy moduł ładujący pokazuje przed pojawieniem się prawdziwego obrazu.
Jak znaleźć tło CSS i obrazy JSON-LD?
Użyj wyrażenia regularnego, aby wyciągnąć URL background-image deklaracje i przejdź do dowolnego bloku JSON-LD, aby go przeczytać image pole. Te dwa źródła nigdy nie pojawiają się w pliku <img> tag, więc skrobak, który czyta tylko tagi graficzne, całkowicie je pominie.
Obrazy dekoracyjne i główne są powszechnie ustawiane w CSS. Zeskanuj oba bezpośrednio style atrybuty i <style> bloki dla url(...) wartości.
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Dane strukturalne to najbardziej niezawodne miejsce na znalezienie kanonicznego obrazu w pełnej rozdzielczości na stronach produktów i artykułów. The image wartością może być ciąg znaków, lista lub obiekt zagnieżdżony, dlatego należy przejść przez całe drzewo.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Na przykład połącz trzy kolektory za pomocą złącza zbiorczego collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base)i masz zdeduplikowany zestaw kandydatów URL gotowy do pobrania.
Jak bezpiecznie pobierać pliki obrazów?
Przesyłaj strumieniowo każdą odpowiedź, potwierdź Content-Type nagłówek jest w rzeczywistości obrazem i ogranicza rozmiar, aby pojedynczy plik nie mógł wyczerpać pamięci ani dysku. Pobieranie URL na ślepo wiąże się z ryzykiem zapisania stron błędów HTML, przekierowań lub dużych plików, więc sprawdź poprawność, zanim zachowasz bajty.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Przesyłanie strumieniowe z stream=True I iter_content oznacza, że sprawdzanie nagłówka odbywa się przed pobraniem całej treści, więc błędnie oznakowane łącze jest wcześniej odrzucane. Sprawdzanie raportowanego typu wychwytuje typowy przypadek, w którym uszkodzony URL zwraca stronę HTML 404 ze statusem 200. Dla dodatkowego bezpieczeństwa możesz także zweryfikować pierwsze magiczne bajty ładunku, ale sprawdzenie nagłówka i ograniczenie rozmiaru radzą sobie z większością skrobań w świecie rzeczywistym.
Jak deduplikować i nazywać pobrane obrazy?
Zaszyfruj pobrane bajty za pomocą SHA-256 i pomiń wszelkie zapisane już skróty, a następnie oczyść nazwę pliku i pliki fragmentów do podfolderów według przedrostka skrótu. Witryny często udostępniają ten sam obraz z wielu ścieżek, sieci CDN lub wariantów rozmiaru, więc skrót treści jest bardziej niezawodny niż porównywanie wartości URL.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Oczyszczenie nazwy bazowej usuwa znaki przechodzenia ścieżki i niepotrzebne ciągi zapytań, więc złośliwy lub niechlujny URL nie może pisać poza folderem docelowym. Dzielenie na fragmenty za pomocą pierwszych dwóch znaków skrótu pozwala zachować mały rozmiar katalogów, co ma znaczenie, gdy zbierzesz dziesiątki tysięcy plików. W celu wykrycia niemal duplikatów, na przykład tego samego zdjęcia w różnych rozdzielczościach, percepcyjna biblioteka skrótów, taka jak imagehash, grupuje wizualnie podobne pliki, które skróty bajtowe traktują jako odrębne.
Jak pobrać wiele obrazów jednocześnie?
Użyj ThreadPoolExecutor aby pobrać kilka obrazów na raz i dodać współdzielony ogranicznik szybkości, aby wszystkie wątki razem pozostały poniżej pułapu requests na sekundę. Pobieranie obrazów jest powiązane z operacjami we/wy, więc wątki zapewniają duże przyspieszenie, ale nieograniczona współbieżność uderzy w cel i spowoduje zablokowanie.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
Zamek dookoła seen sprawia, że deduplikacja jest bezpieczna dla wątków, a opakowanie każdego zadania w bloku try oznacza, że jeden zły URL nie zatrzymuje całego przebiegu. Utrzymuj skromną szybkość, garść requests na sekundę to rozsądna wartość domyślna i przeczytaj etyczne web scraping przewodnik dotyczący wybierania limitów uwzględniających witrynę.
Jak zeskrobywać obrazy na dużą skalę za pomocą serwerów proxy?
Potrzebujesz serwerów proxy, gdy cel zacznie ograniczać prędkość lub blokować Twój IP, co dzieje się szybko w przypadku pobierania wielu obrazów z jednego adresu. Przekaż proxies słownik na każde żądanie, dzięki czemu ta sama pętla pobierania prowadzi przez obrotowe urządzenia IP. Stały strumień obrazu requests z pojedynczego IP jest oczywistym zautomatyzowanym wzorcem, a obrazy są duże, więc prawdziwym ograniczeniem jest zazwyczaj przepustowość.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Rotacyjne serwery proxy rozprzestrzeniają requests na wiele IP, więc żaden pojedynczy adres nie przyciąga uwagi, podczas gdy sticky session przechowują jeden IP dla galerii, którą witryna powiązuje z sesją. DataImpulse zapewnia residential proxies I mobile proxies dla celów, które dokładnie monitorują ruch, plus datacenter proxies w przypadku dużych pobrań z tolerancyjnych źródeł. Wszystkie IP pochodzą od użytkowników, którzy wyrazili na to zgodę i otrzymują wynagrodzenie w sposób etyczny. Jeśli Twoje dane uwierzytelniające zostaną odrzucone z błędem 407, plik uwierzytelnianie proxy przewodnik opisuje dokładny format logowania.
Ponieważ każdy pobrany bajt wlicza się do budżetu ruchu, przed rozpoczęciem zaplanuj rozmiar: pomiń obrazy poniżej progu, jeśli chcesz tylko głównej treści, poproś o mniejszy srcset wariant, gdy nie jest potrzebna pełna rozdzielczość, i buforuj to, co już masz, aby ponowne uruchomienie nie spowodowało ponownego pobrania wszystkiego. DataImpulse korzysta z rozliczeń typu pay-as-you-go od 1 dolara za GB przy niewygasającym ruchu, więc duże, ale okazjonalne zadanie przetwarzania obrazu nie wymaga miesięcznej subskrypcji, a niewykorzystany ruch jest przenoszony.
Jak zeskrobać galerie renderowane w JavaScript?
Jeśli witryna tworzy swoją galerię w całości w JavaScript, obraz URL nigdy nie pojawia się w nieprzetworzonym kodzie HTML, dlatego najpierw wyrenderuj stronę za pomocą Playwright i przekaż wynik tym samym modułom zbierającym. Same żądania nie mogą wykonywać skryptów, dlatego galerie jednostronicowe i z nieskończonym przewijaniem wymagają prawdziwej przeglądarki, aby uruchomić ładowanie.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Przewijanie pętli zmusza leniwy moduł ładujący do zamiany jej data-src symbole zastępcze dla prawdziwych URL, po czym zbierają je te same parsery, które już napisałeś. Więcej informacji na temat renderowania bezgłowego można znaleźć w artykule skrobanie dynamicznych stron internetowych.
Na koniec napisz manifest CSV, aby każdy pobrany plik mógł zostać prześledzony aż do źródła URL, skrótu i rozmiaru. Manifest zamienia folder anonimowych plików w zbiór danych, który można kontrolować, wznawiać i deduplikować w różnych uruchomieniach.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Po umieszczeniu manifestu możesz ponownie uruchomić zadanie i pominąć wszelkie już zarejestrowane URL, co oszczędza przepustowość i zapewnia spójność zestawu danych w czasie.
Czy pobieranie i ponowne wykorzystywanie obrazów ze strony internetowej jest legalne?
Pobieranie pliku obrazu jest czynnością techniczną; nie przyznaje Ci żadnej licencji na ponowne wykorzystanie tego obrazu. Jest to najbardziej źle rozumiana część skrobania obrazu, więc traktuj ją ostrożnie. Prawie każde zdjęcie, ilustracja i grafika w Internecie są chronione prawem autorskim od chwili ich utworzenia, a osoba, która je wykonała, posiada te prawa, chyba że wyraźnie je udostępniła.
Możliwość pobrania pliku nie mówi nic o Twoim prawie do jego ponownej publikacji, sprzedaży, trenowania lub redystrybucji. Przed ponownym wykorzystaniem zeskrobanych obrazów sprawdź dołączone do nich warunki licencji, poszukaj określonej licencji, takiej jak Creative Commons lub domena publiczna, i uzyskaj pisemną zgodę, jeśli wykorzystanie ma charakter komercyjny. Gromadzenie obrazów do prywatnej analizy, indeksowania lub badań to inna sprawa niż ich publikowanie, a bezpiecznym rozwiązaniem domyślnym jest założenie, że obraz jest chroniony, chyba że licencja wyraźnie stanowi inaczej.
Przed rozpoczęciem przejrzyj także warunki korzystania z usługi witryny docelowej i plik robots.txt. The sprawdź, czy witryna umożliwia scrapowanie przewodnik pokazuje, jak odczytać te sygnały, a skrobanie bez blokowania się przewodnik omawia pełne szacunku praktyki pełzania. Żadna z technik opisanych w tym artykule nie zmienia podstawowej zasady: dostęp nie jest licencją, a uczciwe stanowisko jest takie, że działający skrobak i prawo do ponownego użycia to dwie odrębne rzeczy, które musisz spełnić niezależnie.
Często zadawane pytania
Czy mogę pobierać obrazy z dowolnej witryny internetowej?
Technicznie rzecz biorąc, możesz pobierać pliki z większości witryn, ale najpierw powinieneś sprawdzić warunki korzystania z danej witryny oraz plik robots.txt i pamiętać, że pobranie obrazu nie daje prawa do jego ponownego wykorzystania. Dostęp nie jest licencją.
Dlaczego niektóre obrazy nie pojawiają się w pobieranym formacie HTML?
Obrazy te są zwykle ładowane przez JavaScript lub ładowanie z opóźnieniem, więc ich prawdziwe URL znajdują się w atrybutach danych lub są dodawane po wyrenderowaniu strony. Wyrenderuj stronę za pomocą przeglądarki bezobsługowej, takiej jak Playwright, i przewiń, aby uruchomić ładowanie, a następnie przeanalizuj wynik.
Jak wybrać wersję obrazu w najwyższej rozdzielczości?
Przeanalizuj atrybut srcset, przeczytaj deskryptor szerokości po każdym URL i zachowaj URL o największej szerokości. Na stronach produktów często znajduje się również obraz w pełnej rozdzielczości w bloku JSON-LD.
Jak uniknąć dwukrotnego pobierania tego samego obrazu?
Oblicz skrót SHA-256 każdego pobranego pliku i pomiń wszelkie skróty, które już zapisałeś. W przypadku wizualnie podobnych kopii w różnych rozmiarach użyj zamiast tego percepcyjnej biblioteki skrótów, takiej jak imagehash.
Czy DataImpulse oferuje zarządzane skrobanie obrazów API?
Nie. DataImpulse zapewnia proxy, przez które możesz poprowadzić swój własny skrobak; nie jest to zarządzane skrobanie API ani bezpłatna usługa serwera proxy. Piszesz logikę pobierania i używasz jej IP do dostępu i rotacji.
Kiedy DataImpulse nie jest właściwym rozwiązaniem?
Jeśli potrzebujesz statycznych serwerów proxy ISP, w pełni zarządzanego skrobania API lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych rozwiązaniach mieszkaniowych, mobilnych i datacenter proxies do gromadzenia danych publicznych i uzyskiwania dostępu do treści.
Zacznij skrobać obrazy na dużą skalę
Gdy Twój skrobak obrazów potrzebuje niezawodnego dostępu i rotacji IP bez subskrypcji, DataImpulse oferuje etyczne źródła mieszkaniowe, mobilne i datacenter proxies z ruchem płatnym zgodnie z rzeczywistym użyciem od 1 dolara za GB. Utwórz konto i przeprowadź przez niego pętlę pobierania w ciągu kilku minut.