
In diesem Artikel
Um curl in Python umzuwandeln, überträgst du URL, Methode, Header und Body des Befehls in einen Requests-Aufruf und vergleichst dann, was der Server tatsächlich empfängt. Beginne mit dem gepaarten Beispiel unten und lege das Weiterleitungsverhalten ausdrücklich fest.
Eine erfolgreiche Antwort allein beweist noch keine Gleichwertigkeit. In unserem Localhost-Test haben sich bei einfachen Übersetzungen JSON-Bytes, Formularkodierung und Weiterleitungsverhalten verändert, obwohl der Code korrekt aussah.
Wichtige Fakten
- Unser Localhost-Snapshot umfasste sechs Fixtures, die pro Client jeweils dreimal wiederholt wurden.
- Der Test umfasste 36 initiale Client-Ausführungen, ohne die Folgeanfragen bei Weiterleitungen.
- Das Fixture mit wiederholten Query-Parametern behielt Reihenfolge und doppelte Schlüssel bei.
- Das JSON-Fixture behielt die Daten bei, veränderte aber die Body-Bytes.
- Das Formular-Fixture machte aus einem Leerzeichen ein Pluszeichen.
- Das Weiterleitungs-Fixture erzeugte mit curl eine Anfrage und mit Requests zwei.
Wie wandelst du curl mit Requests in Python um?
Übersetze jeweils eine Anfrage und halte Ziel und Eingaben sichtbar. Dieses GET-Beispiel sendet wiederholte Query-Parameter und einen eigenen Header an einen öffentlichen Echo-Endpunkt; verwende dort ausschließlich synthetische Daten.
python -m pip install requests
curl --silent --show-error 'https://httpbin.org/get?tag=a&tag=b&page=2' -H 'X-Test: 1'
import requests
response = requests.get(
'https://httpbin.org/get',
params=[('tag', 'a'), ('tag', 'b'), ('page', '2')],
headers={'X-Test': '1'},
allow_redirects=False,
timeout=(5, 20),
)
response.raise_for_status()
print(response.status_code)
print(response.json()['args'])Antwortet der Endpunkt normal, erwartest du den Status 200 und Argumente, die {'page': '2', 'tag': ['a', 'b']} entsprechen. Die Anzeigereihenfolge des Dictionarys spielt hier keine Rolle, die wiederholten Werte dagegen schon.
Der Requests Quickstart dokumentiert Query-Parameter, Header und die Verarbeitung von Antworten. Ersetze für deinen eigenen Endpunkt zuerst die URL und ändere dann jeweils nur eine Eingabe, damit sich Fehler leicht eingrenzen lassen.
Welche Zuordnungen von curl-Flags zu Python sind am wichtigsten?
Ordne die Bedeutung der Anfrage zu, nicht nur die Schreibweise der Flags. Das curl-Handbuch und die Requests-API-Referenz beschreiben die Optionen hinter dieser Checkliste für die Umwandlung.
| curl-Eingabe | Requests-Entsprechung | Prüfpunkt |
|---|---|---|
| -X POST | requests.post(…) oder request(‘POST’, …) | Prüfe die tatsächliche Methode, auch solche, die sich durch Body-Optionen ergeben. |
| URL-Query oder -G | params= | Behalte doppelte Schlüssel und die Reihenfolge bei, wo es nötig ist. |
| -H | headers= | Erhalte die erforderlichen Werte. |
| -b ‘name=value’ | cookies= | Eine Cookie-Datei erfordert eine gesonderte Behandlung. |
| -u für Basic-Authentifizierung | auth=(username, password) | Gehe nicht davon aus, dass jedes Authentifizierungsverfahren Basic ist. |
| Authorization: Bearer-Header | headers={‘Authorization’: …} | Lies das Token aus einer geheimen Quelle. |
| -d oder –data-raw | data= oder json= | Wähle je nach Body-Format und Byte-Anforderungen. |
| -F | files=, optional data= | Prüfe Dateinamen und Feldnamen. |
| -L | allow_redirects=True | Lege die Weiterleitungsregel ausdrücklich fest. |
| -x | proxies= | Erhalte das Proxy-Schema und das Routing. |
Die Übersetzung von Flags ist nicht durchgängig eins zu eins. Behandle ungewöhnliche Optionen zu Signaturen, Zertifikaten, DNS und Protokollen als eigene Prüfpunkte. Nutze unseren curl-Header-Leitfaden, um herauszufinden, welche Header des Originals wichtig sind.
Wie bewahrst du JSON, Formulare und Datei-Uploads korrekt?
Verwende json= für strukturiertes JSON, data= für Formularfelder oder exakte Body-Bytes und files= für Multipart-Uploads. Diese Schnittstellen sind in den Requests-Beispielen zu Body und Uploads dokumentiert.
Ein POST kann ebenfalls Query-Parameter enthalten. Dieses Beispiel hält die Query getrennt vom JSON-Body und liest ein Bearer-Token aus der Umgebung. Setze API_URL auf deinen autorisierten Endpunkt und API_TOKEN über deinen üblichen Mechanismus für Geheimnisse, bevor du es ausführst.
import os
import requests

response = requests.post(
    os.environ['API_URL'],
    params=[('mode', 'validate')],
    headers={'Authorization': 'Bearer ' + os.environ['API_TOKEN']},
    json={'name': 'a', 'n': 1},
    allow_redirects=False,
    timeout=(5, 20),
)
response.raise_for_status()
print(response.status_code)
Bei signierten Bodys serialisierst du einmal und signierst genau die Bytes, die du sendest. Unser JSON-Fixture hat bei der Übersetzung die Leerzeichen verändert. Eine kompakte Serialisierung reproduziert den ursprünglichen Body dieses Fixtures, kann aber beliebige ursprüngliche Leerzeichen oder die Schlüsselreihenfolge nicht rekonstruieren.
import json
import os
import requests

body = json.dumps({'name': 'a', 'n': 1}, separators=(',', ':')).encode('utf-8')
response = requests.post(
    os.environ['API_URL'],
    data=body,
    headers={'Content-Type': 'application/json'},
    allow_redirects=False,
    timeout=(5, 20),
)
response.raise_for_status()
Für wiederholte Formularfelder verwendest du data=[('k', '1'), ('k', '2'), ('x', 'a b')]. In unserem Test wurde das Leerzeichen dabei als + kodiert, während die literale -d-Eingabe von curl ein Leerzeichen beibehielt. Die curl-Option –data-urlencode kodiert Feldwerte, aber eine gleichwertige Dekodierung belegt noch keine übereinstimmenden Bytes.
Lass bei Uploads den Client die Multipart-Grenze erzeugen. Dieses in sich geschlossene Beispiel verwendet synthetische Dateiinhalte; vergleiche Dateiinhalte und Feldnamen getrennt vom Multipart-Umschlag.
import os
import requests

response = requests.post(
    os.environ['API_URL'],
    data={'label': 'example'},
    files={'file': ('sample.txt', b'hello\n', 'text/plain')},
    allow_redirects=False,
    timeout=(5, 20),
)
response.raise_for_status()
Wie kopierst du eine Browser-Anfrage sicher?
Erfasse nur eine autorisierte Anfrage und entferne Geheimnisse, bevor du sie teilst. Öffne in den Chrome DevTools den Tab Network, klicke mit der rechten Maustaste auf die Anfrage und wähle Copy > Copy as cURL, wie in der Chrome-Network-Referenz dokumentiert.
Prüfe den Text, bevor du etwas ausführst. Das Quoting der Shell gehört zur Syntax des Befehls, nicht unbedingt zur Payload. Prüfe eingebettete Anführungszeichen, Zeilenfortsetzungen und Variablenverweise anhand der Shell, die für die Erfassung verwendet wurde.
Verschiebe Autorisierungs- und Sitzungswerte in einen Speicher für Geheimnisse. Behalte erforderliche Anwendungs-Header bei, prüfe aber erfasste Host-, Content-Length- und browserspezifische Header, bevor du sie übernimmst. Entferne fragwürdige Header einzeln und teste erneut; wenn du alles löschst, bleibt unklar, welcher Wert entscheidend war.
Notiere den Zeitpunkt der Erfassung und den beabsichtigten Vorgang. Eine kopierte Anfrage ist eine Momentaufnahme, daher können ein Sitzungsablauf oder ein veränderter Anwendungszustand sie ungültig machen. Die Übersetzung stellt keine Browser-Emulation dar und reproduziert auch keine gesamte Interaktion.
Wann solltest du einen Konverter oder einen anderen Ansatz nutzen?
Nutze die manuelle Umwandlung für Code, den du pflegen wirst, und einen Konverter für eine erste Übersetzung, die du prüfen kannst. Behalte curl bei, wenn der Erhalt seines Verhaltens wichtiger ist als ein natives Python-HTTP-Client.
| Ansatz | Verwende X, wenn … | Vermeide X, wenn … |
|---|---|---|
| Manuelle Requests-Umwandlung | Verwende die manuelle Requests-Umwandlung, wenn du lesbaren, gepflegten Code brauchst. | Vermeide die manuelle Requests-Umwandlung, wenn ungewöhnliches curl-Verhalten noch nicht zugeordnet ist. |
| curlconverter | Verwende curlconverter, wenn du eine Ausgangsübersetzung möchtest. | Vermeide curlconverter, wenn du den generierten Code nicht prüfen oder Zugangsdaten nicht schützen kannst. |
| curl weiterverwenden über subprocess | Verwende subprocess, wenn das bestehende curl-Verhalten unverzichtbar ist. | Vermeide subprocess, wenn der Inhalt des Befehls nicht vertrauenswürdig ist oder natives Python erforderlich ist. |
Die offizielle curlconverter-Website gibt an, dass die Umwandlung in deinem Browser stattfindet. Diese Aussage gilt für jene Website, nicht für jeden curl-zu-Python-Konverter. Das offizielle Repository dokumentiert diesen CLI-Weg:
npm install --global curlconverter
curlconverter --language python 'https://httpbin.org/get'
Curl aus Python heraus auszuführen ist ein anderer Ansatz. Verwende gemäß der Python-subprocess-Dokumentation eine feste Argumentliste und vermeide die Auswertung durch die Shell. Prüfe dennoch jedes Argument und jedes Ziel.
import subprocess

result = subprocess.run(
    ['curl', '--silent', '--show-error', '--fail',
     '--max-time', '20', 'https://httpbin.org/get'],
    check=True,
    capture_output=True,
    text=True,
    timeout=25,
)
print(result.stdout)
Wie prüfst du, ob die Umwandlung gleichwertig ist?
Nutze den 4-Schichten-Check für Anfragegleichheit, um übereinstimmende Anwendungseingaben von übereinstimmenden Bytes und übereinstimmendem Antwortverhalten zu trennen. Lege fest, welche Eigenschaften dein Endpunkt verlangt, bevor du eine Umwandlung akzeptierst.
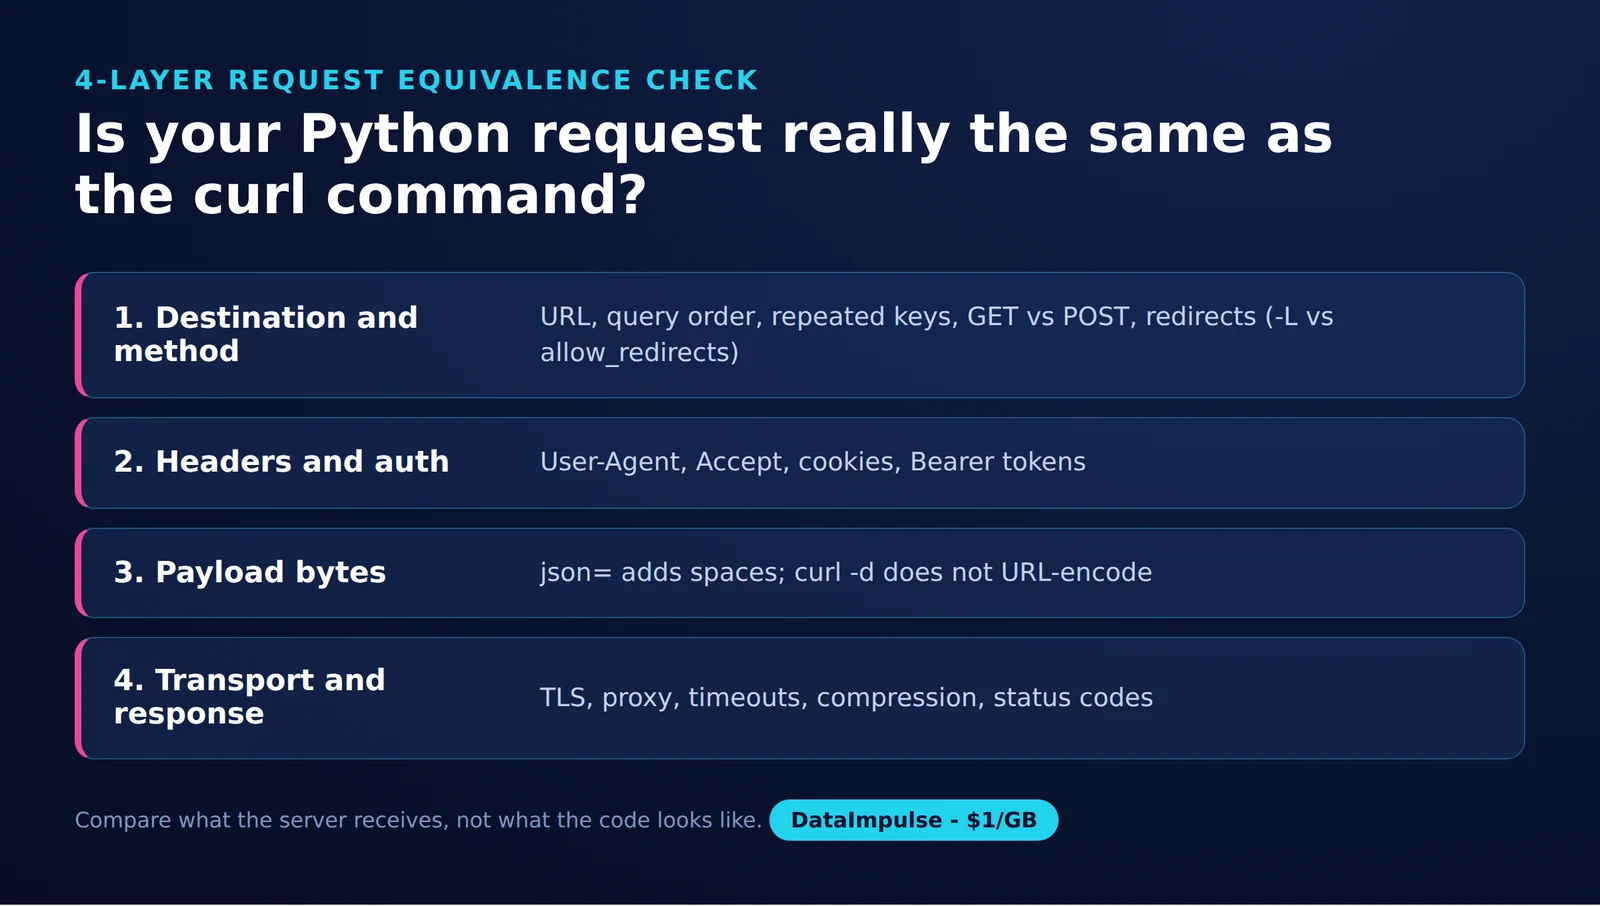
- Schicht 1, Ziel und Methode: Vergleiche Methode, Pfad und geordnete Query-Paare.
- Schicht 2, Header und Authentifizierung: Vergleiche ausgewählte Header-Werte und die Platzierung der Zugangsdaten, ohne Geheimnisse zu protokollieren.
- Schicht 3, Payload: Vergleiche die Länge des rohen Bodys, SHA-256 und die Gleichheit der geparsten Payload.
- Schicht 4, Transport und Antwort: Vergleiche Status, finale URL und Anzahl der Weiterleitungsschritte.
In unserem Test vom 15. Oktober 2026 empfing ein protokollierender HTTP-Server, der an 127.0.0.1 gebunden war, sechs Fixtures, die mit jedem Client dreimal ausgeführt wurden. Das ergibt 36 initiale Ausführungen, wobei die Folgeanfragen bei Weiterleitungen separat zählen. Die Ergebnisse wiederholten sich in allen drei Durchläufen konsistent.
Quelle: DataImpulse, CURL vs PYTHON REQUESTS EQUIVALENCE TEST, 15. Oktober 2026, 16:12 UTC. Die Linux-Umgebung nutzte curl 8.5.0, Python 3.12.3 und Requests 2.34.2. Dies ist ein Localhost-Snapshot, kein Benchmark.
| Fixture | Semantische Übereinstimmung | Byte-Übereinstimmung | Übereinstimmung bei Weiterleitung | Erklärung |
|---|---|---|---|---|
| Wiederholte Query | Ja | Ja, Query | Nicht geprüft | Tupel-Paare erhielten tag=a, tag=b und page=2. |
| Eigener Header und Cookie | Ja | Ja, ausgewählte Werte | Nicht geprüft | X-Test und das synthetische Cookie stimmten überein. |
| Bearer-Header | Ja | Ja, ausgewählter Wert | Nicht geprüft | Der synthetische Autorisierungswert stimmte überein. |
| JSON-POST | Ja | Nein | Nicht geprüft | Hinzugefügte Leerzeichen veränderten den Hash des Bodys. |
| Wiederholte Formularfelder | Gleiche dekodierte Felder | Nein | Nicht geprüft | Ein Leerzeichen wurde zu +. |
| 302-Weiterleitung | Nur die initiale Anfrage | Für die Kette nicht belegt | Nein | curl stellte eine Anfrage; Requests stellte zwei. |
Die oben genannten Byte-Übereinstimmungen betreffen die benannten Felder, nicht vollständige Nachrichten auf der Leitung. Der User-Agent unterschied sich zwischen den Clients. Der Snapshot kann weder die Kompatibilität mit externen APIs noch das TLS-Verhalten, die Proxy-Leistung oder verallgemeinerte Erfolgsraten belegen.
Für deine eigene wiederholbare Prüfung bewahrst du bereinigte Befehle, Servercode und Paketversionen auf. Protokolliere die vier Schichten getrennt. Wiederhole das Weiterleitungs-Fixture zuerst mit beiden Clients ohne Folgen der Weiterleitung und dann mit beiden Clients mit Folgen; das sind Schritte zur weiteren Validierung, keine zusätzlichen gemessenen Ergebnisse, die hier berichtet werden.
Warum schlägt umgewandelter Code fehl oder liefert andere Ergebnisse?
Finde die erste Schicht, die abweicht, bevor du mehrere Einstellungen änderst. Beginne mit dem ursprünglichen Befehl und der umgewandelten Anfrage zeitnah nacheinander und mit denselben autorisierten Eingaben.
- Authentifizierung: Prüfe Ablauf und Geltungsbereich der Zugangsdaten sowie den erforderlichen Sitzungszustand. Gib bei der Diagnose eines 401 oder 403 niemals Tokens aus.
- Weiterleitungen: Prüfe die erste Antwort, bevor du den finalen Inhalt vergleichst. Unser Fixture zeigte sofort ein anderes Standardverhalten.
- Kodierung: Vergleiche Bytes, wenn Signaturen oder exakte Payloads wichtig sind; vergleiche dekodierte Felder, wenn die Bedeutung für die Anwendung zählt.
- HTTP-Fehler: Prüfe den Status und einen bereinigten Auszug der Antwort. Requests bietet raise_for_status() für die Behandlung nicht erfolgreicher HTTP-Status.
- Timeouts: Lege explizite Werte für Verbindung und Lesen fest. Sie sind keine Frist für die gesamte verstrichene Zeit.
- TLS: Behebe Probleme mit Zertifikatsvertrauen oder Hostnamen. Das Abschalten der Prüfung schafft ein Abfangrisiko.
- Streaming: Verarbeite die Antwort bewusst und schließe sie; nutze für gestreamte Downloads einen Context-Manager.
Der Requests Quickstart behandelt den Umgang mit Status, während Advanced Usage Timeouts, Zertifikatsprüfung und Streaming erklärt. Diagnostiziere den Fehler, bevor du Wiederholungen hinzufügst, besonders bei Vorgängen, die den Serverzustand ändern.
Wie passen Proxys in eine umgewandelte Anfrage?
Übersetze das Routing erst, nachdem die direkte Umwandlung funktioniert. Halte die Proxy-Authentifizierung getrennt vom Bearer-Token oder den Cookies des Ziels.
import os
import requests

proxy_url = os.environ['PROXY_URL']
response = requests.get(
    os.environ['API_URL'],
    proxies={'http': proxy_url, 'https': proxy_url},
    allow_redirects=False,
    timeout=(5, 20),
)
response.raise_for_status()
print(response.status_code)
Requests dokumentiert Proxy-URLs, eingebettete Proxy-Authentifizierung und Proxy-Einstellungen aus der Umgebung in der Proxy-Dokumentation. Prüfe das Routing über die Umgebung, wenn die Ergebnisse abweichen. SOCKS erfordert optionale Abhängigkeiten; erhalte neben der Proxy-Adresse auch das beabsichtigte DNS-Verhalten.
Nutze die Anleitung zur curl-Proxy-Einrichtung, um den ursprünglichen Befehl zu prüfen, und das Tutorial zu Python-Requests-Proxys für den Zielcode. Wenn die Gleichwertigkeitsprüfungen bestanden sind, bieten der Leitfaden zum Python-Routing und der Leitfaden zum curl-Routing optionale nächste Schritte.
Häufig gestellte Fragen
Wie wandle ich einen curl-Befehl in Python Requests um?
Zerlege die curl-Anfrage in Ziel, Methode, Header und Payload und übersetze dann jeden Teil. Vergleiche die Beobachtungen auf dem Server, bevor du dich auf das Ergebnis verlässt; eine erfolgreiche Ausführung allein reicht nicht aus.
Wie lassen sich curl-Optionen für JSON, Formulare und Uploads auf Python abbilden?
Wähle json= für JSON-Objekte, data= für Formularfelder oder exakte Bytes und files= für Multipart-Uploads. Behalte bei byte-sensiblen Anfragen den ursprünglichen Body bei und prüfe seinen Hash, statt anzunehmen, dass die Serialisierung ihn erhält.
Wie bewahre ich Header, Cookies und Bearer-Authentifizierung sicher?
Erfasse die erforderlichen Werte und lade echte Geheimnisse erst zur Laufzeit. Verwende beim Teilen von Beispielen synthetische Ersatzwerte und vermeide es, Zugangsdaten für das Ziel oder für den Proxy zu protokollieren.
Warum kann sich umgewandelter Python-Code anders verhalten als der ursprüngliche curl-Befehl?
Unser Snapshot zeigte Unterschiede bei der Body-Serialisierung und beim Umgang mit Weiterleitungen. Prüfe die erste Anfrage und Antwort, bevor du abweichende Ausgaben dem entfernten Dienst zuschreibst.
Wie übertrage ich curl-Proxy-Einstellungen in Requests?
Übernimm den Proxy-Endpunkt in das proxies-Mapping und erhalte sein Schema. Prüfe das Routing über die Umgebung und die Proxy-Authentifizierung getrennt von der Anwendungsauthentifizierung, bevor du Ergebnisse vergleichst.
Beweist übereinstimmendes geparstes JSON, dass eine Umwandlung korrekt ist?
Es beweist nur, dass die verglichenen Payloads zu denselben Daten dekodiert werden. Unser JSON-Fixture hatte dennoch unterschiedliche Body-Hashes, was relevant ist, wenn die Validierung von exakten Bytes abhängt.
Brauchst du Proxy-Routing, nachdem deine Umwandlung funktioniert?
Beginne mit der DataImpulse-Anleitung zur Requests-Einrichtung, wenn dein autorisierter Workflow Proxy-Routing benötigt. DataImpulse ist keine Scraping-API, kein verwalteter Unblocker und kein VPN; die Korrektheit der Anfragen und die Verarbeitung der Antworten bleiben Teil deines Codes.
Zuletzt aktualisiert: 15. Oktober 2026.