
In this Article
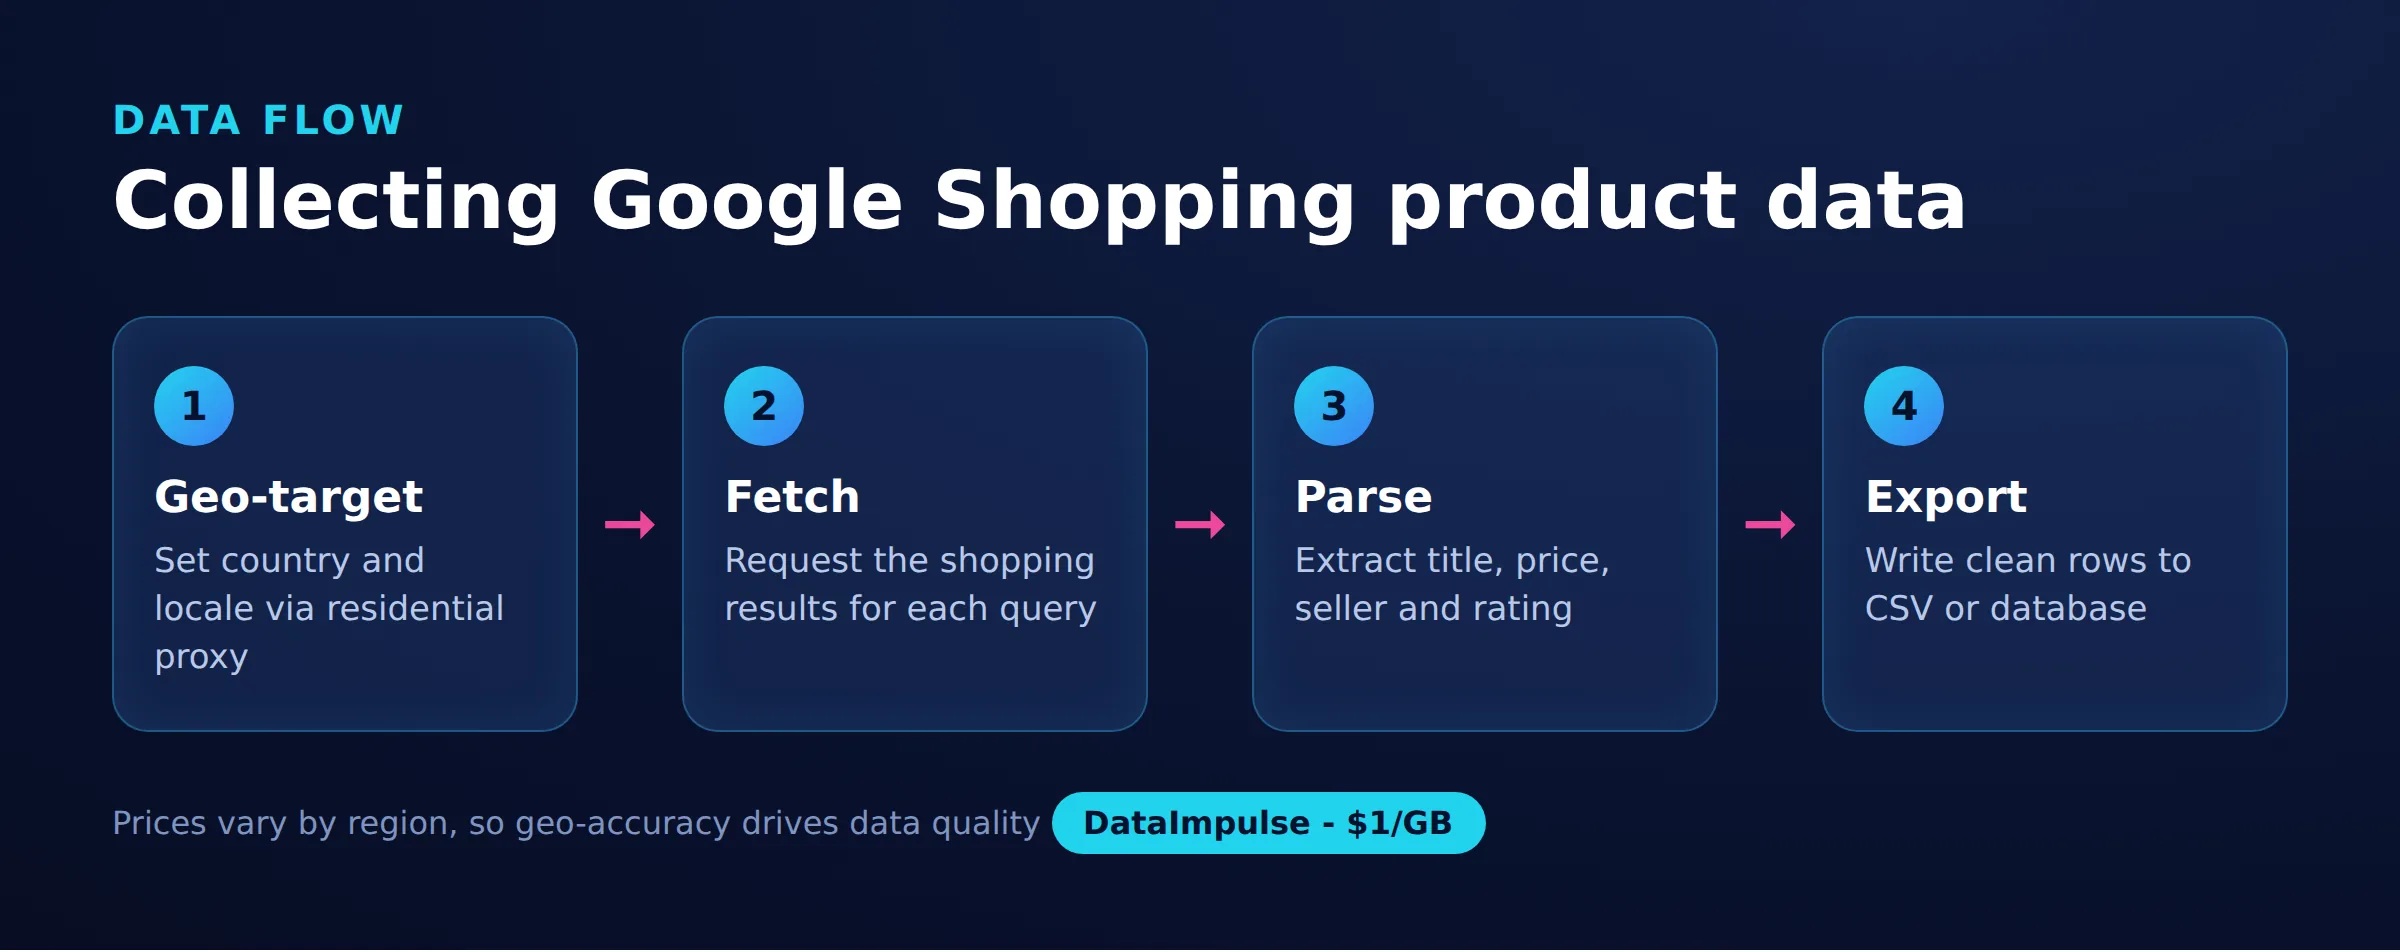
يعني تجريف Google Shopping جمع بيانات منظَّمة عن المنتجات، مثل العناوين والأسعار والبائعين والتقييمات وملاحظات الشحن، من نتائج التسوق في Google على نطاق واسع. ولأن هذه النتائج محمية بدرجة كبيرة ومحلية، فإن جمعها بصورة موثوقة يتطلب تدوير عناوين IP واستهدافاً جغرافياً صحيحاً، بدلاً من تشغيل مكشطة واحدة على اتصال واحد.
هذا الدليل عملي ويركز على الشفرة البرمجية. يشرح الطلبات المستهدفة جغرافياً، والتوجيه عبر بروكسيات خاصة بالدولة، وتحليل بطاقات المنتجات التي يعمّي Google بنيتها عمداً، وترقيم الصفحات، وإعادة المحاولة والتراجع عند حدود المعدل، وخياراً احتياطياً لمتصفح بلا واجهة مع معالجة مربع حوار الموافقة، ونموذج بيانات نظيفاً مع تصدير CSV، ومتتبعاً لسجل الأسعار، وجدولاً للمراقبة. كما يعرض بصدق واقع مكافحة الروبوتات، والموازنة بين مكشطة تبنيها بنفسك وواجهة SERP API مدفوعة، وأين تقع الحدود القانونية.
DataImpulse مزود بروكسيات IP أخلاقي يوفر أكثر من 90 مليون عنوان IP سكني ومحمول ومن مراكز البيانات عبر 195 دولة. ويستخدم نموذج الدفع بحسب الاستخدام بدءاً من 1 دولار لكل GB مع حركة مرور لا تنتهي صلاحيتها، ويُستخدم لتجريف الويب والتحقق من الإعلانات ومراقبة الأسعار وأبحاث السوق وإدارة حسابات متعددة.
حقائق أساسية
- التسعير المحلي: لجمع بيانات Google Shopping بدقة، يجب ضبط معاملي gl وhl وتوجيه الطلبات عبر عنوان IP في الدولة المستهدفة، لأن الأسعار والبائعين والتوافر تختلف من منطقة إلى أخرى.
- أفضل نوع من البروكسيات: بروكسيات سكنية دوارة تستخدم عناوين IP حقيقية للمستهلكين وتتجاوز آليات الكشف.
- السعر: بدءاً من 1 دولار لكل GB، والدفع بحسب الاستخدام، مع حركة مرور لا تنتهي صلاحيتها ومن دون اشتراك.
- التغطية: أكثر من 90M عنوان IP مورداً أخلاقياً عبر 195 دولة.
- الموثوقية: معدل نجاح 99.51%، وتقييم 4.8 من 5 على G2.
- البروتوكولات والاستهداف: HTTP وHTTPS وSOCKS5، مع تضمين الاستهداف حسب الدولة.
ما البيانات التي يمكنك جمعها من Google Shopping؟
يعرض Google Shopping قوائم منتجات تضم عدة حقول منظَّمة مفيدة للتسعير وأبحاث السوق. وتحمل كل نتيجة عادةً مجموعة متسقة من السمات التي يمكنك استخراجها وتوحيدها في صفوف.
- تفاصيل المنتج: العنوان ومقتطف الوصف والعلامة التجارية والطراز وURL لصورة المنتج.
- السعر: السعر المعروض والعملة، وأحياناً نطاق سعر بين البائعين.
- البائع: اسم التاجر، وفي صفحة تفاصيل المنتج، قائمة بالبائعين المنافسين الذين يعرضون العنصر نفسه.
- التقييمات والمراجعات: متوسط تقييم النجوم وعدد المراجعات عند توفرهما.
- التوافر والشحن: حالة المخزون وملاحظات الشحن التي تختلف حسب المنطقة.
تتغير الحقول الدقيقة كلما حدّث Google تخطيطه، لذا ينبغي لأي محلل أن يتسامح مع القيم المفقودة والوسوم المتغيرة. تعامل مع كل حقل بوصفه اختيارياً وتحقق من الأنواع بعد الاستخراج بدلاً من افتراض وجود تقييم أو بائع دائماً. ولأن المنتج نفسه قد يظهر بأسعار مختلفة في دول مختلفة، فصمم مخططك حول مفتاح (المنتج، الدولة، الطابع الزمني) منذ البداية بدلاً من إضافة البعد الجغرافي لاحقاً.
كيف ترسل طلباً مستهدفاً جغرافياً إلى Google Shopping؟
يمكنك إرسال طلب مستهدف جغرافيًا عن طريق الضغط على نقطة نهاية بحث Google باستخدام علامة علامة تبويب التسوق بالإضافة إلى المعلمات المحلية، ثم قراءة نفس إشارات IP والمعلمات التي يرسلها المتسوق الحقيقي. المعلمتان الأكثر أهمية هما gl (البلد مثلا gl=de لألمانيا) و hl (لغة الواجهة، على سبيل المثال hl=de). والثالث المفيد هو أ موقعمصطلح -style يمكنك طيه في سياق الاستعلام، ولكن gl بالإضافة إلى أن عنوان IP للخروج المطابق يقوم بمعظم العمل.
لا يكفي ضبط المعاملات وحده، لأن Google يقرأ أيضاً عنوان IP للطلب ليقرر الأسعار والبائعين المعروضين. يرسل الطلب الأدنى أدناه ترويسات واقعية وزوج معاملات اللغة والمنطقة. وقد تُرك عمداً بلا بروكسي لكي ترى الاستدعاء الأساسي قبل إضافة طبقة IP.
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
احتفظ بال قبول اللغة رأس محاذاة مع hl. إن طلب صفحة أسعار ألمانية بترويسة لغة إنجليزية عدم تطابق يبدو غير طبيعي وقد يعيد العملة الخطأ. وعند التوسع، تصبح هذه الدالة الأساسية المكان الوحيد لتحديد اللغة والمنطقة، ما يبقي كل الاستدعاءات اللاحقة متسقة.
كيف توجه الطلبات عبر بروكسيات مستهدفة حسب الدولة؟
يمكنك التوجيه عبر وكيل مستهدف للبلد عن طريق الإشارة طلبات في بوابة واحدة وترميز البلد المستهدف في اسم مستخدم الوكيل. مع DataImpulse البوابة هي gw.dataimpulse.com:823، وإلحاق __cr.us أو __cr.de إلى اسم المستخدم الخاص بك يحدد بلد الخروج. يتم تضمين استهداف الدولة في السعر الأساسي، في حين أن استهداف الولاية والمدينة والرمز البريدي وASN عبارة عن وظائف إضافية مدفوعة الأجر. إذا كانت مصادقة الوكيل جديدة بالنسبة لك، فدليلنا حول مصادقة البروكسي يغطي ميكانيكا اسم المستخدم وكلمة المرور في العمق.
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
الانضباط المهم هو تبديل البلد الوكيل و gl/hl زوجان معًا. لإنشاء مقارنة الأسعار عبر الأسواق، قم بالتكرار على قائمة البلدان وحافظ على عنوان IP الخاص بالخروج والإعدادات المحلية بشكل متماسك بحيث تعكس كل استجابة موقعًا واحدًا ومتسقًا للمتسوقين.
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
يوفر DataImpulse طبقة IP، وليس خدمة تجريف مُدارة، لذا فأنت تمتلك أداة الكشط نفسها. الدورية البروكسيات السكنية هي الملائمة المعتادة هنا لأنها تأتي من أجهزة استهلاكية حقيقية؛ بروكسيات مراكز البيانات هي أرخص ولكن من الأسهل وضع علامة عليها، و البروكسيات المحمولة تحمل عناوين IP من فئة الناقل لأصعب الأهداف.
كيف يمكنك تحليل بطاقات منتجات Google Shopping؟
يمكنك تحليل بطاقات المنتج باستخدام مكتبة HTML متسامحة والارتساء على أنماط نصية ثابتة بدلاً من المحددات العميقة الهشة، لأن أسماء فئات Google مبهمة ويتم تدويرها بشكل متكرر. قد يتعطل أي محدد تنسخه من أدوات تطوير متصفحك اليوم في غضون أسابيع، لذا قم ببناء المحلل اللغوي ليتحلل بأمان بدلاً من التعطل عند تغيير التخطيط.
يقرأ النهج القوي كل بطاقة مرشح، ويسحب العنوان والصورة من بنية العلامة، ويستخرج السعر بتعبير عادي مدرك للعملة. المحددات أدناه هي أمثلة واقعية، وليست ضمانات؛ نتوقع تحديثها والاحتفاظ بالتعبير العادي باعتباره احتياطيًا موثوقًا به.
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
نظرًا لأن العلامات المبهمة هي القاعدة هنا، فإن بعض الفرق تصل إلى DOM معروض بدلاً من ذلك. للحصول على المفاضلات الأوسع نطاقًا لتحليل صفحات HTML الثابتة مقابل الصفحات المعروضة، راجع دليلنا لـ كشط صفحات الويب الديناميكية.
كيف يمكنك ترقيم الصفحات والتراجع عندما تقوم Google بإرجاع 429؟
يمكنك ترقيم الصفحات من خلال تقدم يبدأ يتم الإزاحة في خطوات تتوافق مع حجم صفحتك، ويمكنك تجاوز حدود المعدل من خلال التعامل مع HTTP 429 (والاستجابات الفارغة أو CAPTCHA) كإشارة للانتظار وإعادة المحاولة من خلال عنوان IP جديد. يخنق Google الطلبات التلقائية المتكررة بقوة، لذا فإن ترقيم الصفحات والتراجع ينتميان إلى نفس الحلقة.
انتقل إلى الصفحات حتى لا يُرجع الطلب أي بطاقات أو تصل إلى رأس الصفحة. قم بتدوير عنوان IP الخاص بالخروج بين الصفحات عن طريق إعادة قراءة إملاء الوكيل، واكتشف الكتل الإلكترونية عن طريق التحقق من الموافقة أو علامات CAPTCHA في النص بدلاً من الثقة في رمز الحالة وحده.
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
يستخدم مساعد إعادة المحاولة أدناه التراجع الأسي مع عدم الاستقرار، الذي ينشر عمليات إعادة المحاولة بحيث لا تتم إعادة المحاولة لجميع العمال المحظورين في نفس اللحظة. تقوم كل محاولة بإعادة جلب أمر الوكيل، لذا فإن المجموعة الدوارة تمنحك عنوان IP جديدًا في المحاولة التالية.
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
حافظ على معدلات الطلب معقولة حتى عندما تنجح عمليات إعادة المحاولة. يؤدي تأخير الخط الأساسي المهذب بين الصفحات، جنبًا إلى جنب مع التدوير، إلى تحقيق الاستقرار على المدى الطويل أكثر من الدق والاعتماد على إعادة المحاولة. ملاحظاتنا على أفضل ممارسات تجريف الويب سرعة التغطية ونظافة الرأس بمزيد من التفاصيل.
كيف يمكنك عرض الصفحات المحظورة باستخدام متصفح بدون رأس؟
عندما يستمر طلب HTTP العادي في الوصول إلى جدران الموافقة أو المحتوى الذي يتم عرضه بواسطة JavaScript، ارجع إلى متصفح بدون رأس ينفذ الصفحة مثل عميل حقيقي ويتجاهل مربع حوار الموافقة قبل قراءة DOM. يعد Playwright مناسبًا لأنه يدعم الوكلاء لكل سياق والانتظار الموثوق به.
يقوم البرنامج النصي أدناه بتشغيل Chromium من خلال وكيل DataImpulse الذي يستهدف الدولة، ويتعامل مع ملف تعريف الارتباط أو مربع حوار الموافقة الذي تعرضه اللغات الأوروبية عادةً، وينتظر المحتوى، ويعيد HTML المعروض حتى تتمكن من إدخاله في نفس parse_cards وظيفة.
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
يعد المتصفح بدون رأس أثقل على وحدة المعالجة المركزية والذاكرة من الطلب الأولي، لذا استخدمه كبديل مستهدف للصفحات التي تحتاج حقًا إلى العرض بدلاً من المسار الافتراضي. تقوم العديد من الفرق بتشغيل HTTP المباشر للسرعة ولا يتم تصعيده إلى Playwright إلا عندما is_blocked يستمر في إطلاق النار. إذا كانت مجموعتك تستخدم JavaScript بدلاً من Python، فسيتم تطبيق نفس النمط مع Puppeteer؛ يرى تجريف الويب باستخدام JavaScript.
كيف يمكنك تنظيم وتصدير البيانات المسروقة؟
يمكنك تنظيم البيانات حول سجل ثابت يتضمن دائمًا السوق والطابع الزمني للالتقاط، ثم تصديرها إلى ملف CSV بحيث يسهل تمييز المخرجات أو تحميلها في جدول بيانات أو دفعها إلى مستودع. تمنحك فئة البيانات تلميحات للكتابة وتعريفًا واحدًا واضحًا للصف.
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
إن كتابة ملف CSV هي مسألة تفريغ حقول فئة البيانات. يتيح وضع الإلحاق بالإضافة إلى حماية الرأس للمهمة المجدولة زيادة ملف واحد بمرور الوقت دون إعادة كتابته.
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
إن الاحتفاظ بالبلد والطابع الزمني في كل صف هو ما يتيح لك لاحقًا الإجابة على أسئلة مثل أي سوق هو الأرخص بالنسبة لـ SKU اليوم، أو كيف تحرك السعر هذا الأسبوع. يعد مفتاح الجغرافيا والوقت هذا هو الأساس لمتتبع تاريخ الأسعار في القسم التالي.
كيف يمكنك تتبع سجل أسعار Google Shopping مع مرور الوقت؟
يمكنك تتبع سجل الأسعار عن طريق إدخال كل ملاحظة في قاعدة بيانات صغيرة مرتبطة بالمنتج والبلد واليوم، لذا فإن إعادة تشغيل أداة الكشط تقوم بتحديث صف اليوم بدلاً من تكراره مع الحفاظ على الأيام السابقة. SQLite يكفي لملايين الصفوف ولا يحتاج إلى خادم، مما يحافظ على وظيفة المراقبة مستقلة بذاتها.
يستخدم المخطط أدناه مفتاحًا فريدًا مركبًا و حول الصراع مضايقة. يؤدي تشغيل المكشطة مرتين في يوم واحد إلى استبدال أحدث سعر لذلك (المنتج، البلد، اليوم)؛ يؤدي تشغيله عبر الأيام إلى إنشاء سلسلة زمنية يمكنك رسمها لاحقًا.
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
تعد مطابقة العناوين عبر الأيام هي الجزء الصعب من الناحية العملية، لأن عناوين Google تختلف قليلاً بين اللقطات. بالنسبة لقائمة مراقبة صغيرة، قم بتعيين العناوين الأولية إلى معرف المنتج الأساسي الذي تتحكم فيه قبل ظهوره، بدلاً من الوثوق بالعنوان المسروق كمفتاح ثابت.
كيف يمكنك جدولة المراقبة المستمرة للأسعار؟
يمكنك جدولة المراقبة عن طريق تجميع خطوات الجلب والتحليل في نقطة إدخال واحدة وتشغيلها بإيقاع ثابت باستخدام cron، بحيث يتم تحديث الأسعار تلقائيًا دون تشغيل يدوي. يعد التشغيل مرة واحدة يوميًا خيارًا افتراضيًا معقولًا لتتبع الأسعار؛ تؤدي عمليات التشغيل المتكررة إلى زيادة التكلفة ومنع المخاطر دون وجود الكثير من الإشارات الإضافية لمعظم الكتالوجات.
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
ثم قم بتسجيله في cron. يقوم الإدخال أدناه بتشغيل الشاشة كل يوم في الساعة 06:15 ويسجل المخرجات لتصحيح الأخطاء، وهو أمر مهم لأن المكشطة المجدولة تفشل بصمت.
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
أضف ارتعاشًا خفيفًا داخل المهمة (نوم عشوائي لبضع دقائق في البداية) حتى لا تصل الطلبات إلى Google في نفس الساعة الثانية كل يوم. قم بتدوير بلدان الخروج وطلبات السرعة كما تمت مناقشتها سابقًا، وراقب السجل بحثًا عن معدل متزايد من عمليات الحظر، وهو أول علامة على أن Google قد غيرت دفاعاتها أو أن أنماطك أصبحت منتظمة للغاية.
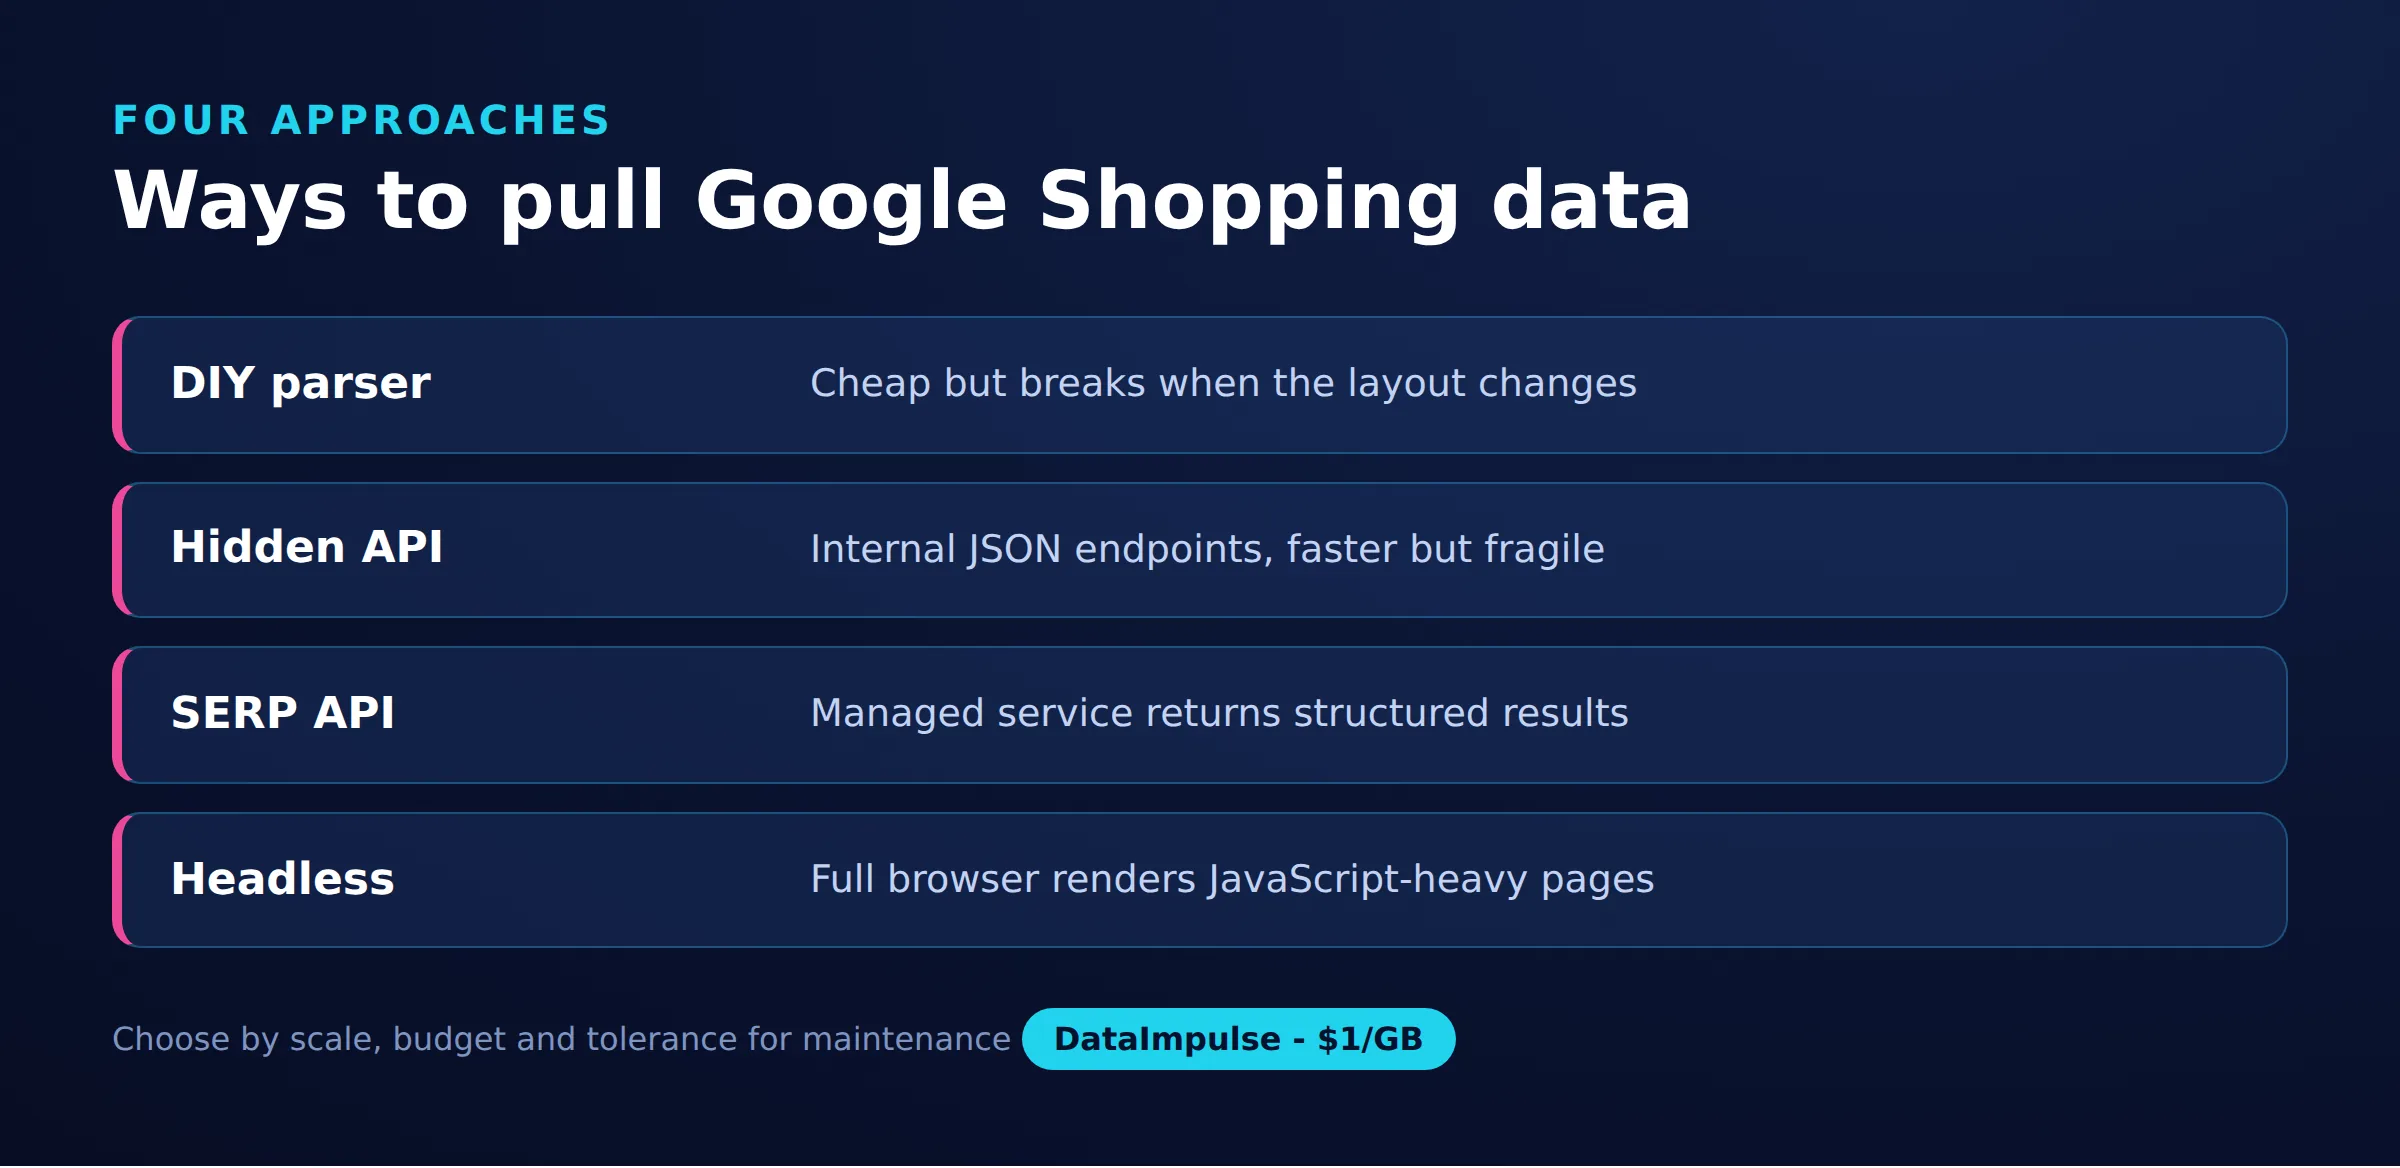
ما هو أسلوب التجميع الذي يجب عليك اختياره: DIY، أو نقاط النهاية المخفية، أو SERP API، أو مقطوعة الرأس؟
اختر بناءً على مقدار الهشاشة والهندسة التي ترغب في امتلاكها مقابل المبلغ الذي ترغب في دفعه لكل طلب. لا توجد إجابة واحدة صحيحة. والمقايضة الصادقة هي التحكم والتكلفة مقابل عبء الصيانة والتعرض لمكافحة الروبوتات.
حقيقة مكافحة الروبوتات: تدافع Google بشكل فعال عن هذه النتائج من خلال تحديد المعدلات واختبارات CAPTCHA وجدران الموافقة والعلامات المبهمة الدوارة والإشارات السلوكية. سوف تنكسر أي مكشطة يتم صنعها بنفسك بشكل دوري وتحتاج إلى صيانة مستمرة. الوكلاء والتراجع يقللان من الكتل؛ لا يقضون عليهم. أي شخص يعد بمكشطة Google غير قابلة للحظر بشكل دائم يبالغ في البيع.
| يقترب | يكلف | هشاشة | يتحكم |
|---|---|---|---|
| تحليل HTML DIY | منخفض (الوكيل فقط) | عالي | ممتلىء |
| نقاط النهاية JSON المخفية | منخفض (الوكيل فقط) | عالية جدا | ممتلىء |
| API سيرب | عالية (حسب الطلب) | قليل | محدود |
| متصفح بلا رأس | متوسط (حساب + وكيل) | واسطة | ممتلىء |
API SERP مقابل DIY: تقوم API SERP التابعة لجهة خارجية بإرجاع نتائج التسوق التي تم تحليلها بتنسيق JSON وتستوعب أعمال التحليل وإلغاء الحظر نيابةً عنك، بسعر لكل طلب ومع قفل البائع وتحكم أقل في ما يتم جلبه بالضبط. تكلفة أداة استخراج البيانات التي تقوم بها بنفسك على الوكلاء أقل بكثير لكل طلب وتمنحك التحكم الكامل، لكنك تمتلك المحلل اللغوي وعمليات إعادة المحاولة والصيانة عندما يتغير Google. لتوضيح المكان المناسب لـ DataImpulse: إنها طبقة الوكيل الموجودة أسفل أي من أساليب DIY هذه، وليست API SERP وليست خدمة تجريف مُدارة. إذا كنت لا تريد أي عمل تحليلي، فإن API SERP هي التوصية الصادقة؛ إذا كنت تريد تكلفة منخفضة وتحكمًا ويمكنك صيانة مكشطة، فإن DIY على الوكلاء الدوارين هو الأفضل من الناحية الاقتصادية. يمكن أن تكون نقاط نهاية JSON المخفية أرخص ولكنها الأكثر هشاشة على الإطلاق، حيث يمكن لـ Google تغييرها أو إزالتها دون إشعار.
هل من القانوني والأخلاقي التخلص من Google Shopping؟
يتم التعامل بشكل عام مع عملية استخراج بيانات المنتج المرئية بشكل عام على أنها أقل خطورة من الوصول إلى المحتوى الخاص أو المسور، ولكنها ليست خالية من القواعد، وهذه ليست نصيحة قانونية. الأسعار والقوائم الموجودة على Google Shopping علنية، ولكن كيفية جمعها واستخدامها لا تزال مهمة، ويجب عليك تأكيد حالتك المحددة مع محامٍ مؤهل.
- شروط الخدمة: يمكن أن يتعارض الوصول الآلي مع شروط Google، وهي مسألة تعاقدية منفصلة عن حقوق الطبع والنشر أو قانون الوصول إلى الكمبيوتر.
- البيانات الشخصية: قوائم المنتجات ليست في العادة بيانات شخصية، ولكن تجنب جمع أسماء المراجعين أو المعرفات الأخرى، واتبع اللائحة العامة لحماية البيانات (GDPR) حيثما ينطبق ذلك.
- معدل وتحميل: حافظ على حجم الطلب معقولًا حتى لا تؤدي إلى تدهور الخدمة التي تستفسر عنها.
- استخدام البيانات: إن إعادة استخدام الصور أو الأوصاف المحمية بحقوق الطبع والنشر بالجملة تحمل مخاطر أكبر من تحليل الأسعار كحقائق.
من ناحية المجموعة، تبدأ الأخلاقيات بعناوين IP التي تستخدمها. تقوم DataImpulse بمصادر عناوين IP الخاصة بها من المستخدمين الذين يختارون الاشتراك ويتم تعويضهم، وتتوافق مع اللائحة العامة لحماية البيانات، وتقدم اتفاقية معالجة البيانات، التي تدعم خط أنابيب يمكن الدفاع عنه. للحصول على معالجة أكمل للموافقة، وتحديد المصادر، والممارسة المسؤولة، راجع دليلنا لـ تجريف الويب الأخلاقية. اجمع بين مصدر IP أخلاقي والسرعة المهذبة والاستخدام الضيق والواقعي للبيانات، وستحافظ على انخفاض المخاطر القانونية والمخاطر المتعلقة بالسمعة.
الأسئلة المتداولة
هل أحتاج إلى وكلاء سكنيين للتخلص من Google Shopping؟
يعد الوكلاء السكنيون الخيار الأكثر موثوقية لأنهم يستخدمون عناوين IP حقيقية للمستهلكين والتي تمتزج مع حركة المرور العادية. يمكن أن تعمل وكلاء مركز البيانات مع حجم خفيف ولكن يتم اكتشافها وحظرها بسهولة أكبر.
كيف يمكنني الحصول على الأسعار المحلية من Google Shopping؟
قم بتعيين معلمات gl وhl على البلد واللغة المستهدفين، وقم بتوجيه الطلب عبر عنوان IP الوكيل في نفس البلد باستخدام بناء جملة البلد، على سبيل المثال، اسم مستخدم ينتهي بـ __cr.de لألمانيا. يقرأ Google كلاً من المعلمات وعنوان IP للطلب لتحديد الأسعار التي سيتم عرضها.
هل DataImpulse عبارة عن API لاستخلاص البيانات من Google Shopping؟
لا. يوفر DataImpulse طبقة الوكيل (عناوين IP السكنية والمتنقلة ومراكز البيانات)، وليس عملية استخراج مُدارة أو API SERP. يمكنك تشغيل أداة الكشط الخاصة بك أو أداة تابعة لجهة خارجية أعلى عناوين IP الخاصة بها.
لماذا يستمر حظر مكشطة Google Shopping الخاصة بي؟
تمنع Google الطلبات التلقائية المتكررة من عنوان IP واحد وتخدم اختبارات CAPTCHA وجدران الموافقة. يعمل الوكلاء السكنيون المتناوبون، والترويسات الواقعية، والتراجع المتسارع على 429 استجابة، ومعدلات الطلب المعقولة على تقليل الكتل بشكل كبير، على الرغم من عدم وجود طريقة لإزالتها بالكامل.
هل يجب علي استخدام API SERP أو إنشاء أداة الكشط الخاصة بي؟
تعمل API SERP على إزالة التحليل وإلغاء حظر العمل بتكلفة أعلى لكل طلب وتحكم أقل، وهو ما يناسب الفرق التي لا تريد أي صيانة. تكلف أداة الكشط التي يمكنك تنفيذها بنفسك على الوكلاء المتناوبين تكلفة أقل بكثير وتمنحك تحكمًا كاملاً، لكنك تحتفظ بالمحلل اللغوي وتعيد المحاولة مع تغير Google.
متى لا يكون DataImpulse مناسبًا؟
إذا كنت بحاجة إلى وكلاء ISP ثابتين، أو API مُدارة بالكامل، أو الوصول إلى المواقع المصرفية والحكومية، فإن DataImpulse ليست الأداة المناسبة. وهو يركز على تناوب الوكلاء السكنيين والمتنقلين ومراكز البيانات لجمع البيانات العامة والوصول إلى المحتوى.
ابدأ في استخراج Google Shopping باستخدام وكلاء موثوقين
إذا كنت مستعدًا لجمع بيانات Google Shopping عبر الأسواق، فإن DataImpulse يمنحك عناوين IP السكنية والهواتف المحمولة ومراكز البيانات الدورية والثابتة مع تضمين استهداف البلد، بدءًا من دولار واحد لكل جيجابايت. إنشاء حساب وقم بتوجيه مكشطةك الأولى عبر تجمع IP نظيف.