
Dans cet article
Une recherche sur l’API Google Patents mène à plusieurs voies d’accès différentes, mais nous n’avons trouvé aucune API Google publique documentée pour les résultats de recherche du site. Les développeurs doivent distinguer les jeux de données de brevets interrogés via BigQuery, les services de recherche tiers et les endpoints non documentés du site.
Ce guide relie ce choix à une tâche d’extraction concrète. Nous expliquons la documentation, reproduisons le script Python exact de notre essai rapide du 16 octobre 2026 et indiquons ce qu’il a extrait de 10 résultats de recherche. Les mesures constituent un petit instantané, pas un benchmark ni une garantie d’accès futur.
Points clés
- Google Patents n’a pas d’API publique officielle (en octobre 2026).
- Les pages de brevets contiennent le titre, le résumé, les revendications, le déposant et les dates sous forme de microdonnées schema.org dans du HTML brut.
- L’endpoint JSON propre à la page de recherche a renvoyé 129 598 résultats pour « residential proxy », plafonnés à 100 pages.
- Les voies officielles exigent une inscription : EPO OPS a répondu 403 et l’API de l’USPTO 401 sans identifiants lors de notre vérification.
- Notre extracteur a récupéré les titres et les déposants pour 10 brevets sur 10 ; les pages chinoises (CN) demandent un traitement distinct.
- Le jeu de données patents-public-data de Google dans BigQuery est l’alternative officielle pour les volumes importants.
Une API Google Patents officielle existe-t-elle ?
Nous avons trouvé un accès documenté à des jeux de données et une aide à la recherche sur le site, mais aucune API de recherche Google Patents publique et documentée, assortie d’un processus officiel d’enregistrement de clé. Ce constat est plus étroit que la preuve qu’aucune interface n’existe.
L’aide à la recherche de Google décrit les requêtes sur le site. Le dépôt du jeu de données de brevets de Google décrit l’analyse SQL via BigQuery. Aucun des deux ne doit être lu comme la documentation de l’endpoint de recherche interne du site. Le dépôt est archivé et indique explicitement que son contenu n’est pas un produit Google officiel ; ses exemples sont des références utiles, pas un engagement de maintenance.
Notre essai a observé du JSON provenant de /xhr/query, l’endpoint appelé par la page de recherche. Une réponse réussie n’établit ni un contrat d’API pris en charge, ni un schéma stable, ni l’autorisation d’automatiser, ni une pagination garantie. Les règles robots actuelles distinguent aussi cet endpoint des pages de brevets, comme nous le verrons plus loin.
Choisissez la voie d’accès avant de chercher des identifiants. Une clé de fournisseur tiers s’authentifie auprès de ce fournisseur. BigQuery utilise l’authentification Google Cloud. Aucun de ces identifiants ne transforme l’endpoint XHR interne en API Google Patents officielle.
Quelle voie d’API Google Patents convient à votre tâche ?
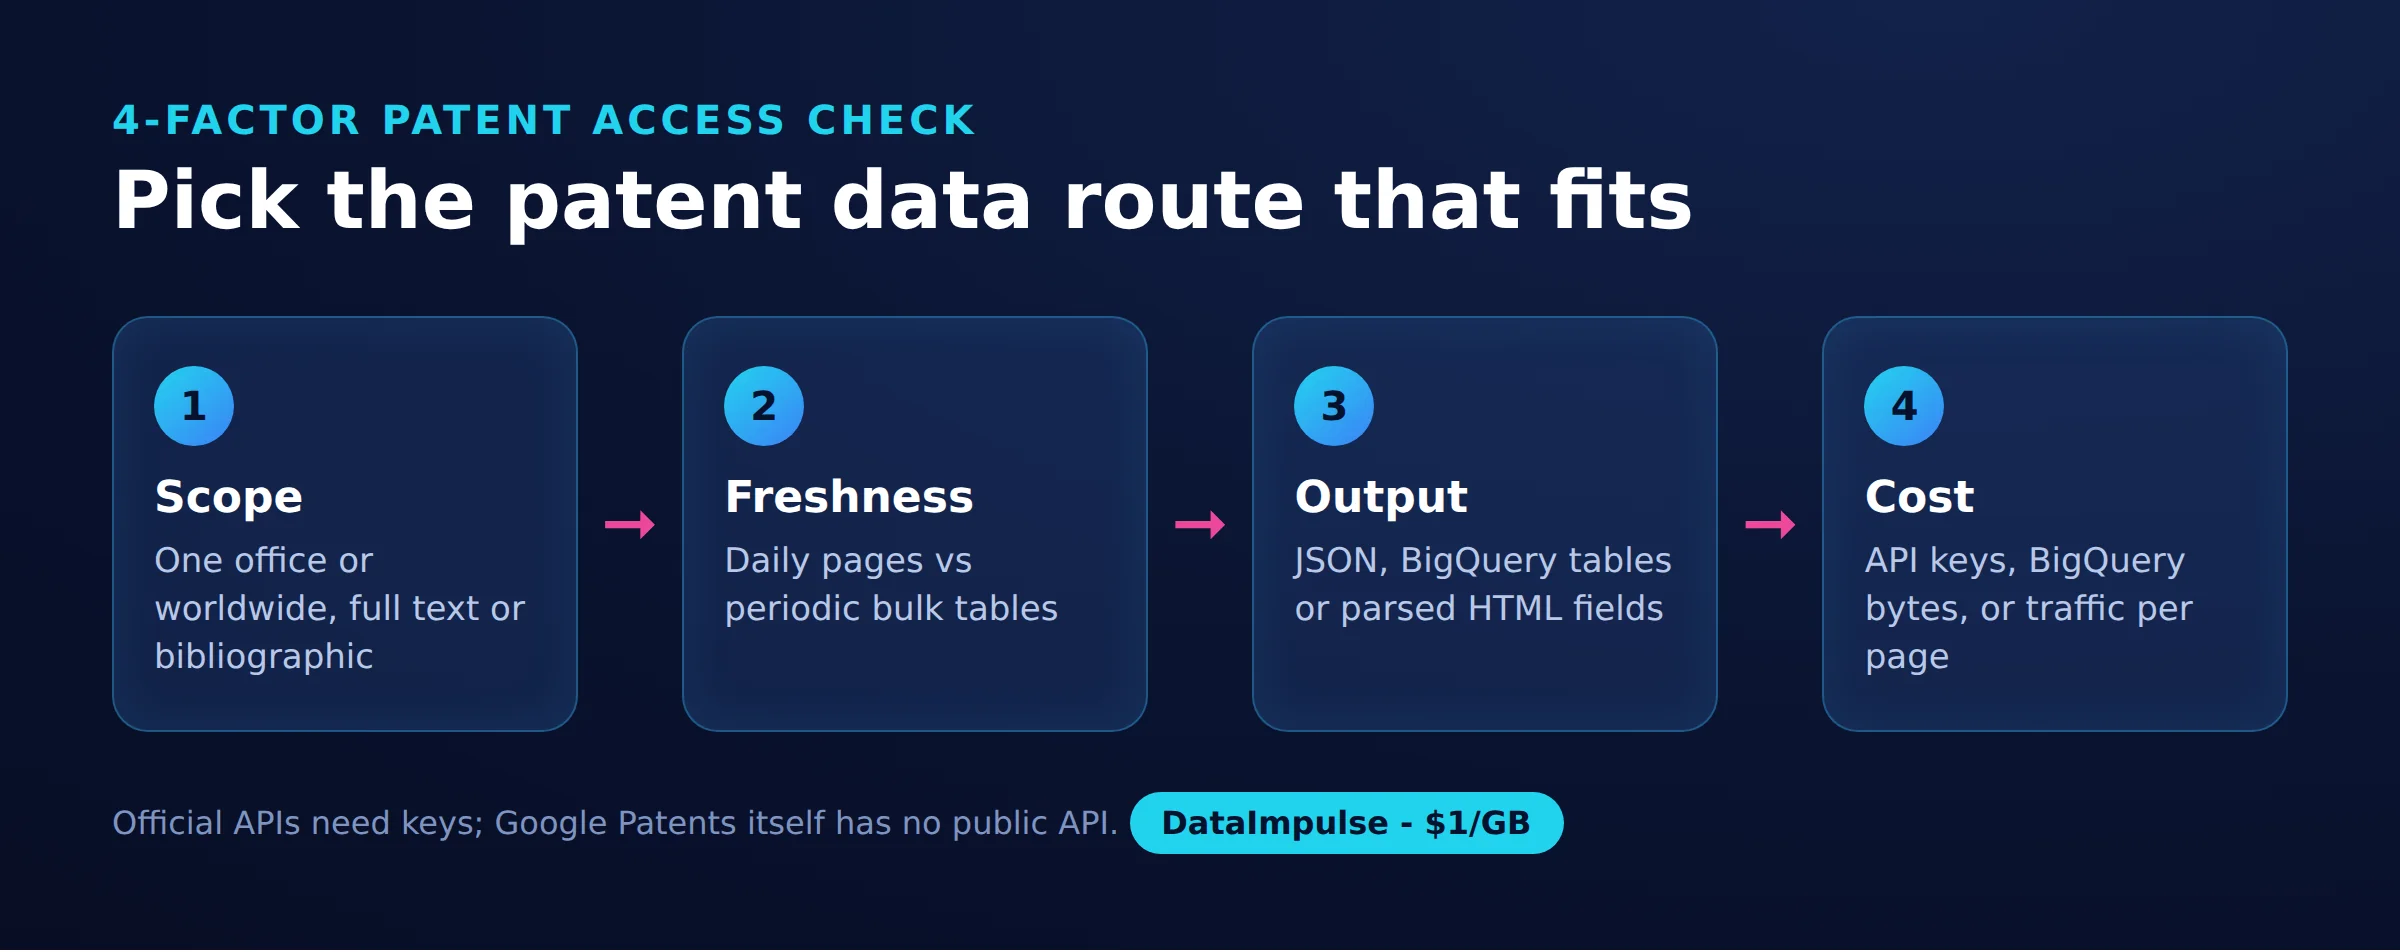
Utilisez le contrôle d’accès aux brevets en 4 critères pour choisir une voie : périmètre, fraîcheur, format de sortie et coût. Notez les réponses acceptables avant de construire un collecteur.
- Périmètre : quelles juridictions, quels types de publication, quelles langues et quels champs doivent être présents ?
- Fraîcheur : un instantané de recherche daté suffit-il, ou les publications et événements récents doivent-ils apparaître ?
- Sortie : avez-vous besoin de résultats classés, de fiches de publication, du texte complet, de PDF ou d’agrégats par famille ?
- Coût : quel budget couvre les requêtes, les appels, le transfert, le stockage et la maintenance ?
| Voie | Utiliser X quand… | Éviter X quand… |
|---|---|---|
| BigQuery | Utilisez BigQuery quand une analyse SQL est nécessaire. | Évitez BigQuery quand le classement du site doit être reproduit. |
| API tierce | Utilisez une API tierce quand une sortie de recherche structurée est nécessaire. | Évitez une API tierce quand la dépendance à un fournisseur est inacceptable. |
| Extraction de pages publiques | Utilisez l’extraction de pages publiques quand une petite tâche de métadonnées le justifie. | Évitez l’extraction de pages publiques quand l’exhaustivité sur de gros volumes est essentielle. |
| Source officielle en volume ou API | Utilisez une source officielle quand ses enregistrements correspondent à votre besoin. | Évitez cette source quand sa couverture ne correspond pas au projet. |
Par exemple, la recherche de concurrents et une étude historique des dépôts demandent des tests d’acceptation différents. Notre guide sur les sources de données pour les études de marché explique comment évaluer l’adéquation d’une source avant la collecte.
Comment interroger des jeux de données de brevets avec BigQuery et Python ?
Utilisez BigQuery pour une analyse SQL reproductible, après avoir inspecté le schéma de la table et estimé le coût de la requête. Nous n’avons exécuté aucune requête BigQuery lors de cet essai.
La référence du schéma des publications du dépôt identifie patents-public-data.patents.publications, des enregistrements CPC répétés et des tableaux de textes localisés. Elle décrit des données bibliographiques mondiales et le texte intégral des brevets américains. Comme cette référence contient des métadonnées historiques, inspectez la table en production avant de supposer une couverture actuelle des revendications ou des descriptions internationales.
Concevez la requête autour des identifiants de publication, des dates, d’une condition CPC et du champ de texte réellement nécessaire. Pour les classifications répétées et les textes localisés, utilisez des conditions d’existence séparées afin d’éviter de multiplier les lignes. Sélectionnez la langue explicitement. Un filtre par mot-clé sur le résumé n’est pas une recherche en texte intégral, et un nombre de publications n’est pas un nombre de familles.
Pour l’authentification en Python, suivez les instructions de Google sur les Application Default Credentials. La documentation du client Python explique l’envoi des requêtes. Sélectionnez le projet explicitement et gardez les identifiants hors du contrôle de version.
La méthode REST jobs.query renvoie des informations sur l’achèvement du job et peut renvoyer un jeton de page. Récupérez les résultats suivants via la méthode de continuation documentée ; n’exécutez pas de nouveau l’analyse d’origine à répétition simplement pour obtenir une page de plus.
Pour les requêtes à la demande, définissez une limite d’octets facturés maximale (en octobre 2026) et effectuez d’abord une simulation (dry run). Les contrôles de coûts de Google expliquent pourquoi LIMIT seul ne réduit pas de façon fiable le volume d’octets analysés. Conservez avec le résultat la requête, l’identifiant de la table, la date d’exécution et l’estimation en octets.
Comment fonctionnent les API tierces de recherche et de détails ?
Les API tierces exposent leur propre authentification et leurs propres contrats de réponse. La recherche récupère des candidats ; la récupération des détails demande les informations d’un enregistrement précis.
La documentation Google Patents de SerpApi précise engine=google_patents, une requête et une clé d’API du fournisseur. Ses exemples de réponse incluent des résultats de recherche structurés. La pagination utilise page et num ; la taille de page documentée va de 10 à 100 résultats (en octobre 2026). Suivez la numérotation du fournisseur plutôt que de recopier la valeur de page de l’endpoint interne du site.
La documentation des détails de SearchApi précise engine=google_patents_details et un patent_id, tel que le chemin d’une URL de brevet. Son JSON documenté inclut les identifiants de publication et de demande, les inventeurs, les déposants, les classifications et les événements. Ces paramètres appartiennent à SearchApi, pas à SerpApi.
Par ailleurs, la page de tarifs de SerpApi indique son offre Starter à 25 $ par mois pour 1 000 recherches (en octobre 2026). Prévoyez un budget pour les pages de recherche et pour les éventuelles requêtes de détails supplémentaires que votre flux de travail exige ; ne partez pas du principe que chaque résultat nécessite toujours un appel de plus.
Nous n’avons testé aucune de ces deux API commerciales. Avant de vous engager, évaluez un ensemble représentatif d’identifiants et comparez les champs requis, les valeurs manquantes, la gestion des doublons et l’usage facturé. Conservez la réponse d’origine du fournisseur à côté de votre enregistrement normalisé, afin que les changements de schéma restent diagnosticables.
Comment Python peut-il extraire des pages de brevets publiques et des PDF ?
Notre extracteur Python lit les métadonnées dans le HTML des brevets et enregistre les liens PDF. Il ne télécharge pas les PDF et n’établit pas qu’un champ absent de l’analyse est absent du brevet sous-jacent.
Restriction d’accès : le fichier robots actuel de Google Patents autorise /patent/ mais interdit le chemin de recherche XHR au titre de sa règle générale. Le script de mesure exact ci-dessous consigne ce qui a été exécuté ; son étape de recherche automatisée ne doit pas être réutilisée sans une autorisation conforme aux conditions et règles applicables.
Le script utilise requests pour HTTP et des expressions régulières pour le balisage observé. Il marque une pause de deux à quatre secondes entre les requêtes de brevets et écrit patents.csv. Cet analyseur étroit est facile à inspecter, mais ses échecs sur les pages chinoises montrent pourquoi il ne convient pas comme analyseur universel de brevets.
import csv, html, json, random, re, time
from urllib.parse import quote
import requests

HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                         "(KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36"}


def search(query, num=10, page=0):
    """The JSON endpoint the Google Patents search page itself calls (undocumented, may change)."""
    inner = f"q=({quote(query)})&num={num}&page={page}"
    r = requests.get("https://patents.google.com/xhr/query",
                     params={"url": inner, "exp": ""}, headers=HEADERS, timeout=40)
    r.raise_for_status()
    res = r.json()["results"]
    ids = [hit["id"] for c in res["cluster"] for hit in c["result"]]  # e.g. patent/US12381958B2/en
    return res["total_num_results"], ids


def itemprop(page, name):
    m = re.search(rf'itemprop="{name}"[^>]*>(.*?)</', page, re.S)
    return html.unescape(re.sub(r"\s+", " ", re.sub(r"<[^>]+>", " ", m.group(1)))).strip() if m else None


def patent(path):
    """Patent pages carry schema.org microdata (itemprop) in plain HTML."""
    page = requests.get(f"https://patents.google.com/{path}", headers=HEADERS, timeout=40).text
    claims = re.search(r'<section itemprop="claims".*?</section>', page, re.S)
    pdf = re.search(r'<meta name="citation_pdf_url" content="([^"]+)"', page)
    abstract = re.search(r'<div[^>]*class="abstract"[^>]*>(.*?)</div>', page, re.S)
    return {
        "id": path.split("/")[1],
        "title": itemprop(page, "title"),
        "assignee": itemprop(page, "assigneeOriginal"),
        "priority_date": itemprop(page, "priorityDate"),
        "publication_date": itemprop(page, "publicationDate"),
        "status": itemprop(page, "legalStatusIfi"),
        "abstract": html.unescape(re.sub(r"\s+", " ", re.sub(r"<[^>]+>", " ", abstract.group(1)))).strip()[:500] if abstract else None,
        "claims": len(re.findall(r'class="claim"', claims.group(0))) if claims else 0,
        "pdf": pdf.group(1) if pdf else None,
    }


if __name__ == "__main__":
    total, ids = search("residential proxy", num=10)
    print(f"{total} results; fetching {len(ids)} patents")
    rows = []
    for path in ids[:10]:
        rows.append(patent(path))
        time.sleep(random.uniform(2, 4))
    with open("patents.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=list(rows[0].keys()))
        w.writeheader()
        w.writerows(rows)
    print(json.dumps(rows[0], indent=1)[:800])
Interprétez son résultat avec prudence : les résumés sont tronqués à 500 caractères, les revendications sont comptées et non extraites, et le champ du déposant correspond au déposant d’origine. La fonction de récupération des pages ne vérifie pas non plus le statut HTTP, si bien qu’une page d’erreur pourrait devenir une ligne trompeuse de champs vides.
Pour un téléchargement de PDF autorisé, traitez chaque URL découverte comme un téléchargement distinct : vérifiez les règles de la destination, contrôlez la réponse et le type de contenu, écrivez en flux vers le stockage et enregistrez une somme de contrôle. Distinguez les liens manquants des téléchargements échoués. Notre guide des proxies pour Python requests couvre la configuration de la connexion lorsqu’un flux de travail autorisé en a réellement besoin.
Qu’a renvoyé notre test d’accès rapide ?
Notre essai rapide du 16 octobre 2026 a renvoyé des métadonnées exploitables, avec des lacunes d’analyse visibles. Il s’agissait d’un petit instantané, pas d’un benchmark.
Andrii a exécuté les vérifications sous Linux avec Python 3.12 et requests. L’échantillon d’extraction comprenait les 10 premiers résultats pour residential proxy, récupérés directement avec des pauses. Les artefacts de mesure sont google_patents.py, reproduit plus haut, et son fichier de sortie patents.csv. Des vérifications séparées ont porté sur une page de brevet, sur l’endpoint de recherche et sur des services alternatifs sans authentification.
| Vérification | Résultat observé |
|---|---|
| Page US9876543B2 | HTTP 200 ; environ 449 Ko ; 0,16 seconde |
| Recherche XHR | HTTP 200 ; application/json ; environ 37 Ko ; 1,1 seconde |
| Réponse de recherche | 129 598 résultats annoncés et un plafond de 100 pages |
| Titres et déposants | Extraits pour 10 résultats sur 10 |
| Résumés | Absents de la sortie analysée pour 3 résultats sur 10 |
| Revendications | Zéro analysée pour 2 pages de brevets chinois à la structure différente |
| Liens PDF | Absents de la sortie analysée pour 1 résultat sur 10 |
Le premier résultat était US12381958B2, Methods and systems for implementing a regionally contiguous proxy service. Ses champs extraits indiquaient Oxylabs UAB, une date de priorité au 2021-03-19, une date de publication au 2025-08-05, le statut Active et 18 revendications. Ce sont des valeurs observées sur les pages, pas une évaluation juridique indépendante.
OPS a renvoyé 403 avec un message de rejet Fair Use sans inscription OAuth. ODP a renvoyé 401 sans clé d’API. L’ancien nom d’hôte de PatentsView n’a pas pu être résolu par le DNS depuis notre serveur. Rien de tout cela n’établit une panne générale ni un taux de réussite d’un service authentifié.
Avec environ 0,45 Mo par page, 1 000 pages similaires représenteraient environ 0,45 Go de transfert, soit environ 0,45 $ à 1 $ par Go. Cette extrapolation exclut les PDF, les nouvelles tentatives et les autres flux. Nous n’avons eu besoin d’aucun proxy pour les 10 pages et n’avons pas mesuré de durée de collecte globale.
Quelles API et exports officiels constituent des alternatives ?
Commencez par la source dont les enregistrements correspondent au projet. Un export, un jeu de données de recherche et une API de documents répondent à des problèmes différents.
Pour une courte liste, les instructions d’export CSV de Google permettent d’obtenir jusqu’aux 1 000 premiers résultats (en octobre 2026), parfois moins. Il s’agit d’un export de recherche borné, pas d’une preuve d’exhaustivité du corpus.
L’USPTO indique désormais que PatentsView est hébergé sur ODP. Le guide de transition n’a pas pu être lu pendant la vérification ; nous ne déduisons donc pas d’endpoints de remplacement et ne reprenons pas les anciennes instructions d’authentification. La page d’accueil officielle est une meilleure preuve de l’emplacement que l’échec de résolution DNS de notre serveur.
EPO OPS documente l’inscription et OAuth. Son quota gratuit va jusqu’à 4 Go par semaine, avec un abonnement annuel de 2 800 EUR pour un usage supérieur (en octobre 2026), sous réserve de ses conditions et de ses règles d’usage raisonnable.
PATSTAT, DOCDB et le service de données en volume de The Lens méritent d’figurer sur la liste restreinte pour les collections analytiques plus importantes. Comparez leurs modèles de livraison avant de choisir un format de stockage.
Comment constituer des données de brevets en volume pour l’analyse ?
Constituez les collections volumineuses à partir de versions identifiables, conservez les fichiers bruts et normalisez-les dans un schéma analytique documenté. Un import réussi ne suffit pas à établir l’exhaustivité.
| Source | Livraison documentée | Vérifications d’actualisation et d’historique | Décision d’intégration |
|---|---|---|---|
| Export de recherche Google | CSV | Consigner la requête et la date d’export | Petites listes de candidats ; conserver le contexte de recherche |
| Publications BigQuery | Tables accessibles en SQL | Inspecter les métadonnées de la table en production et la couverture des dates | Les champs répétés exigent des jointures réfléchies |
| Données de publication de l’USPTO | XML des brevets délivrés et des demandes | Faire correspondre les fichiers aux dates de délivrance et aux générations de schéma | Séparer les brevets délivrés des publications de demandes |
| PATSTAT | Tables CSV en volume ; analyse SQL via son service en ligne | Éditions semestrielles ; conserver l’identité de l’édition | Les jointures relationnelles conviennent aux études statistiques |
| DOCDB | XML bibliographique | Téléchargements hebdomadaires des données courantes ; évaluer les besoins en fonds historique | Prévoir la normalisation XML et les mises à jour |
| The Lens | JSON Lines compressé | Publications toutes les deux semaines et métadonnées de mise à jour | Vérifier les droits d’abonnement et l’accès par jeton |
Les références de format et de publication sont les ressources XML de l’USPTO, le manuel PATSTAT, la documentation DOCDB et la documentation des données en volume de Lens, liées plus haut. Ne supposez pas qu’un dump SQL ou un export TSV existe simplement parce que l’analyse en aval utilise ces formats. La profondeur historique doit être vérifiée pour les champs et les juridictions dont vous avez besoin.
Étape 1 : inventaire. Consignez le produit, la version, la plage de dates de délivrance, le schéma, la somme de contrôle et les conditions d’utilisation. Vérifiez séparément les droits de redistribution et les droits d’accès. Obtenez des devis d’abonnement à jour si nécessaire ; il n’existe pas de prix universel pour les données en volume.
Étape 2 : normalisation. Pour le XML de l’USPTO, extrayez les identifiants de publication, les codes de type, les dates, les déposants et le texte requis dans des tables liées distinctes. Conservez les identifiants sous forme de chaînes. Gardez les inventeurs, classifications et revendications répétés hors d’une ligne aplatie qui multiplierait les publications par accident.
Étape 3 : chargement. Écrivez un CSV normalisé avec des colonnes explicites, puis utilisez l’importeur CSV de DuckDB documenté. Déclarez délibérément les types des identifiants et des dates. Comparez le nombre de documents source aux identifiants distincts importés, inspectez les rejets et testez les jointures avant de calculer des tendances.
Étape 4 : mise à jour. Suivez les versions traitées et remplacez ou fusionnez les enregistrements selon la sémantique de la source. Conservez les versions brutes afin de pouvoir expliquer les corrections. Planifiez les vérifications de disponibilité autour des publications documentées plutôt que de télécharger sans cesse des fichiers inchangés.
Pour un client ODP, distinguez l’API de recherche de produits en volume de la récupération File Wrapper au niveau des demandes. Sa recherche en volume documentée exige une clé d’API ; notre vérification sans authentification n’a validé ni la récupération des demandes ni la pagination.
Pour un client OPS, terminez l’inscription OAuth, choisissez XML ou JSON à l’aide de la référence OPS et appliquez les règles de continuation de cet endpoint. Bornez chaque tâche par le nombre d’enregistrements, de requêtes et par la durée écoulée. Suivez les instructions de limitation de débit des réponses et arrêtez-vous en cas d’échec d’authentification. Notre guide sur la limitation de débit des API explique le schéma opérationnel.
Dans quelle mesure la couverture et les champs de statut juridique sont-ils fiables ?
La couverture et le statut doivent être évalués au niveau du champ, de la juridiction et de la date. Un champ renseigné ne peut pas garantir l’exactitude d’une conclusion analytique.
La documentation de Google sur la couverture ne garantit explicitement pas l’exhaustivité. L’indexation du site, un jeu de données téléchargeable et une réponse tierce doivent donc être audités séparément. Nos résumés et revendications manquants étaient des observations de l’analyseur, pas la preuve que ces documents étaient dépourvus de texte.
Gardez séparés les identifiants de demande, de publication et de famille. Définissez si votre étude compte des documents publiés, des demandes ou des familles avant la déduplication. Conservez le code de type d’origine et l’identifiant de la source, même si vous ajoutez une clé normalisée.
Pour un travail sur le statut juridique, enregistrez la valeur observée avec sa source et sa date de récupération. Vérifiez les conclusions importantes auprès du registre de l’office des brevets concerné et des événements sous-jacents. La valeur Active de notre échantillon est une étiquette de page, pas une garantie de droits opposables dans toutes les juridictions.
Auditez un échantillon stratifié couvrant les pays, les années, les types de documents et les langues. Mesurez l’exhaustivité des champs séparément du succès des requêtes. Pour une recherche mêlant brevets et littérature scientifique, notre guide de collecte sur Google Scholar propose un flux de travail apparenté, mais chaque source exige ses propres contrôles.
Quelles contraintes juridiques et opérationnelles s’appliquent ?
La visibilité publique ne règle pas la question de l’autorisation d’automatiser, de réutiliser ou de redistribuer des données. Vérifiez les conditions applicables et les règles lisibles par machine avant la collecte.
Le fichier robots actuel autorise les chemins de brevets mais interdit la recherche XHR. Les conditions de Google interdisent l’accès automatisé contraire aux instructions lisibles par machine. Ces vérifications n’établissent pas ce qui avait été examiné avant notre essai historique ; ses réponses réussies ne constituent que des observations techniques.
L’arrêt hiQ v. LinkedIn de 2022 portait sur des mesures provisoires et sur une question précise du CFAA concernant des pages publiques. Il ne constitue pas une autorisation générale de faire du web scraping ni la résolution de toutes les actions contractuelles.
La directive européenne sur les bases de données peut restreindre l’extraction ou la réutilisation d’une partie substantielle. Lorsque des données personnelles sont concernées, évaluez la licéité du traitement, la finalité, la conservation et la minimisation au regard du RGPD. Les informations publiques sur les inventeurs ne sont pas automatiquement exclues de ces obligations.
Utilisez des requêtes bornées, respectez les refus et ne considérez pas la rotation de proxies comme une autorisation. Consultez notre guide juridique sur le web scraping pour plus de contexte ; c’est au lecteur de décider, vérifiez la législation locale.
Questions fréquentes
Existe-t-il une API Google Patents officielle ?
Nous n’avons identifié aucune API Google publique documentée pour les résultats de recherche du site. L’interface XHR interne observée lors de notre essai ne doit pas être considérée comme une API publique prise en charge.
Où obtenir une clé d’API ?
Choisissez d’abord le service, puis suivez ses instructions d’authentification officielles liées plus haut. Un identifiant de fournisseur de recherche, une identité Google Cloud et un identifiant d’office des brevets ne sont pas interchangeables.
Puis-je accéder gratuitement aux données de brevets ?
Nos vérifications directes de pages n’ont entraîné aucun frais de proxy, et les options d’accès officielles ci-dessus incluent un accès gratuit borné. Cela ne rend pas tous les flux de travail gratuits : l’exécution des requêtes, le stockage, les abonnements et la maintenance peuvent tout de même coûter de l’argent.
En quoi BigQuery, Google Patents, l’USPTO et EPO OPS diffèrent-ils ?
Considérez-les comme des choix de source et d’accès différents plutôt que comme des endpoints équivalents. Faites correspondre chaque voie documentée à l’analyse, aux juridictions, aux champs et à la fraîcheur dont vous avez besoin, puis testez ces exigences avant de passer à l’échelle.
Quand l’extraction de pages publiques nécessite-t-elle un proxy ?
Un proxy peut convenir à un flux de travail autorisé qui exige un itinéraire réseau particulier ou une sortie géographique précise. Notre essai sur 10 pages n’en a eu besoin d’aucun, et en ajouter un ne résoudrait ni les erreurs d’analyse, ni les champs manquants, ni les restrictions d’accès.
Un nombre de revendications égal à zéro signifie-t-il que le brevet n’a aucune revendication ?
Non. Notre script a renvoyé zéro lorsque la structure de revendications attendue était absente, y compris pour deux pages chinoises. Considérez ce résultat comme un problème d’analyse à inspecter.
Le script testé peut-il télécharger tous les brevets et PDF correspondants ?
Non. Il traite les 10 premiers résultats de recherche et stocke les liens PDF découverts sans les télécharger. Il tronque aussi les résumés et dépend d’un endpoint de recherche non documenté dont les règles robots actuelles restreignent l’accès automatisé.
Estimez les coûts de transfert avant d’ajouter des proxies
Si un flux de collecte autorisé nécessite un routage par proxy, les proxies résidentiels DataImpulse démarrent à 1 $ par Go. Mesurez séparément des pages et des PDF représentatifs avant d’établir un budget. DataImpulse fournit de la connectivité proxy, pas une API de scraping, un unblocker géré, un VPN ni un fournisseur de données de brevets.
Dernière mise à jour : 16 octobre 2026.